[プレースホルダー:公開日は未確定。]
[プレースホルダー:Yelp のお客様事例動画—最終版の動画、サムネイル、字幕、文字起こしは準備中。]
本日、GPT‑Live‑1 を API で提供開始します。開発者は、強力な音声モデルとフロンティアレベルの応答性能を独自のアプリケーションで組み合わせられます。GPT‑Live‑1 はまず ChatGPT に導入され、聞くことと話すことを同時に行えます。また、Codex と ChatGPT Work で示したように(新しいウィンドウで開く)、より深い推論やアクションを、組み合わせたモデルやツールに委任できます。
GPT‑Live の API 提供にあたり、利用者、ワークフロー、目標に合わせて音声体験を設計できる新機能に注力しました。たとえば初期評価では、語学学習アプリの Speak において、学習者が考えている間の割り込みが従来のターン制システムより約 80% 減少しました。講師が話し始める前に、学習者が言葉を探す余裕が広がります。
API 版で追加される機能:
割り込み処理:単一のモデルが入力音声と出力音声をまとめて推論し、STT–LLM–TTS を連結したアーキテクチャの遅延や不安定な受け渡しを回避します。
エージェントのオーケストレーション:複数ステップの指示に従う精度とカスタムツール呼び出しの実行精度が向上し、より深い推論やアクションを、開発者が選んだバックエンドモデルやエージェントハーネスに委任します。
カスタム音声:[XX—count TBD]種類の新しいカスタム音声を[XX—count TBD]言語で追加し、ブランドが言語や方言をまたいで自然で独自性のある音声体験を構築できるようにします。
パーソナリティの調整:システムプロンプトを通じて、エージェントの口調、話す速さ、会話スタイルを設定できます。
バックグラウンドでのコンテキスト管理と背景雑音:会話を遮ったり各ステップを逐一読み上げたりせず、背景雑音や沈黙をより適切に処理します。
柔軟な応答性能:ワークフローに合う任意のバックエンドモデルやエージェントハーネスを選択できます。
長時間セッションの信頼性:長時間のやり取りでも、コンテキストの保持力と会話品質が向上します。
電話対応:レストランの予約からカスタマーサポートまで、通話用の全二重音声エージェントを導入できます。
[PLACEHOLDER: Interactive voice demo—source mockup shown; final GPT‑Live‑1 experience pending.]
従来の音声エージェントは、音声認識、リーズニングモデル、音声合成を連結しています。受け渡しのたびに遅延が生じ、会話のタイミングやコンテキスト、自然なリズムが損なわれやすくなります。誰かが割り込んだり、間を置いたり、話題を変えたりした場合の処理も含め、こうした各段階の調整は多くの場合、開発者に委ねられています。
GPT‑Live‑1 は単一のモデルで聞くことと話すことを処理し、リアルタイム音声レイヤーを簡素化します。割り込みや相づちにその場で応答しながら、より深い推論をバックエンドに委任できます。これにより、バックグラウンドで処理を進めながら会話を続けられます。
開発者は、会話を支えるモデル、ツール、エージェントハーネスを選択できます。たとえば、スケジュール調整や注文状況の更新といった大量のタスクには GPT‑Live‑1 と Luna のようなモデルを組み合わせ、推論を要する複雑な顧客課題には Astra のようなモデルを使用できます。この柔軟性により、タスクごとに推論の深さ、速度、コストを最適化できます。
GPT‑Llive‑1 は、ASR の文字起こしと応答テキストをネイティブで提供します。また、英数字を高精度で理解し、キーワードバイアスにも対応します。GPT‑live はターン制モデルではありませんが、ターン検出にネイティブ対応しているため、開発者は明示的なターン境界を前提とした構築を継続できます。
[PLACEHOLDER: Side-by-side audio comparison of GPT‑Live‑1 and a cascaded voice system—audio files and transcripts pending.]
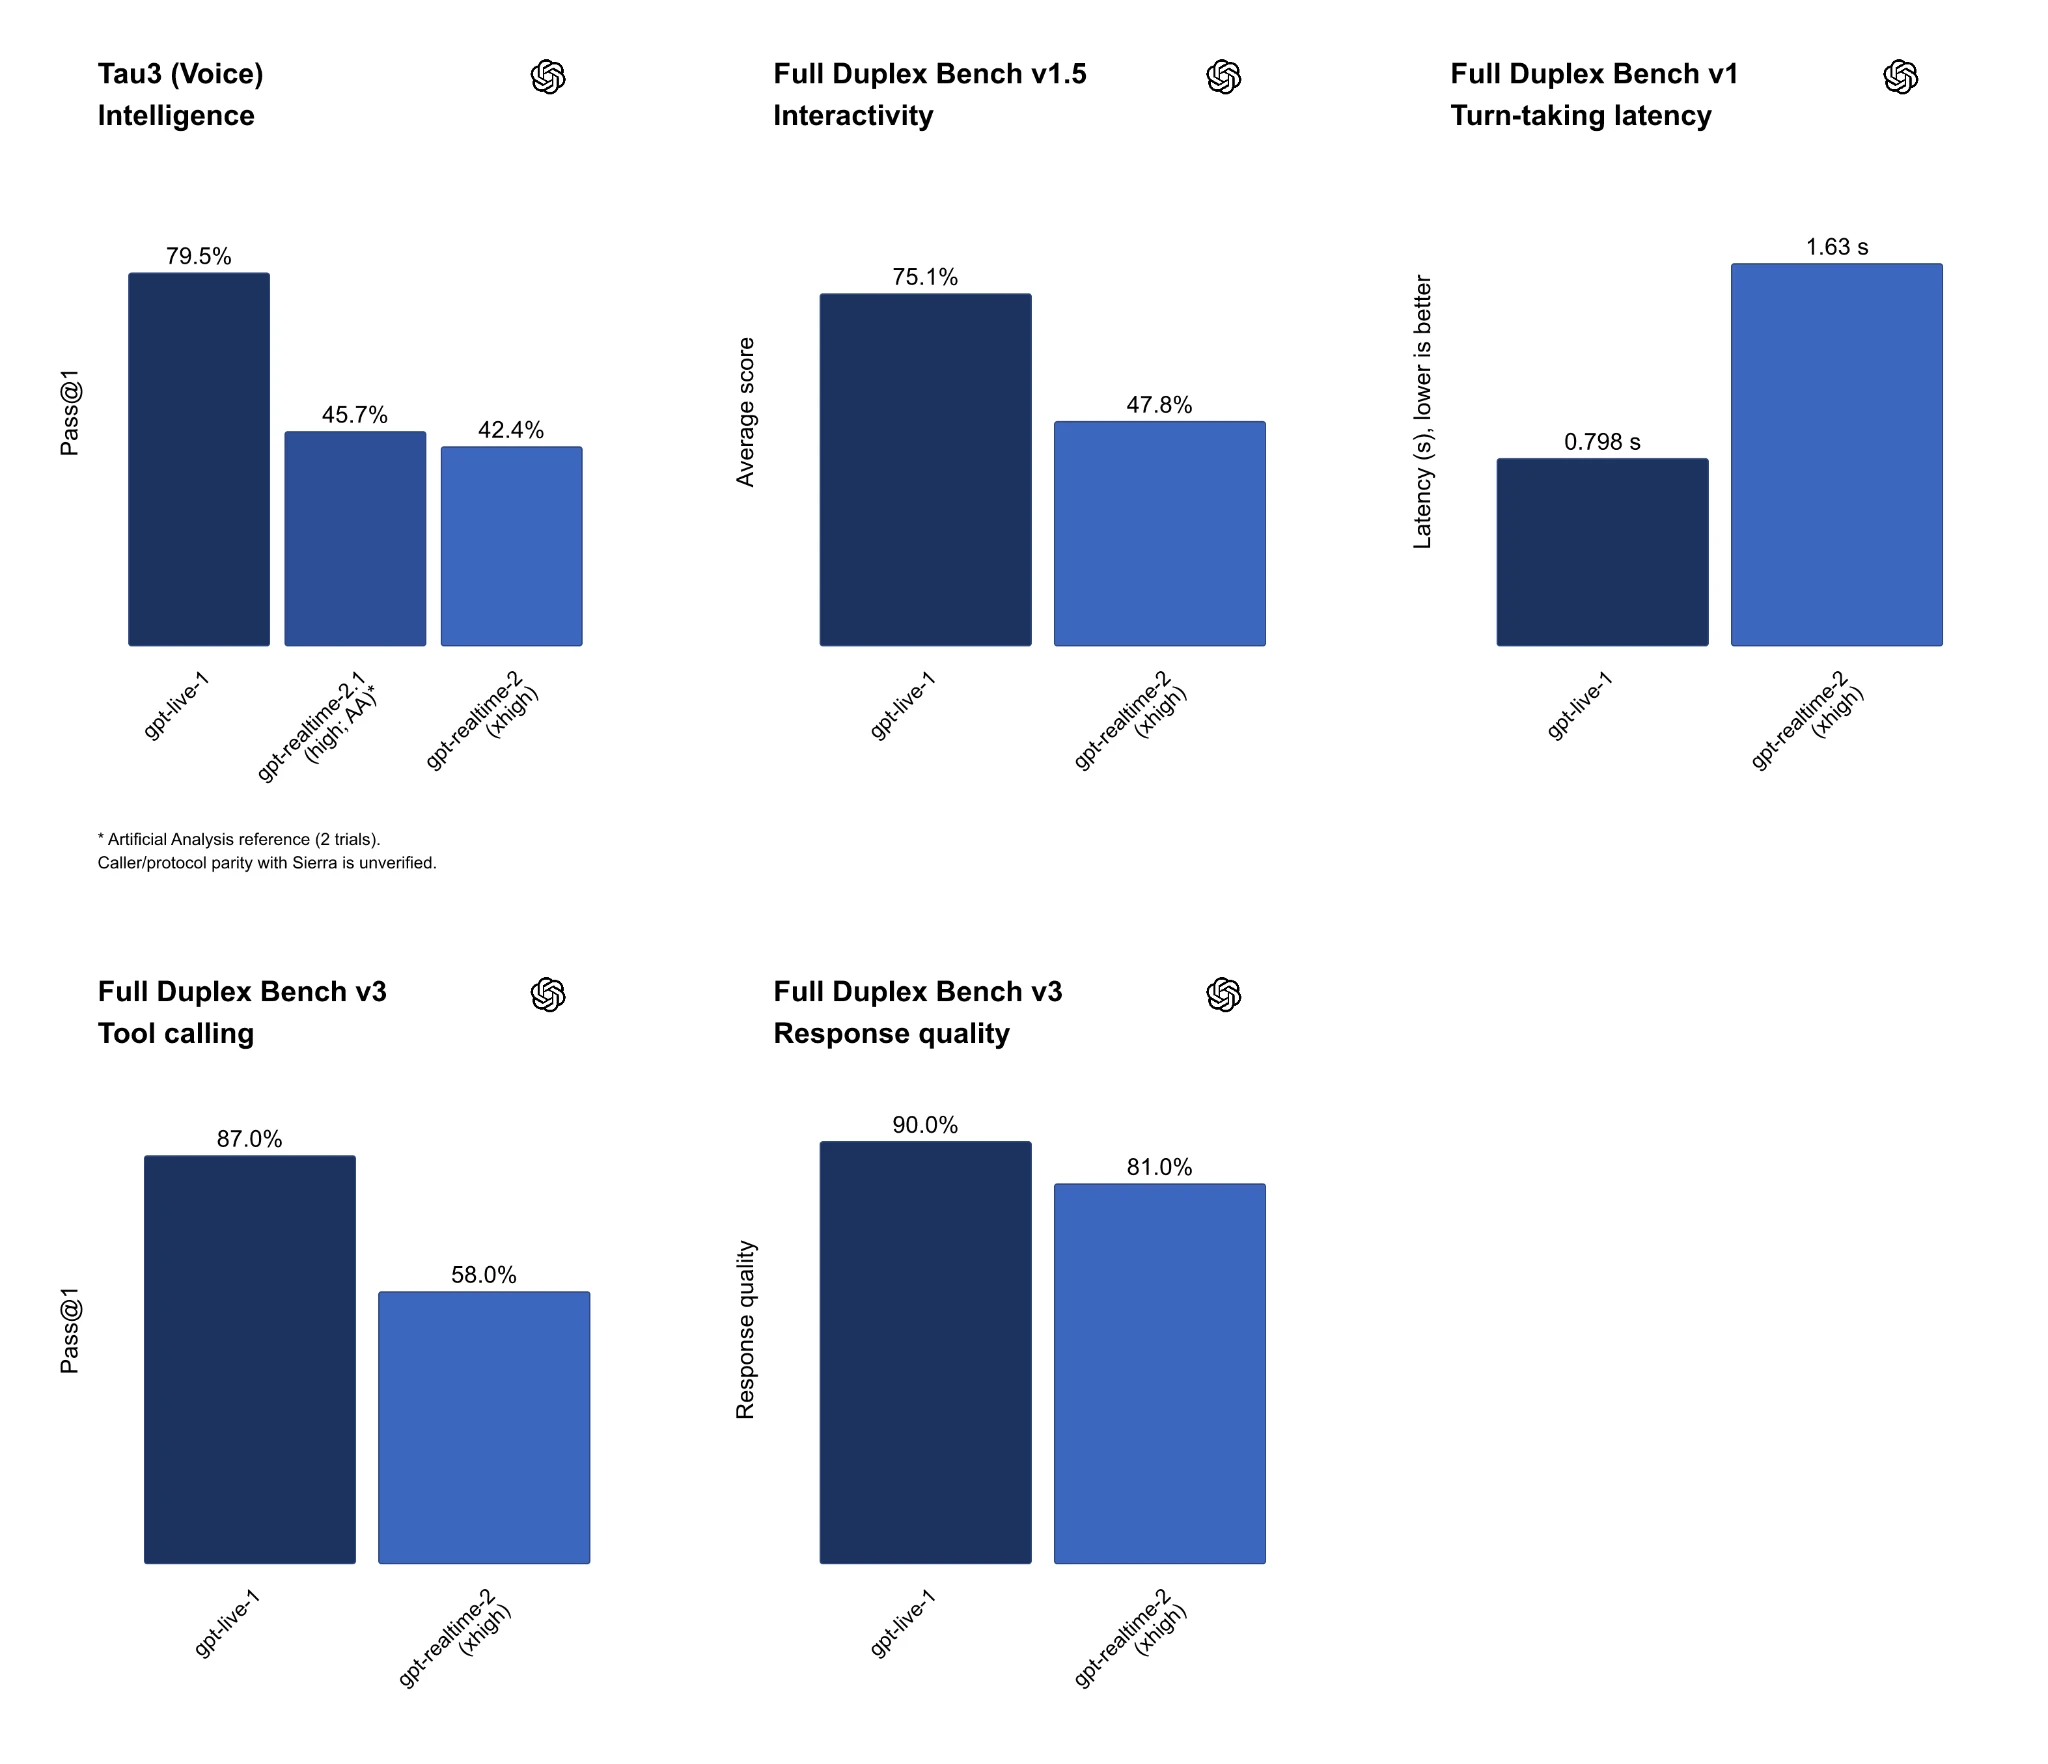
当社の評価では、思考量を「中」に設定した GPT‑6 Astra と GPT‑Live‑1 の組み合わせが、エンドツーエンドのタスクでフロンティア音声エージェントの応答性能を測る Tau3 で 1 位となりました。また、対話性、発話交代の遅延、ツール呼び出し、応答品質を評価する Full Duplex Bench でも 1 位です。
開発者には、製品に合い、利用者にとって自然に聞こえる音声が必要です。GPT‑Live‑1 では、少数のリアルタイム音声から、アクセント、方言、言語をまたぐ幅広い選択肢へと拡充し、アシスタントの声をより柔軟に選べるようにします。
Quartz—オーストラリア英語、女性的、生成音声
Ripple—オーストラリア英語、男性的、自然音声
Vesper—イギリス英語、男性的、自然音声
Willow—アイルランド英語、女性的、自然音声
Stone—アイルランド英語、男性的、自然音声
Gleam—北米英語、女性的、自然音声
Meridian—北米英語、男性的、自然音声
Bossa—ブラジルポルトガル語、女性的、自然音声
Tempo—ブラジルポルトガル語、男性的、自然音声
Aster—インド英語、女性的、生成音声
Beacon—フィリピン英語、男性的、生成音声
Delta—米国南部英語、女性的、生成音声
Cinder—米国南部英語、男性的、生成音声
[プレースホルダー:音声ごとに 3~5 個のサンプル文を繰り返し再生する音声選択画面—音声サンプルとインタラクティブ体験は準備中。]
今後数か月にわたり、音声オプションと対応言語を引き続き拡充します。
GPT‑Live‑1 は本日より API で提供され、フロントエンドの音声レイヤーは 1 分あたり 0.05 ドルです。製品に適したバックエンドモデルやエージェントハーネスと組み合わせることで、担う業務に応じて拡張できる音声体験を構築できます。
カスタム音声の利用条件や申請手続きについては、営業担当へのお問い合わせをご利用ください。
音声とチャットのリアルタイム体験に対応する Presence を使えば、GPT‑Live‑1 をより迅速に導入できます。カスタマーサポート、アウトバウンド営業、リスクの高い社内ワークフローなどに活用できます。詳しくは、OpenAI のアカウントディレクターにお問い合わせください。