Terminal X: 88,6% eens met ervaren beleggers met GPT‑6.1
De Eval Agent van Terminal X toetst output aan 54 criteria en ontdekt met GPT‑6.1 Sol 25% meer afwijkingen van het fondsmandaat.
25%
Hogere detectiegraad van agentantwoorden buiten het fondsmandaat met GPT‑6.1 Sol dan met het op één na beste model
$ 2,4 mln.
Besparing op jaarbasis voor één klant op due diligence en beleggingsworkflows
+220 basispunten
Meer overeenstemming tussen agents en menselijke beoordelaars met GPT‑6.1 Sol dan met het op één na beste model
30%
Lagere kosten per query met GPT‑6.1 Sol dan met het op één na beste model
Een investeringsmaatschappij bouwt haar voorsprong transactie voor transactie op, maar de afwegingen achter elke beslissing zitten meestal in het hoofd van een paar ervaren beleggers. Als zij vertrekken, ontstaat wat Terminal X(opent in een nieuw venster) een geheugenschuld noemt: de documenten blijven misschien bewaard, maar de redenering gaat verloren.
Het besturingssysteem Capital Memory van Terminal X is ontworpen om die schuld af te bouwen. De engineers die het bedrijf bij klanten inzet, werkten eerder als financiële en beleggingsprofessionals bij JPMorgan en Blackstone. Ze werken nauw samen met de beleggingsteams van elke klant, ontwerpen de agentarchitectuur en leggen de beleggingsaanpak vast in agents die eigendom zijn van de klant en lokaal of in de eigen cloud draaien.
OpenAI-modellen, waaronder GPT‑6.1 Sol en GPT‑6 Luna, verzorgen de redenering binnen die agents. De Eval Agent van Terminal X beoordeelt de output van de agents aan de hand van de normen van de investeringsmaatschappij. Met GPT‑6.1 Sol ontdekte de Eval Agent ongeveer 25% meer aanbevelingen die afweken van het fondsmandaat. Het model voerde dezelfde workflows uit tegen circa 30% lagere kosten per query dan het op één na beste model.
"Dankzij de redenering over lange contexten en het efficiënte tokengebruik van GPT-6.1 Sol kunnen we grondigere evaluatiepipelines bouwen. Dit helpt onze Eval Agents om beleggingsafwegingen meetbaar en controleerbaar te maken."
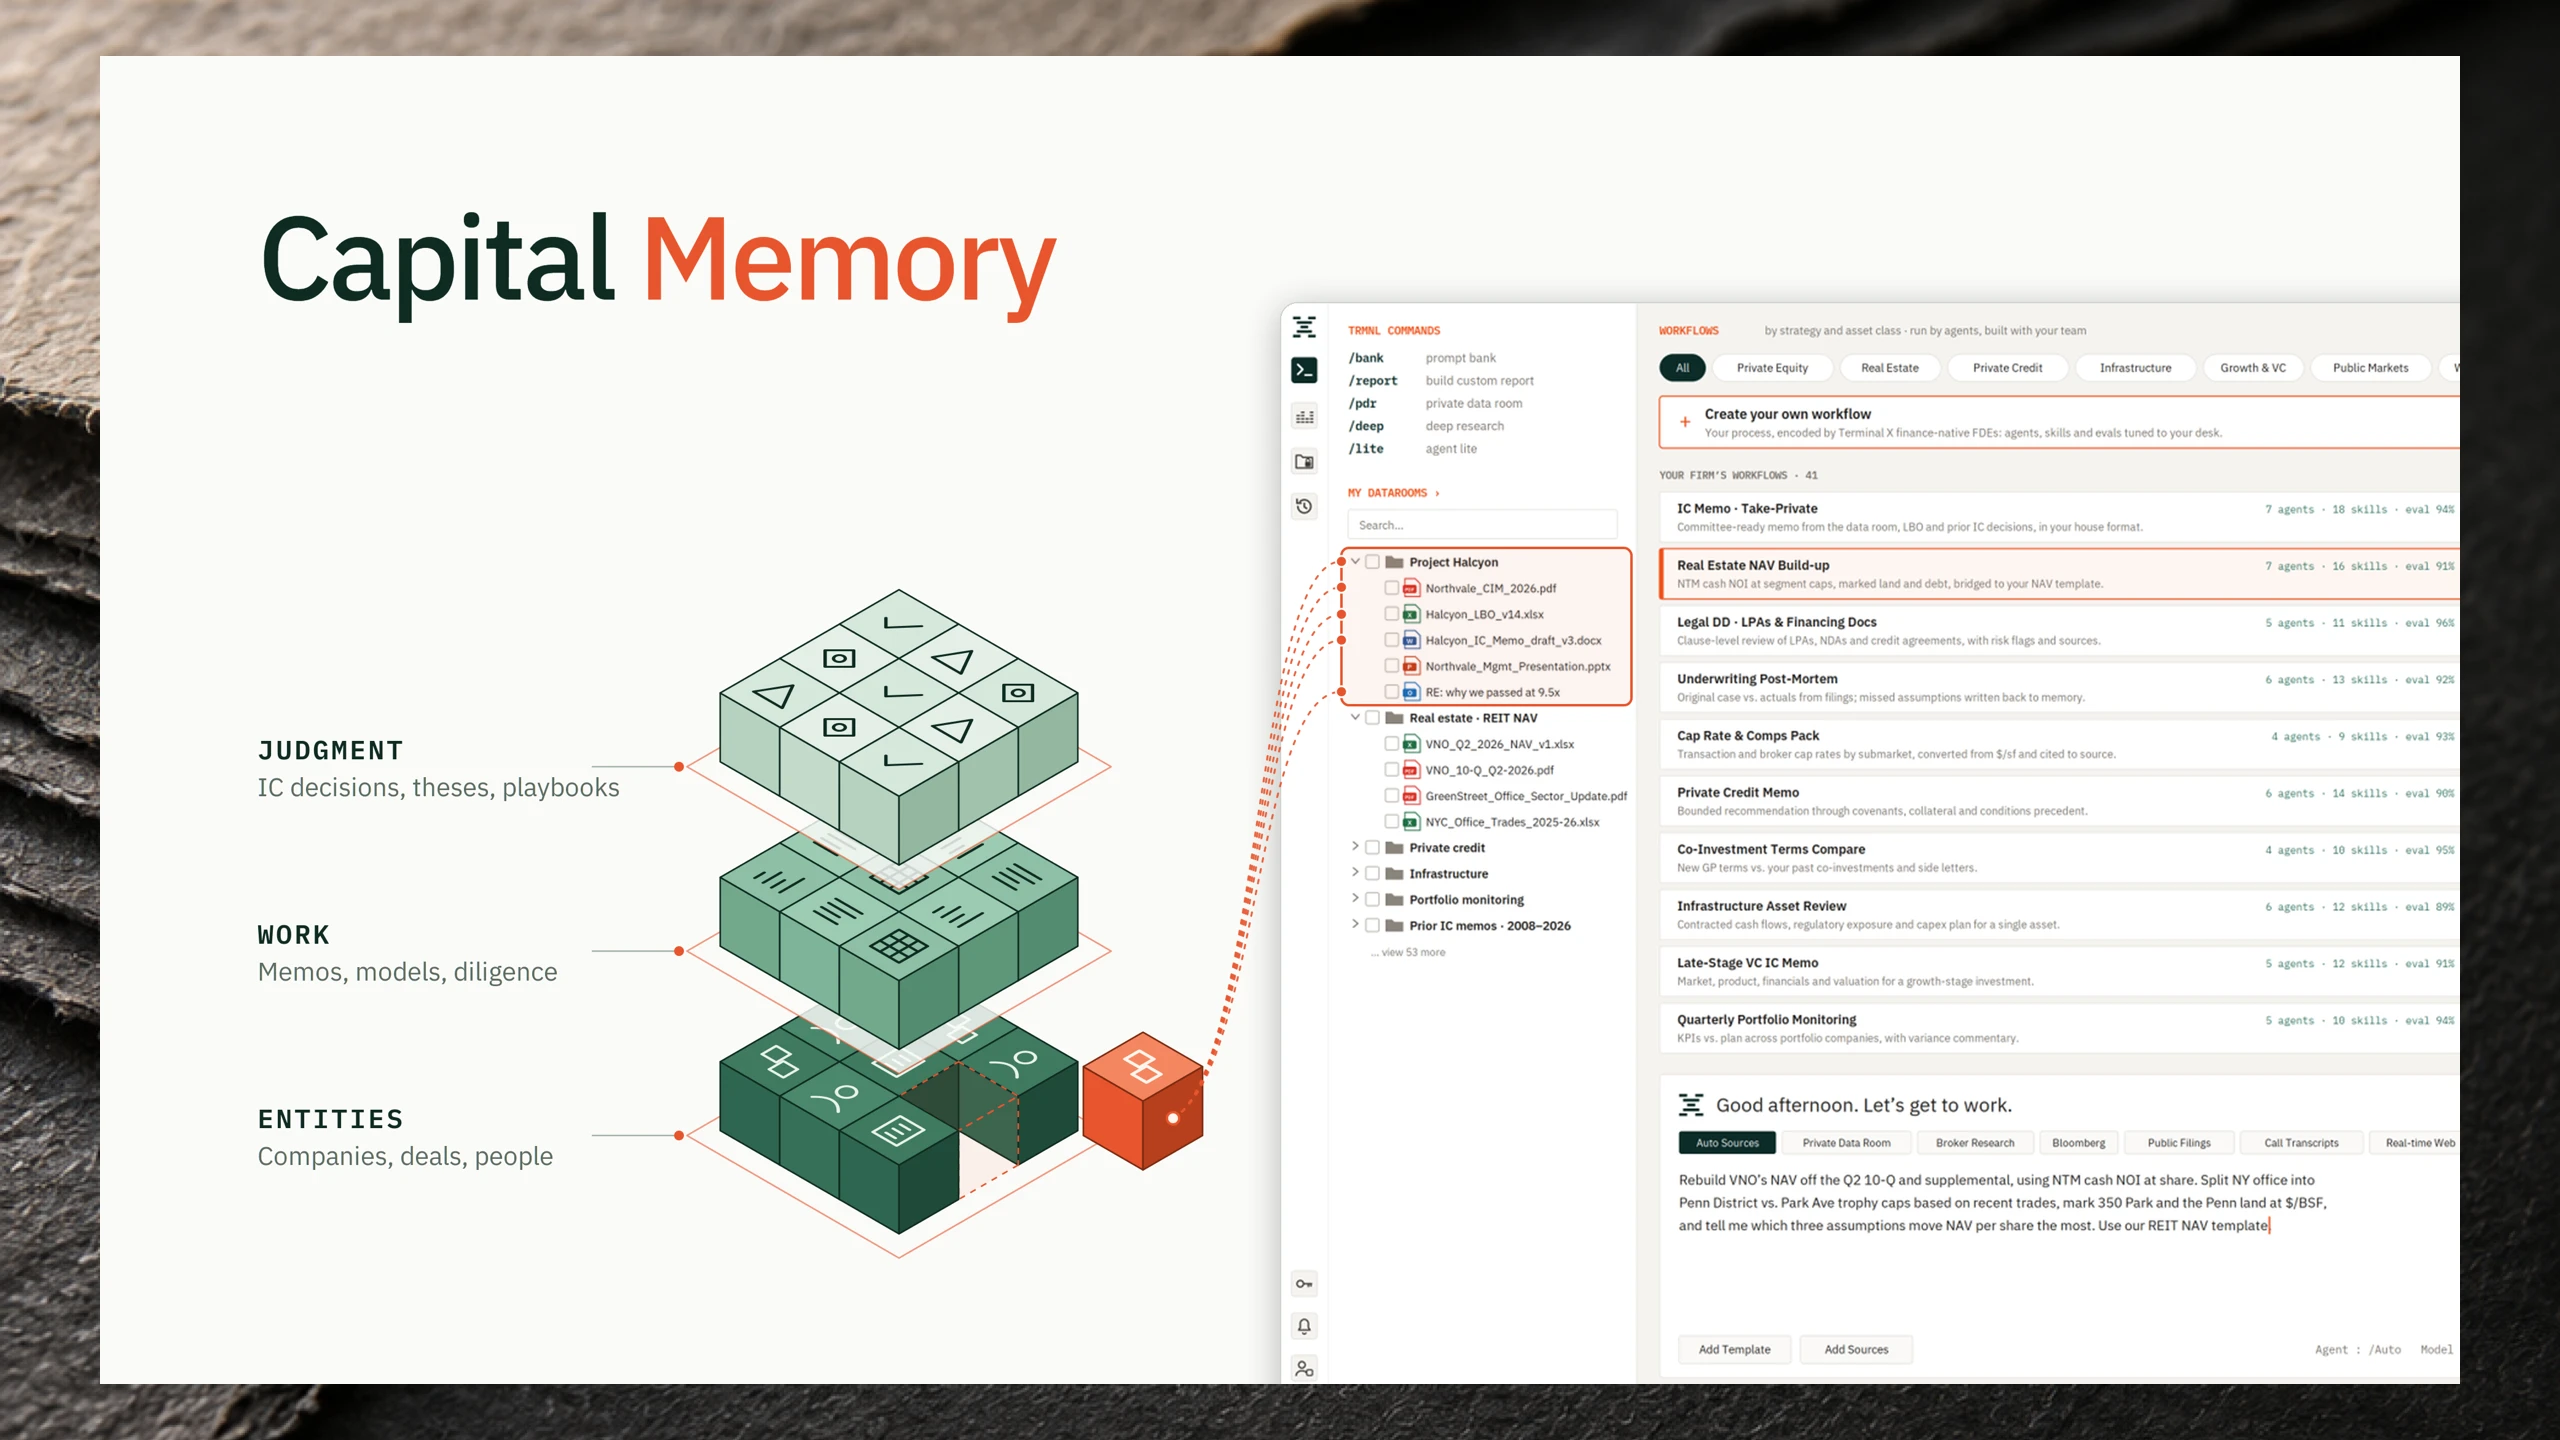
Voor elke klant bouwt Terminal X agents die zijn ontworpen om te beleggen zoals de beste beleggers van die investeringsmaatschappij. Engineers van Terminal X werken wekenlang op locatie bij de klant. Ze reconstrueren de werkwijze achter vertrouwde memo's en leggen processen vast die nooit zijn opgeschreven, zoals hoe het kredietteam een kredietnemer doorlicht of welke bronnen het co-investeringsteam raadpleegt voor een memo.
Vervolgens worden die processen vastgelegd in honderden agents, afgestemd op beleggingscategorie en strategie, met subagents voor elke fase van het beleggingsproces. GPT‑6.1 Sol verzorgt de fasen die oordeelsvermogen en een zeer groot contextvenster vereisen: de beleggingsthese formuleren, de belangrijkste overwegingen identificeren en beoordelen of een belegging past binnen het mandaat van de investeringsmaatschappij. GPT‑6 Luna voert de veelvoorkomende stappen uit waarbij efficiënt tokengebruik belangrijker is dan diepgang.
De agents werken binnen de privédataroom van elke investeringsmaatschappij, een speciale omgeving waarin bedrijven gevoelige beleggingsgegevens delen en beheren. De agents verwerken documenten in het Engels, Koreaans, Japans en Chinees. Wat ze leren, slaan ze op als een bedrijfsspecifieke Memory: een vastlegging met versiebeheer van hoe één team één soort beslissing neemt, inclusief eerdere analyses, commissiebesluiten, workflowinstructies en eigen beleggingsvisies.
Engineers zetten elke Memory om in een herhaalbare workflow op het platform van Terminal X. Daar is elke query in de productieomgeving volledig controleerbaar: alle uitgevoerde stappen, geraadpleegde bronnen, het gebruikte model en de redenering zijn terug te vinden.
Volgens Terminal X levert deze aanpak klanten aanzienlijke besparingen op. Zo meldde een private-equitymaatschappij op jaarbasis 2,4 miljoen dollar te besparen door workflows voor due diligence en investeringsmemo's te automatiseren.
Terminal X bouwde een Eval Agent om de antwoorden van agents te toetsen aan de eigen normen van de investeringsmaatschappij. Deze georkestreerde workflow op GPT‑6.1 Sol en andere OpenAI-modellen is ontworpen om elke agentoutput te lezen zoals een VP het werk van een analist leest.
De Eval Agent toetst elke output aan een beoordelingskader met 54 criteria. Daarbij stelt hij vragen als: komen de cijfers, vergelijkingsgegevens, consensusramingen en citaten uit de juiste bronnen? Houdt het betoog stand? Sluit de aanbeveling aan op de beleggingsvisie van de investeringsmaatschappij?
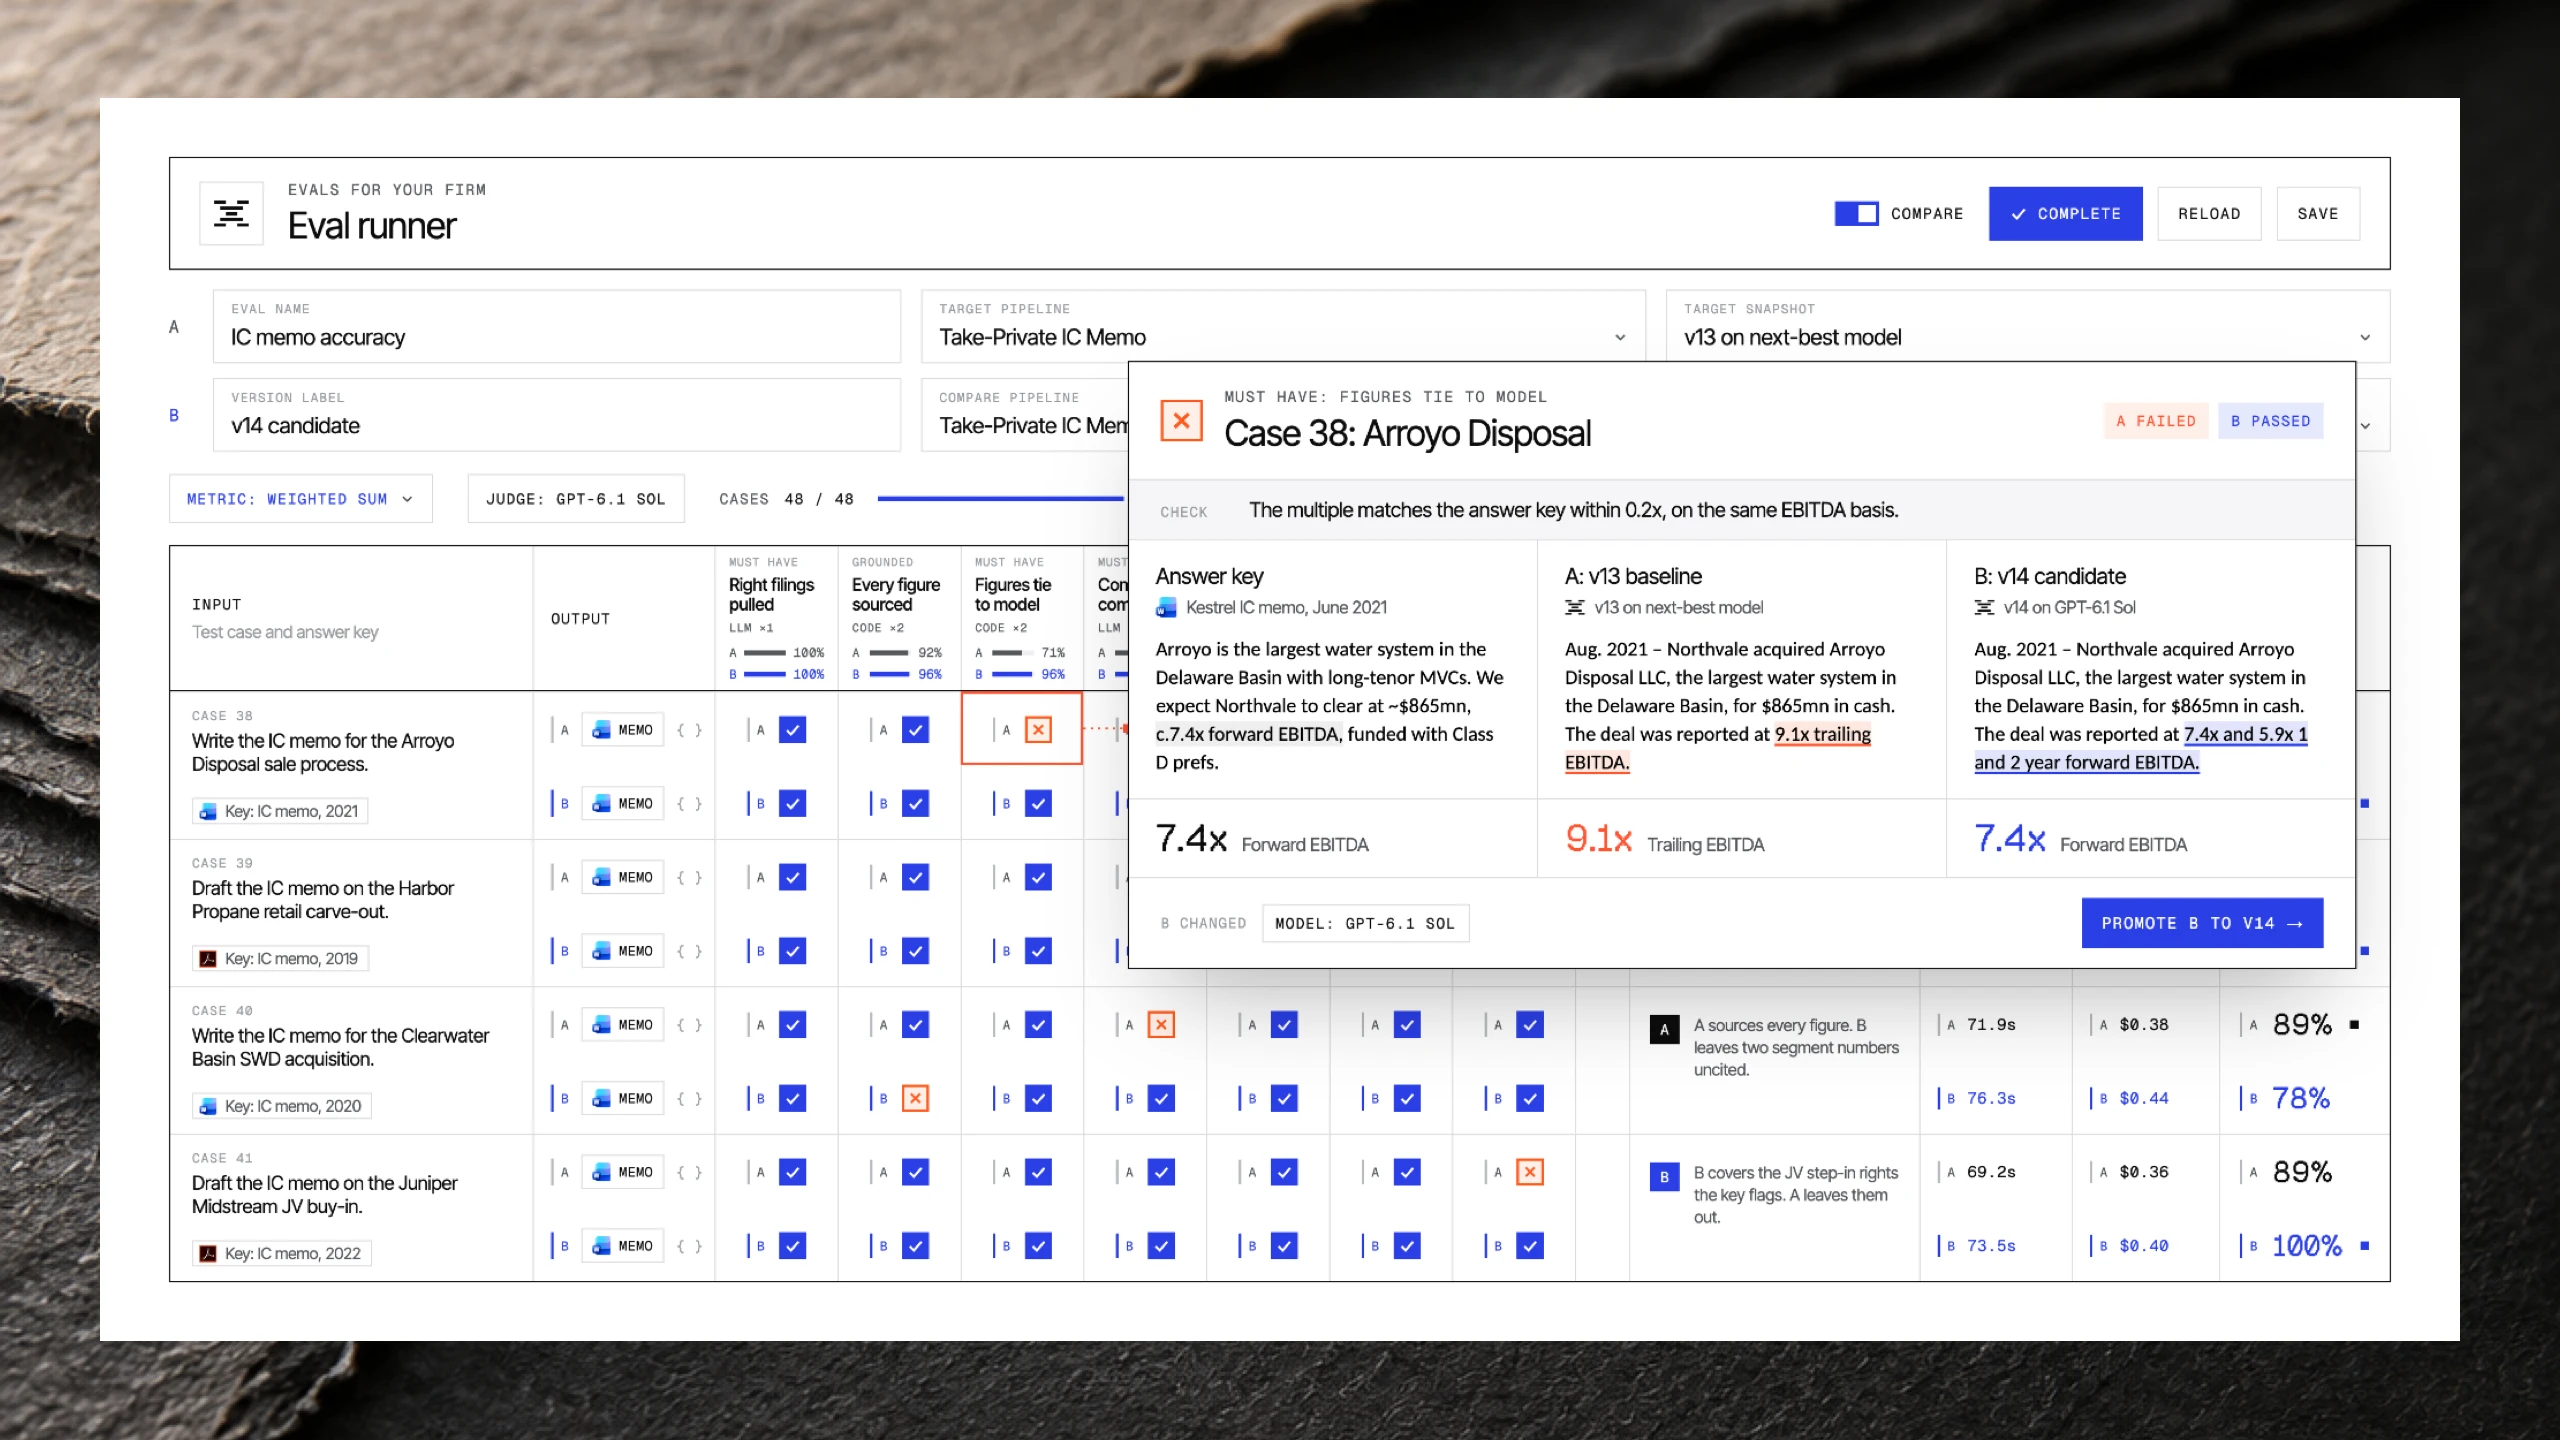
Elke controle levert een voldoende of onvoldoende op. Elke onvoldoende krijgt een toelichting van één regel en een betere bron of gecorrigeerde tekst, en wordt vastgelegd als een Memory. Een gemiste bron, een onjuist vergelijkingsobject of een beleggingsthese die afwijkt van de eigen beleggingsvisie wordt bijvoorbeeld vastgelegd als nieuwe workflowinstructie of testcase voor dat team.
"Elk antwoord wordt geëvalueerd, en met elke correctie van de analist leert het systeem iets meer over hoe die investeringsmaatschappij werkt", zegt Ken Lee, medeoprichter en CTO van Terminal X. "Hoe langer een investeringsmaatschappij het gebruikt, hoe meer het dus denkt als het eigen team."
Terminal X kiest modellen op basis van eigen evaluatieresultaten. Bij 500 getoetste beoordelingen kwam de Eval Agent op GPT‑6.1 Sol in 88,6% van de gevallen tot hetzelfde oordeel als de ervaren menselijke beoordelaar, tegenover 86,4% voor het op één na beste model: een verbetering van 220 basispunten.
Een type fout dat GPT‑6.1 Sol beter herkende, was het afwijken van de beleggingsstijl. Het mandaat van een buy-outfonds kan bijvoorbeeld zijn om beursgenoteerde overnamekandidaten te vinden die onder hun intrinsieke waarde noteren, de onderneming te beoordelen en de financiering voor een beursexit te structureren. Wanneer scenariomodellen op een marktomslag wijzen, beginnen transactievoorstellen echter beleggingen in noodlijdende schuld of reddingsfinanciering aan te bevelen. De Eval Agent op GPT‑6.1 Sol ontdekte ongeveer 25% meer van deze afwijkingen dan het op één na beste model.
Dankzij het efficiënte tokengebruik van GPT‑6.1 Sol bij taken met een lange context kon Terminal X binnen hetzelfde budget een workflow voor grondigere beoordelingen bouwen. De beleggingsthese wordt eerst getoetst aan het fondsmandaat en vervolgens aan recente transacties van het fonds. Bij onzekere oordelen wordt de beoordeling herhaald, waarna de agent de resultaten met elkaar in overeenstemming brengt voordat hij rapporteert.
Die grondigere beoordeling signaleerde problemen bij transacties die een vergelijkbaar model na één beoordelingsronde had goedgekeurd. GPT‑6.1 Sol voerde dezelfde workflows bovendien uit tegen ongeveer 30% lagere kosten per query dan het op één na beste model, bij een vergelijkbare snelheid.
Met GPT‑6.1 Sol en GPT‑6 Luna heeft Terminal X 1.700 bedrijfsspecifieke Memories opgebouwd en meer dan 1 miljoen maatwerkworkflows uitgevoerd. Het aantal wekelijks actieve gebruikers is inmiddels gelijk aan 81% van het aantal maandelijks actieve gebruikers.
De volgende stap van Terminal X is om bedrijfsspecifieke Memories uit te breiden van teams naar individuele medewerkers. Zo wordt de beoordelingsnorm van elke beleggingsprofessional vastgelegd zoals die in de praktijk wordt toegepast, niet alleen zoals die wordt beschreven.
Voor Hyun, medeoprichter en CEO van Terminal X, is dat precies waar het om draait: "De investeringsmaatschappijen die het komende decennium winnen, hebben hun oordeelsvermogen als data in eigen bezit. Het is onze taak om dat oordeelsvermogen meetbaar te maken, zodat het behouden, verbeterd en hergebruikt kan worden."