GPT‑6.1 で熟練投資家との判断一致率 88.6% を実現した Terminal X
Terminal X の Eval Agent が 54 項目の基準で出力を評価。GPT‑6.1 Sol により、ファンドの運用方針からの逸脱の検出数が 25% 増加
25%
GPT‑6.1 Sol による、ファンドの運用方針を逸脱したエージェント回答の検出率向上幅(次点モデル比)
240 万ドル
ある顧客がデューデリジェンスと投資ワークフローで実現した年間換算のコスト削減額
+220bps
GPT‑6.1 Sol による、エージェントと人間のレビュアーの判断一致率の向上幅(次点モデル比)
30%
GPT‑6.1 Sol による、次点モデル比でのクエリあたりのコスト削減率
投資会社の競争力は、一つひとつの案件を通じて築かれます。しかし、個々の意思決定を支える判断の根拠は、たいてい少数の熟練投資家の頭の中にしかありません。彼らが会社を去ると、その会社は Terminal X(新しいウィンドウで開く) が「記憶の負債」と呼ぶものを抱えます。文書は残っていても、判断に至った思考過程は失われてしまうのです。
Terminal X のオペレーティングシステム、Capital Memory は、この負債を減らすために設計されています。同社の顧客現場に常駐するエンジニアは、JPMorgan や Blackstone で金融・投資業務に携わった経験者です。各顧客の投資チームとともに業務に取り組み、エージェントを活用するアーキテクチャを設計し、その会社の投資手法をエージェントに組み込みます。エージェントは顧客企業が所有し、オンプレミスまたは自社のクラウドに展開されます。
これらのエージェント内で推論を担うのが、GPT‑6.1 Sol や GPT‑6 Luna をはじめとする OpenAI のモデルです。そして、Terminal X の Eval Agent が、各社の基準に照らしてエージェントの出力を採点します。GPT‑6.1 Sol を使うことで、Eval Agent はファンドの運用方針から逸脱した提案を次点のモデルより約 25% 多く検出できました。また、同じワークフローを実行した際のクエリあたりのコストは、約 30% 低くなりました。
「GPT-6.1 Sol は、長いコンテキストでの推論能力とトークン効率に優れており、より詳細な評価パイプラインを構築できます。これにより、私たちの Eval Agent は投資判断を測定可能かつ監査可能なものにできます」
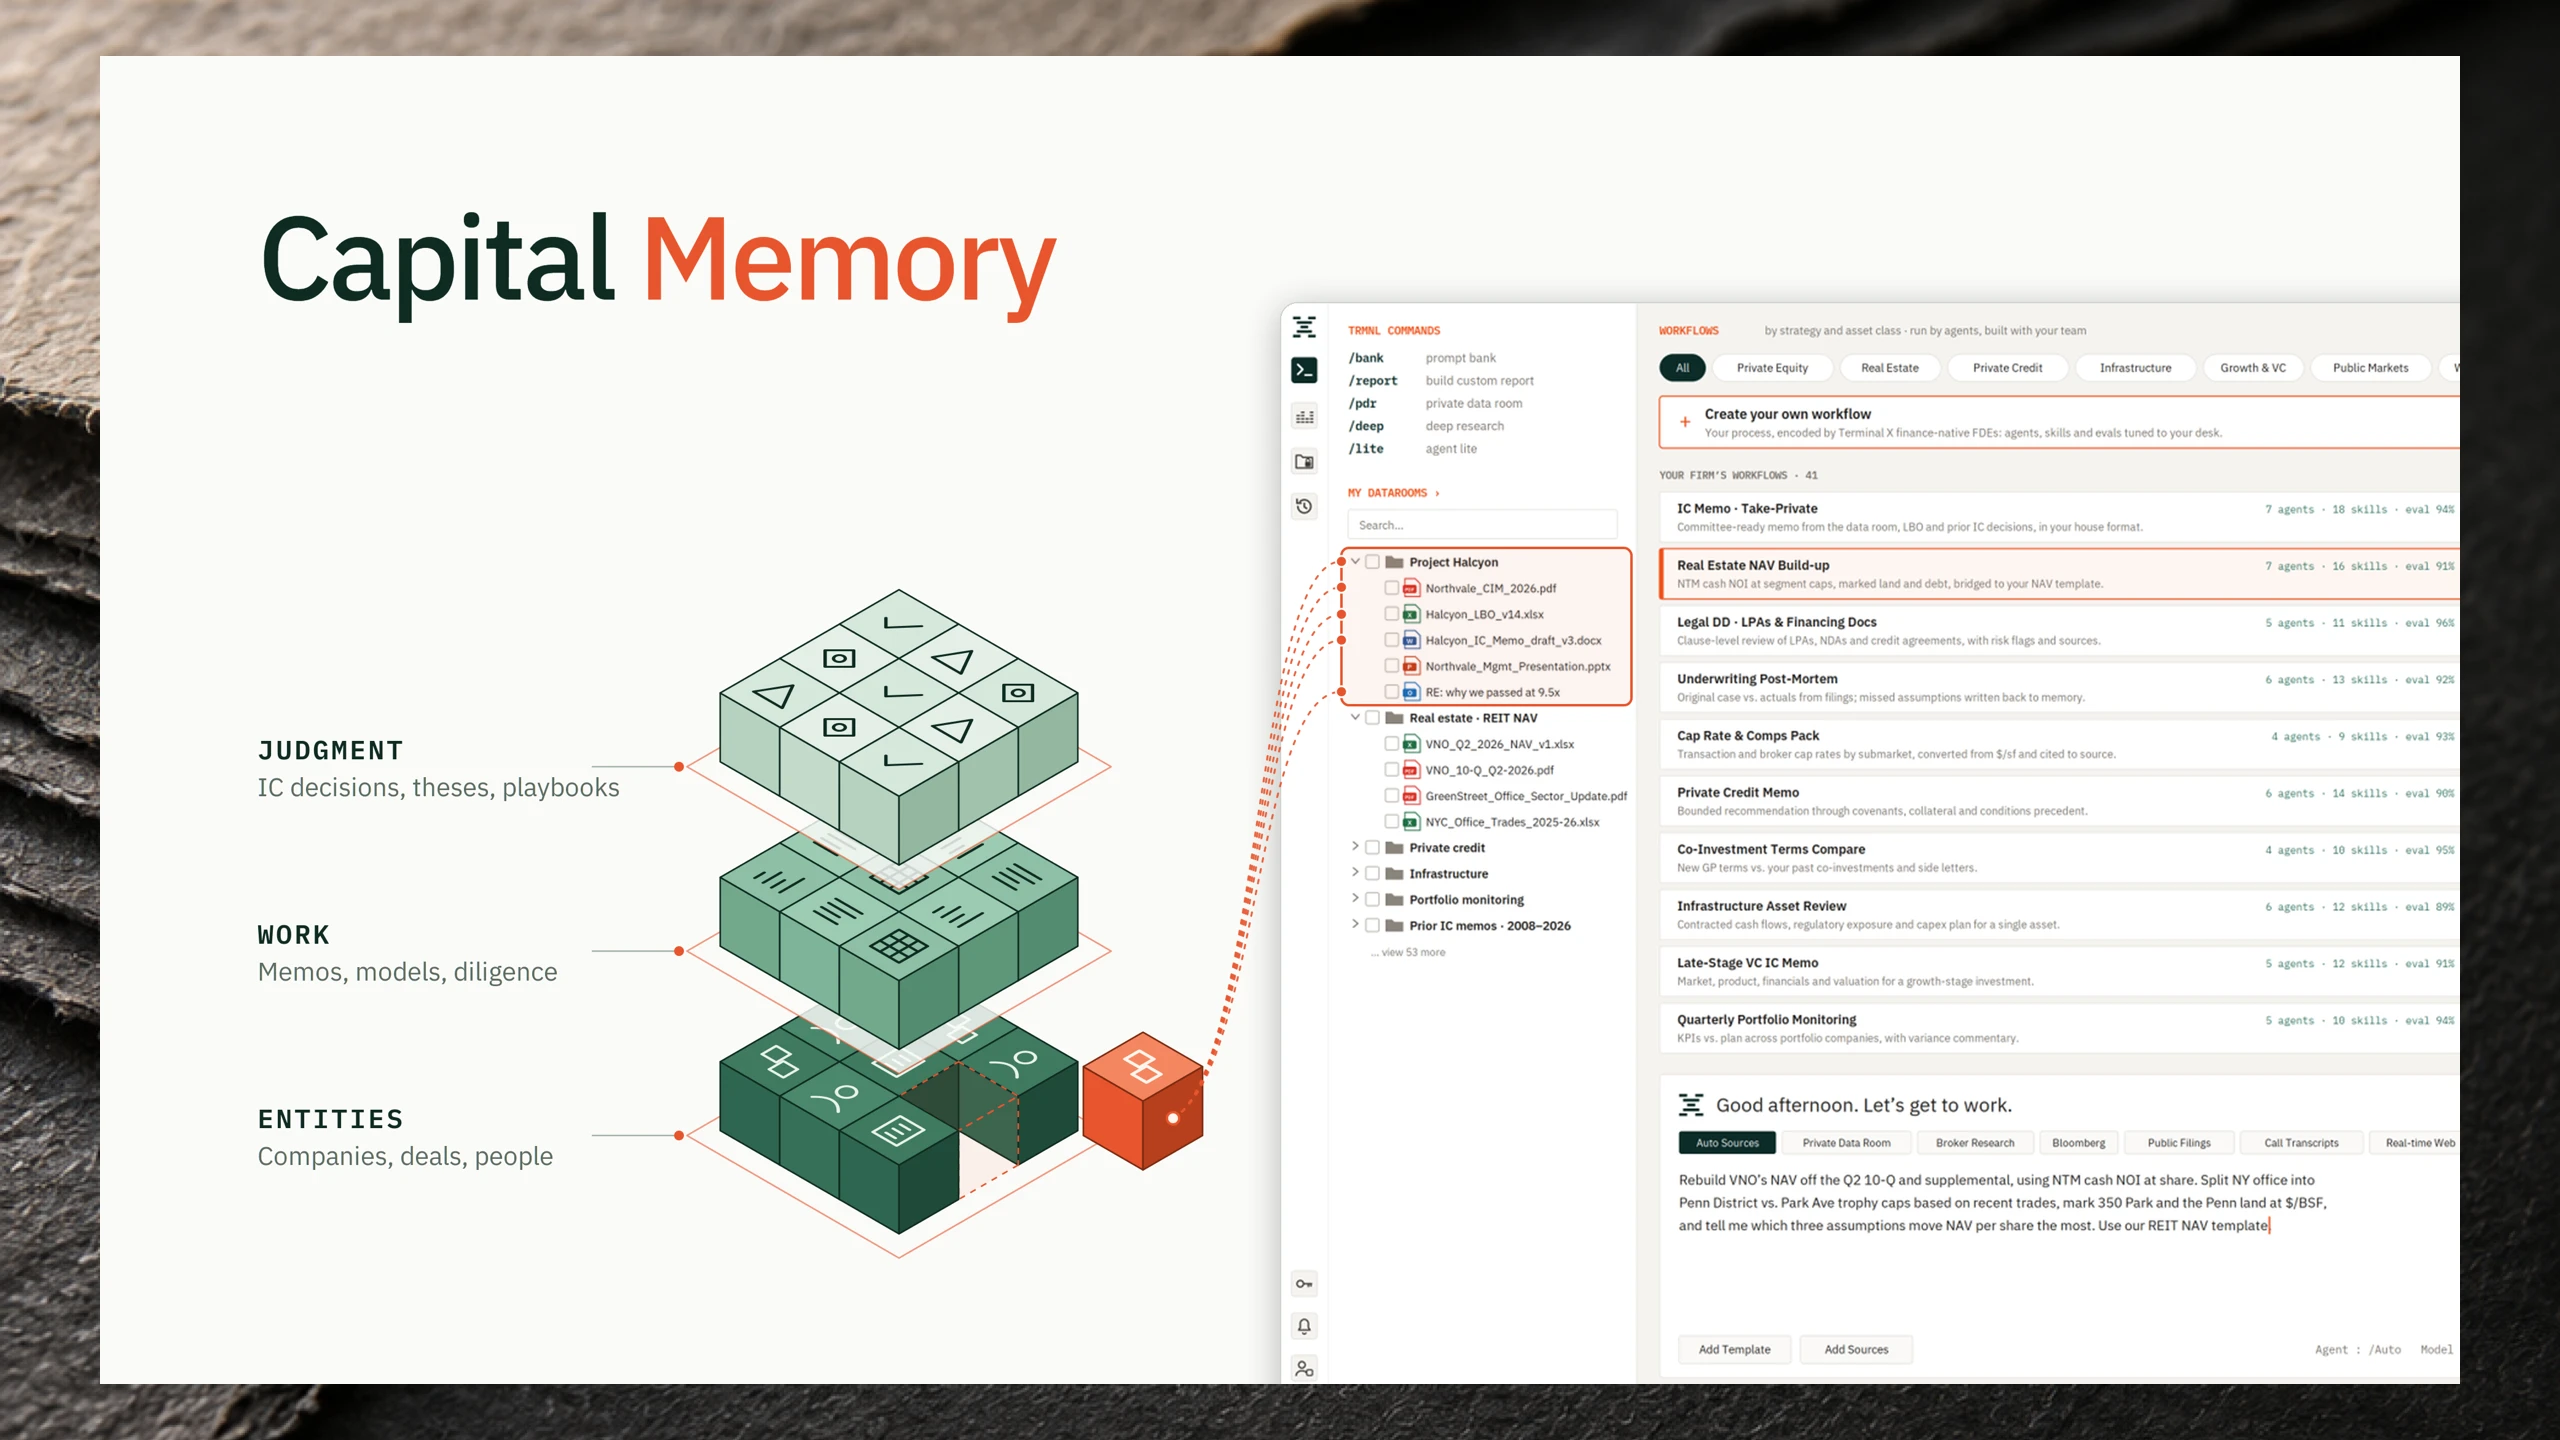
Terminal X は顧客ごとに、その会社の優れた投資家と同じように投資を行うためのエージェントを構築します。Terminal X のエンジニアは数週間にわたって顧客の現場に入り、社内で信頼されている投資メモから作成過程を分析します。同時に、クレジット部門が借り手を審査する方法や、共同投資チームがメモの作成前に参照する情報源など、これまで文書化されていなかったプロセスを把握します。
次に、それらのプロセスを、資産クラスや戦略に合わせてカスタマイズした数百のエージェントに組み込みます。投資の各段階にはサブエージェントを配置します。GPT‑6.1 Sol は、投資仮説の統合、重要な検討事項の特定、自社の運用方針との適合性評価など、判断力と大規模なコンテキストウィンドウが必要な段階を担当します。GPT‑6 Luna は、分析の深さよりもトークン効率が重視される、大量処理が必要なステップを実行します。
エージェントは、各社のプライベートデータルーム内で動作します。これは、機密性の高い投資データを企業が共有・管理するための専用環境です。エージェントは英語、韓国語、日本語、中国語の文書を処理し、学んだ内容をその会社の Memory として保存します。Memory は、ある部門が特定の種類の意思決定をどのように行うかを、バージョン管理した記録です。過去の分析、委員会の決定、ワークフローの指示、自社の投資見解などが含まれます。
エンジニアは各 Memory を、Terminal X のプラットフォーム上で繰り返し実行できるワークフローに変換します。本番環境のすべてのクエリについて、実行したステップ、取得した情報源、使用したモデル、推論過程まで、全履歴をたどって監査できます。
Terminal X によると、このアプローチによって顧客は大幅なコスト削減を実現しています。あるプライベートエクイティ会社は、デューデリジェンスと投資メモのワークフローを自動化したことで、年間換算で 240 万ドルのコストを削減したと報告しています。
Terminal X は、各社独自の基準に照らしてエージェントの回答を検証するために、Eval Agent を構築しました。これは、GPT‑6.1 Sol とその他の OpenAI モデルを連携させたワークフローです。VP がアナリストの成果物を精査するのと同じように、エージェントのすべての出力を読み込むよう設計されています。
Eval Agent は、54 項目の評価基準に照らして各出力をチェックします。たとえば、数値、類似企業の比較データ、市場コンセンサスの数値、引用は、適切な情報源から取得されているでしょうか。論旨に一貫性はあるでしょうか。提案は自社の投資見解に沿っているでしょうか。
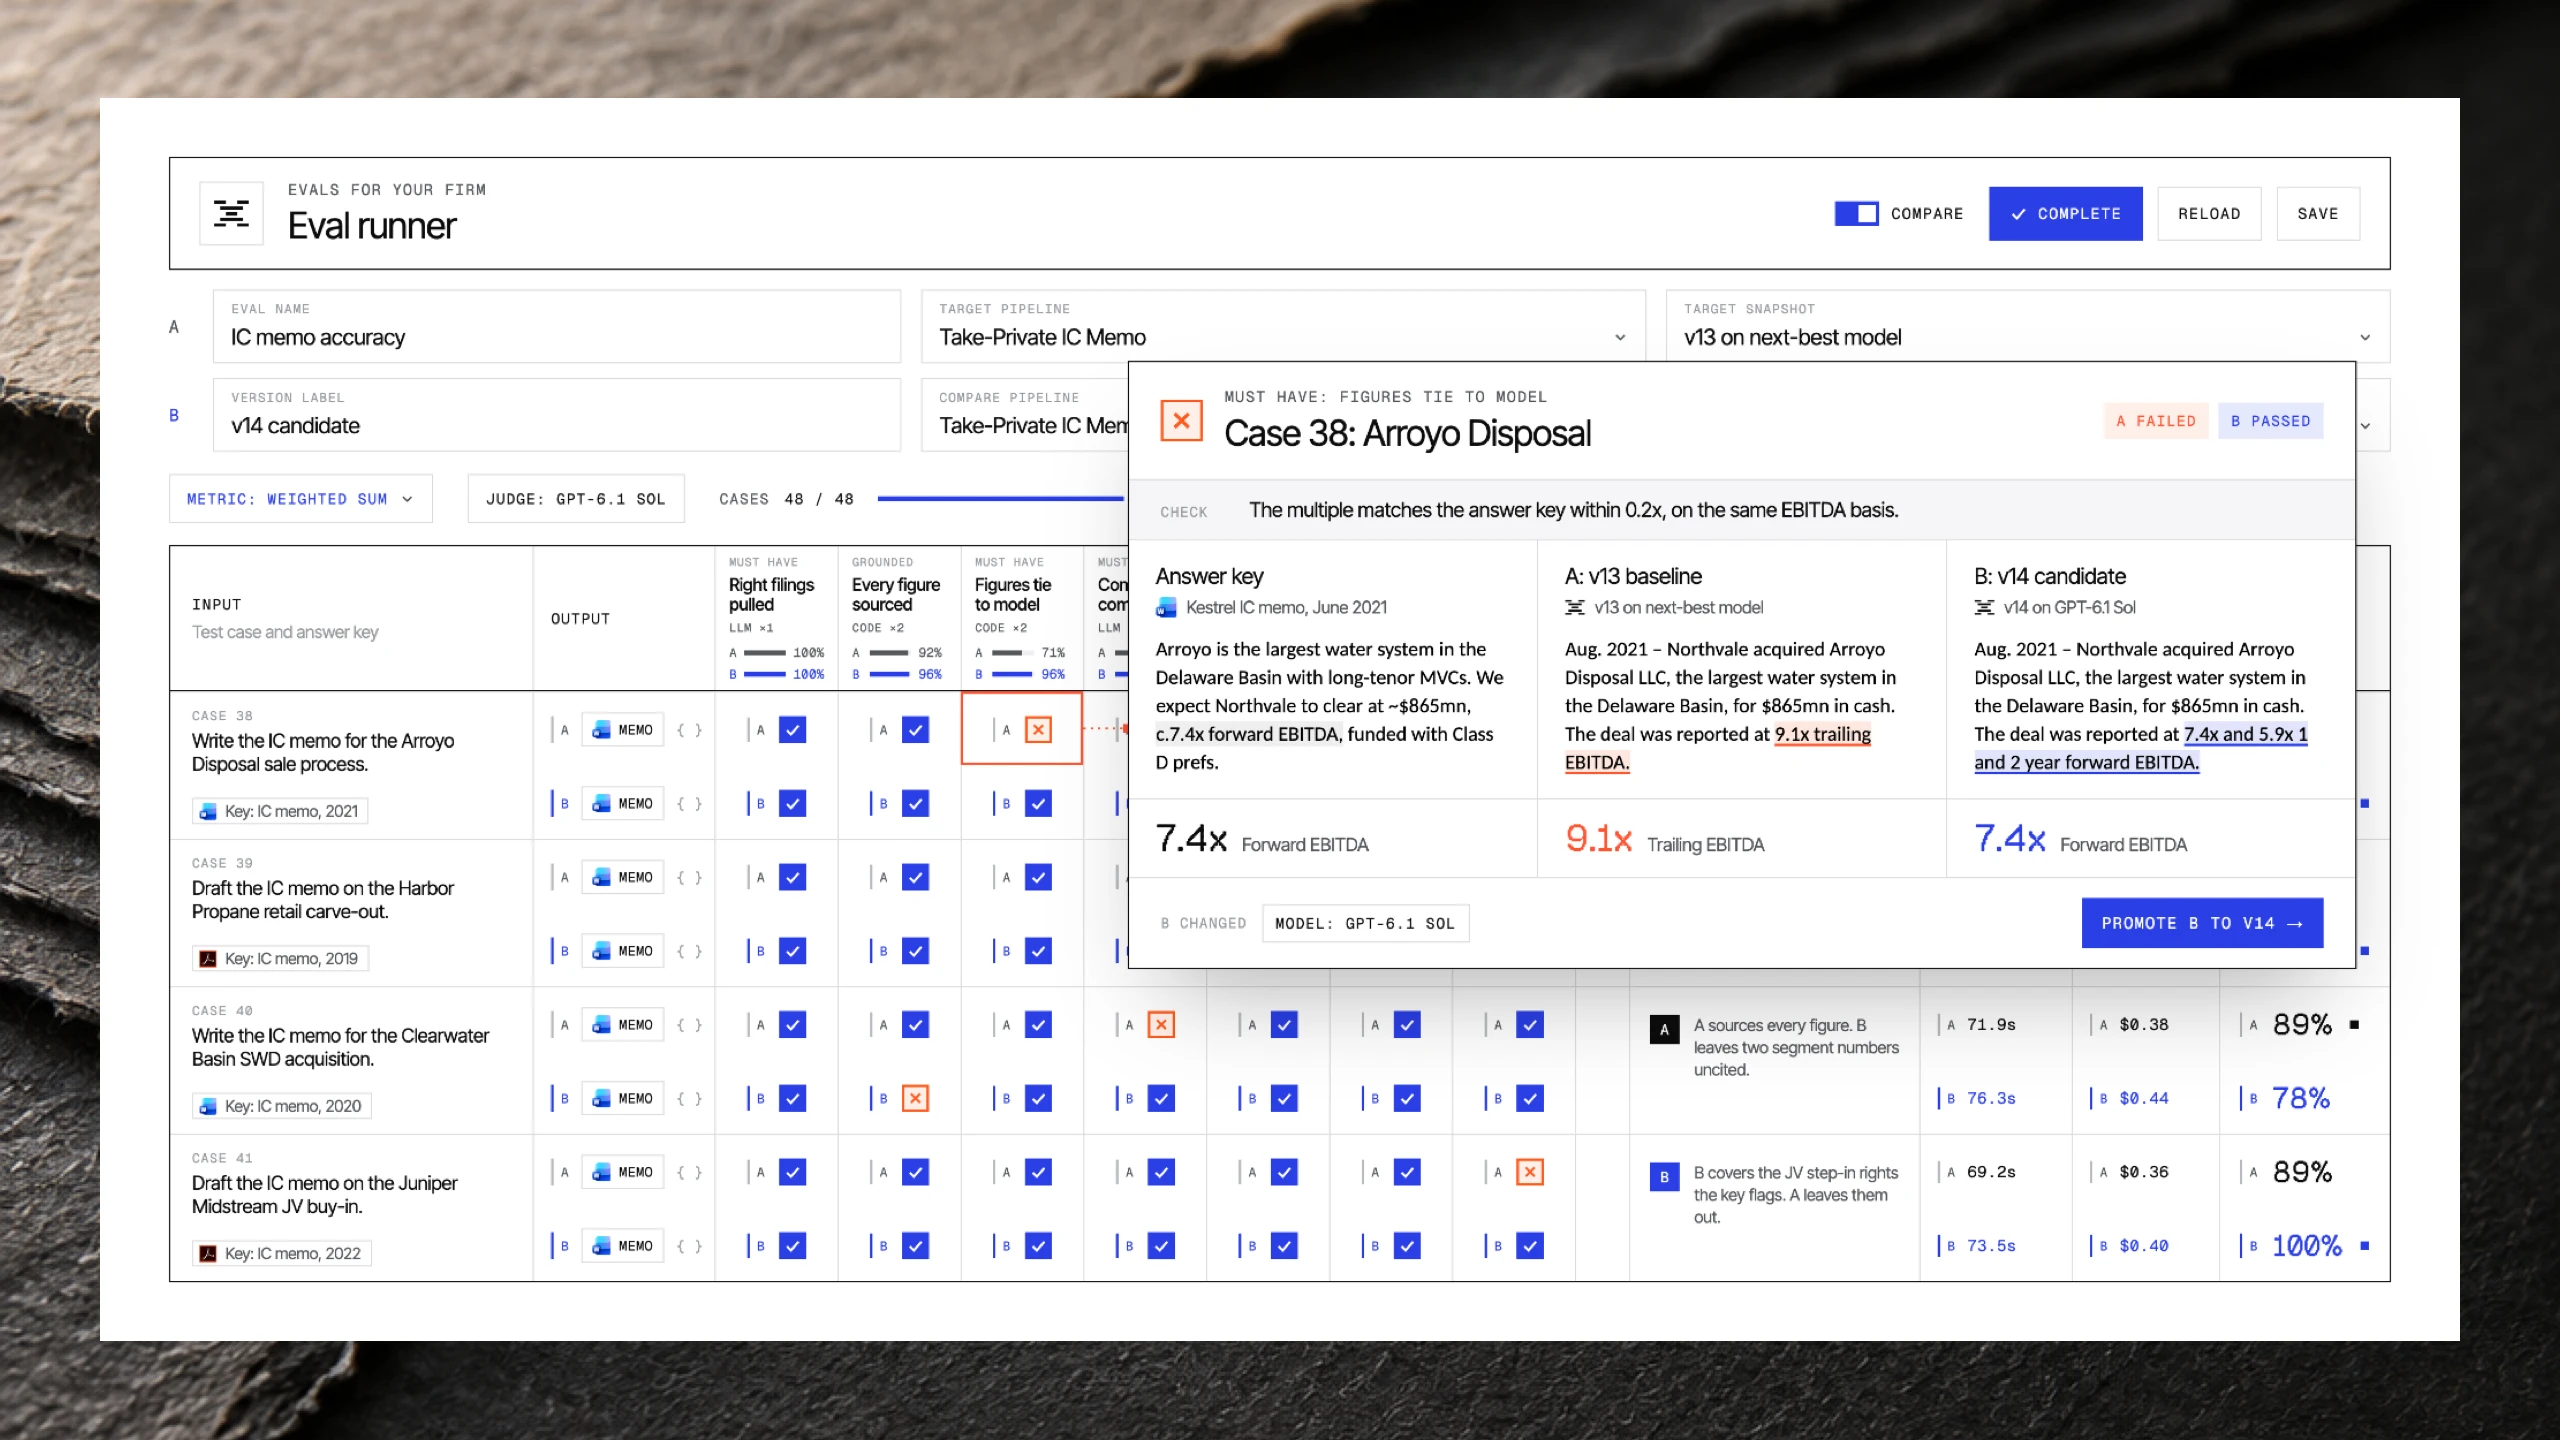
各チェックでは、合格か不合格かを判定します。不合格の項目には必ず、1 行の理由と、より適切な情報源または修正済みの文章が付され、Memory として記録されます。たとえば、情報源の見落とし、比較対象の誤り、自社の投資見解から外れた投資仮説などは、その部門向けの新たなワークフロー指示やテストケースとして組み込まれます。
「すべての回答が評価され、アナリストが修正するたびに、システムはその会社の仕事の進め方を少しずつ学んでいきます」と、Terminal X の共同創業者兼 CTO、Ken Lee 氏は話します。「そのため、使い続けるほど、その会社のチームと同じように考えられるようになるのです」
Terminal X は、独自の評価結果に基づいてモデルを選定しています。採点した 500 件の判断で、GPT‑6.1 Sol を使った Eval Agent と熟練レビュアーの判断の一致率は 88.6% でした。次点のモデルの 86.4% に対し、220 ベーシスポイントの改善です。
GPT‑6.1 Sol が優れた検出性能を示したエラーの一つが、投資スタイルからの逸脱です。たとえば、あるバイアウトファンドの運用方針は、純資産価値(NAV)を下回る価格で取引されている非公開化候補企業を探し、事業を精査して投資判断を行い、資金調達の仕組みを組み立てることだとします。ところが、シナリオモデルが市場の転換を示すと、案件の提案内容がディストレスト債権への投資や救済融資へと変わり始めます。GPT‑6.1 Sol を使った Eval Agent は、こうした逸脱を次点のモデルより約 25% 多く検出しました。
GPT‑6.1 Sol は長いコンテキストを扱う処理でのトークン効率が高く、Terminal X は同じ予算内で、より踏み込んだレビューのワークフローを構築できました。投資仮説は、まずファンドの運用方針に照らして検証され、次に直近の案件と照合されます。判定が不確かな場合は再実行し、エージェントが結果を突き合わせてから報告します。
この詳細なレビューによって、同等のモデルによる 1 回のチェックでは通過していた案件の問題を検出できました。また、GPT‑6.1 Sol は、次点のモデルと同程度の速度を保ちながら、クエリあたりのコストを約 30% 抑えて同じワークフローを実行しました。
Terminal X は、GPT‑6.1 Sol と GPT‑6 Luna を使って企業向けの Memory を 1,700 件構築し、100 万回を超えるカスタムワークフローを実行してきました。週間アクティブユーザー数は、月間アクティブユーザー数の 81% に達しています。
Terminal X の次のステップは、企業の Memory の対象を部門から個人へと広げることです。これにより、投資のプロ一人ひとりの判断基準を、言葉で説明された内容だけでなく、実際の業務での適用のされ方まで含めて記録できるようにします。
Terminal X の共同創業者兼 CEO、Hyun 氏は、そこにこそ意義があると考えています。「今後 10 年間を勝ち抜くのは、自社の判断をデータとして保有する企業です。私たちの仕事は、その判断を測定可能にし、保存、改善、再利用できるようにすることです」