OpenAI で製品改善を 1~2 日で届ける Amplitude の取り組み
主に OpenAI モデルを基盤とする Amplitude の製品エージェント Wave は、自発的に開発すべき改善案を特定し、コーディングエージェントによる実装とリリースを支援して、その効果を測定します。
160%
1 日後のエージェント利用増加率(対照群比)
1~2 日
Wave を使った製品改善のリリースまでの推定所要時間
51%
Amplitude のデータサイエンスエージェント評価における GPT‑6.1 Sol のディスパッチあたりの平均モデルコスト削減率
1.34 ドル
Amplitude の改善機会調査エージェント評価における GPT‑6.1 Sol のモデルコスト
Amplitude はこれまで、ユーザーが製品を実際にどう使っているかをチームが把握できるよう支援してきました。同社の自発的に動く製品エージェント Wave は、そうしたインサイトを実際の改善として届けるまでを支援します。Amplitude によると、Wave の約 80% は GPT‑6.1 Sol、GPT‑6 Luna、GPT‑Image‑2.5 Flare などの OpenAI モデルで動いています。Wave は製品に関するインサイトを、Codex などのコーディングエージェントに渡せる実装計画に変換し、その後、改善の効果を測定します。
Amplitude は、Wave によって製品改善のリリースまでの期間を約 1 か月から 1~2 日に短縮できると見積もっています。 Amplitude 自社のホーム画面では、Wave が提案カードのパーソナライズを支援し、カード経由のメッセージ送信が 160% 増加しました。
「今や AI は、私たちが任せようとさえ思わなかった有益な仕事を自ら見つけられます。OpenAI のモデルは問題を調査し、コードを書いて実行し、その結果を基に次に何を試すかを判断できます。」
Wave は、自発的に動く Amplitude の製品エージェントです。チームは対象となる製品領域と、達成したい目標、改善したい指標を指定します。Wave は Amplitude のデータ、セッションリプレイ、顧客からのフィードバック、コードを組み合わせ、改善機会の特定と優先順位付け、解決策の策定を行い、人とコーディングエージェントによる実装を調整します。その後、成果を追跡し、得られた知見を次の改善に生かします。
このワークフローを支えるために、Amplitude はタスクに応じて OpenAI のモデルを使い分けています。GPT‑6.1 Sol は、改善機会の管理や、コードとデータの詳細な調査を支えています。GPT‑6 Luna は、コードのスキャンや小規模な評価チェックなど、頻度が高く低コストで処理するタスクを担当します。GPT‑Image‑2.5 Flare は、セッションリプレイのスクリーンショットを視覚的な参考資料として、製品のモックアップを生成します。
改善案を実装する準備が整ったら、チームは実装の指針となる技術計画や受け入れ基準とともに、Wave から Codex などのコーディングエージェントに直接送信できます。
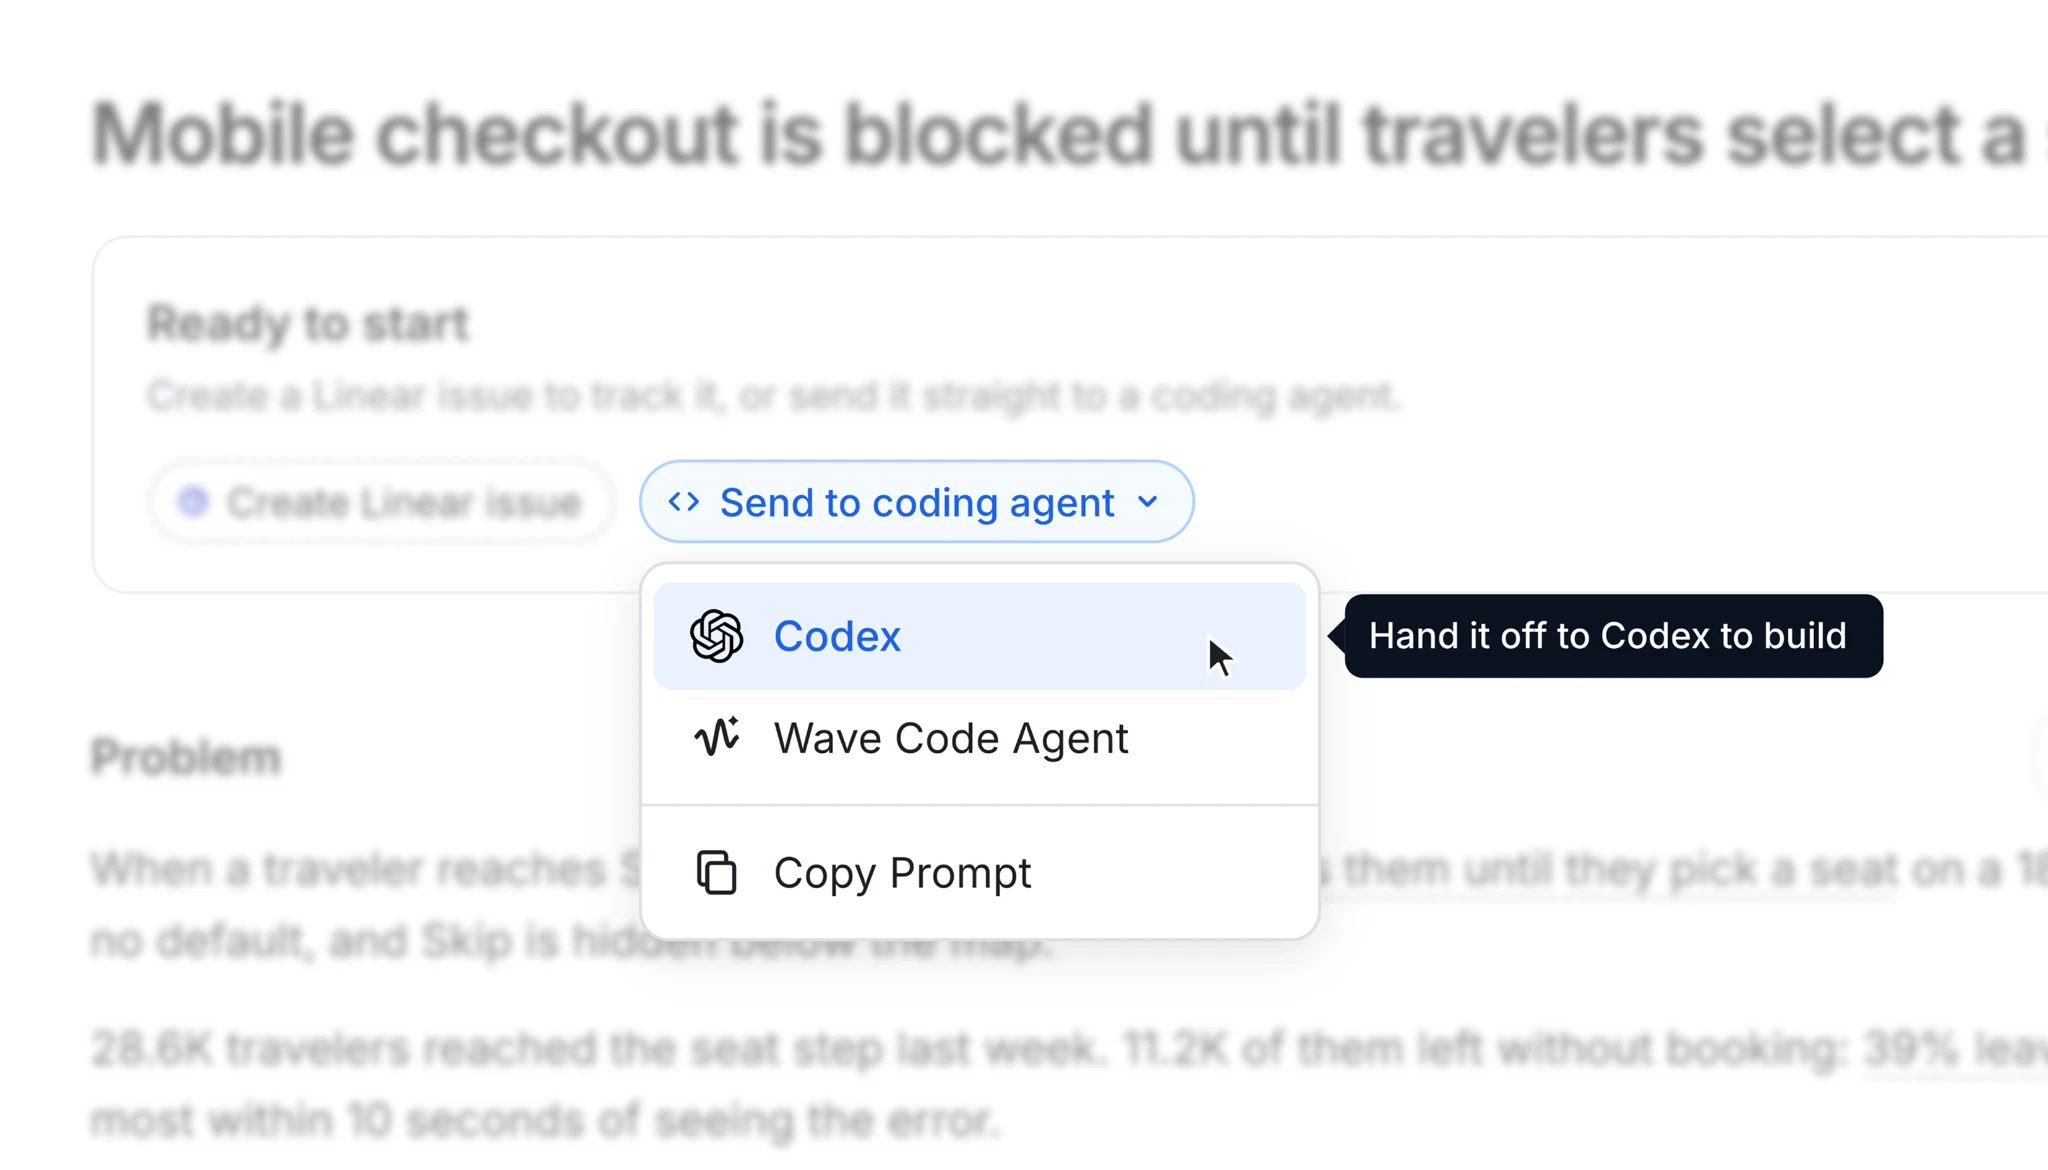
Amplitude のプリンシパル AI プロダクトマネージャー、Jacob Newman 氏は次のように説明します。「Wave の構想は、膨大なセッションリプレイ、分析データ、コードをエージェントがくまなく調べ、製品の改善機会を見つける統合プラットフォームです」
Amplitude は自社のホーム画面で Wave を試しました。この画面には、ユーザーが AI エージェントとの会話を始めやすくするために、汎用的な提案カードが配置されていました。Wave は、そのカードが使われないことが多いと発見しました。100 件のセッションリプレイを調べたところ、80 人が自分で質問を入力し、提案を選んだのはわずか 12 人でした。
Wave は、最近使ったチャートやダッシュボード、ユーザーの遷移元ページを基に、カードをパーソナライズすることを提案しました。変更案を図示するとともに、自由入力を維持することや、パーソナライズに必要な情報がない場合には汎用的な提案を表示することも含めた技術計画を作成しました。チームは簡単にレビューした後、作業をコーディングエージェントに引き継ぎ、変更の A/B テストを実施しました。
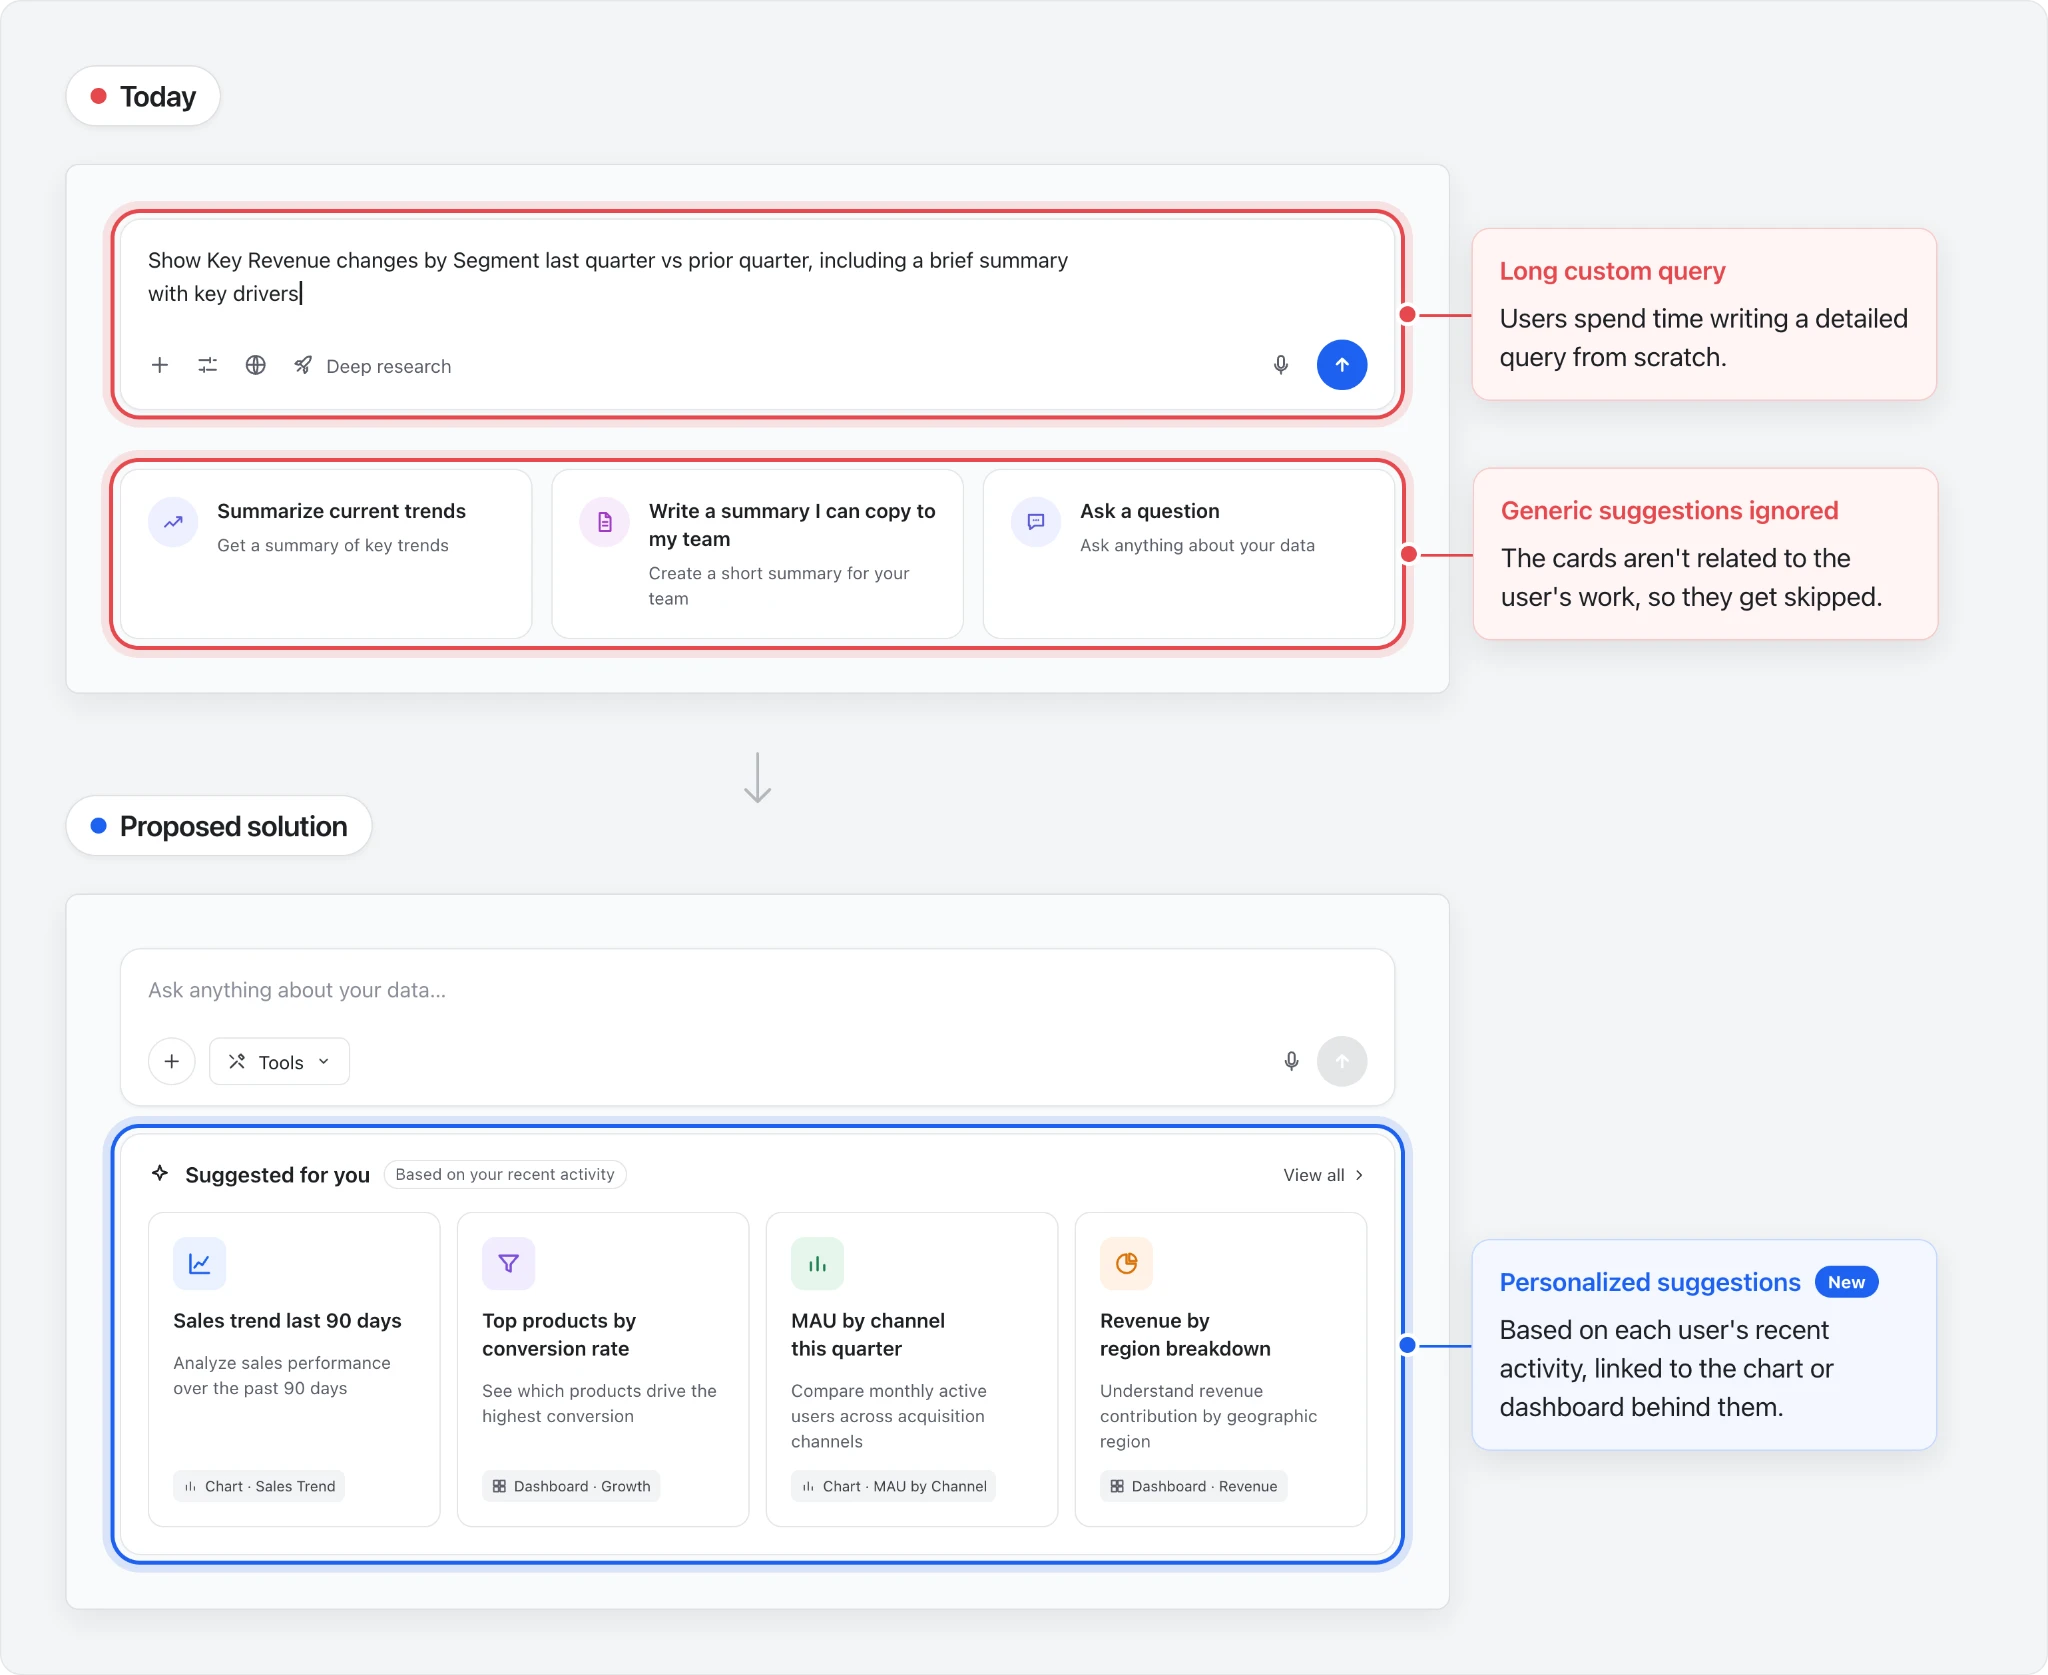
Amplitude が共有した実験結果によると、1 日後にはホーム画面の提案カード経由で送信されたメッセージが、対照群に比べて 160% 増加しました。Amplitude のシニアプリンシパル AI エンジニア、Eric Carlson 氏はこう説明します。「画期的ではないために見過ごされがちな改善でも、思いがけない形で機能の利用を増やせることを示す好例です」
Wave のタスクは、モデルに求める要件がそれぞれ異なります。詳細な調査には、高い推論能力と十分な裏付けのある結論が必要です。何百回も繰り返す小規模なチェックには、速さとコストの低さが求められます。Amplitude はタスクごとに品質、レイテンシ、コストを評価し、それに応じてモデルを割り当てています。
「OpenAI は高性能な推論モデルと、小型で高速なモデルの両方を提供してくれました。そのおかげで、製品全体で品質、レイテンシ、推論コストのバランスを取ることができました」
Wave の改善機会調査エージェントについては、モデルが調査結果の裏付けを取り、偽陽性を避け、評価者のフィードバックを反映し、ツール障害から復旧し、証拠に見合った主張を維持できるかを Amplitude が評価しました。GPT‑6.1 Sol の総合スコアは 5 点満点中 4.06 点で、比較対象の 3 モデルはそれぞれ 3.62 点、3.52 点、2.94 点でした。GPT‑6.1 Sol は調査に関する 5 つの評価基準すべてでトップに立ち、調査時間の中央値も 54 分と最短でした。
Wave のデータサイエンスエージェントを対象とした別の評価では、GPT‑6.1 Sol のスコアは 100 点満点中 67.5 点で、比較した有力モデルは 69.3 点でした。一方、ディスパッチあたりの平均モデルコストは、比較モデルの 2.63 ドルに対して 1.28 ドルでした。GPT‑6.1 Sol は、ツールの入出力仕様の遵守、推定と不確実性の扱い、証拠に基づくグラウンディングでも、より高いスコアを獲得しました。
コードのスキャンや小規模な評価チェックなど、大量に発生する作業には、Amplitude は GPT‑6 Luna を使ってレイテンシとコストを抑えています。専門エージェント間で作業を分担することで、コストの高い推論を、それが最も必要なタスクに集中できます。
ワイヤーフレームやモックアップの生成では、解決策のワイヤーフレームに対する評価で、OpenAI の画像生成モデルが 100 点満点中 80.3 点を獲得し、比較対象の画像生成モデルは 63.9 点でした。Amplitude は 15 件の改善機会を対象に、情報の伝わりやすさ、製品の再現性、指示への準拠、テキストと UI の読みやすさ、視覚的な一貫性を評価しました。
さまざまな業界の顧客が、すでにベータ版の Wave を使って製品の改善点を特定し、リリースしています。Wave はセッションデータと分析データを調べ、修正案、技術計画、受け入れ基準を含む提案を作成します。
その先をどこまで自動化するかは、チームが決められます。多くのチームは、バグ修正をコーディングエージェントに直接任せる一方、新機能や大きな挑戦を伴う施策は人がレビューしています。
リリースに至った変更では、発見から実行までの期間が短い場合もあります。顧客が公開した実験、フラグ、ガイドのうち、4 分の 1 は Wave が改善機会を発見した当日に、半数は 4 日未満で、3 分の 2 は 1 週間以内に公開されました。
提供された節目のデータを補間しています。曲線は例示であり、個別の観測値を示すものではありません。
Skates 氏は、「OpenAI とともに目指しているのは、自ら改善する製品を、企業のソフトウェア開発の標準にすることです」と語ります。OpenAI のモデルの推論能力とコーディング能力が向上するにつれて、チームはより多くの調査や実装作業をエージェントに任せられるようになります。その結果、より優れた製品を、より早くユーザーに届けられるようになります。Amplitude はすでにその変化を実感しています。チームがほかの優先課題に取り組む間も、エージェントが自社製品の改善点を見つけ、その実現を支援しています。「ソフトウェアがチームとともに製品の改善に取り組むようになれば、どれほど多くのことを達成できるか、チーム自身も驚くと思います」