Le rôle d’ingénieur déployé sur le terrain chez OpenAI
Notre rôle, nos méthodes et notre façon de résoudre les défis les plus complexes des entreprises pour avoir un impact concret.
Par : Colin Jarvis, responsable de l’ingénierie déployée sur le terrain chez OpenAI
À la sortie de Codex, quelqu’un dans l’équipe m’a demandé : « Que faisons-nous quand Codex peut simplement réaliser en une seule étape les cas d’utilisation que nous avons passé les derniers mois à développer? »
Cette question touche au cœur du rôle d’ingénieur déployé sur le terrain chez OpenAI. Nous travaillons aux côtés des clients pour comprendre leurs problèmes les plus difficiles et créer des solutions sur lesquelles ils peuvent compter. Ce que nous apprenons contribue à façonner nos produits et donne à l’équipe de recherche des problèmes concrets à résoudre.
C’est cela, le progrès. Si nous nous rendons obsolètes tous les deux ou trois mois, notre équipe d’ingénieurs déployés sur le terrain fait son travail.
J’ai fondé l’équipe au début de 2025 pour combler ce que nous appelons « l’écart de déploiement » : la distance entre ce dont les modèles semblent capables et ce que les gens peuvent utiliser de façon fiable dans leur travail.
Les capacités des modèles ont évolué plus vite que les systèmes et les processus nécessaires pour les mettre à profit. Parfois, la pièce manquante est un produit. Parfois, un modèle réussit bien un test de référence, mais ne peut pas accomplir le travail avec les variables et les contraintes du monde réel.
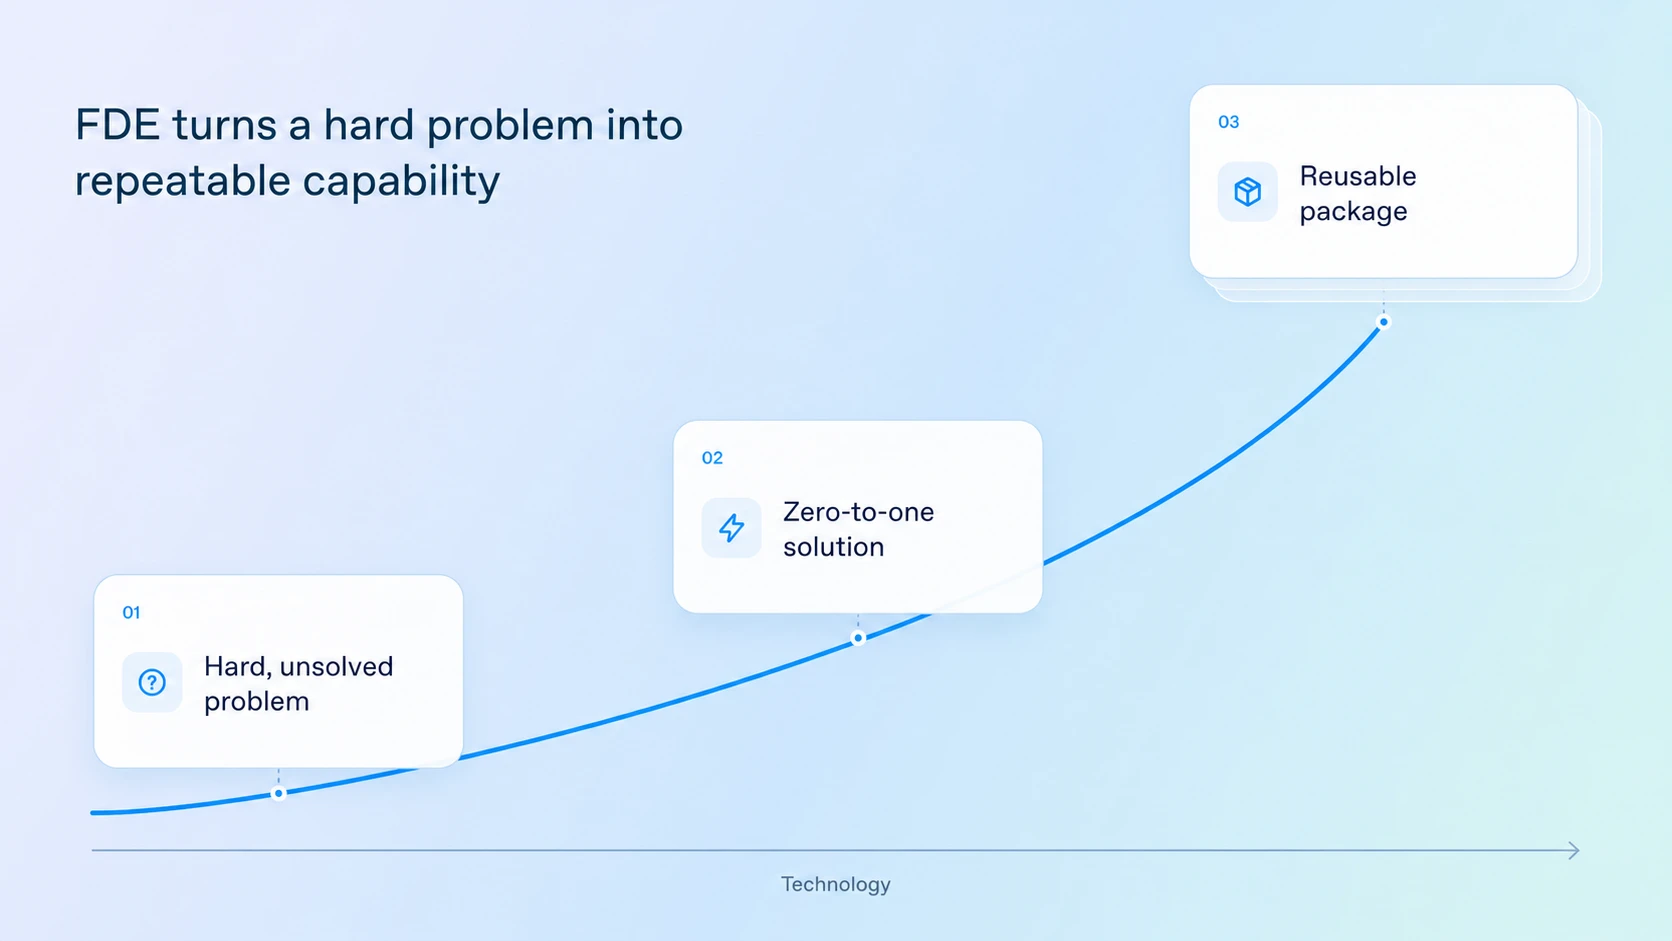
Nous nous concentrons sur les problèmes les plus difficiles de nos clients. Là où nos modèles peuvent déjà accomplir le travail, nous collaborons avec l’équipe produit et notre client pour rendre la solution reproductible. Là où ils montrent leurs limites, nous travaillons avec les clients et l’équipe de recherche pour cerner l’écart et apporter des améliorations. Notre objectif est que chaque mandat offre au client suivant un meilleur point de départ. Si nous relevons le niveau de base au point où nos clients n’ont plus besoin d’ingénieurs déployés sur le terrain pour résoudre ce type de problème la prochaine fois, nous avons bien fait notre travail.
Pour John Deere, une entreprise agricole vieille de 200 ans, le défi consistait à offrir des conseils personnalisés aux agriculteurs à grande échelle.
See & Spray en est un exemple : cette technologie de désherbage de précision utilise des caméras et l’apprentissage automatique pour repérer et pulvériser les mauvaises herbes plutôt que de traiter des champs entiers, réduisant ainsi l’utilisation de produits chimiques jusqu’à 70 %.
Mais pour profiter de ces avantages, les agriculteurs doivent savoir comment configurer la technologie, planifier leur saison et adapter leurs pratiques à l’évolution des conditions.
John Deere a déployé les API d’OpenAI pour offrir ce soutien de façon personnalisée et à grande échelle.
L’IA peut répondre aux questions des agriculteurs en langage naturel, fournir des conseils de configuration et des recommandations sur mesure, repérer les situations où l’équipement n’atteint pas son plein potentiel et aider les agriculteurs à comprendre la valeur qu’ils tirent de la technologie.
Le potentiel va au-delà d’une interaction isolée : il s’agit d’offrir des conseils pertinents tout au long du parcours client, pour aider les agriculteurs à mieux utiliser leur équipement tout en améliorant l’efficacité et la durabilité.
C’est le genre de défi que les ingénieurs déployés sur le terrain d’OpenAI s’efforcent de relever : aider les organisations à transformer les capacités de l’IA en systèmes qui apportent une valeur concrète dans des environnements réels et complexes.
Mais les problèmes sont souvent très ouverts, il n’existe pas toujours de vérité de référence établie, ni de marche à suivre. Tout le monde veut créer quelque chose qui n’a jamais existé. Moins de gens veulent faire le nécessaire pour y arriver.
Trouver des ingénieurs déployés sur le terrain talentueux tout en relevant le seuil du « suffisamment bon » a exigé une expérimentation et une mise en pratique constantes.
Au début de chaque séance de l’équipe d’ingénieurs déployés sur le terrain, j’affiche une diapositive présentant une valeur fondamentale : « Commencez par le résultat visé, faites le nécessaire pour réussir, puis passez à l’échelle ».
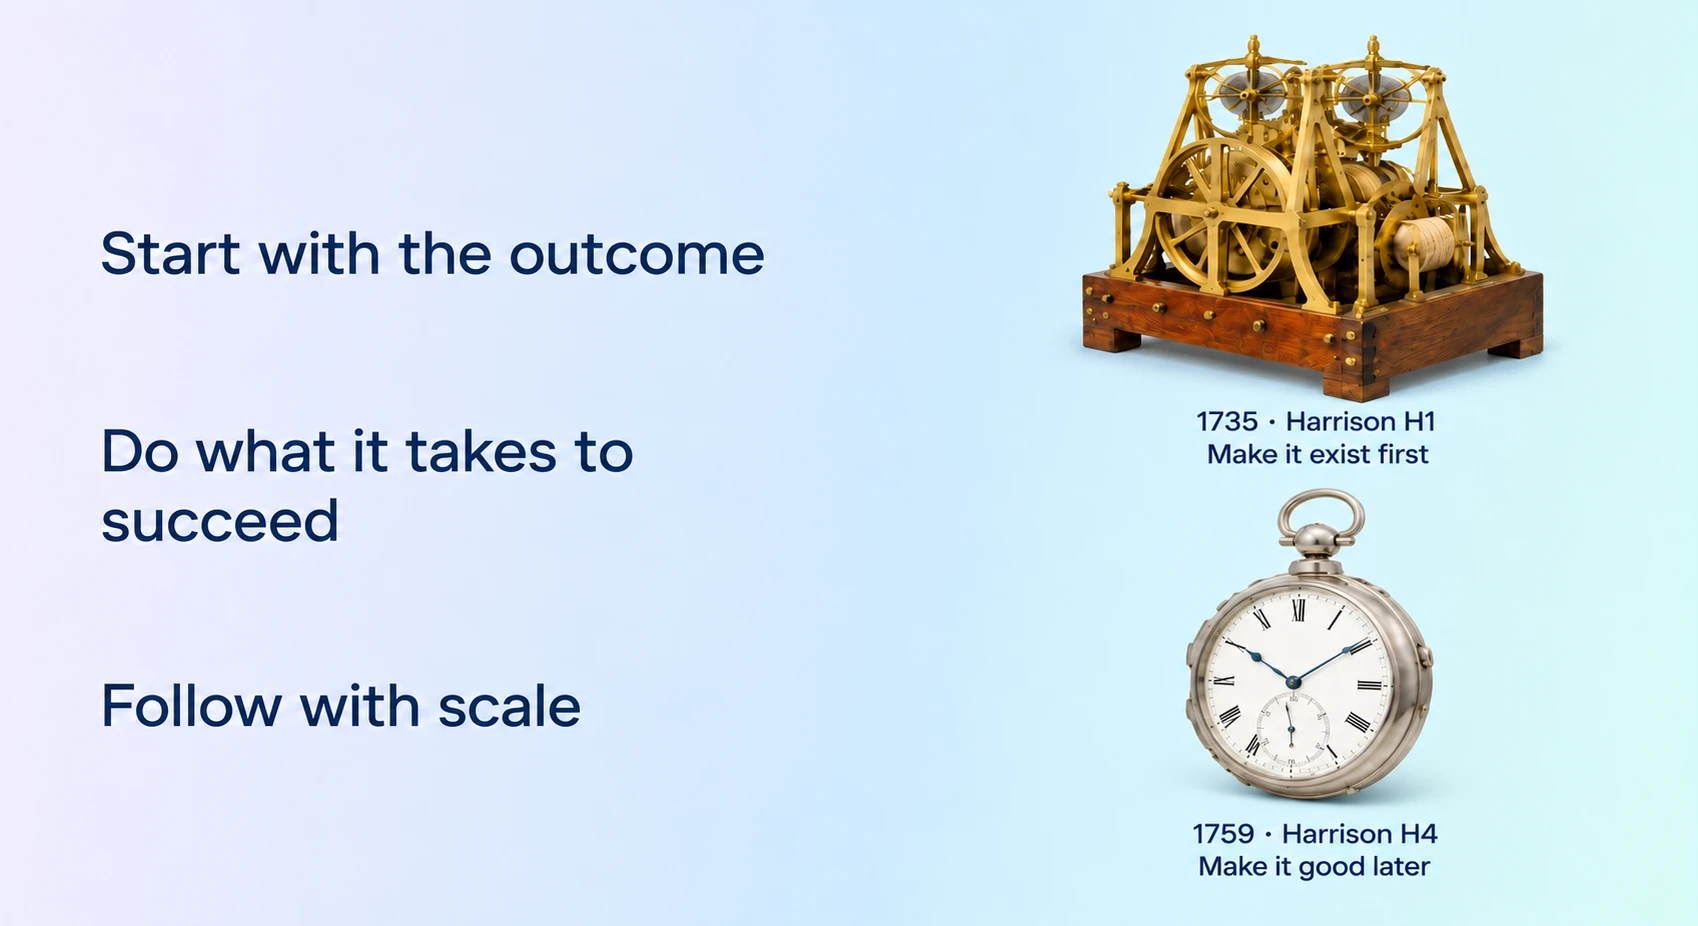
Une démonstration impressionnante peut aller loin avant que quelqu’un demande si elle fonctionne dans le monde réel.
Notre travail consiste à résoudre le problème du client avec un niveau de qualité que nous pouvons assumer en production.
Au milieu de 2025, une quinzaine de nos ingénieurs déployés sur le terrain travaillaient avec un important client du secteur des semi-conducteurs sur plus de 10 cas d’utilisation. L’ambition était de faire de l’IA le fondement de son processus de vérification, notamment pour :
La génération de tests ciblés
L’analyse des causes profondes et le débogage
Un assistant en architecture
La vérification peut représenter environ 70 % du travail consacré à un projet dans ce secteur. Le potentiel était énorme, et les points de départ possibles étaient nombreux.
Certains ingénieurs déployés sur le terrain avaient rejoint OpenAI quelques jours auparavant et n’avaient jamais travaillé dans le secteur des semi-conducteurs. Ils se sont intégrés à l’équipe de vérification du client, ont étudié la conception de puces dans leurs temps libres et ont créé des évaluations avec les ingénieurs pour vérifier si l’IA pouvait générer des tests utiles et diagnostiquer correctement les défaillances des puces.
Parallèlement à cet apprentissage, nous avons construit des harnais sur mesure pour chaque cas d’utilisation. Au cours des trois à six premiers mois, tous ont été mis en production et adoptés par leurs premiers utilisateurs. Les résultats chiffrés ont récompensé ces efforts :
Environ 48 % de temps économisé grâce à la génération de tests ciblés par l’IA.
Une amélioration médiane des performances de 22 % grâce à l’optimisation des noyaux.
Des semaines de débogage réduites à quelques heures
Lorsque nous avons présenté l’ensemble de ces résultats, le directeur du matériel a demandé : « Aviez-vous travaillé comme concepteurs de puces avant d’arriver ici? »
Nos ingénieurs déployés sur le terrain n’ont pas besoin de connaître le secteur dès le premier jour, mais il leur incombe de l’apprendre.
À mesure que les assistants de programmation accélèrent le développement logiciel, comprendre les activités du client devient encore plus important. Nous formons des équipes qui réunissent des généralistes et des experts du domaine.
Il faut assez de connaissances pour exercer un jugement sûr, et assez de curiosité pour remettre en question les idées reçues sur le statu quo.
Dans les sciences de la vie, par exemple, la formation scientifique de nos ingénieurs déployés sur le terrain les aide à gagner la confiance des chercheurs qui travaillent à la découverte préclinique de médicaments, notamment à la validation et à la priorisation des cibles, à l’analyse de l’expression génique et à la reconstitution des voies de synthèse chimique. Cette expertise leur permet de porter un jugement éclairé sur la façon d’améliorer ces flux de travail.
Nous avions démontré que ces flux de travail pouvaient apporter de la valeur, mais chacun exigeait encore trop d’intégration sur mesure pour être étendu à une autre équipe. Le défi suivant consistait à préserver ces résultats tout en rendant le logiciel plus facile à déployer et à maintenir.
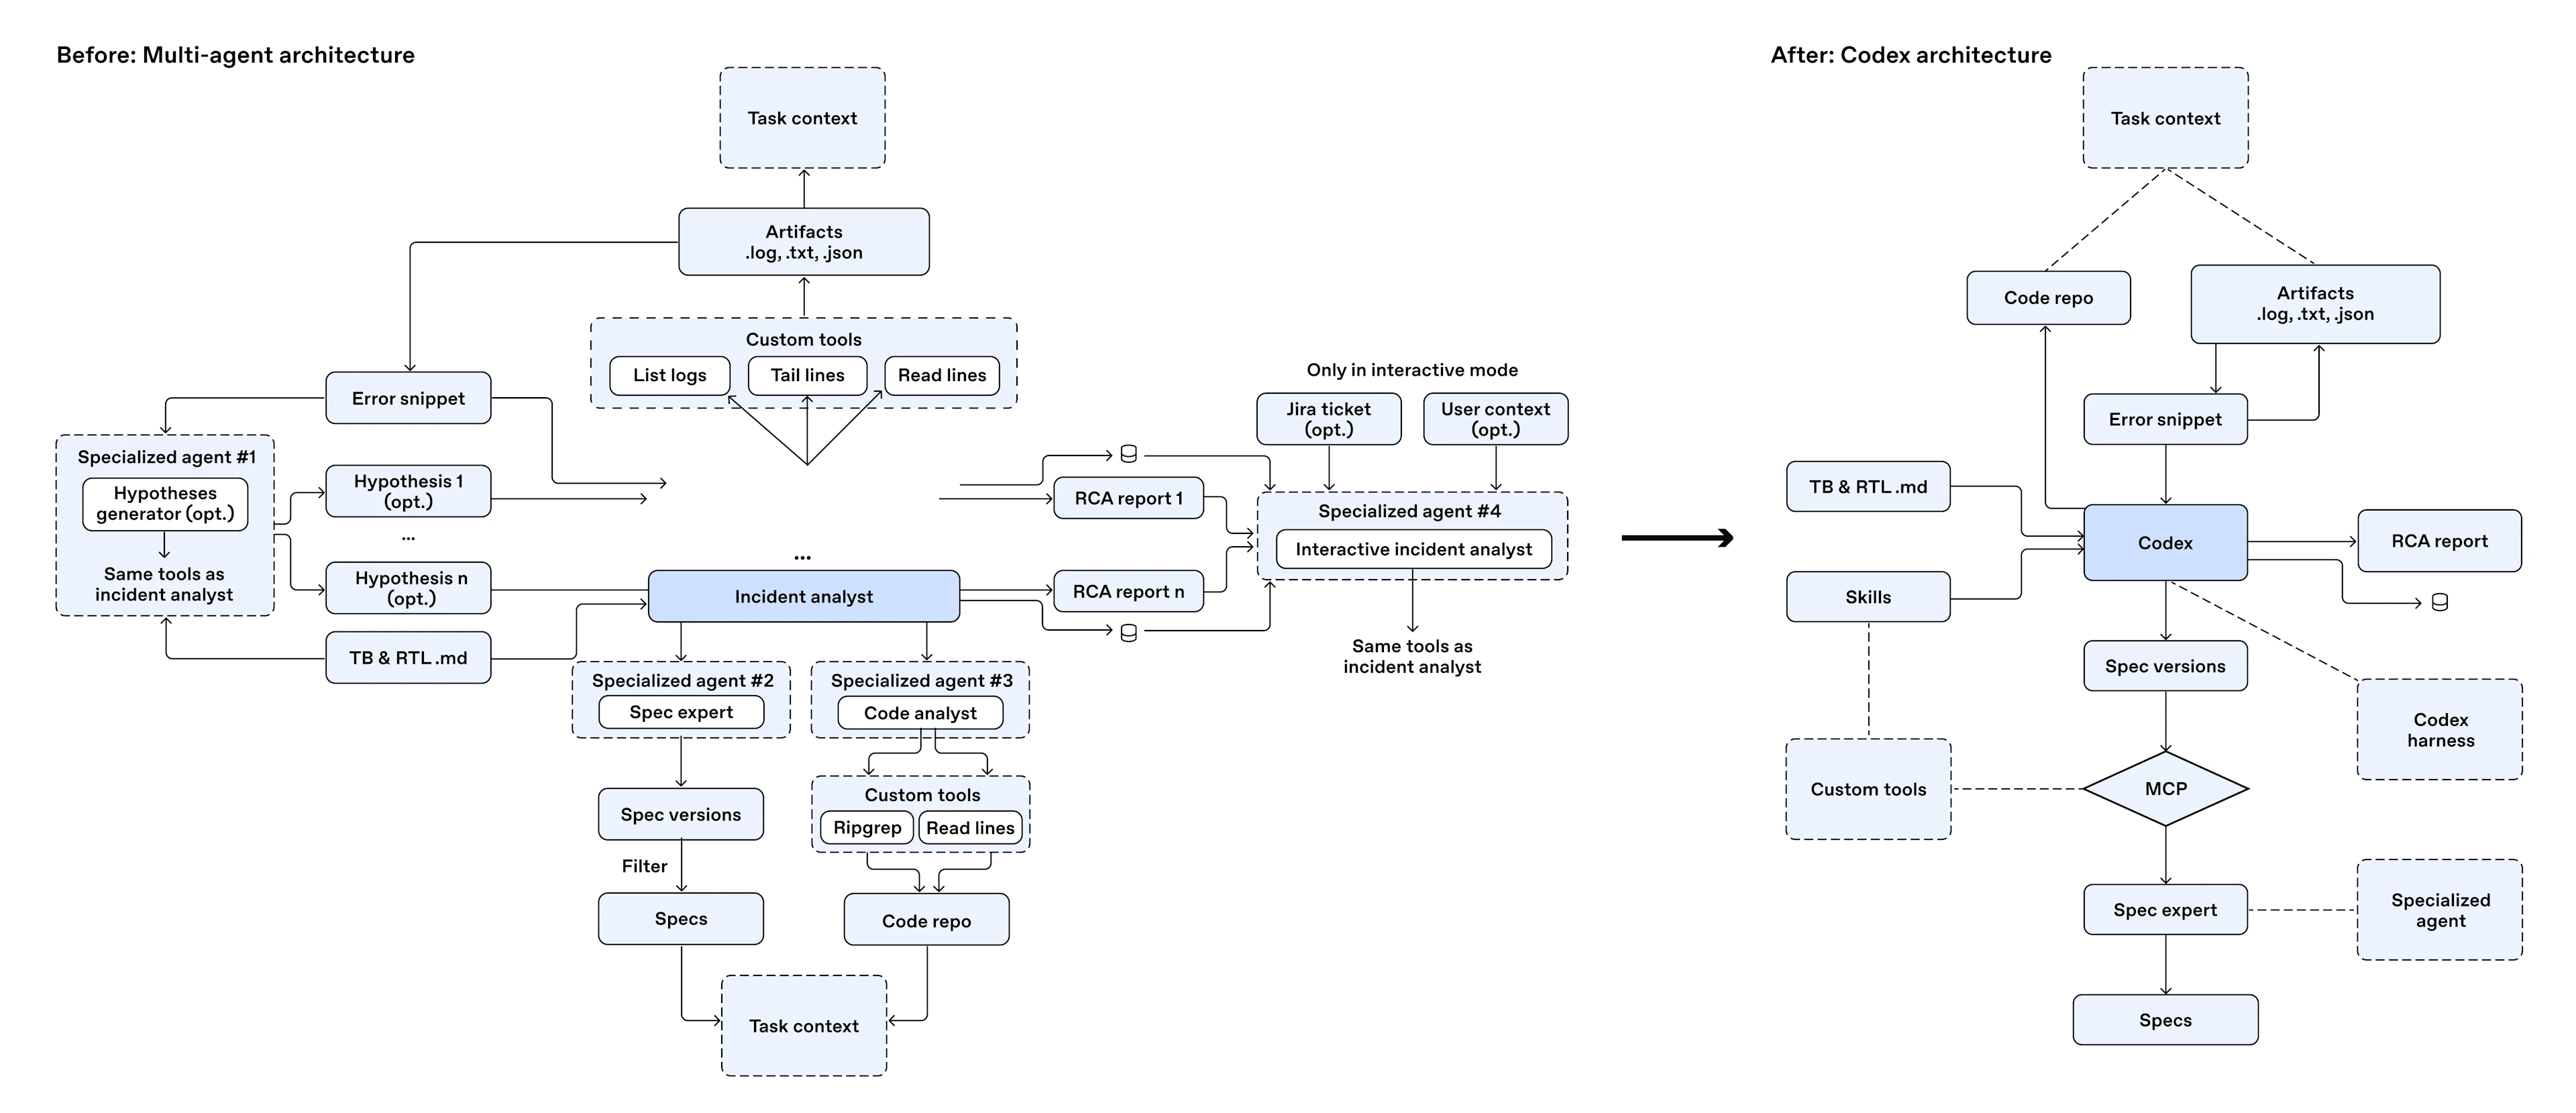
Entre-temps, les capacités de Codex s’étaient accrues. Un ingénieur déployé sur le terrain a essayé de reconstruire son application autour de Codex, puis a travaillé avec l’équipe pour transférer les cas d’utilisation vers un harnais commun centré sur Codex.
Les applications sur mesure sont devenues des modules d’extension et des compétences reposant sur des primitives communes de Codex. Codex est aussi devenu l’interface, ce qui nous a permis de retirer les interfaces de terminal et de ligne de commande distinctes que nous avions créées pour chaque cas d’utilisation.
Nous avons pu supprimer environ 90 % du code sur mesure de chaque projet, ce qui a changé notre façon de créer, de maintenir et de déployer ces flux de travail à grande échelle :
Nous pouvions profiter des améliorations centralisées de Codex, réduisant ainsi la quantité de code de liaison nécessaire pour chaque cas d’utilisation
Les fonctionnalités clés étaient regroupées en compétences et en modules d’extension, ce qui facilitait leur partage entre équipes et leur contrôle centralisé par le centre d’excellence en IA. Ainsi, pour étendre la solution d’une équipe à l’autre, il pouvait suffire de remplacer les connecteurs ou les serveurs MCP, de créer de nouvelles évaluations (nous avions aussi une compétence pour cela) et de démarrer.
Dans un exemple datant d’août 2026, le déploiement initial a pris deux mois. Étendre la solution à une deuxième équipe a pris une journée. Les équipes suivantes ont été intégrées plus rapidement à mesure que nous passions à l’échelle. Cette tendance s’est maintenue : en août 2026, un cas d’utilisation a demandé une journée pour la deuxième équipe, après un déploiement initial de deux mois.
C’est une façon de nous rendre nous-mêmes obsolètes. Le travail accompli pour atteindre la production avait établi ce qui comptait. À mesure que le produit sous-jacent s’améliorait, nous pouvions remplacer une grande partie de notre mise en œuvre sur mesure tout en préservant la valeur qu’elle apportait.
Voilà pourquoi l’ordre compte. Les LLM nous permettent de construire rapidement. Utilisez cette rapidité pour mettre quelque chose d’utile entre les mains des utilisateurs, découvrir ce qui tient la route en pratique, puis déployer à grande échelle ce qui fonctionne.
Le même principe s’applique à tous les mandats.
OpenAI Presence, notre produit pour les agents vocaux et de clavardage d’entreprise, est né de véritables déploiements clients. Le travail a commencé avec Swarm(s'ouvre dans une nouvelle fenêtre) et a évolué avec l’Agents API, et aujourd’hui un client gère maintenant plus de la moitié de ses appels grâce à l’IA.
Mettre ces déploiements en production nous a appris quels problèmes nécessitaient une solution personnalisée et quels blocs de construction d’autres équipes pouvaient utiliser. Nous avons intégré ces éléments de base à Presence, facilitant ainsi l’automatisation des flux de travail réglementés par les développeurs sans reconstruire l’infrastructure sous-jacente. Chaque déploiement a contribué à façonner le produit et a offert au client suivant un meilleur point de départ.
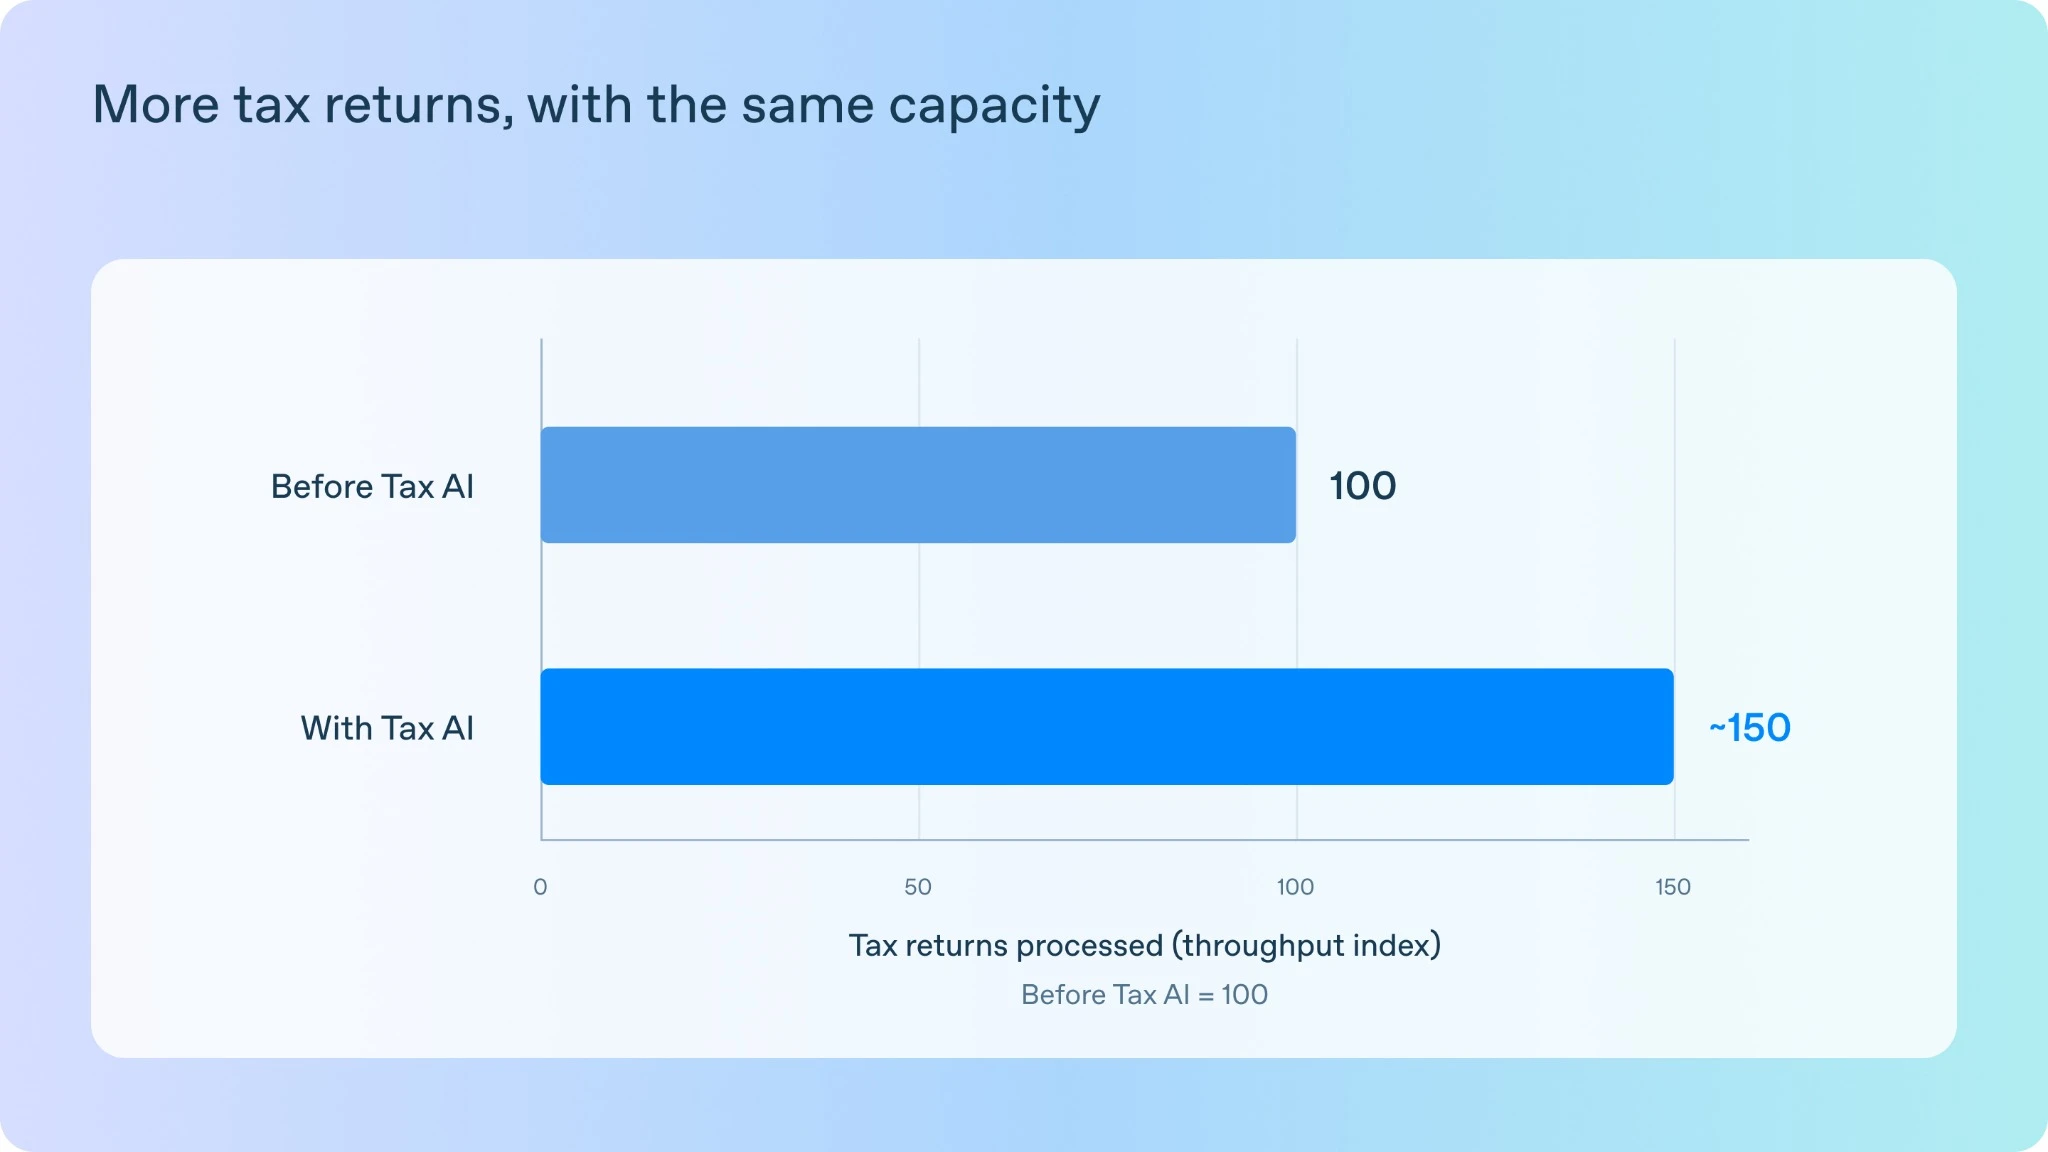
Avec Thrive Holdings,les FDE d’OpenAI et des chercheurs ont collaboré avec des ingénieurs et des comptables pour développer Tax AI pour les cabinets comptables de Crete. Au cours de son projet pilote, Tax AI a traité 7 000 déclarations de revenus et a augmenté le débit d’environ 50%.
L’un des défis les plus difficiles a été d’automatiser les déclarations fiscales relatives aux immeubles locatifs, ce qui a nécessité six semaines d’ingénierie et d’examen par les praticiens pour atteindre une précision et un rappel de 90 %. Ce travail a créé des schémas réutilisables qui ont facilité l’extension de Tax AI à d’autres annexes fiscales complexes.
Les équipes appliquent maintenant la même approche à la tenue de livres, à l’audit et au soutien informatique — construisant des systèmes qui s’améliorent grâce à la rétroaction des praticiens et à l’utilisation concrète.
Parfois, un meilleur produit nous permet de simplifier ce que nous avons construit, mais parfois, le modèle lui-même ne peut pas encore accomplir le travail.
Si nous ne construisons que ce que les modèles actuels rendent déjà possible, nous ne découvrirons pas les prochaines lacunes d’intelligence que l’équipe de recherche doit combler. C’est pourquoi bon nombre de nos mandats importants commencent à ces limites, avec le client, les ingénieurs déployés sur le terrain et l’équipe de recherche déterminés à les repousser ensemble.
Nous avions déjà développé une plateforme de service à la clientèle avec un important client du secteur des télécommunications, qui souhaitait l’étendre aux interactions vocales.
Les interactions vocales représentaient environ 90 % de son volume de service à la clientèle. Ces demandes coûtaient plus cher à traiter sans intervention humaine que celles par clavardage et soulevaient de nouveaux défis techniques : la gestion des accents, le ton, la latence et l’exactitude devaient atteindre un niveau adapté à la production. Une solution efficace aurait des retombées considérables pour son entreprise.
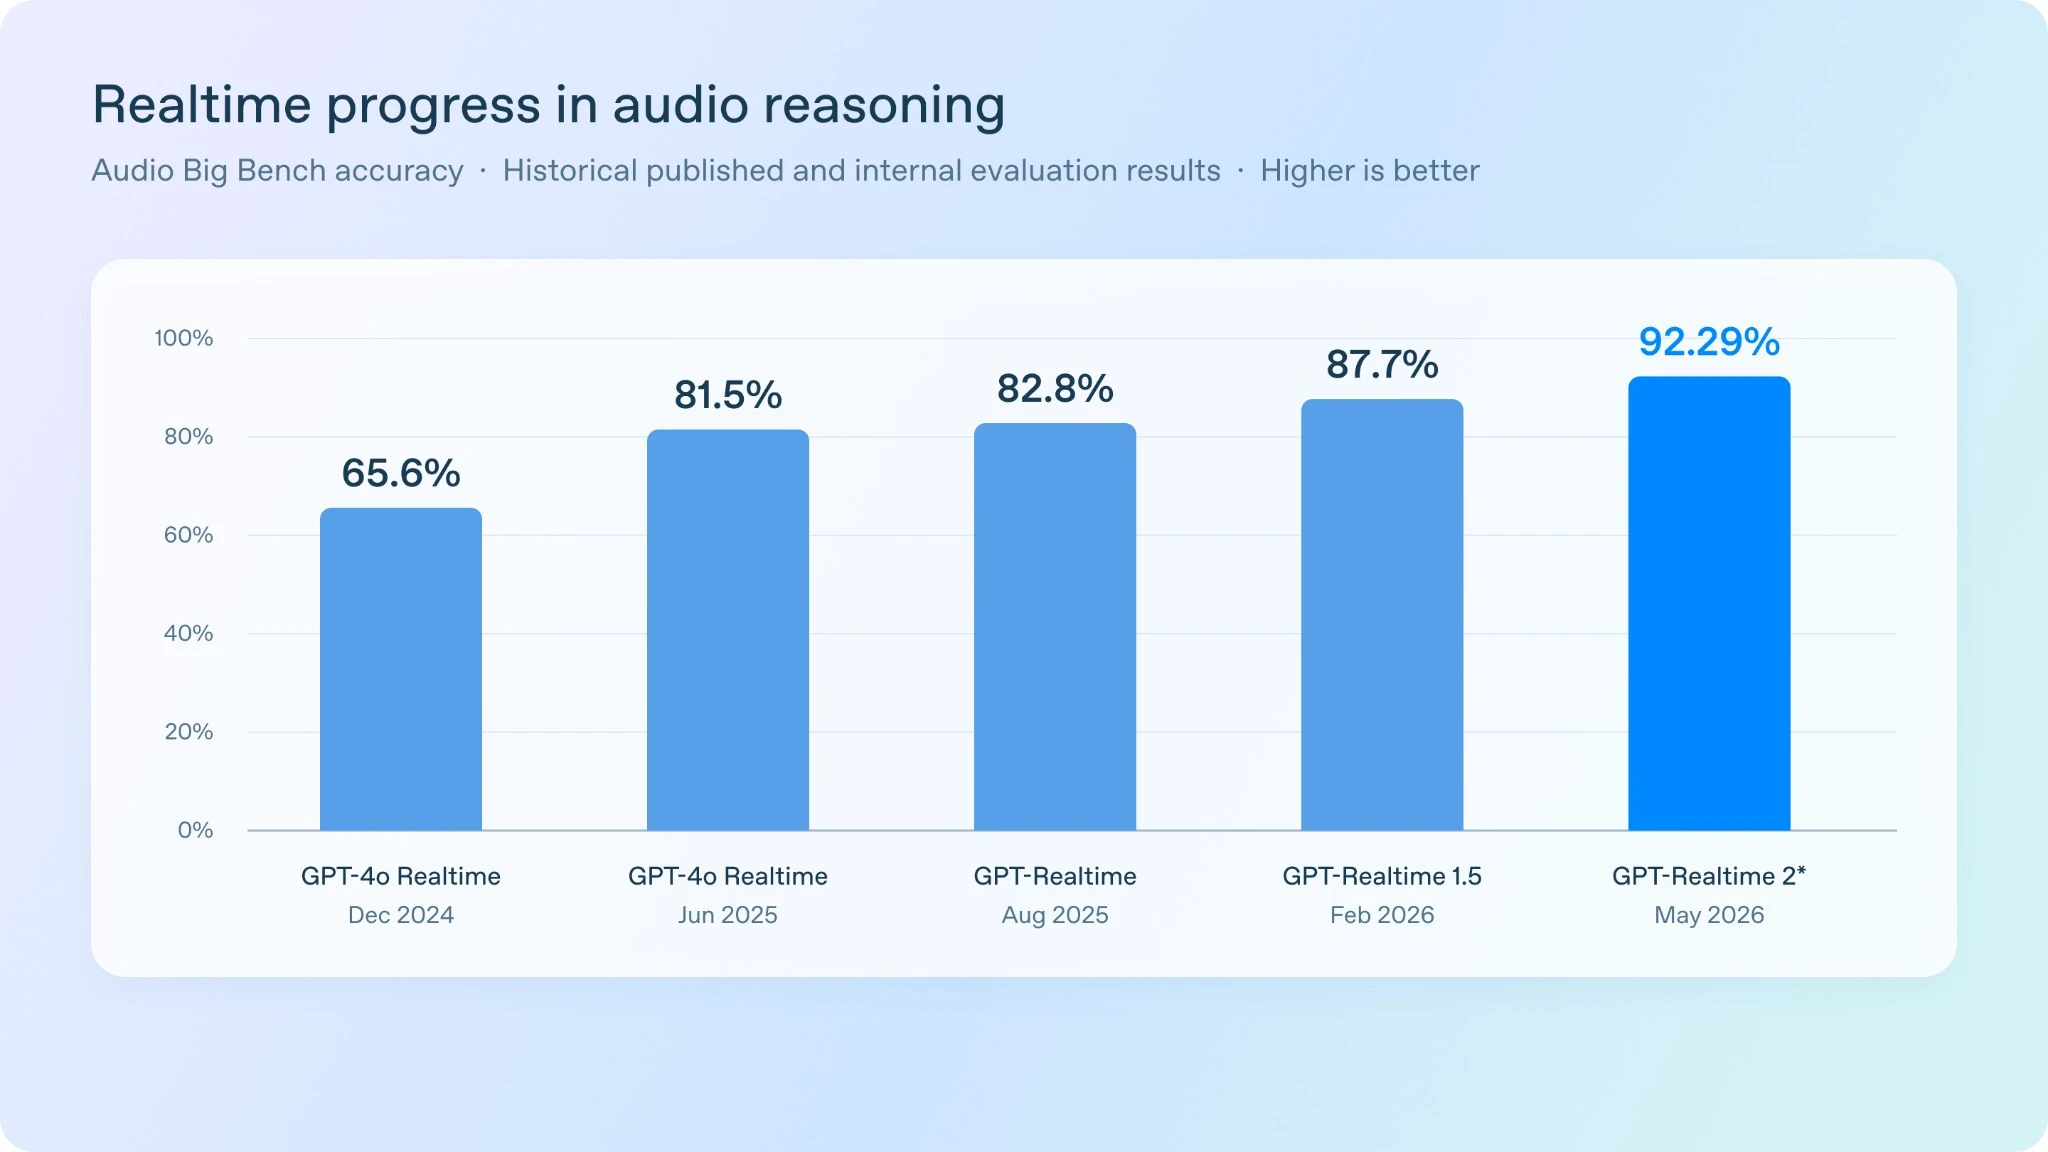
Lors du cadrage du projet, notre modèle obtenait un score d’environ 60 % aux évaluations clés servant à déterminer s’il pouvait accomplir le travail en production. Nous avions atteint les limites de ses capacités. L’appel de fonction et le respect des instructions dans les scénarios de service à la clientèle devaient être améliorés.
Nous l’avons expliqué au client et avons fait participer l’équipe de recherche aux travaux. Les ingénieurs déployés sur le terrain ont travaillé avec le client pour construire la plateforme et définir ce que le modèle devait faire. L’équipe de recherche s’est employée à combler les lacunes du modèle, dont les versions successives nous ont permis de mesurer les progrès par rapport aux exigences du client.
En six mois, les résultats aux évaluations clés sont passés d’environ 60 % à 80 %, puis à plus de 90 %, atteignant les niveaux requis pour la production.
Le modèle vocal ainsi créé prend maintenant en charge le déploiement de ce client, d’autres déploiements sur mesure de service à la clientèle et des déploiements gérés par l’intermédiaire de Presence. Un problème rencontré dans les activités d’un client a permis de cerner des améliorations pouvant servir à beaucoup d’autres.
Chaque contribution comptait. Le client s’est engagé à travailler sur un problème que le modèle ne pouvait pas encore résoudre. Les ingénieurs déployés sur le terrain sont restés assez proches du client pour cadrer le problème, construire la plateforme et mener le mandat de bout en bout. L’équipe de recherche a amélioré les capacités du modèle sous-jacent.
C’est l’autre façon de nous rendre nous-mêmes obsolètes : aider à transformer un problème que les modèles actuels ne peuvent pas résoudre en une capacité que les modèles futurs pourront offrir. Les retombées de notre travail vont au-delà des heures passées auprès d’un client donné.
J’ai rejoint OpenAI pour contribuer à rendre l’IA utile dans le travail quotidien des gens. C’est toujours ce qui guide l’équipe. Je dis souvent à l’équipe que, dans la plupart des cas de développement de LLM, le rasoir d’Occam s’applique : la solution la plus simple est la meilleure. Dans une entreprise qui se définit par sa recherche de pointe et un secteur marqué par l’exagération, nous voulons construire des solutions fiables sur lesquelles les gens sur le terrain peuvent compter.
L’objectif est que chaque mandat améliore la suite : un produit plus facile à déployer, un modèle capable d’accomplir une tâche plus difficile ou moins de travail sur mesure pour le prochain client.
Si vous avez un problème difficile à résoudre, nous aimerions travailler avec vous. Si vous voulez contribuer à résoudre ces problèmes, nous aimerions vous compter parmi nous.
Alors, que faisons-nous quand Codex peut accomplir le travail pour lequel nous avons passé des mois à développer des solutions?
Nous cherchons un problème plus difficile.