Was Forward Deployed Engineering bei OpenAI bedeutet
Was wir tun, wie wir arbeiten und wie wir die schwierigsten Probleme von Unternehmen lösen, um konkret etwas zu bewirken.
Von Colin Jarvis, Head of Forward Deployed Engineering bei OpenAI
Als Codex erschien, fragte mich jemand aus dem Team: „Was machen wir, wenn Codex die Anwendungsfälle, an denen wir in den letzten Monaten gearbeitet haben, einfach in einem Durchgang lösen kann?“
Diese Frage trifft den Kern dessen, was Forward Deployed Engineering bei OpenAI bedeutet. Wir arbeiten eng mit Kundenunternehmen zusammen, um ihre schwierigsten Probleme zu verstehen und Lösungen zu entwickeln, auf die sie sich verlassen können. Was wir dabei lernen, prägt unsere Produkte mit und gibt unserem Forschungsteam konkrete Probleme, die es lösen kann.
Das ist Fortschritt. Wenn wir uns alle paar Monate selbst überflüssig machen, erfüllt unser Team der Forward Deployed Engineers seine Aufgabe.
Ich habe das Team Anfang 2025 gegründet, um das zu schließen, was wir „die Umsetzungslücke“ nennen: den Abstand zwischen dem, wozu Modelle scheinbar fähig sind, und dem, was Menschen bei ihrer Arbeit zuverlässig nutzen können.
Die Fähigkeiten der Modelle haben sich schneller entwickelt als die Systeme und Prozesse, die für ihren Einsatz nötig sind. Manchmal fehlt ein Produkt. Manchmal schneidet ein Modell in einem Benchmark gut ab, kann die Aufgabe unter realen Bedingungen und Einschränkungen aber nicht bewältigen.
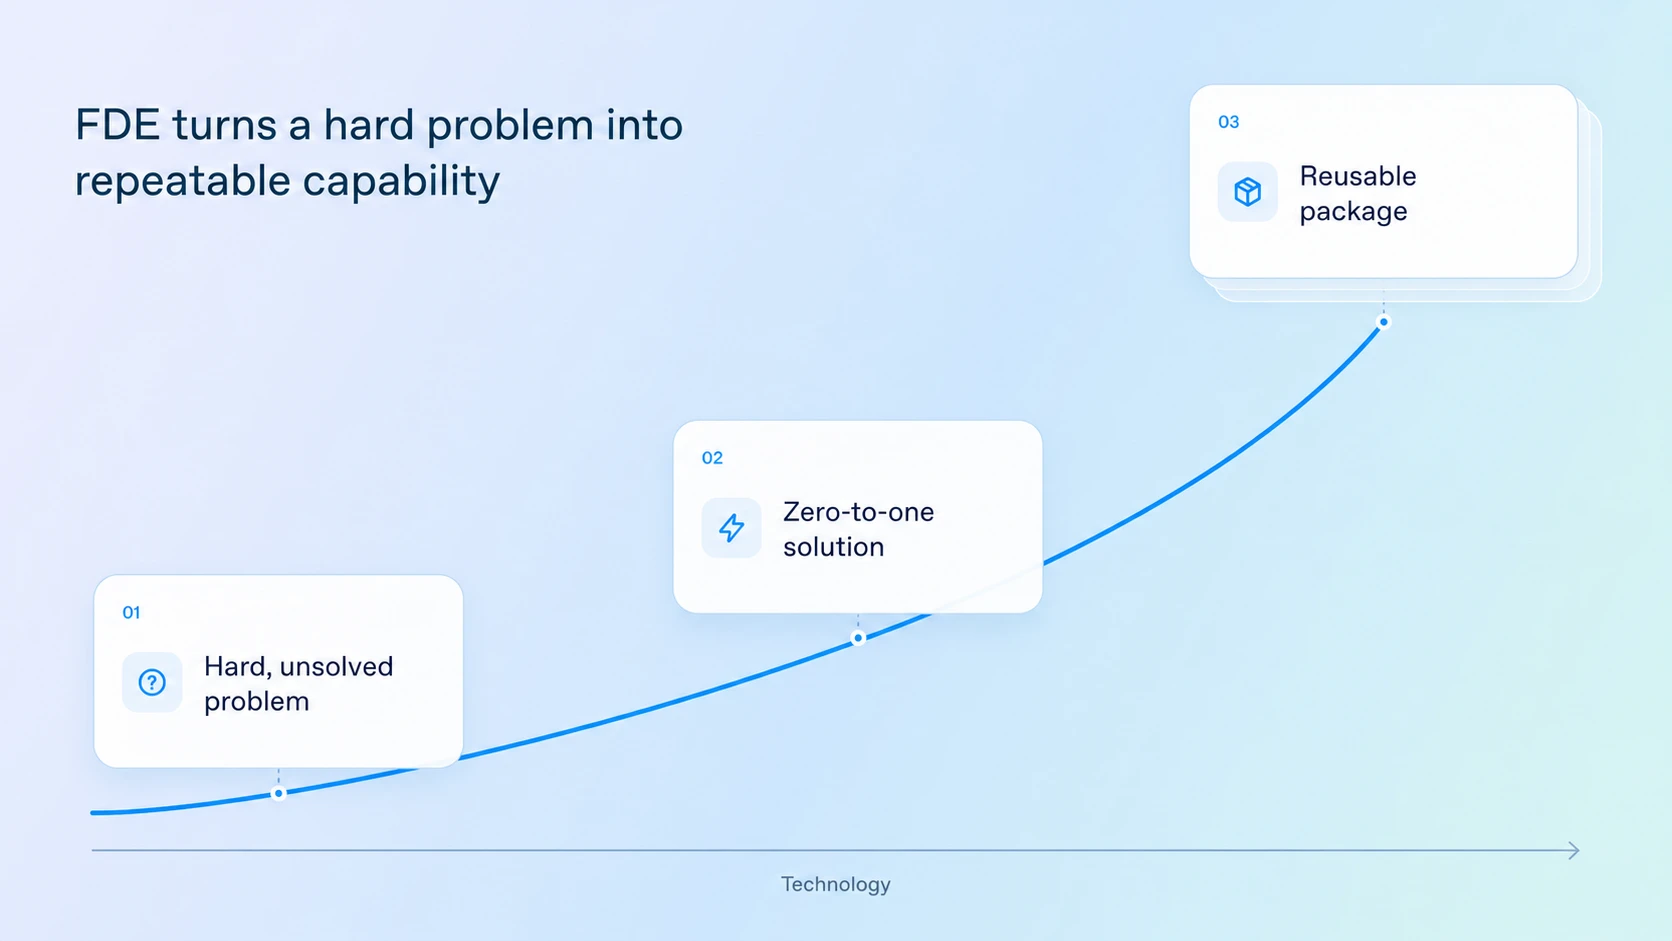
Wir konzentrieren uns auf die schwierigsten Probleme unserer Kundenunternehmen. Wo unsere Modelle die Aufgabe heute schon bewältigen, arbeiten wir mit dem Produktteam und dem Kundenunternehmen daran, die Lösung wiederholbar zu machen. Wo die Modelle noch nicht ausreichen, definieren wir gemeinsam mit den Unternehmen und unserem Forschungsteam die Lücke und arbeiten an Verbesserungen. Unser Ziel ist, mit jedem Projekt eine bessere Ausgangsbasis für das nächste Kundenunternehmen zu schaffen. Wenn wir die Voraussetzungen so weit verbessern, dass die Unternehmen beim nächsten Mal keine Forward Deployed Engineers mehr brauchen, um diese Art von Problem zu lösen, haben wir gute Arbeit geleistet.
John Deere, ein 200 Jahre altes Agrarunternehmen, stand vor der Herausforderung, individuelle Beratung für mehr landwirtschaftliche Betriebe bereitzustellen.
Ein Beispiel ist See & Spray, eine Technologie zur präzisen Unkrautbekämpfung. Sie erkennt und besprüht Unkraut mithilfe von Kameras und maschinellem Lernen, statt ganze Felder zu behandeln. So lässt sich der Chemikalieneinsatz um bis zu 70 % reduzieren.
Diese Vorteile lassen sich aber nur nutzen, wenn die Menschen in den Betrieben wissen, wie sie die Technologie konfigurieren, ihre Saison planen und ihre Arbeitsweise an veränderte Bedingungen anpassen.
John Deere setzte die APIs von OpenAI ein, um diese Unterstützung individuell und skalierbar zu gestalten.
KI kann Fragen aus den Betrieben in natürlicher Sprache beantworten, maßgeschneiderte Anleitungen zur Einrichtung und Empfehlungen geben und erkennen, wenn Maschinen ihr Potenzial möglicherweise nicht voll ausschöpfen. Außerdem hilft sie den Betrieben zu verstehen, welchen Nutzen ihnen die Technologie bringt.
Die Möglichkeiten reichen über einzelne Interaktionen hinaus: Relevante Beratung während der gesamten Kundenbeziehung hilft landwirtschaftlichen Betrieben, ihre Maschinen besser zu nutzen und zugleich effizienter und nachhaltiger zu arbeiten.
An solchen Herausforderungen arbeiten die Forward Deployed Engineers von OpenAI: Sie helfen Organisationen, aus KI-Fähigkeiten Systeme zu entwickeln, die unter komplexen Praxisbedingungen konkreten Nutzen bringen.
Doch oft sind die Probleme noch völlig offen, es gibt möglicherweise keine gesicherte Referenz und kein erprobtes Vorgehen. Alle wollen etwas entwickeln, das es noch nie gab. Weniger Menschen sind bereit, das zu tun, was dafür nötig ist.
Talentierte Forward Deployed Engineers zu finden und zugleich den Maßstab für „gut genug“ anzuheben, hat ständiges Experimentieren und Erproben in der Praxis erfordert.
Zu Beginn jeder Teamsitzung unserer Forward Deployed Engineers zeige ich eine Folie mit einem zentralen Grundsatz: „Beginne mit dem Ergebnis, tu, was für den Erfolg nötig ist, und skaliere anschließend.“
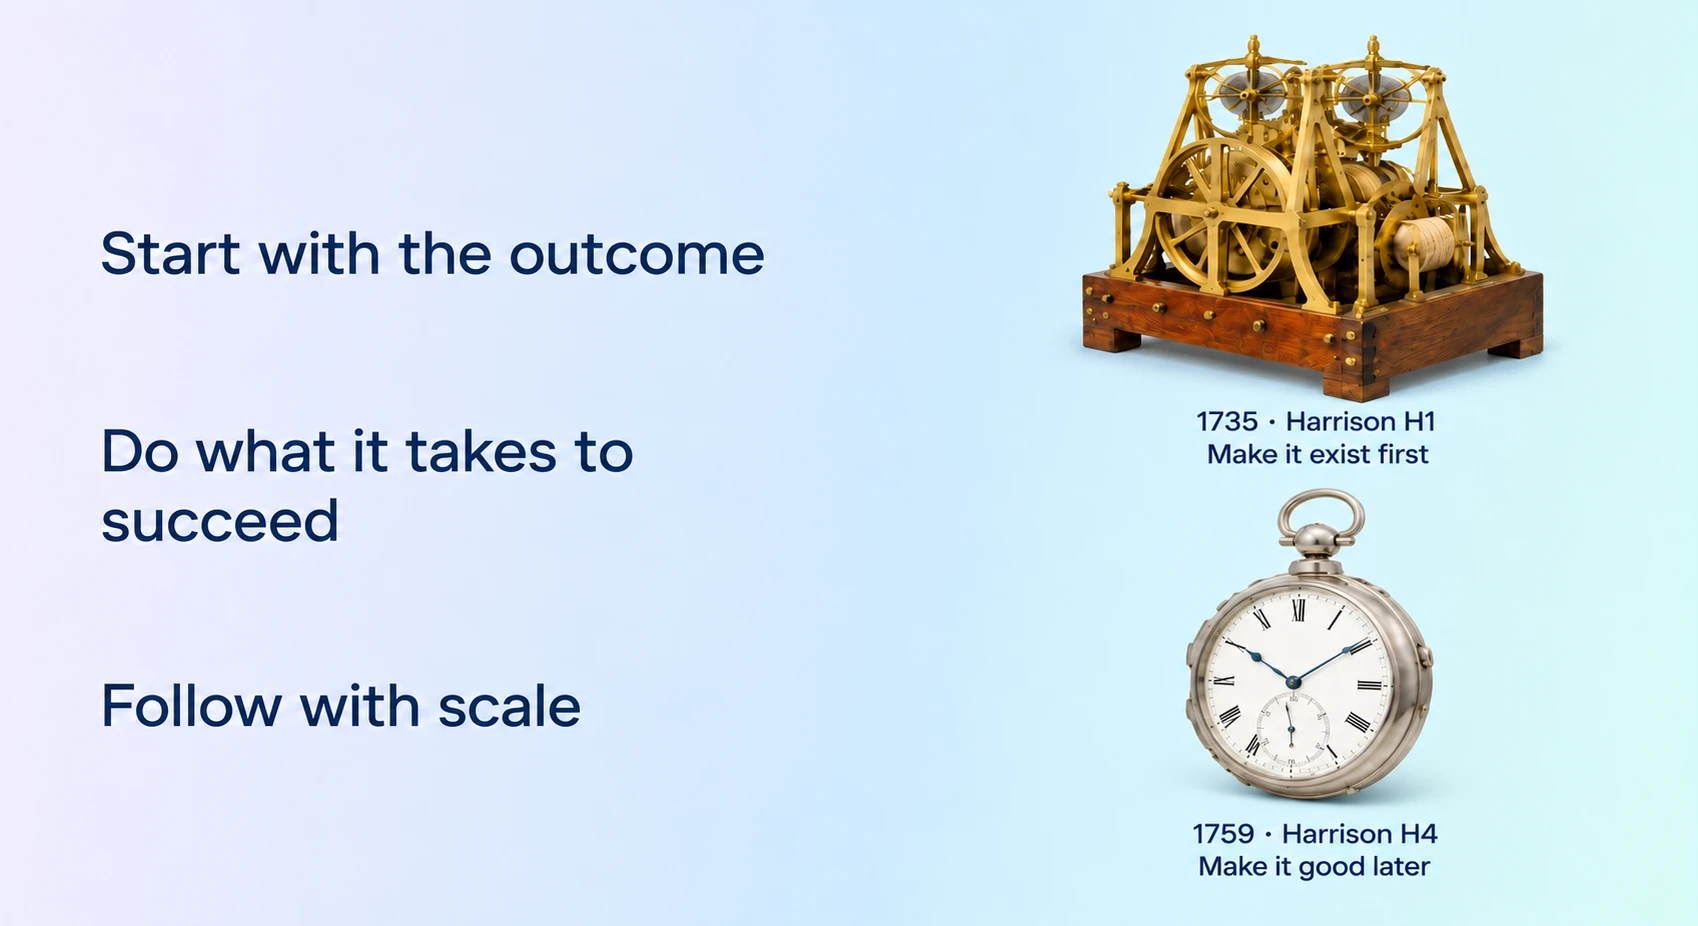
Eine eindrucksvolle Demo kann lange überzeugen, bevor jemand fragt, ob sie auch in der Praxis funktioniert.
Unsere Aufgabe ist es, das Problem des Kundenunternehmens in einer Qualität zu lösen, für die wir auch im Produktivbetrieb einstehen können.
Mitte 2025 arbeiteten rund 15 unserer Forward Deployed Engineers mit einem großen Halbleiterunternehmen an mehr als zehn Anwendungsfällen. Ziel war es, den Verifikationsprozess des Unternehmens von Grund auf auf KI auszurichten. Dazu gehörten:
Generierung gezielter Tests
Ursachenanalyse und Fehlerbehebung
Ein Architekturassistent
In dieser Branche kann die Verifikation rund 70 % des Projektaufwands ausmachen. Das Potenzial war enorm, und es gab viele mögliche Ansatzpunkte.
Einige Forward Deployed Engineers hatten erst wenige Tage zuvor bei OpenAI angefangen und noch nie in der Halbleiterbranche gearbeitet. Sie arbeiteten direkt im Verifikationsteam des Unternehmens mit, beschäftigten sich in ihrer Freizeit mit Chipdesign und entwickelten gemeinsam mit dem Engineering-Team Evaluierungen. Damit prüften sie, ob die KI nützliche Tests generieren und Chipfehler korrekt diagnostizieren konnte.
Parallel zu dieser Einarbeitung entwickelten wir maßgeschneiderte Harnesses für die einzelnen Anwendungsfälle. In den ersten drei bis sechs Monaten gingen alle in den Produktivbetrieb und wurden von den ersten Teams genutzt. Der Erfolg zeigte sich in den Kennzahlen:
Rund 48 % Zeitersparnis durch die KI-gestützte Generierung gezielter Tests.
22 % Leistungssteigerung im Median durch Kernel-Optimierung.
Fehlerbehebung in Stunden statt Wochen
Als wir all das vorstellten, fragte der Chief Hardware Officer: „Habt ihr schon im Chipdesign gearbeitet, bevor ihr hierhergekommen seid?“
Unsere Forward Deployed Engineers müssen die Branche nicht vom ersten Tag an kennen. Aber es liegt in ihrer Verantwortung, sie kennenzulernen.
Da Programmierassistenten die Softwareentwicklung beschleunigen, wird es noch wichtiger, das Geschäft des Kundenunternehmens zu verstehen. Wir stellen Teams zusammen, die breites Wissen mit Fachkenntnissen in einzelnen Bereichen verbinden.
Du brauchst genug Wissen, um fundierte Entscheidungen zu treffen, und genug Neugier, um Annahmen über den Status quo zu hinterfragen.
In den Biowissenschaften etwa hilft der wissenschaftliche Hintergrund unserer Forward Deployed Engineers dabei, Vertrauen bei Forschenden aufzubauen. Diese arbeiten an präklinischer Wirkstoffforschung, etwa an der Validierung und Priorisierung von Zielstrukturen, der Genexpressionsanalyse und der Rekonstruktion chemischer Synthesewege. Mit diesem Fachwissen können unsere Forward Deployed Engineers fundiert beurteilen, wie sich solche Arbeitsabläufe verbessern ließen.
Wir hatten gezeigt, dass diese Arbeitsabläufe Nutzen bringen konnten. Doch um sie auf ein weiteres Team zu übertragen, war jeweils noch zu viel individuelle Integrationsarbeit nötig. Die nächste Herausforderung bestand darin, diese Ergebnisse zu erhalten und zugleich die Bereitstellung und Wartung der Software zu vereinfachen.
Inzwischen war Codex leistungsfähiger geworden. Eine Person aus unserem Team der Forward Deployed Engineers erprobte, die eigene Anwendung auf Basis von Codex neu aufzubauen. Anschließend übertrug sie gemeinsam mit dem Team die Anwendungsfälle auf einen gemeinsamen Harness mit Codex als Kern.
Aus individuellen Anwendungen wurden Plugins und Skills auf Basis gemeinsamer Codex-Grundbausteine. Codex wurde auch zur Benutzeroberfläche. Dadurch konnten wir die separaten Terminal-Oberflächen und Befehlszeilenschnittstellen ablösen, die wir für einzelne Anwendungsfälle geschrieben hatten.
Wir konnten aus jedem Projekt rund 90 % des individuell entwickelten Codes entfernen. Das veränderte, wie wir diese Arbeitsabläufe entwickelten, warteten und skalierten:
Wir konnten von zentralen Verbesserungen an Codex profitieren und brauchten dadurch weniger Verbindungscode für jeden einzelnen Anwendungsfall.
Wichtige Funktionen wurden als Skills und Plugins gebündelt. So ließen sie sich leichter untereinander teilen und vom AI CoE zentral steuern. Um die Lösung auf ein weiteres Team auszuweiten, konnte es dadurch genügen, neue Konnektoren oder MCP-Server einzubinden, neue Evaluierungen zu erstellen (wofür wir ebenfalls einen Skill hatten) und loszulegen.
Bei einem Beispiel aus dem August 2026 dauerte die erste Bereitstellung zwei Monate. Die Übertragung der Lösung auf ein zweites Team dauerte einen Tag. Mit zunehmender Skalierung konnten weitere Teams schneller einsteigen. Dieser Trend setzte sich fort: Bei einem Anwendungsfall im August 2026 dauerte die Einführung für das zweite Team einen Tag, nachdem die erste Bereitstellung zwei Monate gebraucht hatte.
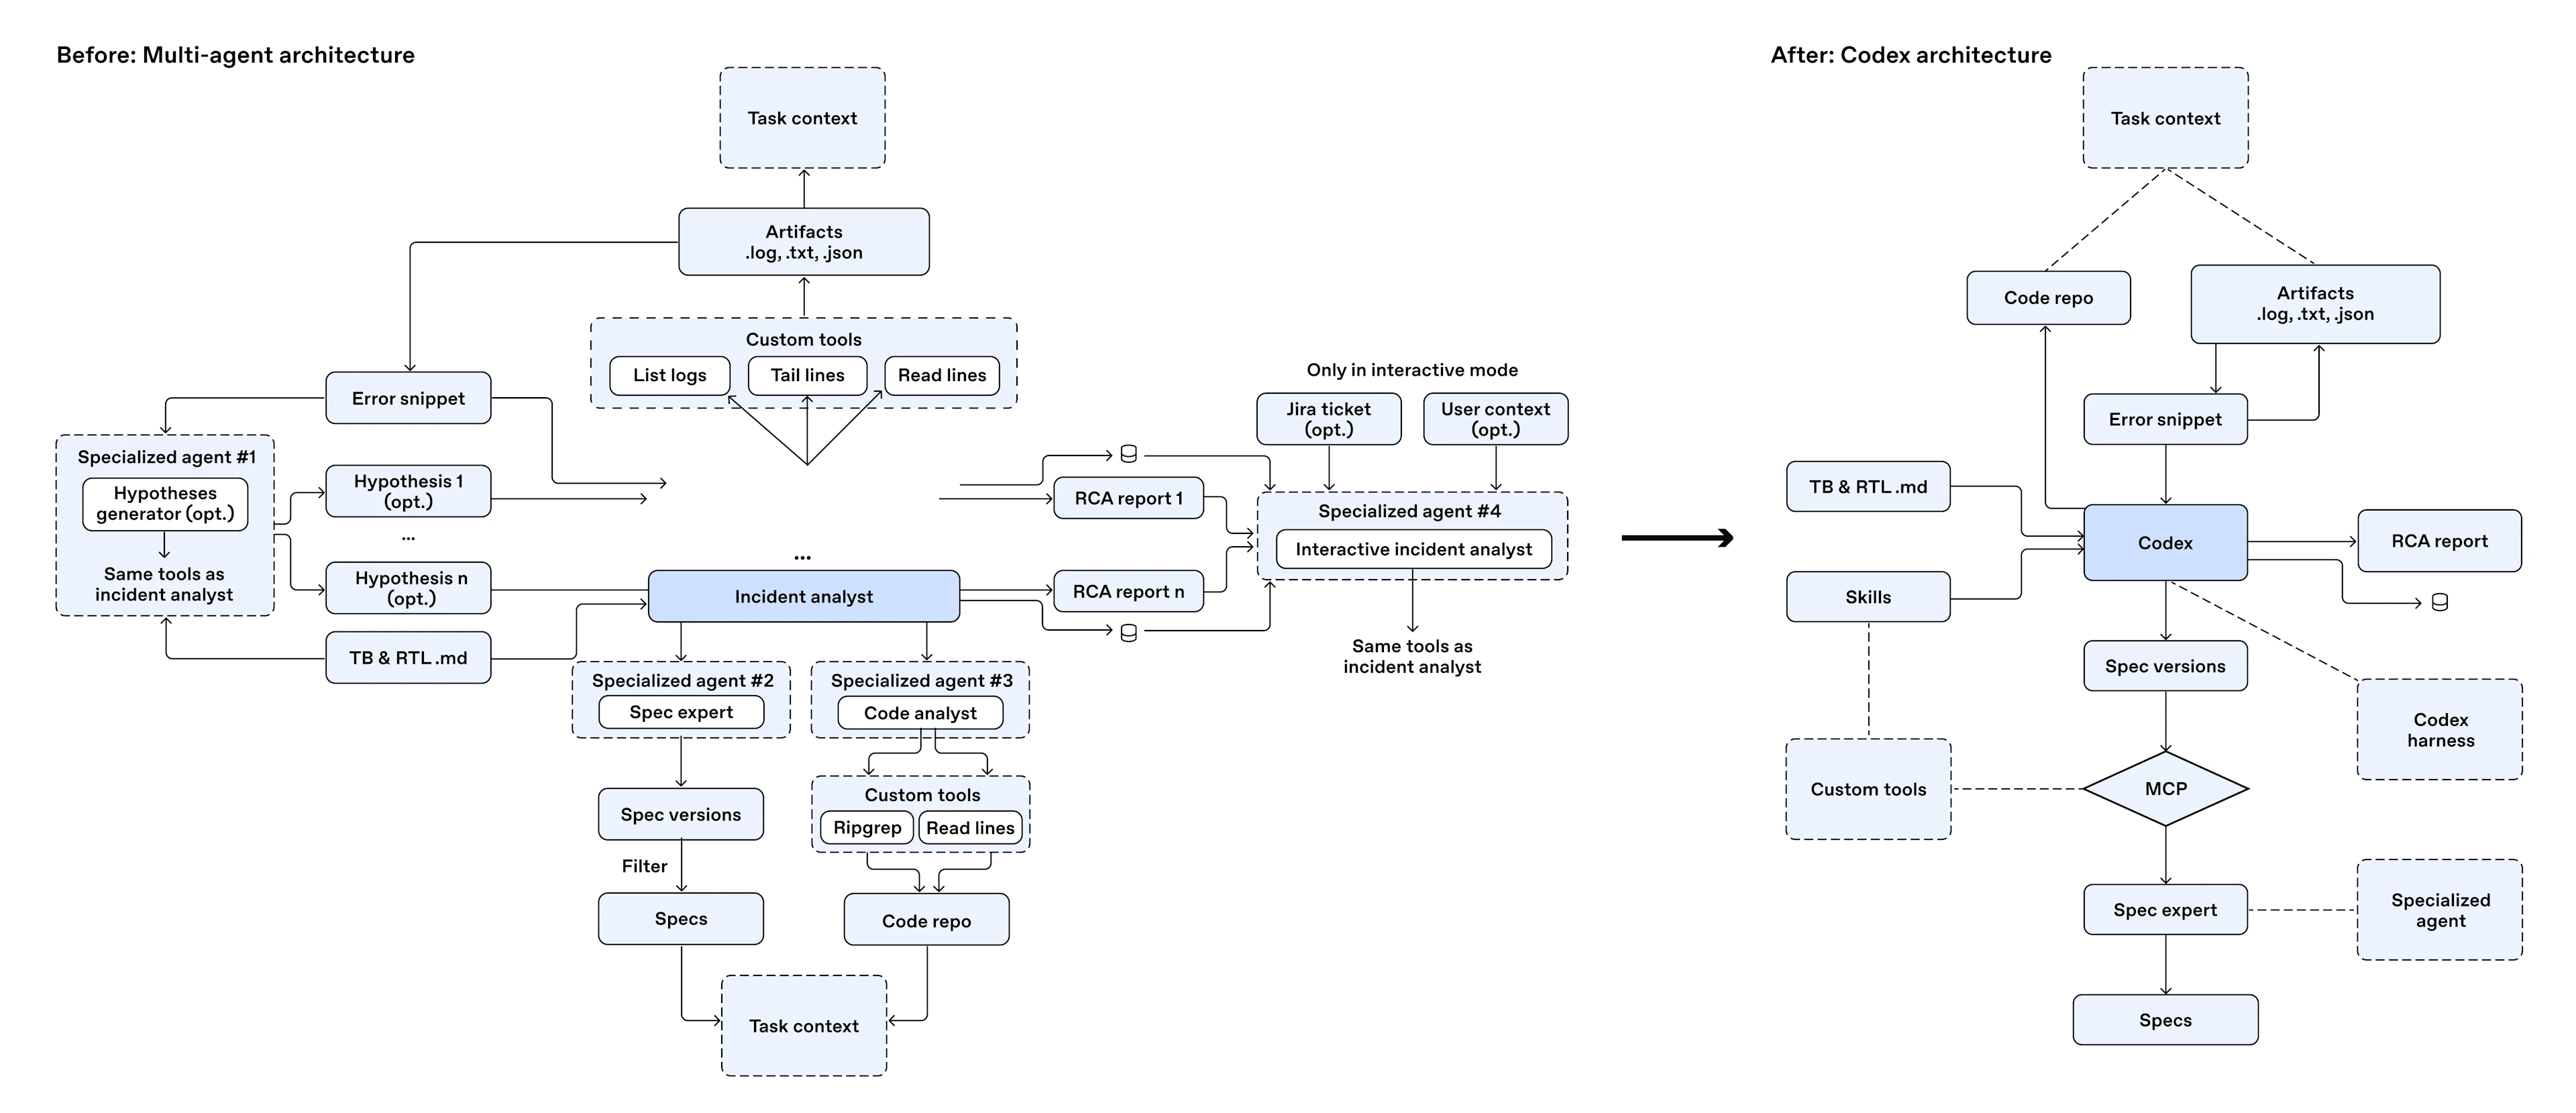
Das ist eine Möglichkeit, uns selbst überflüssig zu machen. Die Arbeit auf dem Weg zum Produktivbetrieb hatte gezeigt, worauf es ankam. Mit der Weiterentwicklung des zugrunde liegenden Produkts konnten wir einen Großteil unserer individuellen Implementierung ersetzen und ihren Nutzen erhalten.
Deshalb kommt es auf die Reihenfolge an. Mit LLMs können wir schnell entwickeln. Nutze dieses Tempo, um Menschen etwas Nützliches an die Hand zu geben. Finde heraus, was sich in der Praxis bewährt, und skaliere dann, was funktioniert.
Dasselbe Prinzip gilt für alle Projekte.
OpenAI Presence, unser Produkt für Enterprise-Sprach- und Chat-Agenten, entstand aus echten Kundendeployments. Die Arbeit begann mit Swarm(wird in einem neuen Fenster geöffnet) und entwickelte sich durch die Agents API, weiter und heute übernimmt ein Kunde mehr als die Hälfte seiner Anrufe mit KI.
Diese Deployments in die Produktion zu bringen, hat uns gelehrt, welche Probleme eine individuelle Lösung benötigen und welche Bausteine andere Teams nutzen könnten. Wir haben diese Bausteine in Presence integriert, was es Entwickler:innen erleichtert, regulierte Arbeitsabläufe zu automatisieren, ohne die zugrundeliegende Infrastruktur neu aufbauen zu müssen. Jede Implementierung half dabei, das Produkt zu formen und dem nächsten Kunden einen besseren Ausgangspunkt zu verschaffen.
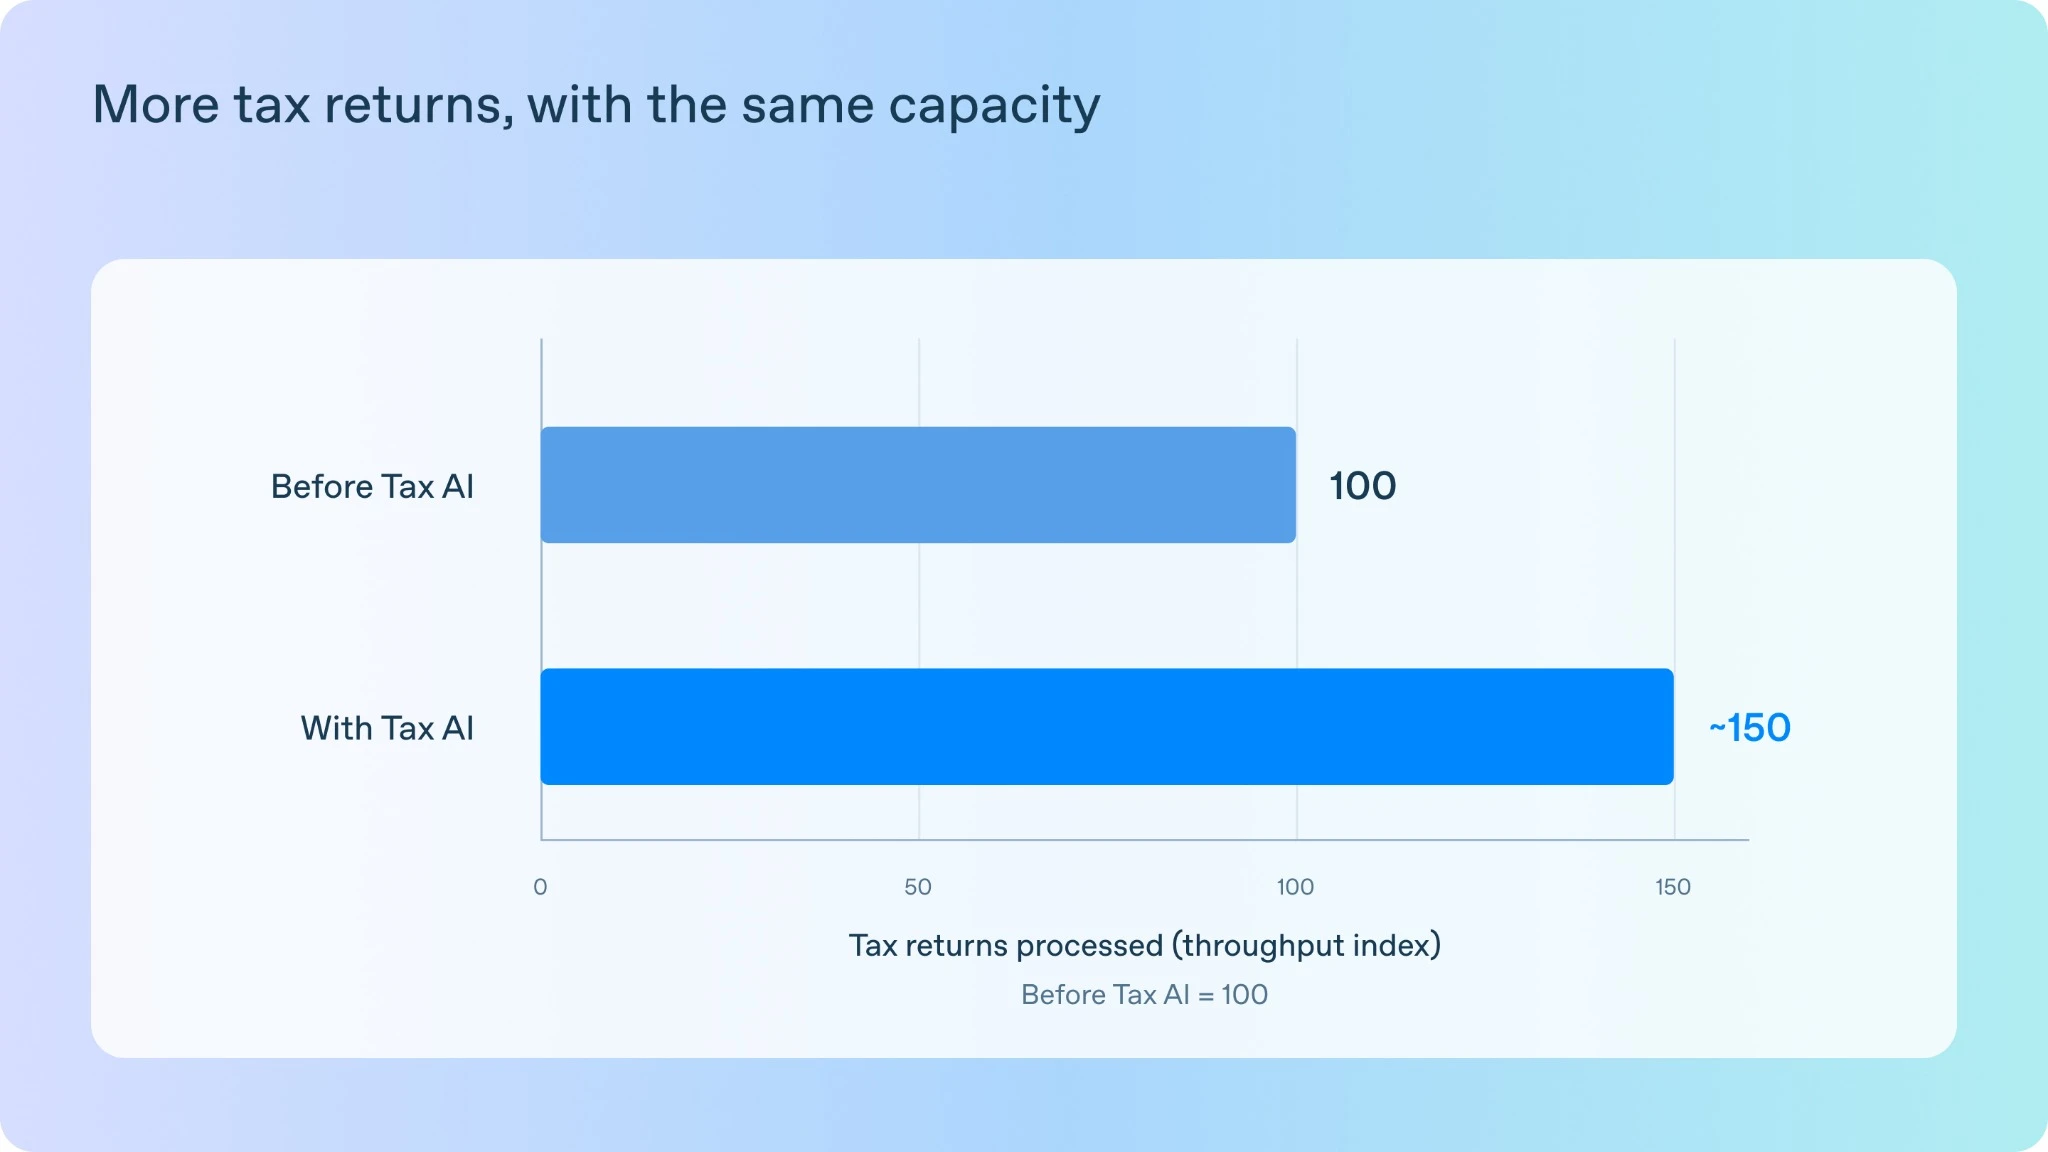
Mit Thrive Holdings,OpenAI FDEs und Forscher arbeiteten gemeinsam mit Ingenieur:innen und Buchhalter:innen zusammen, um Tax AI für die Wirtschaftsprüfungsgesellschaften Kretas zu entwickeln. Während des Pilotprojekts bearbeitete Tax AI 7.000 Steuererklärungen und steigerte den Durchsatz um etwa 50 %.
Eine der schwierigsten Herausforderungen war die Automatisierung der Steuererklärungen für Mietobjekte. Dafür waren sechs Wochen technische und praktische Überprüfung erforderlich, um eine Präzision und einen Recall von 90 % zu erreichen. Die Arbeit schuf wiederverwendbare Muster, die es erleichterten, Steuer-KI auf andere komplexe Steuerpläne auszuweiten.
Die Teams wenden nun denselben Ansatz bei Buchführung, Audit und IT-Support an – sie bauen Systeme, die durch Feedback von Praktiker:innen und den Einsatz in der Praxis verbessert werden.
Manchmal können wir unsere Lösung dank eines besseren Produkts vereinfachen. Manchmal ist aber das Modell selbst der Aufgabe noch nicht gewachsen.
Wenn wir nur entwickeln, was heutige Modelle bereits ermöglichen, entdecken wir nicht die Intelligenzlücken, die unser Forschungsteam als Nächstes schließen muss. Deshalb beginnen viele unserer wichtigen Projekte genau an diesen Grenzen. Das Kundenunternehmen, unsere Forward Deployed Engineers und unser Forschungsteam nehmen sich vor, sie gemeinsam zu überwinden.
Wir hatten bereits gemeinsam mit einem großen Telekommunikationsunternehmen eine Kundenservice-Plattform entwickelt. Nun wollte das Unternehmen sie um Sprachfunktionen erweitern.
Rund 90 % der Kundenservice-Anfragen gingen telefonisch ein. Diese Fälle automatisiert zu bearbeiten war teurer als im Chat. Zudem brachte es neue technische Herausforderungen mit sich: Der Umgang mit Akzenten, der Tonfall sowie Latenz und Genauigkeit mussten die Anforderungen des Produktivbetriebs erfüllen. Eine erfolgreiche Umsetzung würde für das Unternehmen einen erheblichen Unterschied machen.
Bei der Festlegung des Projektumfangs erreichte unser Modell rund 60 % in den zentralen Evaluierungen, mit denen wir seine Eignung für den Produktivbetrieb prüften. Wir waren an die Grenzen seiner Fähigkeiten gestoßen. Funktionsaufrufe und das Befolgen von Anweisungen in Kundenservice-Szenarien mussten besser werden.
Wir erklärten das dem Unternehmen und bezogen unser Forschungsteam ein. Unsere Forward Deployed Engineers entwickelten gemeinsam mit dem Unternehmen die Plattform und legten fest, was das Modell leisten musste. Das Forschungsteam arbeitete daran, die Fähigkeitslücken zu schließen. Mit aufeinanderfolgenden Modellversionen konnten wir die Fortschritte anhand der Anforderungen des Unternehmens testen.
Innerhalb von sechs Monaten stieg die Leistung in den zentralen Evaluierungen von rund 60 % auf 80 % und schließlich auf über 90 %. Damit erreichte sie das für den Produktivbetrieb erforderliche Niveau.
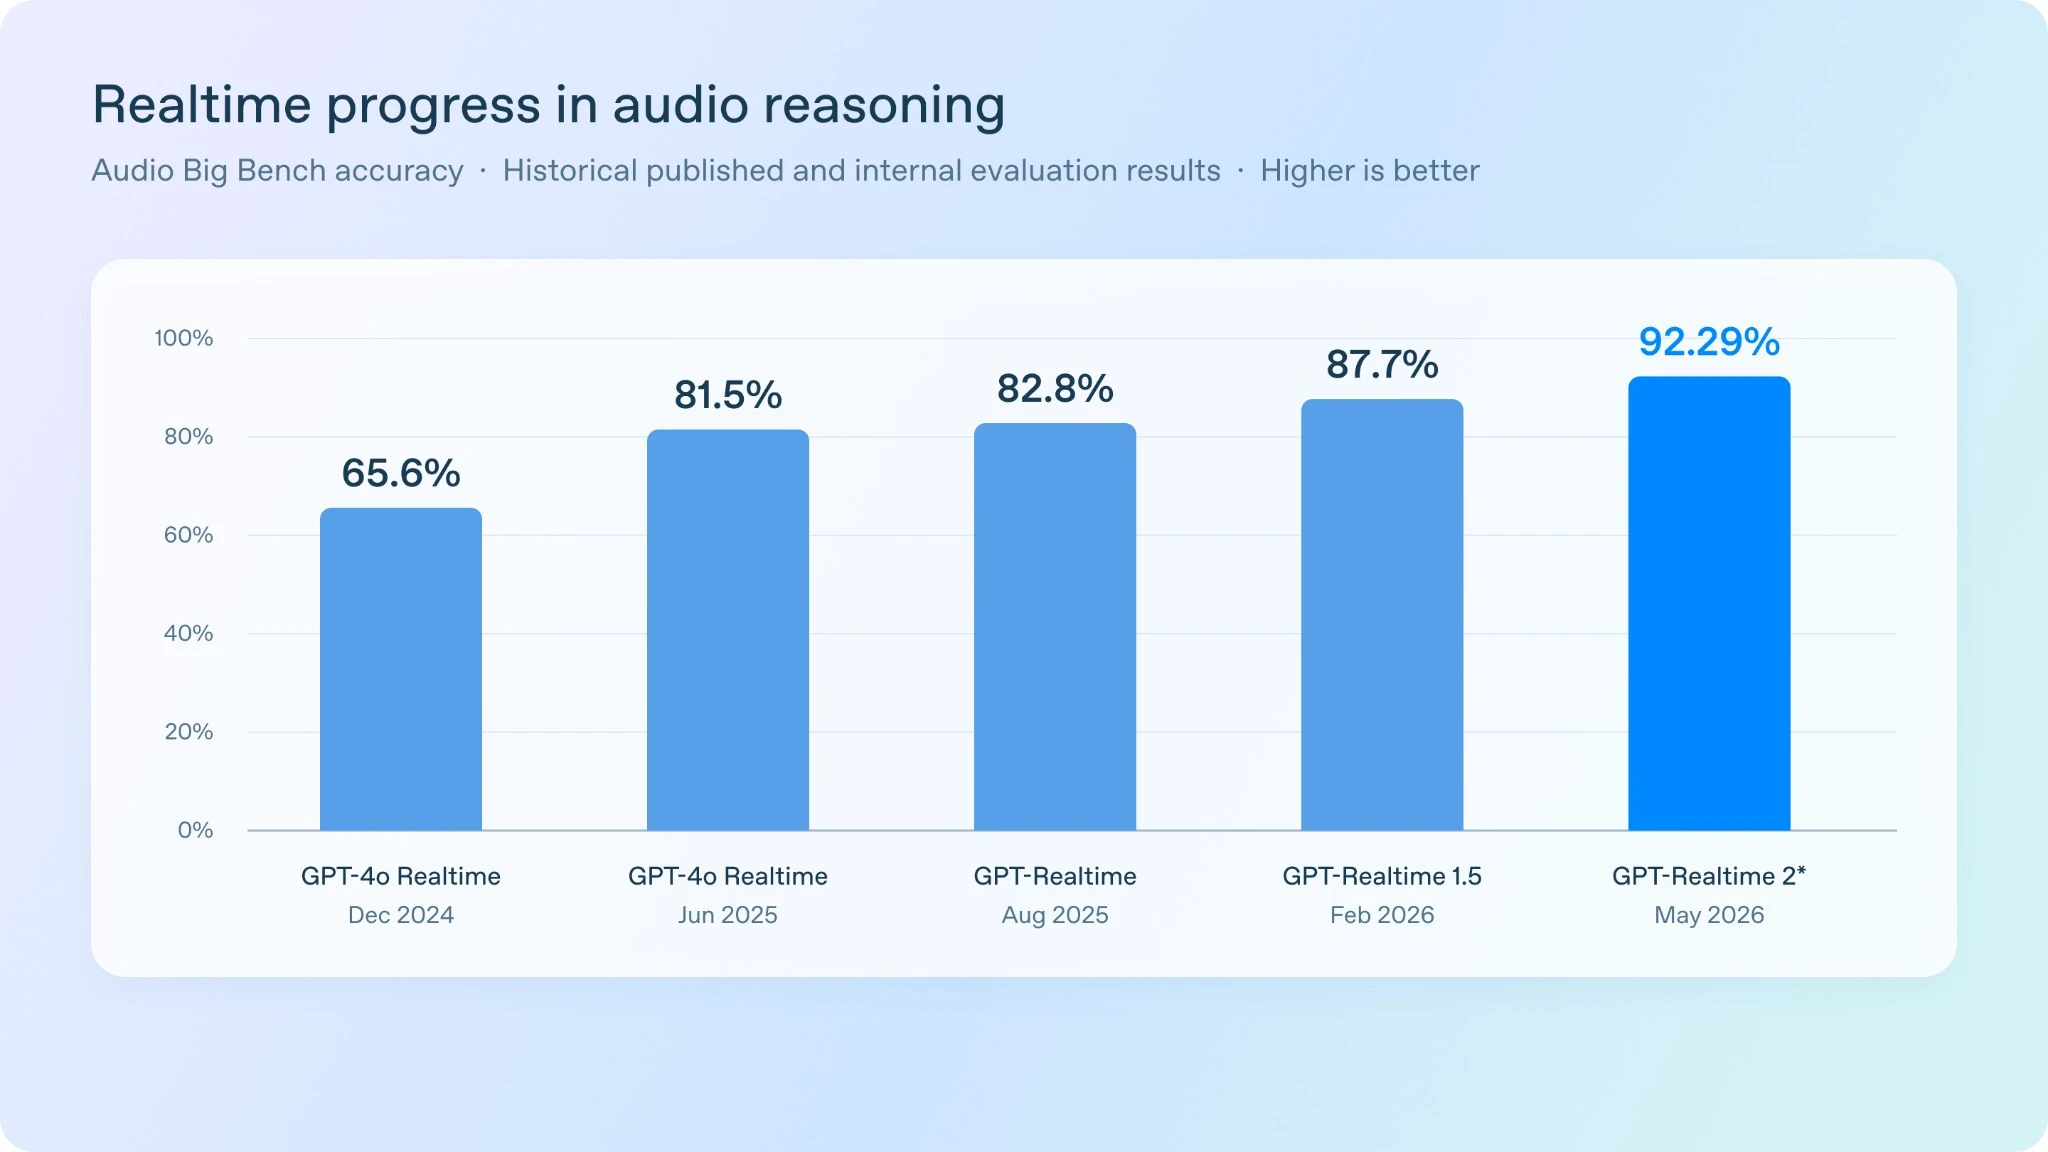
Das daraus entstandene Sprachmodell unterstützt heute die Lösung dieses Unternehmens, weitere maßgeschneiderte Kundenservice-Lösungen und verwaltete Bereitstellungen über Presence. Ein Problem im Geschäftsalltag eines Unternehmens half dabei, Verbesserungen zu erkennen, die vielen weiteren Unternehmen zugutekommen könnten.
Jeder Beitrag war wichtig. Das Kundenunternehmen war bereit, an einem Problem zu arbeiten, das das Modell noch nicht lösen konnte. Unsere Forward Deployed Engineers blieben eng genug eingebunden, um das Problem klar zu definieren, die Plattform zu entwickeln und das Projekt von Anfang bis Ende voranzutreiben. Das Forschungsteam verbesserte die zugrunde liegenden Modellfähigkeiten.
Das ist die andere Möglichkeit, uns selbst überflüssig zu machen: Wir helfen dabei, aus einem Problem, das heutige Modelle nicht lösen können, eine Fähigkeit künftiger Modelle zu machen. Der Nutzen unserer Arbeit reicht über die Stunden hinaus, die wir mit einem einzelnen Kundenunternehmen verbringen.
Ich bin zu OpenAI gekommen, um KI für Menschen im Arbeitsalltag nützlich zu machen. Das ist nach wie vor die Leitidee unseres Teams. Ich sage dem Team oft, dass bei der LLM-Entwicklung in den meisten Fällen gilt: Die einfachste Lösung ist die beste. In einem Unternehmen, das von Spitzenforschung geprägt ist, und in einer Branche, deren Ruf unter überzogenen Behauptungen leidet, wollen wir Lösungen entwickeln, die zuverlässig funktionieren und auf die sich Menschen in der Praxis verlassen können.
Jedes Projekt soll die Voraussetzungen für das nächste verbessern: durch ein Produkt, das sich leichter bereitstellen lässt, ein Modell, das eine schwierigere Aufgabe bewältigt, oder weniger individuelle Entwicklungsarbeit für das nächste Kundenunternehmen.
Wenn du ein schwieriges Problem lösen möchtest, arbeiten wir gern mit dir zusammen. Wenn du helfen möchtest, solche Probleme zu lösen, freuen wir uns, wenn du Teil unseres Teams wirst.
Was tun wir also, wenn Codex die Aufgaben übernehmen kann, für die wir monatelang Lösungen entwickelt haben?
Wir suchen uns das schwierigere Problem.