Kaj pomeni vloga implementacijskih inženirjev v OpenAI
Kaj počnemo, kako delamo in kako rešujemo najtežje probleme podjetij, da dosežemo konkretne rezultate.
Avtor: Colin Jarvis, vodja implementacijskega inženirstva (FDE) v OpenAI
Ko je izšel Codex, me je nekdo iz ekipe vprašal: »Kaj bomo naredili, ko bo Codex v enem poskusu rešil primere uporabe, za katere smo zadnjih nekaj mesecev razvijali rešitve?«
To vprašanje zadene bistvo vloge implementacijskih inženirjev v družbi OpenAI. S strankami tesno sodelujemo, da razumemo njihove najtežje probleme in razvijemo rešitve, na katere se lahko zanesejo. Naša spoznanja pomagajo oblikovati izdelke, raziskovalni ekipi pa dajejo konkretne probleme za reševanje.
To je napredek. Če vsakih nekaj mesecev poskrbimo, da nas ne potrebujejo več, naša ekipa implementacijskih inženirjev dobro opravlja svoje delo.
Ekipo sem ustanovil v začetku leta 2025, da bi premostili to, čemur pravimo »vrzel pri uvajanju«: razkorak med tem, česar so modeli na videz zmožni, in tem, kar lahko ljudje zanesljivo uporabljajo pri svojem delu.
Zmožnosti modelov so napredovale hitreje kot sistemi in procesi, potrebni za njihovo uporabo. Včasih manjka izdelek. Včasih se model dobro odreže na primerjalnem preizkusu, vendar ob spremenljivkah in omejitvah iz resničnega sveta nalogi ni kos.
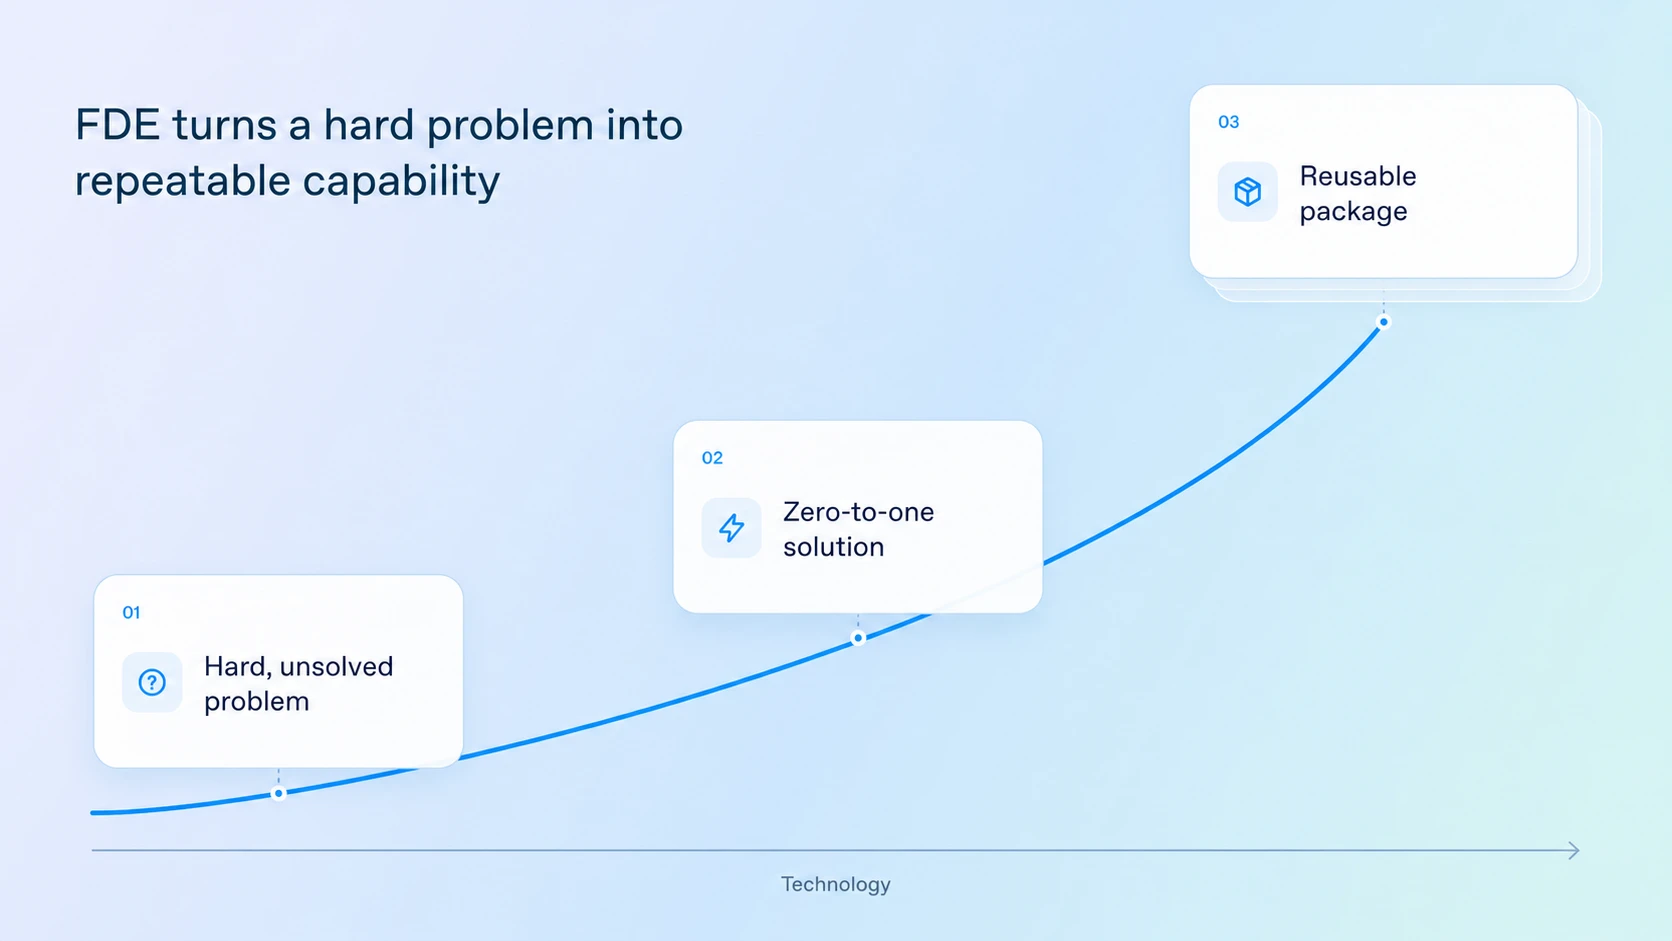
Osredotočamo se na najtežje probleme strank. Kadar so naši modeli nalogi kos že danes, z ekipo za razvoj izdelkov in stranko poskrbimo, da je rešitev ponovljiva. Kadar ne zadoščajo, s strankami in raziskovalno ekipo opredelimo vrzel in uvedemo izboljšave. Naš cilj je, da vsak projekt naslednji stranki zagotovi boljše izhodišče. Če osnovno raven dvignemo toliko, da stranke za reševanje te vrste problemov naslednjič ne potrebujejo implementacijskih inženirjev, smo svoje delo opravili dobro.
Podjetje John Deere, ki v kmetijski panogi deluje že 200 let, se je spoprijelo z izzivom, kako osebno prilagojeno svetovanje ponuditi več kmetom.
Primer je See & Spray, njihova tehnologija za natančno zatiranje plevela. S kamerami in strojnim učenjem prepoznava plevel in škropi le njega namesto celotnih polj, s čimer zmanjša uporabo kemikalij za do 70 %.
Toda da bi kmetje te prednosti lahko izkoristili, morajo znati tehnologijo nastaviti, načrtovati sezono in prilagajati svoje prakse spreminjajočim se razmeram.
John Deere je uvedel API-je družbe OpenAI, da bi bila ta podpora osebno prilagojena in na voljo v večjem obsegu.
Umetna inteligenca lahko na vprašanja kmetov odgovarja v naravnem jeziku, ponuja prilagojena navodila za nastavitev in priporočila, prepoznava, kdaj oprema morda ne dosega svojega polnega potenciala, ter kmetom pomaga razumeti, kakšne koristi jim prinaša tehnologija.
Priložnost sega dlje od posameznega stika: ustrezne napotke lahko zagotavljamo skozi celotno uporabniško pot ter kmetom pomagamo bolje izkoristiti opremo in hkrati izboljšati učinkovitost in trajnostnost.
Prav takšne izzive rešujejo implementacijski inženirji družbe OpenAI: organizacijam pomagajo pretvoriti zmožnosti umetne inteligence v sisteme, ki prinašajo praktično vrednost v kompleksnih okoljih resničnega sveta.
Toda problemi so pogosto povsem odprti, preverjena referenčna resnica morda ne obstaja in ustaljenih navodil ni. Vsi želijo ustvariti nekaj, kar še nikoli ni obstajalo. Manj jih je pripravljenih narediti vse, kar je za to potrebno.
Iskanje nadarjenih implementacijskih inženirjev ob hkratnem dvigovanju merila za »dovolj dobro« je zahtevalo nenehno preizkušanje in prenašanje spoznanj v prakso.
Na začetku vsakega srečanja ekipe implementacijskih inženirjev pokažem diapozitiv z enim temeljnim vodilom: »Začnite pri želenem rezultatu, naredite vse potrebno za uspeh, nato pa razširite obseg«.
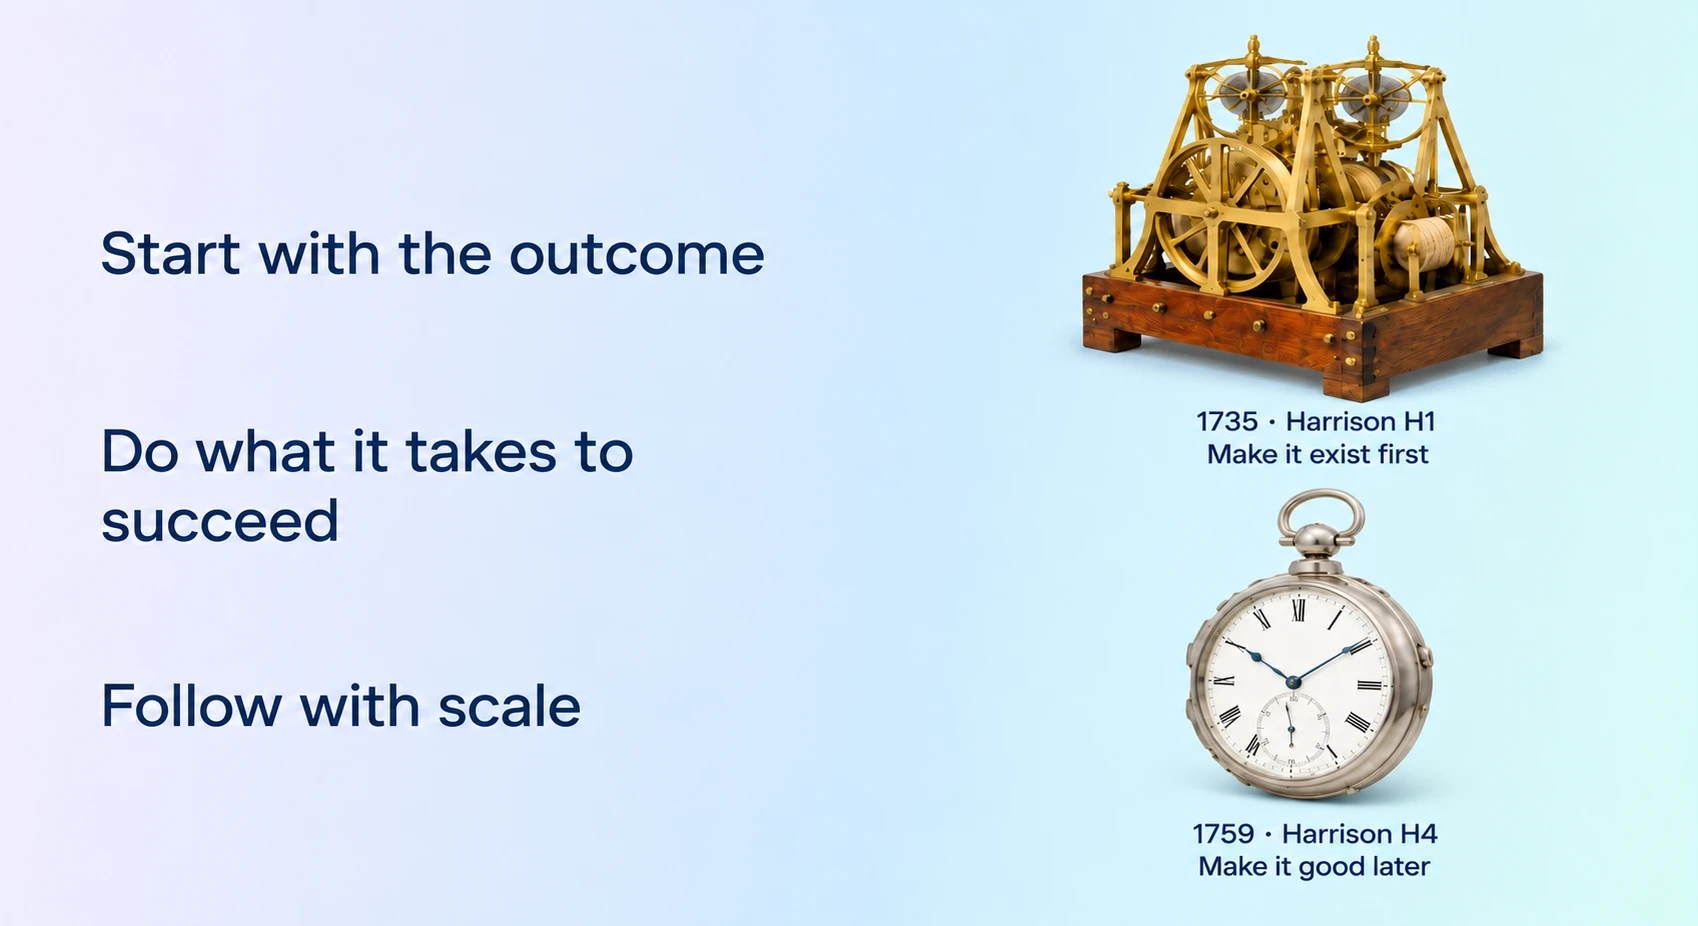
Prepričljiva predstavitev lahko odpre marsikatera vrata, še preden se kdo vpraša, ali rešitev deluje tudi v resničnem svetu.
Naša naloga je rešiti strankin problem tako kakovostno, da lahko za rešitvijo stojimo tudi v produkciji.
Sredi leta 2025 je približno 15 naših implementacijskih inženirjev z veliko stranko iz polprevodniške industrije razvijalo več kot 10 primerov uporabe. Cilj je bil njihov postopek verifikacije že v osnovi zasnovati na umetni inteligenci, kar je vključevalo:
Generiranje usmerjenih preizkusov
Analizo temeljnih vzrokov in odpravljanje napak
Pomočnika za arhitekturo
Verifikacija lahko v tej panogi predstavlja približno 70 % dela pri projektu. Priložnost je bila ogromna, možnih izhodišč pa veliko.
Nekateri implementacijski inženirji so se družbi OpenAI pridružili le nekaj dni prej in še nikoli niso delali na področju polprevodnikov. Vključili so se v strankino ekipo za verifikacijo, v prostem času preučevali načrtovanje čipov in skupaj z inženirji pripravili evalvacije, da bi preverili, ali lahko umetna inteligenca generira uporabne preizkuse in pravilno diagnosticira odpovedi čipov.
Ob tem učenju smo za posamezne primere uporabe zgradili prilagojena ogrodja. V prvih treh do šestih mesecih so vsi zaživeli v produkciji in dobili prve uporabnike. Trud se je obrestoval, kar so pokazale meritve:
Približno 48 % prihranjenega časa z generiranjem usmerjenih preizkusov z umetno inteligenco.
22-odstotno izboljšanje mediane zmogljivosti z optimizacijo jeder.
Tedni odpravljanja napak skrčeni na zgolj ure
Ko smo vse to predstavili direktorju za strojno opremo, nas je vprašal: »Ali ste pred prihodom k nam delali kot konstruktorji čipov?«
Našim implementacijskim inženirjem ni treba poznati panoge že prvi dan, vendar so jo dolžni spoznati.
Ker pomočniki za programiranje pospešujejo razvoj programske opreme, postaja razumevanje strankinega poslovanja še pomembnejše. Sestavljamo ekipe, ki združujejo strokovnjake s širokim znanjem in področne specialiste.
Potrebujete dovolj znanja za premišljeno presojo in dovolj radovednosti, da podvomite o predpostavkah, na katerih temelji trenutno stanje.
Na področju ved o življenju našim implementacijskim inženirjem znanstveno znanje denimo pomaga pridobiti zaupanje raziskovalcev, ki se ukvarjajo s predkliničnim odkrivanjem zdravil, vključno z validacijo in prednostnim razvrščanjem tarč, analizo izražanja genov ter rekonstrukcijo poti kemijske sinteze. To strokovno znanje jim omogoča utemeljeno presojo o tem, kako bi lahko te delovne tokove izboljšali.
Dokazali smo, da lahko ti delovni tokovi prinašajo vrednost, vendar je prenos vsakega od njih na drugo ekipo še vedno zahteval preveč prilagojenega integracijskega dela. Naslednji izziv je bil ohraniti te rezultate, hkrati pa poenostaviti uvajanje in vzdrževanje programske opreme.
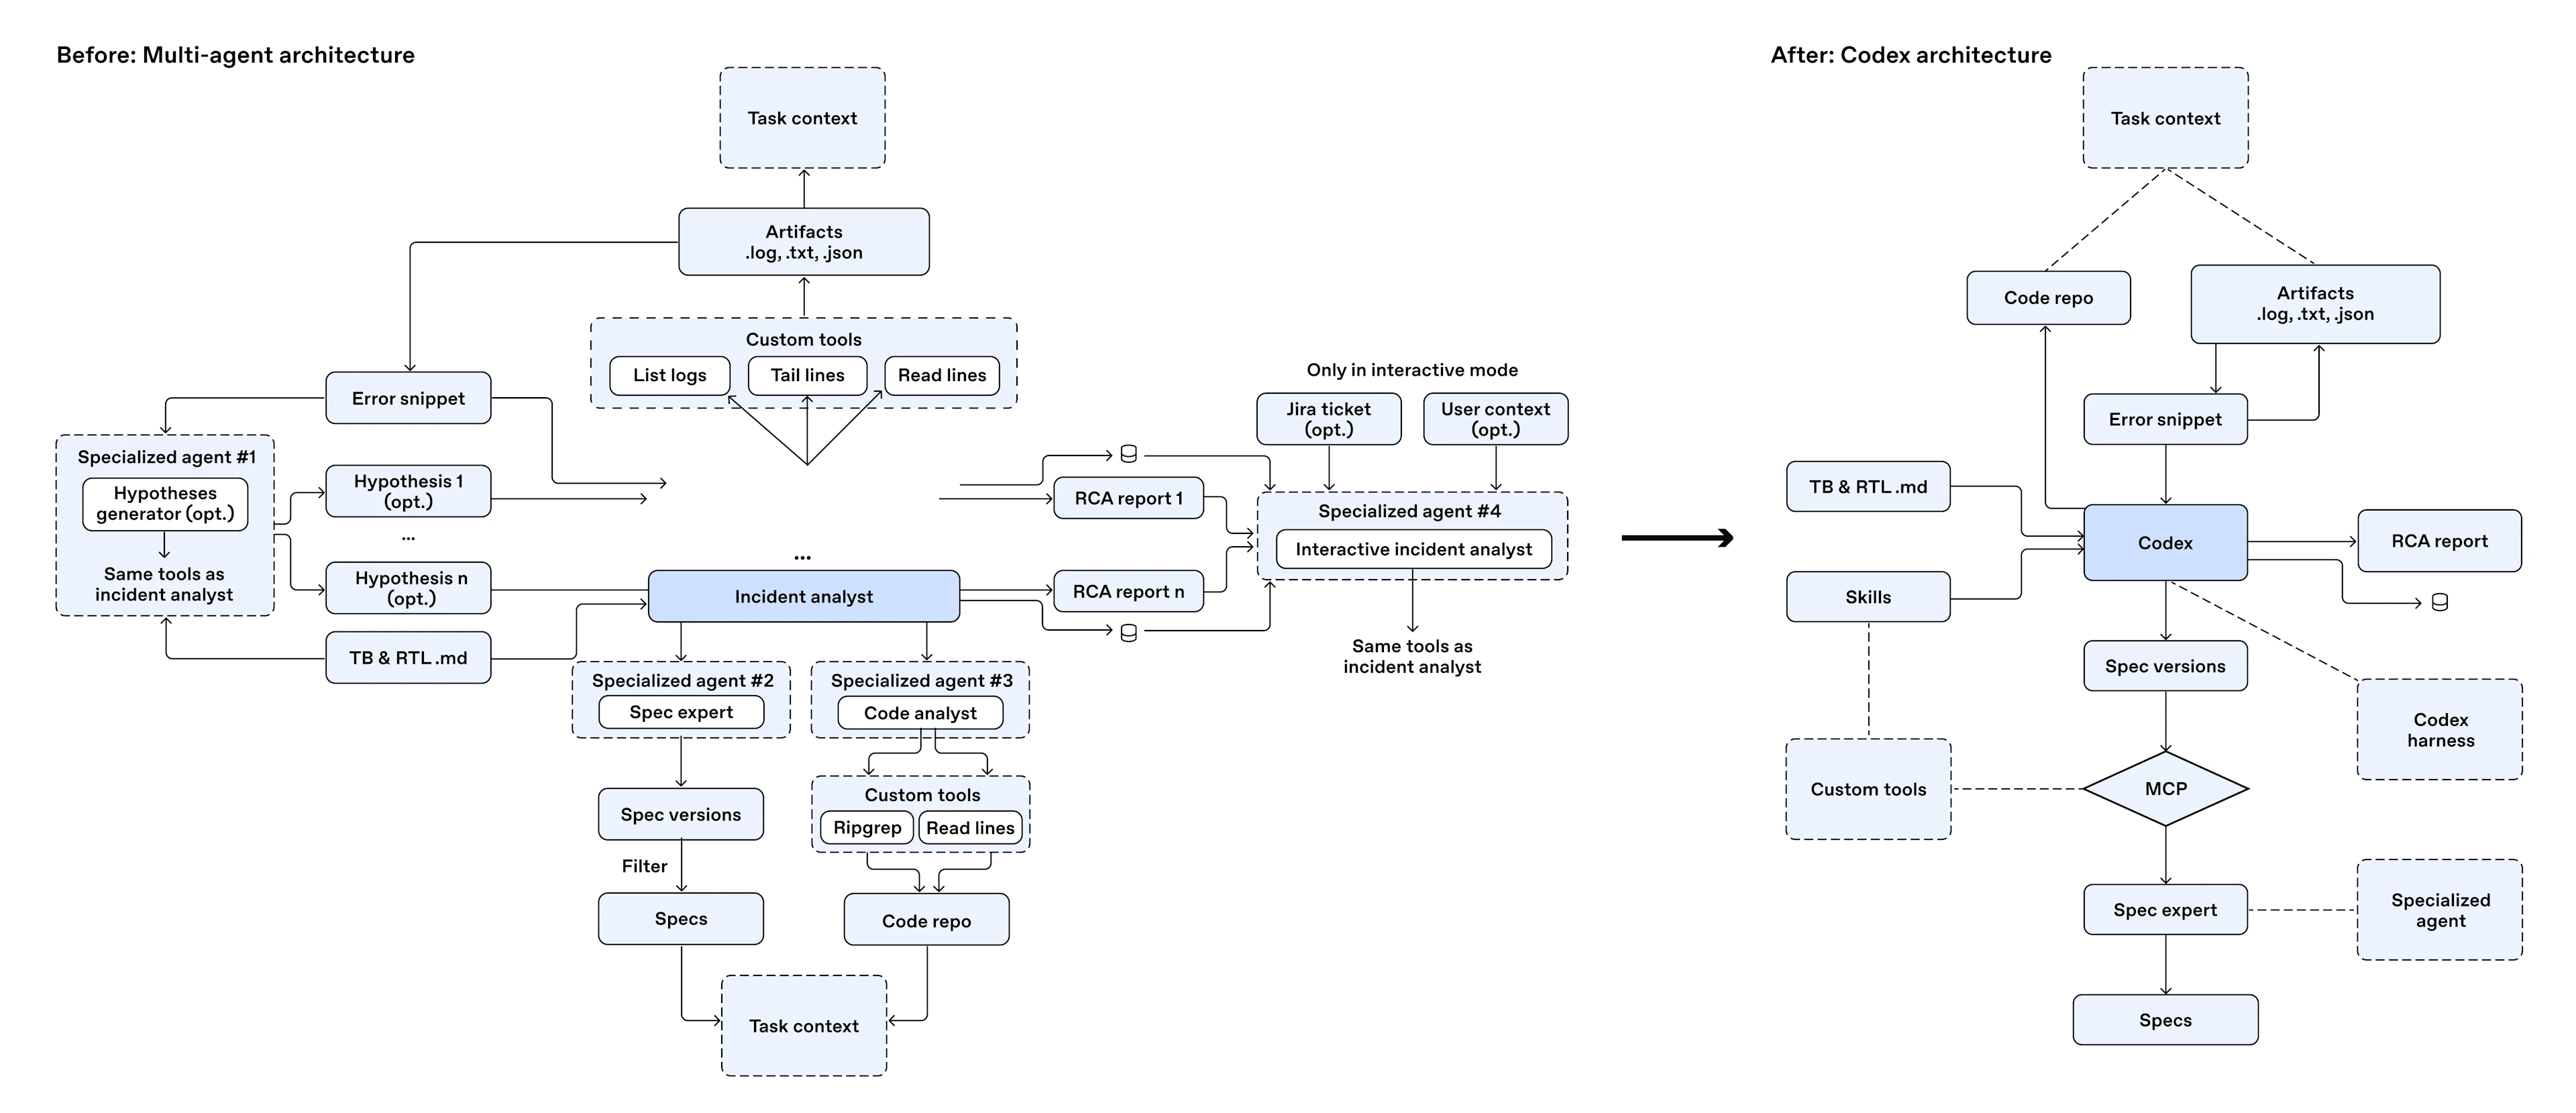
Do takrat je Codex že postal zmogljivejši. Eden od implementacijskih inženirjev je preizkusil prenovo aplikacije na njegovi osnovi, nato pa je z ekipo primere uporabe prenesel na skupno ogrodje s sistemom Codex v jedru.
Prilagojene aplikacije so postale vtičniki in veščine, zgrajeni na skupnih osnovnih gradnikih sistema Codex. Codex je postal tudi vmesnik, zato smo lahko opustili ločene terminalske uporabniške vmesnike in vmesnike ukazne vrstice, ki smo jih razvili za posamezne primere uporabe.
Iz vsakega projekta smo lahko odstranili približno 90 % prilagojene kode. To je spremenilo način, kako smo te delovne tokove gradili, vzdrževali in širili:
Izkoristili smo lahko centralne izboljšave sistema Codex in zmanjšali količino povezovalne kode, potrebne za vsak posamezen primer uporabe
Ključne funkcije smo združili v veščine in vtičnike, kar je olajšalo njihovo medsebojno deljenje in osrednji nadzor v okviru centra odličnosti za umetno inteligenco. To je pomenilo, da je bilo za prenos na drugo ekipo včasih treba le zamenjati povezovalnike oziroma strežnike MCP, pripraviti nove evalvacije (za kar smo prav tako imeli veščino) in začeti uporabljati rešitev.
V enem od primerov iz avgusta 2026 je začetna uvedba trajala dva meseca. Razširitev rešitve na drugo ekipo je trajala en dan. Z večanjem obsega so se naslednje ekipe vključevale hitreje. Ta trend se nadaljuje: pri enem od primerov uporabe avgusta 2026 je uvedba za drugo ekipo trajala en dan, potem ko je začetna uvedba zahtevala dva meseca.
To je eden od načinov, kako poskrbimo, da nas ne potrebujejo več. Delo, ki smo ga opravili do uvedbe v produkcijo, je pokazalo, kaj je pomembno. Ko se je osnovni izdelek izboljševal, smo lahko nadomestili velik del svoje prilagojene implementacije in ohranili vrednost, ki jo je prinašala.
Zato je vrstni red pomemben. Veliki jezikovni modeli nam omogočajo hiter razvoj. Izkoristite to hitrost, da uporabnikom ponudite nekaj koristnega, ugotovite, kaj se obnese v praksi, in nato razširite tisto, kar deluje.
Isto načelo velja za vse projekte s strankami.
OpenAI Presence, naš izdelek za glasovne in klepetalnice v podjetjih, je nastal iz dejanskih uvedb strank. Delo se je začelo s Swarmom(odpre se v novem oknu) in se razvijalo skozi API za agente in danes ena stranka več kot polovico svojih klicev obravnava z umetno inteligenco.
Z uvedbo teh uvedb v produkcijo smo se naučili, katere težave potrebujejo prilagojeno rešitev in katere gradnike lahko uporabijo druge ekipe. Te gradnike smo vključili v Presence, kar je razvijalcem olajšalo avtomatizacijo reguliranih delovnih procesov, ne da bi morali ponovno graditi osnovno infrastrukturo. Vsaka uvedba je pomagala oblikovati izdelek in naslednji stranki dala boljše izhodišče.
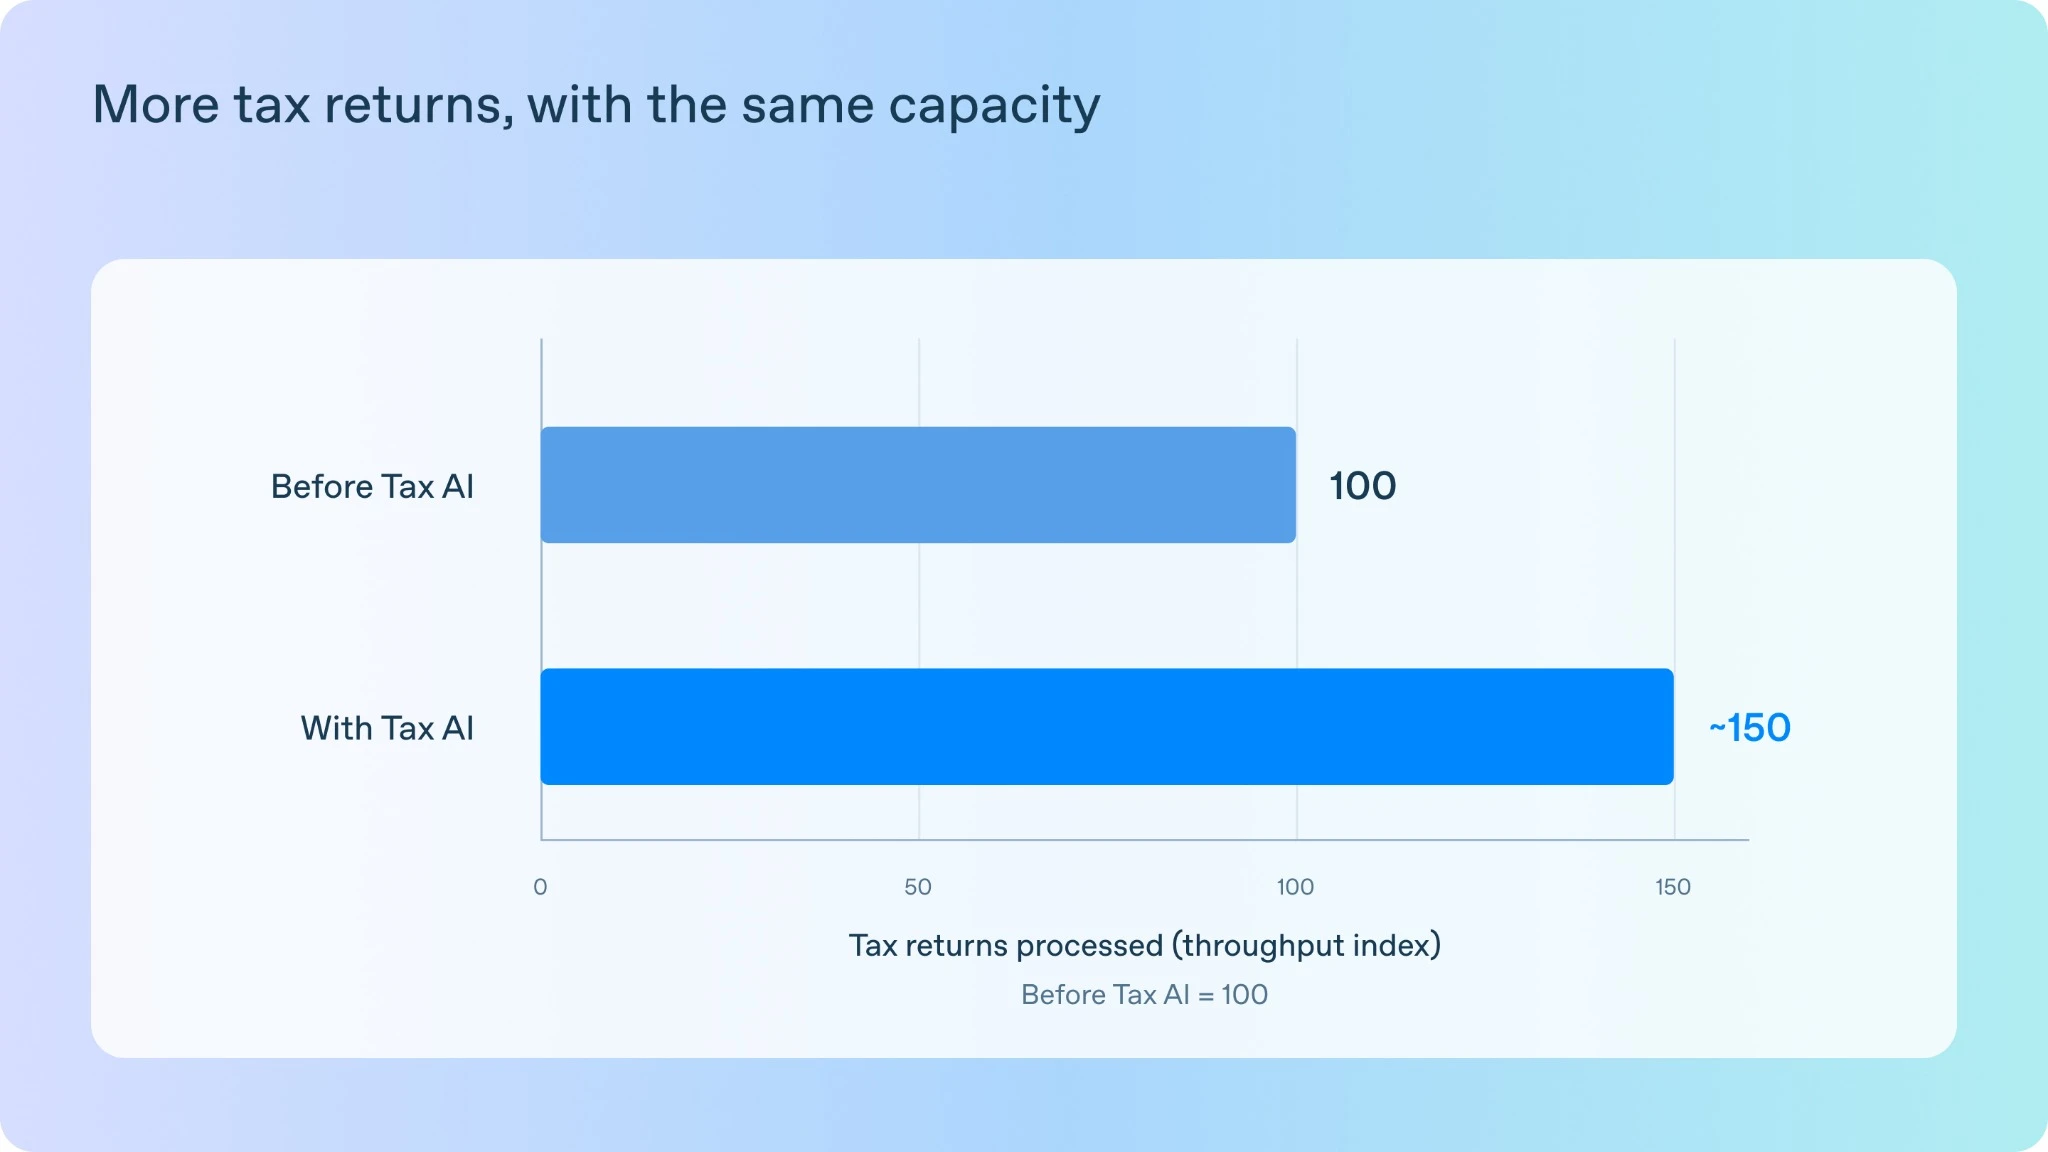
V sklopu pobude Thrive Holdings so neodvisni strokovnjaki za razvoj (FDE) in raziskovalci pri OpenAI sodelovali z inženirji in računovodji pri izgradnji davčne umetne inteligence za računovodska podjetja na Kreti. Med pilotnim projektom je davčna umetna inteligenca obdelala 7000 davčnih napovedi in povečala prepustnost za približno 50 %.
Eden najtežjih izzivov je bila avtomatizacija vračil nepremičnin za najem, kar je zahtevalo šest tednov inženirskega in praktičnega pregleda, da bi dosegli 90-odstotno natančnost in odpoklic. Delo je ustvarilo vzorce za večkratno uporabo, ki so olajšali razširitev davčne umetne inteligence na druge kompleksne davčne sezname.
Ekipe zdaj uporabljajo enak pristop k knjigovodstvu, reviziji in IT-podpori – gradijo sisteme, ki se izboljšujejo s povratnimi informacijami strokovnjakov in uporabo v resničnem svetu.
Včasih nam boljši izdelek omogoči poenostaviti zgrajeno rešitev, včasih pa model sam še ni kos nalogi.
Če gradimo le tisto, kar današnji modeli že omogočajo, ne bomo odkrili vrzeli v zmožnostih, ki jih mora raziskovalna ekipa odpraviti v naslednjem koraku. Zato se številni naši pomembni projekti začnejo prav na teh mejah, pri čemer se stranka, implementacijski inženirji in raziskovalna ekipa zavežejo, da jih bodo skupaj premagali.
Z veliko stranko iz telekomunikacijske panoge smo že razvili platformo za podporo uporabnikom, ki jo je želela razširiti še na glasovno komunikacijo.
Glasovni klici so predstavljali približno 90 % vseh stikov z njihovo podporo uporabnikom. Samodejno reševanje teh primerov je bilo dražje kot pri klepetu. Prineslo je tudi vrsto novih tehničnih izzivov: obravnavo naglasov, ton, zakasnitev in točnost je bilo treba izboljšati na raven, primerno za produkcijsko uporabo. Uspešna rešitev bi pomembno vplivala na njihovo poslovanje.
Med opredeljevanjem obsega projekta je naš model dosegel približno 60 % na ključnih evalvacijah, s katerimi smo ocenjevali, ali lahko nalogo opravlja v produkciji. Dosegli smo meje njegovih zmožnosti. Izboljšati je bilo treba priklic funkcij in sledenje navodilom pri podpori uporabnikom.
To smo pojasnili stranki in v delo vključili raziskovalno ekipo. Implementacijski inženirji (FDE) so s stranko zgradili platformo in opredelili, kaj mora model znati. Raziskovalna ekipa je odpravljala vrzeli v zmožnostih, zaporedne različice modela pa so nam omogočale preverjanje napredka glede na zahteve stranke.
V šestih mesecih se je uspešnost na ključnih evalvacijah zvišala s približno 60 % na 80 % in nato na več kot 90 %, s čimer je dosegla raven, potrebno za produkcijsko uporabo.
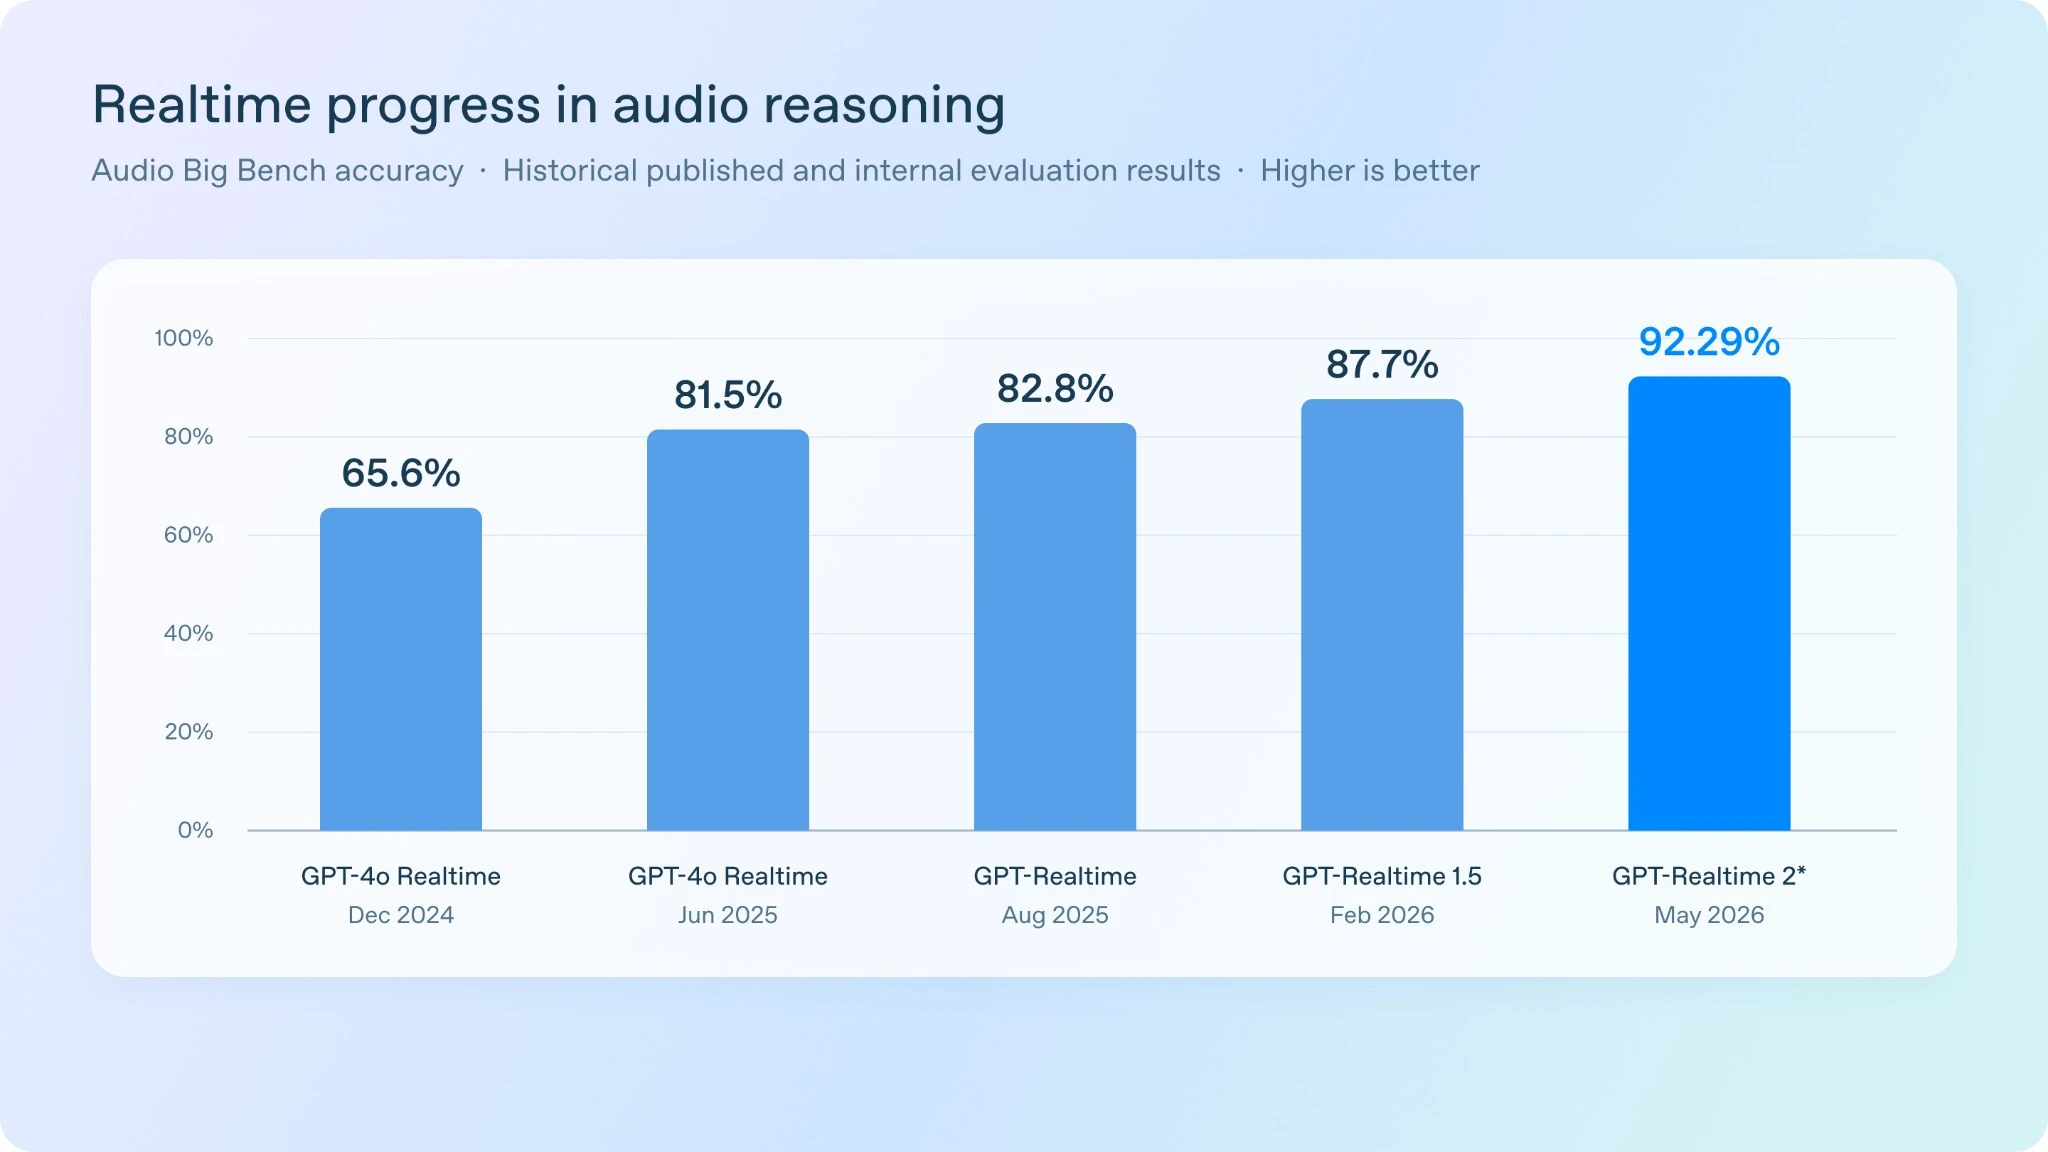
Tako razviti glasovni model zdaj podpira rešitev te stranke, druge prilagojene rešitve za podporo uporabnikom in upravljane uvedbe prek izdelka Presence. Težava, s katero se je srečevala ena stranka, nam je pomagala prepoznati izboljšave, ki lahko koristijo številnim drugim.
Vsak prispevek je bil pomemben. Stranka se je zavezala k sodelovanju pri reševanju težave, ki ji model še ni bil kos. Implementacijski inženirji so tesno sodelovali s stranko, da so lahko opredelili težavo, zgradili platformo in vodili projekt od začetka do konca. Raziskovalna ekipa je izboljšala zmožnosti osnovnega modela.
To je drugi način, kako poskrbimo, da nas ne potrebujejo več: pomagamo razviti zmožnosti, s katerimi bodo prihodnji modeli lahko reševali težave, ki jim današnji še niso kos. Koristi našega dela segajo onkraj ur, ki jih preživimo s posamezno stranko.
Družbi OpenAI sem se pridružil, da bi pomagal umetno inteligenco narediti uporabno pri vsakdanjem delu ljudi. To ekipo vodi še danes. Ekipi pogosto pravim, da pri razvoju velikih jezikovnih modelov večinoma velja Occamova britev: najpreprostejša rešitev je najboljša. V družbi, ki jo zaznamujejo vrhunske raziskave, in panogi, ki jo pogosto spremljajo pretirane trditve, želimo graditi rešitve, ki delujejo zanesljivo in na katere se lahko ljudje zanesejo pri delu v praksi.
Cilj je, da vsak projekt izboljša izhodišče za naslednjega: z izdelkom, ki ga je lažje uvesti, modelom, ki je kos težji nalogi, ali manj prilagojenega dela za naslednjo stranko.
Če želite rešiti težaven problem, bomo z veseljem sodelovali z vami. Če želite pomagati reševati takšne probleme, bomo veseli, če se nam pridružite.
Kaj torej naredimo, ko Codex zmore opraviti delo, za katero smo rešitev gradili več mesecev?
Poiščemo težji problem.