O papel de um Forward Deployed Engineer na OpenAI
O que fazemos, como trabalhamos e como resolvemos os problemas mais difíceis das empresas para gerar um impacto real.
Por: Colin Jarvis, responsável pela engenharia no terreno na OpenAI
Quando o Codex foi lançado, alguém da equipa perguntou-me: «O que fazemos quando o Codex conseguir resolver, numa só tentativa, os casos de uso que passámos os últimos meses a desenvolver?»
Essa pergunta vai ao cerne do que significa ser Forward Deployed Engineer na OpenAI. Trabalhamos lado a lado com os clientes para compreender os seus problemas mais difíceis e criar soluções em que possam confiar. O que aprendemos ajuda a moldar os nossos produtos e dá à equipa de Investigação problemas concretos para resolver.
Isso é progresso. Se nos tornamos dispensáveis de poucos em poucos meses, a nossa equipa de Forward Deployed Engineers está a cumprir o seu papel.
Fundei a equipa no início de 2025 para colmatar o que chamamos «o fosso da implementação»: a distância entre aquilo de que os modelos parecem ser capazes e aquilo que as pessoas conseguem usar de forma fiável no seu trabalho.
As capacidades dos modelos evoluíram mais depressa do que os sistemas e processos necessários para as pôr em prática. Por vezes, a peça que falta é um produto. Noutras, um modelo tem um bom desempenho num teste de referência, mas não consegue desempenhar a tarefa com as variáveis e restrições do mundo real.
Concentramo-nos nos problemas mais difíceis dos clientes. Quando os nossos modelos já conseguem desempenhar a tarefa, trabalhamos com a equipa de Produto e com o cliente para tornar a solução replicável. Quando ficam aquém, trabalhamos com os clientes e com a equipa de Investigação para identificar a lacuna e introduzir melhorias. Queremos que cada projeto dê ao cliente seguinte um melhor ponto de partida. Se elevarmos o nível de base ao ponto de os clientes deixarem de precisar de Forward Deployed Engineers para resolver este tipo de problema, teremos feito bem o nosso trabalho.
O desafio da John Deere, uma empresa do setor agrícola com 200 anos, era levar aconselhamento personalizado a mais agricultores.
Um exemplo é o See & Spray, a sua tecnologia de precisão para controlo de ervas daninhas, que usa câmaras e aprendizagem automática para identificar e pulverizar as ervas daninhas, em vez de tratar campos inteiros, reduzindo a utilização de produtos químicos em até 70%.
Mas concretizar esses benefícios depende de os agricultores saberem configurar a tecnologia, planear a campanha agrícola e ajustar as suas práticas à medida que as condições mudam.
A John Deere implementou as API da OpenAI para ajudar a tornar esse apoio personalizado e escalável.
A IA pode responder às perguntas dos agricultores em linguagem natural, fornecer orientações de configuração e recomendações adaptadas às suas necessidades, identificar quando o equipamento poderá não estar a dar o máximo e ajudar os agricultores a perceber o valor que estão a obter da tecnologia.
A oportunidade vai além de uma interação isolada: oferecer orientações relevantes ao longo de todo o percurso do cliente, ajudando os agricultores a tirar mais partido do equipamento e a melhorar a eficiência e a sustentabilidade.
É este o tipo de desafio que os Forward Deployed Engineers da OpenAI procuram resolver: ajudar as organizações a transformar as capacidades da IA em sistemas que gerem valor prático em ambientes reais e complexos.
Mas, muitas vezes, os problemas estão totalmente em aberto, pode não haver uma verdade de referência estabelecida e não existe um guião a seguir. Todos querem criar algo que nunca existiu. São menos os que querem fazer o necessário para lá chegar.
Encontrar Forward Deployed Engineers talentosos e, ao mesmo tempo, elevar o patamar do que é «suficientemente bom» tem exigido experimentação e aplicação constantes.
No início de cada sessão da equipa de Forward Deployed Engineers, mostro um diapositivo com um valor fundamental: «Começar pelo resultado, fazer o que for preciso para ter sucesso e, depois, aumentar a escala».
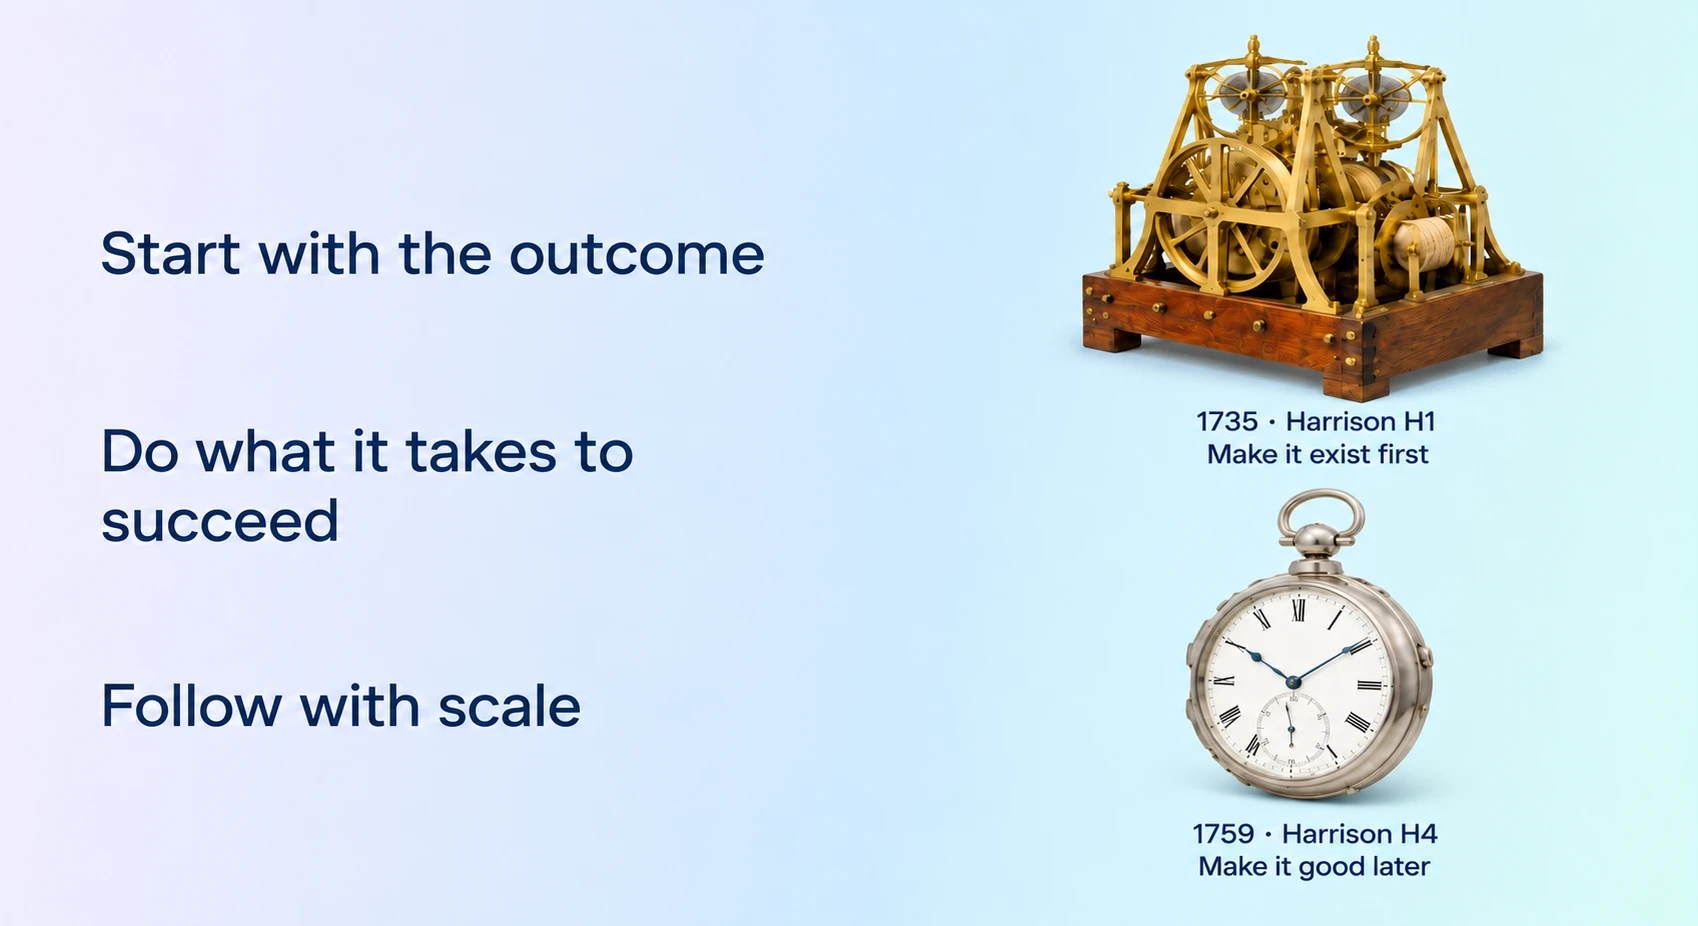
Uma demonstração impressionante pode abrir muitas portas antes de alguém perguntar se funciona no mundo real.
O nosso trabalho é resolver o problema do cliente com um nível de qualidade que possamos garantir em produção.
Em meados de 2025, tínhamos cerca de 15 Forward Deployed Engineers a trabalhar com um grande cliente do setor dos semicondutores em mais de 10 casos de uso. A ambição era tornar a IA parte integrante do processo de verificação, abrangendo:
Geração de testes direcionados
Análise de causas-raiz e depuração
Um assistente de arquitetura
Neste setor, a verificação pode representar cerca de 70% do esforço de um projeto. A oportunidade era enorme e havia muitos pontos de partida possíveis.
Alguns Forward Deployed Engineers tinham entrado na OpenAI poucos dias antes e nunca tinham trabalhado no setor dos semicondutores. Integraram-se na equipa de verificação do cliente, estudaram conceção de chips no tempo livre e criaram avaliações com os engenheiros para testar se a IA conseguia gerar testes úteis e diagnosticar corretamente falhas nos chips.
Em paralelo com essa aprendizagem, criámos harnesses personalizados para cada caso de uso. Nos primeiros 3 a 6 meses, todos chegaram à produção e começaram a ser adotados pelos utilizadores. A recompensa veio ao ver as métricas:
Cerca de 48% de tempo poupado com a geração de testes direcionados baseada em IA.
Melhoria mediana de 22% no desempenho através da otimização de kernels.
Semanas de depuração reduzidas a horas
Quando apresentámos todos estes resultados, o diretor de Hardware perguntou: «Já trabalhavam na conceção de chips antes de virem para cá?»
Os nossos Forward Deployed Engineers não precisam de conhecer o setor no primeiro dia, mas têm a responsabilidade de aprender.
À medida que os assistentes de programação aceleram o desenvolvimento de software, compreender o negócio do cliente torna-se ainda mais importante. Formamos equipas que combinam generalistas e especialistas de cada área.
É preciso ter conhecimento suficiente para tomar decisões fundamentadas e curiosidade suficiente para questionar os pressupostos sobre a forma como as coisas são feitas.
Nas ciências da vida, por exemplo, a formação científica dos nossos Forward Deployed Engineers ajuda-os a conquistar a confiança de investigadores que trabalham na descoberta pré-clínica de fármacos, em tarefas como a validação e priorização de alvos, a análise da expressão génica e a reconstrução de vias de síntese química. Esse conhecimento especializado permite-lhes contribuir com uma perspetiva fundamentada sobre como melhorar esses fluxos de trabalho.
Tínhamos demonstrado que estes fluxos de trabalho podiam gerar valor, mas cada um ainda exigia demasiado trabalho de integração personalizada para ser alargado a outra equipa. O desafio seguinte era preservar esses resultados e, ao mesmo tempo, tornar o software mais fácil de implementar e manter.
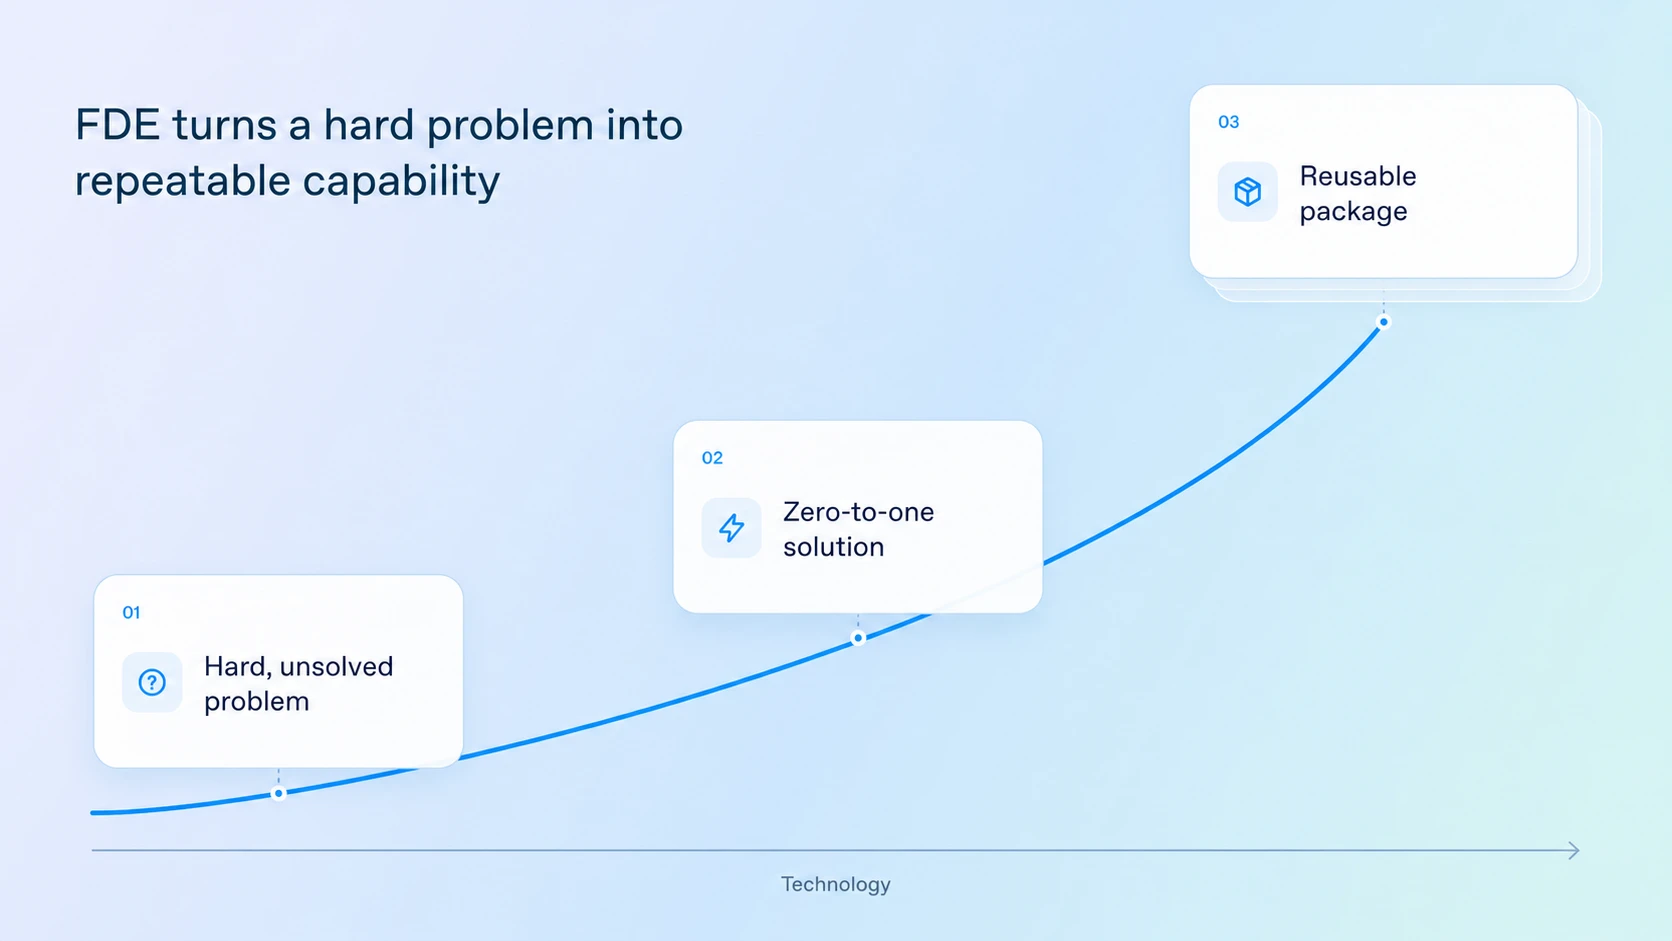
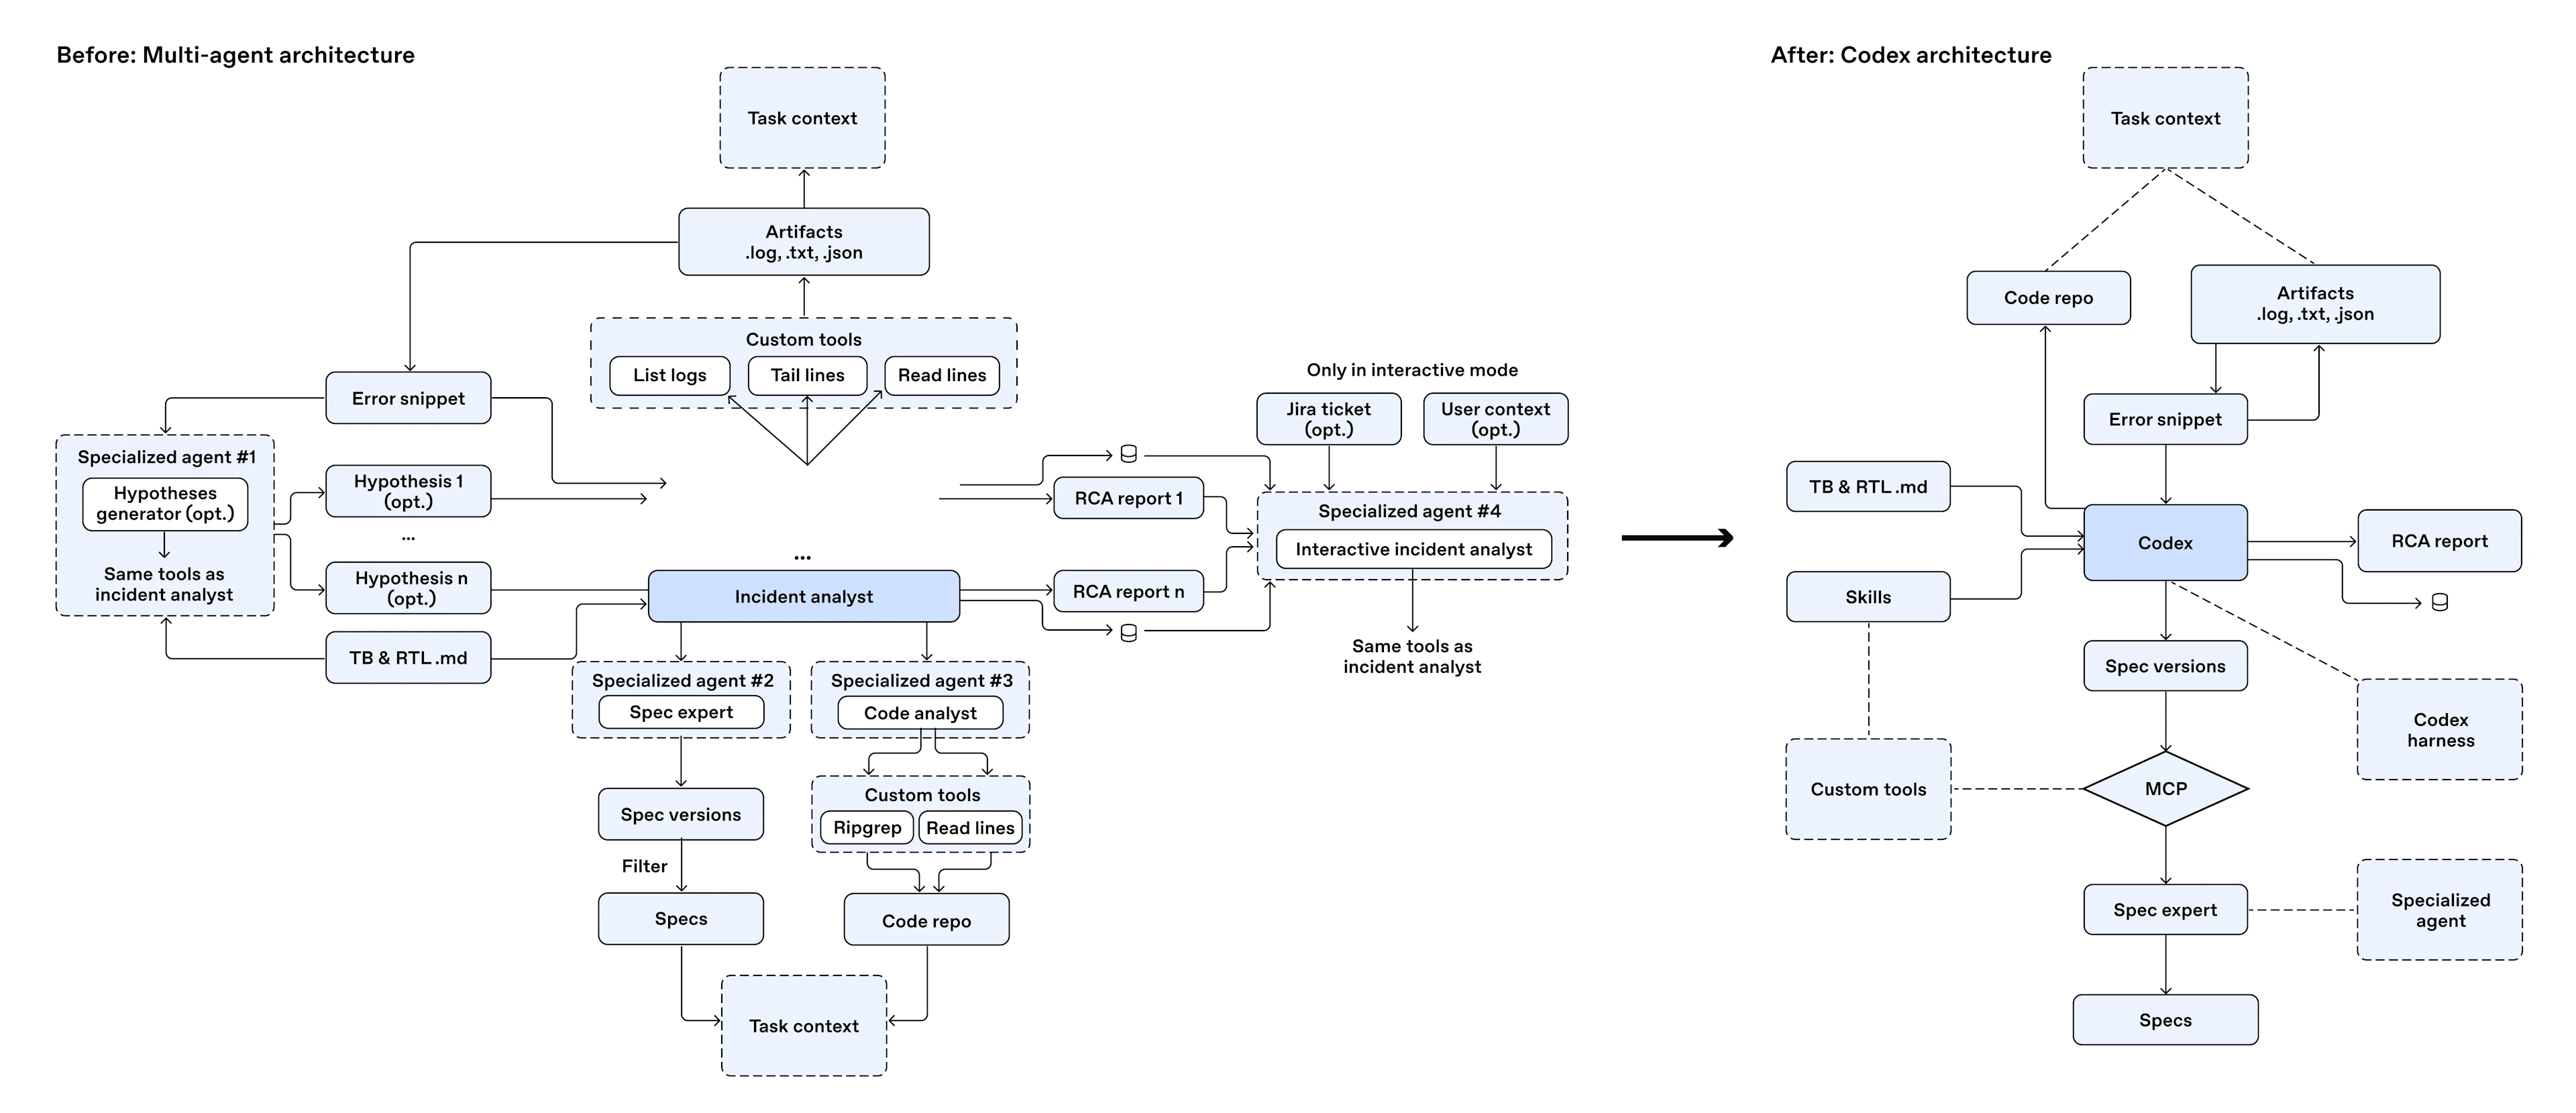
Entretanto, as capacidades do Codex tinham evoluído. Um Forward Deployed Engineer experimentou reconstruir a sua aplicação com base no Codex e, depois, trabalhou com a equipa para migrar os casos de uso para um harness comum, centrado no Codex.
As aplicações personalizadas tornaram-se plugins e competências criados a partir das mesmas primitivas do Codex. O Codex passou também a ser a interface, permitindo-nos descontinuar as interfaces de terminal e de linha de comandos separadas que tínhamos desenvolvido para cada caso de uso.
Conseguimos eliminar cerca de 90% do código personalizado de cada projeto, o que mudou a forma como criávamos, mantínhamos e expandíamos estes fluxos de trabalho:
Passámos a beneficiar de melhorias centralizadas no Codex, reduzindo a quantidade de código de ligação necessária para cada caso de uso
As principais funcionalidades foram reunidas em competências e plugins, facilitando a partilha entre equipas e o controlo centralizado pelo Centro de Excelência em IA. Assim, alargar a solução de uma equipa para outra podia ser tão simples como substituir os conectores ou servidores MCP, criar novas avaliações (para as quais também tínhamos uma competência) e começar a trabalhar.
Num exemplo de agosto de 2026, a implementação inicial demorou dois meses. Alargar a solução a uma segunda equipa demorou um dia. À medida que aumentávamos a escala, as equipas seguintes começavam a usar a solução mais depressa. Essa tendência manteve-se: num caso de uso em agosto de 2026, a segunda equipa precisou de 1 dia, após uma implementação inicial de 2 meses.
Esta é uma das formas de nos tornarmos dispensáveis. O trabalho que tínhamos feito para chegar à produção permitiu identificar o que realmente importava. À medida que o produto de base melhorava, podíamos substituir grande parte da nossa implementação personalizada e preservar o valor que gerava.
É por isso que a ordem importa. Os LLM permitem-nos desenvolver rapidamente. Use essa rapidez para pôr algo de valor nas mãos dos utilizadores, perceber o que resiste à prova da prática e, depois, aumentar a escala do que funciona.
O mesmo princípio aplica-se a todos os projetos com clientes.
O OpenAI Presence, o nosso produto para agentes de voz e chat empresariais, surgiu a partir de implementações reais em clientes. O trabalho começou com o Swarm(abre numa nova janela) e evoluiu através da API de agentes e, hoje, um cliente já gere mais de metade das suas chamadas com IA.
Ao colocar estas implementações em produção, aprendemos quais os problemas que exigiam uma solução personalizada e quais os componentes básicos que outras equipas poderiam utilizar. Incorporamos estes elementos básicos no Presence, facilitando aos programadores a automatização de fluxos de trabalho regulamentados sem a necessidade de reconstruir a infraestrutura subjacente. Cada implementação ajudou a moldar o produto e proporcionou ao cliente seguinte um melhor ponto de partida.
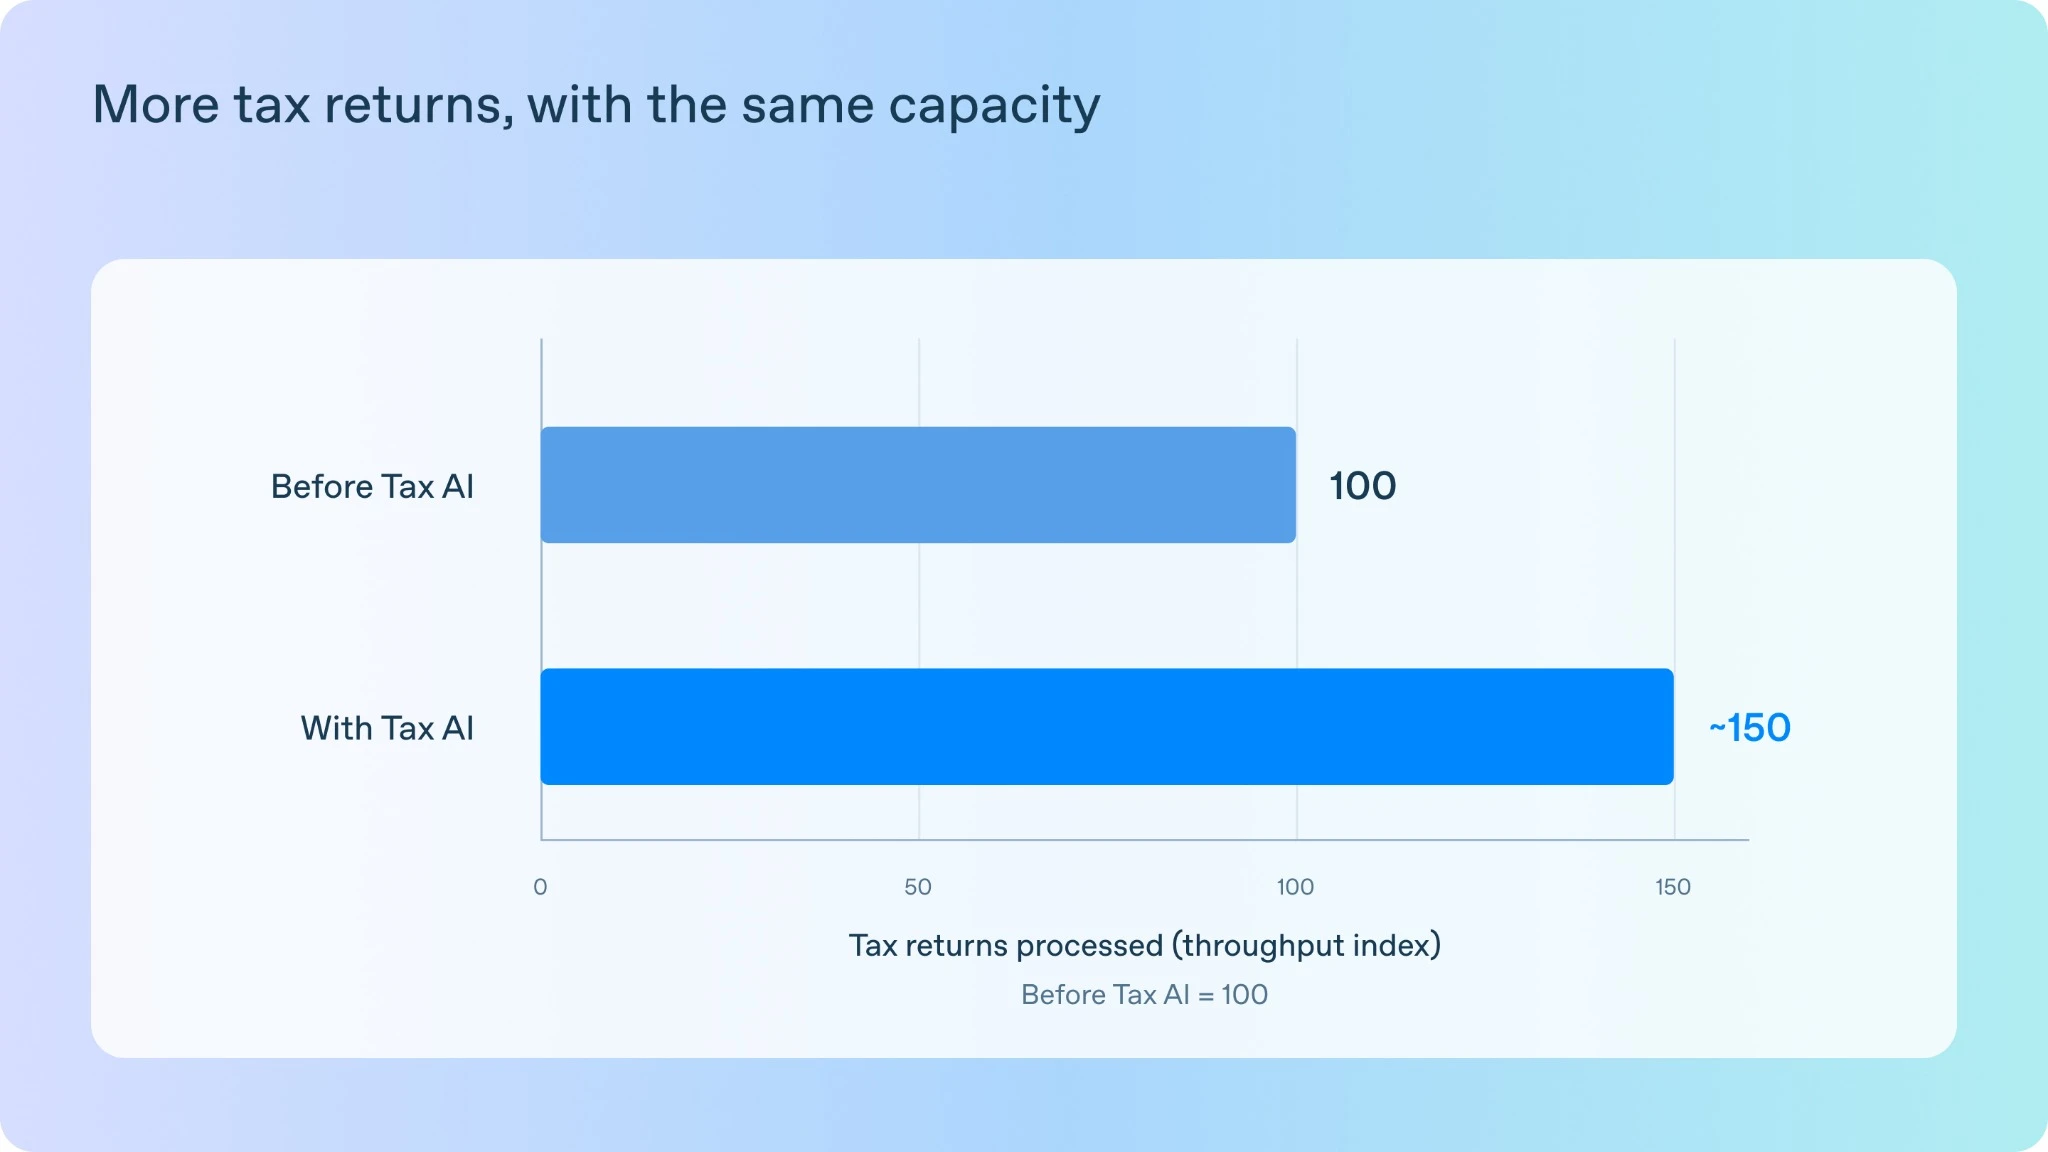
Com a Thrive Holdings, os funcionários de desenvolvimento de campo (FDEs) da OpenAI e investigadores trabalharam em conjunto com engenheiros e contabilistas para desenvolver uma IA fiscal para os gabinetes de contabilidade da Crete. Durante o projeto-piloto, a Tax AI processou 7.000 declarações fiscais e aumentou a taxa de processamento em cerca de 50%.
Um dos maiores desafios foi automatizar a declaração de impostos sobre imóveis arrendados, o que exigiu seis semanas de trabalho de engenharia e de revisão por profissionais da área para atingir 90% de precisão e recall. O trabalho criou padrões reutilizáveis que facilitaram a extensão da Tax AI a outros anexos complexos das declarações fiscais.
As equipas estão agora a aplicar a mesma abordagem à contabilidade, auditoria e suporte de TI — construindo sistemas que melhoram através do feedback dos profissionais e da utilização no mundo real.
Por vezes, um produto melhor permite-nos simplificar o que construímos, mas, noutras, o próprio modelo ainda não consegue desempenhar a tarefa.
Se nos limitarmos a construir o que os modelos atuais já permitem, não descobriremos as lacunas de inteligência que a equipa de Investigação precisa de colmatar a seguir. Por isso, muitos dos nossos projetos mais importantes começam nesses limites, com o cliente, os Forward Deployed Engineers e a equipa de Investigação empenhados em ultrapassá-los em conjunto.
Já tínhamos desenvolvido uma plataforma de apoio ao cliente com um grande cliente do setor das telecomunicações, que queria alargá-la ao canal de voz.
O canal de voz representava cerca de 90% do volume de contactos de apoio ao cliente. Resolver estes casos sem intervenção humana era mais dispendioso do que no chat e trazia novos desafios técnicos: lidar com sotaques, acertar no tom e alcançar os níveis de latência e exatidão necessários para utilização em produção. Conseguir fazê-lo bem teria um impacto significativo no negócio do cliente.
Durante a definição do âmbito do projeto, o nosso modelo obteve cerca de 60% nas principais avaliações que usámos para determinar se conseguiria desempenhar a tarefa em produção. Tínhamos atingido os limites das suas capacidades. Era preciso melhorar a chamada de funções e o cumprimento de instruções em cenários de apoio ao cliente.
Explicámos isso ao cliente e envolvemos a equipa de Investigação no trabalho. A equipa de Forward Deployed Engineers trabalhou com o cliente para construir a plataforma e definir o que o modelo precisava de fazer. A equipa de Investigação trabalhou para colmatar as lacunas de capacidade, e as sucessivas versões do modelo permitiram-nos avaliar o progresso face aos requisitos do cliente.
Ao longo de seis meses, o desempenho nas principais avaliações subiu de cerca de 60% para 80% e, depois, para mais de 90%, atingindo os níveis necessários para utilização em produção.
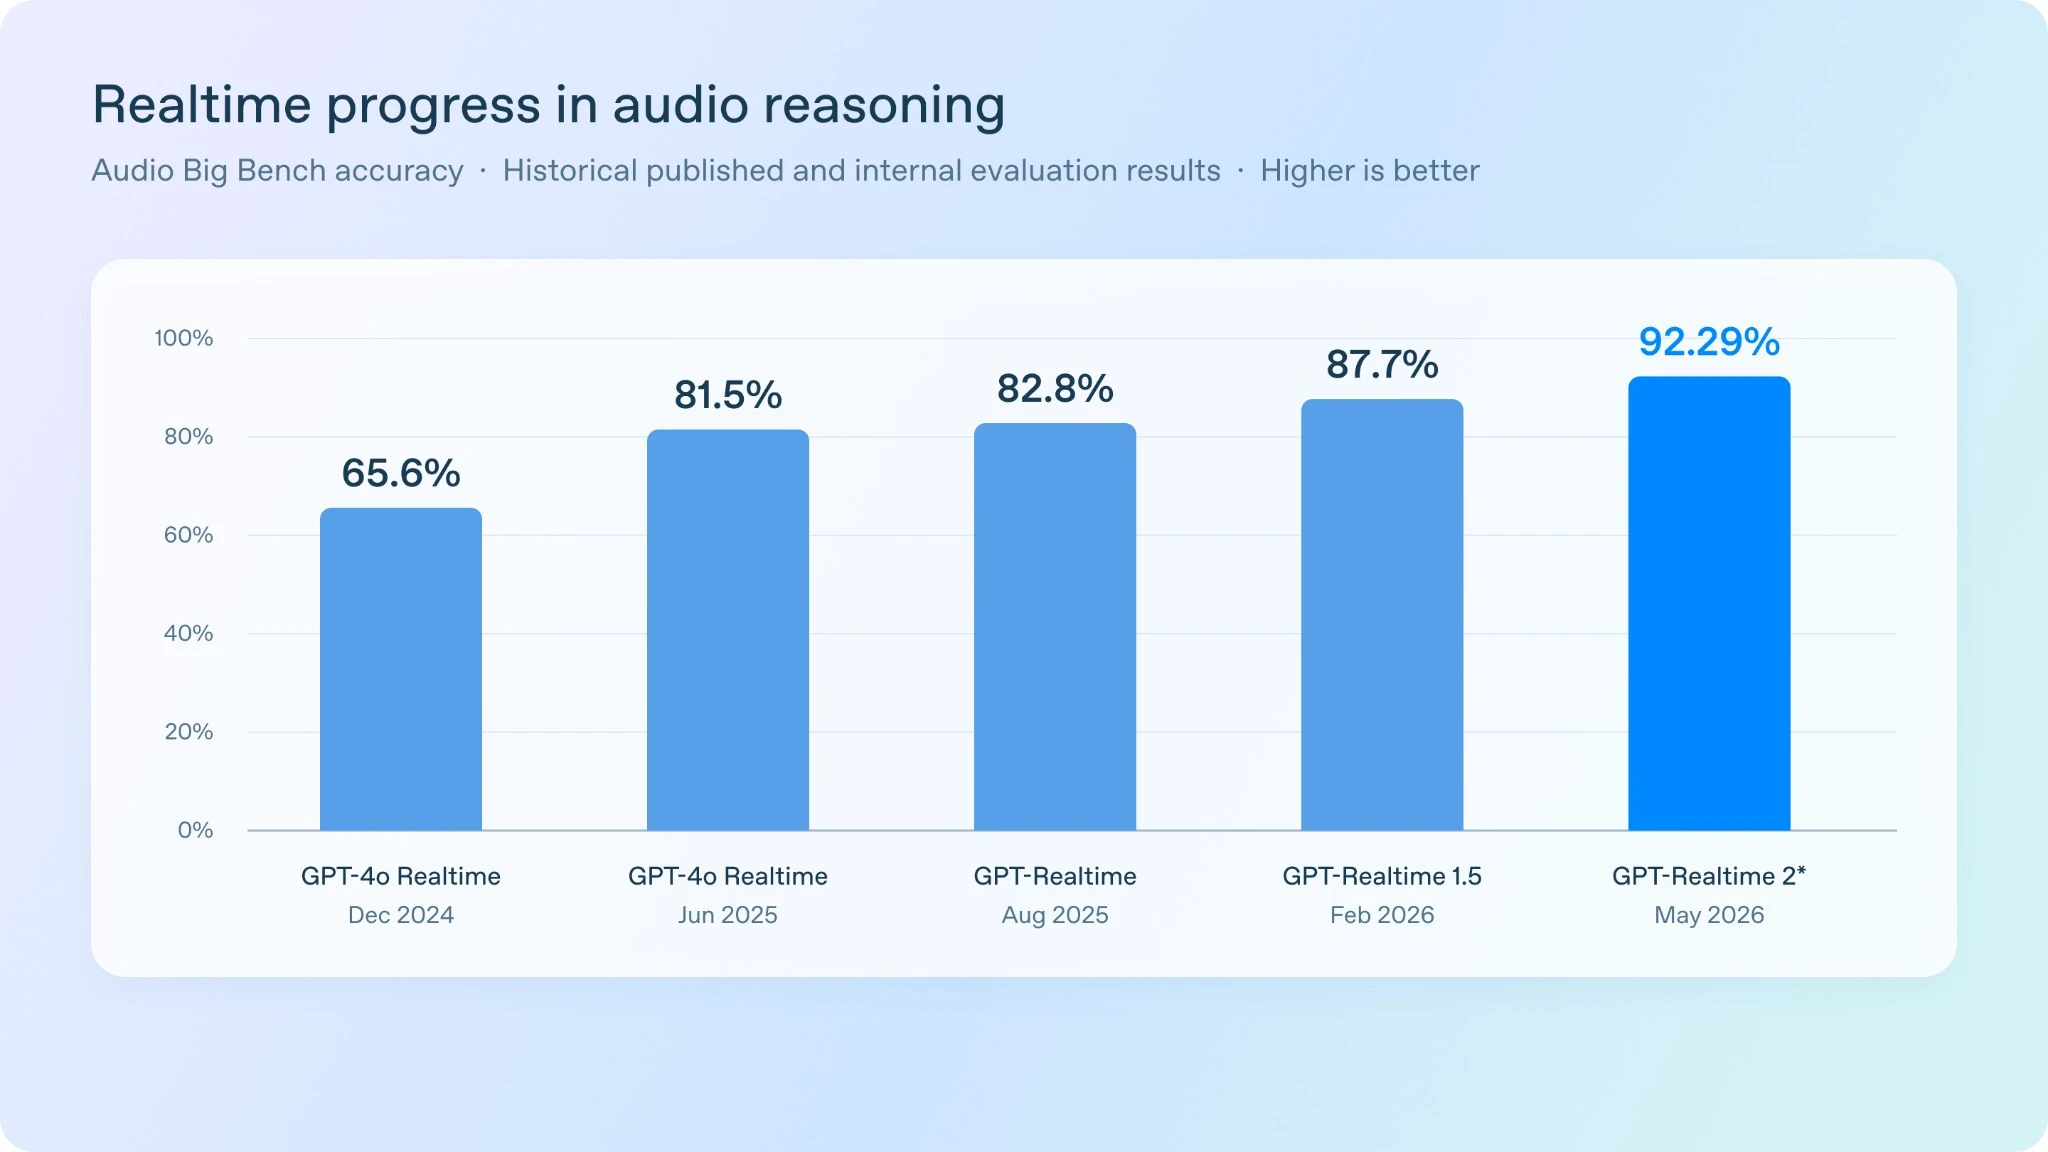
O modelo de voz resultante serve agora de base à implementação desse cliente, a outras implementações personalizadas de apoio ao cliente e a implementações geridas através do Presence. Um problema encontrado no negócio de um cliente ajudou a identificar melhorias que poderiam beneficiar muitos outros.
Cada contributo foi importante. O cliente comprometeu-se a trabalhar num problema que o modelo ainda não conseguia resolver. A equipa de Forward Deployed Engineers manteve a proximidade necessária para definir o problema, construir a plataforma e conduzir o projeto do princípio ao fim. A equipa de Investigação melhorou as capacidades do modelo subjacente.
Esta é a outra forma de nos tornarmos dispensáveis: ajudar a transformar um problema que os modelos atuais não conseguem resolver numa capacidade que os modelos futuros poderão oferecer. O retorno do nosso trabalho vai além das horas que dedicamos a cada cliente.
Entrei na OpenAI para ajudar a tornar a IA útil no trabalho diário das pessoas. É isso que continua a orientar a equipa. Digo muitas vezes à equipa que, na maioria dos casos de desenvolvimento de LLM, se aplica a navalha de Occam: a solução mais simples é a melhor. Numa empresa que se define pela investigação de ponta e num setor marcado por exageros, queremos criar soluções fiáveis, com as quais quem trabalha no terreno possa contar.
O objetivo é que cada projeto melhore o que vem a seguir: um produto mais fácil de implementar, um modelo capaz de lidar com uma tarefa mais difícil ou menos trabalho personalizado para o próximo cliente.
Se tem um problema difícil que quer resolver, gostaríamos muito de trabalhar consigo. Se quer ajudar a resolver esses problemas, gostaríamos muito que se juntasse a nós.
Então, o que fazemos quando o Codex consegue executar o trabalho que passámos meses a desenvolver?
Vamos à procura do problema mais difícil.