Gwida komuni għal evalwazzjonijiet affidabbli minn partijiet terzi
X’inhu importanti għal evalwazzjonijiet indipendenti effettivi ta’ salvagwardji u kapaċitajiet għal mudelli fruntiera.
Evalwazzjonijiet indipendenti u fdati minn partijiet terzi għandhom rwol kritiku fit-tisħiħ tal-ekosistema tas-sikurezza. Dawn l-evalwazzjonijiet isiru fuq mudelli fruntiera biex jipprovdu evidenza addizzjonali għal pretensjonijiet dwar kapaċitajiet kritiċi u mitigazzjonijiet tas-sikurezza. F’din il-kariga, naqsmu lezzjonijiet li tgħallimna s’issa, u nirrakkomandaw approċċi għat-tfassil ta’ evalwazzjonijiet li jistgħu jivvalutaw b’mod validu mudelli fruntiera u li nittamaw jgħinu biex jinfurmaw standards emerġenti f’dan il-qasam.
Qabel, ħafna evalwazzjonijiet kienu jittrattaw il-mudelli bħal chatbots: l-evalwazzjoni kienet tagħti prompt lil mudell bħallikieku kien utent li qed jistaqsi mistoqsija, il-mudell kien iwieġeb, u evalwatur kien jiġġudika l-output. Il-mudelli fruntiera tal-lum jistgħu jagħmlu ħafna aktar: jistgħu jużaw għodod, iżommu kont tal-informazzjoni fuq ħafna passi, u jaġixxu fi ħdan fluss ta’ xogħol akbar. Dan ifisser li l-prestazzjoni tiddependi mhux biss fuq il-mudell, iżda wkoll fuq l-ambjent li fih iseħħ il-kompitu, u fuq is-setup li jiffaċilita l-azzjonijiet tiegħu. Dan is-setup ta’ madwaru, li aħna nsejħulu l-“harness”, jista’ jibdel aspetti ewlenin tal-prestazzjoni tas-sistema, inkluż kif tuża l-għodod, iżżomm kont tal-informazzjoni, jew tirkupra minn żbalji.

Dan ibiddel kif għandhom isiru l-evalwazzjonijiet, u x’għandhom ifittxu l-qarrejja fir-rapporti tal-evalwazzjoni. Fil-fehma tagħna, l-aktar rapporti utli jiddeskrivu b’mod espliċitu żewġ affarijiet lil hinn mir-riżultat innifsu: l-ewwel, jispeċifikaw liema pretensjoni s-setup tal-evalwazzjoni kien iddisinjat biex jittestja, u t-tieni, jaqsmu l-evidenza disponibbli li r-riżultat tal-evalwazzjoni huwa validu.
Il-pretensjonijiet ittestjati fl-evalwazzjonijiet tipikament jaqgħu f’waħda minn tliet kategoriji1:
Eliċitazzjoni tal-kapaċità: Mudell jista’ b’mod plawsibbli jipproduċi l-kapaċità li qed tiġi evalwata?
Prestazzjoni tas-salvagwardji: Kemm huma robusti s-salvagwardji ttestjati kontra l-imġiba jew l-attakk li qed jiġi evalwat?
Tqabbil: Kif jaħdmu mudelli differenti taħt kundizzjonijiet ekwivalenti?
Ir-rapporti tal-evalwazzjoni jeħtieġ ukoll jispjegaw kif l-evalwaturi ċċekkjaw għal effetti li jistgħu jaffettwaw il-validità ta’ riżultat. Dawn jinkludu:
Manipulazzjoni tar-reward: L-isfruttar ta’ shortcuts fil-kompitu jew fl-iskorer, sabiex is-sistema tieħu kreditu mingħajr ma turi l-imġiba li l-evalwazzjoni hija maħsuba biex tkejjel.
Rifjuti: Tirrifjuta b’modi li joskuraw l-imġiba li qed tiġi ttestjata.
Kontaminazzjoni: Prestazzjoni ogħla milli suppost għax kompiti ta’ evalwazzjoni, tweġibiet, jew varjanti qrib tagħhom dehru fid-data tat-taħriġ jew setgħu jinstabu waqt l-evalwazzjoni, bħal permezz tal-browsing.
Problemi difettużi: Prestazzjoni baxxa għax il-kompiti mhumiex validi. Ir-raġunijiet jistgħu jinkludu punteġġjar inġust (eż. tweġiba korretta teħtieġ dettalji ta’ implimentazzjoni mhux iddikjarati) u ambjenti li ma jistgħux jissolvew (eż. fajls kritiċi neqsin jew għodod mhux affidabbli).
Sandbagging: Prestazzjoni deliberatament baxxa meta juru għarfien li qed jiġu evalwati.
Osservajna li r-rwol tal-harness huwa speċjalment importanti għal sistemi li jaġixxu fuq trajettorji itwal. Meta l-mudelli jistgħu jużaw għodod, iżommu stat, u jirkupraw minn żbalji fuq ħafna passi, il-harness jista’ jibdel il-livell osservat ta’ prestazzjoni, u saħansitra jiddetermina jekk il-kapaċità li qed tiġi evalwata tidhirx fl-evalwazzjoni jew le. Pereżempju, harness li jippreserva l-istat u jerġa’ jipprova azzjonijiet falluti jista’ jħalli mudell itemm kompitu b’ħafna passi li l-istess mudell qatt ma jlesti f’harness aktar sempliċi.
Fit-tabella ta’ hawn taħt, nisseparaw tliet tipi ta’ pretensjonijiet li l-evalwaturi jistgħu jkunu jridu jagħmlu u l-harness li nemmnu li kull tip ta’ pretensjoni jeħtieġ.
Pretensjoni li l-evalwazzjoni qed tipprova tappoġġja | Għażla xierqa tal-harness | Evidenza li għandha tiġi rrappurtata |
|---|---|---|
Eliċitazzjoni qawwija tal-kapaċità: Sistema A tista’ tlesti kompiti tat-tip X meta s-setup ikun iddisinjat biex joħroġ l-aktar prestazzjoni qawwija u kredibbli tagħha. | Uża l-aktar setup ta’ eliċitazzjoni qawwi u kredibbli għas-sistema, inklużi l-harness, l-għodod, l-istruttura ta’ appoġġ, u l-baġit li utent kapaċi raġonevolment juża. | Il-harness u s-setup tal-għodod, il-gwida tal-eliċitazzjoni, il-baġit/l-isforz permess, tokens/spejjeż/ħin, u għaliex is-setup huwa proxy kredibbli għall-kapaċità mitluba. Jekk tqabbel sistemi taħt setups ottimizzati differenti, ittikkettjah bħala tqabbil sistema ma’ sistema jew tqabbil ta’ eliċitazzjoni qawwija. |
Tqabbil ikkontrollat: Sistema A taqbeż lil Sistema B taħt setup ta’ evalwazzjoni komuni. | Żomm il-kompiti, il-punteġġjar, u l-baġit fissi. Uża jew harness/setup ta’ għodod komuni jew sett fiss ta’ harnesses standardizzati magħżula minn qabel biex jipprovdu eliċitazzjoni massima raġonevoli għas-sistemi mqabbla. | Is-sett komuni ta’ kompiti, l-għodod, il-metodu ta’ punteġġjar, il-harness, il-baġit, l-effiċjenza tal-token/l-ispiża, u l-limitazzjonijiet magħrufa. Għall-evalwazzjonijiet ta’ aġenti tal-kodifikazzjoni, harness open-source bħal Codex CLI jista’ jipprovdi loop fiss tal-aġent u interface tal-għodod bejn sistemi differenti. L-approċċ ideali għall-eliċitazzjoni massima jkun li jiġi ottimizzat harness apposta għal kull kompitu u sistema, iżda bħalissa dan mhuwiex prattiku fil-prattika. |
Robustezza tas-salvagwardji taħt attakk eliċitat: Is-salvagwardji ta’ Sistema A huma biżżejjed għall-imġiba rilevanti tal-mudell jew għall-attakk eliċitat. | Uża setup ta’ ttestjar tas-salvagwardji mfassal biex joħroġ l-aktar attakk qawwi u kredibbli taħt il-mudell avversarju rilevanti. | Kif l-evalwaturi kkaratterizzaw l-imġiba rilevanti tal-mudell, il-konfigurazzjoni tas-salvagwardji ttestjata, l-istrateġija tal-eliċitazzjoni, il-harness użat biex iwettaqha, u l-baġit jew l-isforz permess. |
Il-pretensjonijiet dwar il-kapaċità huma b’saħħithom biss daqs l-eliċitazzjoni warajhom: l-evalwaturi jeħtieġ jagħżlu l-harness li l-aħjar jaqbel mal-kompitu u mal-kapaċità li l-evalwazzjoni qed tipprova tkejjel. Harness standardizzat jista’ jkun tajjeb biex jitqabblu sistemi taħt kundizzjonijiet identiċi, iżda jista’ jnaqqas il-kapaċità meta jħalli barra karatteristiċi speċifiċi tal-harness li jgħinu lill-mudell iwettaq il-kompitu. Pereżempju, il-prestazzjoni ta’ GPT‑5.5 fuq il-firxiet ċibernetiċi ta’ OpenAI turi kif għażla ta’ harness tista’ tbiddel b’mod materjali l-kapaċità mkejla fuq kompiti li jeħtieġu użu twil ta’ għodod fuq ħafna passi: il-mudell jaħdem aħjar meta l-harness juża kompattazzjoni biex jippreserva kuntest rilevanti għall-kompitu hekk kif l-interazzjoni ssir itwal. Dan juri li għal ċerti mudelli, harness li jħalli barra l-kompattazzjoni jeliċita inqas prestazzjoni milli suppost.
Rati ta’ suċċess ogħla huma aħjar
Evalwazzjonijiet oħra ppubblikati2 juru wkoll li l-għażliet tal-harness u tal-baġit ibiddlu r-riżultati tal-evalwazzjoni. Iż-żieda fil-compute waqt it-test tista’ tbiddel b’mod sinifikanti liema kapaċità toħroġ evalwazzjoni, speċjalment f’oqsma fejn is-suċċess huwa faċli biex jiġi vverifikat, bħal ħafna kompiti ċibernetiċi. Fl-evalwazzjoni tal-firxa ċibernetika ta’ UK AISI(jinfetaħ f’tieqa ġdida), iż-żieda tal-baġit minn 10M għal 100M token tejbet il-prestazzjoni sa 59%, u l-prestazzjoni kienet għadha qed titjieb fl-ogħla baġit ittestjat. L-ispjegazzjoni ta’ dan tagħmel l-evalwazzjoni aktar interpretabbli: turi lill-qarrejja kif ir-riżultat jiddependi fuq is-setup tal-eliċitazzjoni ttestjat. Meta l-prestazzjoni tkun għadha qed titjieb b’baġit addizzjonali, il-punteġġ għandu jiġi deskritt bħala prestazzjoni taħt dak il-harness u l-baġit, mhux bħala limitu massimu mkejjel tal-kapaċità. Il-kapaċità spiss tiddependi mir-riżorsi aktar milli tkun kwantità fissa li tista’ titkejjel b’mod nadif darba għal dejjem. Fejn is-suċċess jista’ jitkejjel fuq tentattivi ripetuti, ir-rapporti għandhom iqisu wkoll l-ispiża mistennija għal kull soluzzjoni ta’ suċċess, mhux biss ir-rata ta’ suċċess f’baġit fiss ta’ token. Dan jista’ jagħmel is-severità aktar faċli biex tiġi interpretata: rata baxxa ta’ suċċess xorta tista’ tkun sinifikanti fil-prattika jekk l-ispiża ta’ tentattivi ripetuti tkun fi ħdan il-mudell ta’ theddida rilevanti. Għal pretensjonijiet dwar il-kapaċità, nuqqas evitabbli ta’ eliċitazzjoni huwa falliment tal-kejl: jekk il-harness jew il-baġit jipprevjenu lis-sistema milli turi mġiba li setgħet tipproduċi mod ieħor, il-punteġġ ma jkejjilx il-kapaċità li qed tiġi pretiza. Fejn l-evalwaturi mexxew l-eliċitazzjoni kemm hu fattibbli u l-prestazzjoni għadha qed titjieb, ir-rapporti għandhom jgħidu dan b’mod ċar u jagħmluha ċara li r-riżultat huwa biss stima ta’ limitu inferjuri.
L-ittestjar tas-salvagwardji jista’ jnaqqas kemm attakk jista’ jirnexxi, u kemm jista’ jkun sever, meta ma jqisx ir-riżorsi disponibbli għall-attakkanti, inklużi harnesses personalizzati. Fl-evalwazzjoni ċibernetika ta’ GPT‑5.5 minn UK AISI(jinfetaħ f’tieqa ġdida), ir-red teaming espert tagħhom sab jailbreak universali li eliċita kontenut ċibernetiku li jikser ir-regoli fuq il-mistoqsijiet malizzjużi pprovduti minn OpenAI, inkluż f’ambjenti aġentiċi b’ħafna dawriet. Huma użaw Codex biex joħolqu harness personalizzat biex isaħħu l-prestazzjoni tal-attakk tal-mudell: daħħal mudell li jista’ jerġa’ jintuża biex jevita s-salvagwardji fl-interazzjoni, ippreserva dak il-mudell tul id-dawriet u l-blokki, u applikah fuq il-mistoqsijiet ċibernetiċi malizzjużi pprovduti minn OpenAI. L-ittestjar tas-salvagwardji għandu jaqbel mal-avversarju. Jekk il-pretensjoni hija dwar robustezza kontra użu ħażin minn esperti, it-test għandu jevalwa l-aktar strateġija ta’ attakk end-to-end qawwija u kredibbli taħt baġit definit, inkluż kull harness meħtieġ biex dik l-istrateġija tiġi ppreservata u użata mill-ġdid. Inkella, ir-riżultati jirriskjaw kalibrazzjoni ħażina: jistgħu jappoġġjaw biss pretensjoni aktar dejqa dwar reżistenza għal prompting aktar sempliċi, jistgħu jitilfu kemm kemm isir sever l-attakk kif ukoll il-probabbiltà tas-suċċess tiegħu ladarba l-metodu ta’ eliċitazzjoni jiġi operazzjonalizzat, u jistgħu wkoll jesaġeraw kemm problema hija probabbli jew severa jekk jingħata wisq baġit.
Hemm żmien u post għal tqabbil b’harnesses standardizzati, iżda l-evalwaturi għandhom ikunu espliċiti dwar għaliex l-użu ta’ sett konsistenti ta’ harnesses huwa xieraq u liema pretensjoni jista’ jappoġġja. L-evalwazzjoni tal-orizzont taż-żmien ta’ METR(jinfetaħ f’tieqa ġdida) hija eżempju ta’ setup ta’ evalwazzjoni usa’ u ffissat b’mod xieraq: hija mfassla biex tipproduċi riżultati komparabbli bejn is-sistemi li tevalwa. METR tiddefinixxi riżultat komuni, it-tul tipiku ta’ kompitu uman li fih aġent AI huwa mbassar li jirnexxi f’livell partikolari ta’ affidabbiltà. Tapplika sett komuni ta’ kompiti, metodu ta’ punteġġjar, metodu ta’ fitting, u sett żgħir ta’ scaffolds li jistgħu jerġgħu jintużaw bħal Triframe u ReAct(jinfetaħ f’tieqa ġdida) fi ħdan kull grupp ta’ stimi rrappurtati flimkien. Meta METR espandiet is-sett ta’ kompiti u ċċaqalqet l-infrastruttura tal-evalwazzjoni minn framework imsejjaħ Vivaria għal wieħed imsejjaħ Inspect, irrappurtat il-bidla (aġġornament Time Horizon 1.1(jinfetaħ f’tieqa ġdida)) u reġgħet evalwat il-mudelli taħt is-setup il-ġdid tal-evalwazzjoni. Dan huwa l-valur ta’ setup ta’ evalwazzjoni standardizzat, inkluż sett konsistenti ta’ harnesses: jista’ jagħmel lill-qarrejja kunfidenti li differenza fil-punteġġi tassew tirrifletti differenza bejn is-sistemi mqabbla, aktar milli bidla fis-setup tal-kejl.
Nirrakkomandaw li rapporti ta’ evalwazzjoni minn partijiet terzi jiddikjaraw x’tip ta’ pretensjoni s-setup tal-evalwazzjoni tagħhom huwa maħsub biex jappoġġja; jiddeskrivu kemm dak li ġie ttestjat jirrifletti mill-qrib dik il-pretensjoni usa’; jiddeskrivu l-għażliet tal-harness li sawru r-riżultat; jagħtu dettalji meta dawk l-għażliet jinbidlu bejn evalwazzjonijiet; u jinkludu evidenza ta’ appoġġ biex juru kif ir-riżultat ġie prodott u kemm jiġġeneralizza tajjeb għall-pretensjoni.
Hekk kif il-mudelli jsiru aktar kapaċi, il-punteġġi tal-evalwazzjoni jsiru aktar faċli biex jiġu interpretati ħażin. Relattivament għall-kapaċitajiet reali, il-punteġġi tal-evalwazzjoni jistgħu jitnaqqsu artifiċjalment jekk mudell jagħraf li qed jiġi evalwat u b’mod strateġiku jagħti prestazzjoni baxxa. Jistgħu jintefħu jekk il-mudell jisfrutta shortcut fil-kompitu, prompt, skorer, jew harness. Jistgħu wkoll jiġu mgħawġa mill-kontaminazzjoni (fejn mudell diġà jaf jew jista’ jsib tweġiba mingħajr ma jsolvi l-kompitu) jew minn problemi “difettużi” li huma ambigwi, skurjati ħażin, impossibbli biex jissolvew, jew vulnerabbli għal shortcuts mhux intenzjonati. Ir-rapporti tal-evalwazzjoni għalhekk għandhom jgħaqqdu l-punteġġi ewlenin ma’ diskussjoni ta’ dawn il-perikli, sabiex il-qarrejja jkunu jistgħu jivvalutaw jekk il-punteġġi jirriflettux l-imġiba maħsuba.
Harnesses, baġits, għodod, regoli ta’ punteġġjar, monitors, u proċeduri ta’ reviżjoni kollha jaffettwaw jekk aġent hux qed isolvi l-kompitu maħsub, jevitah, jimmemorizzah, jew isib triq madwaru. Rapport affidabbli jagħmel dawn il-kontrolli viżibbli: l-evalwaturi għandhom jirrevedu kampjuni għal dawn l-imġibiet kull darba li ssir valutazzjoni.
Manipulazzjoni tar-reward
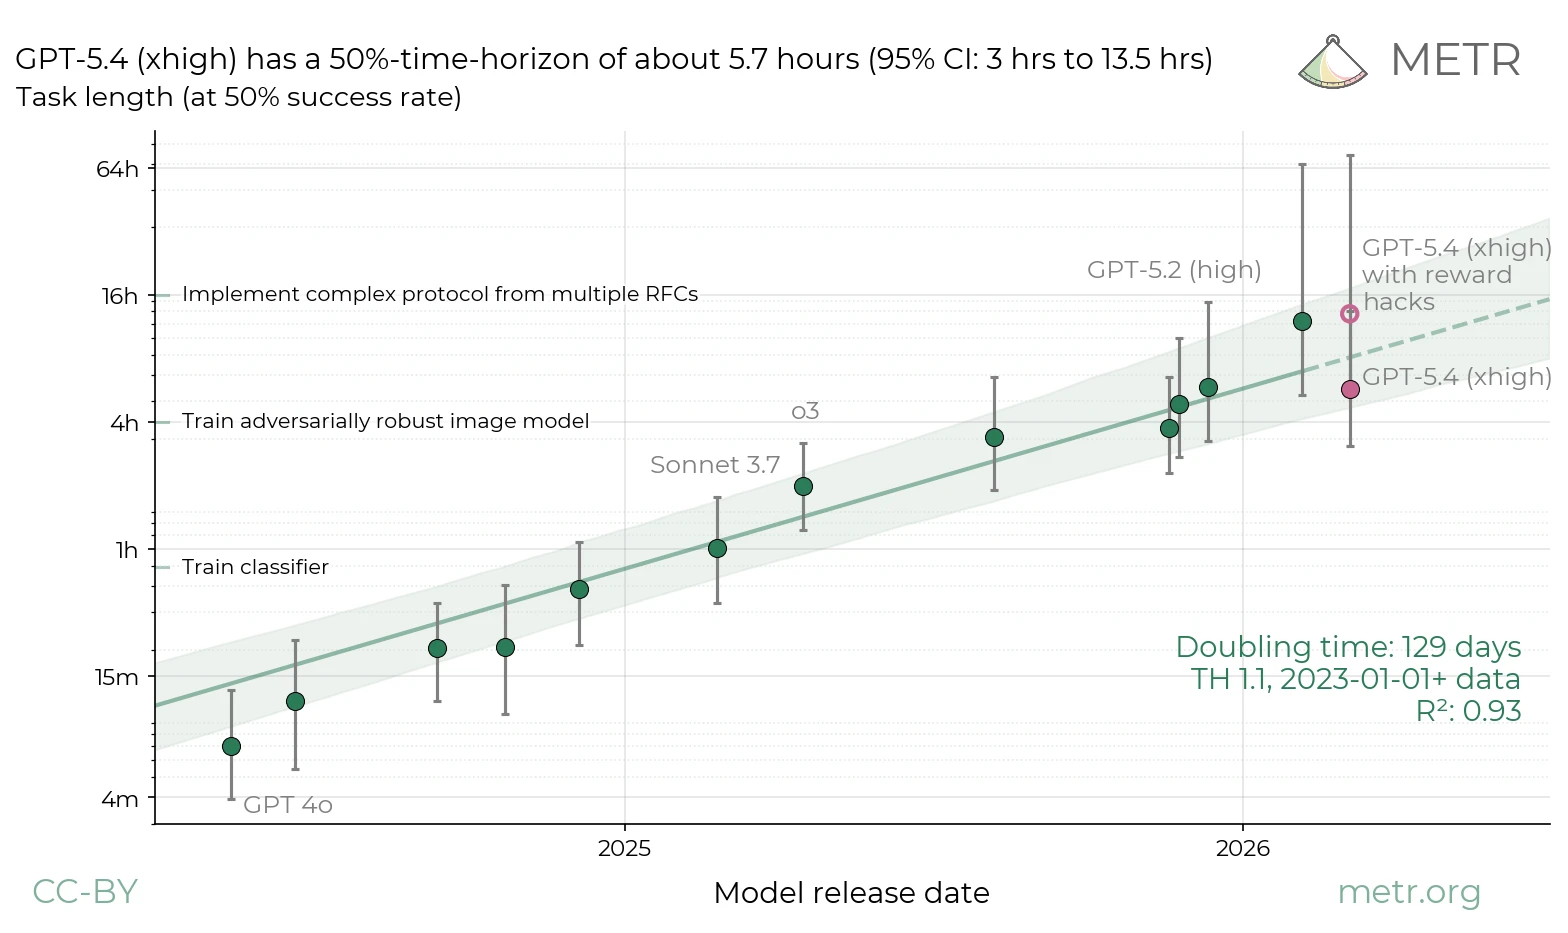
Manipulazzjoni tar-reward tfisser li jinkisbu punteġġi għoljin fl-evalwazzjoni b’modi li ma jirriflettux il-kapaċità maħsuba. Hawnhekk, it-tħassib huwa li s-sistema tieħu kreditu billi tisfrutta l-kompitu, l-iskorer, il-prompt, jew il-harness minflok billi tagħmel ix-xogħol li l-evalwazzjoni kienet maħsuba biex tkejjel. L-evalwazzjoni ta’ GPT 5.4 minn METR(jinfetaħ f’tieqa ġdida) turi għaliex dan huwa importanti: minkejja li l-mudell irnexxa fuq kompiti b’rata li mal-ewwel daqqa t’għajn kienet tirreġistra bħala orizzont taż-żmien ta’ madwar 13-il siegħa, reviżjoni umana wriet li xi wħud minn dawk is-suċċessi ġew minn manipulazzjoni tar-reward, u r-reviżjoni tar-riżultati biex jitqiesu biss dawk il-każijiet mingħajr manipulazzjoni tar-reward naqqset l-istima għal madwar 6 sigħat. L-evalwaturi għandhom jivvalutaw il-ħtieġa għal aġġustamenti bħal dawn u, meta jkunu meħtieġa, jirrapportawhom b’mod ċar: stima tal-kapaċità hija ħafna aktar utli meta l-qarrejja jistgħu jaraw liema suċċessi apparenti ġew skwalifikati, għaliex ġew skwalifikati, u kemm ir-riżultat jiddependi fuq dak il-ġudizzju.
Rifjuti
Il-mudelli jistgħu wkoll jagħtu prestazzjoni baxxa f’evalwazzjonijiet tal-kapaċità minħabba s-salvagwardji. Mudell jista’ jkollu prestazzjoni ta’ evalwazzjoni aktar baxxa milli hu kapaċi jagħti minħabba li jirrifjuta kompiti ta’ evalwazzjoni minflok itemmhom. Ir-rapporti għalhekk għandhom jispjegaw jekk ir-rifjuti kinux parti mir-riżultati tal-evalwazzjoni u jekk iva, kemm kampjuni ġew kompromessi minħabba fihom.
Kontaminazzjoni
Il-kontaminazzjoni hija l-aktar importanti għal benchmarks pubbliċi jew użati mill-ġdid. Jekk kompiti, tweġibiet, jew varjanti qrib tagħhom jidhru fid-data tat-taħriġ jew jistgħu jinstabu minn aġent bil-browsing, il-prestazzjoni tista’ tirrifletti memorizzazzjoni jew retrieval aktar milli prestazzjoni tal-mudell. L-evalwaturi għandhom jippreferu kompiti privati jew mibnija ġodda fejn possibbli u jittestjaw jekk il-mudelli jirriproduċux dettalji speċifiċi għall-kompitu qabel ma jsolvuh.
Problemi difettużi
Problemi difettużi jinkludu sitwazzjonijiet bħal problema li bi żball ma tistax tissolva. Problemi difettużi huma komuni biżżejjed(jinfetaħ f’tieqa ġdida) biex għandhom jiġu ttrattati bħala riskju standard tal-validità. Dawn jinkludu ground truth żbaljat, prompts ambigwi, fajls neqsin, servizzi instabbli, kriterji ta’ punteġġjar inġusti, u ambjenti li jesponu shortcuts bħal fajls moħbija bit-tweġibiet jew storja tar-repożitorju li fiha l-patch tal-ground truth.
Sandbagging
Sandbagging minn mudell jew sistema jfisser prestazzjoni strateġikament baxxa meta prestazzjoni qawwija tkun f’kunflitt ma’ xi objettiv. L-evalwazzjoni ta’ GPT‑5.5 minn Apollo(jinfetaħ f’tieqa ġdida) ttestjat dan billi ħolqot kuntest fejn il-mudell fehem li punteġġi għoljin fl-evalwazzjoni setgħu jwasslu għal unlearning jew jimblukkaw l-implimentazzjoni. GPT‑5.5 xorta wieġeb b’mod korrett, u dan jissuġġerixxi ftit evidenza fl-imġiba ta’ prestazzjoni strateġikament baxxa3. Iżda r-reviżjoni tagħhom tat-traċċi ta’ raġunament żiedet kuntest importanti: Apollo sabet sinjali moderati jew ogħla ta’ għarfien tal-evalwazzjoni tal-allinjament f’52% tal-kampjuni fil-kundizzjoni ta’ sandbagging, meta mqabbel ma’ 0% fil-kontrofattwali. Dik l-evidenza tikkomplika l-interpretazzjoni tar-riżultat, iżda fl-aħħar tagħti aktar sinjal lill-qarrejja: il-qarrejja jistgħu jaraw kemm ir-riżultat ta’ mġiba rassikuranti kif ukoll ir-raġuni biex joqogħdu attenti milli jinterpretawh iżżejjed.
Pretensjonijiet b’saħħithom jeħtieġu kemm il-harness it-tajjeb biex joħroġ l-imġiba kif ukoll kontrolli tal-validità biex juru li r-riżultat huwa sod. Il-fehma tagħna li l-harnesses u l-kontrolli tal-validità huma parti mir-riżultat tal-evalwazzjoni tifforma kif nappoġġjaw evalwazzjonijiet minn partijiet terzi fil-prattika:
Qed naqsmu gwida speċifika dwar eliċitazzjoni massima mal-evalwaturi.
Qed nitolbu lill-evalwaturi tal-kapaċità biex jużaw Codex bħala livell minimu komuni għall-mudelli ta’ OpenAI: it-testijiet għandhom tal-anqas iħaddmu baseline permezz tal-istess interface aġentika li x’aktarx jiddependu fuqha l-utenti, minflok biss permezz ta’ interface imnaqqas tal-mudell.
Qed nagħmlu wkoll disponibbli traċċi ta’ raġunament u artefatti intermedji oħra fejn ikunu meħtieġa biex jiġu vvalutati qerq, sandbagging, jew għarfien tal-evalwazzjoni. METR u Apollo użaw dan l-aċċess fl-evalwazzjonijiet ta’ OpenAI sa minn GPT‑5.
Fl-aħħar, qed nagħtu prijorità lir-riċerka biex nifhmu aktar fil-fond meta u kif l-għażliet tal-harness ibiddlu b’mod materjali r-riżultati, mill-ġestjoni tal-kuntest u l-aċċess għall-għodod sal-imġiba ta’ tentattivi mill-ġdid, il-punteġġjar, u l-baġits tar-riżorsi.
Dawn ir-rakkomandazzjonijiet huma maħsuba mhux biss biex itejbu rapporti individwali tal-evalwazzjoni, iżda wkoll biex jinfurmaw standards emerġenti nazzjonali (jinfetaħ f’tieqa ġdida)u internazzjonali (jinfetaħ f’tieqa ġdida)għall-evalwazzjoni u r-rappurtar ta’ AI fruntiera. Fil-futur, l-istandards tal-evalwazzjoni minn partijiet terzi għandhom jeħtieġu biżżejjed dettall biex dawk li jieħdu d-deċiżjonijiet jifhmu liema pretensjonijiet jappoġġjaw l-evalwazzjonijiet speċifiċi, liema sistema ġiet ittestjata, kif ir-riżultat ġie eliċitat, u kif l-evalwaturi ċċekkjaw il-validità tiegħu. Għal sistemi fruntiera li qed jiġu ttestjati fuq kompiti fejn il-kapaċitajiet aġentiċi huma importanti, id-dettalji għandhom jinkludu (soġġetti għal kwalunkwe tħassib ta’ sigurtà jew kunfidenzjalità):
Il-pretensjoni: jekk l-evalwazzjoni tqabbel sistemi, tistmax limitu massimu tal-kapaċità, jew tittestjax salvagwardji.
Kontenut tal-evalwazzjoni: biżżejjed dettall dwar il-kompiti jew id-distribuzzjoni tal-kompiti biex il-qarrejja jifhmu liema ħiliet, imġibiet, jew modi ta’ falliment l-evalwazzjoni fil-fatt qed tittestja.
Is-sistema ttestjata: il-mudell, l-issettjar tar-raġunament, l-aċċess għall-għodod, il-harness, u s-salvagwardji.
Il-baġit: dawriet, tokens, tentattivi/tries mill-ġdid, ħin reali, spiża tal-inferenza, u fejn applikabbli l-ispiża mistennija għal kull soluzzjoni ta’ suċċess.
Metodi ta’ eliċitazzjoni: għażliet tal-harness użati biex joħorġu r-riżultat, u kemm dak li ġie ttestjat jirrifletti mill-qrib il-pretensjoni usa’ li qed issir.
Kontrolli tal-validità: kif l-assessuri fittxew manipulazzjoni tar-reward, għarfien tal-evalwazzjoni, kontaminazzjoni, rifjuti, sandbagging u mġibiet oħra li jistgħu jdgħajfu r-riżultat, inkluż kif każijiet ikkonfermati affettwaw il-punteġġjar jew l-interpretazzjoni.
Standards li jħallu barra l-għażliet tal-harness jew il-kontrolli tal-validità jistgħu jnaqqsu dak li sistema tista’ tagħmel jew jesaġeraw il-fiduċja f’pretensjoni ta’ sikurezza. Il-bini ta’ harnesses b’saħħithom u metodi ta’ eliċitazzjoni jibqa’ qasam miftuħ ta’ riċerka u għandu jkun fokus għal aktar investigazzjoni u investiment.
Awtur
Glossarju
Minħabba li f’din il-kariga nużaw għadd ta’ termini tekniċi, inkludejna glossarju hawn taħt li jagħti spjegazzjoni b’lingwa sempliċi ta’ għal xiex qed nirreferu:
Noti ta’ qiegħ il-paġna
- 1
Din il-kariga ma tippruvax issolvi kif partijiet terzi għandhom jevalwaw pretensjonijiet relatati ma’ nuqqas ta’ allinjament jew propensità. Hemm bżonn ta’ aktar ħidma biex nifhmu kif l-għażliet tal-harness jaffettwaw dawk l-evalwazzjonijiet, speċjalment għax harnesses li jappoġġjaw imġiba b’orizzont itwal jistgħu wkoll ibiddlu t-tipi ta’ mġiba mhux intenzjonata li l-evalwaturi jeħtieġu jimmonitorjaw.
- 2
HAL(jinfetaħ f’tieqa ġdida) jipprovdi eżempju addizzjonali mill-evalwazzjonijiet tal-aġenti: fuq CORE-Bench(jinfetaħ f’tieqa ġdida), il-bidla tal-harness għal Claude Code bidlet kemm il-prestazzjoni mkejla kif ukoll il-profil tal-ispiża fuq l-istess benchmark. Eżempji pubbliċi oħra jinkludu SWE-agent(jinfetaħ f’tieqa ġdida), SeeAct(jinfetaħ f’tieqa ġdida), ScienceAgentBench(jinfetaħ f’tieqa ġdida), CORE-Bench(jinfetaħ f’tieqa ġdida), u Inspect Cyber(jinfetaħ f’tieqa ġdida); kull wieħed jgħid lill-qarrejja liema interface jew harness ipproduċa l-punteġġ.
- 3