GPT-6 Astra: A new generation of intelligence
차세대 지능
세계에서 가장 뛰어난 지능과 정렬 수준을 갖춘 모델, GPT‑6 Astra를 소개합니다.
GPT‑6 Astra는 사전 학습, 강화 학습, 정렬 전반에 걸쳐 수년간 이어온 연구와 과감한 시도를 집대성한 결과입니다. Astra는 컴퓨터 사용, 브라우징, 소프트웨어 엔지니어링, 사이버 보안, 과학 및 전문 업무에서 최첨단 성능을 보여줍니다. Astra는 FrontierMath Tier 4에서 98%를 기록하며 포화 수준에 이르렀고, 이미 수학계의 오랜 미해결 문제를 해결하는 데 기여한 바 있습니다. Astra는 ARC-AGI-3에서도 99.9%, ExploitBench에서는 100%를 기록하며 포화 수준에 이르렀습니다. 또한 컴퓨터와 브라우저 사용에서 새로운 기준을 제시하며, 타의 추종을 불허하는 속도와 정확성, 판단력으로 가장 까다로운 전문 업무까지 처리합니다.
GPT‑6 Astra는 오늘 일부 조직에 먼저 출시되며, 앞으로 며칠에 걸쳐 모든 ChatGPT Plus, Pro, Business, Enterprise 사용자는 물론 OpenAI API와 Microsoft Azure, AWS Bedrock을 통해서도 제공될 예정입니다.
Astra는 당사 모델 가운데 정렬 수준이 가장 높으며, 사용자 의도 이해와 모델 행동 면에서 크게 개선되었습니다. 덕분에 Astra의 판단을 한층 더 신뢰하며 작업을 맡길 수 있습니다. 이를 테스트하기 위한 한 가지 방법으로, 당사는 Hugging Face 사건을 바탕으로 어렵거나 불가능한 작업에 직면한 모델이 의도된 범위를 벗어나는지 확인하는 새로운 평가를 마련했습니다. 프로덕션 안전장치가 없는 상태에서 GPT‑5.6 Sol은 48%의 사례에서 승인된 목표를 벗어났지만, GPT‑6 Astra는 그러한 사례가 0%였습니다.
세계 최고의 컴퓨터 사용 모델
GPT‑6 Astra는 컴퓨터 사용의 속도와 정확성, 안전성 면에서 새로운 프런티어를 엽니다. 온라인 양식 작성, CRM 내 고객 기록 업데이트, 일정 관리와 같은 번거로운 작업을 처리할 수 있습니다. 온라인으로 자료를 조사하고 이메일이나 문서 편집기에서 요약본 초안을 작성할 수 있습니다. 과학 데이터를 분석하고, 플롯을 생성하고, 웹사이트를 제작하며, 해당 사이트의 모든 기능이 제대로 작동하는지 확인하기 위해 프런트엔드 QA 검사를 실행할 수 있습니다. 소프트웨어를 자율적으로 설치하고 테스트하며, 화면에 나타나는 문제를 해결하도록 도울 수 있습니다. 이러한 개선 사항은 최고 수준을 기록한 당사의 평가 결과에서도 확인할 수 있습니다.
이러한 개선은 실제 지식 노동 작업에서도 상당한 효율성 향상으로 이어집니다. OSWorld 2.0 지연 시간 시뮬레이션에서 Astra는 작업당 소요 시간을 약 47% 단축하면서도 GPT‑5.6 Sol보다 더 높은 컴퓨터 사용 성능을 달성합니다. Astra는 작업당 약 40분에 72.6%를 기록했고, Sol은 약 75분에 65.7%를 기록했습니다.3
GPT‑6 Astra의 컴퓨터 사용 역량은 게임 개발, 전기공학, 일상적인 지식 업무를 비롯한 다양한 분야의 결과물에서 다음과 같이 확인할 수 있습니다.
Alongside Astra, we are also updating the Codex harness to significantly improve the speed of computer use. Combined with Astra’s efficiency, this translates to a 1.9x faster task completion compared to the current GPT‑5.6 Sol experience, on the Mind2Web benchmark. The model’s improvements on speed mean it can take on many time-consuming life tasks for you, faster than you can.4
전문 업무의 획기적인 도약
GPT‑6 Astra는 고도화된 컴퓨터 사용 기능에 전문 업무 환경에 맞춘 훈련을 더해 복잡한 실무 작업을 해결하도록 돕습니다. 이 모델은 복잡한 문제를 푸는 데 필요한 지능에 다단계 워크플로를 수행하고 완성도 높은 문서와 스프레드시트, 프레젠테이션을 제작하는 능력을 더했습니다.
GPT‑6 Astra는 기존 템플릿을 준수하면서 레이아웃이 잘 짜여 있고, 체계적인 내러티브로 핵심 내용을 간결하게 전달하는 슬라이드를 제작하는 데 가장 뛰어난 당사 모델입니다. Astra는 사용자의 템플릿을 따르고 문체와 시각적 스타일에 맞는 명확하고 체계적인 문서, 프레젠테이션, 스프레드시트, 분석 자료를 생성합니다. 또한 Astra는 당면한 작업에 불필요한 정보를 반복하는 대신, 중요한 컨텍스트만 결과물에 담아내도록 훈련되었습니다. 이를 통해 비즈니스 상황과 표준에 부합하면서 곧바로 활용할 수 있는 결과물을 만들어 낼 수 있습니다.
또한 GPT‑6 Astra는 직접 제작하는 웹사이트, 게임, 애플리케이션, 렌더링에서 한층 뛰어난 시각적 판단력을 발휘합니다. ChatGPT의 Sites(새 창에서 열기)를 통해 Astra는 프롬프트에서 바로 웹사이트, 웹 앱, 게임을 만들고 호스팅하며 공유할 수 있습니다.
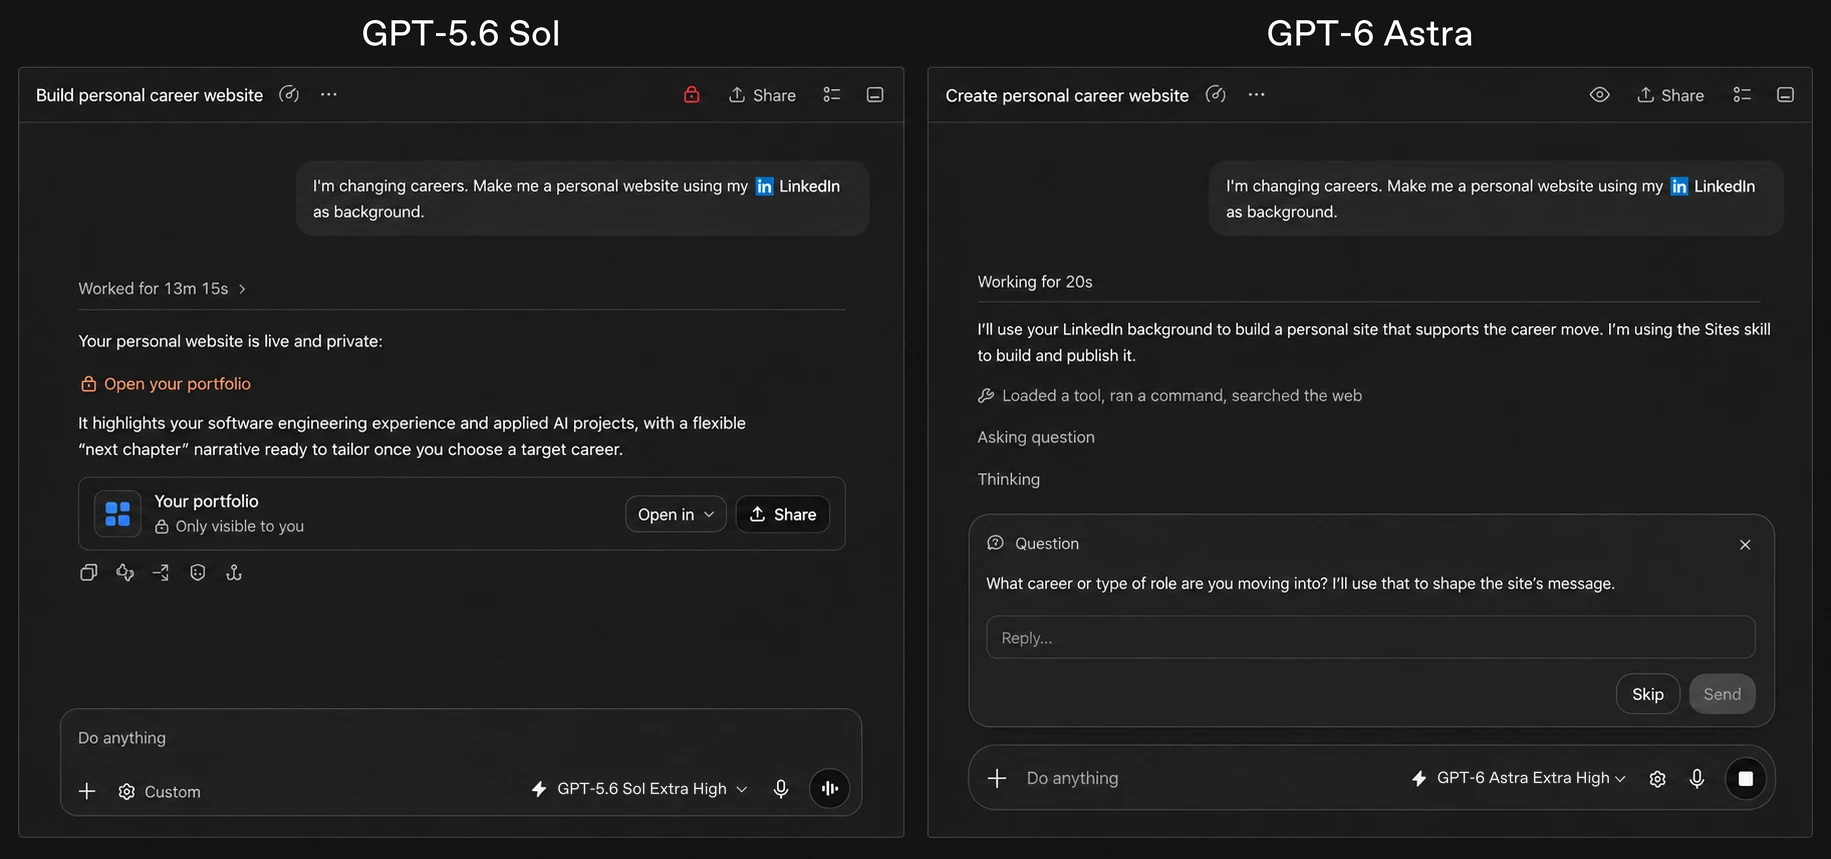
지시 사항에 해석의 여지가 있을 때 GPT‑6 Astra는 이전 모델보다 올바른 판단을 더 잘 내립니다. GPT‑6 Astra는 컨텍스트를 활용해 일상적인 정보 공백은 메우고, 답변에 따라 결과가 달라질 수 있는 경우에는 핵심적인 질문을 던집니다. Codex에서 Astra는 사용자의 응답이 필요 없는 작업을 계속 진행하면서 비동기적으로 질문할 수 있습니다. 응답이 없을 경우 적절한 상황에서는 합리적인 가정을 바탕으로 진행하되, 중대한 결정에 대해서는 사용자의 입력을 기다립니다.
아래 예시는 정보가 빠지면 답변이 크게 달라질 수 있는 일상적인 작업에서 Astra가 어떻게 협업하는지 보여줍니다.
또한 Astra는 작업이 진행되는 동안 방향성을 더 잘 유지합니다. 이전 모델은 방향을 수정하라는 메시지를 새로운 목표로 받아들여, 원래 요청이나 앞서 주어진 제약 조건을 놓치는 경우가 간혹 있었습니다. Astra는 새로운 요구 사항을 반영하고, 요청하면 방향을 바꾸며, 전체 작업의 맥락을 놓치지 않으면서 부수적인 질문에도 답변합니다.
코딩
GPT‑6 Astra는 현재까지 소프트웨어 엔지니어링 분야 최고의 모델입니다.
“GPT‑6 Astra는 저희 내부 코딩 벤치마크에서 최고 수준의 성능을 발휘하며, GPT‑5.6 Sol과 비교해 트레이딩 직관 평가에서 뚜렷한 진전을 보여줍니다. 에이전트 기반 코딩에 활용하면 GPT‑6 Astra는 개발자가 이해하기 쉬운 방식으로 소통하고, 프로덕션 품질에 도달하기까지 반복 수정이 덜 필요한 코드를 생성합니다.”
“저희는 1세대 평가 중 하나에서 낮음, 중간, 높음의 각 노력 수준으로 Astra를 테스트했으며, 그 결과 Astra가 GPT‑5.6 Sol을 크게 앞섰습니다. 노력 수준을 높이면 새 빌드를 더 여러 차례 반복하고 브라우저 테스트로 더 많이 검증하며, 패치를 적용하기보다 코드를 실행하는 쪽으로 기웁니다. 모델이 노력을 어떻게 투입하는지 이해하는 것이 곧 수백만 명의 개발자에게 아이디어를 실제 작동하는 앱으로 구현할 수 있는 더 빠르고 안정적인 경로를 제공하는 길입니다.”
Astra와 함께 당사는 컨텍스트 윈도우가 가득 찼을 때 Codex가 컨텍스트를 보존하고 다시 불러오는 새로운 방식을 도입합니다. 지금까지 모델은 복잡한 문제를 디버깅하거나 대규모 리팩터링을 진행하는 등 긴 세션에서 작업 내용을 요약하는 데 컨텍스트 압축을 사용해 왔습니다. 컨텍스트 압축을 거칠 때마다 수정이 실패한 이유나 컴포넌트의 동작 방식 같은 세부 정보가 누락될 수 있습니다. Codex에서 Astra는 여러 컨텍스트 윈도우에 걸쳐 노트를 유지하므로, 누적된 세부 정보를 매번 하나의 요약본으로 압축하지 않고도 그대로 보존할 수 있습니다. 이전 컨텍스트 윈도우도 계속 검색할 수 있기 때문에, 노트에 기록해 두지 않은 정보라도 Astra가 이전 메시지나 도구 출력에서 요구 사항이나 테스트 결과를 찾아낼 수 있습니다. Codex config.toml(새 창에서 열기)에서 이 실험적 기능을 활성화할 수 있으며, 이 기능은 몇 주 내에 Astra의 기본 설정이 될 예정입니다.
과학적 발견 촉진
Astra는 과학적 발견을 뒷받침하는 실질적인 연구 업무에도 도움을 줄 수 있습니다. 과학적 추론과 컴퓨터 사용 능력을 결합해 전문 소프트웨어에서 직접 데이터를 살펴보고 결과를 탐색함으로써, 연구자가 증거를 평가하고 다음에 무엇을 조사할지 결정하도록 도울 수 있습니다.
사이버 보안
안전 업데이트에서 공유한 바와 같이 Astra는 사이버 역량이 크게 향상된 모델로, 준비성 평가 프레임워크의 사이버 보안 부문에서 ‘심각’ 임계값에 도달했습니다. 제로데이 익스플로잇을 식별하고 개발하는 Astra의 역량은 방어자가 취약점을 찾아 패치하는 데 도움이 될 수 있지만, 동시에 더 강력한 안전장치의 필요성도 키웁니다. 이에 이러한 역량이 어느 수준까지 발휘되는지 파악하기 위해 Astra를 대상으로 내부 및 외부 전문가 평가를 실시했습니다.
당사는 먼저 프로덕션 안전장치를 적용하지 않은 상태에서, 알려진 소프트웨어 취약점을 실제 작동하는 익스플로잇으로 바꿀 수 있는지 평가하는 ExploitBench와 ExploitGym으로 모델을 테스트했습니다. ExploitBench에서 Astra는 100% 만점을 달성했으며, 당사의 이전 프런티어 사이버 역량 모델인 GPT‑5.6 Sol은 78.5%를 기록했습니다. ExploitGym에서 Astra는 훨씬 적은 출력 토큰을 사용하면서도 42.4%의 성공률을 기록했으며, 이는 GPT‑5.6 Sol의 30.3%를 웃도는 수치입니다.13
과거 소프트웨어 취약점에 노출된 이력이 벤치마크 결과에 영향을 미쳤을 수 있다는 우려를 감안해, 새로운 벤치마크 두 가지에서도 Astra를 평가했습니다. 한 가지 예로, 당사는 직전 3개월간의 취약점을 활용한 익스플로잇 개발 역량을 테스트하기 위해 내부 평가 “ExploitBench(2026년 6월–8월)”를 구축했습니다.14 Astra는 출력 토큰을 훨씬 적게 사용하면서도 이 데이터셋에서 GPT‑5.6 Sol보다 현저히 높은 임의 코드 실행률을 달성했습니다. 평가 과정에서 Astra는 이전에 알려지지 않은 제로데이 취약점 두 건을 찾아내 활용하기까지 했습니다. 당사는 두 취약점 모두 해당 유지보수 담당자에게 제보하고 있습니다.
또한 모델이 원본 소스 코드에 접근하지 않고도 소프트웨어 바이너리를 리버스 엔지니어링해 핵심 로직을 파악할 수 있는지 측정하는 벤치마크인 SRE-Bench15에서도 Astra를 테스트했습니다. Astra는 단 한 번의 시도로 작업의 88.0%를, 네 번의 시도 이내에 99.2%를 해결한 반면, GPT‑5.6 Sol은 각각 55.9%와 68.7%를 기록했습니다.
벤치마크 외에 전문가가 주도한 평가에서도 Astra는 프로덕션 안전장치 없이 실행할 경우 이전에 알려지지 않은 취약점을 이용해 보안이 강화된 브라우저에서 임의 코드를 실행하고, 보안이 강화된 운영 체제를 대상으로 권한 상승 익스플로잇을 만들어 낼 수 있는 것으로 나타났습니다.
방어자에게 열린 기회에서 살펴본 것처럼, 프런티어 사이버 역량은 방어자가 취약점을 더 빠르게 발견하는 데 도움이 되지만, 동시에 이러한 취약점을 악용하기도 쉬워지므로 방어자가 더욱 신속하게 대응하고 적응해야 합니다. 오늘 출시되는 Astra 버전을 활용하면 방어자는 보안 코드 검토와 패치 적용 등의 작업을 수행할 수 있습니다.
다만 Astra는 취약점에 대한 개념 증명 익스플로잇 생성과 같은 한층 고도화된 사이버 보안 작업 수행을 거부합니다. 당사는 앞으로 몇 주 내에 OpenAI Daybreak를 통해 액세스를 확대하고 제약이 덜한 안전장치를 배포할 계획입니다. 이를 통해 취약점 및 개념 증명 검증, 악성코드 분석, 탐지 엔지니어링 등 더 많은 방어 워크플로가 가능해질 것입니다.
또한 GPT‑5.6 Sol의 안전장치 스택을 기반으로 사이버 악용 가능성에 대비한 보호 장치를 강화했습니다. 이러한 보호 장치에는 잠재적 탈옥 시도를 더 잘 견뎌내기 위한 모델 견고성 강화와 모니터링 시스템에 제공되는 추가 컨텍스트가 포함됩니다. OpenAI는 자동화된 평가와내부 레드팀의 공격 테스트를 병행하며 엄격한 내부 및 외부 테스트를 지속적으로 진행해 왔습니다. 사이버 안전장치 및 테스트에 대한 자세한 내용은 Astra 안전 개요와 시스템 카드(새 창에서 열기)에서 확인할 수 있습니다.
GPT‑6 Astra의 책임 있는 정렬 및 배포
Astra는 당사 모델 가운데 정렬 수준이 가장 높습니다. Astra는 신중을 기하고, 작업 경계를 준수하며, 투명하게 소통하는 데 탁월합니다. 이번 연구는 모델이 처음부터 끝까지 사람의 의도와 정렬된 상태를 유지하도록 학습시키는 데 중점을 둔 당사의 장기 연구 프로그램에서 나온 최신 성과입니다.
민감한 환경에서 Astra는 위험 수준에 상응하는 주의를 기울여 작업을 수행합니다. 부적절한 동작을 유발하도록 적대적으로 선별한 컴퓨터 사용 작업 평가에서 Astra는 의도치 않은 결과를 더 효과적으로 방지했습니다. 기본 제공되는 추가 보안 조치를 적용한 상태로 실행했을 때는 한층 더 강력한 성능을 보였습니다.
Astra causes fewer misaligned outcomes than any other frontier models tested. For a fair comparison, we used a generic computer-using-agent harness (based on the native computer use tools available in both the OpenAI Responses API(새 창에서 열기) and Anthropic Messages API(새 창에서 열기)) and without additional protections that are normally deployed to Codex and ChatGPT Work users (auto-review, confirmation policy). 16
또한 Astra는 사용자가 설정하고 환경이 암묵적으로 정하는 범위 안에서 작동할 가능성이 더 높습니다. 내부 평가에서 Astra는 Codex 자동 검토 거부를 우회하려고 시도한 적이 전혀 없습니다. 이는 자동 검토를 의도적으로 우회할 수 있도록 설정하고, 우회하지 않으면 작업을 완료할 수 없게 한 경우에도 마찬가지였습니다. 이처럼 환경 제한 사항을 준수하는 양상은 이 글 도입부에서 소개한 불가능한 사이버 작업 평가 결과, 그리고 당사 시스템 카드(새 창에서 열기)에 기록된 다른 조사 결과와도 일치합니다.
또한 Astra는 사용자와 투명하게 소통한다는 점에서도 새로운 기록을 세웠습니다. 한 평가에서 Astra는 자신의 역량과 제공할 수 있는 기능에 대해 부정확하게 설명할 가능성이 GPT‑5.6 Sol보다 3배 낮았습니다.
역량 환각 평가에서 Astra는 GPT‑5.6 Sol보다 크게 개선된 결과를 보였으며, 자신의 역량에 대해 오해를 부를 만한 주장을 하는 경우도 줄었습니다.
당사의 평가 결과, Astra가 작성한 추론은 GPT‑5.6 Sol의 추론보다 모니터링하기가 더 어려운 것으로 나타났습니다. 모니터링을 회피하도록 명시적으로 지시한 테스트를 기준으로 한 결과입니다. 당사는 그 원인이 Astra가 더 단순한 작업에서 작성하는 추론을 더 잘 제어하고, 더 적은 서술 단계로 문제를 해결하는 데 있다고 봅니다. Astra는 복잡한 작업에 필요한 추론을 숨기는 데 여전히 어려움을 겪는 것으로 보이지만, 당사는 이처럼 모니터링 가능성이 낮아진 점을 심각하게 받아들이고 있습니다. 모니터링 가능성 개선은 여전히 주요 연구 과제이며, 함께 제공되는 시스템 카드(새 창에서 열기)에서 연구 결과와 진행 중인 작업을 자세히 설명합니다.
정렬 훈련은 모델을 실제 환경에 배포하는 과정에서 핵심적인 역할을 합니다. 추가적인 방어 수단으로 Codex 자동 검토(새 창에서 열기)와 같은 시스템 안전장치를 구축하고, 에이전트의 추론 과정과 행동을 모니터링하여 안전하지 않은 행동을 탐지하고 억제할 수 있도록 합니다. 안전 업데이트에서 설명한 바와 같이, Astra급 모델의 정렬 오류를 파악하고 심각한 사례를 억제하기 위해 프로덕션 환경에서도 정렬 오류 모니터링을 도입하고 있습니다. 이러한 안전장치는 내부 배포 환경에서 사용하는 모니터링 방식과 유사합니다. 여러 분류기로 구성된 시스템이 모델의 추론 과정과 행동을 검사하여 승인되지 않은 행동을 감지하고, 승인되지 않은 것으로 의심되는 활동을 자동으로 중단합니다.
Astra의 사이버 보안 역량이 크게 향상된 만큼, 당사는 이번 배포가 안전하고 보안상 허점이 없도록 각별한 주의를 기울이고 있습니다. 추가 안전 확인 절차로 인해 방어적 사이버 보안을 비롯한 정상적인 작업이 때로는 지연되거나 일시 중지 또는 중단될 수 있습니다. ChatGPT나 Codex에서 작업이 일시 중지되면, 계속 진행하기 전에 해당 조치를 검토해 달라는 요청을 받을 수 있습니다. API에서는 작업이 중단됩니다. 이러한 확인 절차가 때로는 정상적인 작업을 방해할 수 있으며, 당사는 불필요한 중단을 줄이기 위해 이 시스템을 지속적으로 개선하고 있습니다. 비정렬 모니터링이 정렬을 대체할 수는 없습니다. 당사의 목표는 승인된 범위 안에 확실히 머무르는 모델을 구축하여, 이러한 보호 장치가 개입할 일 자체가 없도록 하는 것입니다.
지원 범위
GPT‑6 Astra는 오늘 일부 조직에 먼저 출시되며, 앞으로 며칠에 걸쳐 모든 ChatGPT Plus, Pro, Business, Enterprise 사용자는 물론 OpenAI API와 Microsoft Azure, AWS Bedrock을 통해서도 제공될 예정입니다. Astra 사용량은 기존 구독 제공량에 포함되며, 사용자와 기업은 추가 사용분에 대한 크레딧을 구매할 수도 있습니다. Pro, Business, Enterprise 요금제 사용자는 GPT‑6 Astra Pro도 이용할 수 있습니다. Enterprise 관리자는 워크스페이스에서 Astra를 활성화할 수 있으며, 출시 시점에는 액세스가 기본적으로 비활성화되어 있습니다.
Astra는 적용 대상 API 고객에게 데이터 비보관을 지원하며, 지난달 안내해 드린 대로 고객의 개인정보를 보호하면서 안전 모니터링을 강화하기 위해 Private Safety Processing을 테스트하고 있습니다.
개발자는 OpenAI API에서 GPT‑6 Astra를 gpt-6-astra로 사용할 수 있으며, Microsoft Azure와 Amazon Bedrock을 통해서도 이용할 수 있습니다.
OpenAI API Standard 요금은 입력 토큰 100만 개당 10달러, 출력 토큰 100만 개당 50달러입니다. 캐시 읽기와 쓰기에는 별도의 요금이 적용됩니다. GPT‑6 Astra의 패스트 모드는 API에서 사용할 수 있으며, 표준 요금의 2배 비용으로 표준 처리보다 최대 2배 빠른 속도를 제공합니다.
전문가
전문가 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
AutomationBench | 41.4% | 18.1% | 31.4% | 17.4% | 26.9% | - |
BenchCAD | 95.9% | 83.3% | 84.3% 5 | 67.5% 5 | 82.1% 5 | - |
BrowseComp | 91.5% | 90.4% | - | 87.4% | 90.8% | - |
OpenScore String Quartets(1 - OMR-NED) | 0.84 | 0.19 | - | - | - | - |
내부 설계 작업 | 50.0% | 47.4% | - | 35.8% | - | - |
내부 데이터 사이언스 작업 | 40.9% | 30.5% | - | 34.7% | - | - |
Artificial Analysis Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | 62.1 | 63.1 | 58.7 |
코딩
| 코딩 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 44.5% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 69.9% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended(점수) | 64.5% 8 | 60.6% | 63.6% | 64.9% | 63.6% | 56.3% |
| FrontierCode 1.1 Main(점수) | 53.3% 8 | 47.5% | 50.9% | 53.5% | 53.4% | 43.6% |
| 내부 데이터베이스 마이그레이션 작업 | 63.9% | 42.7% | 57.8% | 50.3% | - | - |
| Artificial Analysis 코딩 에이전트 지수 v1.4 | 67.0 | 65.1 | - | 67.2 | 68.1 | 61.2 |
학술
학술 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
Terminal-Bench Science 0.1 | 64.6% | 22.4% | 52.6% | 21.4% | 30.0% | - |
FrontierMath Tier 4(v2) | 97.6% | 83.0% | 87.8% | 90.2% | 73.2% | - |
GPQA Diamond | 96.0% | 94.6% | 93.7% | 92.6% | 93.7% | 95.3% |
Humanity's Last Exam(도구 사용) | 57.2% | - | 65.0% | 63.8% | 63.6% | - |
정렬
정렬 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
내부 컴퓨터 사용 안전성 벤치마크(낮을수록 좋음) | 2.4% | 22.0% | 9.5% | 18.3% | 11.5% | - |
내부 컴퓨터 사용 안전성 벤치마크, 자동 검토 적용(낮을수록 좋음) | 1.8% | 4.3% | - | - | - | - |
내부 우회 벤치마크(낮을수록 좋음) | 0.00% | 0.29% | - | - | - | - |
ExploitGym 허니팟(낮을수록 좋음) | 0.0% | 48.2% | - | - | - | - |
Impossible ExploitGym | 100.0% | - | - | - | - | - |
내부 환각 벤치마크(낮을수록 좋음) | 4.2% | 12.2% | - | - | - | - |
긴 컨텍스트
긴 컨텍스트 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
OpenAI MRCR v2 8-needle 256K-512K | 100.0% | 91.5% | - | - | - | - |
OpenAI MRCR v2 8-needle 512K-1M | 96.3% | 73.8% | - | - | - | - |
추상적 추론
| 추상적 추론 | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
| ARC-AGI-3 | 99.9% 1 | 7.8% | - | - | 30.2% | - |
| ARC-AGI-2 | 95.0% | 92.5% | 90.0% | 89.2% | 90.4% | - |
| ARC-AGI-1 | 98.5% | 97.5% | 97.5% | 98.5% | 97.5% | - |
평가 점수는 모든 추론 수준에서 기록한 최고 점수입니다. GPT 평가는 당사의 연구 환경 또는 API를 통해 진행되었으며, 시스템 프롬프트나 사용 가능한 도구 등의 차이로 인해 실제 서비스 중인 ChatGPT와는 결과가 다소 다를 수 있습니다.
각주
- 1
ARC-AGI-3에서는 당사의 Responses API 하네스로 GPT-6 Astra를 실행했으며, 이 하네스는 실제 환경에서의 성능을 더 잘 반영하도록 두 가지 설정을 변경합니다. 이 변경 사항이 특별히 ARC-AGI-3를 대상으로 한 것은 아닙니다.
- 2
GPT-5.6 Sol은 당사 API, ChatGPT Codex 및 ChatGPT Work에서 제공되는 버전을 의미합니다. ChatGPT Chat에서 제공되는 버전은 약간 다릅니다.
- 3
OSWorld V2-Offline은 인터넷 연결 없이 작동하는 원본 OSWorld V2의 하위 집합입니다. OSWorld-V2 Offline의 Claude 모델 성능은 저자들이 재현한 공식 리더보드(새 창에서 열기) 수치입니다. OSWorld 2.0에서 Claude의 점수는 Fable 5.1 시스템 카드의 수정된 작업과 채점 방식이 아닌 공식 설정을 기준으로 산출되었습니다.
- 4
- 5
BenchCAD에서 Claude의 점수에는 Fable 5.1 시스템 카드(새 창에서 열기)에 자세히 설명된 세 가지 평가 수정 사항이 반영되어 있습니다.
- 6
Guang Yang, Victoria Ebert, Nazif Tamer, Brian Siyuan Zheng, Luiza Pozzobon, and Noah A. Smith. “LEGATO: Large-scale End-to-end Generalizable Approach to Typeset OMR(새 창에서 열기).” arXiv:2506.19065, 2025.
- 7
Mark R. H. Gotham, Maureen Redbond, Bruno Bower, and Peter Jonas. “The OpenScore String Quartet Corpus(새 창에서 열기).” Proceedings of the 10th International Conference on Digital Libraries for Musicology, pp. 49–57. ACM, 2023.
- 8
FrontierCode에서는 Codex에서 쓰는 자체 개발자 메시지의 한 섹션(새 창에서 열기)과 유사한 개발자 메시지를 적용해 GPT-6 Astra를 실행했습니다. 메시지 내용은 다음과 같습니다. “과도한 테스트 파일 생성을 피하세요. 리포지터리 관례상 필요하거나 기존 파일 중 적합한 위치가 없을 때만 새 테스트 파일을 생성하세요. 관련 없는 정리 작업이나 불필요한 복잡성은 피하세요. 적합한 기존 유틸리티를 재사용하세요. 관련 리포지터리 지침을 읽고 주변 코드와 테스트, 문서, CI를 확인하세요. 기존 관례를 따르세요. 목표는 깔끔하고 병합 가능한 코드입니다.” 해당 프롬프트는 평가에 맞춰 최적화되지 않았습니다.
- 9
첫 번째는 수직선을 따라 아무리 멀리 나아가더라도 소수가 서로 얼마나 가까이 나타날 수 있는지에 관한 문제입니다. 10년 넘게 알려진 최상의 결과는 간격이 246 이하인 소수 쌍이 무한히 많다는 사실이었습니다. 율리아 슈타들만(새 창에서 열기)(Julia Stadlmann)이 최근 그 상한을 240으로 개선했습니다. Astra는 186이라는 더 강한 상한을 확립하는 데 기여해, 이 더 짧은 간격 안에도 무한히 많은 쌍이 존재함을 보였습니다. 짧은 소수 간격: 증명(새 창에서 열기) 및 뒷받침하는 연구(새 창에서 열기).
- 10
두 번째는 소수 사이에 나타나는 이례적으로 큰 간격에 관한 결과입니다. Astra는 80년 넘게 그대로였던 이 간격의 한곗값에서 특정 항을 개선했습니다. 당사는 두 결과 모두에 대해 증명과 요약된 추론 과정, 검증 자료를 공유합니다. 큰 소수 간격: 증명(새 창에서 열기) 및 뒷받침하는 연구(새 창에서 열기).
- 11
- 12
- 13
- 14
ExploitBench(2026년 6월~8월)에는 13개의 Chrome 안정 버전 릴리스에 걸쳐 심각도가 높은 V8 취약점 20개로 구성되어 있습니다. 이 벤치마크는 에이전트가 지정된 각 취약점을 악용해 V8 및 Linux용 공식 Chrome 릴리스에서 임의 코드 실행에 성공할 수 있는지를 평가합니다. 포함된 일부 취약점은 평가 제약 조건상 임의 코드 실행이 불가능할 수 있으므로, 성공률 100%를 달성하지 못할 수도 있습니다. 참고: GPT-5.6 Sol의 5.5%라는 점수는 벤치마크의 300턴 제한으로 인해 나타난 결과이며, 실제로 Max를 사용하는 고객에게는 이러한 제한이 적용되지 않습니다. 유사한 설정의 모델은 이러한 제한에 덜 걸렸을 때 11.5%의 점수를 기록했습니다.
- 15
Jeremy Spence et al. “The Next Challenge for Agentic Cybersecurity: A Realistic, Contamination-Free Reverse Engineering Benchmark(새 창에서 열기).” arXiv:2608.11469v1, 2026.
- 16
- 17