Cosa significa essere Forward Deployed Engineer in OpenAI
Cosa facciamo, come lavoriamo e come risolviamo i problemi più difficili delle aziende per ottenere risultati concreti.
Di Colin Jarvis, responsabile del Forward Deployed Engineering di OpenAI
Quando è uscito Codex, qualcuno nel team mi ha chiesto: “Cosa facciamo quando Codex riesce a realizzare in un solo tentativo i casi d'uso a cui abbiamo lavorato negli ultimi mesi?”
Questa domanda coglie l'essenza di cosa significhi essere Forward Deployed Engineer in OpenAI. Lavoriamo al fianco dei clienti per comprendere i loro problemi più difficili e costruire soluzioni su cui possano contare. Ciò che impariamo contribuisce a plasmare i nostri prodotti e offre al team di ricerca problemi concreti da risolvere.
Questo è progresso. Se ogni paio di mesi rendiamo superfluo il nostro intervento, il nostro team di Forward Deployed Engineer sta facendo il proprio lavoro.
Ho fondato il team all'inizio del 2025 per colmare quello che chiamiamo “il divario di implementazione”: la distanza tra ciò che i modelli sembrano in grado di fare e ciò che le persone possono usare in modo affidabile per svolgere il proprio lavoro.
Le capacità dei modelli sono progredite più rapidamente dei sistemi e dei processi necessari per metterle a frutto. A volte il tassello mancante è un prodotto. Altre volte un modello ottiene buoni risultati in un benchmark, ma non riesce a svolgere il compito con le variabili e i vincoli del mondo reale.
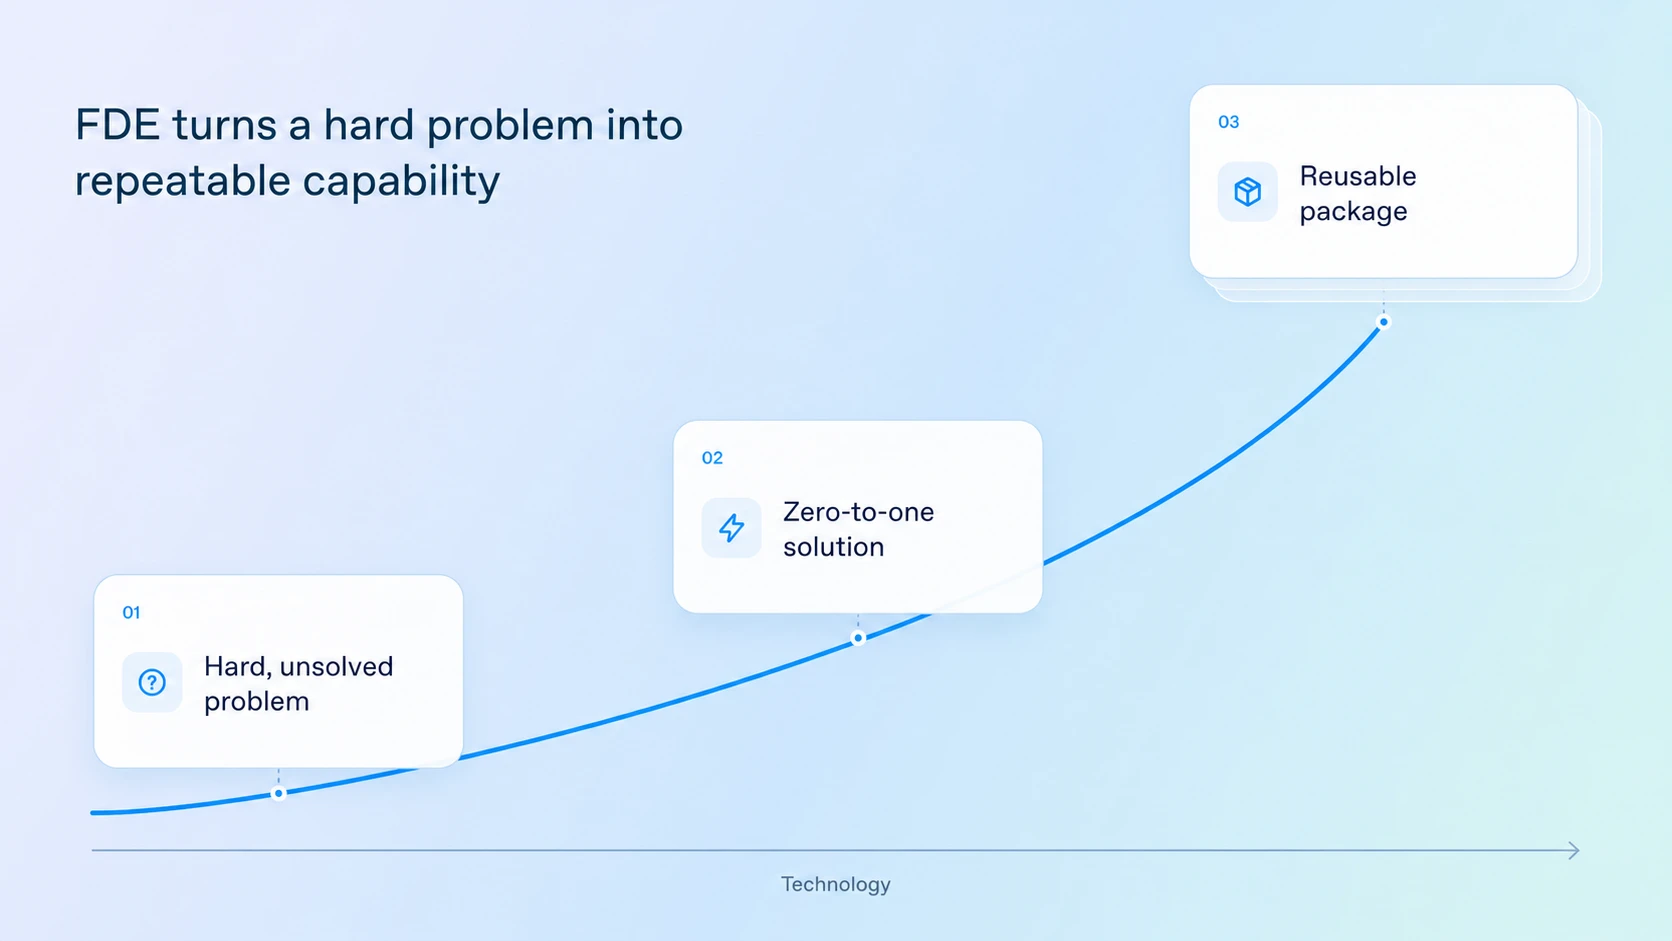
Ci concentriamo sui problemi più difficili dei clienti. Dove i nostri modelli sono già in grado di svolgere il compito, collaboriamo con il team di prodotto e con il cliente per rendere la soluzione replicabile. Dove invece non bastano, lavoriamo con i clienti e con il team di ricerca per definire le lacune e apportare miglioramenti. Il nostro obiettivo è che ogni collaborazione offra al cliente successivo un punto di partenza migliore: se alziamo il livello di base al punto che, la volta dopo, i clienti non hanno più bisogno dei Forward Deployed Engineer per risolvere quel tipo di problema, abbiamo fatto bene il nostro lavoro.
Per John Deere, azienda del settore agricolo con 200 anni di storia, la sfida era offrire consulenza personalizzata agli agricoltori su larga scala.
Un esempio è See & Spray, la sua tecnologia di diserbo di precisione, che usa telecamere e machine learning per individuare e irrorare le erbe infestanti anziché trattare interi campi, riducendo l'uso di prodotti chimici fino al 70%.
Per ottenere questi benefici, però, gli agricoltori devono sapere come configurare la tecnologia, pianificare la stagione e adattare le proprie pratiche al mutare delle condizioni.
John Deere ha adottato le API di OpenAI per rendere questo supporto personalizzato e scalabile.
L'IA può rispondere alle domande degli agricoltori in linguaggio naturale, fornire indicazioni e consigli su misura per la configurazione, individuare quando le attrezzature potrebbero non esprimere tutto il loro potenziale e aiutare gli agricoltori a capire quale valore stanno ricavando dalla tecnologia.
L'opportunità va oltre la singola interazione: offrire indicazioni pertinenti lungo tutto il percorso del cliente, aiutando gli agricoltori a usare meglio le proprie attrezzature e a migliorare efficienza e sostenibilità.
È questo il tipo di sfida che affrontano i Forward Deployed Engineer di OpenAI: aiutare le organizzazioni a trasformare le capacità dell'IA in sistemi che producono valore concreto in contesti reali e complessi.
Ma spesso i problemi sono ancora tutti da esplorare, può mancare un riferimento certo e non esiste un metodo collaudato. Tutti vogliono costruire qualcosa che non è mai esistito. Sono meno quelli disposti a fare ciò che serve per riuscirci.
Trovare Forward Deployed Engineer di talento e al tempo stesso alzare la soglia di ciò che consideriamo “abbastanza buono” ha richiesto sperimentazione e lavoro sul campo costanti.
All'inizio di ogni incontro del team di Forward Deployed Engineer, mostro una slide con un principio fondamentale: “Parti dal risultato, fai ciò che serve per riuscirci, poi passa alla scala”.
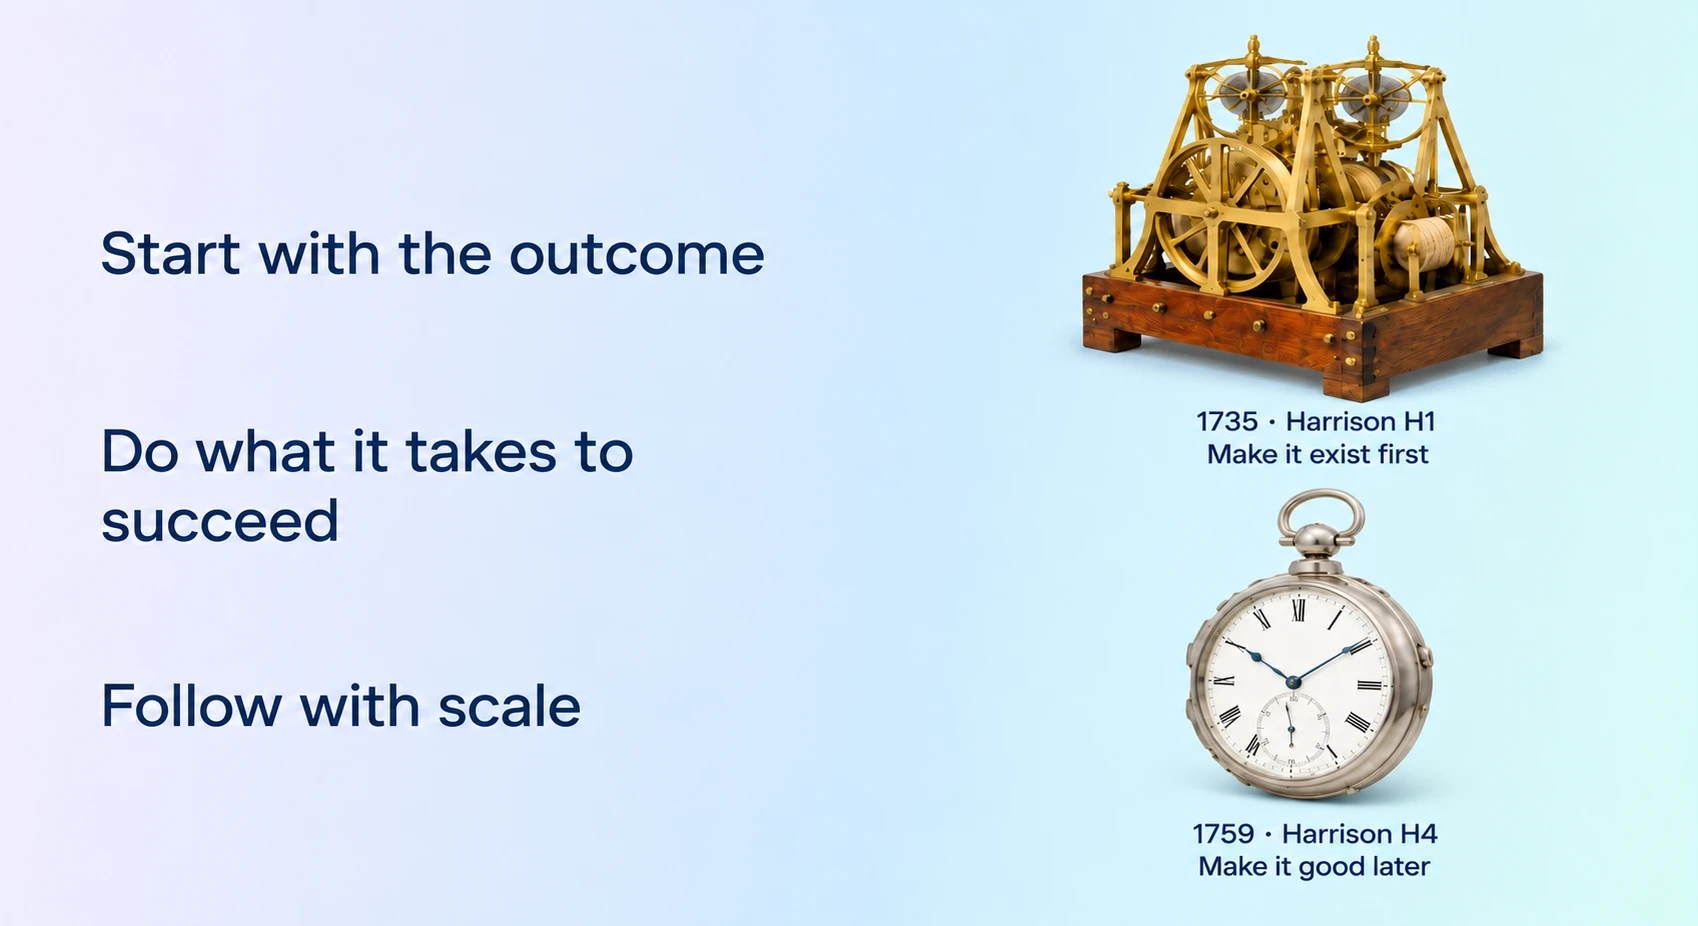
Una demo d'effetto può riscuotere molto successo prima che qualcuno chieda se funzioni nel mondo reale.
Il nostro compito è risolvere il problema del cliente con un livello di qualità che possiamo garantire in produzione.
A metà del 2025, circa 15 Forward Deployed Engineer lavoravano con un grande cliente del settore dei semiconduttori su oltre 10 casi d'uso. L'obiettivo era ripensare il loro processo di verifica attorno all'IA, intervenendo su:
Generazione di test mirati
Analisi delle cause profonde e debug
Un assistente per la progettazione dell'architettura
In questo settore, la verifica può assorbire circa il 70% del lavoro richiesto da un progetto. L'opportunità era enorme e i possibili punti di partenza erano molti.
Alcuni Forward Deployed Engineer erano entrati in OpenAI solo pochi giorni prima e non avevano mai lavorato nel settore dei semiconduttori. Si sono integrati nel team di verifica del cliente, hanno studiato la progettazione dei chip nel tempo libero e hanno sviluppato valutazioni insieme agli ingegneri per verificare se l'IA potesse generare test utili e diagnosticare correttamente i malfunzionamenti dei chip.
Mentre imparavamo, abbiamo anche costruito infrastrutture su misura per i singoli casi d'uso. Nei primi 3-6 mesi, tutti sono entrati in produzione e hanno iniziato a essere adottati dagli utenti. La soddisfazione è arrivata vedendo i numeri:
Circa il 48% di tempo risparmiato grazie alla generazione di test mirati basata sull'IA.
Miglioramento mediano delle prestazioni del 22% grazie all'ottimizzazione dei kernel.
Settimane di debug ridotte a poche ore
Quando abbiamo presentato tutti questi risultati, il Chief Hardware Officer ha chiesto: “Prima di venire qui lavoravate come progettisti di chip?”
I nostri Forward Deployed Engineer non devono conoscere il settore fin dal primo giorno, ma hanno la responsabilità di imparare a conoscerlo.
Man mano che gli assistenti di programmazione accelerano lo sviluppo del software, comprendere l'attività del cliente diventa ancora più importante. Formiamo team che uniscono generalisti ed esperti di settore.
Servono conoscenze sufficienti per formulare giudizi fondati e abbastanza curiosità da mettere in discussione ciò che si dà per scontato nello stato attuale delle cose.
Nelle scienze della vita, per esempio, la formazione scientifica dei nostri Forward Deployed Engineer li aiuta a conquistare la fiducia dei ricercatori che lavorano alla scoperta di farmaci in fase preclinica, in attività come la validazione e la definizione delle priorità dei bersagli terapeutici, l'analisi dell'espressione genica e la ricostruzione delle vie di sintesi chimica. Queste competenze consentono loro di contribuire con valutazioni fondate su come migliorare tali flussi di lavoro.
Avevamo dimostrato che questi flussi di lavoro potevano generare valore, ma estenderli a un altro team richiedeva ancora troppo lavoro di integrazione su misura. La sfida successiva era mantenere quei risultati rendendo il software più semplice da implementare e mantenere.
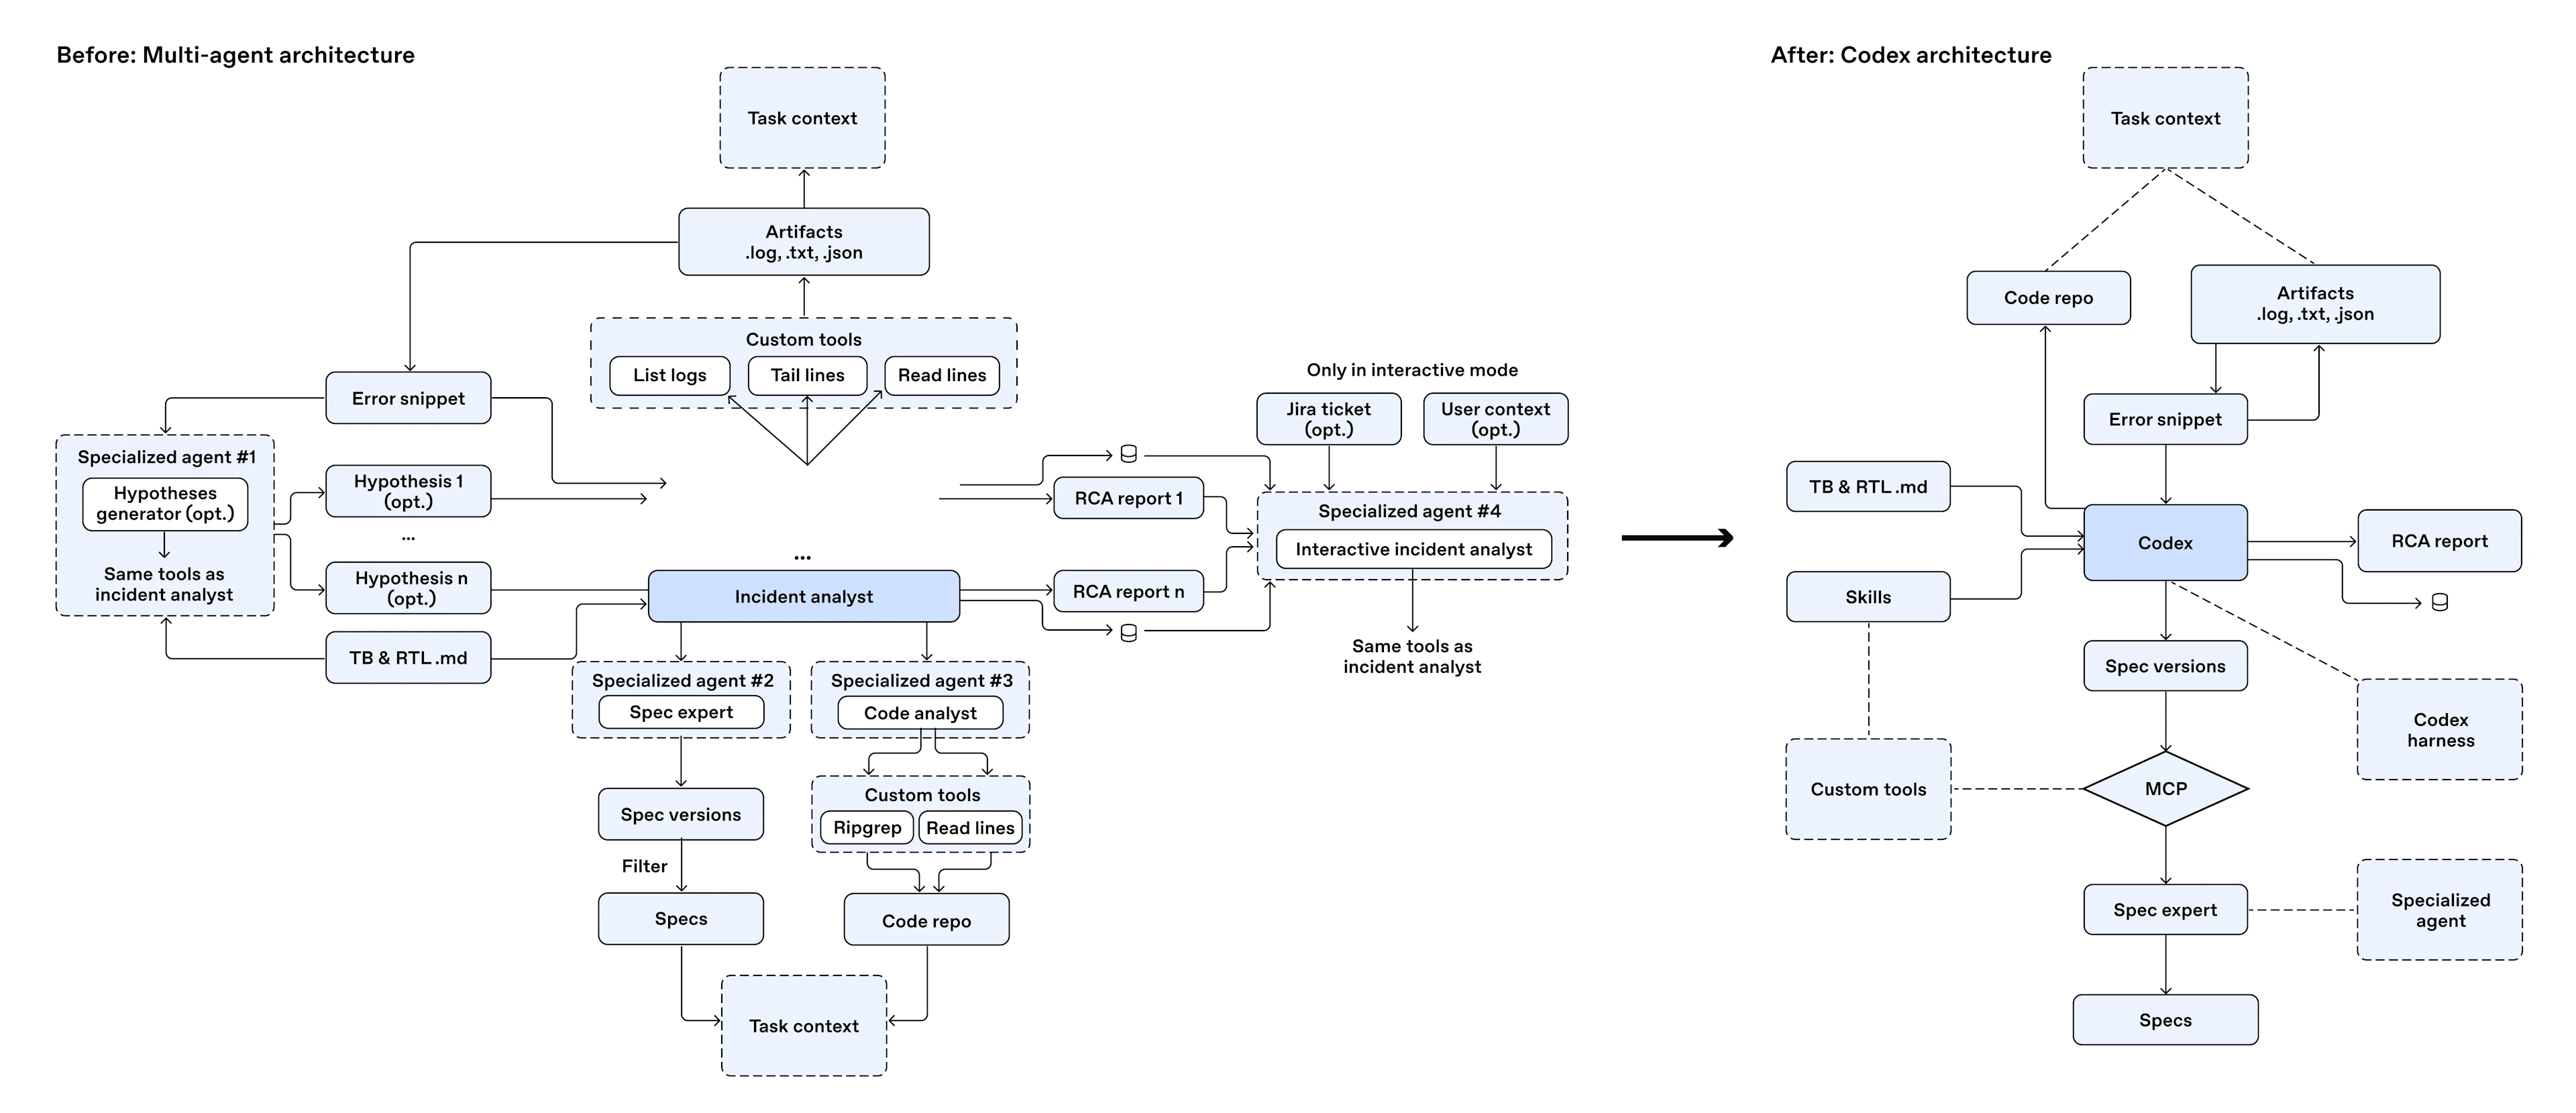
Nel frattempo, le capacità di Codex erano cresciute. Un Forward Deployed Engineer ha provato a ricostruire l'applicazione attorno a Codex, poi ha lavorato con il team per trasferire i casi d'uso su un'infrastruttura comune con Codex al centro.
Le applicazioni personalizzate sono diventate plugin e competenze basati su primitive comuni di Codex. Codex è diventato anche l'interfaccia, permettendoci di dismettere le interfacce utente da terminale e le CLI separate che avevamo scritto per i singoli casi d'uso.
Abbiamo potuto eliminare circa il 90% del codice personalizzato da ogni progetto, cambiando così il modo in cui sviluppavamo, mantenevamo ed estendevamo questi flussi di lavoro:
Potevamo beneficiare dei miglioramenti centralizzati di Codex, riducendo la quantità di codice di raccordo necessaria per ogni singolo caso d'uso
Le funzionalità chiave sono state raccolte in competenze e plugin, rendendole più facili da condividere tra i team e da gestire centralmente da parte del centro di eccellenza per l'IA. Per estendere la soluzione da un team all'altro poteva quindi bastare sostituire i connettori o i server MCP, creare nuove valutazioni (per cui avevamo anche una competenza dedicata) e iniziare a lavorare.
In un caso dell'agosto 2026, l'implementazione iniziale ha richiesto due mesi. Per estendere la soluzione a un secondo team è bastato un giorno. Man mano che aumentava la scala, i team successivi diventavano operativi più rapidamente. Questa tendenza è proseguita: per un caso d'uso dell'agosto 2026, sono serviti due mesi per l'implementazione iniziale e un solo giorno per il secondo team.
Questo è uno dei modi in cui rendiamo superfluo il nostro intervento. Il lavoro svolto per arrivare in produzione aveva chiarito ciò che contava davvero. Con il migliorare del prodotto sottostante, abbiamo potuto sostituire gran parte della nostra implementazione su misura, mantenendo il valore che offriva.
Ecco perché l'ordine conta. Gli LLM ci permettono di sviluppare rapidamente. Usa questa velocità per mettere qualcosa di utile nelle mani degli utenti, capire cosa regge alla prova dei fatti e poi estendere ciò che funziona.
Lo stesso principio vale per tutte le collaborazioni.
OpenAI Presence, il nostro prodotto per agenti vocali e di chat destinati alle aziende, è nato da reali implementazioni dei clienti. L'opera iniziò con Swarm(si apre in una nuova finestra) ed evolse attraverso l’Agents API, e oggi un cliente gestisce più della metà delle sue chiamate con l'IA.
Portare quelle implementazioni in produzione ci ha insegnato quali problemi necessitavano di una soluzione personalizzata e quali elementi di base potevano usare gli altri team. Abbiamo integrato questi mattoni di base in Presence, rendendo più facile per gli sviluppatori automatizzare i flussi di lavoro regolamentati senza ricostruire l'infrastruttura sottostante. Ogni distribuzione ha contribuito a plasmare il prodotto e ha dato al cliente successivo un punto di partenza migliore.
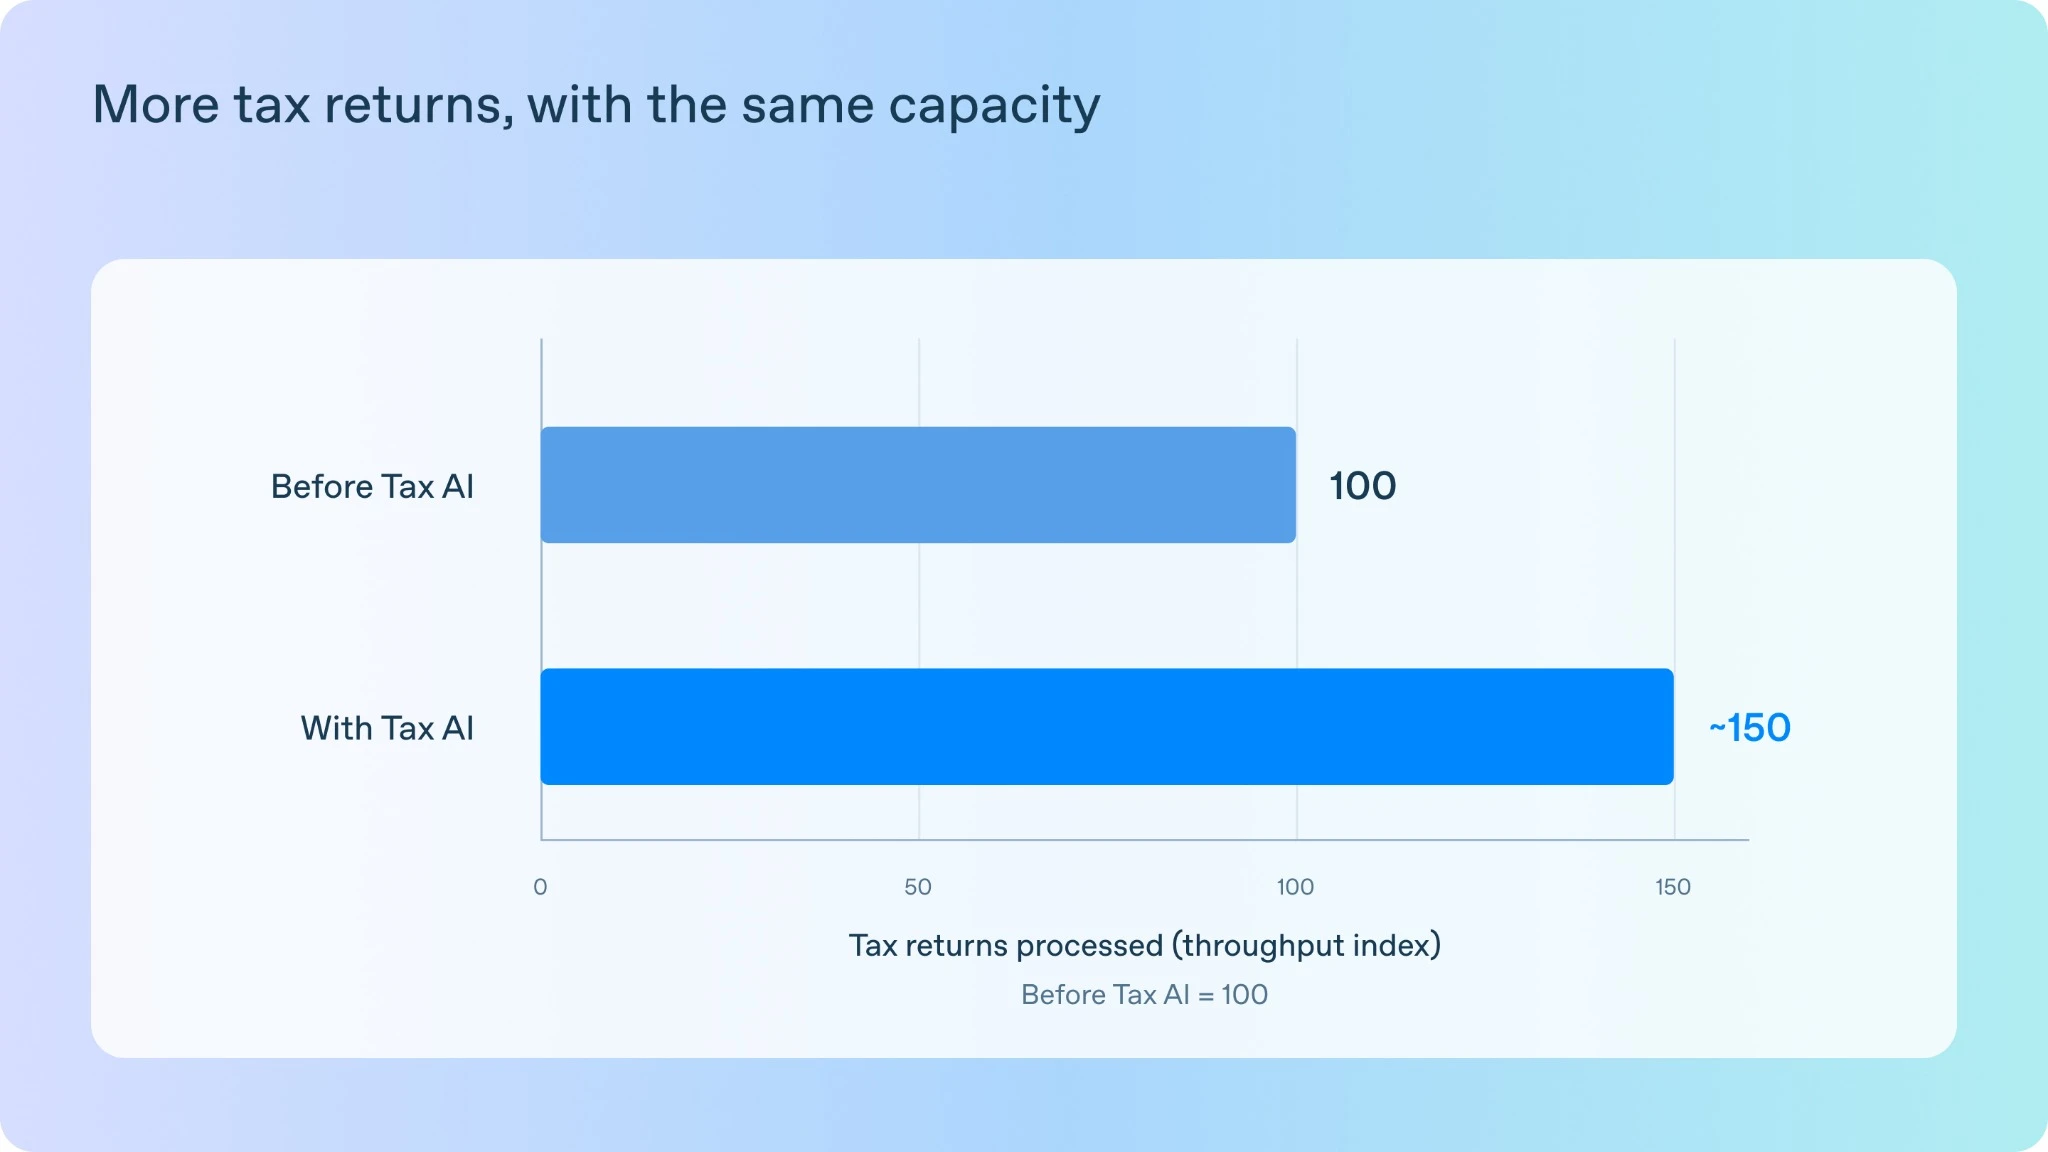
Con Thrive Holdings, i Forward Deployed Engineer e i ricercatori di OpenAI hanno collaborato con ingegneri e commercialisti per sviluppare Tax AI per gli studi contabili della rete Crete. Durante il suo progetto pilota, Tax AI ha elaborato 7.000 dichiarazioni dei redditi e aumentato la capacità di elaborazione di circa il 50%.
Una delle sfide più difficili è stata automatizzare la compilazione delle dichiarazioni fiscali relative agli immobili in affitto, un’attività che ha richiesto sei settimane di sviluppo e revisione da parte dei professionisti per raggiungere il 90% di precisione e richiamo. Il lavoro ha creato schemi riutilizzabili che hanno facilitato l'estensione di Tax AI ad altri moduli fiscali complessi.
I team ora applicano lo stesso approccio alla contabilità, all’audit e al supporto IT—costruendo sistemi che migliorano attraverso il feedback dei professionisti e l'uso nel mondo reale.
A volte un prodotto migliore ci permette di semplificare ciò che abbiamo costruito, ma altre volte è il modello stesso a non essere ancora in grado di svolgere il compito.
Se costruiamo solo ciò che i modelli attuali rendono già possibile, non scopriremo le lacune nelle capacità che il team di ricerca dovrà colmare. Per questo molte delle nostre collaborazioni più importanti partono proprio da quei limiti, con il cliente, i Forward Deployed Engineer e il team di ricerca impegnati a superarli insieme.
Avevamo già sviluppato una piattaforma di assistenza clienti insieme a un grande cliente del settore delle telecomunicazioni, che voleva estenderla al canale vocale.
Il canale vocale rappresentava circa il 90% del volume di richieste di assistenza. Gestire queste richieste senza l'intervento di un operatore costava più che in chat e poneva nuove sfide tecniche: occorreva portare la gestione degli accenti, il tono, la latenza e l'accuratezza a livelli adeguati all'uso in produzione. Riuscirci avrebbe fatto una differenza sostanziale per la loro attività.
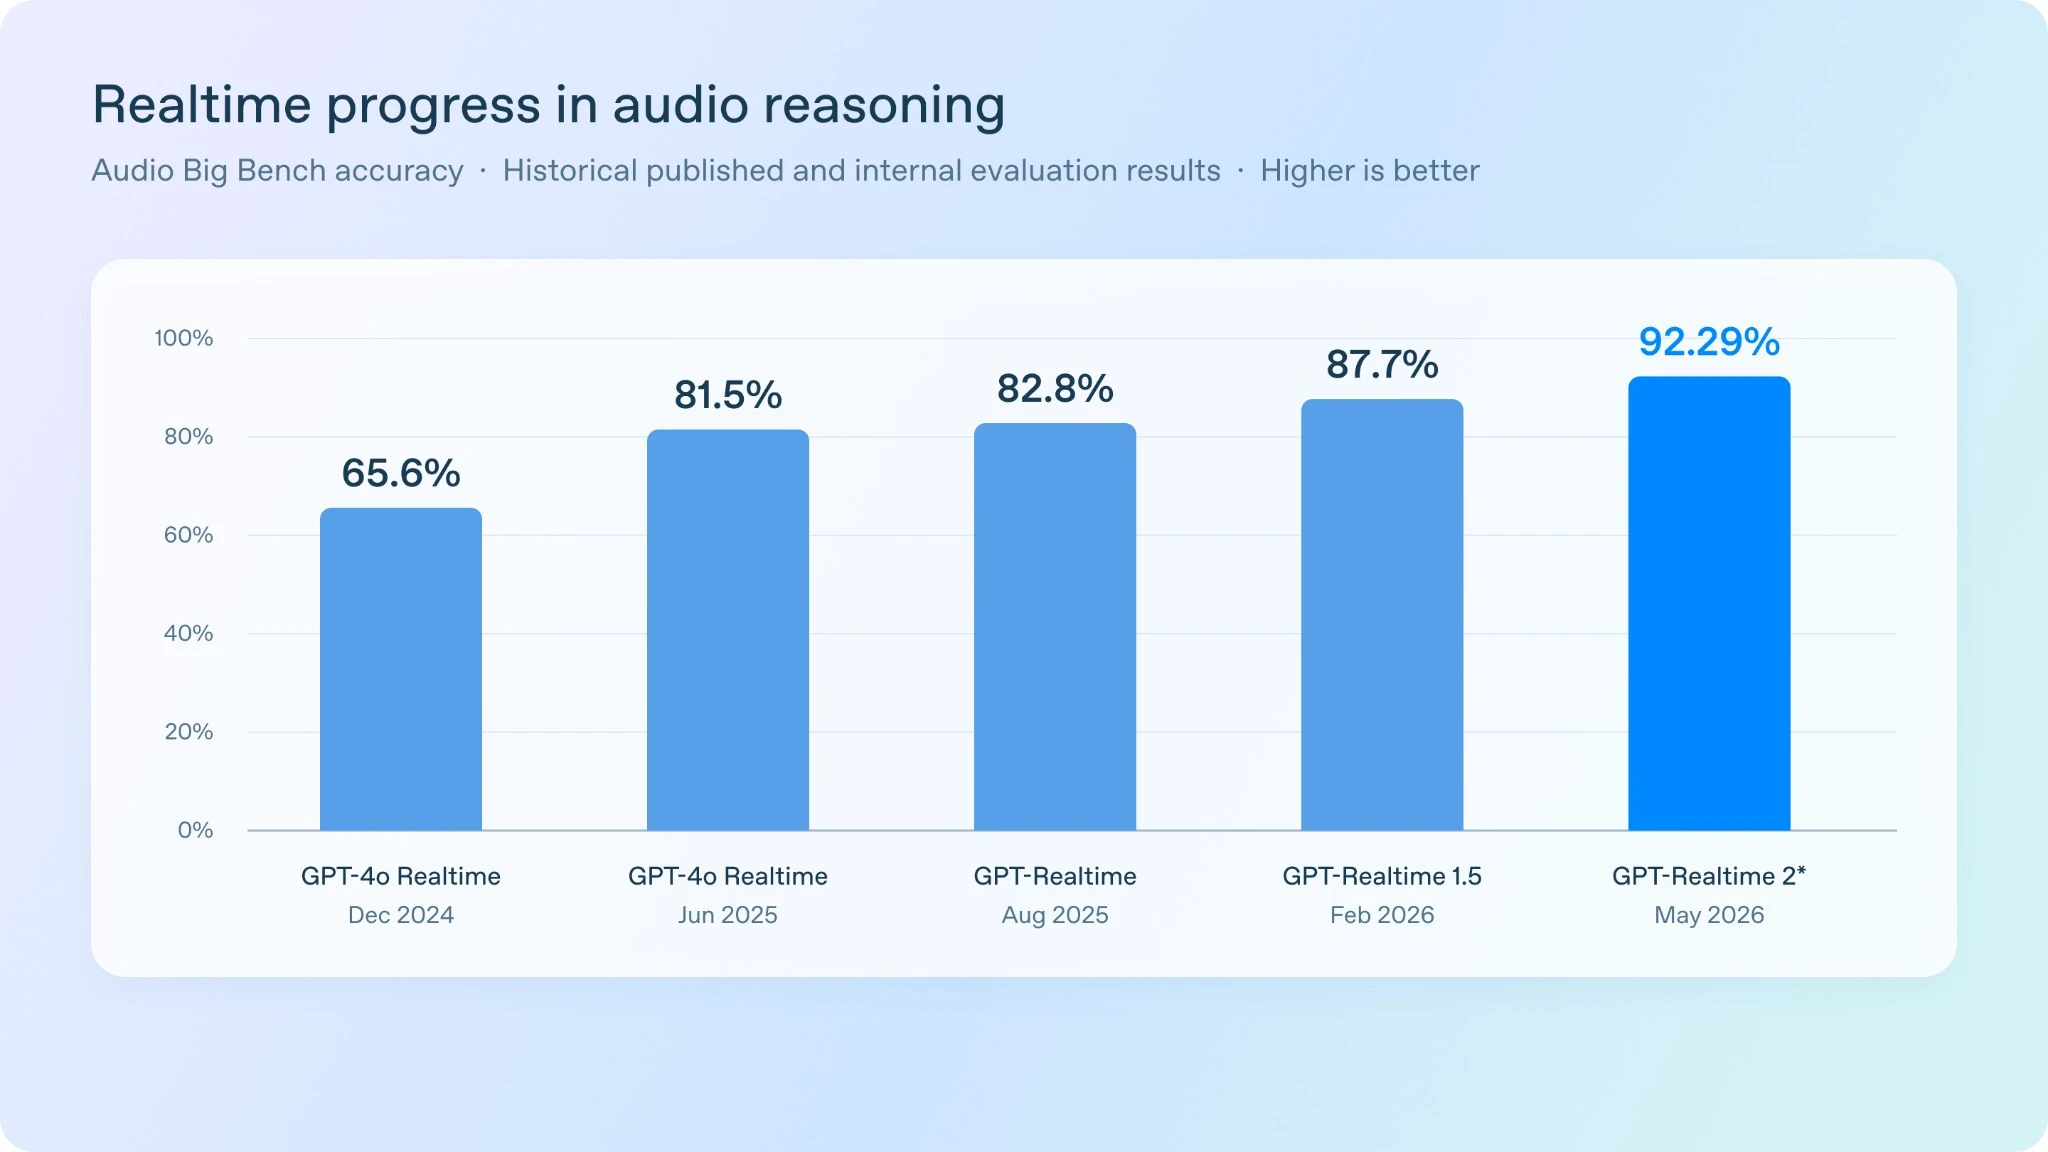
Durante la definizione del progetto, il nostro modello otteneva circa il 60% nelle principali valutazioni usate per stabilire se fosse in grado di svolgere il compito in produzione. Avevamo raggiunto i limiti delle sue capacità. La chiamata di funzioni e la capacità di seguire le istruzioni negli scenari di assistenza clienti dovevano migliorare.
Lo abbiamo spiegato al cliente e abbiamo coinvolto il team di ricerca. Il team di Forward Deployed Engineer ha collaborato con il cliente per costruire la piattaforma e definire cosa dovesse fare il modello. Il team di ricerca ha lavorato per colmare le lacune del modello, fornendoci versioni successive con cui verificare i progressi rispetto ai requisiti del cliente.
In sei mesi, i risultati nelle principali valutazioni sono passati da circa il 60% all'80% e poi a oltre il 90%, raggiungendo i livelli necessari per l'uso in produzione.
Il modello vocale così ottenuto è ora alla base della soluzione di quel cliente, di altre soluzioni personalizzate per l'assistenza clienti e di quelle gestite tramite Presence. Un problema riscontrato nell'attività di un cliente ha contribuito a individuare miglioramenti utili a molti altri.
Ogni contributo è stato importante. Il cliente si è impegnato a lavorare su un problema che il modello non era ancora in grado di risolvere. Il team di Forward Deployed Engineer ha mantenuto uno stretto contatto con il cliente per definire il problema, costruire la piattaforma e guidare la collaborazione dall'inizio alla fine. Il team di ricerca ha migliorato le capacità del modello sottostante.
Questo è l'altro modo in cui rendiamo superfluo il nostro intervento: contribuire a trasformare un problema che i modelli attuali non sanno risolvere in una capacità che i modelli futuri potranno offrire. Il valore del nostro lavoro va oltre le ore che dedichiamo a un singolo cliente.
Sono entrato in OpenAI per contribuire a rendere l'IA utile nel lavoro quotidiano delle persone. È ancora questo a guidare il team. Dico spesso al team che, nello sviluppo degli LLM, nella maggior parte dei casi vale il rasoio di Occam: la soluzione più semplice è la migliore. In un'azienda che si distingue per la ricerca d'avanguardia e in un settore inquinato dalle esagerazioni, vogliamo costruire soluzioni che funzionino in modo affidabile e su cui chi lavora sul campo possa contare.
L'obiettivo è che ogni collaborazione migliori ciò che viene dopo: un prodotto più semplice da implementare, un modello capace di affrontare un compito più difficile o meno lavoro su misura per il cliente successivo.
Se hai un problema difficile da risolvere, ci piacerebbe lavorare con te. Se vuoi contribuire a risolvere questi problemi, ci piacerebbe averti nel nostro team.
Quindi, cosa facciamo quando Codex riesce a svolgere il lavoro per cui abbiamo impiegato mesi a costruire soluzioni?
Andiamo in cerca di un problema più difficile.