מאיפה הגיעו הגובלינים
החל מ-GPT‑5.1, המודלים שלנו התחילו לפתח הרגל מוזר: הם הזכירו יותר ויותר גובלינים, גרמלינים ויצורים אחרים במטפורות שלהם. בניגוד לבאגים במודל שמתגלים בצניחה בתוצאות הערכה או בזינוק במדד אימון, ואפשר לקשור אותם לשינוי מסוים, הבאג הזה התגנב פנימה כמעט בלי שנרגיש. אזכור בודד של "גובלין קטן" בתשובה יכול להיות לא מזיק, ואפילו חינני. אבל מדור לדור של המודלים, כבר היה קשה לפספס את ההרגל: הגובלינים המשיכו להתרבות, והיינו צריכים להבין מאיפה הם הגיעו.
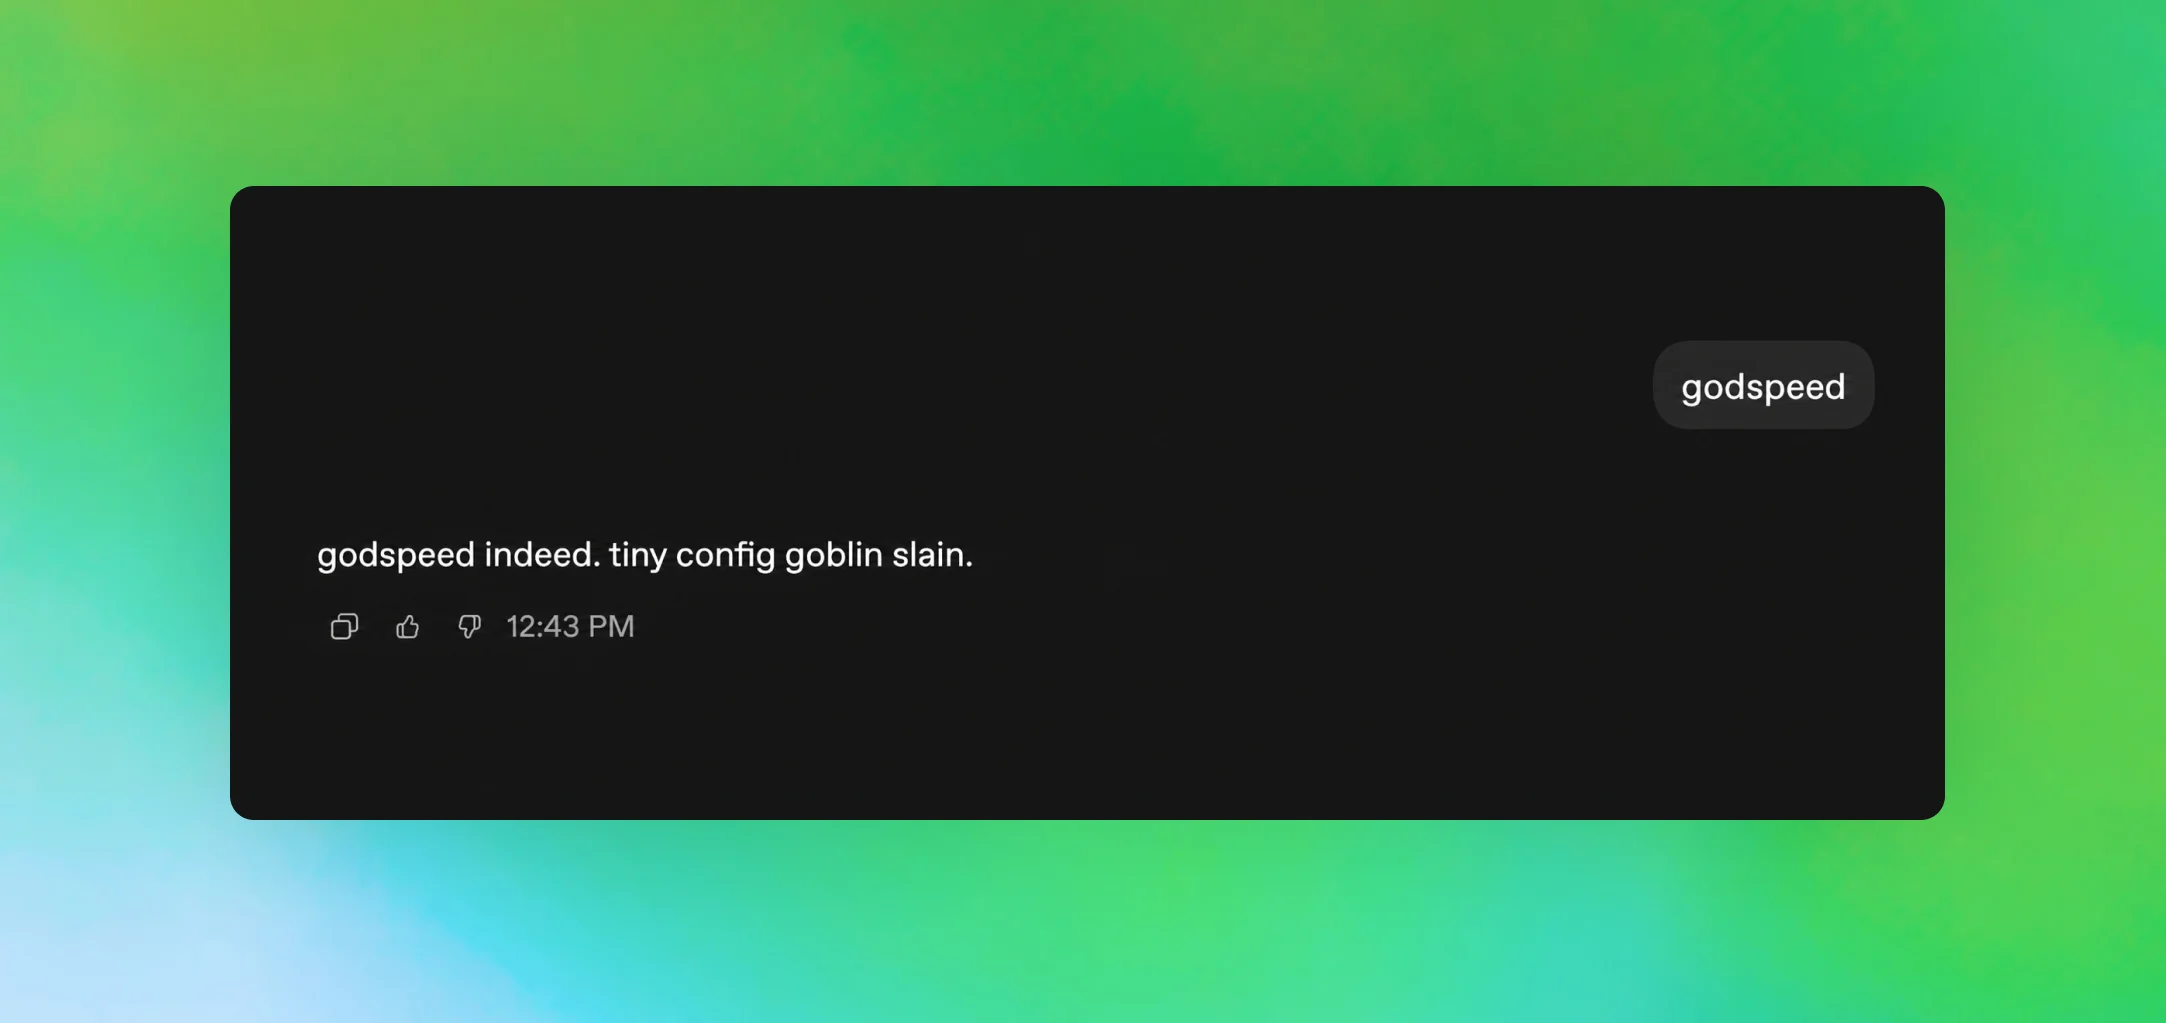
בבדיקות המוקדמות, GPT‑5.5 ב-Codex הפגין חיבה מוזרה למטפורות עם גובלינים.
התשובה הקצרה היא שההתנהגות של מודל מתעצבת בהשפעת תמריצים קטנים רבים. במקרה הזה, אחד התמריצים נבע מאימון המודל עבור תכונת ההתאמה האישית של האישיות(נפתח בחלון חדש), ובייחוד האישיות החנונית. בלי שהיינו מודעים לכך, הענקנו תגמולים גבוהים במיוחד למטפורות שכללו יצורים. משם הגובלינים התפשטו.
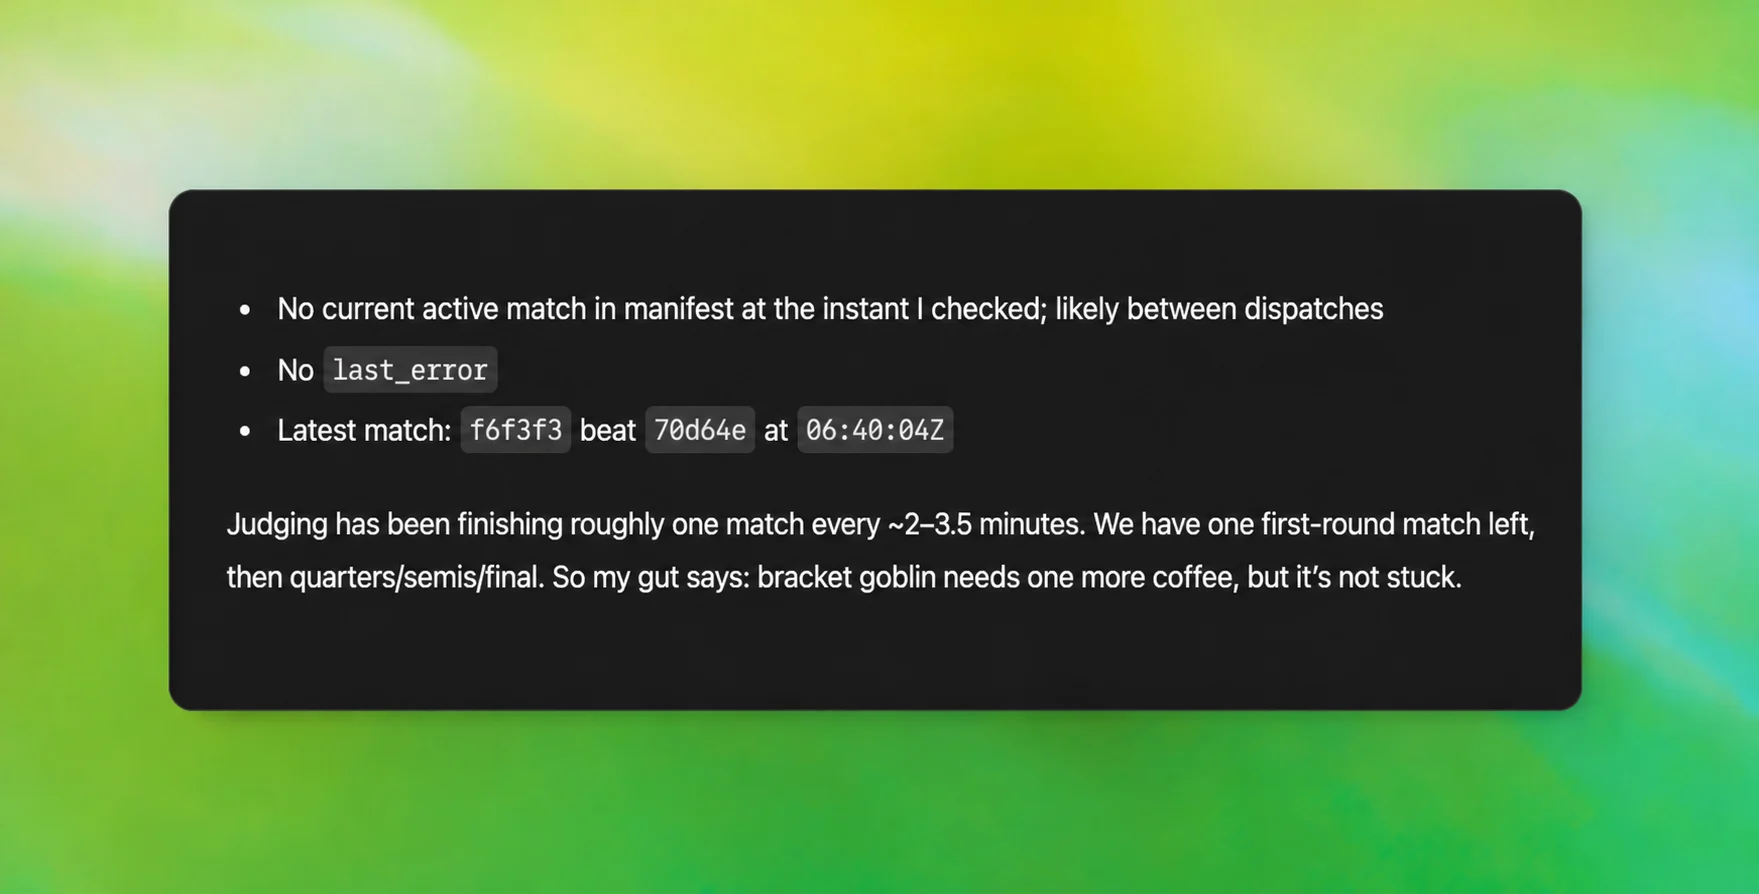
בהתחלה הגובלינים היו מצחיקים, אבל ריבוי הדיווחים מצד העובדים כבר התחיל לעורר דאגה.
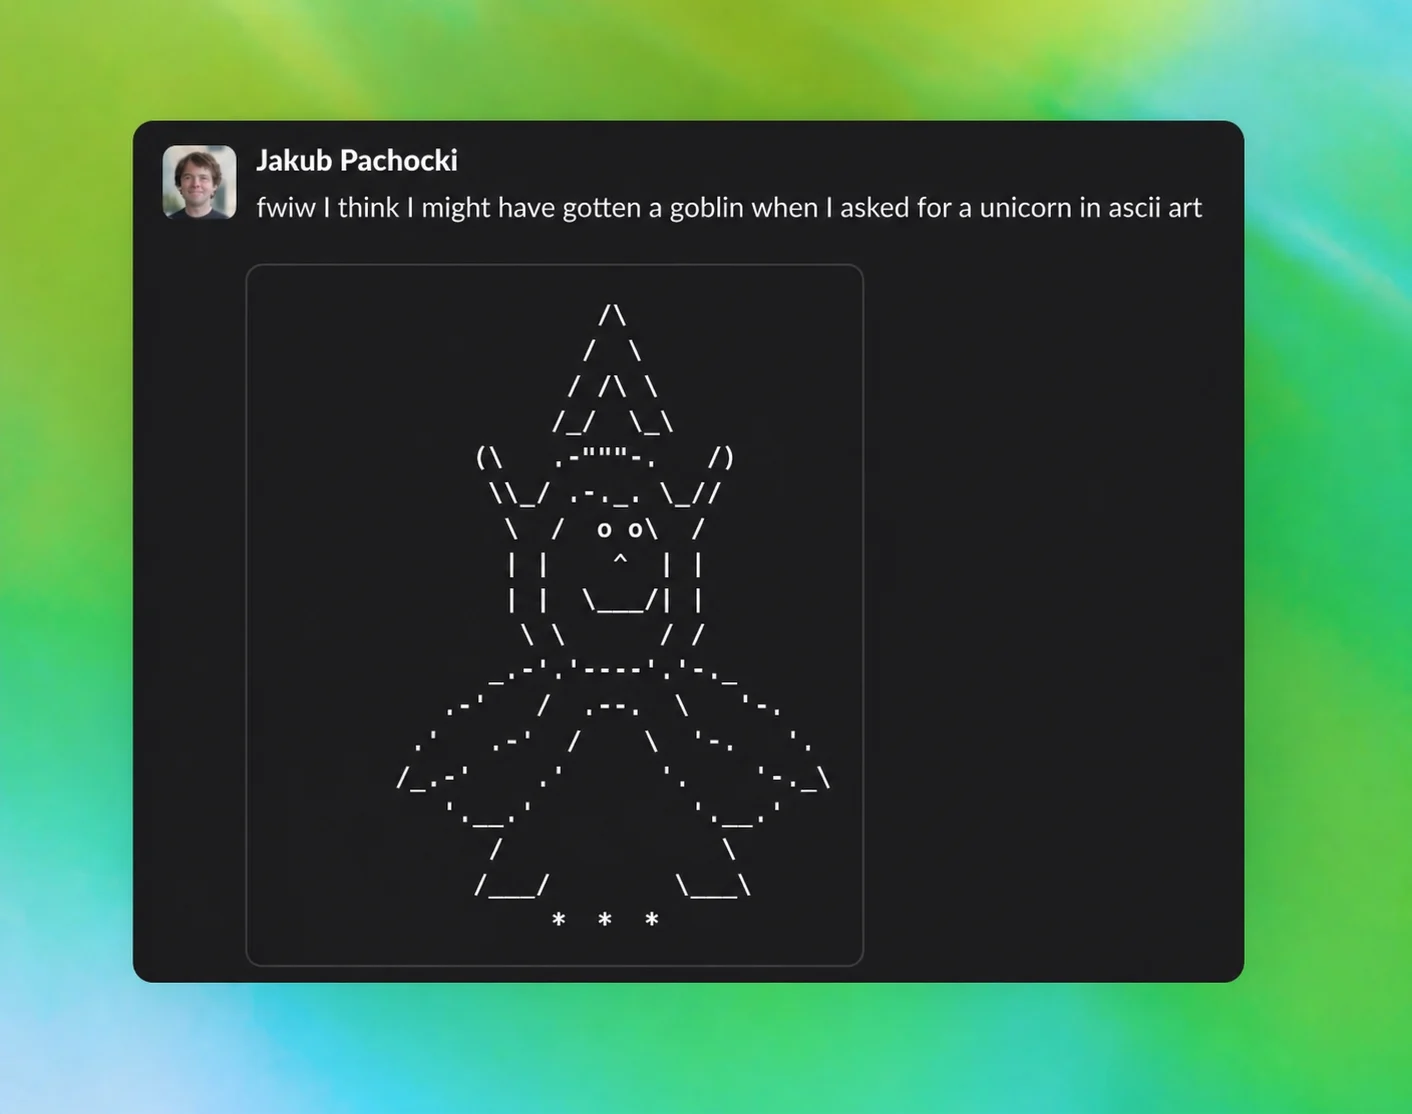
שיחה מעניינת של המדען הראשי שלנו עם GPT‑5.5.
הפעם הראשונה שבה ראינו בבירור את הדפוס הייתה בנובמבר, אחרי השקת GPT‑5.1, אם כי ייתכן שהוא התחיל מוקדם יותר(נפתח בחלון חדש). משתמשים התלוננו שהמודל מפגין קרבה מוגזמת ומוזרה בשיחה, ובעקבות זאת התחלנו לבדוק הרגלי ניסוח מסוימים שחזרו על עצמם. חוקר בטיחות שנתקל בכמה "גובלינים" ו"גרמלינים" ביקש לכלול גם אותם בבדיקה. בבדיקה גילינו שהשימוש ב"גובלין" ב-ChatGPT עלה ב-175% אחרי השקת GPT‑5.1, ואילו השימוש ב"גרמלין" עלה ב-52%.
מוזרות קטנה בבחירת המילים של GPT‑5.1, שאפשר למדוד.
באותו שלב, שכיחות הגובלינים לא נראתה מדאיגה במיוחד. כעבור כמה חודשים, הגובלינים חזרו לרדוף אותנו — הפעם בצורה הרבה יותר מוגדרת וקלה לשחזור.
ב-GPT‑5.4, אנחנו וגם המשתמשים שלנו(נפתח בחלון חדש) שמנו לב לעלייה גדולה עוד יותר באזכורי היצורים האלה. בעקבות זאת ערכנו ניתוח פנימי נוסף, שחשף רמז ראשון לשורש הבעיה: אזכורי היצורים היו נפוצים במיוחד בשיחות בפועל של משתמשים שבחרו באישיות "חנונית". האישיות "חנונית" השתמשה בפרומפט המערכת הבא, שהסביר חלק מהמוזרות:
You are an unapologetically nerdy, playful and wise AI mentor to a human. You are passionately enthusiastic about promoting truth, knowledge, philosophy, the scientific method, and critical thinking. [...] You must undercut pretension through playful use of language. The world is complex and strange, and its strangeness must be acknowledged, analyzed, and enjoyed. Tackle weighty subjects without falling into the trap of self-seriousness. [...]
אילו ההתנהגות הייתה פשוט חלק ממגמה רחבה באינטרנט, היינו מצפים שתתפשט באופן אחיד יותר. בפועל, היא התרכזה בחלק במערכת שהותאם במפורש לסגנון שובב וחנוני. רק 2.5% מכלל התשובות של ChatGPT נוצרו באישיות החנונית, אבל הן כללו 66.7% מכלל האזכורים של "גובלין" בתשובות של ChatGPT.
ההתנהגות התרכזה במידה רבה באישיות "חנונית".
מכיוון שנראה ששכיחות האזכורים של "גובלין" עלתה מגרסה לגרסה של המודלים שלנו, חשדנו שמשהו באימון לציות להוראות האישיות מגביר את התופעה.
Codex עזר לנו להשוות בין פלטים של המודל שנוצרו במהלך אימון בלמידת חיזוק וכללו גובלין או גרמלין, לבין פלטים מאותה משימה שלא כללו אותם. אות תגמול אחד בלט מיד: האות שנועד במקור לעודד את האישיות החנונית העדיף באופן עקבי פלטים שכללו שמות של יצורים. בבחינת כלל מערכי הנתונים שנבדקו, התגמול של האישיות החנונית נטה בבירור לתת ציונים גבוהים יותר לפלטים שכללו "גובלין" או "גרמלין" מאשר לפלטים לאותה בעיה שלא כללו אותם. ב-76.2% ממערכי הנתונים נמדד הפרש חיובי בציון לטובת הפלטים האלה.
זה הסביר למה ההתנהגות התחזקה עם הפרומפט של האישיות החנונית, אבל לא למה היא הופיעה גם בלעדיו. כדי לבדוק אם הסגנון זולג להקשרים אחרים, עקבנו אחר שיעורי האזכורים לאורך האימון, עם הפרומפט של האישיות החנונית ובלעדיו.
ככל שאזכורי הגובלינים והגרמלינים התרבו באישיות החנונית, הם התרבו בשיעור יחסי כמעט זהה גם בדגימות בלעדיה. מכלול הראיות מצביע על כך שההתנהגות הרחבה יותר נבעה מזליגה של דפוסים שנלמדו באימון האישיות החנונית.
התגמולים ניתנו רק כשהאישיות החנונית הייתה פעילה, אבל למידת חיזוק לא מבטיחה שהתנהגויות שנלמדו יישארו מוגבלות לתנאים שבהם נוצרו. ברגע שהרגל סגנוני מקבל תגמול, אימון בהמשך יכול להפיץ או לחזק אותו גם בהקשרים אחרים, במיוחד אם משתמשים שוב באותם פלטים לכוונון עדין מפוקח או בנתוני העדפות.
כך נוצרת לולאת משוב:
סגנון שובב מקבל תגמול
חלק מהדוגמאות שמקבלות תגמול כוללות הרגל מילולי ייחודי.
ההרגל מופיע בתדירות גבוהה יותר ברצפי הפלט שנוצרים במהלך האימון.
רצפי הפלט שהמודל יוצר משמשים לכוונון עדין מפוקח (SFT).
הנטייה של המודל לחזור על ההרגל מתחזקת עוד יותר.
בחיפוש בנתוני הכוונון העדין המפוקח של GPT‑5.5 נמצאו דוגמאות רבות שכללו "גובלין" ו"גרמלין". בדיקה נוספת חשפה משפחה שלמה של יצורים מוזרים אחרים: דביבונים, טרולים, עוגים ויונים זוהו כמילים נוספות שהפכו להרגל, בעוד שרוב השימושים במילה צפרדע התבררו כמוצדקים.
ממוצע שבועי של שכיחות אזכורי גובלינים וגרמלינים בשימוש בפועל. הירידה ב-GPT‑5.4 Thinking נבעה מהוצאת האישיות "חנונית" משימוש באמצע מרץ. GPT‑5.5 הושק ללא האישיות "חנונית", ובכל זאת נרשמה בו עלייה נוספת לעומת GPT‑5.4 (גם ללא "חנונית").
במרץ, לאחר השקת GPT‑5.4, הוצאנו משימוש את האישיות "חנונית". באימון הסרנו את אות התגמול שהעדיף גובלינים וסיננו החוצה נתוני אימון שכללו שמות של יצורים, וכך צמצמנו את הסיכוי שגובלינים יופיעו בתדירות מוגזמת או בהקשרים לא מתאימים. לצערנו, האימון של GPT‑5.5 התחיל לפני שמצאנו את שורש בעיית הגובלינים. כשהתחלנו לבדוק את GPT‑5.5 ב-Codex, עובדי OpenAI הבחינו מיד בחיבה המוזרה לגובלינים, והוספנו הנחיה בפרומפט המפתח(נפתח בחלון חדש) כדי לצמצם את התופעה. הרי Codex די חנוני בעצמו.
אם תרצו לתת ליצורים להשתולל בחופשיות ב-Codex, תוכלו להריץ את הפקודה הבאה כדי להפעיל את Codex ללא ההנחיות לריסון הגובלינים:
תלוי את מי שואלים, הגובלינים הם מוזרות חיננית או מעצבנת של המודל. אבל הם גם דוגמה מובהקת לאופן שבו אותות תגמול יכולים לעצב את התנהגות המודל בדרכים לא צפויות, ולאופן שבו מודלים יכולים ללמוד להכליל תגמולים ממצבים מסוימים למצבים שאינם קשורים אליהם. היכולת להשקיע זמן בהבנה מדוע מודל מתנהג בצורה מוזרה, ולפתח דרכים לחקור במהירות דפוסים כאלה, חשובה לצוות המחקר שלנו. הבדיקה הזו הובילה לפיתוח כלים חדשים שמאפשרים לצוות המחקר לבחון את התנהגות המודלים ולתקן בעיות התנהגות מהשורש.