פוסט זה הציג את GPT-5.6 בשנת 2026.
עדכון מ-21 באוגוסט 2026: OpenAI הורידה את מחירי ה-API והקרדיטים של GPT‑5.6 Sol ביותר מ-20% לשלושת החודשים הקרובים.
עדכון מ-30 ביולי 2026: OpenAI הורידה את המחיר של GPT‑5.6 Luna ב-80% ושל GPT‑5.6 Terra ב-20%. למידע נוסף.
אנחנו משיקים את משפחת המודלים GPT‑5.6 לזמינות כללית לאחר התצוגה המקדימה המוגבלת: מודל הדגל החדש שלנו, Sol, לצד Terra, מודל מאוזן לעבודה יומיומית, ו-Luna, המודל החסכוני ביותר שלנו.
GPT‑5.6 Sol קובע רף חדש הן בבינה והן ביעילות, עם תוצאות שיא בתכנות, בעבודת ידע, באבטחת סייבר ובמדע. הוא עולה בביצועיו על מודלי חזית קודמים ומתחרים, תוך שימוש בפחות טוקנים ובעלות משוערת נמוכה יותר. התוצאה היא ביצועים טובים יותר לכל דולר: יותר עבודה מוצלחת באותה הוצאה, או תוצאות דומות בעלות כוללת נמוכה יותר. אנחנו מציגים גם דרך חדשה להאיץ את העבודה התובענית ביותר: ultra היא ההגדרה בעלת היכולות הגבוהות ביותר שלנו, והיא מתאמת בין כמה סוכנים הפועלים במקביל כדי להשלים משימות מורכבות מהר יותר. יכולות משופרות של שימוש במחשב ושיקול דעת עיצובי הופכות את GPT‑5.6 Sol לשותף העבודה המלוטש ביותר שלנו עד כה, ומסייעות לו לבדוק, לשפר ולספק תוצאות המוכנות לשימוש.
אימנו את GPT‑5.6 להפיק יותר עבודה מועילה מכל טוקן. ב-Agents’ Last Exam(נפתח בחלון חדש), מבחן של תהליכי עבודה מקצועיים ממושכים ב-55 תחומים, GPT‑5.6 Sol קובע שיא חדש של 53.6, ועולה על Claude Fable 5 (עם reasoning אדפטיבי) ב-13.1 נקודות. גם ברמת reasoning בינונית, הוא גובר על Fable 5 ב-11.4 נקודות, בכרבע מהעלות המשוערת. היעילות הזו ניכרת גם במודלים קטנים יותר, החיוניים להנגשת הבינה ולהוזלתה: GPT‑5.6 Terra ו-GPT‑5.6 Luna עולים בביצועיהם על Fable 5 בעלות של כ-1/16 ממנו. ב-Artificial Analysis Intelligence Index(נפתח בחלון חדש), מדד רחב לבינה הכולל עבודה אג'נטית, תכנות, reasoning מדעי ויכולות כלליות, GPT‑5.6 Sol ברמת reasoning מקסימלית מגיע לפער של פחות מנקודה מ-Fable 5, תוך השלמת משימות ב-61% פחות זמן ובכמחצית העלות המשוערת.
GPT‑5.6 מושק עם אמצעי ההגנה העמידים ביותר שלנו עד כה, שנועדו לעמוד בפני ניסיונות נחושים ומסתגלים לשימוש לרעה, בלי להגביל באופן גורף עבודה לגיטימית. לפני הזמינות הכללית, העברנו את המודלים ואת אמצעי ההגנה את תקופת ההערכה המקיפה ביותר שלנו עד כה, בשילוב red teaming אנושי ובדיקות אוטומטיות בקנה מידה גדול. במהלך התצוגה המקדימה עבדנו בצמוד לארגוני מומחים ולשותפים מהימנים כדי לבחון את עמידות ההגנות ולחזק את אמצעי ההגנה לפני ההשקה הרחבה. המערכת שנוצרה משלבת בשכבות הגנות שהוטמעו במודל באימון, בדיקות בזמן אמת, ניטור והרשאות גישה המותאמות לרמת האמון והסיכון.
GPT‑5.6 Sol הוא מודל התכנות הטוב ביותר שלנו עד כה. ב-Artificial Analysis Coding Agent Index, GPT‑5.6 Sol ברמת reasoning מקסימלית קובע שיא חדש של 80, גבוה ב-2.8 נקודות מ-Fable 5, תוך שימוש בפחות ממחצית טוקני הפלט, בפחות ממחצית הזמן ובעלות נמוכה בכשליש. היתרון הזה ניכר בכל המשפחה: Terra עולה מעט בביצועיו על Fable 5, ואילו Luna עולה על Opus 4.8; כל אחד מהם עושה זאת בכשליש מהזמן, עם כמחצית מטוקני הפלט ובכרבע מהעלות המשוערת. הוא קובע שיאים חדשים גם ב-Terminal‑Bench 2.1 וב-DeepSWE, שבוחנים תהליכי עבודה מורכבים בשורת הפקודה ועבודת הנדסה ממושכת בבסיסי קוד אמיתיים.
GPT‑5.6 יכול לכתוב ולהריץ תוכניות קלות משקל שמתאמות בין כלים, מעבדות תוצאות ביניים, עוקבות אחר ההתקדמות ובוחרות את הפעולה הבאה תוך כדי העבודה. כך משימות עתירות כלים יכולות להתקדם עם פחות טוקנים, פחות סבבי פנייה למודל ופחות הכוונה. במקום לדרוש ממפתחים לכתוב סקריפט לכל שלב או להעביר כל תשובת כלי בחזרה דרך המודל, קריאה לכלים באמצעות קוד(נפתח בחלון חדש) ב-Responses API יכולה לסנן כמויות גדולות של נתוני ביניים, לשמור רק את המידע החשוב ולהתאים את תהליך העבודה תוך כדי ביצועו.
בבעיות שבהן השקעה רבה יותר של זמן ומשאבי מחשוב משתלמת, GPT‑5.6 יכול להתקדם מעבר לברירת המחדל היעילה הזו. max מעניקה ל-GPT‑5.6 עוד יותר זמן מ-xhigh לחשוב ולבחון חלופות, לבצע בדיקות ולעדכן את הגישה שלו. ultra הולכת רחוק יותר ומתאמת כברירת מחדל בין ארבעה סוכנים במקביל, תוך שימוש ביותר טוקנים בתמורה לתוצאות טובות יותר ולהגעה מהירה יותר לתוצאה במשימות תובעניות. התרשימים הבאים משווים את תצורת ברירת המחדל של אולטרה, עם ארבעה סוכנים, לקו בסיס של סוכן יחיד ב-BrowseComp, ב-SEC-Bench Pro וב-Terminal-Bench 2.1; ב-BrowseComp וב-SEC-Bench Pro מוצגות גם תצורות של 16 סוכנים. בכל שלושת המבחנים, הוספת סוכנים במקביל מזיזה את גבול הביצועים ביחס לזמן ההשהיה כלפי מעלה ושמאלה, ומאפשרת תוצאות טובות יותר בפחות זמן. ב-API, מפתחים יכולים לבנות חוויות דמויות אולטרה באמצעות גרסת הבטא של ריבוי סוכנים(נפתח בחלון חדש) ב-Responses API. 4, 5 ו-6
GPT‑5.6 מציג קפיצת מדרגה בשיקול הדעת העיצובי. עם הכוונה כללית בלבד, GPT‑5.6 יוצר ממשקים מעוצבים בטוב טעם, נוחים לשימוש ופונקציונליים. יכולות השימוש המשופרות שלו במחשב מאפשרות לו לבדוק וללטש את התוצאה כפי שהיא מוצגת — ולא רק לייצר את הקוד או התוכן שמאחוריה — כך שיוכל לזהות בעיות חזותיות ותפקודיות ולהוסיף נגיעות אחרונות לפני מסירת העבודה.
יכולות פיתוח צד הלקוח של GPT‑5.6 הופכות גם בקשות בשפה טבעית להסברים ולהמחשות מלוטשים ואינטראקטיביים בתוך ChatGPT Work.
GPT‑5.6 מספק תוצאות טובות יותר במשימות מקצועיות. הוא לוקח מידע לא מאורגן מהמסמכים ומתהליכי העבודה היומיומיים שלכם ב-Slack, ב-Notion, ב-Microsoft 365 וב-Google Drive, והופך אותו לתוצרים ברמת מומחה שאפשר לשתף.
היכולות של GPT‑5.6 בעבודת ידע באות לידי ביטוי במבחנים הכוללים ניתוח מקצועי ממושך, גלישה, שימוש בכלים ושימוש במחשב. GPT‑5.6 Sol קובע שיאים חדשים ב-BrowseComp עם 92.2% וב-OSWorld 2.0 עם 62.6%; ב-OSWorld הוא עולה על Opus 4.8 תוך שימוש ב-85% פחות טוקני פלט. כאן, השיפור בביצועים לכל דולר ניכר בכל משפחת GPT‑5.6. Luna כמעט משתווה לביצועי השיא של GPT‑5.5 בפחות ממחצית העלות המשוערת, ואילו Terra עולה עליו בעלות נמוכה יותר.
GPT‑5.6 Sol משפר את האיכות של מצגות, מסמכים וגיליונות אלקטרוניים, ומפיק תוצרים מלוטשים ומדויקים יותר. הוא יכול ליצור מאפס מצגות הניתנות לעריכה מלאה, ולהפוך פרומפט וחומרי מקור לסיפור חזותי מגובש עם פריסות, היררכיה ועיצוב איכותיים.
השיפור בולט במיוחד בעבודה לפי תבניות ומצגות לדוגמה. GPT‑5.6 יכול להסיק את מערכת העיצוב של מצגת — פריסות, טיפוגרפיה, ריווח, צבעים ודפוסי תוכן חוזרים, כולל כללים המוטמעים בתבנית הבסיס לשקופיות — וליישם אותם בעקביות על חומר חדש. בדוגמה זו, כשהתבקש לעדכן מספרים לפי קובץ לדוגמה, בתוצר של GPT‑5.5 חסרים רכיבים מרכזיים משקופית הבסיס, ואילו GPT‑5.6 שומר בנאמנות רבה יותר על מבנה הדוגמה.
קובץ לדוגמה
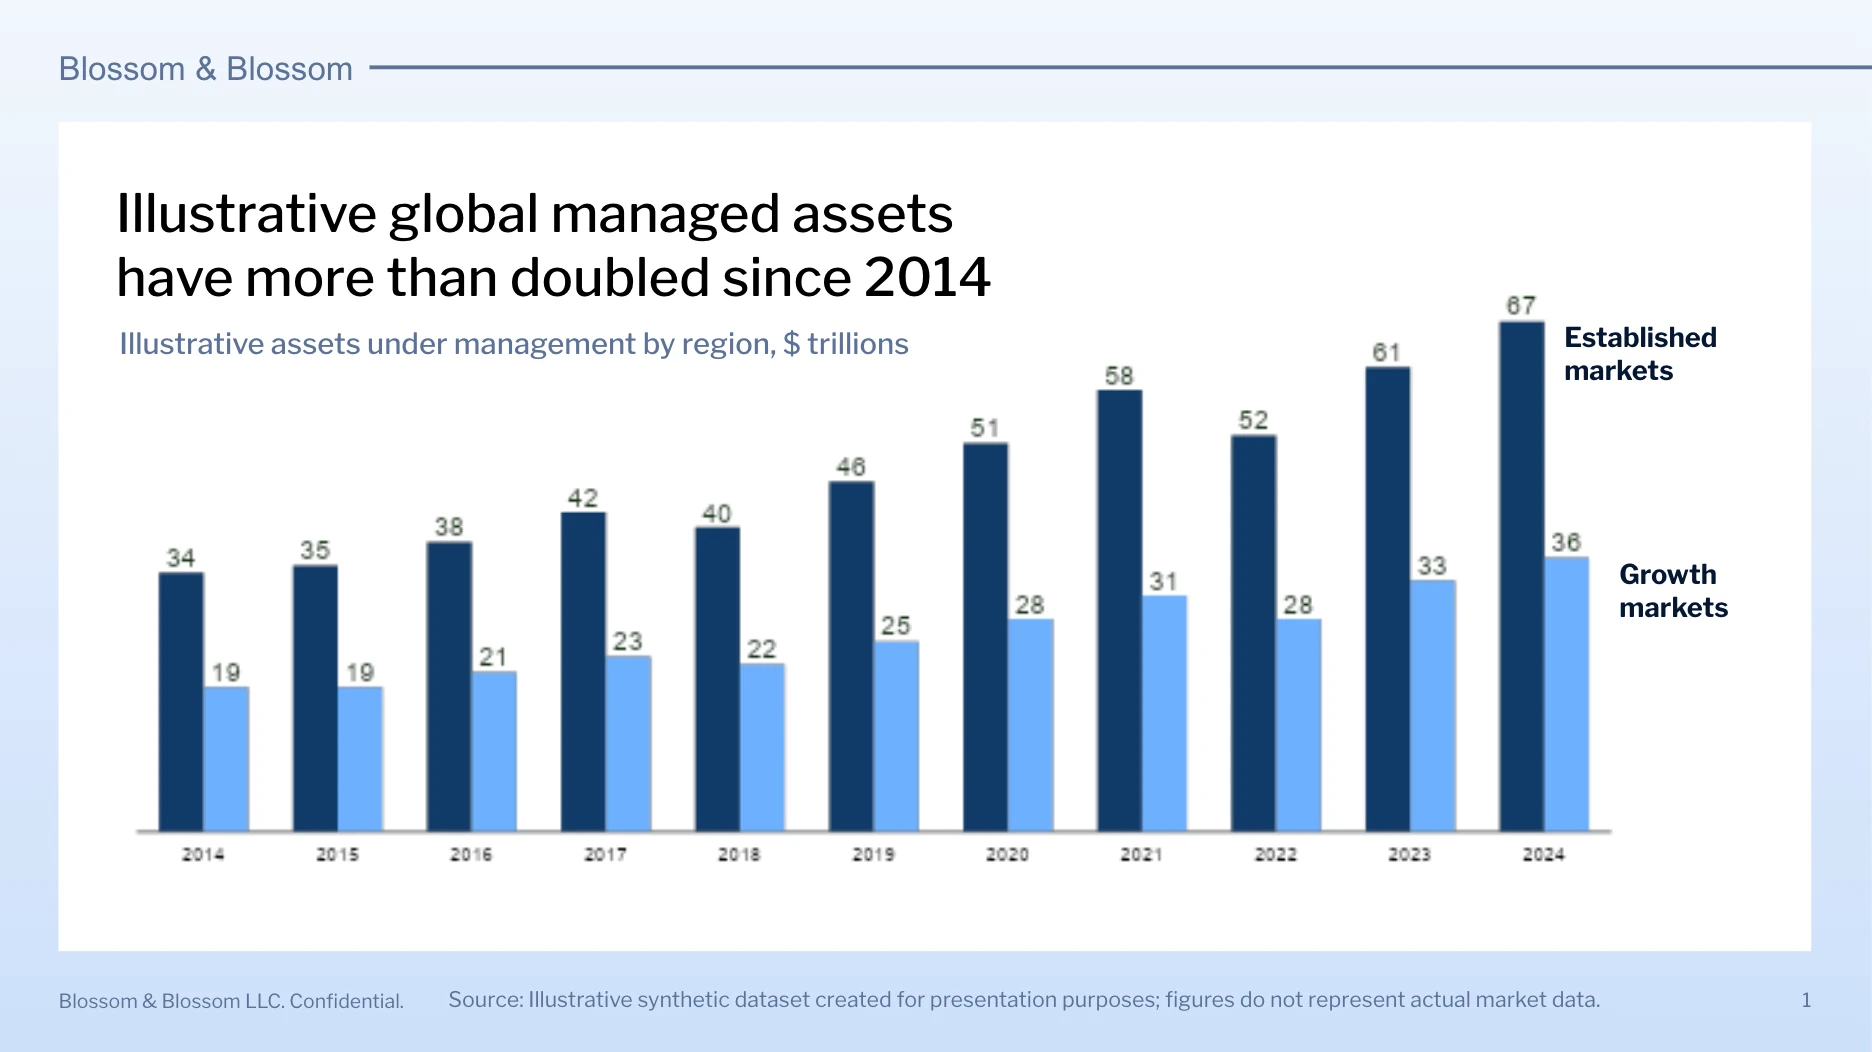
תוצר של GPT‑5.5
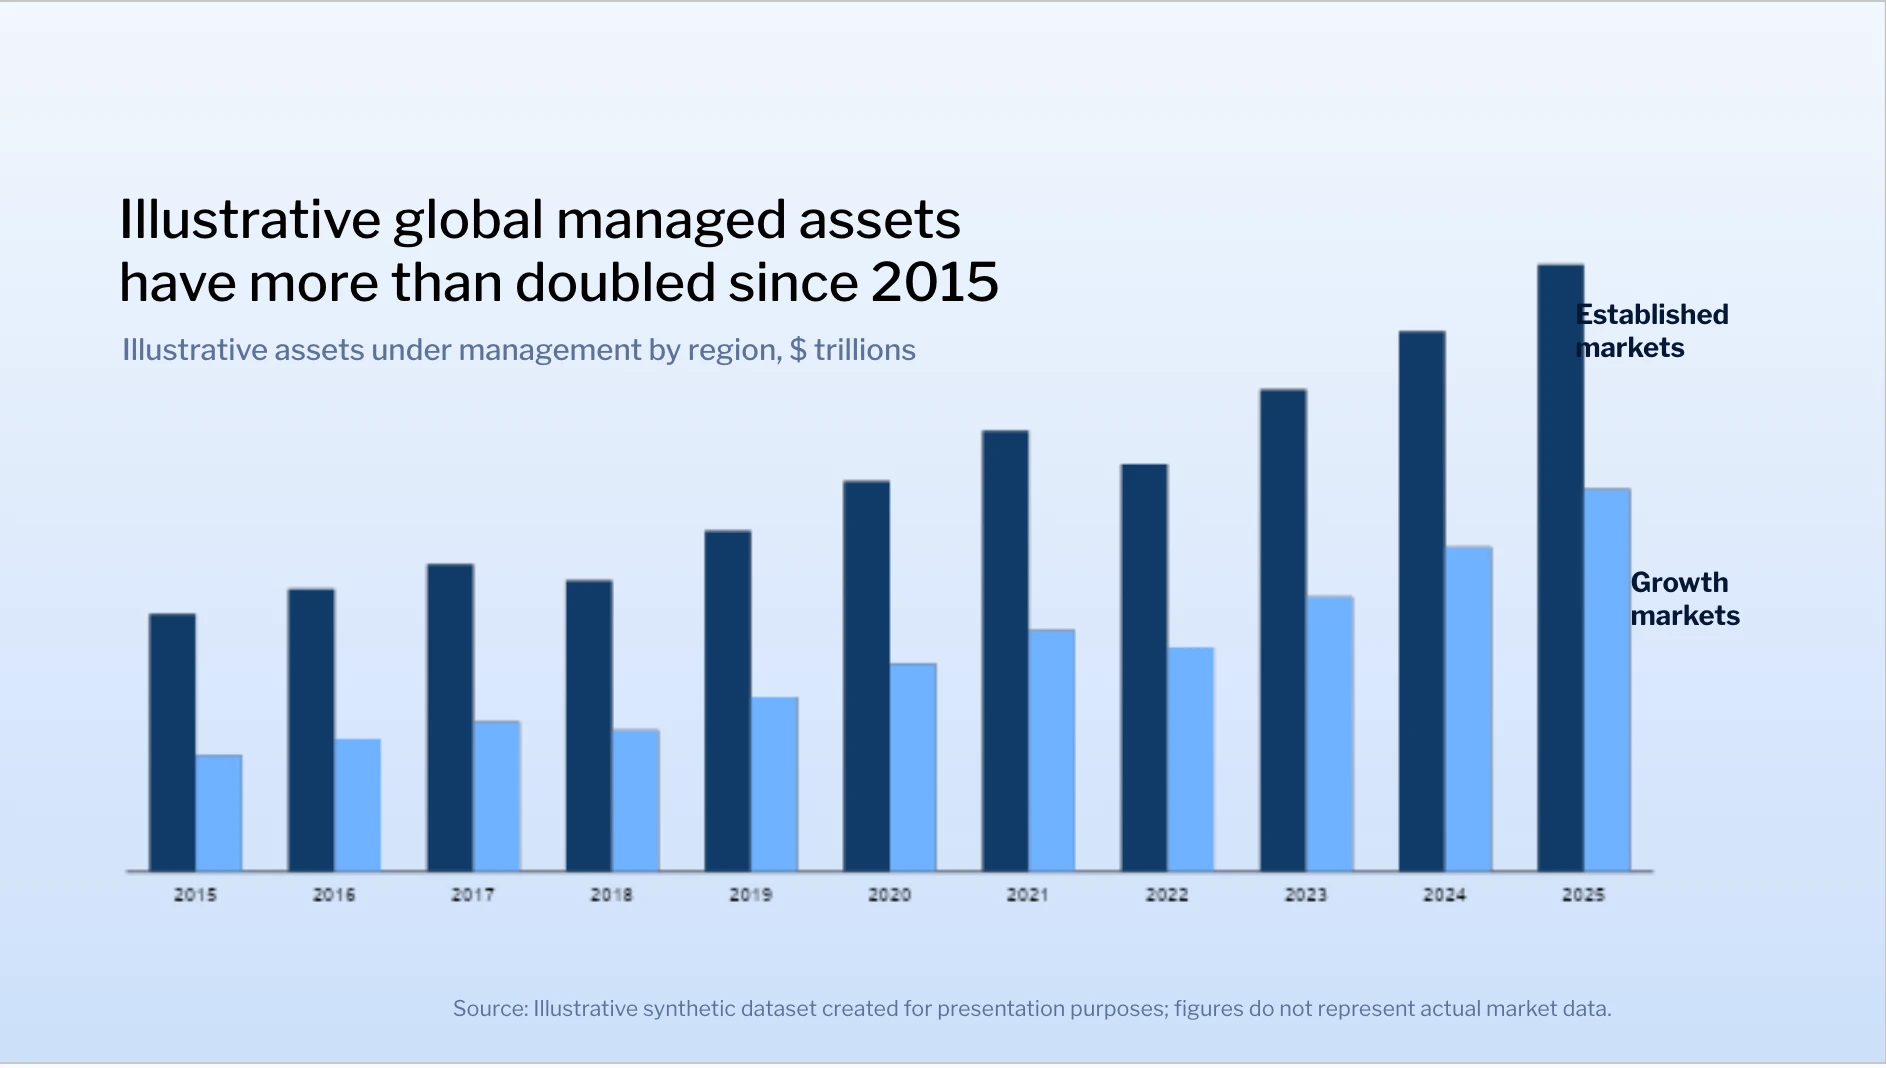
תוצר של GPT‑5.6
GPT‑5.6 יוצר גם מסמכים וגיליונות אלקטרוניים בעלי עיצוב מלוטש יותר. הוא נצמד בנאמנות רבה יותר לפורמטים מורכבים שניתנו כדוגמה — יכולת חשובה במשימות חוזרות של עבודת ידע. הוא מטפל במשוואות ובמודלים פיננסיים בדיוק רב יותר, ומשתמש טוב יותר בטיפוגרפיה, בריווח, בהיררכיה ובפריסת העמוד או הגיליון.
לקוחות שבדקו את GPT‑5.6 בשלב מוקדם ראו שיפור בתוצרי עבודת ידע במגוון תחומים.
GPT‑5.6 הוא מודל אבטחת הסייבר החזק ביותר שלנו עד כה, עם ביצועי חזית תוך שימוש בפחות טוקנים באופן משמעותי. ב-ExploitBench2, שמודד התקדמות מהגעה לקוד פגיע ועד להרצת קוד שרירותי, הוא משיג ציון של 73.5% לעומת 47.9% של GPT‑5.5, בתקציב דומה של טוקני פלט. ב-ExploitGym3, שבו סוכנים מתבקשים להפוך חולשות מהעולם האמיתי לקוד ניצול פעיל, הוא כמעט מכפיל את שיעור ההצלחה המרבי של GPT‑5.5, מ-15.1% ל-24.9% במסגרת מגבלת השעתיים; עם שש שעות הוא מגיע ל-33.7%. ב-SEC-Bench Pro, שבוחן יצירת הוכחות היתכנות בתוכנות מורכבות, הוא משיג 71.2% לעומת 45.8% של GPT‑5.5, בזמן השהיה קצר יותר. 1
GPT‑5.6 תומך במשימות הגנה חשובות, כגון סקירת קוד לאבטחה, תיקון חולשות, מידול איומים ופעילות צוותי הגנה. אנשים וארגונים העומדים בתנאי הזכאות של תוכנית הגישה המהימנה לסייבר של OpenAI Daybreak יכולים לקבל גישה ליכולות הגנה נוספות שלו, באמצעות אמצעי הגנה מדויקים יותר לעבודה מאומתת בסביבות מורשות, כולל מיון ואימות חולשות, ניתוח נוזקות, פיתוח מנגנוני זיהוי ואימות תיקונים.
אנשים פרטיים יכולים לאמת את זהותם ולבקש גישה מהימנה(נפתח בחלון חדש), וארגונים יכולים להגיש בקשה עבור הצוותים שלהם. משתתפים פרטיים יצטרכו להפעיל בטיחות חשבון מתקדמת(נפתח בחלון חדש) עם מפתחות גישה מגובי חומרה עד 1 בספטמבר כדי לשמור על הגישה למודלי החזית שלנו בעלי יכולות הסייבר הגבוהות ביותר; מי שלא יעשו זאת יחזרו לגישת ברירת המחדל. משתמשים שעדיין אין להם מפתחות גישה מגובי חומרה יכולים לקבל מחיר מיוחד(נפתח בחלון חדש) מהשותפה שלנו, Yubico. אנחנו גם נוקטים צעדים נוספים להגבלת הגישה של גורמים בסיכון גבוה ובתחומי שיפוט בסיכון גבוה.
GPT‑5.6 Sol מציג גם שיפורים נרחבים במחקר מדעי. במבחנים במדעי החיים, GPT‑5.6 מציג שיפורי פארטו לעומת GPT‑5.5 בביולוגיה יישומית, בתהליכי מחקר במדעי החיים ובכימיה.
GPT‑5.6 הוא המודל החזק ביותר שלנו עד כה להאצת מחקר בבינה מלאכותית. ב-OpenAI, חוקרים משתמשים בו לאורך כל מחזור הפיתוח: לאבחון כשלים, למיטוב מערכות אימון, להרצת ניסויים ולפירוש תוצאות. כבר בתקופת הבדיקות הפנימיות של GPT‑5.6 ראינו את ההאצה ואת האימוץ המוגבר: מספר טוקני הפלט היומי הממוצע לחוקר פעיל היה יותר מכפול מהרמה הגבוהה ביותר שנצפתה ב-GPT‑5.5.
דרך העבודה הזו הופכת במהירות לנורמה. בששת החודשים האחרונים, חלקם של משאבי מחשוב המחקר שהוקדשו להסקה לצורכי תכנות פנימיים גדל פי 100, והשימוש הפנימי בטוקנים לצרכים אג'נטיים גדל פי 22 בקירוב. מדדי האימוץ האלה אינם מודדים התקדמות מחקרית כשלעצמם, אך הם מראים באיזו מהירות גובר השימוש בסיוע של בינה מלאכותית במחקר ובצוותים אחרים, כגון מכירות, שיווק, תפעול משתמשים, כספים ועוד.
כדי למדוד את היכולת הזו ישירות, פיתחנו מערך מבחנים פנימי המבוסס על משימות אמיתיות במחקר בינה מלאכותית, ובהן איתור ותיקון תקלות במערכות מחקר, מיטוב קרנלים ומתכוני אימון, הרצת ניסויי למידת מכונה ושיפור מודל אחר.
ככל שיכולות המודלים גדלות, אנחנו מחזקים את מערך הבטיחות שלנו כדי שבינה מתקדמת תמשיך להועיל במגוון רחב של שימושים, תוך בחינה קפדנית יותר של השימושים בעלי הסיכון הגבוה ביותר. עבור GPT‑5.6 בנינו את מערכת הבטיחות העמידה ביותר שלנו עד כה, המותאמת ליכולות של כל מודל ומופעלת באמצעות יותר משאבי מחשוב מאי פעם.
למודלי GPT‑5.6 יכולות גבוהות יותר מהמודלים הקודמים שלנו הן בביולוגיה והן באבטחת סייבר, אך הם אינם חוצים את סף הסיכון הקריטי באף אחת מהקטגוריות. באבטחת סייבר, הבדיקות שלנו מצביעות על כך ש-GPT‑5.6 טוב יותר באיתור ובתיקון חולשות מאשר בביצוע אמין של מתקפות אוטונומיות מקצה לקצה נגד יעדים מוקשחים — וכך מעניק למגינים הזדמנות לחזק מערכות לפני שהחולשות מנוצלות. בביולוגיה, הבדיקות שלנו מצביעות על כך ש-GPT‑5.6 יכול לתמוך במחקר לגיטימי, אך אינו מספק את היכולת מקצה לקצה הדרושה ליצירה, להנדסה או לסינתזה של איום חדש ומסוכן ביותר.
בשני התחומים יש מטבעם פוטנציאל לשימוש כפול. באבטחת סייבר, אותן יכולות שעשויות לעזור לתוקף לנצל חולשה יכולות לעזור למגן למצוא אותה, לשחזר אותה ולפתח תיקון אמין. לכן חסימת יתר יוצרת סיכון אבטחה בפני עצמה. היא עלולה למנוע ממגינים לבדוק מערכות ולהחיל תיקונים, בזמן שגורמים זדוניים ממשיכים להשתמש במודלים אחרים, כולל מודלים בקוד פתוח בעלי יכולות הולכות וגדלות, וכן בכלים מוכרים. אמצעי הגנה יעילים מביאים בחשבון את ההקשר ואת ההשלכות הסבירות של בקשה, ומאפשרים עבודת הגנה לגיטימית תוך החלת בקרות מחמירות יותר כשהראיות מצביעות על סיכון משמעותי לנזק.
אמצעי ההגנה של GPT‑5.6 בנויים בשכבות לשיפור הדיוק והיתירות, ונועדו להסתגל במהירות כשמופיעות מתקפות חדשות. הגנות שהוטמעו במודל באימון פועלות לצד בדיקות בזמן אמת, ניטור רציף ואכיפה ברמת החשבון, כדי לסייע למערכת להישאר בטוחה גם כששכבה מסוימת אינה פועלת כמתוכנן. במערכות רבות, ההחלטה מה לחסום מבוססת רק על סימונים של מסווגים, תוך הסתמכות על מודלים בעלי יכולות בינה נמוכות יותר שקשה יותר לשנות כדי למנוע נזק. הגישה שלנו מוסיפה מנגנון ניטור מבוסס reasoning שסוקר את השיחה כדי לקבוע אם יש פוטנציאל לנזק. התכנון הזה נועד לאפשר עבודת הגנה תוך חסימת שימוש חמור לרעה, כאשר היכולות הרגישות ביותר שמורות למשתמשים מאומתים במסגרת גישה מהימנה. מכיוון שחלק מההגנות משתמשות ב-reasoning בזמן ההרצה, אנחנו יכולים לעדכן אותן במהירות כדי לסגור פערים בלי לאמן מסווגים מחדש מאפס.
אנחנו נוקטים גישה שמרנית יותר בעודנו ממשיכים לחזק את המערכת נגד מתקפות מסתגלות. בהשוואה למודלים קודמים, אמצעי הגנת הסייבר שלנו ב-GPT‑5.6 Sol חוסמים בערך פי עשרה יותר פעילות שעלולה להזיק. מכיוון שאמצעים אלה עלולים להקשות על שימוש תמים, אנחנו מספקים ב-ChatGPT וב-Codex אפשרות לנסות שוב בקלות פרומפטים במודלים בעלי יכולות נמוכות יותר. נמשיך לצמצם את השפעת אמצעי ההגנה על שימוש תמים, תוך שמירה על רף עמידות גבוה. כך באה לידי ביטוי גישת ההשקה ההדרגתית שלנו: מתחילים בזהירות ומשפרים על סמך מה שאנחנו לומדים מהשימוש בפועל.
לפני הזמינות הכללית ערכנו את מבחני הבטיחות האינטנסיביים ביותר שלנו עד כה, כולל red teaming נרחב, בדיקות מקיפות של יכולות ואמצעי הגנה עם מומחים חיצוניים, ו-red teaming אוטומטי בגישת קופסה שחורה בהיקף השווה לכ-700,000 שעות GPU מסוג NVIDIA A100 Tensor Core. כך יכולנו לבחון באופן שיטתי נקודות תורפה סבירות, לחשוף פרצות ולחזק את המערכת לפני ההשקה.
אין דבר כזה אבטחה מושלמת, והעבודה שלנו לאבטחת מודלים בעלי יכולות הולכות וגדלות נמשכת. יתגלו נקודות תורפה חדשות, וכך גם פרצות חדשות שעוקפות אמצעי הגנה קיימים. כל דור חדש של מודלים ייצור גם דרכים חדשות לתקיפה ולשימוש לרעה. אנחנו נערכים למציאות הזו באמצעות אמצעי הגנה רב-שכבתיים, ניטור רציף, תיקון מהיר ושיתוף פעולה בקהילת ההגנה. עבור GPT‑5.6 שילבנו את תוכנית התגמולים הקיימת לאיתור חולשות אבטחה(נפתח בחלון חדש) ואת תוכנית התגמולים לאיתור כשלים בתחום הביולוגיה עם תהליך חדש לתיקון מהיר ועם מערך הניטור החזק ביותר שלנו עד כה. ממצאים מחוקרים, מניטור ומשימוש לרעה בפועל ישמשו באופן שוטף לפיתוח מבחנים חדשים ולחיזוק אמצעי ההגנה.
למידע נוסף על אמצעי ההגנה שלנו, ראו את כרטיס המערכת המעודכן של GPT‑5.6(נפתח בחלון חדש).
GPT‑5.6 כולל שלוש רמות מודלים: Sol, מודל הדגל שלנו; Terra, מודל בעלות נמוכה יותר עם ביצועים תחרותיים ביחס ל-GPT‑5.5; ו-Luna, המודל המהיר והזול ביותר שלנו. המספר מציין את הדור, ואילו Sol, Terra ו-Luna הן רמות יכולת קבועות שיכולות להתקדם כל אחת בקצב שלה.
GPT‑5.6 זמין החל מהיום ב-ChatGPT, ב-Codex וב-API של OpenAI. ההשקה העולמית מתחילה כעת ותימשך בהדרגה עד לזמינות מלאה במהלך 24 השעות הקרובות.
צ'אט: משתמשי Plus, Pro, Business ו-Enterprise מקבלים גישה ל-GPT‑5.6 Sol דרך הגדרות מאמץ ברמה בינונית ומעלה. משתמשי Pro ו-Enterprise יכולים גם לבחור ב-GPT‑5.6 Sol Pro לקבלת התוצאות האיכותיות ביותר במשימות מורכבות.
ChatGPT Work ו-Codex: משתמשי Free ו-Go מקבלים גישה ל-GPT‑5.6 Terra. משתמשי Plus, Pro, Business ו-Enterprise יכולים לבחור בין GPT‑5.6 Sol, Terra ו-Luna ולהגדיר רמת מאמץ לכל אחד.
maxזמינה לכל המשתמשים בעלי גישה ל-GPT‑5.6 ב-ChatGPT Work וב-Codex, ואפשר להפעיל אותה בהגדרות. ב-ChatGPT Work,ultraזמינה למשתמשי Pro ו-Enterprise. ב-Codex היא זמינה בתוכניות Plus ומעלה.API: מפתחים יכולים לגשת ל-Sol, ל-Terra ול-Luna דרך ה-API של OpenAI. ב-Responses API, קריאה לכלים באמצעות קוד מאפשרת ל-GPT‑5.6 לכתוב ולהריץ בזיכרון תוכניות שמתאמות בין כלים ומעבדות תוצאות ביניים, כך שהיכולת תואמת לאפס שמירת נתונים (ZDR). ריבוי סוכנים, הזמין בתחילה בגרסת בטא, מאפשר ל-GPT‑5.6 להפעיל סוכני משנה במקביל ולשלב את עבודתם בבקשה אחת.
התמחור של GPT‑5.6 הוא למיליון טוקנים בשלושה גדלי מודל: Sol — 5 דולר לקלט / 30 דולר לפלט; Terra — 2.50 דולר לקלט / 15 דולר לפלט; Luna — דולר אחד לקלט / 6 דולר לפלט. GPT‑5.6 מציג גם מטמון פרומפטים עם התנהגות צפויה יותר, כולל תמיכה בנקודות עצירה מפורשות למטמון(נפתח בחלון חדש) ומשך שמירה מינימלי של 30 דקות במטמון. ב-GPT‑5.6 ובמודלים מאוחרים יותר, כתיבה למטמון מחויבת לפי 1.25 מתעריף הקלט של המודל ללא מטמון, ואילו קריאה מהמטמון ממשיכה ליהנות מהנחה של 90% על קלט שמור במטמון.
עבודה מקצועית
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview | Gemini 3.5 Flash |
|---|---|---|---|---|---|---|---|---|
| Agents' Last Exam | 52.7% | 50.4% | 50.3% | 46.9% | 40.5% | 45.2% | 32.1% | — |
| GDPval-AA v2 | 1,747.8 Elo | 1,593 Elo | 1,591.8 Elo | 1,493.7 Elo | 1,759.6 Elo | 1,600.1 Elo | 962.3 Elo | 1,348.8 Elo |
| משימות ייעוץ ניהולי (פנימי) | 43.2% | 37.2% | 35.4% | 31.3% | 35.5% | 31.6% | 13.2% | — |
| Big Finance Bench | 53% | 51% | 36% | 49% | — | 44% | — | — |
| Artificial Analysis Intelligence Index v4.1 | 58.9 במדד | 55 במדד | 51.2 במדד | 54.8 במדד | 59.9 במדד | 55.7 במדד | 46.5 במדד | 50.2 במדד |
תכנות
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Sol אולטרה | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|---|
| Artificial Analysis Coding Agent Index v1.1 | 80 במדד | — | 77.4 במדד | 74.6 במדד | 76.4 במדד | — | — | 77.2 במדד | 72.5 במדד | 42.7 במדד |
| SWE-Bench Pro | 64.6% | — | 63.4% | 62.7% | 59.4% | 80.3% | 77.8% | 80% | 69.2% | 54.2% |
| DeepSWE v1.1 | 72.7% | — | 69.6% | 67.2% | 67% | — | — | 69.7% | 59% | 11.8% |
| Terminal-Bench 2.1 | 88.8% | 91.9% | 87.4% | 84.7% | 85.6% | 88% | — | 83.1% | 78.9% | 70.7% |
Science and health
| Eval | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview | Gemini 3.5 Flash |
|---|---|---|---|---|---|---|---|---|
| GeneBench Pro | 28.7% | 23.3% | 10.8% | 12% | — | 16% | 3.1% | 8.14% |
| LifeSciBench | 59.9% | 56% | 51.2% | 50.4% | — | 53.6% | — | — |
| MedChemBench (Internal) | 48.3% | 35% | 30.4% | 35.5% | — | — | — | — |
| HealthBench Professional⁶ | 60.5% | 57.7% | 55.7% | 49.5% | 60.9% | 53% | — | — |
שימוש במחשב
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Sol אולטרה | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|
| OSWorld 2.0 | 62.6% | — | 50.2% | 45.6% | 47.5% | — | — | 54.8% | — |
| BrowseComp | 90.4% | 92.2% | 87.5% | 83.3% | 84.4% | 88% | 87.9% | 84.3% | 85.9% |
| BenchCAD | 70.6% | — | 62.3% | 63.1% | 44.4% | 38.4% | 35.5% | 27.3% | — |
| BenchCAD (כלי Python) | 83.4% | — | 78.2% | 73.9% | 55.8% | 65% | 61% | 51.8% | — |
אבטחת סייבר
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Sol אולטרה | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Opus 4.8 |
|---|---|---|---|---|---|---|---|---|
| אתגרי תפוס את הדגל | 96.7% | — | 91.8% | 85.2% | 88.1% | — | — | — |
| SEC-Bench Pro | 71.2% | 74.3% | 57.7% | 48.9% | 45.8% | — | — | — |
| ExploitBench | 73.5% | — | 52.9% | 33.2% | 47.9% | 78% | 74.2% | 40% |
| ExploitGym | 33.7% | — | 23.2% | 12.4% | 15.1% | — | — | — |
שיפור עצמי
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 |
|---|---|---|---|---|
| מבחן פנימי לאיתור ותיקון תקלות מחקר | 68.3% | 67.8% | 50.8% | 50% |
| KernelGen 1P | 61.1% | 49.2% | 22.4% | 29.3% |
| NanoGPT | 9.69% | 14.5% | 1.66% | 2.65% |
| PostTrainBench Lite | 50.3% | 51.5% | 29.6% | 38.8% |
| מדד RSI | 57.9% | 56.3% | 41.9% | 41.7% |
רב-מודאליות
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|
| MMMU Pro (ללא כלים) | 83% | 80.7% | 78.4% | 81.2% | — | — | 80.5% |
| MMMU Pro (עם כלים) | 84.6% | 82% | 79.5% | 83.2% | — | — | — |
| gdp.pdf | 30.7% | 24.7% | 22.7% | 26% | 29.8% | 22.5% | 16.7% |
ידע אקדמי
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|---|---|---|
| GPQA Diamond | 94.6% | 92.9% | 92.3% | 93.6% | 94.1% | 94.6% | 92.6% | 92% | 94.3% |
| FrontierMath רמות 1-3 (v2) | 89% | 84.9% | 78.6% | 85.3% | — | — | 87% | 80% | 59.6% |
| FrontierMath רמה 4 (v2) | 83% | 68.3% | 58.5% | 72.5% | — | — | 87.8% | 56.1% | — |
שימוש בכלים
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Fable 5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview | Gemini 3.5 Flash |
|---|---|---|---|---|---|---|---|---|---|---|
| AutomationBench | 18.1% | 15.2% | 14.9% | 12.9% | — | — | 17.4% | 15.5% | — | 14.5% |
| Toolathlon | 58% | 53.1% | 53.4% | 55.6% | 61.7% | 61.1% | 61.7% | 59.9% | 48.8% | — |
הקשר ארוך
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Mythos 5 | Claude Mythos Preview | Claude Opus 4.8 |
|---|---|---|---|---|---|---|---|
| OpenAI MRCR v2 8-needle 256K-512K | 91.5% | 89.6% | 41.3% | 81.5% | — | — | — |
| OpenAI MRCR v2 8-needle 512K-1M | 73.8% | 72.5% | 41.3% | 74% | — | — | — |
| GraphWalks BFS 256k f1 | 90.7% | 76.9% | 81.3% | 73.7% | 91.1% | 85.7% | 85.9% |
| GraphWalks BFS 1mil f1 | 77.1% | 71.2% | 51.2% | 45.4% | 79.4% | 74.3% | 68.1% |
reasoning מופשט
| מבחן | GPT‑5.6 Sol | GPT‑5.6 Terra | GPT‑5.6 Luna | GPT‑5.5 | Claude Opus 4.8 | Gemini 3.1 Pro Preview |
|---|---|---|---|---|---|---|
| ARC-AGI-3⁷ | 7.78% | 0.8% | 0.18% | 0.43% | 1.5% | 0.42% |
מחבר/ת
הערות שוליים
- 1
יכולות הסייבר נבחנות עם אמצעי הגנה מצומצמים. משתמשים יכולים להצטרף לתוכנית הגישה המהימנה לסייבר של OpenAI Daybreak כדי לקבל גישה מורחבת ליכולות הגנת סייבר.
- 2
- 3
הרצנו את ExploitGym ב-API שלנו בגרסת אלפא, שמפיק תשובות מהר יותר מה-API הציבורי שלנו, ולאחר מכן התאמנו את התוצאות למהירות ה-API הציבורי. התאמת זמני ההשהיה למהירויות הצפויות ב-API הציבורי שלנו גורמת לחלק מהזמנים המשוערים לחרוג ממגבלות השעתיים ושש השעות, אף שההרצה המקורית של המבחן עמדה במגבלות האלה. כדי לאפשר עבודה מהירה יותר במשימות רגישות לזמן, אנחנו מציעים עיבוד בעדיפות ב-API ומצב מהיר ב-Codex.
- 4
אנחנו מעריכים את זמן ההשהיה ואת עלות ה-API על סמך התנהגות המודלים שלנו בסביבת ייצור ובאמצעות סימולציה לא מקוונת. ההערכות האלה מביאות בחשבון את פרטי הקריאות לכלים, הטוקנים שנדגמו וטוקני הקלט. התוצאות בפועל עשויות להיות שונות במידה ניכרת, והן תלויות בגורמים רבים שאינם נכללים בסימולציה שלנו. אנחנו מדמים זמני השהיה לפי מהירויות API מהירות, ועלויות לפי תעריפי API רגילים.
- 5
- 6
- 7
- 8