מדריך פעולה משותף לבחינות מהימנות בידי צדדים שלישיים
מה חשוב בבחינות עצמאיות ואפקטיביות של אמצעי הגנה ויכולות במודלי חזית.
לבחינות עצמאיות ומהימנות בידי צדדים שלישיים יש תפקיד מכריע בחיזוק המערך הכולל של בטיחות הבינה המלאכותית. בחינות אלה נערכות על מודלי חזית כדי לספק ראיות נוספות לטענות בנוגע ליכולות קריטיות ולאמצעים לצמצום סיכוני בטיחות. במאמר זה אנו משתפים לקחים שלמדנו עד כה וממליצים על גישות לתכנון בחינות שיכולות להעריך מודלי חזית באופן תקף, בתקווה שיסייעו בעיצוב התקנים המתגבשים בתחום.
בעבר, בחינות רבות התייחסו למודלים כאל צ'אטבוטים: במסגרת הבחינה הוצג למודל פרומפט כאילו משתמש שואל אותו שאלה, המודל ענה ובוחן שפט את הפלט. מודלי החזית של היום יכולים לעשות הרבה יותר: להשתמש בכלים, לעקוב אחר מידע לאורך שלבים רבים ולפעול כחלק מתהליך עבודה רחב יותר. משמעות הדבר היא שהביצועים תלויים לא רק במודל, אלא גם בסביבה שבה מתבצעת המשימה ובמערך שמאפשר את פעולותיו. המערך המקיף הזה, שאנו מכנים ״harness״, יכול לשנות היבטים מרכזיים בביצועי המערכת, ובהם אופן השימוש שלה בכלים, המעקב אחר מידע או ההתאוששות מטעויות.

הדבר משנה את האופן שבו יש לערוך בחינות ואת מה שעל הקוראים לחפש בדוחות הבחינה. לדעתנו, הדוחות המועילים ביותר מתארים במפורש שני דברים מעבר לתוצאה עצמה: ראשית, הם מציינים איזו טענה נועד מערך הבחינה לבדוק; ושנית, הם מציגים את הראיות הזמינות לכך שתוצאת הבחינה תקפה.
טענות הנבדקות בבחינות משתייכות בדרך כלל לאחת משלוש קטגוריות1:
elicitation: האם סביר שהמודל מסוגל להפגין את היכולת הנבחנת?
ביצועי אמצעי ההגנה: עד כמה אמצעי ההגנה שנבדקו עמידים בפני ההתנהגות או המתקפה הנבחנת?
השוואה: מהם הביצועים של מודלים שונים בתנאים שקולים?
דוחות הבחינה צריכים גם להסביר כיצד הבוחנים בדקו השפעות שעלולות לפגוע בתוקף התוצאה. אלה כוללות:
reward hacking: ניצול קיצורי דרך במשימה או במנגנון הניקוד, כך שהמערכת מקבלת ניקוד בלי להפגין את ההתנהגות שהבחינה נועדה למדוד.
סירובים: סירוב בדרכים שמקשות לזהות את ההתנהגות הנבדקת.
זיהום נתונים: ביצועים גבוהים מהיכולת האמיתית משום שמשימות הבחינה, תשובותיהן או גרסאות דומות להן הופיעו בנתוני האימון או היו ניתנות לאיתור במהלך הבחינה, למשל באמצעות גלישה.
בעיות פגומות: ביצועים נמוכים מהיכולת האמיתית משום שהמשימות אינן תקינות. הסיבות עשויות לכלול ניקוד לא הוגן (למשל, כשהתשובה הנכונה מחייבת פרטי מימוש שלא צוינו) וסביבות שבהן אי אפשר לפתור את המשימה (למשל עקב קבצים קריטיים חסרים או כלים לא אמינים).
sandbagging: הפגנה מכוונת של ביצועים נמוכים מהיכולת בפועל כאשר המודלים מגלים מודעות לכך שהם נבחנים.
מצאנו שתפקידו של ה-harness חשוב במיוחד במערכות שפועלות לאורך מסלולי פעולה ארוכים יותר. כאשר מודלים יכולים להשתמש בכלים, לשמר מצב ולהתאושש מטעויות לאורך שלבים רבים, ה-harness יכול לשנות את רמת הביצועים הנצפית, ואף לקבוע אם היכולת המוערכת תבוא בכלל לידי ביטוי בבחינה. לדוגמה, harness שמשמר מצב ומנסה שוב פעולות שנכשלו עשוי לאפשר למודל להשלים משימה רב-שלבית שאותו מודל לעולם אינו משלים עם harness פשוט יותר.
בטבלה שלהלן אנו מבחינים בין שלושה סוגי טענות שבוחנים עשויים לרצות לטעון, ובין סוגי ה-harness שלדעתנו נדרשים לכל אחד מהם.
הטענה שהבחינה נועדה לתמוך בה | בחירת harness מתאים | ראיות שיש לדווח עליהן |
|---|---|---|
יכולת בתנאי elicitation חזקים: מערכת A יכולה להשלים משימות מסוג X כאשר מערך הבחינה נועד להפיק ממנה את הביצועים החזקים ביותר שניתן לצפות להם באופן מציאותי. | יש להשתמש במערך ה-elicitation החזק ביותר שניתן להפעיל באופן מציאותי עבור המערכת, לרבות ה-harness, הכלים, תשתית התמיכה והתקציב שסביר שמשתמש מיומן ישתמש בהם. | תצורת ה-harness והכלים, הנחיות ה-elicitation, התקציב או המאמץ שהותרו, טוקנים, עלות וזמן, והסבר מדוע המערך מהווה מדד עקיף מהימן ליכולת הנטענת. אם משווים מערכות בתצורות שונות שעברו אופטימיזציה, יש לסמן זאת כהשוואה בין מערכות או כהשוואה בתנאי elicitation חזקים. |
השוואה מבוקרת: מערכת A עולה בביצועיה על מערכת B במערך בחינה משותף. | יש לשמור על משימות, שיטת ניקוד ותקציב קבועים. יש להשתמש בתצורת harness וכלים משותפת, או בקבוצה קבועה של מעטפות harness אחידות שנבחרו מראש כדי לאפשר elicitation מרבי ברמה סבירה למערכות המושוות. | מערך המשימות המשותף, הכלים, שיטת הניקוד, ה-harness, התקציב, יעילות השימוש בטוקנים ועלותם, והמגבלות הידועות. בבחינות של סוכני תכנות, harness בקוד פתוח כמו Codex CLI יכול לספק לולאת סוכן וממשק כלים קבועים לכל המערכות. הגישה האידיאלית ל-elicitation מרבי היא לבצע אופטימיזציה של harness ייעודי לכל משימה ומערכת, אך כיום הדבר אינו מעשי. |
עמידות אמצעי ההגנה מול מתקפה שהופקה בתהליך elicitation: אמצעי ההגנה של מערכת A מספקים מענה להתנהגות המודל הרלוונטית או למתקפה שהופקה. | יש להשתמש במערך לבדיקת אמצעי הגנה שנועד להפיק את המתקפה החזקה ביותר שניתן לצפות לה באופן מציאותי במסגרת מודל היריב הרלוונטי. | כיצד הבוחנים אפיינו את התנהגות המודל הרלוונטית, תצורת אמצעי ההגנה שנבדקה, אסטרטגיית ה-elicitation, ה-harness ששימש למימושה והתקציב או המאמץ שהותרו. |
חוזקן של טענות על יכולת תלוי בחוזק ה-elicitation שעליו הן מבוססות: על הבוחנים לבחור ב-harness המתאים ביותר למשימה וליכולת שהבחינה מנסה למדוד. harness אחיד עשוי להתאים להשוואת מערכות בתנאים זהים, אך הוא עלול להציג הערכת חסר של היכולת אם חסרות בו תכונות מסוימות שעוזרות למודל לבצע את המשימה. לדוגמה, הביצועים של GPT‑5.5 בזירות הסייבר של OpenAI מראים כיצד בחירת harness יכולה לשנות באופן מהותי את היכולת הנמדדת במשימות המחייבות שימוש ממושך ורב-שלבי בכלים: ביצועי המודל טובים יותר כאשר ה-harness משתמש ב-compaction כדי לשמר הקשר רלוונטי למשימה ככל שהאינטראקציה מתארכת. הדבר מראה שבמודלים מסוימים, harness ללא compaction לא יפיק את מלוא הביצועים האפשריים.
שיעורי הצלחה גבוהים יותר מעידים על ביצועים טובים יותר
גם בחינות אחרות שפורסמו2 מראות שבחירות הנוגעות ל-harness ולתקציב משנות את תוצאות הבחינה. הגדלת משאבי החישוב בזמן הבדיקה יכולה לשנות במידה ניכרת את היכולת שהבחינה מפיקה, במיוחד בתחומים שבהם קל לאמת הצלחה, כמו משימות סייבר רבות. ב-בחינת זירות הסייבר של UK AISI(נפתח בחלון חדש), הגדלת התקציב מ-10 מיליון ל-100 מיליון טוקנים שיפרה את הביצועים בעד 59%, והביצועים המשיכו להשתפר גם בתקציב הגבוה ביותר שנבדק. פירוט הנתונים האלה מקל על פרשנות הבחינה: הוא מראה לקוראים כיצד התוצאה תלויה במערך ה-elicitation שנבדק. כאשר הביצועים עדיין משתפרים עם תוספת תקציב, יש לתאר את הציון כביצועים במסגרת אותו harness ואותו תקציב, ולא כתקרת יכולת שנמדדה. יכולת תלויה לעיתים קרובות במשאבים, ואינה גודל קבוע שניתן למדוד באופן חד-משמעי אחת ולתמיד. כאשר אפשר למדוד הצלחה לאורך ניסיונות חוזרים, על הדוחות להתייחס גם לעלות הצפויה לכל פתרון מוצלח, ולא רק לשיעור ההצלחה בתקציב טוקנים קבוע. כך קל יותר להבין את חומרת הסיכון: גם שיעור הצלחה נמוך עשוי להיות משמעותי בפועל אם עלות הניסיונות החוזרים תואמת את המשאבים שמניח מודל האיום הרלוונטי. כשמדובר בטענות על יכולת, elicitation חסר שניתן היה למנוע הוא כשל מדידה: אם ה-harness או התקציב מונעים מהמערכת להפגין התנהגות שאחרת הייתה יכולה להפיק, הציון אינו מודד את היכולת הנטענת. כאשר הבוחנים מיצו את ה-elicitation ככל שניתן והביצועים עדיין משתפרים, על הדוחות לציין זאת במפורש ולהבהיר שהתוצאה היא רק אומדן לחסם התחתון של היכולת.
בדיקת אמצעי הגנה עלולה להמעיט בהערכת סיכויי ההצלחה של מתקפה ובחומרתה האפשרית אם אינה מביאה בחשבון את המשאבים העומדים לרשות תוקפים, לרבות מעטפות harness מותאמות אישית. ב-בחינת יכולות הסייבר של GPT‑5.5 שערך UK AISI(נפתח בחלון חדש), פעילות ה-red teaming של המומחים מצאה פרצה שהפיקה תוכן סייבר המפר את הכללים במגוון השאילתות הזדוניות שסיפקה OpenAI, לרבות בסביבות אג'נטיות מרובות סבבים. הם השתמשו ב-Codex כדי ליצור harness מותאם אישית לחיזוק ביצועי התקיפה של המודל: הוא הטמיע באינטראקציה דפוס רב-פעמי לעקיפת אמצעי הגנה, שימר אותו לאורך סבבים ומקטעים ויישם אותו על פני שאילתות הסייבר הזדוניות שסיפקה OpenAI. בדיקת אמצעי ההגנה צריכה להתאים ליריב. אם הטענה נוגעת לעמידות בפני שימוש לרעה בידי מומחים, הבדיקה צריכה לבחון את אסטרטגיית התקיפה החזקה ביותר שניתן לממש באופן מציאותי מקצה לקצה במסגרת תקציב מוגדר, לרבות כל harness הנדרש לשימור האסטרטגיה ולשימוש חוזר בה. אחרת, התוצאות עלולות להוביל להערכה לא מכוילת: הן עשויות לתמוך רק בטענה מצומצמת יותר על עמידות בפני פרומפטים פשוטים יותר, להחמיץ הן את חומרת המתקפה והן את סיכויי הצלחתה לאחר שה-elicitation מיושם בפועל, וגם להפריז בהערכת ההסתברות לבעיה או חומרתה אם מוקצה תקציב גדול מדי.
יש מקום להשוואות באמצעות מעטפות harness אחידות, אך על הבוחנים להסביר במפורש מדוע מתאים להשתמש בקבוצה קבועה של מעטפות harness ובאיזו טענה שימוש כזה יכול לתמוך. בחינת אופק הזמן של METR(נפתח בחלון חדש) היא דוגמה למערך בחינה רחב יותר שנשמר קבוע בהתאם למטרתו: הוא נועד להפיק תוצאות בנות השוואה בין המערכות הנבחנות. METR מגדירה מדד תוצאה משותף: משך הזמן הטיפוסי שאדם נדרש לו לביצוע משימה שסוכן בינה מלאכותית צפוי להצליח בה ברמת אמינות נתונה. בכל קבוצת אומדנים המדווחים יחד, היא משתמשת באותו מערך משימות, באותה שיטת ניקוד, באותה שיטת התאמה ובקבוצה קטנה של תשתיות תמיכה רב-פעמיות, כמו Triframe ו-ReAct(נפתח בחלון חדש). כאשר METR הרחיבה את מערך המשימות והעבירה את תשתית הבחינה ממסגרת בשם Vivaria למסגרת בשם Inspect, היא דיווחה על השינוי (עדכון אופק זמן 1.1(נפתח בחלון חדש)) ובחנה מחדש מודלים במערך הבחינה החדש. זהו הערך של מערך בחינה אחיד, הכולל קבוצה קבועה של מעטפות harness: הוא יכול לתת לקוראים ביטחון שהבדל בציונים אכן משקף הבדל בין המערכות המושוות, ולא שינוי במערך המדידה.
אנו ממליצים שדוחות בחינה של צדדים שלישיים יציינו באיזה סוג טענה מערך הבחינה נועד לתמוך; יתארו עד כמה מה שנבדק משקף את הטענה הרחבה יותר; יתארו את הבחירות הנוגעות ל-harness שעיצבו את התוצאה; יפרטו מתי בחירות אלה משתנות בין בחינות; ויכללו ראיות תומכות המראות כיצד התקבלה התוצאה ובאיזו מידה ניתן להכליל ממנה לטענה.
ככל שיכולות המודלים משתפרות, קל יותר לפרש באופן שגוי את ציוני הבחינות. ציוני הבחינות עלולים להיות נמוכים באופן מלאכותי ביחס ליכולות האמיתיות אם מודל מזהה שהוא נבחן ומפגין בכוונה ביצועים נמוכים יותר מטעמים אסטרטגיים. הם עלולים להיות מנופחים אם המודל מנצל קיצור דרך במשימה, בפרומפט, במנגנון הניקוד או ב-harness. הם עלולים להתעוות גם עקב זיהום נתונים (כאשר מודל כבר יודע את התשובה או יכול למצוא אותה בלי לפתור את המשימה), או עקב בעיות ״פגומות״ שהן עמומות, מנוקדות באופן שגוי, אינן ניתנות לפתרון או מאפשרות קיצורי דרך לא מכוונים. לכן, לצד הציונים המרכזיים, דוחות הבחינה צריכים לכלול דיון בגורמי הסיכון האלה, כדי שהקוראים יוכלו להעריך אם הציונים משקפים את ההתנהגות שנועדה להימדד.
מעטפות harness, תקציבים, כלים, כללי ניקוד, מנגנוני ניטור ותהליכי סקירה — כולם משפיעים על השאלה אם סוכן פותר את המשימה המיועדת, נמנע ממנה, משנן אותה או מוצא דרך לעקוף אותה. דוח מהימן מציג את הבדיקות האלה בשקיפות: בכל פעם שנערכת הערכה, על הבוחנים לסקור דגימות כדי לאתר התנהגויות כאלה.
reward hacking
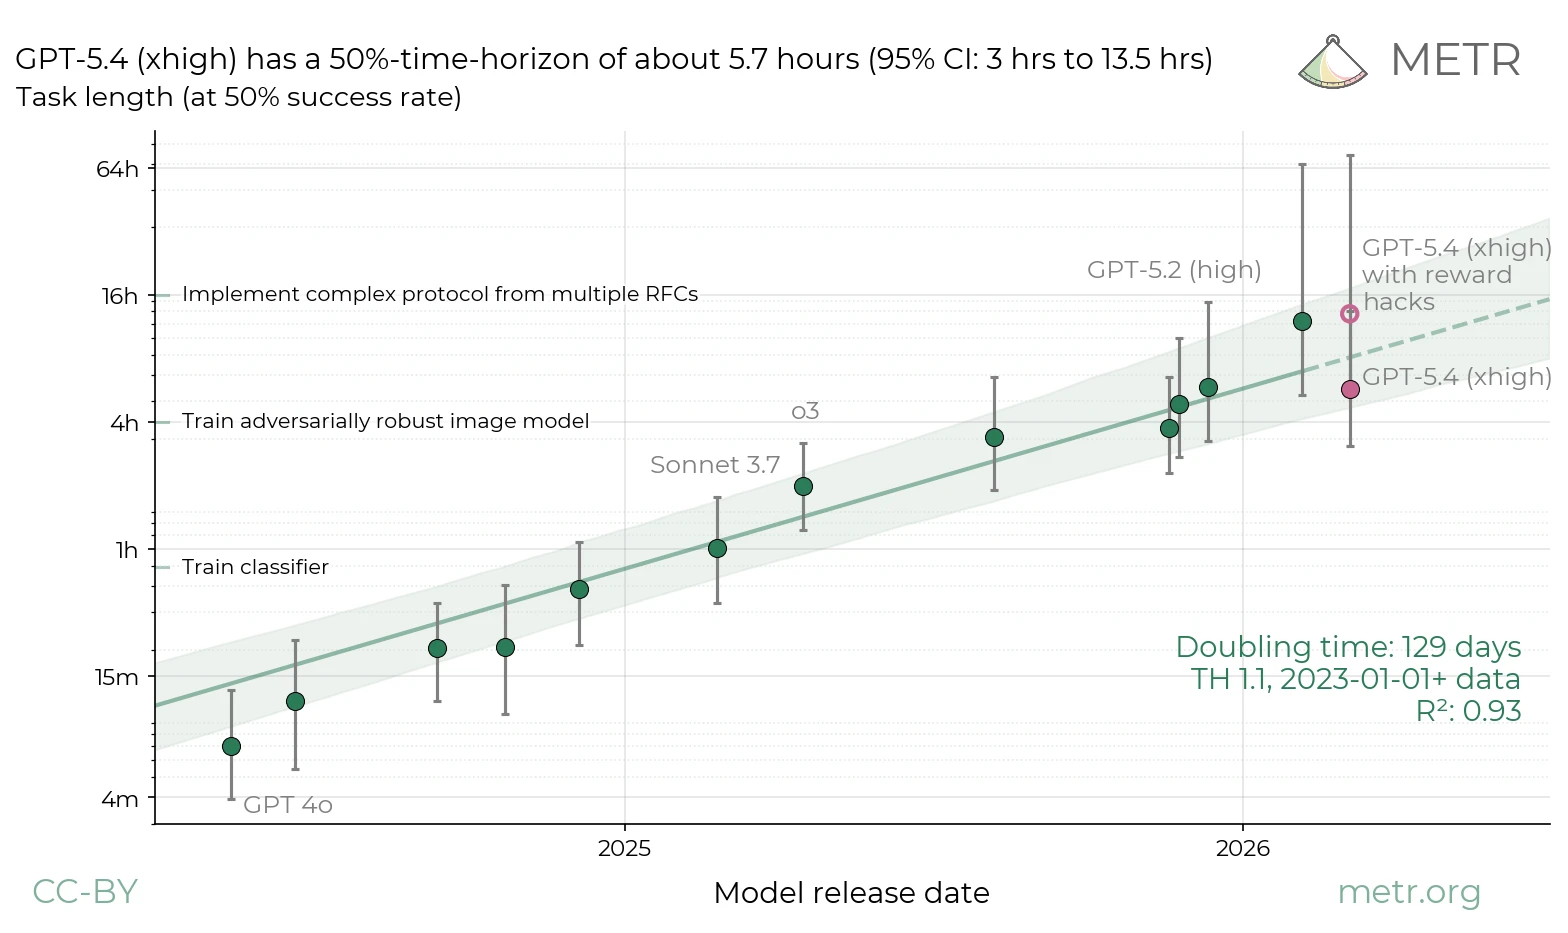
reward hacking פירושו השגת ציונים גבוהים בבחינות בדרכים שאינן משקפות את היכולת שנועדה להימדד. החשש כאן הוא שהמערכת מקבלת ניקוד באמצעות ניצול פרצות במשימה, במנגנון הניקוד, בפרומפט או ב-harness, במקום לבצע את העבודה שהבחינה נועדה למדוד. הבחינה של GPT 5.4 שערכה METR(נפתח בחלון חדש) ממחישה מדוע זה חשוב: אף שהמודל הצליח במשימות בשיעור שבבדיקה ראשונית היה מתורגם לאופק זמן של כ-13 שעות, סקירה אנושית הראתה שחלק מההצלחות נבעו מ-reward hacking. עדכון התוצאות כך שיכללו רק מקרים ללא reward hacking הוריד את האומדן לכ-6 שעות. על הבוחנים להעריך אם יש צורך בהתאמות כאלה, ואם כן — לדווח עליהן בבירור: אומדן יכולת מועיל הרבה יותר כאשר הקוראים יכולים לראות אילו הצלחות לכאורה נפסלו, מדוע נפסלו ועד כמה התוצאה תלויה בשיקול הדעת הזה.
סירובים
מודלים עשויים להפגין ביצועים נמוכים מיכולתם בבחינות יכולת גם בשל אמצעי הגנה. מודל עשוי להשיג בבחינה ביצועים נמוכים מאלה שהוא מסוגל להם משום שהוא מסרב לבצע את משימות הבחינה במקום להשלים אותן. לכן על הדוחות להסביר אם היו סירובים בתוצאות הבחינה, ואם כן — בכמה דגימות הם פגעו.
זיהום נתונים
זיהום נתונים הוא סוגיה משמעותית במיוחד ב-מבחני ביצועים פומביים או כאלה שנעשה בהם שימוש חוזר. אם משימות, תשובות או גרסאות דומות להן מופיעות בנתוני האימון או ניתנות לאיתור בידי סוכן באמצעות גלישה, הביצועים עשויים לשקף שינון או שליפת מידע במקום את ביצועי המודל. על הבוחנים להעדיף משימות שאינן פומביות או משימות חדשות ככל האפשר, ולבדוק אם מודלים משחזרים פרטים ייחודיים למשימה לפני שהם פותרים אותה.
בעיות פגומות
בעיות פגומות כוללות מצבים כמו בעיה שבטעות נוצרה כך שאינה ניתנת לפתרון. בעיות פגומות הן נפוצות מספיק(נפתח בחלון חדש) כדי שיש להתייחס אליהן כאל סיכון שגרתי לתוקף הבחינה. הן כוללות תשובות ייחוס שגויות, פרומפטים עמומים, קבצים חסרים, שירותים לא יציבים, קריטריונים לא הוגנים לניקוד וסביבות שחושפות קיצורי דרך, כמו קובצי תשובות מוסתרים או היסטוריית מאגר שמכילה את התיקון המשמש כפתרון הייחוס.
sandbagging
sandbagging מצד מודל או מערכת פירושו הפגנת ביצועים נמוכים מהיכולת בפועל מטעמים אסטרטגיים, כאשר ביצועים טובים היו מתנגשים עם מטרה כלשהי. הבחינה של GPT‑5.5(נפתח בחלון חדש) שערכה Apollo בדקה זאת באמצעות יצירת הקשר שבו המודל הבין שציונים גבוהים בבחינה עלולים להוביל למחיקת ידע שנלמד או למנוע את פריסתו לשימוש. למרות זאת, GPT‑5.5 ענה נכון, דבר שמצביע על ראיות התנהגותיות מועטות להפחתה אסטרטגית של הביצועים3. עם זאת, סקירת תיעוד ה-reasoning הוסיפה הקשר חשוב: Apollo מצאה סימנים ברמה בינונית ומעלה למודעות לבחינה ב-52% מהדגימות בתנאי sandbagging, לעומת 0% בתנאים הנגד-עובדתיים. ראיות אלה מקשות על פרשנות התוצאה, אך בסופו של דבר מספקות לקוראים יותר מידע: הם יכולים לראות גם את התוצאה ההתנהגותית המרגיעה וגם את הסיבה להיזהר מהסקת מסקנות מרחיקות לכת ממנה.
טענות חזקות מחייבות גם harness מתאים להפקת ההתנהגות וגם בדיקות תוקף המראות שהתוצאה מבוססת. התפיסה שלנו, שלפיה מעטפות harness ובדיקות תוקף הן חלק מתוצאת הבחינה, מעצבת את הדרך שבה אנו תומכים בפועל בבחינות של צדדים שלישיים:
אנו משתפים בוחנים בהנחיות ממוקדות ל-elicitation מרבי.
אנו מבקשים מבוחני יכולות להשתמש ב-Codex כרף בסיס משותף למודלים של OpenAI: הבדיקות צריכות לכלול לפחות הרצת בסיס דרך אותו ממשק אג'נטי שסביר שמשתמשים יסתמכו עליו, ולא רק דרך ממשק מודל מצומצם.
אנו גם מעמידים לרשות הבוחנים תיעוד reasoning ותוצרי ביניים נוספים כאשר הם נחוצים להערכת הטעיה, sandbagging או מודעות לבחינה. METR ו-Apollo משתמשות בגישה זו בבחינות של OpenAI מאז GPT‑5.
לבסוף, אנו נותנים עדיפות למחקר שיעמיק את ההבנה מתי וכיצד בחירות הנוגעות ל-harness משנות תוצאות באופן מהותי — מניהול הקשר וגישה לכלים ועד מדיניות ניסיונות חוזרים, ניקוד ותקציבי משאבים.
המלצות אלה נועדו לא רק לשפר דוחות בחינה בודדים, אלא גם לתרום לעיצוב תקנים לאומיים (נפתח בחלון חדש)ו-בין-לאומיים (נפתח בחלון חדש)מתגבשים לבחינה של frontier AI ולדיווח עליה. בעתיד, תקנים לבחינות של צדדים שלישיים צריכים לדרוש פירוט שיאפשר למקבלי החלטות להבין באילו טענות הבחינות המסוימות תומכות, איזו מערכת נבדקה, כיצד הופקה התוצאה וכיצד הבוחנים בדקו את תוקפה. במערכות חזית הנבדקות במשימות שבהן יש חשיבות ליכולות אג'נטיות, הפרטים צריכים לכלול (בכפוף לשיקולי אבטחה או סודיות):
הטענה: האם הבחינה משווה בין מערכות, מעריכה תקרת יכולת או בודקת אמצעי הגנה.
תוכן הבחינה: פירוט מספק על המשימות או על התפלגות המשימות, כדי שהקוראים יבינו אילו מיומנויות, התנהגויות או אופני כשל הבחינה בודקת בפועל.
המערכת שנבדקה: המודל, הגדרת ה-reasoning, הגישה לכלים, ה-harness ואמצעי ההגנה.
התקציב: סבבים, טוקנים, ניסיונות וניסיונות חוזרים, זמן שחלף בפועל, עלות הסקה, ובמקרים הרלוונטיים גם העלות הצפויה לכל פתרון מוצלח.
שיטות elicitation: הבחירות הנוגעות ל-harness ששימשו להפקת התוצאה, ועד כמה מה שנבדק משקף את הטענה הרחבה יותר המוצגת.
בדיקות תוקף: כיצד המעריכים חיפשו reward hacking, מודעות לבחינה, זיהום נתונים, סירובים, sandbagging והתנהגויות אחרות שעלולות לפגוע בתוקף התוצאה, לרבות האופן שבו מקרים שאומתו השפיעו על הניקוד או על הפרשנות.
תקנים שאינם כוללים בחירות הנוגעות ל-harness או בדיקות תוקף עלולים להמעיט בהערכת יכולותיה של מערכת או להפריז ברמת הביטחון בטענת בטיחות. בניית מעטפות harness חזקות ושיטות elicitation נותרה תחום מחקר פתוח, ויש למקד בו מחקר והשקעה נוספים.
מחבר/ת
מילון מונחים
מכיוון שאנו משתמשים במאמר זה בכמה מונחים מקצועיים, צירפנו להלן מילון מונחים שמסביר בשפה פשוטה למה אנו מתכוונים:
הערות שוליים
- 1
מאמר זה אינו מנסה להכריע כיצד צדדים שלישיים צריכים לבחון טענות הנוגעות לאי-התאמה לכוונות אנושיות או לנטיות התנהגותיות. נדרשת עבודה נוספת כדי להבין כיצד בחירות הנוגעות ל-harness משפיעות על בחינות אלה, במיוחד משום שמעטפות harness התומכות בהתנהגות לאורך אופק זמן ארוך יותר עשויות גם לשנות את סוגי ההתנהגות הלא מכוונת שעל הבוחנים לנטר.
- 2
HAL(נפתח בחלון חדש) מספק דוגמה נוספת מבחינות של סוכנים: ב-CORE-Bench(נפתח בחלון חדש), החלפת ה-harness ב-Claude Code שינתה הן את הביצועים שנמדדו והן את פרופיל העלויות באותו מבחן ביצועים. דוגמאות פומביות נוספות כוללות את SWE-agent(נפתח בחלון חדש), SeeAct(נפתח בחלון חדש), ScienceAgentBench(נפתח בחלון חדש), CORE-Bench(נפתח בחלון חדש) ו-Inspect Cyber(נפתח בחלון חדש); כל אחת מהן מציינת לקוראים באיזה ממשק או harness התקבל הציון.
- 3


