מציגים את OpenAI o3 ו-o4-mini
המודלים החכמים ובעלי היכולות המתקדמות ביותר שלנו עד כה, עם גישה מלאה לכלים
הפוסט הזה הציג לראשונה את OpenAI o3 ו-o4-mini.
המידע על הזמינות מתייחס להשקה באפריל 2025. o3 ו-o4-mini אינם זמינים עוד ב-ChatGPT ומוגדרים כמיועדים להוצאה משימוש ב-API. ראו את לוח הזמנים להוצאה משימוש ב-API(נפתח בחלון חדש).
לחוויית השימוש העדכנית:
עדכון מ-10 ביוני 2025: OpenAI o3‑pro זמין כעת למשתמשי Pro ב-ChatGPT, וגם ב-API שלנו. בדומה ל-OpenAI o1‑pro, o3‑pro הוא גרסה של המודל החכם ביותר שלנו, OpenAI o3, שנועדה לחשוב זמן רב יותר ולספק את התשובות האמינות ביותר. הפרטים המלאים מופיעים בהערות הגרסה(נפתח בחלון חדש) שלנו.
היום אנחנו משיקים את OpenAI o3 ואת o4-mini, המודלים החדשים ביותר בסדרת o שלנו, שמאומנים לחשוב זמן רב יותר לפני שהם משיבים. אלה המודלים החכמים ביותר שהשקנו עד כה, והם מהווים קפיצת מדרגה ביכולות של ChatGPT לכולם — ממשתמשים סקרנים ועד חוקרים מתקדמים. לראשונה, מודלי ה-reasoning שלנו יכולים להשתמש באופן אג'נטי בכל הכלים שב-ChatGPT ולשלב ביניהם — כולל חיפוש באינטרנט, ניתוח קבצים שהועלו ונתונים אחרים בעזרת Python, חשיבה מעמיקה על קלט חזותי ואפילו יצירת תמונות. חשוב מכך, המודלים האלה מאומנים לחשוב מתי ואיך להשתמש בכלים כדי להפיק תשובות מפורטות ומעמיקות בפורמטי הפלט המתאימים, בדרך כלל בתוך פחות מדקה, וכך לפתור בעיות מורכבות יותר. כך הם יכולים להתמודד בצורה יעילה יותר עם שאלות בעלות היבטים רבים — צעד לקראת ChatGPT אג'נטי יותר, שיוכל לבצע משימות באופן עצמאי עבורכם. השילוב בין reasoning מהמתקדמים ביותר לבין גישה מלאה לכלים מניב ביצועים חזקים משמעותית במבחני ביצועים אקדמיים ובמשימות מהעולם האמיתי, ומציב רף חדש הן ביכולות החשיבה והן בתועלת למשתמש.
OpenAI o3 הוא מודל ה-reasoning העוצמתי ביותר שלנו, שמרחיב את גבולות היכולת בתחומי התכנות, המתמטיקה, המדע והתפיסה החזותית, ועוד. הוא קובע שיאי ביצועים חדשים במבחני ביצועים כגון Codeforces, SWE-bench (ללא בניית מעטפת ייעודית למודל) ו-MMMU. הוא אידיאלי לשאלות מורכבות שמצריכות ניתוח מכמה זוויות ושהתשובות עליהן אינן בהכרח ברורות מיד. הוא מצטיין במיוחד במשימות חזותיות כמו ניתוח תמונות, תרשימים וגרפיקה. בהערכות של מומחים חיצוניים, o3 עושה 20 אחוז פחות טעויות משמעותיות מ-OpenAI o1 במשימות קשות מהעולם האמיתי — ומצטיין במיוחד בתחומים כמו תכנות, עסקים וייעוץ, והעלאת רעיונות יצירתיים. משתמשים שבדקו אותו בשלב מוקדם ציינו את קפדנותו האנליטית כשותף לחשיבה, והדגישו את יכולתו להעלות השערות חדשות ולבחון אותן באופן ביקורתי — במיוחד בתחומי הביולוגיה, המתמטיקה וההנדסה.
OpenAI o4-mini הוא מודל קטן יותר, שמותאם ל-reasoning מהיר וחסכוני — הוא משיג ביצועים מרשימים ביחס לגודלו ולעלותו, במיוחד במתמטיקה, בתכנות ובמשימות חזותיות. מבין המודלים שנבדקו, הוא משיג את הביצועים הטובים ביותר ב-AIME 2024 וב-AIME 2025. אף שגישה למחשב מפחיתה משמעותית את רמת הקושי של מבחן AIME, ראוי לציין ש-o4-mini משיג 99.5% במדד pass@1 (100% במדד consensus@8) ב-AIME 2025 כאשר ניתנת לו גישה למפרש Python. אין להשוות את התוצאות האלה לביצועים של מודלים ללא גישה לכלים, אך הן מדגימות באיזו יעילות o4-mini מנצל את הכלים הזמינים לו. גם o3 מציג שיפורים דומים ב-AIME 2025 בעקבות שימוש בכלים (98.4% במדד pass@1, 100% במדד consensus@8).
בהערכות מומחים, o4-mini עולה בביצועיו על קודמו, o3‑mini, גם במשימות שאינן מתחומי המדע, הטכנולוגיה, ההנדסה והמתמטיקה, וגם בתחומים כמו מדע הנתונים. בזכות יעילותו, o4-mini מאפשר מכסות שימוש גבוהות משמעותית מאלה של o3, ולכן הוא אפשרות מצוינת לשימוש בהיקף גדול ובתפוקה גבוהה עבור שאלות ש-reasoning מועיל בהן. מומחים חיצוניים שהעריכו את שני המודלים קבעו שהם מפגינים יכולת משופרת לפעול לפי הוראות ומספקים תשובות מועילות וניתנות לאימות יותר מקודמיהם, בזכות יכולות חשיבה משופרות ושילוב מקורות מהאינטרנט. בהשוואה לגרסאות קודמות של מודלי ה-reasoning שלנו, השיחה עם שני המודלים האלה אמורה גם להרגיש טבעית וזורמת יותר, במיוחד כשהם נעזרים בזיכרון ובשיחות קודמות כדי להתאים את התשובות באופן אישי ולהפוך אותן לרלוונטיות יותר.
יכולות רב-מודאליות
תכנות
כל הרצות ההערכה של SWE-bench משתמשות בתת-קבוצה קבועה של n=477 משימות מאומתות, שנבדקו בתשתית הפנימית שלנו.
ביצוע הוראות ושימוש אג'נטי בכלים
כל המודלים נבדקים בהגדרות גבוהות של ״מאמץ reasoning״ — בדומה לגרסאות כמו ״o4-mini-high״ ב-ChatGPT.
לאורך פיתוח OpenAI o3, ראינו שלמידת חיזוק בקנה מידה גדול מפגינה את אותה מגמה של ״יותר משאבי חישוב = ביצועים טובים יותר״ שנצפתה באימון המקדים של סדרת GPT. חזרנו על תהליך הגדלת היקף האימון — הפעם בלמידת חיזוק — והגדלנו בסדר גודל נוסף הן את משאבי החישוב לאימון והן את ה-reasoning בזמן ההסקה. גם כך, אנחנו ממשיכים לראות שיפורים ברורים בביצועים, המאשרים שככל שמאפשרים למודלים לחשוב יותר, ביצועיהם ממשיכים להשתפר. באותם זמני תגובה ובאותה עלות כמו OpenAI o1, o3 מספק ביצועים טובים יותר ב-ChatGPT — ואימתנו שאם נותנים לו לחשוב זמן רב יותר, ביצועיו ממשיכים להשתפר.
בנוסף, אימנו את שני המודלים להשתמש בכלים באמצעות למידת חיזוק — ולימדנו אותם לא רק איך להשתמש בכלים, אלא גם לחשוב מתי להשתמש בהם. היכולת שלהם להפעיל כלים בהתאם לתוצאות הרצויות משפרת את יכולתם להתמודד עם מצבים פתוחים — במיוחד כאלה שכוללים reasoning חזותי ותהליכי עבודה מרובי שלבים. השיפור הזה משתקף הן במבחני ביצועים אקדמיים והן במשימות מהעולם האמיתי, כפי שדיווחו משתמשים שבדקו את המודלים בשלב מוקדם.
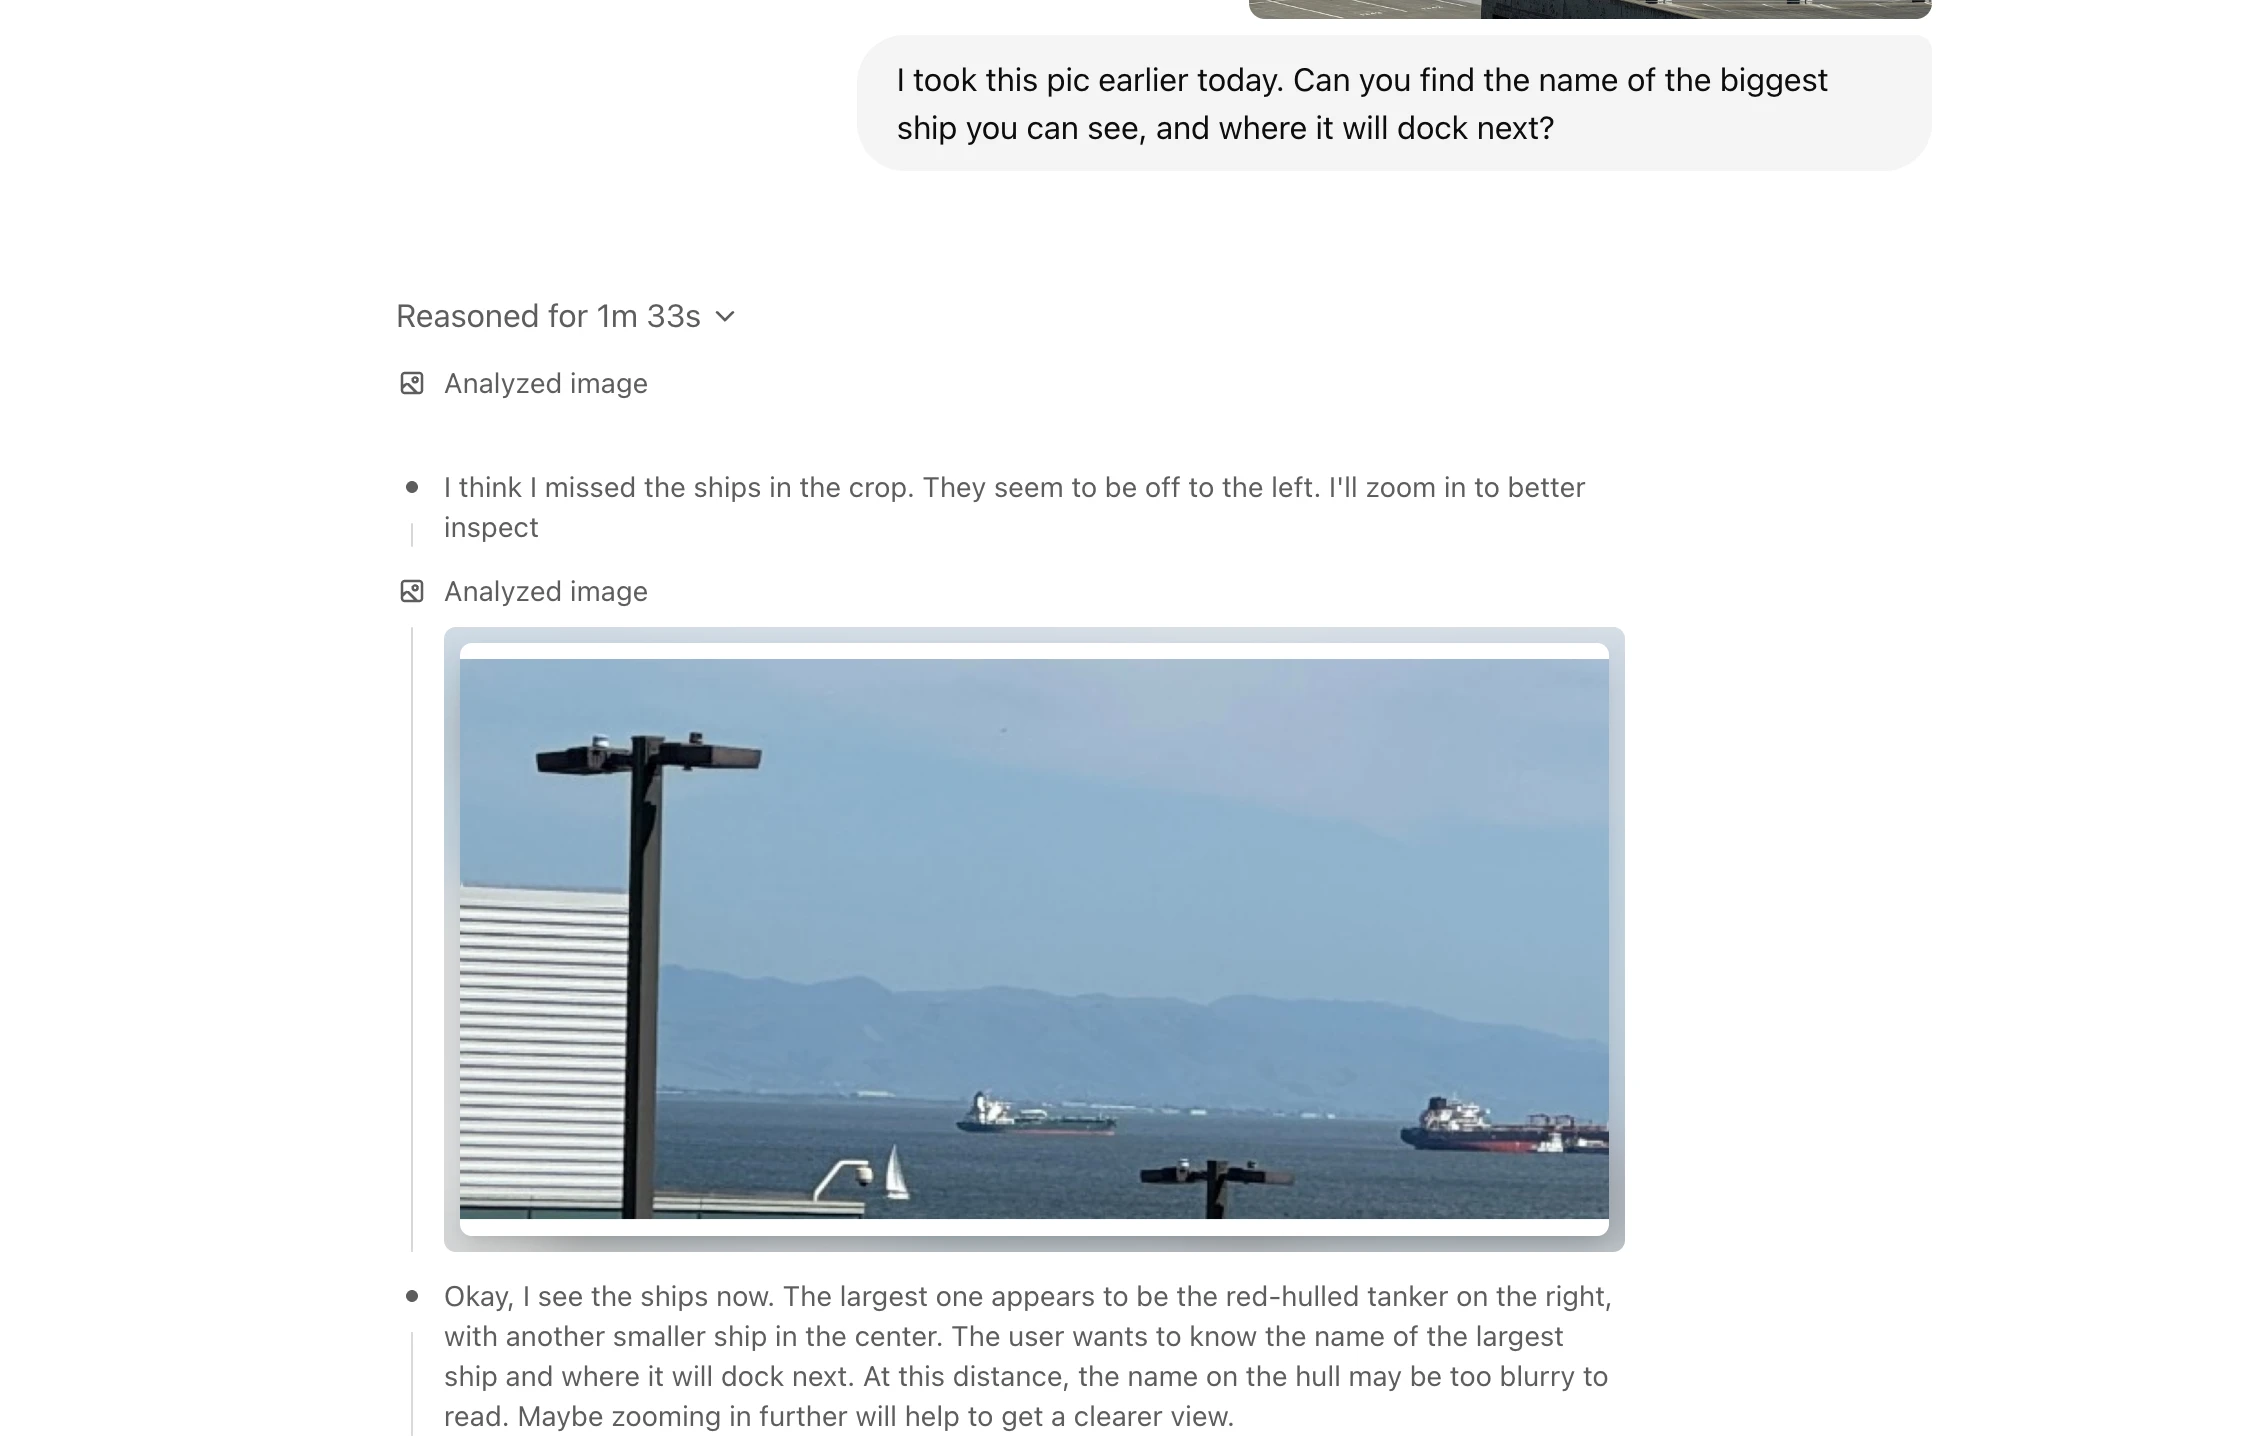
לראשונה, המודלים האלה יכולים לשלב תמונות ישירות בשרשרת החשיבה שלהם. הם לא רק רואים תמונה — הם חושבים בעזרתה. כך נפתחת דרך חדשה לפתרון בעיות, המשלבת reasoning חזותי וטקסטואלי. הדבר משתקף בביצועיהם המובילים במבחני ביצועים רב-מודאליים.
אפשר להעלות צילום של לוח מחיק, תרשים מספר לימוד או סקיצה שצוירה ביד, והמודל יכול לפרש אותם — גם אם התמונה מטושטשת, הפוכה או באיכות נמוכה. באמצעות כלים, המודלים יכולים לעבד תמונות תוך כדי עבודה — לסובב אותן, להגדיל אותן או לשנות אותן כחלק מתהליך ה-reasoning שלהם.
המודלים האלה מספקים דיוק מהמובילים מסוגו במשימות תפיסה חזותית, וכך יכולים לפתור שאלות שבעבר היו מעבר ליכולתם. למידע נוסף, קראו את פוסט המחקר על reasoning חזותי.
ל-OpenAI o3 ול-o4-mini יש גישה מלאה לכלים בתוך ChatGPT, וגם לכלים המותאמים אישית שלכם באמצעות קריאה לפונקציות ב-API. המודלים האלה מאומנים לחשוב על הדרך לפתרון בעיות, ולבחור מתי ואיך להשתמש בכלים כדי להפיק במהירות תשובות מפורטות ומעמיקות בפורמטי הפלט המתאימים — בדרך כלל בתוך פחות מדקה.
למשל, משתמש עשוי לשאול: ״How will summer energy usage in California compare to last year?״ המודל יכול לחפש באינטרנט נתונים של חברות תשתית, לכתוב קוד Python לבניית תחזית, ליצור גרף או תמונה ולהסביר את הגורמים המרכזיים שעליהם מבוססת התחזית, באמצעות שרשור של כמה קריאות לכלים. reasoning מאפשר למודלים להגיב למידע שהם נתקלים בו ולשנות כיוון לפי הצורך. למשל, הם יכולים לבצע כמה חיפושים באינטרנט בעזרת ספקי חיפוש, לבחון את התוצאות ולנסות חיפושים חדשים אם דרוש להם מידע נוסף.
הגישה הגמישה והאסטרטגית הזאת מאפשרת למודלים להתמודד עם משימות שדורשות גישה למידע עדכני מעבר לידע המובנה במודל, reasoning ממושך, שילוב מידע והפקת פלט בסוגי מדיה שונים.
כל הדוגמאות בוצעו באמצעות OpenAI o3.
מקדמים reasoning חסכוני
עלות מול ביצועים: o3‑mini ו-o4-mini


עלות מול ביצועים: o1 ו-o3


OpenAI o3 ו-o4-mini הם המודלים החכמים ביותר שהשקנו אי פעם, ולעיתים קרובות הם גם יעילים יותר מקודמיהם, OpenAI o1 ו-o3‑mini. למשל, בתחרות המתמטיקה AIME לשנת 2025, עקומת העלות-ביצועים המיטבית של o3 טובה מזו של o1 לכל אורכה, וכך גם העקומה של o4-mini לעומת זו של o3‑mini. באופן כללי יותר, אנחנו צופים שברוב השימושים בפועל, o3 ו-o4-mini יהיו גם חכמים יותר וגם זולים יותר מ-o1 ומ-o3‑mini, בהתאמה.
כל שיפור ביכולות המודל מחייב שיפורים מקבילים בבטיחות. עבור OpenAI o3 ו-o4-mini, בנינו מחדש את כל נתוני אימון הבטיחות שלנו, והוספנו פרומפטים חדשים לאימון על סירוב בתחומים כמו איומים ביולוגיים, יצירת נוזקות ופרצות. הנתונים המעודכנים הובילו את o3 ואת o4-mini להישגים גבוהים במבחני הסירוב הפנימיים שלנו (למשל, היררכיית הוראות ופרצות). לצד הביצועים הגבוהים של המודלים בסירוב לבקשות, פיתחנו גם אמצעי הגנה ברמת המערכת שמסמנים פרומפטים מסוכנים בתחומי סיכון ממודלי חזית. בדומה לעבודתנו הקודמת בתחום יצירת תמונות, אימנו מנטר מבוסס LLM בעל יכולות reasoning, שפועל לפי מפרטי בטיחות שנכתבו בידי בני אדם וניתנים להבנה ולפרשנות. כשהפעלנו את המנטר בתחום הסיכונים הביולוגיים, הוא הצליח לסמן כ-99% מהשיחות במסגרת בדיקות התקיפה שביצעו בודקים אנושיים.
העמדנו את שני המודלים במבחני מאמץ במסגרת תוכנית הבטיחות המחמירה ביותר שלנו עד כה. בהתאם ל-Preparedness Framework המעודכנת שלנו, הערכנו את o3 ואת o4-mini בשלושת תחומי היכולת שהמסגרת עוקבת אחריהם: ביולוגיה וכימיה, אבטחת סייבר ושיפור עצמי של בינה מלאכותית. על סמך תוצאות ההערכות האלה, קבענו שגם o3 וגם o4‑mini נותרים מתחת לסף הסיכון ״גבוה״ של המסגרת בכל שלוש הקטגוריות. פרסמנו את התוצאות המפורטות של ההערכות האלה בכרטיס המערכת המצורף.
אנחנו משתפים גם כלי ניסיוני חדש: Codex CLI, סוכן תכנות קל משקל שאפשר להריץ מהטרמינל. הוא פועל ישירות במחשב שלכם ונועד להפיק את המרב מיכולות ה-reasoning של מודלים כמו o3 ו-o4-mini. בקרוב תתווסף תמיכה במודלי API נוספים, כמו GPT‑4.1.
אפשר ליהנות מהיתרונות של reasoning רב-מודאלי דרך שורת הפקודה, באמצעות העברת צילומי מסך או סקיצות ראשוניות למודל, בשילוב גישה לקוד המקומי שלכם. אנחנו רואים בו ממשק מינימליסטי שמחבר את המודלים שלנו למשתמשים ולמחשבים שלהם. החל מהיום, Codex CLI זמין במלואו בקוד פתוח בכתובת github.com/openai/codex(נפתח בחלון חדש).
במקביל, אנחנו משיקים יוזמה בהיקף של מיליון דולר לתמיכה בפרויקטים המשתמשים ב-Codex CLI ובמודלים של OpenAI. נבחן ונאשר בקשות למענקים בכפולות של 25,000 דולר ארה״ב, שיינתנו בצורת קרדיטים לשימוש ב-API. אפשר להגיש הצעות כאן.
החל מהיום, משתמשי ChatGPT Plus, Pro ו-Team יראו בבורר המודלים את o3, o4-mini ו-o4-mini-high במקום o1, o3‑mini ו-o3‑mini‑high. משתמשי ChatGPT Enterprise ו-Edu יקבלו גישה בעוד שבוע. משתמשים בתוכנית החינמית יכולים לנסות את o4-mini באמצעות בחירה באפשרות ״חשיבה״ באזור כתיבת ההודעה לפני שליחת השאלה. מגבלות קצב הבקשות בכל התוכניות נותרות ללא שינוי לעומת מערך המודלים הקודם.
אנחנו צופים להשיק את OpenAI o3‑pro בעוד כמה שבועות, עם תמיכה מלאה בכלים. בינתיים, משתמשי Pro עדיין יכולים לגשת ל-o1‑pro.
גם o3 וגם o4-mini זמינים למפתחים החל מהיום דרך ה-API להשלמת צ'אטים ו-Responses API (חלק מהמפתחים יצטרכו לאמת את הארגונים שלהם(נפתח בחלון חדש) כדי לגשת למודלים האלה). Responses API תומך בסיכומי reasoning ובאפשרות לשמר טוקני reasoning סביב קריאות לפונקציות לשיפור הביצועים. בקרוב הוא יתמוך גם בכלים מובנים כמו חיפוש באינטרנט, חיפוש בקבצים ומפרש קוד כחלק מתהליך ה-reasoning של המודל. כדי להתחיל, עיינו בתיעוד שלנו(נפתח בחלון חדש) והמשיכו לעקוב אחר עדכונים נוספים.
העדכונים של היום משקפים את הכיוון שאליו מתקדמים המודלים שלנו: אנחנו משלבים את יכולות ה-reasoning הייעודיות של סדרת o עם יותר מיכולות השיחה הטבעית והשימוש בכלים של סדרת GPT. באמצעות איחוד היתרונות האלה, המודלים העתידיים שלנו יתמכו בשיחות טבעיות וזורמות לצד שימוש יזום בכלים ופתרון בעיות מתקדם.
עדכון מ-28 ביולי 2025: מערך הנתונים והתוצאות של SWE-Lancer, המעודכנים ל-17 ביולי 2025, זמינים בכתובת: https://github.com/openai/preparedness(נפתח בחלון חדש) ובכרטיסי המערכת שלנו. העדכון פותר כמה בעיות שהשפיעו על תוצאות מדד ההכנסות בדולרים, ומסיר את הדרישה לחיבור לאינטרנט במהלך ההרצה, ובכך מבטל מקור מרכזי לשונות בביצועי המודלים.
עדכון מ-16 באפריל 2025: התוצאות של o3 ב-Charxiv-r וב-Mathvista עודכנו כדי לשקף שינוי בפרומפט המערכת שלא נכלל בהערכה המקורית.
מחבר
הערות שוליים
* תוצאות ההערכה של tau-bench הן ממוצע של 5 הרצות כדי לצמצם את השונות, וההרצות בוצעו ללא כלים או פרומפטים מותאמים אישית. מצאנו שבהרצות של tau-bench בתחום הקמעונאות יש נטייה גבוהה יותר לשגיאות מצד המודל המדמה את המשתמש. התוצאות בעמודה המוצללת התקבלו בהרצות עם GPT-4.1 כמודל המדמה את המשתמש, משום שהוא טוב משמעותית מ-GPT-4o בביצוע הוראות.
* ב-SWE-bench נעשה שימוש באורך הקשר מרבי של 256 אלף טוקנים, שמשפר את שיעור הפתרון של o4-mini בכ-3% ומשפיע על שיעור הפתרון של o3 בפחות מ-1%. בנוסף, איננו כוללים 23 דגימות שלא ניתן להריץ בתשתית הפנימית שלנו.
** כאשר מאפשרים גלישה, המודל עשוי לפעמים למצוא תשובות מדויקות באינטרנט, למשל באמצעות קריאת פוסטים בבלוגים עם בעיות לדוגמה מתוך מערך נתונים. אנחנו מצמצמים את החשש לרמאות של המודל בזמן הגלישה באמצעות שתי אסטרטגיות:
לבסוף, ייתכן שלא ניתן לשחזר באופן מושלם את ההערכות שלנו הכוללות גלישה ב-API של OpenAI, בשל הבדלים בתשתיות מנועי החיפוש בין ChatGPT לבין ה-API של OpenAI. התוצאות האלה נועדו לייצג את חוויית השימוש ב-ChatGPT, אך תצורת החיפוש עשויה להשתנות עם הזמן בהתאם לביקוש.
המשתתפים בפיתוח
Aaditya Singh, Aaron Schlesinger, Adam Fry, Adam Lerer, Adam Perelman, Adam Walker, Ahmed El-Kishky, Aidan Clark, Aidan McLaughlin, Aiden Low, Akila Welihinda, Akshay Nathan, Aleksander Madry, Aleksandra Spyra, Alex Karpenko, Alex Neitz, Alex Tachard Passos, Alex Wei, Alexander Prokofiev, Alexander Zielenski, Alexandra Barr, Alexey Ivanov, Alexi Christakis, Alfred Xue, Allison Tam, Ally Bennett, Ally Bennett , Amelia Liu, Amy McDonald Sandjideh, Ananya Kumar, Andre Saraiva, Andrea Vallone, Andrew Chen, Andrew Duberstein, Andrew Gibiansky, Andrew Kondrich, Andrew Tulloch, Andrey Mishchenko, Andy Applebaum, Andy Wang, Angela Baek, Annie Wei, Anting Shen, Antoine Pelisse, Anuj Saharan, Arun Vijayvergiya, Ashley Tyra, Ashvin Nair, Avi Nayak, Avital Oliver, Behrooz Ghorbani, Belinda Truong, Ben Sokolowsky, Beth Hoover, Bo Xu, Boaz Barak, Bohan Zhang, Borys Minaiev, Botao Hao, Bowen Baker, Bowen Cheng, Brandon McKinzie, Brandon Wang, Brian Hsu, Brian Yang, Brian Yu, Brian Zhang, Camillo Lugaresi, Carolina Paz, Carpus Chang, Cary Bassin , Cary Hudson, Casey Chu, Chak Li, Charles Zhao, Charlie Jatt, Charlotte Cole, Chelsea Voss, Chen Shen, Chengxu Zhuang, Chris Colby, Chris Hallacy , Chris Koch, Christina Kaplan, Christina Kim, Colin Reid, Colin Wei, Cristina Scheau, D. Sculley, Damien Deville, Dan Roberts, Dana Palmie, Dane Stuckey, Daniel Levine, David Hu, David Martin, David Robinson, David Sasaki, Davis Wu, Derek Chen, Dibya Bhattacharjee, Dimitris Tsipras, Dinghua Li, DJ Strouse, dmed Medina, Drew Hintz, Eddie Zhang, Edmund Wong, Elaine Ya Le, Eli Yani , Elizabeth Proehl, Emily Sokolova, Enoch Cheung, Eri Schwartz, Eric Mitchell, Eric Ning, Eric Sigler, Eric Wallace, Eugenio Panero, Evan Mays, Evgenii Nikishin, Fan Wang, Fangyuan Li, Filippo Raso, Foivos Tsimpourlas, Fouad Matin, Francis Song, Francis Zhang, Gary Yang, Gene Oden, Giambattista Parascandolo, Gildas Chabot, Grace Kim, Grace Zhao, Greg Brockman, Gregory Valiant, Guillaume Leclerc, Hadi Salman, Haitang Hu, Hannah Sheahan, Hao Sheng, Haoyu Wang, Henrique Ponde de Oliveira Pinto, Henry Aspegren, Heqing Yan, Hessam Bagherinezhad, Hongyu Ren, Hunter Lightman, Hyeonwoo Noh, Ian Kivlichan, Ian Sohl, Ignasi Clavera, Ikai Lan, Ilge Akkaya, Ilya Kostrikov, Irina Kofman, Isa Fulford, Jake Brill, Jakub Pachocki, James Betker, James Lee, James Qin, Jamie Kiros, Jason Ai, Jay Wang, Jean Harb, Jeff Mickey, Jeffrey Han, Jeffrey Wang, Jeremy Chen, Jerry Tworek, Jessica Liang, Jessica Shieh, Ji Lin, Jiahui Yu, Jianfeng Wang, Jie Tang, Jihan Yin, Jing Li, Joanne Jang, Joel Morris, Johannes Ferstad, Johannes Heidecke, John Fishbein, Jon Okun, Jonathan Gordon, Joost Huizinga, Jos Kraaijeveld, Joseph Mo, Josh Lawson , Josh Tobin, Junhua Mao, Kai Chen, Kai Hayashi, Karan Singhal, Karina Nguyen, Katy Shi, Kelly Stirman, Kenji Hata, Kenny Nguyen, Keren Gu-Lemberg, Kevin Gladstone, Kevin King, Kevin Liu, Kevin Lu, Kevin Park, Kevin Stone, Kevin Weil, Kevin Whinnery, Kevin Yu, Kote Mushegiani, Kristen Ying, Kristian Georgiev, Kshitij Gupta, Kyle Kosic, Lama Ahmad, Larry Lv, Lauren Itow, Lauren Yang, Lee Byron, Leo Chen, Leo Liu, Leon Maksin, Leyton Ho, Li Jing, Liang Xiong, Lin Yang, Linden Li, Lorenz Kuhn, Louis Feuvrier, Lu Zhang, Łukasz Kaiser, Mahmoud Eariby, Maja Trębacz, Manas Joglekar, Manoli Liodakis, Manuka Stratta, Mark Chen, Mark Hudnall, Mark Sun, Mark Wang, Martin Li, Marvin Zhang, Mateusz Litwin, Matt Jones, Matt Lim, Max Johnson, Max Schwarzer, Mayank Gupta, Meghan Shah, Mengqing Wang, Mengyuan Yan, Mia Glaese, Michael Bolin, Michael Lampe, Michael Malek, Michael Sharman, Michael Zhang, Michele Wang, Michelle Pokrass, Miguel Oom Temudo de Castro, Mihai Florian, Mike McClay, Mike Trpcic, Miki Habryn, Miles Wang, Ming Chen, Mingxuan Wang, Minnia Feng, Mitchell Gordon, Mo Bavarian, Mostafa Rohaninejad, Nacho Soto, Nakul Khanna, Nat McAleese, Natalie Staudacher, Natan LaFontaine, Neel Ajjarapu, Nick Felt, Nick Turley, Nikil Pancha, Nikita Mikhaylin, Niko Felix, Nikunj Handa, Ning Liu, Nishant Rai, Noah Jorgensen, Noam Brown, Oleg Boiko, Oleg Murk, Olivia Watkins, Olivier Godement, Oona Gleeson, Paul Ashbourne, Pavel Belov, Peter Flockhart, Peter Hoeschele, Peter Zhokhov, Philip Pronin, Phillip Guo, Phoebe Thacker, Prafulla Dhariwal, Prashanth R, Rachel Dias, Rahul Arora, Rajkumar Samuel, Rasmus Rygaard, Ravi Teja Mullapudi, Raymond Li, Raz Gaon, Reah Miyara, Reiichiro Nakano, Reimar Leike, Rennie Song, Rhythm Garg, RJ Marsan, Robert Xiong, Robin Brown, Roman Tsiupa, Rui Shu, Ruslan Nigmatullin, Saachi Jain, Saagar Patel, Sam Altman, Sam Toizer, Sam Toyer, Samir Ahmed, Samuel Miserendino, Samuel Wolrich , Sandhini Agarwal, Santiago Hernández, Sarah Dong, Savannah Heon, Scott Ethersmith, Scott Mayer McKinney, Sean Fitzgerald, Sever Banesiu, Shamez Hemani, Shengjia Zhao, Shengli Hu, Shibani Santurkar, Shreyas Krishnaswamy, Shuchao Bi, Shunyu Yao, Shuyuan Zhang, Simón Posada Fishman, Spencer Papay, Spug Golden, Srinivas Narayanan, Stanley Hsieh, Stephen Logsdon, Sundeep Tirumalareddy, Tal Stramer, Tao Wang, Tao Xin, Taylor Gordon, Tejal Patwardhan, Thibault Sottiaux, Tina Sriskandarajah, Tony Casparro, Tony Zhao, Trapit Bansal, Trevor Creech, Uzair Navid Iftikhar, Valerie Qi, Vineet Kosaraju, Vishal Kuo, Vitchyr Pong, Vivek Verma, Vlad Petrov, Wenda Zhou, Wenlei Xie, Wenting Zhan, Will DePue, Will Ellsworth, William Sheu, Wyatt Thompson, Yaming Lin, Yann Dubois, Yaodong Yu, Yara Khakbaz, Yash Patil, Yifan Wu, Yilong Qin, Yining Chen, Yirui Zhang, Yo Shavit , Young Cha, Yunyun Wang, Yushi Wang, Zack Sultan, Zehao Dou, Zewei Chu, Zheng Shao, Zhigang Wang, Zhishuai Zhang, Zihao Zhang