מציגים את GeneBench-Pro
מבחן הערכה ברמת מחקר, המודד כיצד סוכני בינה מלאכותית מתמודדים עם עמימות ומקבלים החלטות בעלות השלכות בביולוגיה חישובית.
נתונים מדעיים מגיעים רק לעיתים רחוקות עם הוראות. חוקרים צריכים להחליט אם דפוס מסוים משקף תופעה ביולוגית או רעש, אם הנתונים מאפשרים לענות על השאלה שנשאלת, וכיצד כל תוצאה צריכה לשנות את הצעד הבא שלהם. סוכני בינה מלאכותית מסוגלים יותר ויותר לבצע ניתוחים מורכבים. אבל מחקר מדעי אמיתי אינו מסתפק בשליפת עובדות או במעקב אחר תהליך עבודה מוגדר מראש: הוא דורש גם הפעלת שיקול דעת ברמה גבוהה כזו.
היום אנחנו מציגים את GeneBench-Pro — מבחן הערכה מאתגר ברמת מחקר, הבוחן אם מודלים יכולים לבצע את הניתוחים עתירי שיקול הדעת שדורשת הביולוגיה החישובית בעולם האמיתי. הוא מרחיב את GeneBench(נפתח בחלון חדש) למשימות קשות ומציאותיות יותר בגנומיקה, בביולוגיה כמותית וברפואה תרגומית, ומשקף את המורכבות, את תהליכי העבודה האיטרטיביים ואת העמימות של המחקר המדעי בביולוגיה חישובית.
עד כה, מעט הערכות בחנו באופן משכנע את ההכרעות המערכתיות שהופכות מחקר חישובי בעולם האמיתי למאתגר. אלה כוללות התמודדות עם עמימות, עדכון הנחות, בחירת מסלול הניתוח הנכון וזיהוי השלב שבו תוצאה בשלה לשמש בסיס להחלטה. קשה להגדיר מיומנויות אלה באופן פורמלי, ולכן קשה גם להעריך אותן בקפדנות — אף שחולשות בהן מגבילות יותר ויותר את הביצועים הכוללים של הבינה המלאכותית.
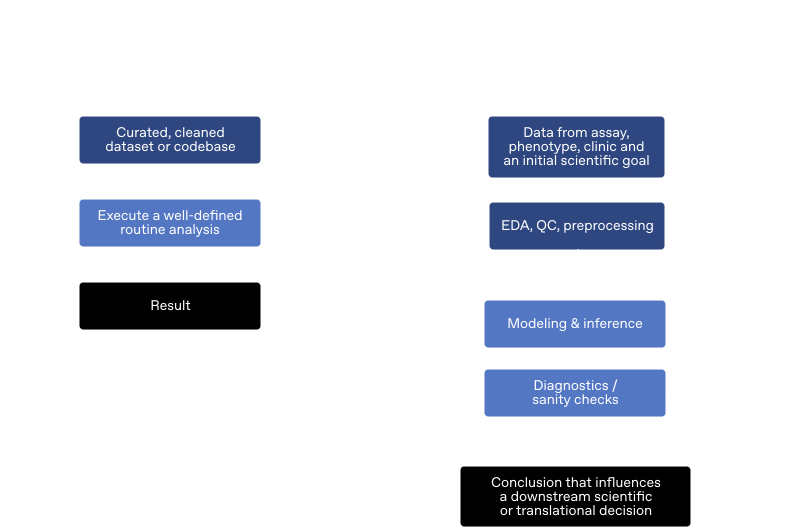
GeneBench-Pro נועד למדוד במדויק את היכולות האלה ברמה הגבוהה יותר. ב-GeneBench-Pro אנחנו מגדירים ״חוש מחקרי״ כרצף ההכרעות שמעצבות ניתוח: על אילו שאלות הנתונים מאפשרים לענות, כיצד בדיקות ראשוניות צריכות לשנות את המודל או את גודל המטרה לאמידה, ומתי צריך לעדכן את התוכנית הראשונית. כל בעיית GeneBench-Pro מספקת למודל מערך נתונים מציאותי ולא מסודר, הקשר ניסויי קצר וגודל מטרה לאמידה הקשור להחלטה שתתקבל בהמשך. כדי לענות נכון, המודל צריך לחקור את הנתונים, לבחור גישת ניתוח מתאימה, לעבור תהליך איטרטיבי של ניסויים ולספק תשובה סופית.
בביולוגיה, עלות הפקת הנתונים (למשל ריצוף גנום) ירדה דרמטית, וכיום יש חוקרים שטוענים(נפתח בחלון חדש) שהגורם המגביל כבר אינו איסוף הדגימות אלא החישוב והניתוח שבאים אחריו. GeneBench-Pro נבנה כדי להעריך את ההתקדמות בהתמודדות עם צוואר הבקבוק הזה, וכולל 129 שאלות המכסות מגוון רחב של תרחישים ושיטות בביולוגיה חישובית.
אטלס הדומיינים: 129 בעיות ב-10 דומיינים וב-21 תת-דומיינים
לחצו על הדוט שלמעלה כדי לצפות במידע על בעיה במבחן ההשוואה.
האטלס הזה מציע הצצה למגוון הרחב של GeneBench-Pro. בעמוד מקרי הבוחן תוכלו לעיין לעומק ב-10 שאלות מייצגות.
GeneBench-Pro תוכנן גם כדי להימנע מכשלים נפוצים במבחני הערכה. מבחני הערכה רבים בביולוגיה, הבוחנים משימות ממושכות, בונים שאלות רב-שלביות סביב מערכי נתונים היסטוריים לא מסודרים, שבהם לא תמיד יש מסלול ניתוח נכון יחיד. סוכן אחד עשוי לבחור ערך סף מוצדק, ואחר — אפשרות שונה אך מוצדקת באותה מידה. במקרה כזה, ההערכה משקפת את הבחירות השרירותיות של יוצר המבחן יותר מאשר הבדלים מהותיים בביצועי המודלים. גם ההפך עלול לקרות: אם הרגישות המספרית של הבעיה נמוכה מדי, סוכן יכול לטעות טעויות יסוד בניתוח ועדיין להפיק תוצאה שעוברת את המבחן.
כדי להימנע מכשלים אלה, כל בעיית GeneBench-Pro נבנית באופן סינתטי: אנחנו מכירים את המבנה הסיבתי המלא ומדמים ישירות את תהליך יצירת הנתונים. כך אפשר לכוונן את מורכבותה של כל בעיה, להבטיח שהבדלים סבירים בבחירות ניתוח סובייקטיביות עדיין יניבו תוצאות מספריות קבילות, ולוודא באמצעות מחקרי אבלציה שניתוחים סבירים לכאורה אך שגויים ייכשלו. לאחר מכן אנחנו בודקים את טיוטות הבעיות באמצעות ניתוח מפורט של עקבות הביצוע, כדי לאתר דליפת מידע ומסלולי פתרון שלא התכוונו לאפשר. כך אנחנו יכולים להיות בטוחים שהגעה לתשובה הנכונה תלויה בבחירת מסלול הניתוח הנכון, ולא בניצול קיצור דרך או בהתאמה להעדפה שרירותית של מחבר הבעיה.

שלחנו 82 מתוך 129 שאלות GeneBench-Pro למומחים חיצוניים בתחום, ובהם סטודנטים לתארים מתקדמים, חוקרי פוסט-דוקטורט, מדענים מהתעשייה ופרופסורים. הסוקרים העריכו עד כמה כל בעיה מציאותית, אם אפשר לזהות את תשובת היעד ואם השיטות והאומדים מתאימים. המשוב שימש לשיפור הבעיות.
“הבעיות שסקרתי היו מאתגרות עבור סטודנט לתואר מתקדם ללא משוב חוזר ממנחה מנוסה לאורך הדרך. בנתונים היו בעיות טכניות ובעיות בבקרת האיכות, וכדי להתמודד איתן בהצלחה נדרש ניתוח נתונים מעמיק וביקורתי, תוך מודעות למכשולים אפשריים; לא היה מדובר רק ביישום שיטת מדף על נתונים נקיים ומאורגנים היטב.”
“גם אם המודלים הנוכחיים עדיין לא מסוגלים לבצע ניתוחים עצמאיים מההתחלה ועד הסוף באופן אמין, ברור שמודלים שמצליחים בבעיות של GeneBench-Pro יוכלו לסייע לחוקרים לקבוע תהליכי עבודה נכונים ולחקור נתונים. אני יכולה לראות איך זה ישפר מאוד את קצב המחקר, את יסודיותו ואת היכולת לשחזר אותו.”
כל בעיית GeneBench-Pro היא ניתוח מדעי העומד בפני עצמו. הסוכנים מקבלים גישה לסביבת עבודה מבודדת ובה פרומפט קצר, קובצי נתונים ומערך כלי ביואינפורמטיקה סטנדרטי, הכולל Python, ספריות לחישוב מדעי וחבילות גנומיקה בסיסיות כמו PLINK 2.0 (אף שהבעיות אינן מחייבות כלים ייעודיים לתחום).
מכיוון שאנחנו שולטים בכל תהליך יצירת הנתונים, אפשר לבדוק נכונות באופן דטרמיניסטי מול יעדים ידועים, ולהימנע מהשונות הנובעת מבחירת מודל ומהשפעות של אריכות התשובה, המאפיינות הערכה רגילה המבוססת על מחוון.
לכל בעיה מצורפים גם מטא-נתונים עשירים, ובהם מבנה הניתוח המיועד, קובצי נתונים, מקרה בוחן מפורט בן כמה עמודים ותוצאות סקירת המומחים. אנחנו מפרסמים 10 שאלות מייצגות של GeneBench-Pro בקוד פתוח מלא ב-Hugging Face(נפתח בחלון חדש), לצד ממשק אינטרנט אינטראקטיבי לעיון בהן. לבסוף, בעתיד הקרוב נעביר ל-Artificial Analysis(נפתח בחלון חדש) מקבץ של 50 שאלות, לצורך הערכה עצמאית בידי צד שלישי.
המודל החזק ביותר שלנו בעת הבדיקה, GPT‑5.6 Sol, מגיע לשיעור הצלחה של 28.7% ברמת ה-reasoning הגבוהה ביותר (31.5% כאשר מצב Pro מופעל). זו עלייה חדה לעומת התקופה שבה התחלנו לבנות את GeneBench המקורי: אז, מודל החזית הטוב ביותר שלנו, GPT‑5, השיג ציון נמוך מ-5%. ההתקדמות במבחן הזה מצביעה על שיפור מהיר במודלי חזית, גם ב-reasoning מדעי ברמה מערכתית, שקשה יותר להגדיר במונחים מוחשיים. בקצב הנוכחי, ייתכן שעד סוף השנה ימוצה האתגר שמציב מבחן ההערכה הזה.
התוצאות מראות גם את השפעתה של הגדלת משאבי החישוב בזמן המבחן. ברמת ה-reasoning הנמוכה ביותר, GPT‑5.6 Sol משיג שיעור הצלחה חד-ספרתי בלבד. ברמת ה-reasoning הגבוהה ביותר, GPT‑5.6 Sol פותר כמעט פי שישה שאלות מ-GPT‑5.2, תוך שימוש בכשני שלישים ממספר הטוקנים.
השוואות בין משפחות מודלים מצביעות על כך שמודלי GPT נמנים עם המערכות החזקות ביותר ב-reasoning מדעי ברמה גבוהה בתנאי אי-ודאות כמותית. פער הביצועים בין GPT‑5.6 ו-GPT‑5.5 לבין מודלים מובילים בקוד פתוח, כמו GLM 5.2, גדול משמעותית מהצפוי לפי מבחני הערכה בתכנות(נפתח בחלון חדש). הדבר מצביע על כך שמודלים בקוד פתוח מתמחים יותר בתכנות מאשר ביכולת reasoning רחבה.
במהלך הפיתוח השתמשנו במודלי חזית ממשפחת GPT כדי להעריך את הבעיות ולחזק את עמידותן. לכן חשדנו ש-GeneBench-Pro עשוי להיות מוטה לרעת מודלי GPT בהשוואה למשפחות מודלים אחרות. עם זאת, מודלים מתחרים השתוו לכל היותר לביצועי מודל ה-GPT המקביל בעת השקתם, ולרוב היו נמוכים מהם במידה ניכרת.
תוצאות ההערכה האלה — עד 31.5% ב-GPT‑5.6 Sol (Pro) — מרשימות בהתחשב בקושי של שאלות GeneBench-Pro. בסקר שערכנו, הסוקרים העריכו שפתרון בעיית GeneBench-Pro טיפוסית ידרוש ממומחה אנושי כ-20–40 שעות. לפי הערכה שמרנית של 200 דולר לשעה, עלות העבודה האנושית לפתרון בעיה אחת מגיעה לאלפי דולרים. סוכני הבינה המלאכותית הנוכחיים עדיין אינם אמינים מספיק כדי להחליף מומחים אנושיים, אבל פער העלויות גדול: עלות ההרצה היא דולרים בודדים בלבד לבעיה. כלומר, גם אוטומציה חלקית ביכולות הקיימות עשויה ליצור ערך כלכלי ומדעי משמעותי.
“מבחני ההערכה נובעים ממגוון רחב של שאלות ביולוגיות, אבל … האתגר האמיתי הוא ניתוח נתונים חקרני והסקת מסקנות מהממצאים: זיהוי דפוסים וארטיפקטים והחלטה אם יש להסיר נתונים או לתקן אותם. זה דומה לאופי הלא-מסודר של מערכי נתונים ביולוגיים אמיתיים. סקירת ההערכות האלה מדגישה עד כמה חשוב להגדיר בבירור את כללי המשימה עבור הסוכן הפותר, כשמשתמשים בסוכנים לפתרון בעיות מדעיות. שינוי בניסוח הפרומפט או בהגדרת המשימה עשוי להשפיע מאוד על סוגי הניתוחים שנראים מותרים.”
“אהבתי את רוב [השאלות]. לרוב הן שילבו: (1) ידע נדרש בתחום, כמו הטיית C>T בדנ״א עתיק, (2) אי-התאמות בנתונים, כמו החלפה בין שיוכי מוצא, (3) היכרות עם כלי הניתוח המתאימים למשימה וידע כיצד ליישם אותם. נראה שרוב הסוכנים נכשלו בסעיף (2). הם לא זהירים מספיק בכל הנוגע לבעיות בנתונים. אולי זה מצביע על חולשה של המודלים הנוכחיים. ובנתונים ביולוגיים רבים יש חריגות.”
ובכל זאת, העובדה שמודלי חזית עדיין פותרים פחות משליש מהבעיות האלה מעידה שנותר מקום ניכר לשיפור. מודלים מסוגלים להתקדם חלקית בבעיות מאתגרות, אך מתקשים להשלים את תהליך הסקת המסקנות. דפוס הכשל הזה דומה לפער בין מומחים אנושיים למתחילים. מומחים נעזרים בניסיונם כדי למסגר את הבעיה ולהתאים את גישתם, ואילו מתחילים מזהים ממצאים אך מתקשים לשלבם בהקשר הרחב של הבעיה.
כדי להגיע לביצועים כמעט מושלמים, יידרשו הערכות שגם מודדות התקדמות באופן אמין וגם מזהות היכן המודלים עדיין נכשלים. מבחני הערכה כמו GeneBench-Pro יכולים להפוך חולשה עמומה ביכולות לדבר שאפשר לאבחן ולשפר.
אם סוכנים יוכלו לבצע באופן אוטומטי ואמין ניתוחים מהסוג הזה, הם עשויים להאיץ משמעותית את קצב הגילוי המדעי. ראיות גנטיות בבני אדם כבר ממלאות תפקיד מרכזי בתעדוף מטרות טיפוליות ובמחקרי המשך תרגומיים, משום שלמנגנונים הנתמכים בראיות גנטיות יש סיכוי גבוה בהרבה להוביל לטיפולים מאושרים.
במקביל, עלויות הריצוף צנחו, ומערכי נתונים בהיקף של בנקים ביולוגיים מקשרים כיום בין מידע מולקולרי, פנוטיפי ורשומות רפואיות בהיקף חסר תקדים. הגורם המגביל עובר מהפקת נתונים להפיכת המידע לתובנות שאפשר לפעול לפיהן. מודלים שיוכלו לבצע בעקביות ניתוחים שכיום נעשים בידי צוותי מומחים אנושיים עשויים לחולל שינוי במחקר בתעשייה: להאיץ סינון השערות, מחקרי המשך על מטרות טיפוליות ואת מחזורי העבודה שבין הפקת נתונים לקבלת החלטות.
GeneBench-Pro הוא ניסיון ראשוני להעריך את המיומנויות המופשטות יותר שבבסיס שיקול הדעת המדעי הטוב של חוקרים מנוסים. מיומנויות אלה מאפשרות להם לזהות, גם מתוך אינטואיציה, את הניתוחים הראשוניים המבטיחים ביותר, לבחון ולעדכן את חשיבתם כשהנתונים סותרים הנחות מוקדמות, ולהגיע למסקנות שעשויות לשמש בסיס להחלטות קליניות, אקדמיות או עסקיות בהמשך.
אנחנו צופים שככל שיכולות המודלים יתקדמו, מבחני הערכה הבוחנים יכולות ברמות ההפשטה הגבוהות האלה יהיו שימושיים יותר ויותר, מעבר למבחנים שבודקים רק ידע עיוני או יכולת לבצע ניתוחים שגרתיים.