Le rôle d’ingénieur déployé sur le terrain (FDE) chez OpenAI
Notre mission, nos méthodes et notre façon de résoudre les défis majeurs des entreprises pour un impact concret.
Par Colin Jarvis, responsable de l’ingénierie déployée sur le terrain chez OpenAI
À la sortie de Codex, quelqu’un dans l’équipe m’a demandé : « Que fait-on lorsque Codex peut réaliser en une seule étape les cas d’usage que nous avons mis des mois à construire ? »
Cette question touche au cœur du rôle d’ingénieur déployé sur le terrain (FDE) chez OpenAI. Nous travaillons aux côtés des clients pour comprendre leurs problèmes les plus difficiles et construire des solutions sur lesquelles ils peuvent compter. Ce que nous apprenons contribue à façonner nos produits et donne à l’équipe de recherche des problèmes concrets à résoudre.
C’est cela, le progrès. Si nous nous rendons obsolètes tous les deux mois, c’est que notre équipe d’ingénieurs déployés sur le terrain (FDE) fait son travail.
J’ai fondé l’équipe début 2025 pour combler ce que nous appelons « le fossé du déploiement » : l’écart entre ce dont les modèles semblent capables et ce que les gens peuvent utiliser de manière fiable pour faire leur travail.
Les capacités des modèles ont évolué plus vite que les systèmes et les processus nécessaires pour les exploiter. Parfois, la pièce manquante est un produit. Parfois, un modèle obtient de bons résultats sur un benchmark, mais ne peut pas accomplir la tâche face aux variables et aux contraintes du monde réel.
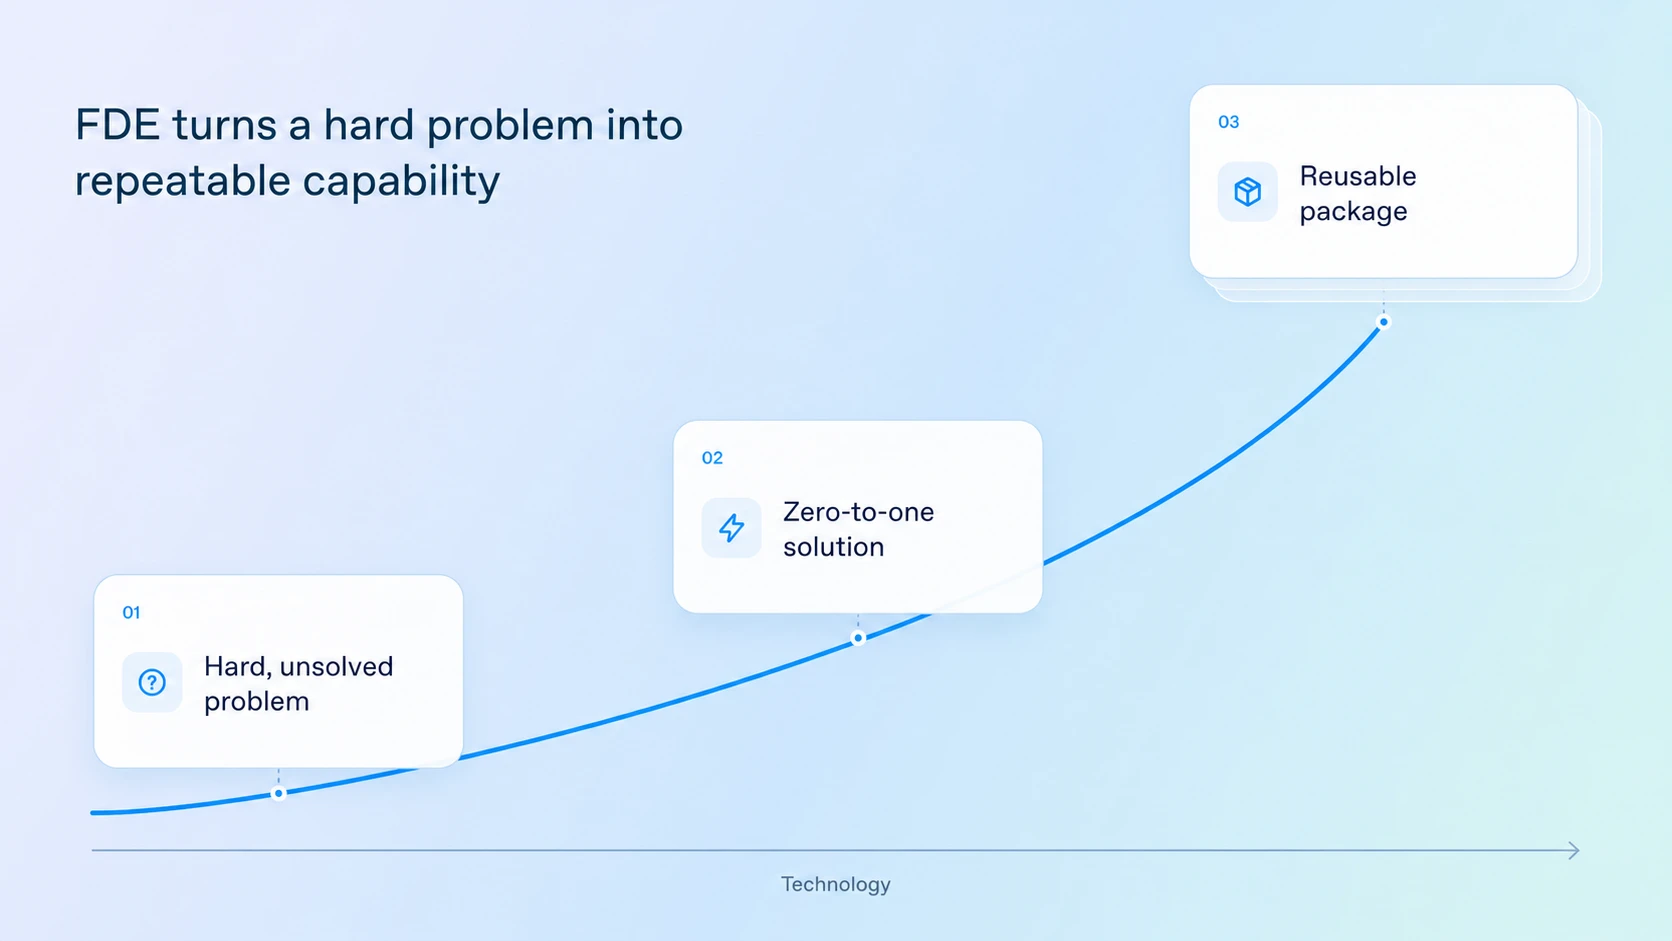
Nous nous concentrons sur les problèmes les plus difficiles de nos clients. Lorsque nos modèles sont déjà à la hauteur de la tâche, nous travaillons avec l’équipe produit et notre client pour rendre la solution reproductible. Lorsqu’ils ne le sont pas, nous collaborons avec les clients et l’équipe de recherche pour cerner les lacunes et apporter des améliorations. Notre objectif est que chaque mission offre un meilleur point de départ au client suivant. Si nous élevons le niveau de base au point que nos clients n’ont plus besoin d’ingénieurs déployés sur le terrain (FDE) pour résoudre ce type de problème la fois suivante, nous avons bien fait notre travail.
Pour John Deere, entreprise agricole vieille de 200 ans, le défi était de proposer des conseils personnalisés aux agriculteurs à grande échelle.
See & Spray en est un exemple : cette technologie de désherbage de précision utilise des caméras et l’apprentissage automatique pour identifier et pulvériser les mauvaises herbes plutôt que de traiter des champs entiers, réduisant ainsi l’utilisation de produits chimiques jusqu’à 70 %.
Mais pour en tirer ces bénéfices, les agriculteurs doivent savoir configurer la technologie, planifier leur saison et adapter leurs pratiques à l’évolution des conditions.
John Deere a déployé les API d’OpenAI pour rendre cet accompagnement personnalisé et accessible à grande échelle.
L’IA peut répondre aux questions des agriculteurs en langage naturel, fournir des conseils de configuration et des recommandations sur mesure, repérer les équipements qui n’exploitent pas tout leur potentiel et aider les agriculteurs à comprendre la valeur qu’ils tirent de cette technologie.
Le potentiel va bien au-delà d’une interaction isolée : fournir des conseils pertinents tout au long du parcours client, pour aider les agriculteurs à mieux utiliser leurs équipements tout en améliorant leur efficacité et leur durabilité.
C’est le type de défi que les ingénieurs déployés sur le terrain (FDE) d’OpenAI s’efforcent de relever : aider les organisations à transformer les capacités de l’IA en systèmes apportant une valeur concrète dans des environnements réels et complexes.
Mais les problèmes sont souvent très ouverts, il n’existe pas toujours de vérité de référence établie, ni de marche à suivre. Tout le monde veut construire quelque chose qui n’a jamais existé. Moins de gens veulent faire le nécessaire pour y parvenir.
Trouver des ingénieurs déployés sur le terrain (FDE) talentueux tout en relevant le seuil du « suffisamment bon » a exigé une expérimentation et une mise en pratique constantes.
Au début de chaque réunion de l’équipe d’ingénieurs déployés sur le terrain (FDE), j’affiche une diapositive avec un principe fondamental : « Partez du résultat, faites le nécessaire pour réussir, puis passez à l’échelle ».
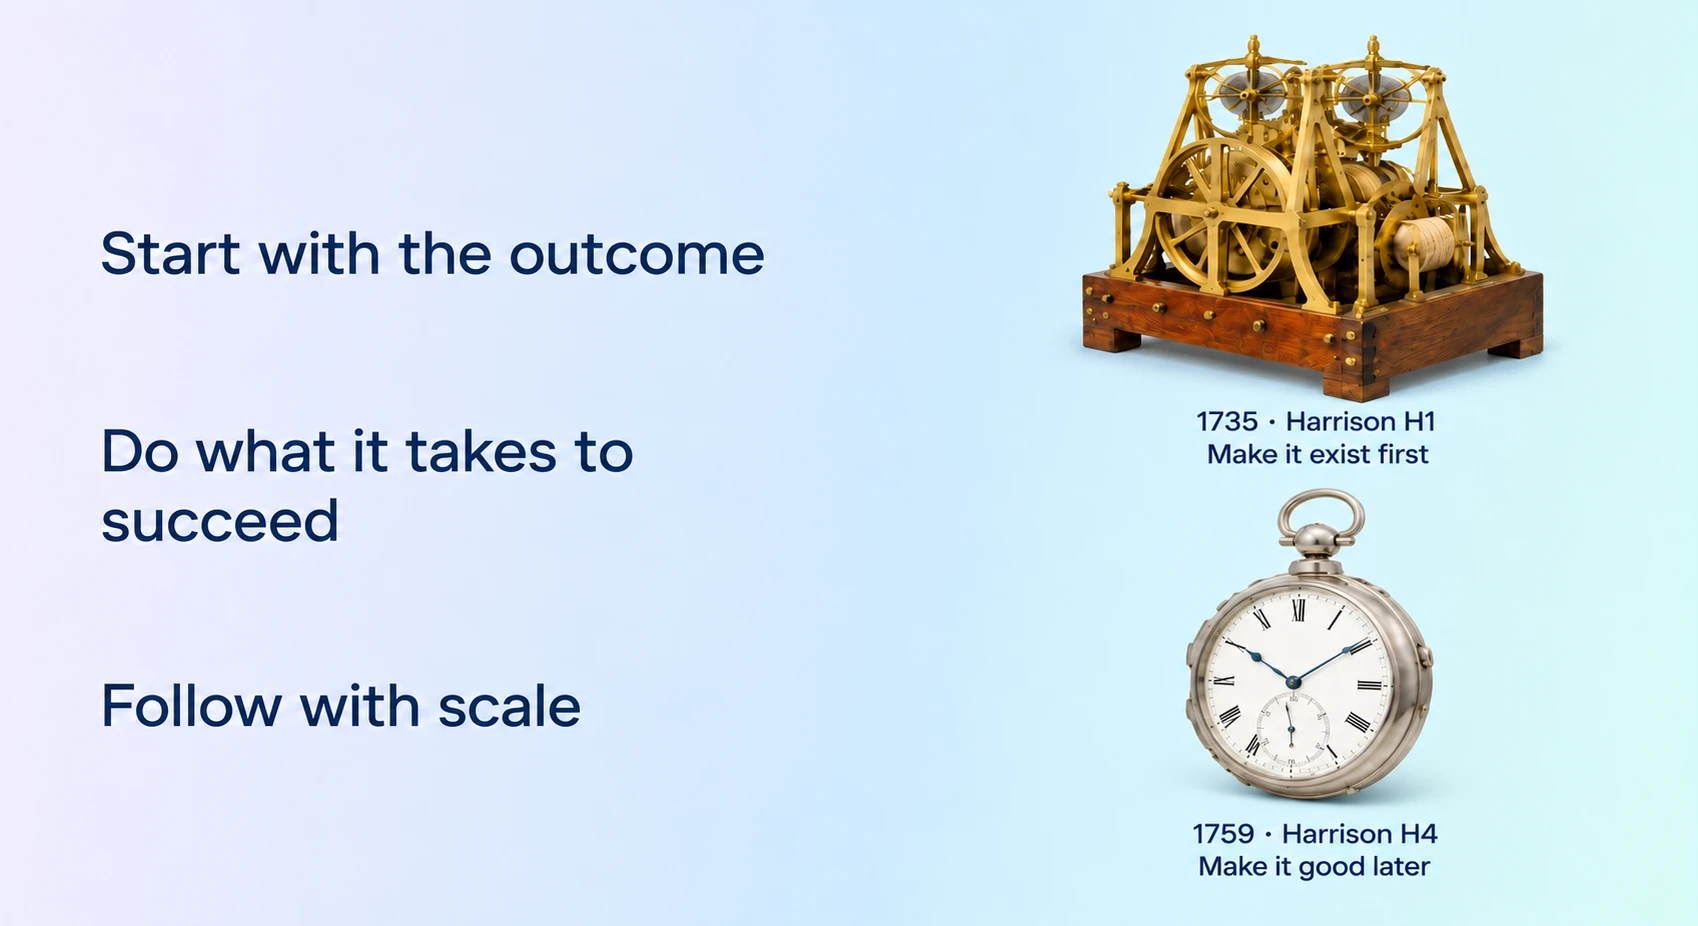
Une démo impressionnante peut faire beaucoup de chemin avant que quelqu’un demande si elle fonctionne dans le monde réel.
Notre travail consiste à résoudre le problème du client avec un niveau de qualité que nous pouvons garantir en production.
Mi-2025, une quinzaine de nos ingénieurs déployés sur le terrain (FDE) travaillaient avec un grand acteur des semi-conducteurs sur plus de dix cas d’usage. L’ambition était de repenser son processus de vérification autour de l’IA, en couvrant :
La génération de tests dirigés
L’analyse des causes racines et le débogage
Un assistant d’architecture
Dans ce secteur, la vérification peut représenter environ 70 % du travail consacré à un projet. Le potentiel était immense et les points de départ possibles, nombreux.
Certains ingénieurs déployés sur le terrain (FDE) avaient rejoint OpenAI quelques jours auparavant et n’avaient jamais travaillé dans les semi-conducteurs. Ils se sont intégrés à l’équipe de vérification du client, ont étudié la conception de puces sur leur temps libre et ont élaboré des évaluations avec les ingénieurs pour tester si l’IA pouvait générer des tests utiles et diagnostiquer correctement les défaillances des puces.
En parallèle de cet apprentissage, nous avons construit des harnais sur mesure pour chaque cas d’usage. Au cours des trois à six premiers mois, tous ont été mis en production et adoptés par de premiers utilisateurs. La récompense a été de découvrir les chiffres :
Environ 48 % de temps gagné grâce à la génération de tests dirigés par l’IA.
Une amélioration médiane des performances de 22 % grâce à l’optimisation des kernels.
Des semaines de débogage réduites à quelques heures
Lorsque nous avons présenté ces résultats, le directeur du matériel nous a demandé : « Vous travailliez dans la conception de puces avant de venir ici ? »
Nos ingénieurs déployés sur le terrain (FDE) n’ont pas besoin de connaître le secteur dès le premier jour, mais il leur incombe de l’apprendre.
À mesure que les assistants de programmation accélèrent la création de logiciels, comprendre l’activité du client devient encore plus important. Nous constituons des équipes mêlant généralistes et experts métier.
Il faut assez de connaissances pour porter un jugement éclairé, et assez de curiosité pour remettre en question les idées reçues sur les pratiques actuelles.
Dans les sciences de la vie, par exemple, la formation scientifique de nos ingénieurs déployés sur le terrain (FDE) les aide à gagner la confiance des chercheurs qui travaillent sur la découverte préclinique de médicaments : validation et hiérarchisation des cibles, analyse de l’expression génique ou reconstitution de voies de synthèse chimique. Cette expertise leur permet de porter un regard éclairé sur les améliorations possibles de ces workflows.
Nous avions montré que ces workflows pouvaient apporter de la valeur, mais chacun exigeait encore trop d’intégration sur mesure pour être étendu à une autre équipe. Le défi suivant était de préserver ces résultats tout en rendant le logiciel plus facile à déployer et à maintenir.
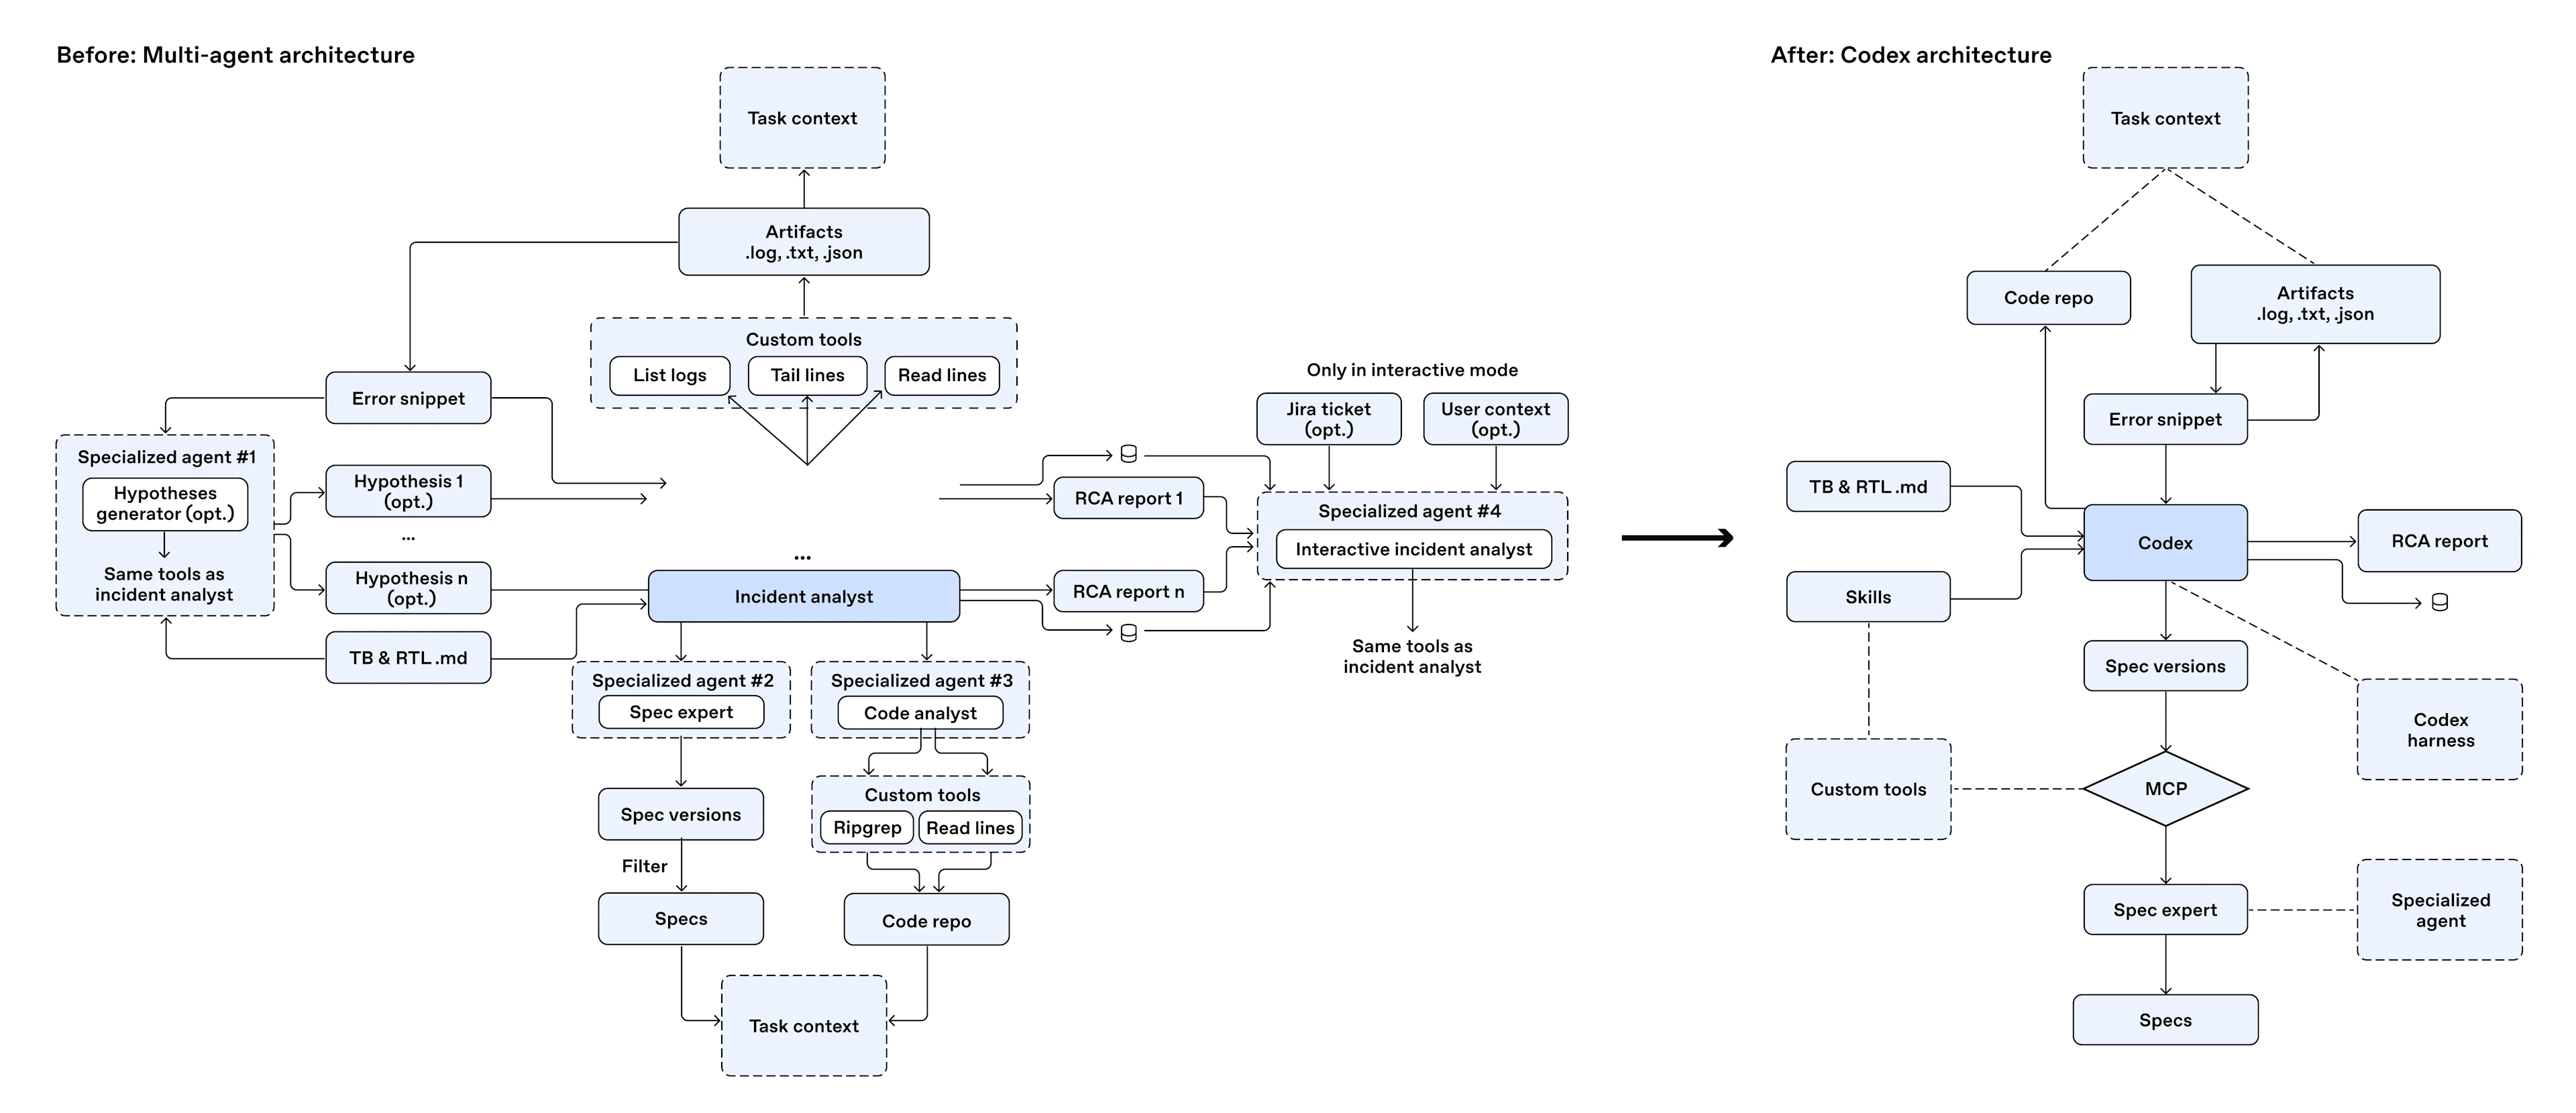
Entre-temps, Codex avait gagné en capacités. Un ingénieur déployé sur le terrain (FDE) a tenté de reconstruire son application autour de Codex, puis a travaillé avec l’équipe pour migrer les cas d’usage vers un harnais commun centré sur Codex.
Les applications sur mesure sont devenues des plugins et des compétences reposant sur des primitives Codex communes. Codex est aussi devenu l’interface, ce qui nous a permis d’abandonner les interfaces de terminal et de ligne de commande distinctes que nous avions écrites pour chaque cas d’usage.
Nous avons pu supprimer environ 90 % du code sur mesure de chaque projet, ce qui a changé notre façon de construire, de maintenir et de déployer ces workflows à grande échelle :
Nous pouvions bénéficier des améliorations centralisées de Codex, réduisant ainsi la quantité de code de liaison nécessaire à chaque cas d’usage
Les fonctionnalités clés ont été regroupées en compétences et en plugins, plus faciles à partager entre équipes et à piloter de façon centralisée par le centre d’excellence en IA. Étendre la solution à une autre équipe pouvait donc se résumer à remplacer les connecteurs ou serveurs MCP, à créer de nouvelles évaluations — pour lesquelles nous avions aussi une compétence — puis à démarrer.
Dans un exemple d’août 2026, le déploiement initial a pris deux mois. Étendre la solution à une deuxième équipe a pris une journée. Les équipes suivantes ont été intégrées plus rapidement à mesure du passage à l’échelle. Cette tendance s’est confirmée : pour un cas d’usage en août 2026, l’intégration de la deuxième équipe a pris un jour, contre deux mois pour le déploiement initial.
C’est une façon de nous rendre obsolètes. Le travail accompli pour atteindre la production avait permis d’établir ce qui comptait. À mesure que le produit sous-jacent s’améliorait, nous pouvions remplacer une grande partie de notre implémentation sur mesure tout en conservant la valeur qu’elle apportait.
C’est pourquoi l’ordre compte. Les LLM nous permettent de construire vite. Utilisez cette rapidité pour mettre quelque chose d’utile entre les mains des utilisateurs, apprendre ce qui tient la route en pratique, puis déployer à grande échelle ce qui fonctionne.
Le même principe s’applique à toutes nos missions.
OpenAI Presence, notre produit pour les agents vocaux et de chat d’entreprise, est né de véritables déploiements clients. L’œuvre a commencé avec Swarm(ouverture dans une nouvelle fenêtre) et a évolué à travers le Agents API, et aujourd’hui un client gère désormais plus de la moitié de ses appels avec l’IA.
Mettre ces déploiements en production nous a appris quels problèmes nécessitaient une solution personnalisée et quels éléments de base les autres équipes pouvaient utiliser. Nous avons intégré ces éléments de base à Presence, facilitant ainsi l’automatisation des flux de travail régulés par les développeurs sans reconstruire l’infrastructure sous-jacente. Chaque déploiement a contribué à façonner le produit et a offert au client suivant un meilleur point de départ.
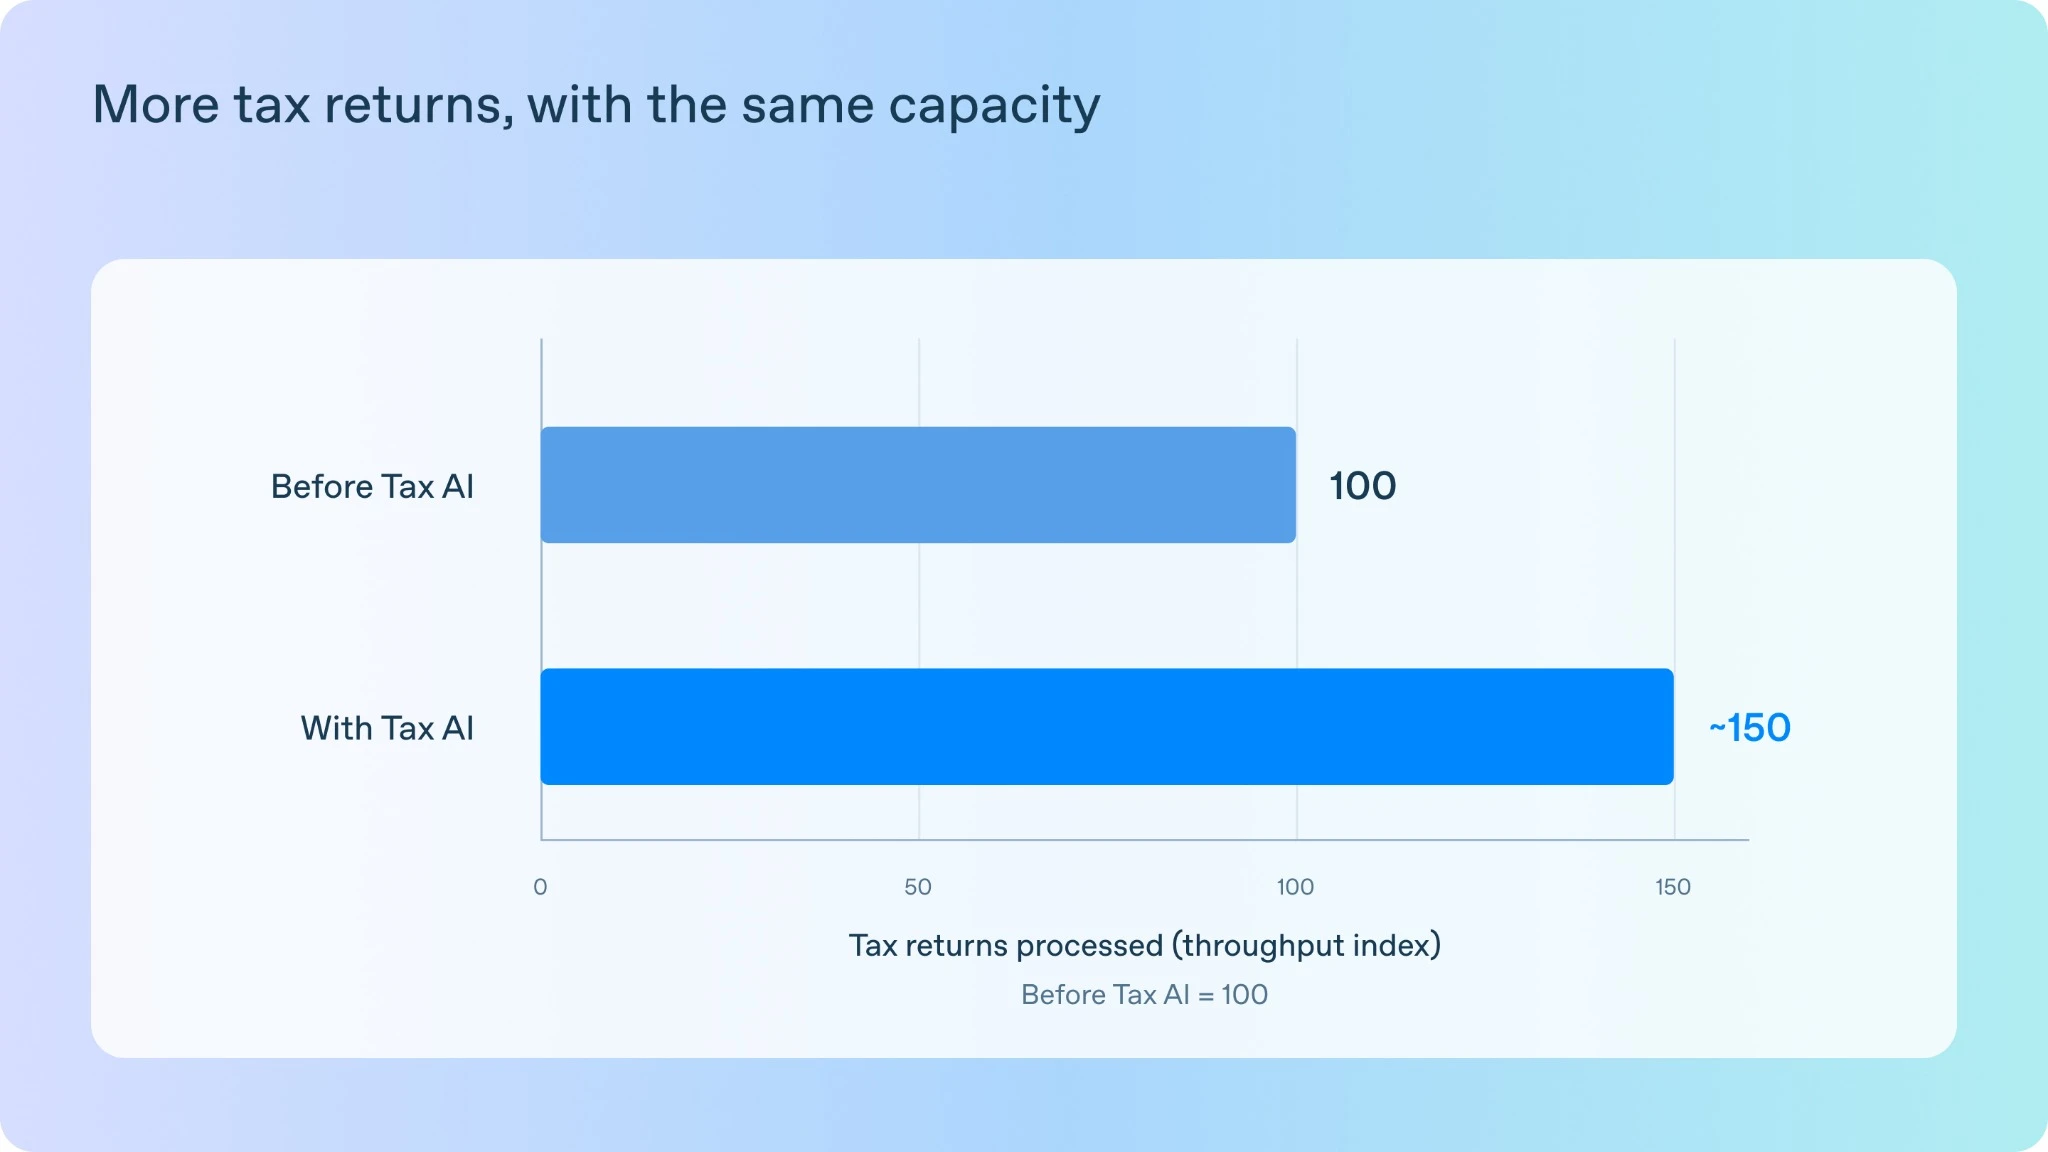
Avec Thrive Holdings, les FDE OpenAI et des chercheurs ont travaillé aux côtés d’ingénieurs et de comptables pour développer Tax AI pour les cabinets comptables de Crete. Au cours de son projet pilote, Tax AI a traité 7 000 déclarations fiscales et augmenté le débit d’environ 50 %.
L’un des défis les plus difficiles a été l’automatisation des déclarations de biens locatifs, ce qui a nécessité six semaines d’ingénierie et d’examen par les praticiens pour atteindre une précision et un rappel de 90 %. Ce travail a créé des schémas réutilisables qui ont facilité l’extension de Tax AI à d’autres grilles fiscales complexes.
Les équipes appliquent désormais la même approche à la tenue de livres, à l’audit et au support informatique — construisant des systèmes qui s’améliorent grâce aux retours des praticiens et à l’utilisation concrète.
Parfois, un meilleur produit nous permet de simplifier ce que nous avons construit. Mais parfois, le modèle lui-même n’est pas encore à la hauteur de la tâche.
Si nous construisons uniquement ce que les modèles actuels rendent déjà possible, nous ne découvrirons pas les lacunes d’intelligence que l’équipe de recherche devra combler ensuite. C’est pourquoi nombre de nos missions importantes commencent à ces limites, avec le client, les ingénieurs déployés sur le terrain (FDE) et l’équipe de recherche engagés à les surmonter ensemble.
Nous avions déjà développé une plateforme de service client avec un grand acteur des télécommunications, qui souhaitait l’étendre au canal vocal.
La voix représentait environ 90 % du volume de son service client. Ces demandes étaient plus coûteuses à traiter sans intervention humaine que celles du chat et posaient de nouveaux défis techniques : gérer les accents, le ton, la latence et la précision au niveau exigé en production. Réussir aurait un impact considérable sur son activité.
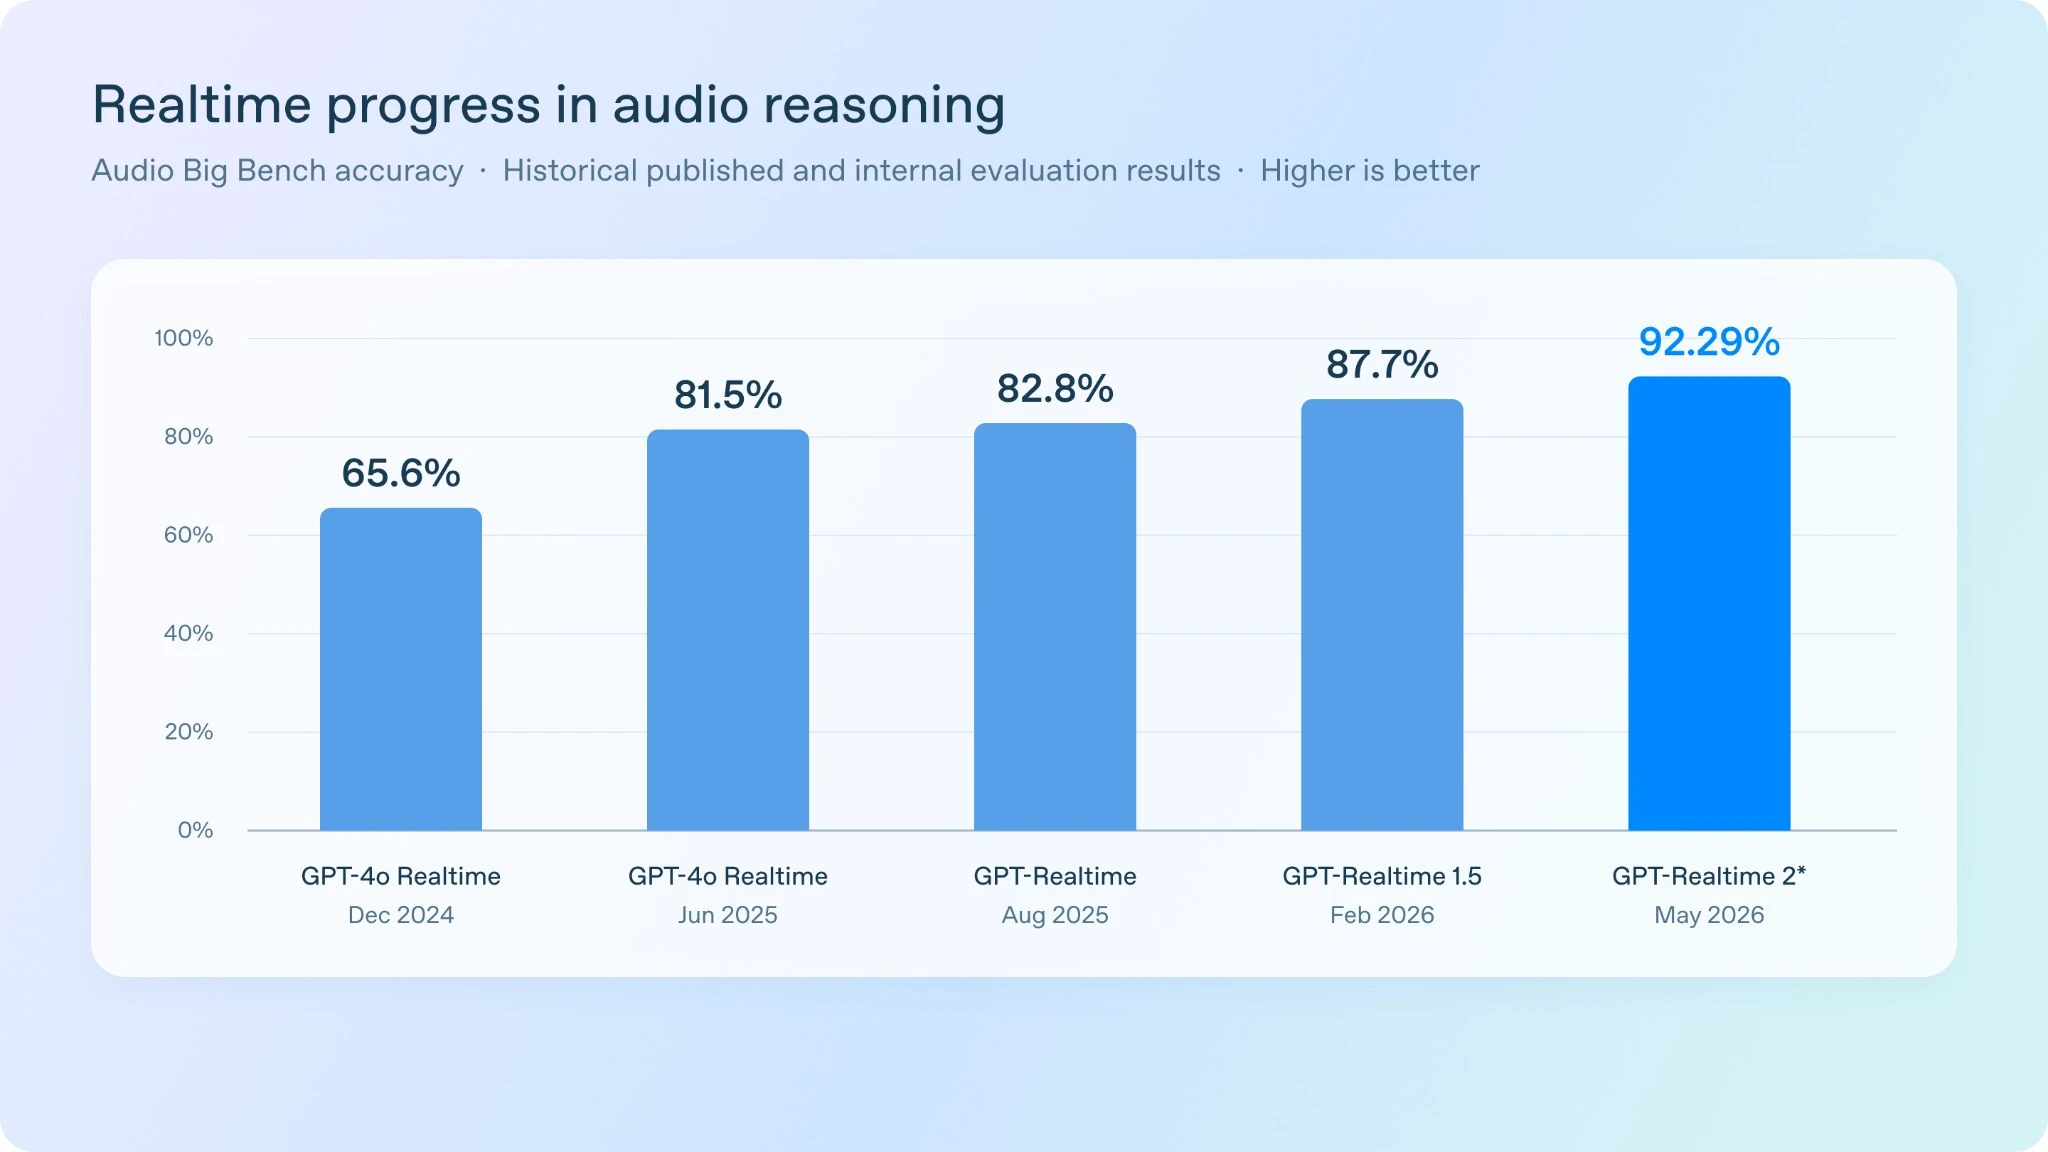
Lors du cadrage, notre modèle obtenait environ 60 % aux évaluations clés utilisées pour déterminer s’il pouvait remplir sa mission en production. Nous avions atteint les limites de ses capacités. L’appel de fonction et le suivi des instructions dans les scénarios de service client devaient être améliorés.
Nous l’avons expliqué au client et avons associé l’équipe de recherche aux travaux. Les ingénieurs déployés sur le terrain (FDE) ont travaillé avec le client pour construire la plateforme et définir ce que le modèle devait faire. L’équipe de recherche s’est employée à combler les lacunes du modèle, dont les versions successives nous permettaient de tester les progrès au regard des exigences du client.
En six mois, les performances aux évaluations clés sont passées d’environ 60 % à 80 %, puis à plus de 90 %, atteignant les niveaux requis pour la production.
Le modèle vocal ainsi obtenu est aujourd’hui utilisé dans le déploiement de ce client, dans d’autres déploiements de service client sur mesure et dans des déploiements gérés via Presence. Un problème rencontré dans l’activité d’un client a permis d’identifier des améliorations utiles à de nombreux autres.
Chaque contribution comptait. Le client s’est engagé à travailler sur un problème que le modèle ne pouvait pas encore résoudre. Les ingénieurs déployés sur le terrain (FDE) sont restés au plus près du client pour cadrer le problème, construire la plateforme et piloter la mission de bout en bout. L’équipe de recherche a amélioré les capacités du modèle sous-jacent.
C’est l’autre façon de nous rendre obsolètes : aider à transformer un problème que les modèles actuels ne peuvent pas résoudre en une capacité que les futurs modèles pourront offrir. Les retombées de notre travail vont au-delà des heures passées auprès d’un client donné.
J’ai rejoint OpenAI pour contribuer à rendre l’IA utile au quotidien dans le travail de chacun. C’est toujours ce qui guide l’équipe. Je dis souvent à l’équipe que, dans la plupart des cas de développement de LLM, le rasoir d’Ockham s’applique : la solution la plus simple est la meilleure. Dans une entreprise qui se définit par sa recherche de pointe et un secteur où les discours sont souvent excessifs, nous voulons construire des solutions fiables sur lesquelles les professionnels de terrain peuvent compter.
L’objectif est que chaque mission améliore la suite : un produit plus facile à déployer, un modèle capable de traiter une tâche plus difficile ou moins de travail sur mesure pour le client suivant.
Si vous avez un problème difficile à résoudre, nous serions ravis de travailler avec vous. Si vous souhaitez contribuer à résoudre ces problèmes, nous serions ravis de vous accueillir.
Alors, que faisons-nous lorsque Codex peut prendre en charge le travail que nous avons mis des mois à construire ?
Nous cherchons un problème plus difficile.