Terminal X : 88,6 % de concordance avec les experts sur GPT‑6.1
L’Eval Agent de Terminal X évalue les réponses selon une grille de 54 critères et détecte 25 % plus d’écarts au mandat d’un fonds avec GPT‑6.1 Sol.
25 %
Meilleur taux de détection des réponses d’agents qui s’écartent du mandat d’un fonds avec GPT‑6.1 Sol par rapport au deuxième meilleur modèle
2,4 M$
Économies annualisées d’un client sur les flux de travail de vérification diligente et d’investissement
+220 pb
Meilleur taux d’accord entre les agents et les évaluateurs humains avec GPT‑6.1 Sol par rapport au deuxième meilleur modèle
30 %
Coût par requête inférieur avec GPT‑6.1 Sol par rapport au deuxième meilleur modèle
L’avantage concurrentiel d’une société d’investissement se construit transaction après transaction, mais le jugement derrière chaque décision réside généralement dans l’esprit de quelques investisseurs chevronnés. À leur départ, la société contracte ce que Terminal X(s'ouvre dans une nouvelle fenêtre) appelle une dette mémorielle : elle conserve peut-être les documents, mais perd le raisonnement.
Le système d’exploitation Capital Memory de Terminal X est conçu pour réduire cette dette. Les ingénieurs de l’entreprise déployés chez les clients, d’anciens professionnels de la finance et de l’investissement chez JPMorgan et Blackstone, travaillent avec les équipes d’investissement de chaque client, conçoivent l’architecture agentique de la société et traduisent sa méthode d’investissement en instructions dans des agents qui lui appartiennent, déployés sur place ou dans son propre nuage.
Les modèles d’OpenAI, dont GPT‑6.1 Sol et GPT‑6 Luna, assurent le raisonnement au sein de ces agents. Et l’Eval Agent de Terminal X évalue les réponses des agents selon les normes de la société. GPT‑6.1 Sol a aidé l’Eval Agent à détecter environ 25 % plus de recommandations qui s’écartaient du mandat d’un fonds et a exécuté les mêmes flux de travail à un coût par requête inférieur d’environ 30 % à celui du deuxième meilleur modèle.
« Le raisonnement à contexte long de GPT-6.1 Sol et son efficacité en matière de tokens nous permettent de créer des chaînes d’évaluation plus approfondies. Cela aide nos Eval Agents à rendre le jugement en matière d’investissement mesurable et vérifiable. »
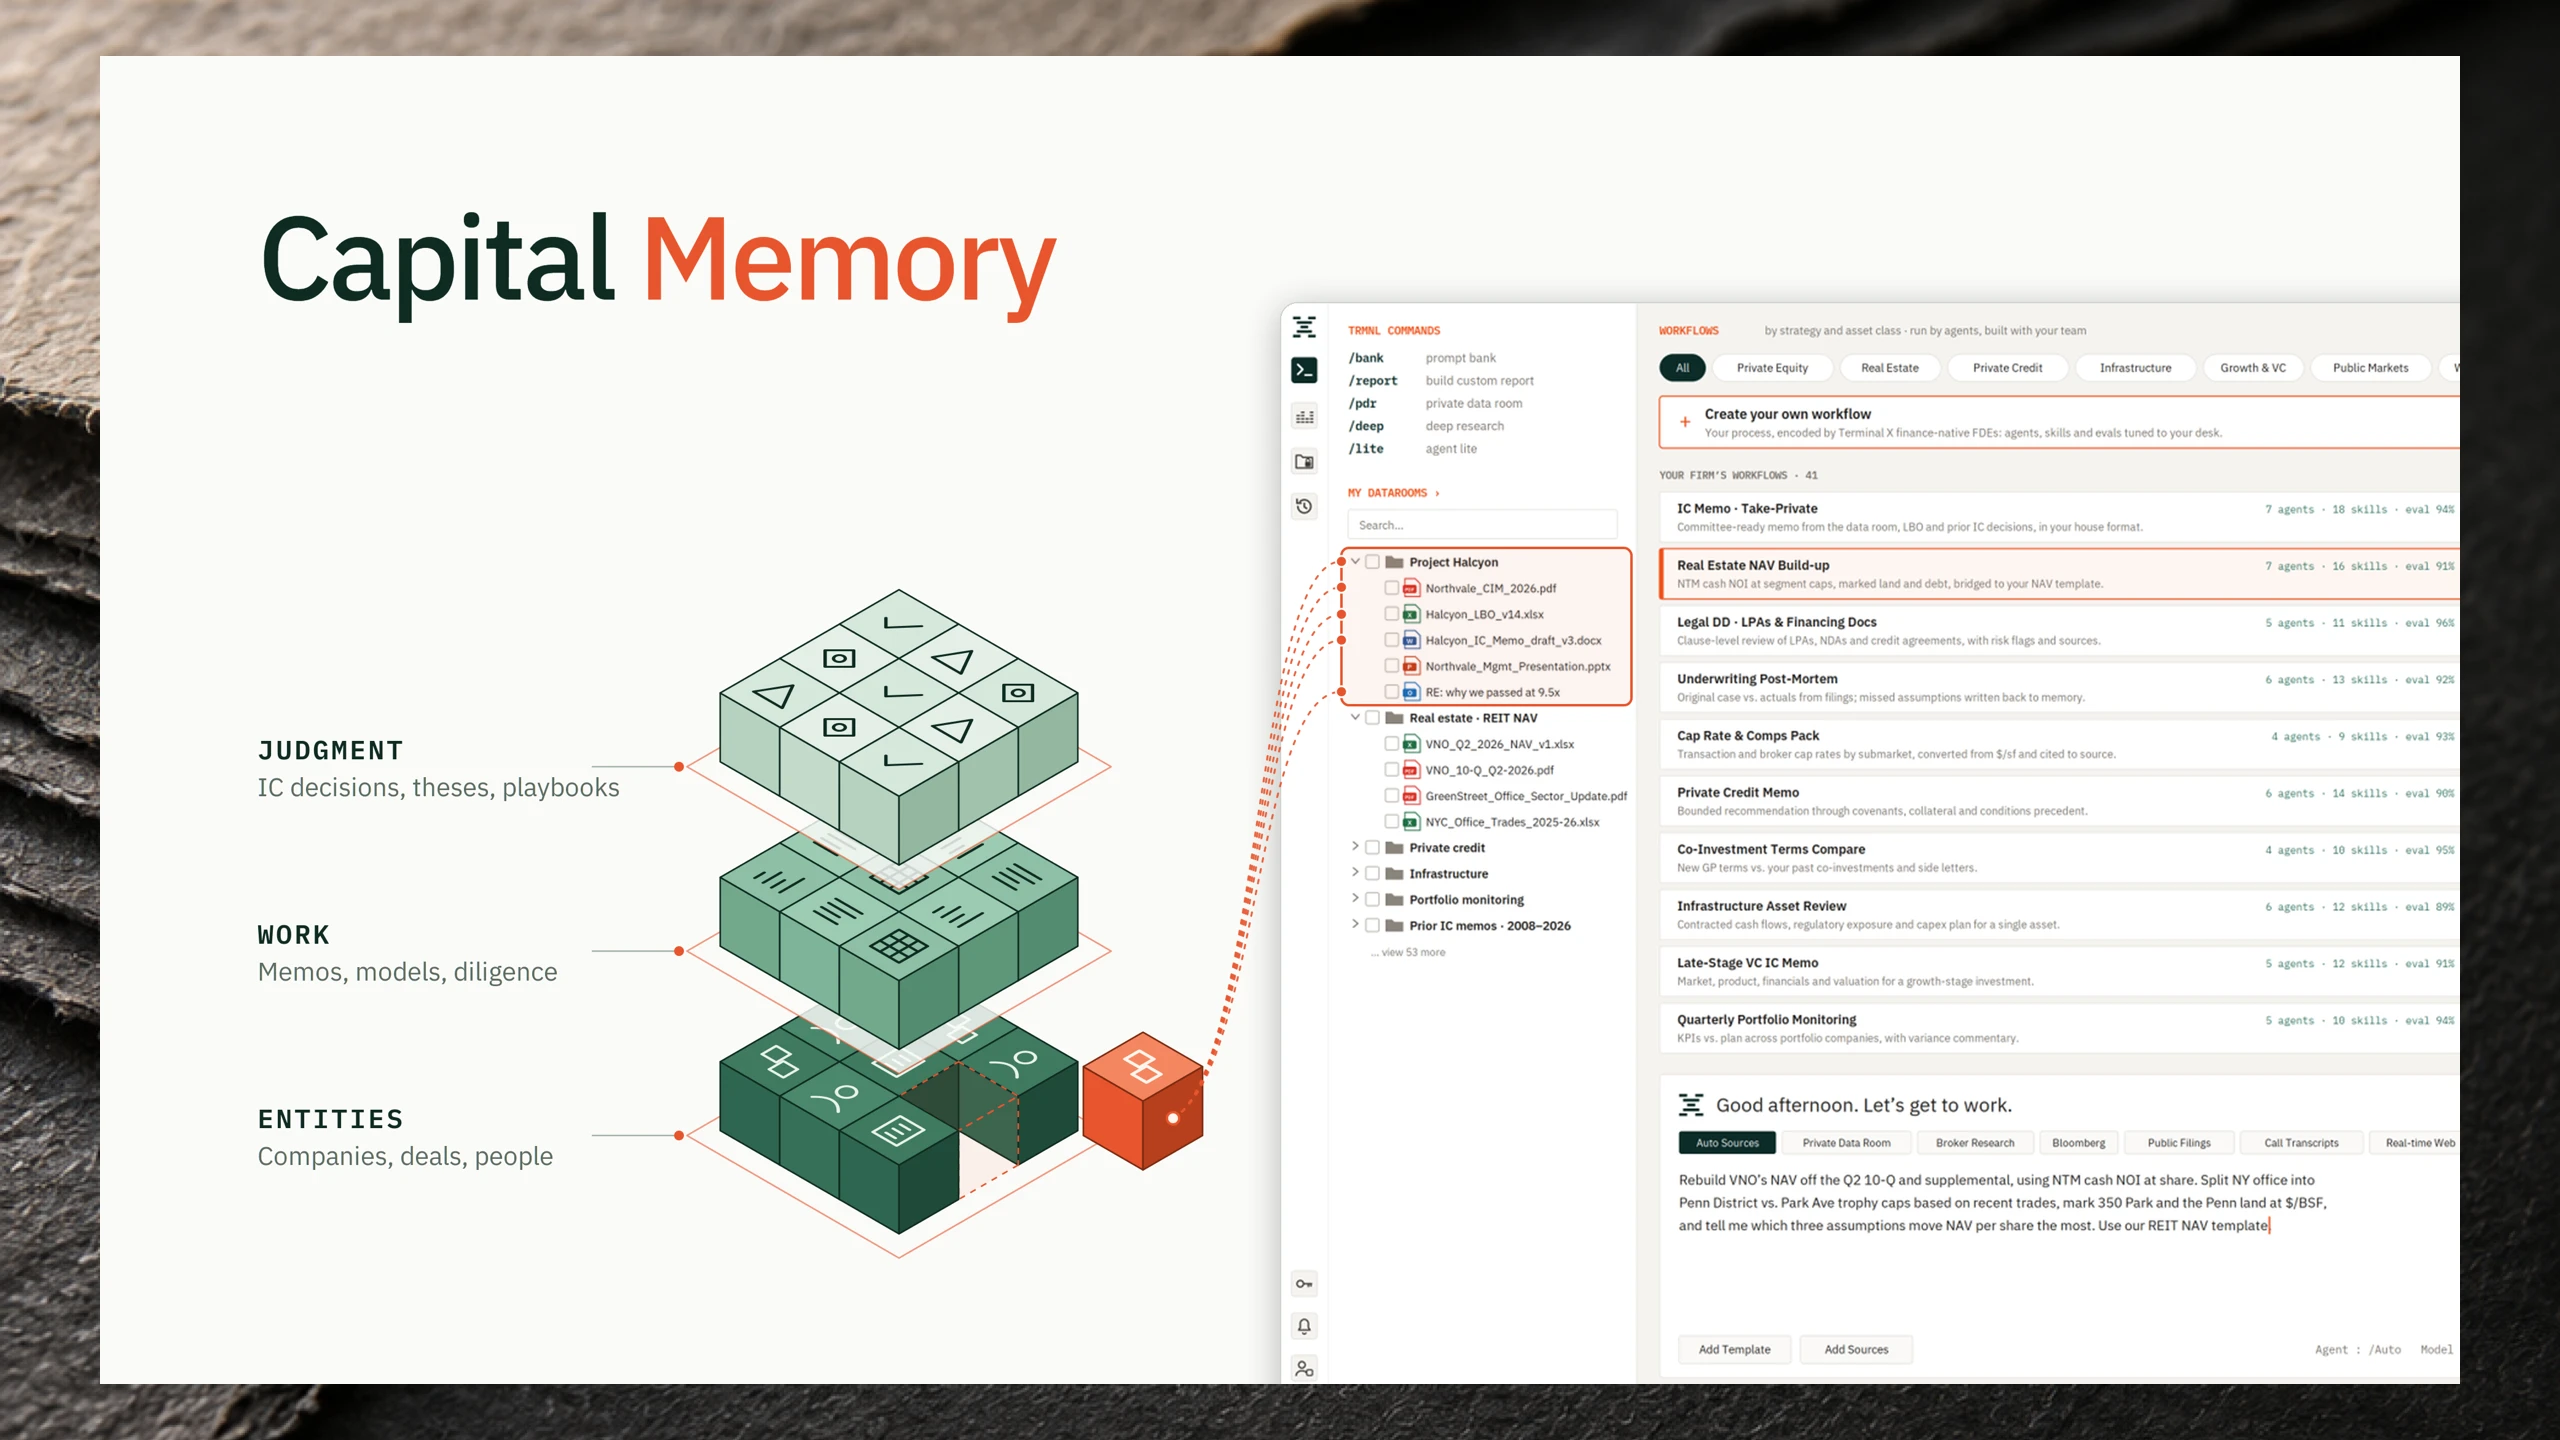
Pour chaque client, Terminal X crée des agents conçus pour investir comme les meilleurs investisseurs de la société. Les ingénieurs de Terminal X passent des semaines chez le client à décortiquer les notes de référence de la société et à consigner des processus jamais documentés, comme la façon dont l’équipe de crédit évalue un emprunteur ou les sources que l’équipe de co-investissement consulte avant de rédiger une note.
Ces processus sont ensuite encodés dans des centaines d’agents, personnalisés selon la catégorie d’actifs et la stratégie, avec des sous-agents pour chaque étape d’investissement. GPT‑6.1 Sol prend en charge les étapes qui exigent du jugement et de vastes fenêtres contextuelles : synthétiser la thèse d’investissement, cerner les facteurs clés et évaluer la conformité au mandat de la société. GPT‑6 Luna exécute les étapes à volume élevé où l’efficacité en matière de tokens compte davantage que la profondeur.
Les agents travaillent dans la salle de données privée de chaque société, un environnement dédié où les entreprises partagent et gèrent des données d’investissement sensibles. Les agents traitent des documents en anglais, en coréen, en japonais et en chinois, puis stockent leurs apprentissages dans une mémoire de la société: un registre avec suivi des versions décrivant comment une équipe prend un type de décision, y compris ses analyses passées, les décisions du comité, les instructions de flux de travail et les positions de la société.
Les ingénieurs transforment chaque mémoire en un flux de travail reproductible sur la plateforme de Terminal X, où chaque requête en production peut être auditée grâce à sa piste d'audit complète : les étapes suivies, les sources récupérées, le modèle utilisé et le raisonnement.
Selon Terminal X, cette approche permet aux clients de réaliser d’importantes économies, notamment une société de capital-investissement qui a déclaré 2,4 millions de dollars d’économies annualisées grâce à l’automatisation des flux de travail de vérification diligente et de rédaction de notes d’investissement.
Pour vérifier les réponses des agents selon les normes propres à la société, Terminal X a créé un Eval Agent. Il s’agit d’un flux de travail orchestré sur GPT‑6.1 Sol et d’autres modèles d’OpenAI, conçu pour examiner chaque réponse d’agent comme un vice-président examine le travail d’un analyste.
L’Eval Agent vérifie chaque réponse selon une grille de 54 critères. Il pose les questions suivantes : les chiffres, les comparables, les estimations consensuelles et les citations proviennent-ils des bonnes sources? L’argumentaire tient-il la route? La recommandation cadre-t-elle avec la position de la société?
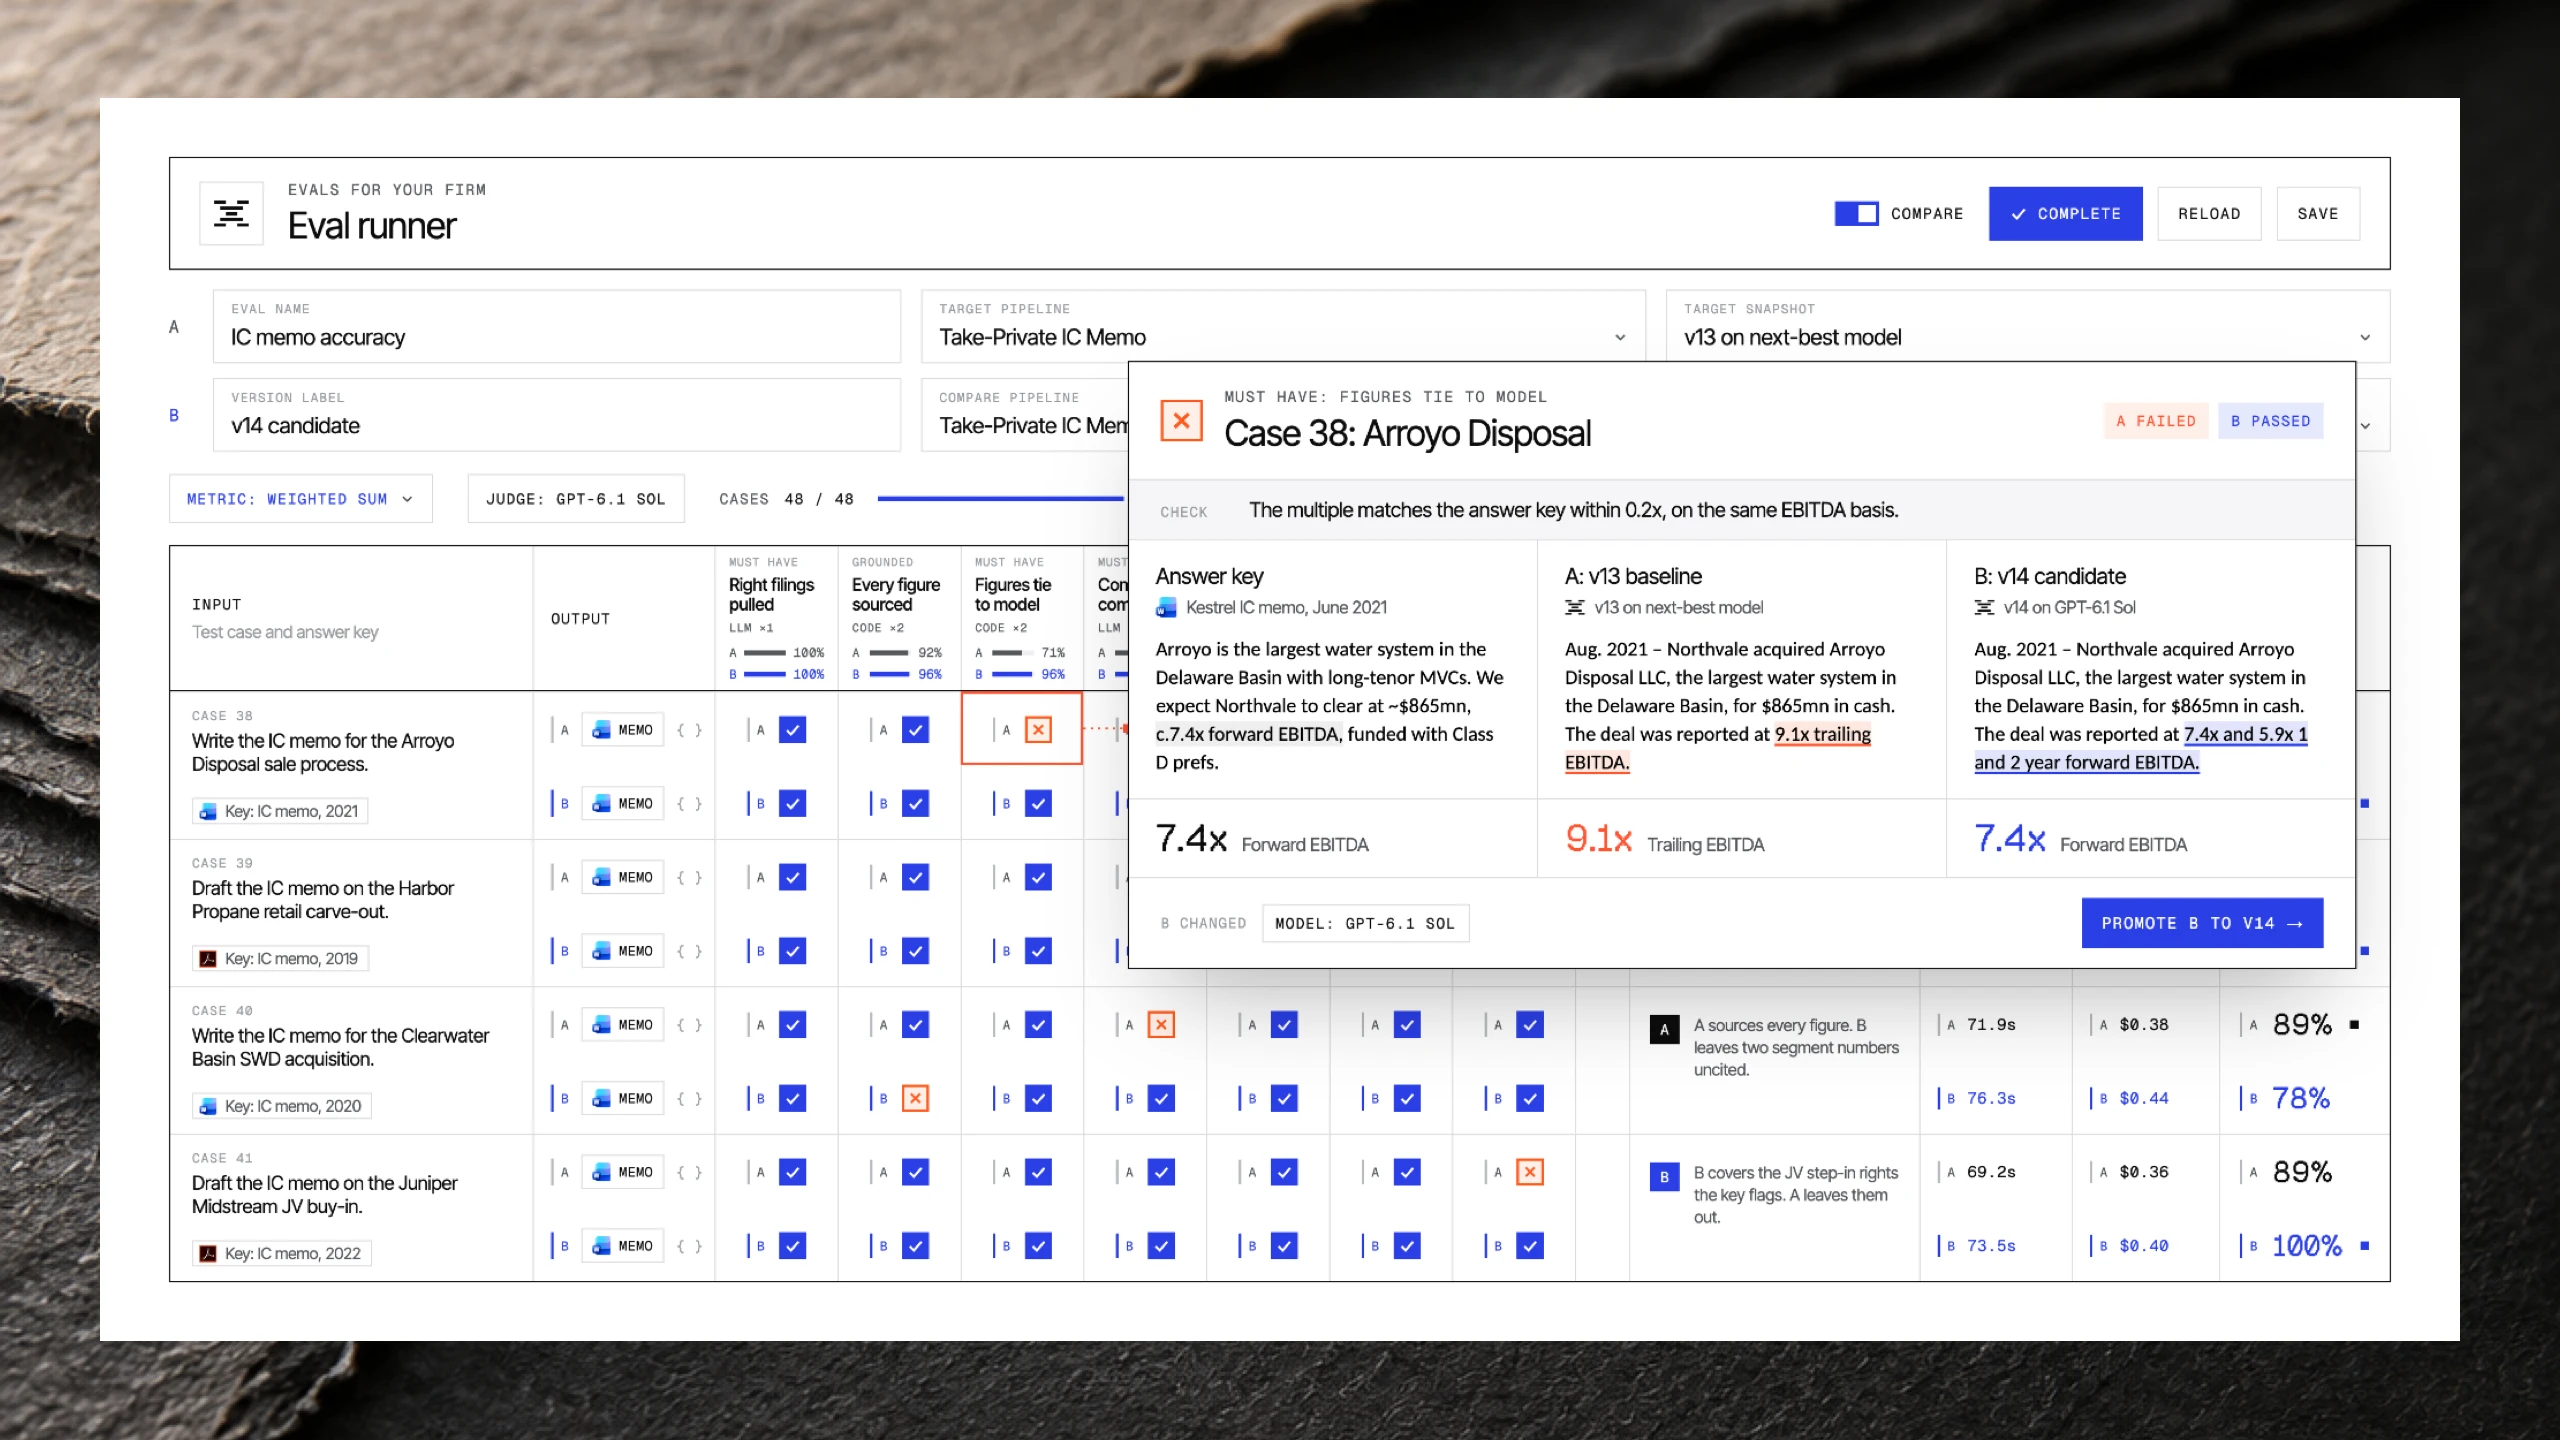
Chaque vérification se solde par une réussite ou un échec. Chaque échec comprend une justification d’une ligne et une meilleure source ou un texte corrigé, puis devient une mémoire. Par exemple, une source oubliée, un mauvais comparable ou une thèse qui s’écarte de la position de la société est encodé sous forme de nouvelle instruction de flux de travail ou de nouveau cas de test pour cette équipe.
« Chaque réponse est évaluée, et chaque correction de l’analyste en apprend un peu plus au système sur le fonctionnement de cette société », explique Ken Lee, cofondateur et chef de la technologie de Terminal X. « Donc, plus une société l’utilise longtemps, plus le système raisonne comme l’équipe de la société. »
Terminal X choisit les modèles en fonction des résultats de ses propres évaluations. Sur 500 jugements évalués, son Eval Agent utilisant GPT‑6.1 Sol était d’accord avec l’évaluateur humain chevronné dans 88,6 % des cas, contre 86,4 % pour le deuxième meilleur modèle, soit une amélioration de 220 points de base.
L'écart par rapport à la stratégie d’investissement est l’une des catégories d’erreurs où GPT‑6.1 Sol s’est démarqué. Par exemple, le mandat d’un fonds de rachat est de repérer des sociétés cotées sous leur valeur liquidative en vue de les retirer de la cote, d’évaluer la viabilité de l’investissement et de structurer le financement. Lorsque les modèles de scénarios laissent entrevoir un retournement du marché, les propositions de transactions commencent à recommander une position en dette en difficulté ou un financement de sauvetage. L’Eval Agent utilisant GPT‑6.1 Sol a détecté environ 25 % plus de ces écarts que le deuxième meilleur modèle.
L’efficacité de GPT‑6.1 Sol en matière de tokens pour les tâches à contexte long a permis à Terminal X de créer un flux de travail de révision plus approfondi sans augmenter le budget. La thèse est d’abord vérifiée par rapport au mandat du fonds, puis à ses transactions récentes. Les verdicts incertains sont réévalués, et l’agent concilie les résultats avant de produire son rapport.
Cette révision approfondie a signalé des transactions qu’un modèle comparable avait approuvées après un seul passage. GPT‑6.1 Sol a aussi exécuté les mêmes flux de travail à un coût par requête inférieur d’environ 30 % à celui du deuxième meilleur modèle, à une vitesse semblable.
Avec GPT‑6.1 Sol et GPT‑6 Luna, Terminal X a créé 1 700 mémoires de sociétés, exécuté plus d’un million de flux de travail personnalisés et atteint un nombre d’utilisateurs actifs hebdomadaires équivalant à 81 % de ses utilisateurs actifs mensuels.
La prochaine étape pour Terminal X consiste à étendre les mémoires des sociétés des équipes aux individus, afin de saisir les critères de chaque professionnel de l’investissement tels qu’il les applique, et pas seulement tels qu’il les décrit.
Pour Hyun, cofondateur et chef de la direction de Terminal X, c’est là tout l’objectif : « Les sociétés qui réussiront au cours de la prochaine décennie posséderont leur jugement sous forme de données. Notre travail consiste à rendre ce jugement mesurable pour qu’il puisse être conservé, amélioré et réutilisé. »