Terminal X: GPT‑6.1 urteilt zu 88,6 % wie erfahrene Anlageprofis
Der Eval Agent von Terminal X bewertet Ergebnisse anhand von 54 Kriterien und erkennt mit GPT‑6.1 Sol 25 % mehr Abweichungen vom Fondsmandat.
25 %
Höhere Erkennungsrate bei Agentenantworten, die vom Fondsmandat abweichen, mit GPT‑6.1 Sol gegenüber dem nächstbesten Modell
2,4 Mio. USD
Auf das Jahr hochgerechnete Einsparungen eines Kundenunternehmens bei Due-Diligence- und Investment-Workflows
+220 Basispunkte
Höhere Übereinstimmung zwischen Agenten und menschlichen Prüfpersonen mit GPT‑6.1 Sol gegenüber dem nächstbesten Modell
30 %
Geringere Kosten pro Anfrage mit GPT‑6.1 Sol gegenüber dem nächstbesten Modell
Eine Investmentgesellschaft baut ihren Wettbewerbsvorteil Transaktion für Transaktion auf. Doch die Urteilskraft hinter jeder Entscheidung steckt meist in den Köpfen weniger erfahrener Anlageprofis. Verlassen diese das Unternehmen, entsteht das, was Terminal X(wird in einem neuen Fenster geöffnet) als Wissensschuld bezeichnet: Die Dokumente bleiben der Firma womöglich erhalten, doch die Entscheidungslogik geht verloren.
Das Betriebssystem Capital Memory von Terminal X soll diese Schuld abbauen. Die forward-deployed engineers des Unternehmens haben zuvor als Finanz- und Investmentfachleute bei JPMorgan und Blackstone gearbeitet. Sie arbeiten vor Ort mit den Investmentteams der Kundenunternehmen, entwerfen deren Agentenarchitektur und bilden die jeweilige Anlagestrategie in Agenten ab. Diese gehören dem Kundenunternehmen und werden vor Ort oder in dessen eigener Cloud bereitgestellt.
OpenAI-Modelle, darunter GPT‑6.1 Sol und GPT‑6 Luna, übernehmen das Reasoning in diesen Agenten. Der Eval Agent von Terminal X bewertet die Ergebnisse der Agenten anhand der Standards des jeweiligen Unternehmens. Mit GPT‑6.1 Sol erkannte der Eval Agent rund 25 % mehr Empfehlungen, die vom Fondsmandat abwichen. Zugleich führte das Modell dieselben Workflows zu etwa 30 % geringeren Kosten pro Anfrage aus als das nächstbeste Modell.
„Das Reasoning von GPT-6.1 Sol bei langem Kontext und seine Token-Effizienz ermöglichen uns, gründlichere Evaluationspipelines zu entwickeln. Das hilft unseren Eval Agents, die Urteilskraft bei Anlageentscheidungen messbar und überprüfbar zu machen.“
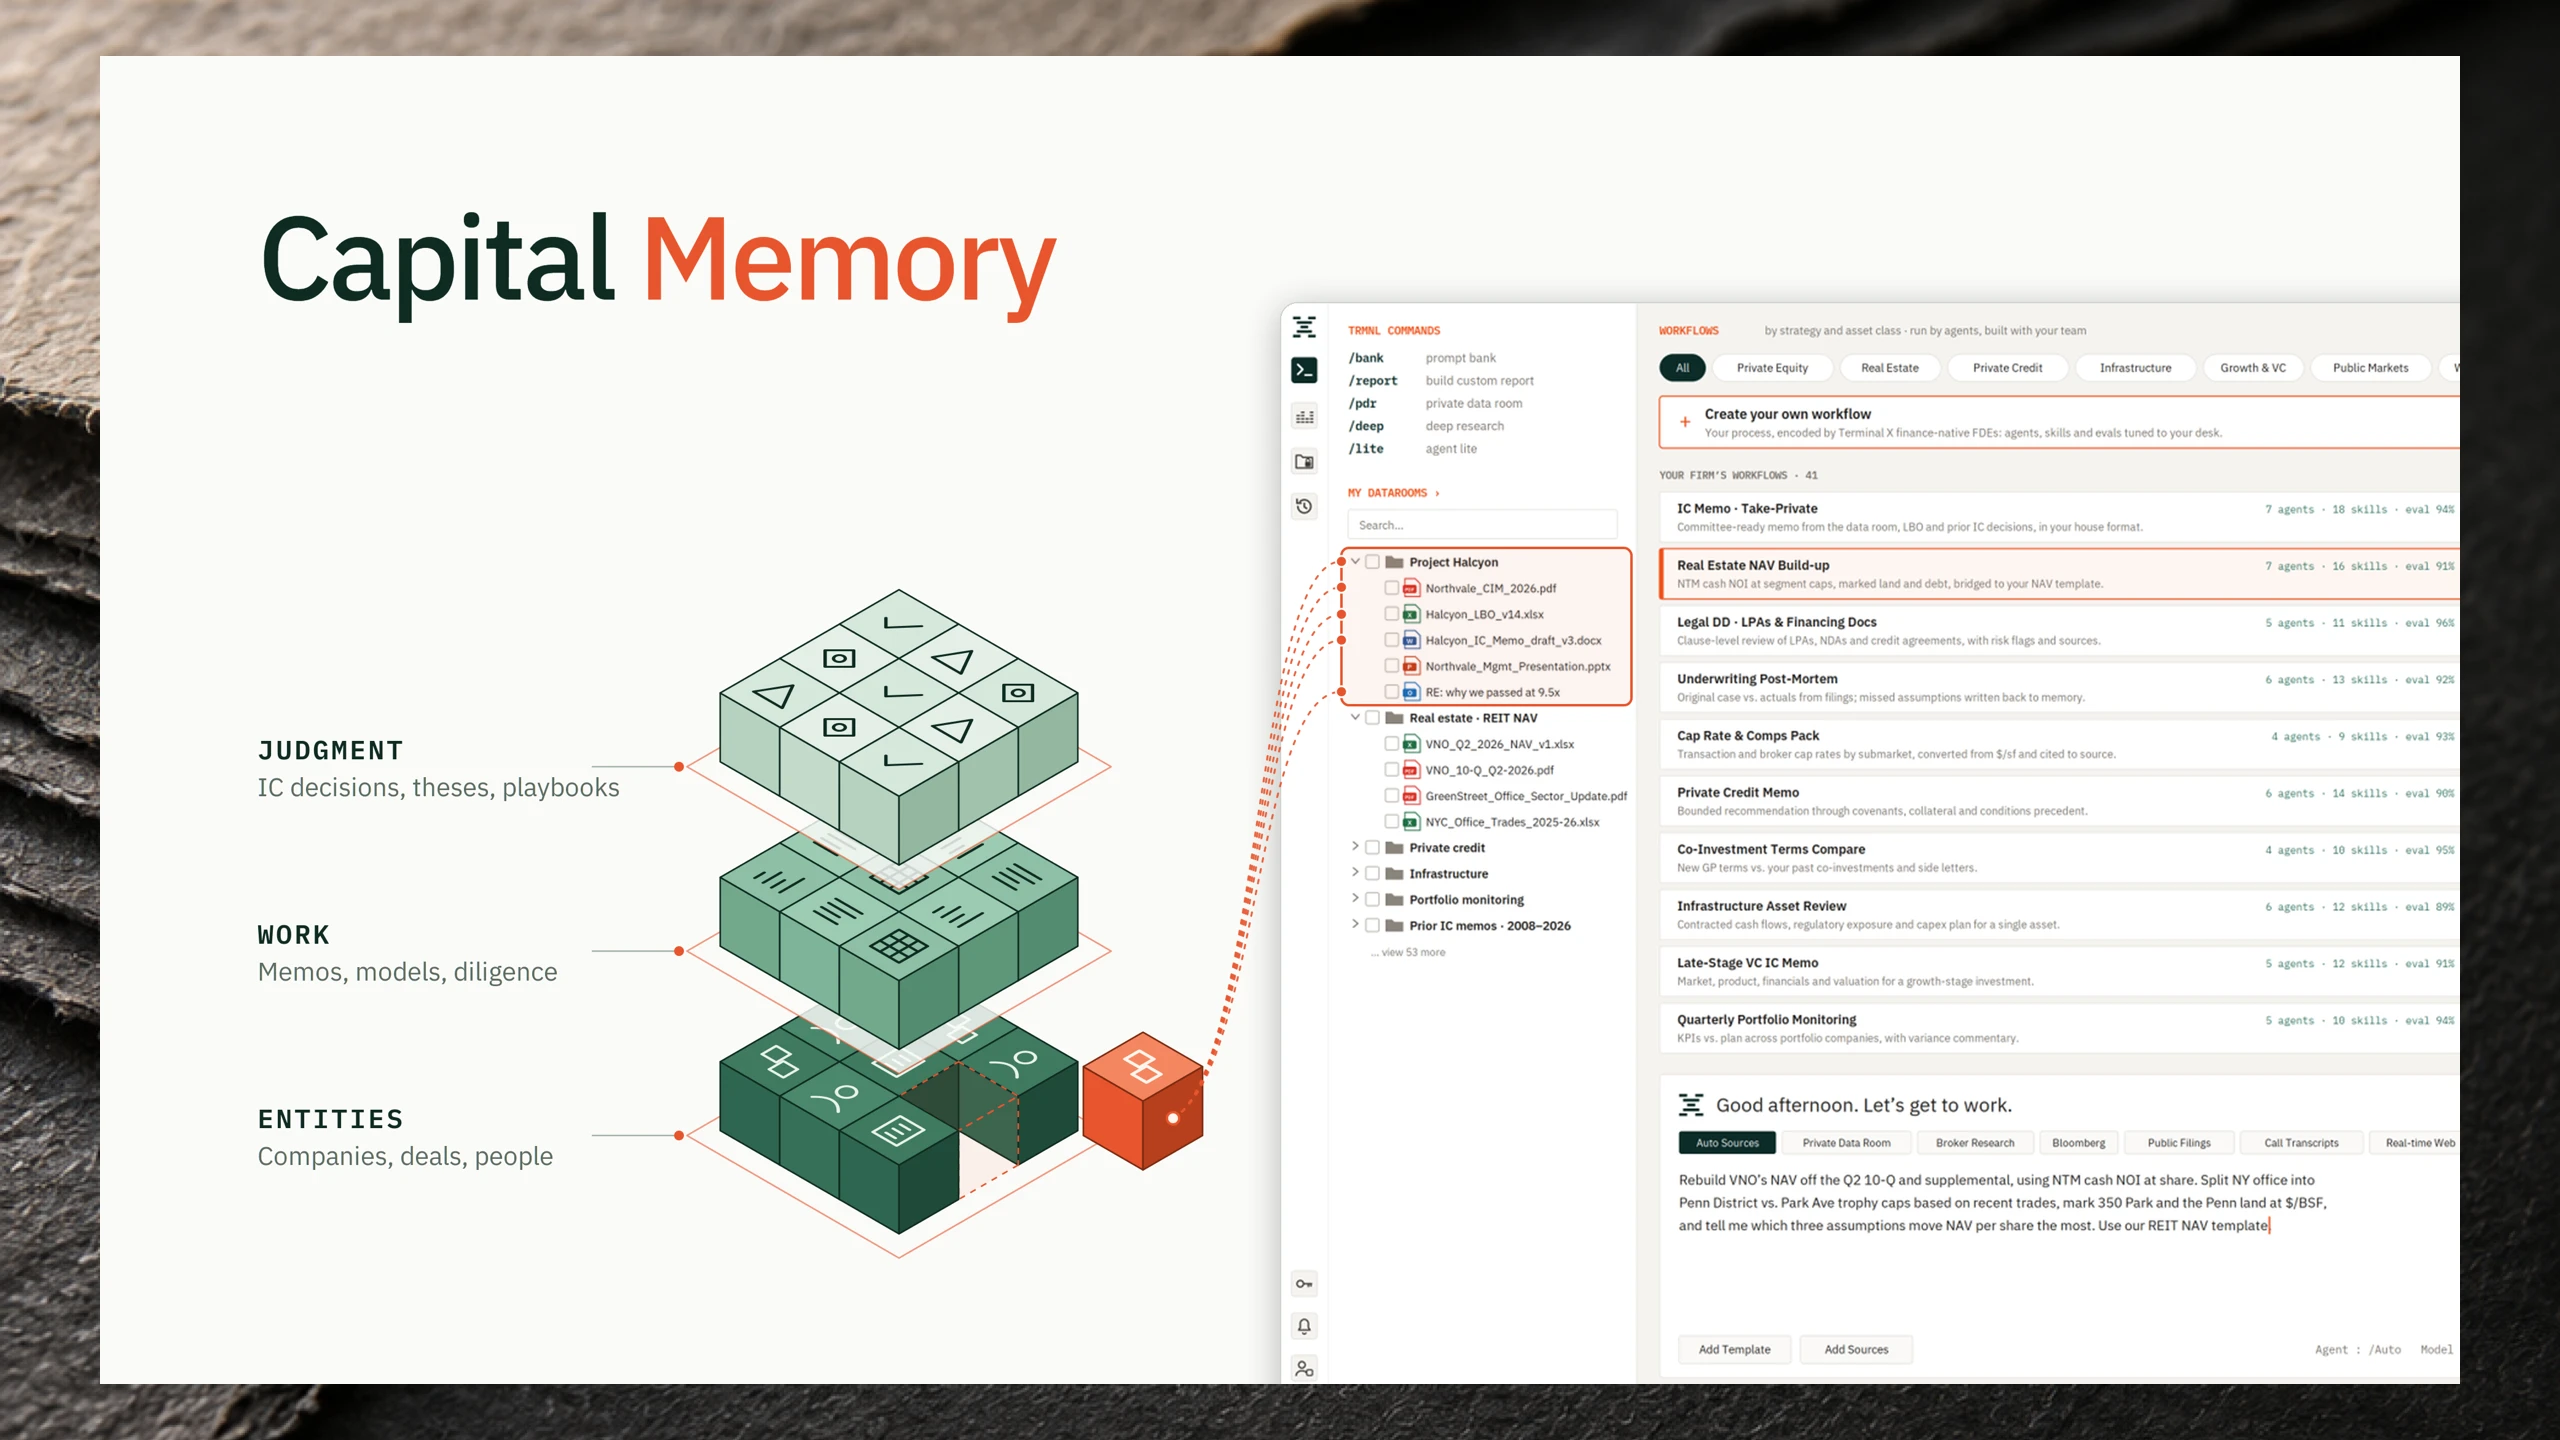
Für jedes Kundenunternehmen entwickelt Terminal X Agenten, die so investieren sollen wie dessen beste Anlageprofis. Das Engineering-Team von Terminal X verbringt Wochen vor Ort beim Kundenunternehmen. Es rekonstruiert die Herangehensweise hinter bewährten Memos und erfasst nie dokumentierte Abläufe: etwa wie das Kreditteam potenzielle Kreditnehmer prüft oder welche Quellen das Co-Investment-Team vor dem Verfassen eines Memos heranzieht.
Anschließend werden diese Prozesse in Hunderten von Agenten abgebildet, angepasst an Anlageklasse und Strategie und mit Unteragenten für jede Investmentphase. GPT‑6.1 Sol übernimmt die Phasen, die Urteilskraft und ein sehr großes Kontextfenster erfordern: die Investmentthese aus den vorliegenden Informationen ableiten, zentrale Aspekte identifizieren und prüfen, ob die These zum Mandat des Unternehmens passt. GPT‑6 Luna übernimmt die Schritte mit hohem Verarbeitungsvolumen, bei denen Token-Effizienz wichtiger ist als Tiefe.
Die Agenten arbeiten im privaten Datenraum des jeweiligen Unternehmens, einer dedizierten Umgebung zum Austausch und zur Verwaltung sensibler Investmentdaten. Die Agenten verarbeiten Dokumente auf Englisch, Koreanisch, Japanisch und Chinesisch. Ihre Erkenntnisse speichern sie als unternehmensspezifische Memory: eine versionierte Aufzeichnung darüber, wie ein bestimmtes Team eine bestimmte Art von Entscheidung trifft. Sie umfasst frühere Analysen, Ausschussentscheidungen, Workflow-Anweisungen und Anlageeinschätzungen des Hauses.
Das Engineering-Team überführt jede Memory in einen wiederholbaren Workflow auf der Plattform von Terminal X. Dort ist jede Anfrage im Produktivbetrieb vollständig nachvollziehbar: mit allen ausgeführten Schritten, abgerufenen Quellen, dem verwendeten Modell und dem Reasoning.
Laut Terminal X erzielen Kundenunternehmen mit diesem Ansatz erhebliche Einsparungen. So berichtete eine Private-Equity-Gesellschaft, durch automatisierte Workflows für Due Diligence und Investment-Memos auf das Jahr hochgerechnet 2,4 Millionen USD einzusparen.
Um die Antworten der Agenten an den unternehmenseigenen Standards zu prüfen, entwickelte Terminal X einen Eval Agent. Dahinter steht ein orchestrierter Workflow mit GPT‑6.1 Sol und weiteren OpenAI-Modellen. Er soll jedes Agentenergebnis so prüfen, wie ein VP die Arbeit einer Analysefachkraft prüft.
Der Eval Agent prüft jedes Ergebnis anhand eines Bewertungsrasters mit 54 Kriterien. Dabei fragt er: Stammen die Zahlen, Vergleichswerte, Konsensschätzungen und Zitate aus den richtigen Quellen? Ist die Argumentation schlüssig? Passt die Empfehlung zur Anlageeinschätzung des Hauses?
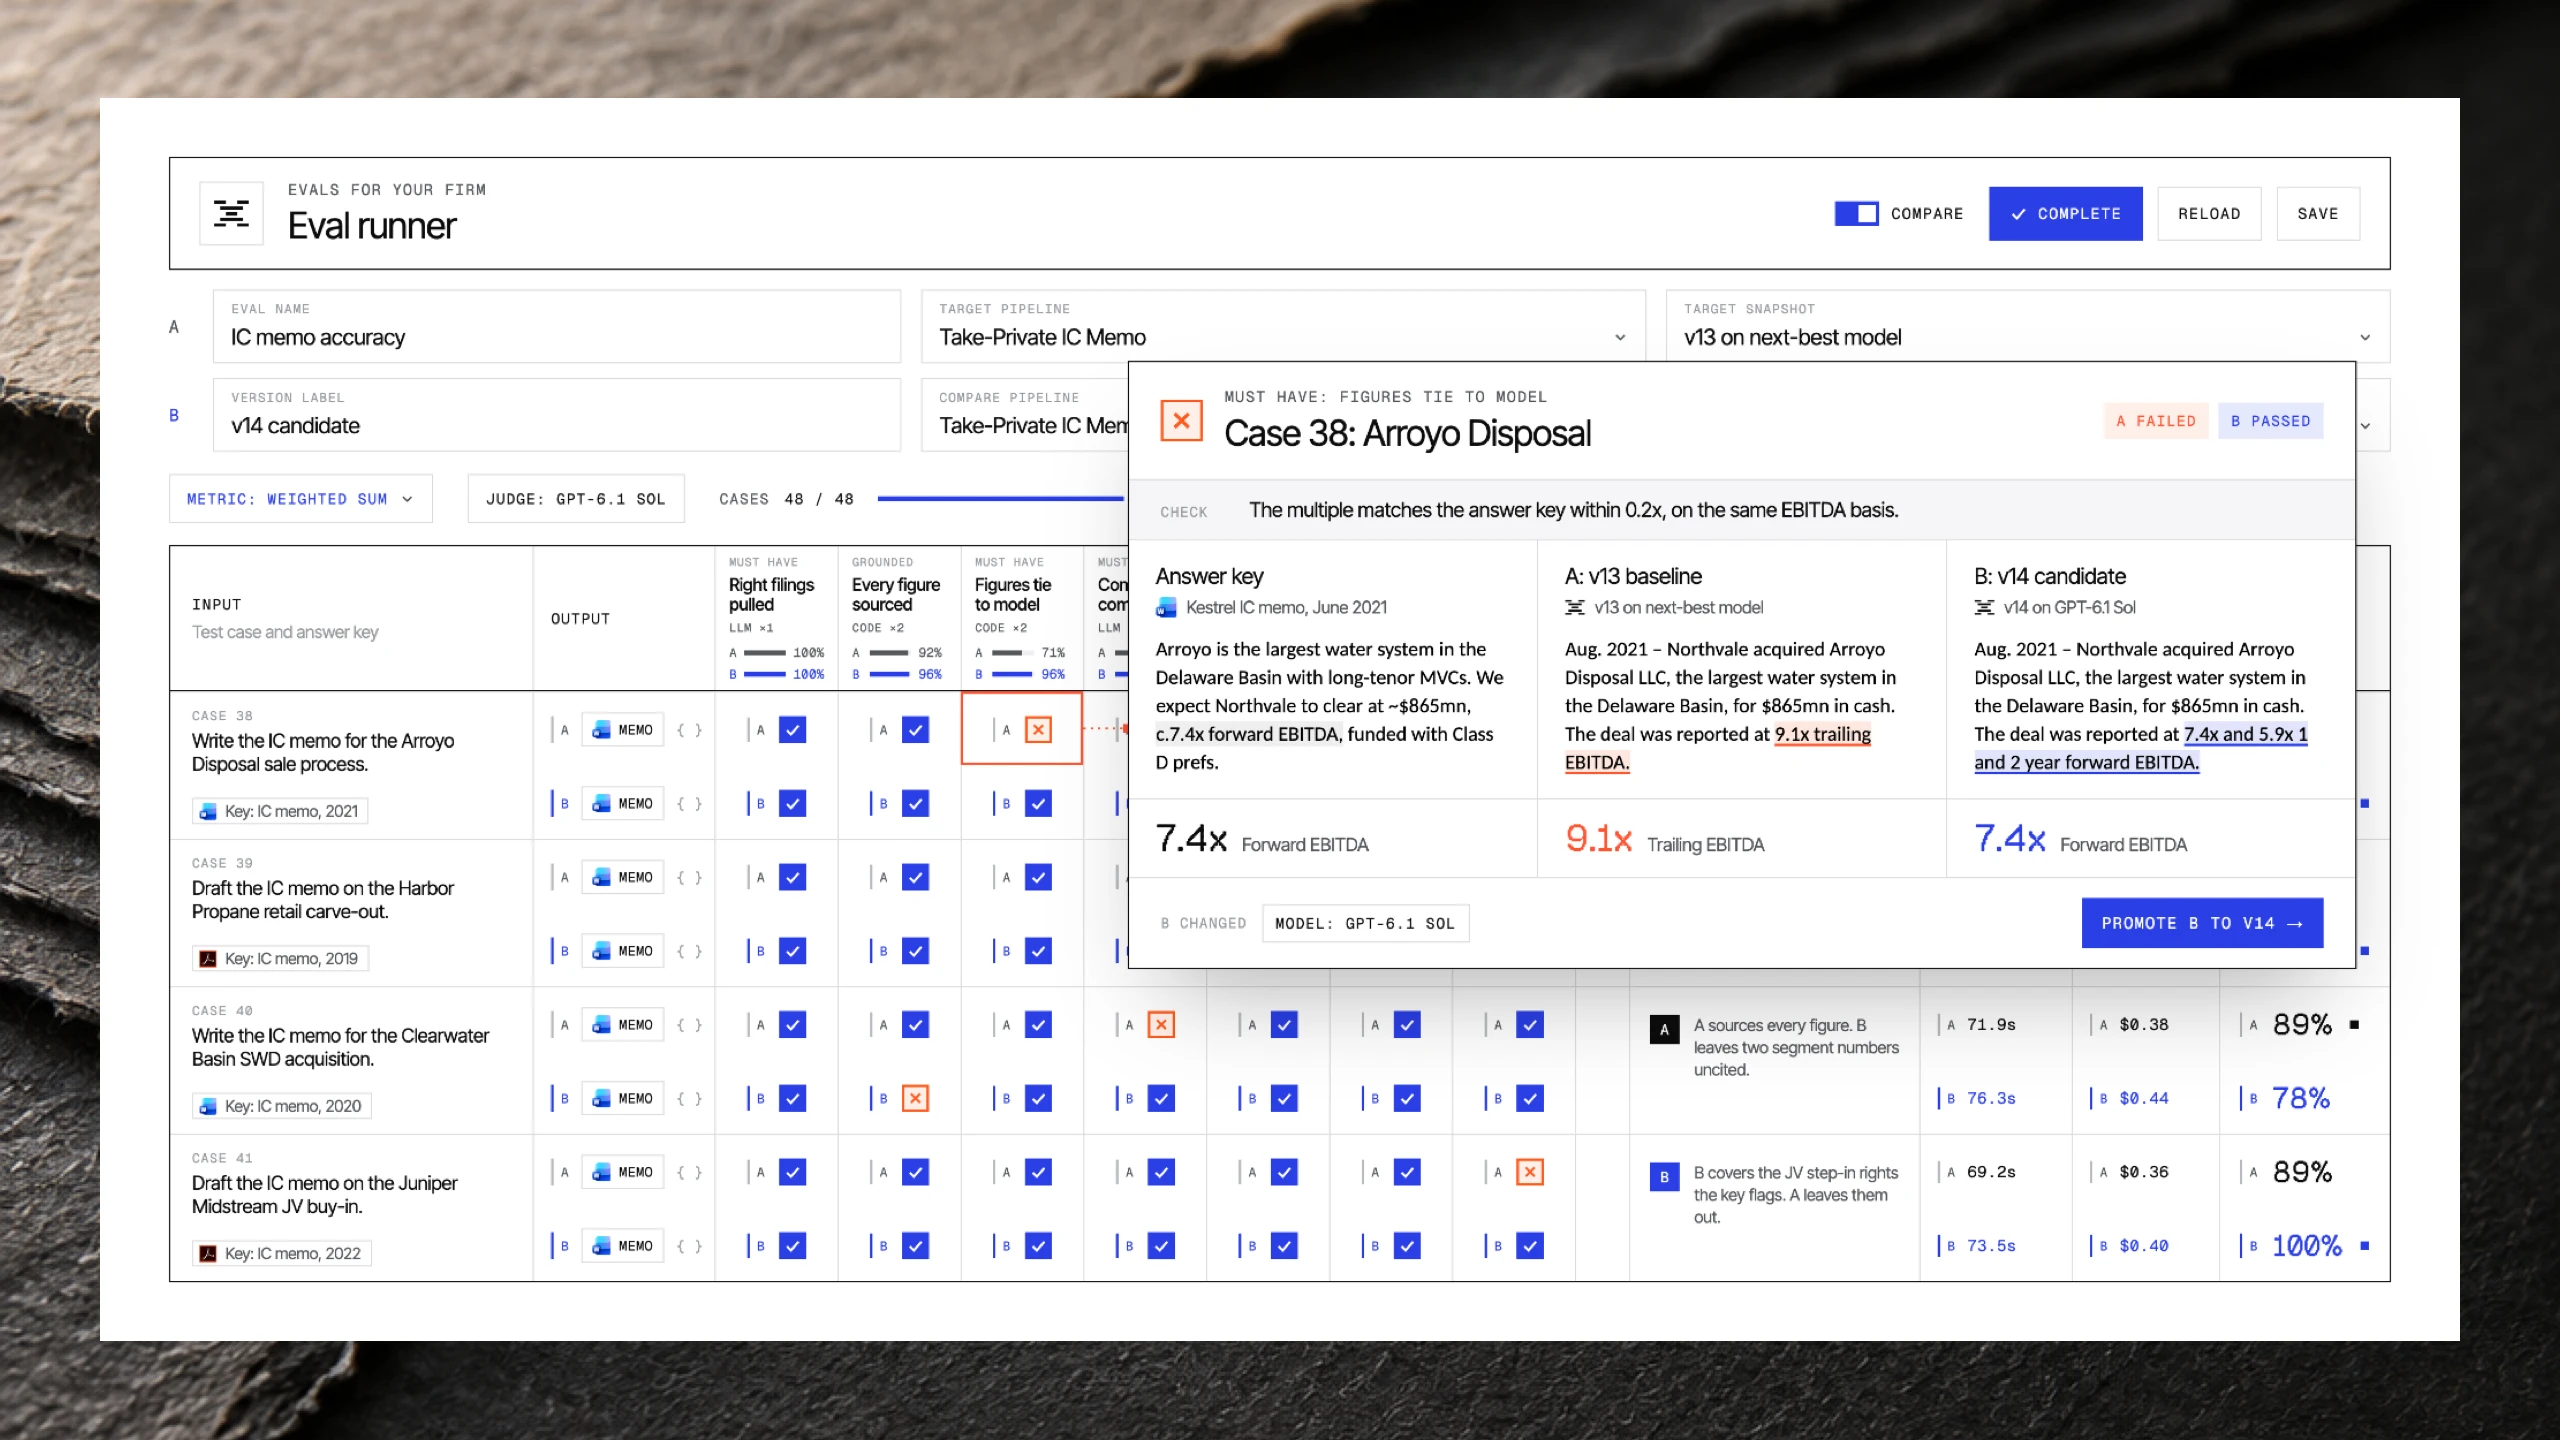
Jede Prüfung wird als bestanden oder nicht bestanden gewertet. Jede nicht bestandene Prüfung enthält eine einzeilige Begründung sowie eine bessere Quelle oder einen korrigierten Text und wird als Memory gespeichert. So wird etwa eine übersehene Quelle, ein ungeeignetes Vergleichsunternehmen oder eine These, die von der Anlageeinschätzung des Hauses abweicht, als neue Workflow-Anweisung oder neuer Testfall für das betreffende Team erfasst.
„Jede Antwort wird evaluiert, und jede Korrektur aus dem Analyseteam bringt dem System ein wenig mehr darüber bei, wie das Unternehmen arbeitet“, sagt Ken Lee, Co-Founder and CTO von Terminal X. „Je länger ein Unternehmen es nutzt, desto mehr denkt es wie das eigene Team.“
Terminal X wählt Modelle anhand eigener Evaluationsergebnisse aus. Bei 500 bewerteten Urteilen stimmte der Eval Agent mit GPT‑6.1 Sol in 88,6 % der Fälle mit der erfahrenen menschlichen Prüfperson überein. Beim nächstbesten Modell waren es 86,4 %, was einer Verbesserung um 220 Basispunkte entspricht.
Eine Fehlerkategorie, in der GPT‑6.1 Sol besser abschnitt, waren Abweichungen vom Anlagestil. Das Mandat eines Buyout-Fonds kann zum Beispiel darin bestehen, Kandidaten für eine Übernahme mit anschließendem Börsenrückzug zu finden, die mit einem Abschlag auf den Nettoinventarwert (NAV) gehandelt werden, das Geschäft auf seine Finanzierbarkeit zu prüfen und die Finanzierung zu strukturieren. Wenn Szenariomodelle eine Marktwende nahelegen, empfehlen die Transaktionsanalysen plötzlich eine Position in notleidenden Krediten oder eine Rettungsfinanzierung. Der Eval Agent mit GPT‑6.1 Sol erkannte rund 25 % mehr dieser Abweichungen als das nächstbeste Modell.
Dank der Token-Effizienz von GPT‑6.1 Sol bei Aufgaben mit langem Kontext konnte Terminal X bei gleichem Budget einen gründlicheren Prüfworkflow entwickeln. Die These wird zunächst mit dem Fondsmandat und anschließend mit den jüngsten Transaktionen des Fonds abgeglichen. Bei unsicheren Urteilen wird die Prüfung wiederholt. Der Agent gleicht die Ergebnisse ab, bevor er Bericht erstattet.
Diese gründlichere Prüfung markierte Transaktionen als auffällig, die ein vergleichbares Modell in einem einzigen Durchlauf durchgewinkt hatte. GPT‑6.1 Sol führte dieselben Workflows zudem zu rund 30 % geringeren Kosten pro Anfrage aus als das nächstbeste Modell, bei ähnlicher Geschwindigkeit.
Mit GPT‑6.1 Sol und GPT‑6 Luna hat Terminal X 1.700 unternehmensspezifische Memories erstellt und mehr als 1 Million maßgeschneiderte Workflows ausgeführt. Die Zahl der wöchentlich aktiven Personen erreichte dabei 81 % der monatlich aktiven Personen.
Als Nächstes will Terminal X die unternehmensspezifischen Memories von Teams auf Einzelpersonen ausweiten. So sollen die Maßstäbe jedes Anlageprofis so erfasst werden, wie sie in der Praxis angewendet und nicht nur beschrieben werden.
Für Hyun, co-founder and CEO von Terminal X, ist genau das entscheidend: „Die Unternehmen, die im nächsten Jahrzehnt erfolgreich sind, werden ihre Urteilskraft als eigene Daten besitzen. Unsere Aufgabe ist es, diese Urteilskraft messbar zu machen, damit sie erhalten, verbessert und wiederverwendet werden kann.“