我们在此分享纳维–斯托克斯 (Navier–Stokes) 存在性与光滑性问题的一种解法,这是千禧年大奖难题之一。这份证明由 OpenAI 内部系统生成,表明在纳维–斯托克斯方程所描述的流体动力学演化中,可能在有限时间内出现奇点。我们同时分享阐述该证明的论文及其 Lean 形式化版本。
千禧年大奖难题(在新窗口中打开)代表了数学前沿最深奥的一些问题。原本光滑的三维流体运动是否会在演化过程中失去光滑性,这一问题已有约 90 年未获解决。
我们工作的一项重要目标,是帮助科学家推动造福全人类的研究与技术发展。为解决纳维–斯托克斯问题,我们使用了一个能力显著超过 GPT‑6 Astra 的内部模型。我们认为,有必要让全世界了解 AI 的进步速度,以及对即将推出的模型可以抱有怎样的预期。
纳维–斯托克斯方程运用牛顿第二运动定律(“F=ma”)描述流体如何运动。重要的是,它们将流体视为连续介质,而不是追踪单个分子。这些方程用于飞机设计、天气预报和血流研究。
这些动力学方程有一个悬而未决的基础问题:对流体所作的连续介质近似是否会失效。具体而言,即使运动初始时是光滑的,描述密度恒定的三维不可压缩流体的纳维–斯托克斯方程是否仍会产生“奇点”?这里,奇点是指流体动力学演化导致流速在有限时间内无限增大。虽然黏性通常会使流体运动趋于平滑,但奇点若要形成,就必须在这种黏性仍然存在的情况下形成。由于真实流体不可能以无限快的速度运动,这将标志着方程对流体的建模失效。若要继续对该系统建模,届时就需要分别追踪每个粒子的行为。
这些方程可追溯至 Claude-Louis Navier 和 George Gabriel Stokes 在 19 世纪的研究。1934 年,Jean Leray 证明了广义解的存在性,而这些解能否始终保持光滑,则成为一个尚待解决的核心问题。2000 年,克雷数学研究所将纳维–斯托克斯存在性与光滑性问题列为七大千禧年大奖难题之一。
我们的系统给出了解析证明和 Lean 形式化证明,表明初始静止且光滑的流体可在有限时间内产生奇点。流体受到光滑外力作用,而从静止到形成奇点的整个动力学过程中,其能量始终有限。这一结果证明了千禧年大奖难题官方表述(在新窗口中打开)中的命题“C”(以及“D”)成立,从而解决了纳维–斯托克斯千禧年大奖难题。
该解是一个涡旋,即一股旋转的流体漩涡,它向内盘旋并像意大利面一样越拉越长。这一中心区域在收缩的同时加速,但其能量仍保持有限,符合物理定律的要求。技术难点在于,使方程的解因流体自身的运动而失去光滑性,而不是靠人为施加无限大的力等方式造成这一结果。更严格地说,纳维–斯托克斯方程中描述运动的各项——加速度、压力梯度、动量传递和黏性——既必须变得很大,又必须以精确方式相互抵消。这种精细平衡使外力保持光滑,即使流体速度无限增大也是如此。
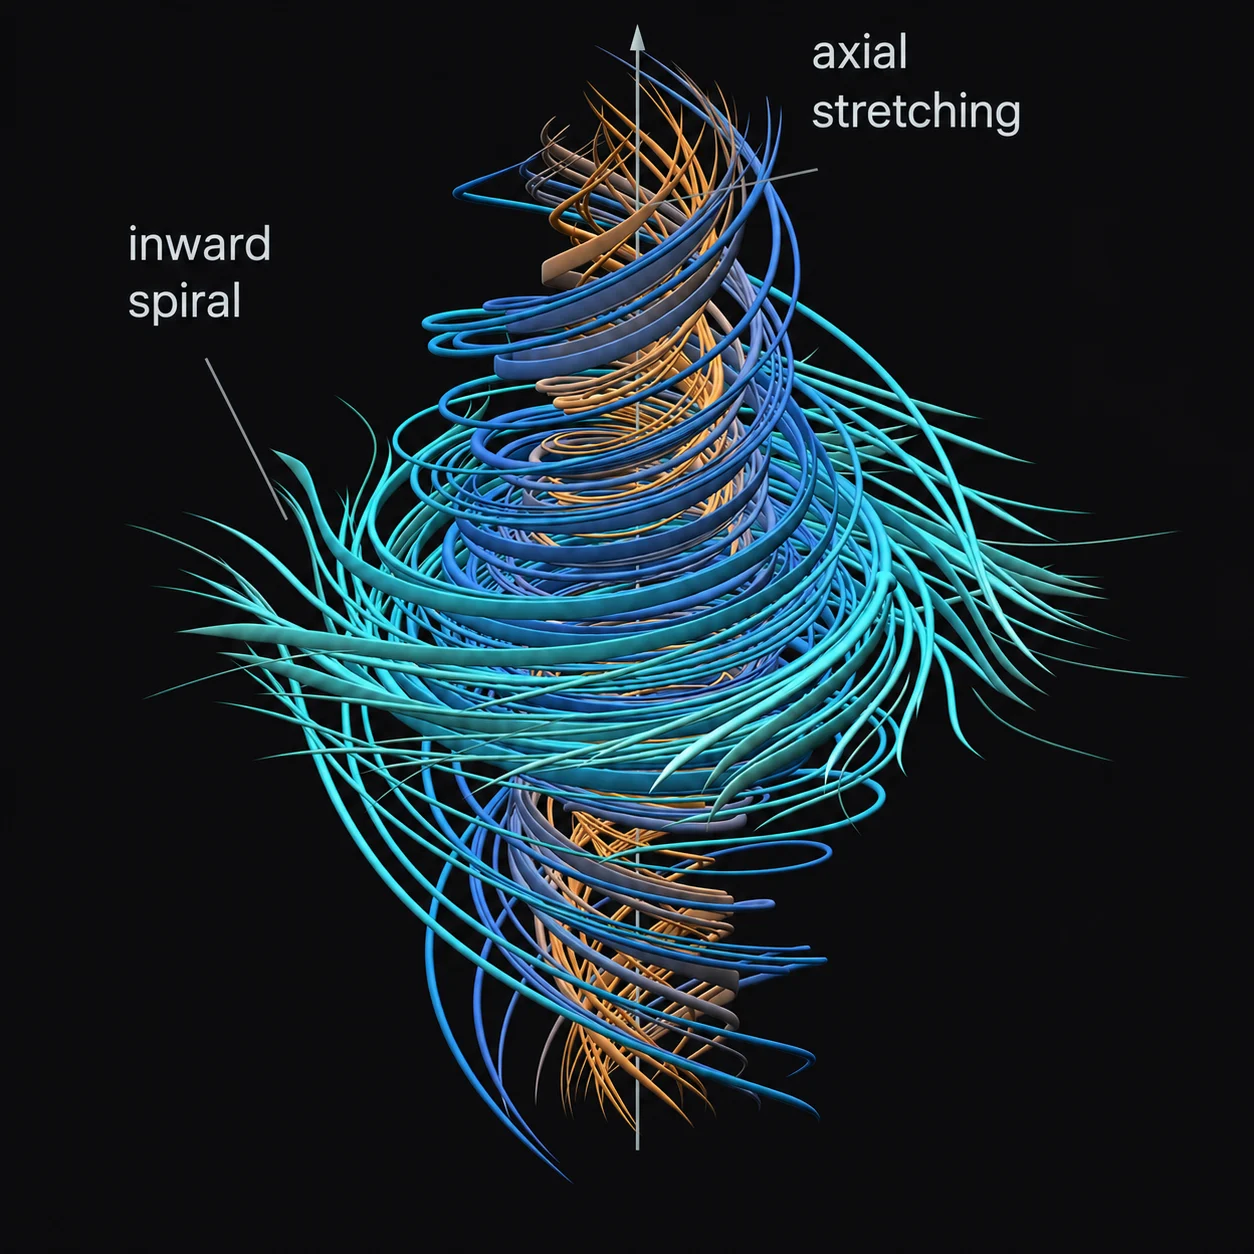
局部不可压缩流动的一个瞬时状态。橙色表示旋转角速度较大,蓝绿色表示旋转角速度较小。沿圆周方向运动的线速度还取决于旋转半径。轨迹显示了向内盘旋和轴向拉伸。
自 8 月 28 日起,我们一直在训练一个新的内部模型;该模型在我们的基准测试中取得了前所未有的成绩,其中包括数学方面的测试。该模型仍在训练中,性能也在持续提升。
9 月 1 日星期二,我们听到传闻称,两道千禧年大奖难题已获解决。受这些传闻以及内部模型性能跃升的启发,我们启动了一个项目,评估它解决所有尚未攻克的千禧年大奖难题和其他几项高影响力问题的能力。
我们使用了一个由内部模型驱动、多个智能体协同工作的系统。这些智能体可以使用多种工具,例如读取互联网缓存版本和运行代码。智能体被分成多个组,并能在组内进行沟通。各组规模不一,得出纳维–斯托克斯问题解法的组包含约 10,000 个并发智能体。我们始终采用与所有前沿模型评估相同的严格安全措施,包括监控和隔离。
对于每个问题,我们向不同组的智能体提供不同版本的问题陈述,以覆盖该问题的所有变体。对于纳维–斯托克斯问题,我们分别向不同的智能体组提供了版本“A”和“B”(纳维–斯托克斯问题的两种特定形式,解决相应版本可得出正面证明),以及版本“C”和“D”(解决相应版本可得出否证)。
除了完整的千禧年大奖难题,我们还让多智能体系统尝试了一组“较简单”的问题。其中一个问题涉及去掉黏性项后的纳维–斯托克斯方程这一极限情形:其解是否也会发生类似的爆破。这称为欧拉方程的正则性问题;令我们惊讶的是,智能体解决了它。它们解决的具体变体是无外力版本,即不对流体施加任何外力。近 100 个智能体协作约 50 小时,给出了证明,表明欧拉方程的解可能失去正则性1。
看到欧拉方程正则性问题的解决结果后,我们认为纳维–斯托克斯问题最有希望取得突破。因此,我们决定将资源集中投入纳维–斯托克斯问题。为此,我们将智能体从其他千禧年大奖难题转移过来,并以欧拉方程的解法作为提示词,引导这些智能体。在项目推进期间,经过进一步训练的内部模型版本可用后,我们便将智能体切换到该版本。
我们鼓励不同的智能体组探索多种思路。一段时间后,我们使用 Codex 汇总各智能体组最有价值的见解,促进不同组之间的思想交流。这些后续提示词借鉴了智能体自身的中间结果。找到纳维–斯托克斯问题解法的小组正是以这种方式获得引导的。
智能体于 9 月 5 日星期六得出解法,距首批智能体启动约 88 小时。随后通过 GPT‑6 Astra 完成 Lean 形式化与验证,又耗时 17 小时。
在尝试解决所有这些问题的过程中,智能体共发送 490 万条消息,使用了约 3000 亿个输出 token。在解决纳维–斯托克斯问题的过程中,智能体发送了 270 万条消息,使用了约 1300 亿个输出 token。
我们是在听到一则传闻后于 9 月 1 日启动这项工作的,后来才得知传闻与 Anthropic 员工 Levent Alpöge 和纽约大学数学教授 Tristan Buckmaster 有关。2 在我们的完整项目和 Lean 验证完成后(9 月 6 日),我们根据传闻认为他们也找到了纳维–斯托克斯问题的解法,于是联系二人,提议与他们同时发布研究结果,并在联合公告中承认他们率先取得了相关成果。那时我们才得知,他们使用 Anthropic 的内部模型解决了受迫欧拉方程问题。在沟通中,我们提出让他们查看我们使用的全部提示词,之后也提出让他们查看证明。我们承认他们率先取得了受迫欧拉方程问题的相关研究成果,并祝贺他们取得这一非凡的数学成就。
在他们公开发布之前,我们(研究人员和智能体)未曾通过任何途径看到他们的工作——尤其是,我们没有为解决此问题而访问任何特定用户的数据。
经调查,我们已确认,Buckmaster 在本公告及论文于 2026 年 9 月 8 日发布之前的两个月内提交给 Codex 的提示词,不可能通过任何方式影响该系统,包括通过训练产生影响。用于得出这一结果的 OpenAI 内部模型,是在一个此前完成预训练的模型基础上,通过大规模强化学习开发的。我们的证明也有显著差异。对于欧拉方程,Alpöge 和 Buckmaster 在存在外力作用的条件下证明了相关结论,而 OpenAI 的系统则在没有外力作用的条件下证明了相关结论。
我们发布这一结果,是为了说明我们的 AI 模型已取得重大进展。我们无意凭借这一结果申领千禧年大奖。
这一里程碑凝聚了数学家和 AI 研究人员的大量工作。不过,这并非终点,而只是 AI 发展进程在这一时刻的缩影。
我们相信,AI 的发展现已进入下一个阶段,今天的结果进一步印证了这一点。我们正专注于理解这一模型,并运用由此获得的认识,指导和调控下一步能力提升的方向与节奏。我们的主要目标之一,是构建可引导、可问责且与人紧密相连的 AI 系统。随着我们继续履行确保 AGI 造福全人类的使命,这可能要求我们更审慎地选择进步的速度。
作者
脚注
- 1
- 2