Amplitude ใช้ OpenAI ปรับปรุงผลิตภัณฑ์ได้ใน 1–2 วัน
Amplitude ใช้โมเดล OpenAI เป็นหลักในการสร้าง Wave เอเจนต์ AI ที่ค้นหาโอกาสในการพัฒนา ช่วยทีมใช้เอเจนต์เขียนโค้ดนำการเปลี่ยนแปลงไปใช้งานจริง และประเมินผลลัพธ์
160%
การใช้งานเอเจนต์เพิ่มขึ้นเมื่อเทียบกับกลุ่มควบคุมหลังผ่านไป 1 วัน
1–2 วัน
ระยะเวลาโดยประมาณในการนำการปรับปรุงผลิตภัณฑ์ไปใช้งานจริงด้วย Wave
51%
GPT‑6.1 Sol มีต้นทุนเฉลี่ยต่อการเรียกใช้โมเดลหนึ่งครั้งต่ำกว่าในการประเมิน Data Science Agent ของ Amplitude
$1.34
ค่าใช้จ่ายในการใช้ GPT-6.1 Sol สำหรับการประเมิน Opportunity Investigator ของ Amplitude
ที่ผ่านมา Amplitude ช่วยให้ทีมมองเห็นว่าผู้ใช้มีปฏิสัมพันธ์กับผลิตภัณฑ์อย่างไร และตอนนี้ Wave เอเจนต์ AI ที่ทำงานเชิงรุกของ Amplitude ยังช่วยให้ทีมนำข้อมูลเชิงลึกเหล่านั้นไปปรับปรุงผลิตภัณฑ์และเปิดใช้งานจริง Amplitude ระบุว่า Wave ใช้โมเดลของ OpenAI เป็นหลักในสัดส่วนประมาณ 80% ซึ่งรวมถึง GPT‑6.1 Sol, GPT‑6 Luna และ GPT‑Image‑2.5 Flare โดย Wave จะเปลี่ยนข้อมูลเชิงลึกเกี่ยวกับผลิตภัณฑ์ให้เป็นแผนการพัฒนาที่ทีมสามารถส่งต่อให้เอเจนต์เขียนโค้ด เช่น Codex นำไปดำเนินการ ก่อนวัดผลที่เกิดขึ้น
Amplitude ประเมินว่า Wave ช่วยให้ทีมสามารถนำการปรับปรุงผลิตภัณฑ์ไปใช้งานจริงได้ภายใน 1–2 วัน จากเดิมที่ใช้เวลาประมาณหนึ่งเดือน โดย Wave ได้ช่วยปรับการ์ดคำแนะนำบนหน้าแรกของ Amplitude ให้เหมาะกับผู้ใช้แต่ละคน ส่งผลให้จำนวนการส่งข้อความผ่านการ์ดคำแนะนำเพิ่มขึ้น 160%
“ตอนนี้ AI สามารถค้นพบงานที่มีประโยชน์ซึ่งเราไม่เคยคิดจะมอบหมายให้ทำมาก่อนได้แล้ว โมเดลของ OpenAI สามารถวิเคราะห์ปัญหา เขียนโค้ด ทดลองรันโค้ด และใช้ผลลัพธ์ที่ได้ตัดสินใจว่าจะลองทำอะไรเป็นขั้นตอนต่อไป”
Wave เป็นเอเจนต์ AI ที่ทำงานเชิงรุกของ Amplitude ทีมงานเพียงกำหนดว่าต้องการปรับปรุงส่วนใดของผลิตภัณฑ์ รวมถึงเป้าหมายและตัวชี้วัดที่อยากพัฒนา จากนั้น Wave จะนำข้อมูลของ Amplitude บันทึกการใช้งานย้อนหลัง ความคิดเห็นของลูกค้า และโค้ดมาวิเคราะห์ร่วมกัน เพื่อค้นหาและจัดลำดับความสำคัญของโอกาสในการปรับปรุง พัฒนาแนวทางแก้ไข และประสานงานกับทีมและเอเจนต์เขียนโค้ดเพื่อนำแนวทางเหล่านั้นไปใช้จริง ก่อนติดตามผลลัพธ์และนำสิ่งที่ได้เรียนรู้ไปใช้วางแผนปรับปรุงผลิตภัณฑ์ในรอบถัดไป
เบื้องหลังกระบวนการทำงานนี้ Amplitude เลือกใช้โมเดลของ OpenAI ให้เหมาะกับงานแต่ละประเภท โดย GPT‑6.1 Sol ช่วยจัดการโอกาสในการปรับปรุงผลิตภัณฑ์และวิเคราะห์โค้ดกับข้อมูลอย่างเจาะลึก ส่วน GPT‑6 Luna รับหน้าที่จัดการงานที่ต้องทำบ่อยและมีต้นทุนต่ำกว่า เช่น การตรวจสอบโค้ดและการประเมินผลเบื้องต้น ขณะที่ GPT‑Image‑2.5 Flare ใช้สร้างภาพจำลองผลิตภัณฑ์ โดยอ้างอิงภาพหน้าจอจากบันทึกเซสชันการใช้งานย้อนหลัง
เมื่อพบโอกาสในการปรับปรุงที่พร้อมนำไปพัฒนา ทีมสามารถส่งต่องานจาก Wave ไปยังเอเจนต์เขียนโค้ด เช่น Codex ได้ทันที โดยมีแผนทางเทคนิคและเกณฑ์การยอมรับผลงานกำกับ เพื่อให้การพัฒนาเป็นไปตามที่กำหนด
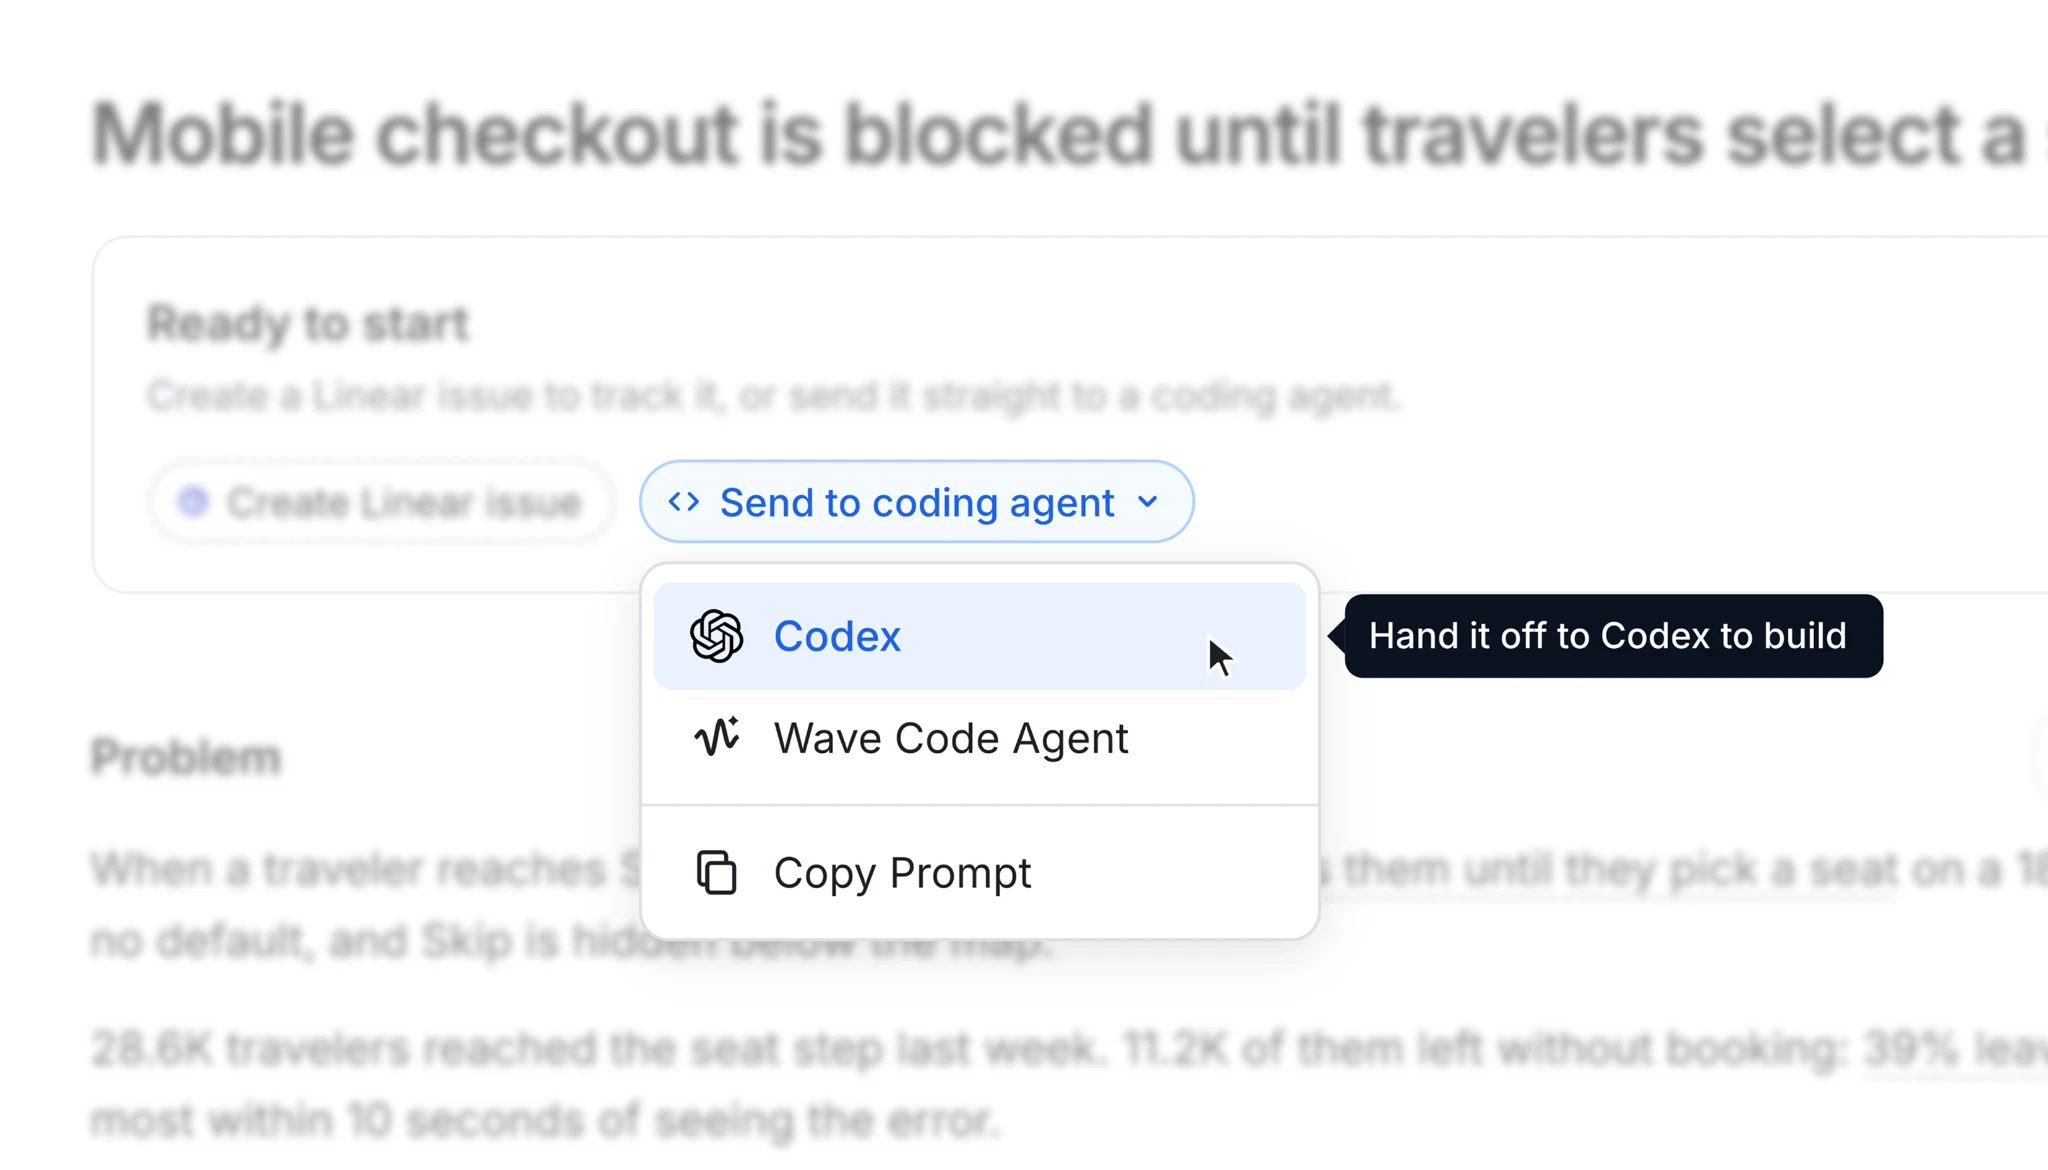
“แนวคิดของ Wave คือการรวมทุกอย่างไว้ในแพลตฟอร์มเดียว โดยมีเอเจนต์ที่ช่วยตรวจสอบข้อมูลจำนวนมหาศาล ทั้งบันทึกเซสชันการใช้งานย้อนหลัง ข้อมูลวิเคราะห์ และโค้ด เพื่อค้นหาโอกาสในการปรับปรุงผลิตภัณฑ์” Jacob Newman ผู้จัดการผลิตภัณฑ์ AI ระดับ Principal ของ Amplitude อธิบาย
Amplitude นำ Wave มาทดลองกับหน้าแรกของตัวเอง ซึ่งมีการ์ดคำแนะนำทั่วไปเพื่อช่วยให้ผู้ใช้เริ่มแชตกับเอเจนต์ AI ได้ง่ายขึ้น แต่ Wave พบว่าผู้ใช้ส่วนใหญ่มักไม่เลือกคำแนะนำเหล่านั้น จากการตรวจสอบบันทึกเซสชันการใช้งานย้อนหลัง 100 รายการ พบว่ามีผู้ใช้ถึง 80 คนที่พิมพ์คำถามด้วยตัวเอง และมีเพียง 12 คนที่เลือกคำแนะนำจากการ์ด
Wave เสนอให้ปรับการ์ดคำแนะนำให้เหมาะกับผู้ใช้แต่ละคน โดยอ้างอิงจากกราฟ แดชบอร์ดที่เพิ่งดู หรือหน้าที่ผู้ใช้เข้าชมก่อนหน้านี้ พร้อมสร้างภาพตัวอย่างการเปลี่ยนแปลงและจัดทำแผนทางเทคนิค ซึ่งยังเปิดให้ผู้ใช้พิมพ์คำถามเองได้ และแสดงคำแนะนำทั่วไปเมื่อไม่มีข้อมูลเพียงพอสำหรับปรับคำแนะนำให้ตรงกับผู้ใช้ หลังจากทีมตรวจสอบแผนดังกล่าวอย่างรวดเร็วแล้ว ก็ส่งงานต่อให้เอเจนต์เขียนโค้ดดำเนินการและทดสอบการเปลี่ยนแปลงด้วยวิธี A/B
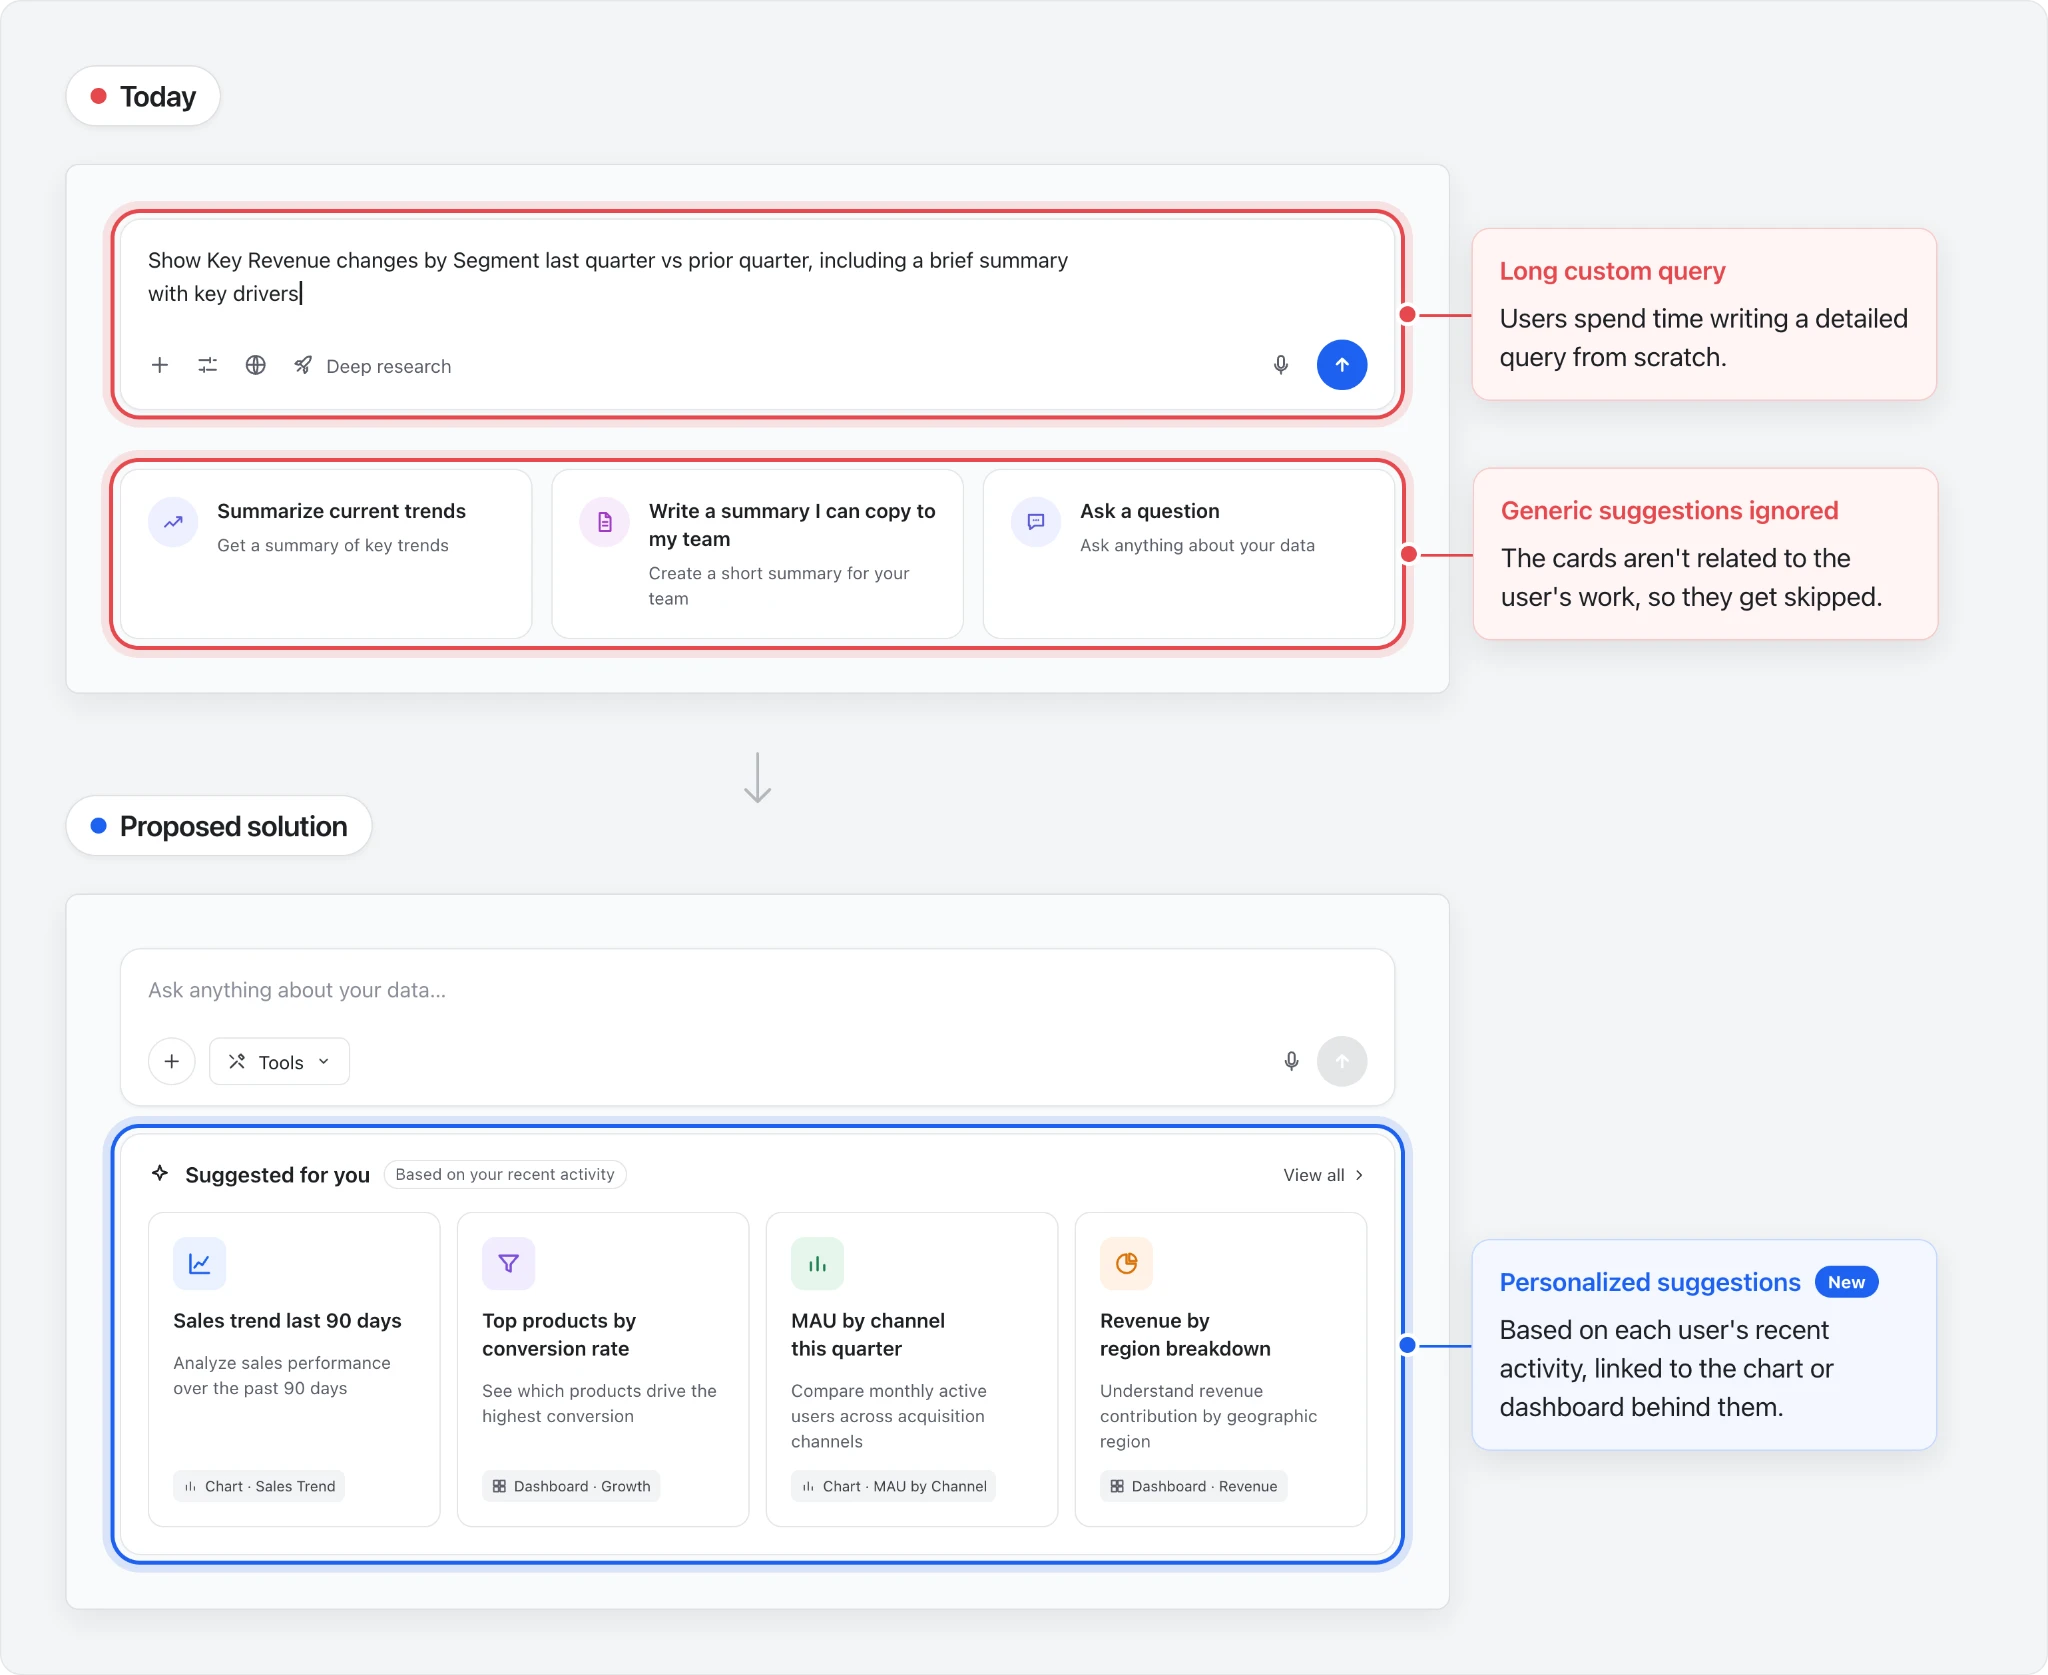
ผลการทดลองที่ Amplitude นำมาเผยแพร่แสดงให้เห็นว่า เพียง 1 วันหลังเริ่มทดลอง จำนวนข้อความที่ผู้ใช้ส่งผ่านการ์ดคำแนะนำบนหน้าแรกเพิ่มขึ้น 160% เมื่อเทียบกับกลุ่มควบคุม “นี่เป็นตัวอย่างที่ดีของการปรับปรุงสิ่งเล็กๆ น้อยๆ ที่คนมักมองข้าม ซึ่งกลับช่วยเพิ่มการใช้งานฟีเจอร์ต่างๆ ได้อย่างคาดไม่ถึง” Eric Carlson วิศวกร AI ระดับ Senior Principal ของ Amplitude อธิบาย
Wave ต้องใช้โมเดลที่มีความสามารถต่างกันตามลักษณะงาน หากเป็นการวิเคราะห์เชิงลึก โมเดลต้องให้เหตุผลได้ดีและสรุปผลอย่างมีหลักฐานรองรับ แต่หากเป็นงานตรวจสอบเล็กๆ ที่ต้องทำซ้ำหลายร้อยครั้ง ความรวดเร็วและต้นทุนต่ำจะมีความสำคัญ Amplitude จึงประเมินคุณภาพ ความหน่วงในการตอบสนอง และต้นทุนของแต่ละงาน ก่อนตัดสินใจว่าจะใช้โมเดลใด
“OpenAI มีทั้งโมเดลที่มีความสามารถในการให้เหตุผลขั้นสูง และโมเดลขนาดเล็กที่ทำงานได้รวดเร็วกว่า ทำให้เราสามารถสร้างสมดุลระหว่างคุณภาพ ความเร็วในการตอบสนอง และต้นทุนการประมวลผลของโมเดลในส่วนต่างๆ ของผลิตภัณฑ์ได้”
Amplitude ทดสอบโมเดลสำหรับ Opportunity Investigator ของ Wave โดยพิจารณาว่าโมเดลสามารถใช้หลักฐานอื่นยืนยันข้อค้นพบ หลีกเลี่ยงผลบวกลวง นำข้อเสนอแนะจากผู้ประเมินมาปรับใช้ รับมือกับความผิดพลาดของเครื่องมือ และสรุปผลตามหลักฐานได้ดีเพียงใด ผลปรากฏว่า GPT‑6.1 Sol ได้คะแนนรวม 4.06 จากเต็ม 5 คะแนน สูงกว่าโมเดลทางเลือกอีก 3 ตัวที่ได้ 3.62, 3.52 และ 2.94 คะแนน โดย GPT‑6.1 Sol ได้คะแนนสูงสุดในเกณฑ์ทั้ง 5 ด้าน และมีระยะเวลามัธยฐานในการตรวจสอบวิเคราะห์สั้นที่สุดเพียง 54 นาที
Amplitude ยังประเมิน Data Science Agent ของ Wave แยกต่างหาก โดย GPT‑6.1 Sol ได้คะแนน 67.5 จาก 100 คะแนน ใกล้เคียงกับโมเดลชั้นนำอีกตัวที่ได้ 69.3 คะแนน แต่มีต้นทุนเฉลี่ยต่อการเรียกใช้งานโมเดลหนึ่งครั้งอยู่ที่ 1.28 ดอลลาร์ ซึ่งต่ำกว่าอีกโมเดลที่มีต้นทุน 2.63 ดอลลาร์ ทั้งยังได้คะแนนสูงกว่าในด้านการทำงานตามข้อกำหนดของเครื่องมือ การประมาณค่าและความไม่แน่นอน ตลอดจนการอ้างอิงหลักฐานเพื่อสนับสนุนผลลัพธ์
Amplitude ใช้ GPT‑6 Luna กับงานที่ต้องทำจำนวนมาก เช่น การสแกนโค้ดและการตรวจประเมินขนาดเล็ก เพื่อควบคุมทั้งระยะเวลาตอบสนองและต้นทุนให้ต่ำ การกระจายงานให้เอเจนต์เฉพาะทางแต่ละตัวช่วยให้ทีมสงวนการใช้โมเดลที่มีความสามารถด้านการให้เหตุผลสูงและมีค่าใช้จ่ายมากกว่าไว้สำหรับงานที่ต้องการความสามารถนี้จริงๆ
สำหรับงานสร้างแบบร่างหน้าจอและภาพตัวอย่างผลิตภัณฑ์ โมเดลสร้างภาพของ OpenAI ทำคะแนนประเมินแบบร่างหน้าจอสำหรับแนวทางแก้ไขได้ 80.3 จาก 100 คะแนน สูงกว่าโมเดลสร้างภาพอีกตัวที่ได้ 63.9 คะแนน โดย Amplitude ประเมินจากโอกาสในการปรับปรุง 15 รายการ และพิจารณาทั้งการสื่อสารแนวคิด ความสอดคล้องกับผลิตภัณฑ์ การทำตามคำสั่ง ความอ่านง่ายของข้อความและองค์ประกอบ UI ตลอดจนความกลมกลืนของภาพโดยรวม
ลูกค้าจากหลากหลายอุตสาหกรรมเริ่มใช้ Wave เวอร์ชันเบต้าเพื่อค้นหาโอกาสในการปรับปรุงผลิตภัณฑ์และนำไปใช้งานจริงแล้ว โดย Wave จะวิเคราะห์ข้อมูลเซสชันการใช้งานและข้อมูลวิเคราะห์ ก่อนจัดทำคำแนะนำที่มาพร้อมแนวทางแก้ไขที่เสนอ แผนทางเทคนิค และเกณฑ์การยอมรับผลงาน
จากนั้นทีมสามารถกำหนดระดับการทำงานอัตโนมัติได้ตามต้องการ โดยทีมส่วนใหญ่มักส่งงานแก้ไขข้อบกพร่องไปยังเอเจนต์เขียนโค้ดโดยตรง ส่วนการพัฒนาฟีเจอร์ใหม่และโครงการขนาดใหญ่ที่มีความสำคัญจะต้องผ่านการตรวจสอบจากคนก่อน
จากการค้นพบโอกาสสู่การลงมือปรับปรุงจริงอาจใช้เวลาไม่นาน โดยในกลุ่มการทดลอง แฟล็กควบคุมฟีเจอร์ และคู่มือที่ลูกค้าเปิดใช้งานจริง 1 ใน 4 เปิดใช้งานได้ตั้งแต่วันที่ Wave พบโอกาสในการปรับปรุง ครึ่งหนึ่งใช้เวลาไม่ถึง 4 วัน และ 2 ใน 3 เปิดใช้งานภายในหนึ่งสัปดาห์
กราฟนี้สร้างขึ้นโดยประมาณค่าระหว่างจุดข้อมูลสำคัญที่ได้รับ เส้นกราฟใช้เพื่อประกอบการอธิบายเท่านั้น ไม่ได้แสดงข้อมูลที่สังเกตได้จริงในแต่ละจุด
“เป้าหมายของเราในการร่วมมือกับ OpenAI คือการทำให้ผลิตภัณฑ์สามารถพัฒนาตัวเองให้ดีขึ้นได้ และกลายเป็นแนวทางที่บริษัทต่างๆ ใช้ในการพัฒนาซอฟต์แวร์” Skates กล่าว เมื่อโมเดลของ OpenAI มีความสามารถในการให้เหตุผลและเขียนโค้ดดีขึ้น ทีมต่างๆ ก็จะสามารถมอบหมายงานตรวจสอบวิเคราะห์และงานพัฒนาให้เอเจนต์รับผิดชอบได้มากขึ้น ซึ่งท้ายที่สุดจะช่วยให้ผู้ใช้ได้ใช้งานผลิตภัณฑ์ที่ดีขึ้นรวดเร็วยิ่งกว่าเดิม Amplitude เริ่มเห็นผลลัพธ์นี้แล้วจากการที่เอเจนต์ช่วยค้นหาและนำการปรับปรุงมาใช้กับผลิตภัณฑ์ของบริษัท ขณะที่ทีมมีเวลาไปดูแลงานสำคัญด้านอื่น “ผมคิดว่าหลายทีมจะต้องแปลกใจว่าตัวเองทำอะไรได้มากขึ้นแค่ไหน เมื่อมีซอฟต์แวร์ร่วมทำงานไปด้วยกันเพื่อพัฒนาผลิตภัณฑ์ให้ดีขึ้น”