O que significa ser Forward Deployed Engineer na OpenAI
O que fazemos, como trabalhamos e como resolvemos os problemas mais difíceis das empresas para gerar impacto real.
Por: Colin Jarvis, líder de Engenharia de Implantação em Campo na OpenAI
Quando o Codex foi lançado, alguém da equipe me perguntou: "O que vamos fazer quando o Codex conseguir resolver de uma só vez os casos de uso que passamos os últimos meses desenvolvendo?"
Essa pergunta vai direto à essência do que significa ser Forward Deployed Engineer na OpenAI. Trabalhamos lado a lado com os clientes para entender seus problemas mais difíceis e construir soluções nas quais possam confiar. O que aprendemos ajuda a moldar nossos produtos e oferece à equipe de Pesquisa problemas concretos para resolver.
Isso é progresso. Se nos tornamos obsoletos a cada dois meses, nossa equipe de Forward Deployed Engineers está cumprindo seu papel.
Fundei a equipe no início de 2025 para eliminar o que chamamos de "lacuna de implantação": a distância entre o que os modelos parecem capazes de fazer e o que as pessoas conseguem usar com confiança para realizar seu trabalho.
As capacidades dos modelos avançaram mais rápido do que os sistemas e processos necessários para colocá-las em uso. Às vezes, a peça que falta é um produto. Às vezes, um modelo tem bom desempenho em um benchmark, mas não consegue realizar o trabalho com as variáveis e restrições da vida real.
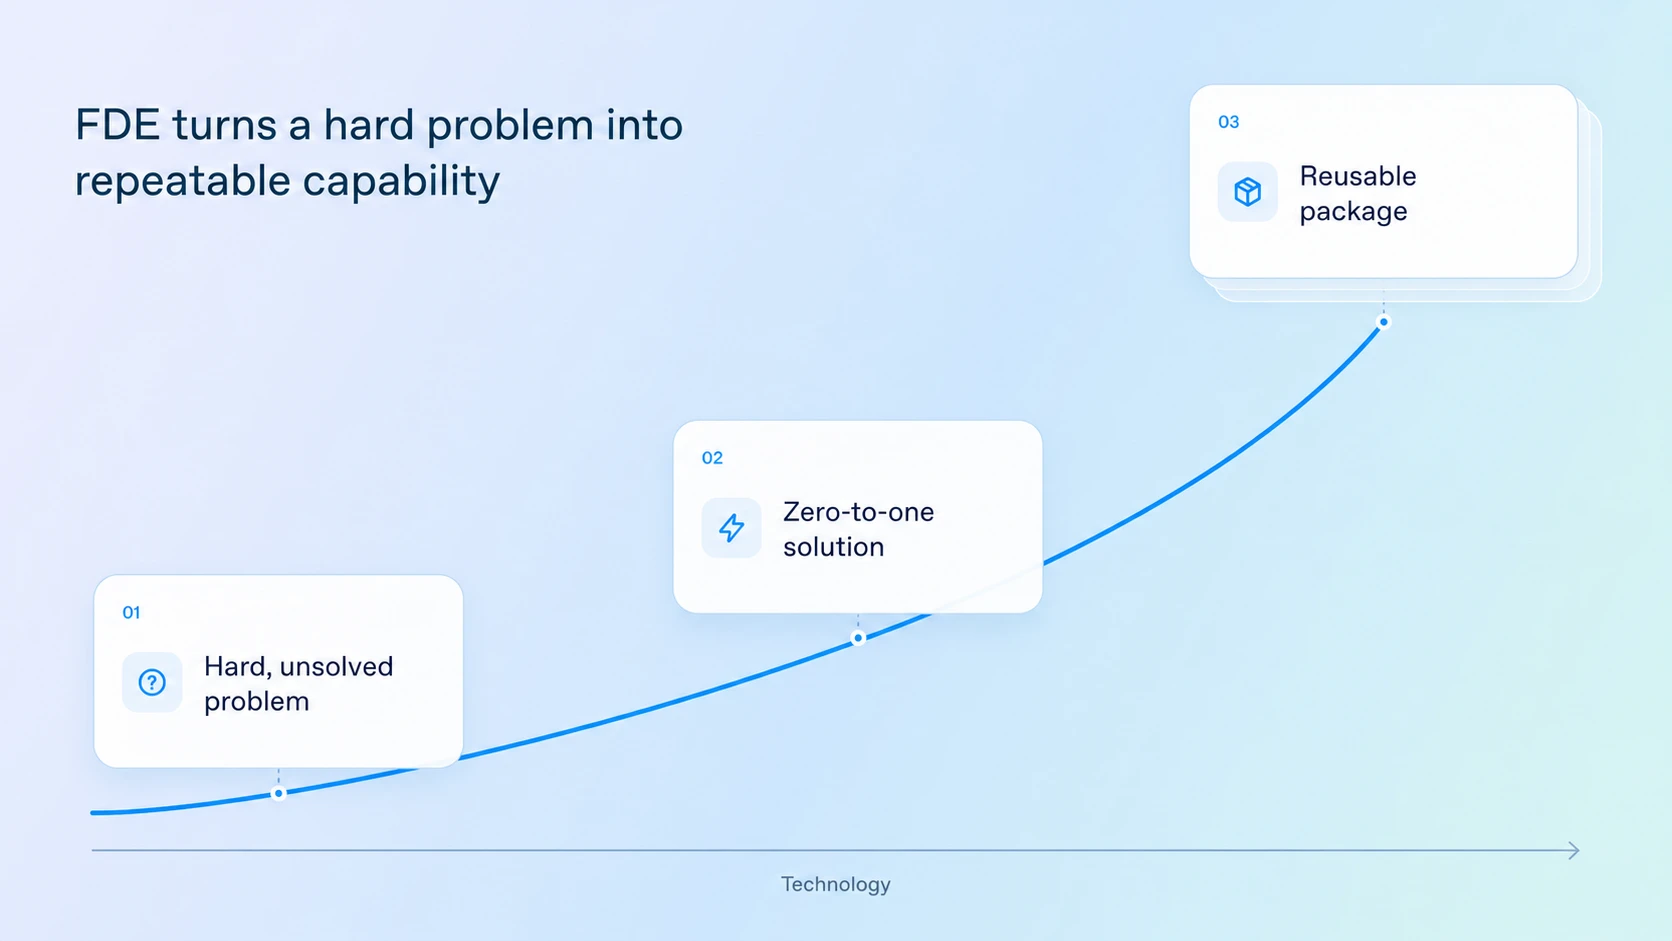
Nosso foco está nos problemas mais difíceis dos clientes. Quando nossos modelos já conseguem realizar o trabalho, colaboramos com a equipe de Produto e com o cliente para tornar a solução replicável. Quando não conseguem, trabalhamos com os clientes e a equipe de Pesquisa para definir a lacuna e implementar melhorias. Nosso objetivo é que cada projeto deixe o próximo cliente com um ponto de partida melhor. Se elevarmos esse patamar a ponto de nossos clientes não precisarem de Forward Deployed Engineers para resolver esse tipo de problema da próxima vez, teremos feito um bom trabalho.
O desafio da John Deere, uma empresa do setor agrícola com 200 anos de história, era oferecer orientação personalizada a agricultores em escala.
Um exemplo é o See & Spray, sua tecnologia de precisão para controle de plantas daninhas, que usa câmeras e aprendizado de máquina para identificar e pulverizar essas plantas, em vez de tratar lavouras inteiras, reduzindo o uso de produtos químicos em até 70%.
Mas concretizar esses benefícios depende de os agricultores saberem configurar a tecnologia, planejar a safra e ajustar suas práticas conforme as condições mudam.
A John Deere implementou as APIs da OpenAI para ajudar a tornar esse suporte personalizado e escalável.
A IA pode responder às perguntas dos agricultores em linguagem natural, oferecer orientações de configuração e recomendações personalizadas, identificar quando os equipamentos podem não estar atingindo todo o seu potencial e ajudar os agricultores a entender o valor que estão obtendo com a tecnologia.
A oportunidade vai além de uma interação isolada: oferecer orientações relevantes ao longo de toda a jornada do cliente, ajudando os agricultores a aproveitar melhor seus equipamentos e a aumentar a eficiência e a sustentabilidade.
Esse é o tipo de desafio que os Forward Deployed Engineers da OpenAI buscam resolver: ajudar organizações a transformar capacidades de IA em sistemas que entreguem valor prático em ambientes complexos do mundo real.
Mas os problemas muitas vezes estão totalmente em aberto, pode não haver uma referência validada, e não existe um roteiro a seguir. Todo mundo quer construir algo que nunca existiu. Menos gente está disposta a fazer o que é preciso para chegar lá.
Encontrar Forward Deployed Engineers talentosos enquanto elevamos o patamar do que é "bom o suficiente" tem exigido experimentação e aplicação constantes.
No início de cada reunião da equipe de Forward Deployed Engineers, apresento um slide com um valor central: "Comece pelo resultado, faça o que for preciso para ter sucesso e, depois, amplie a escala".
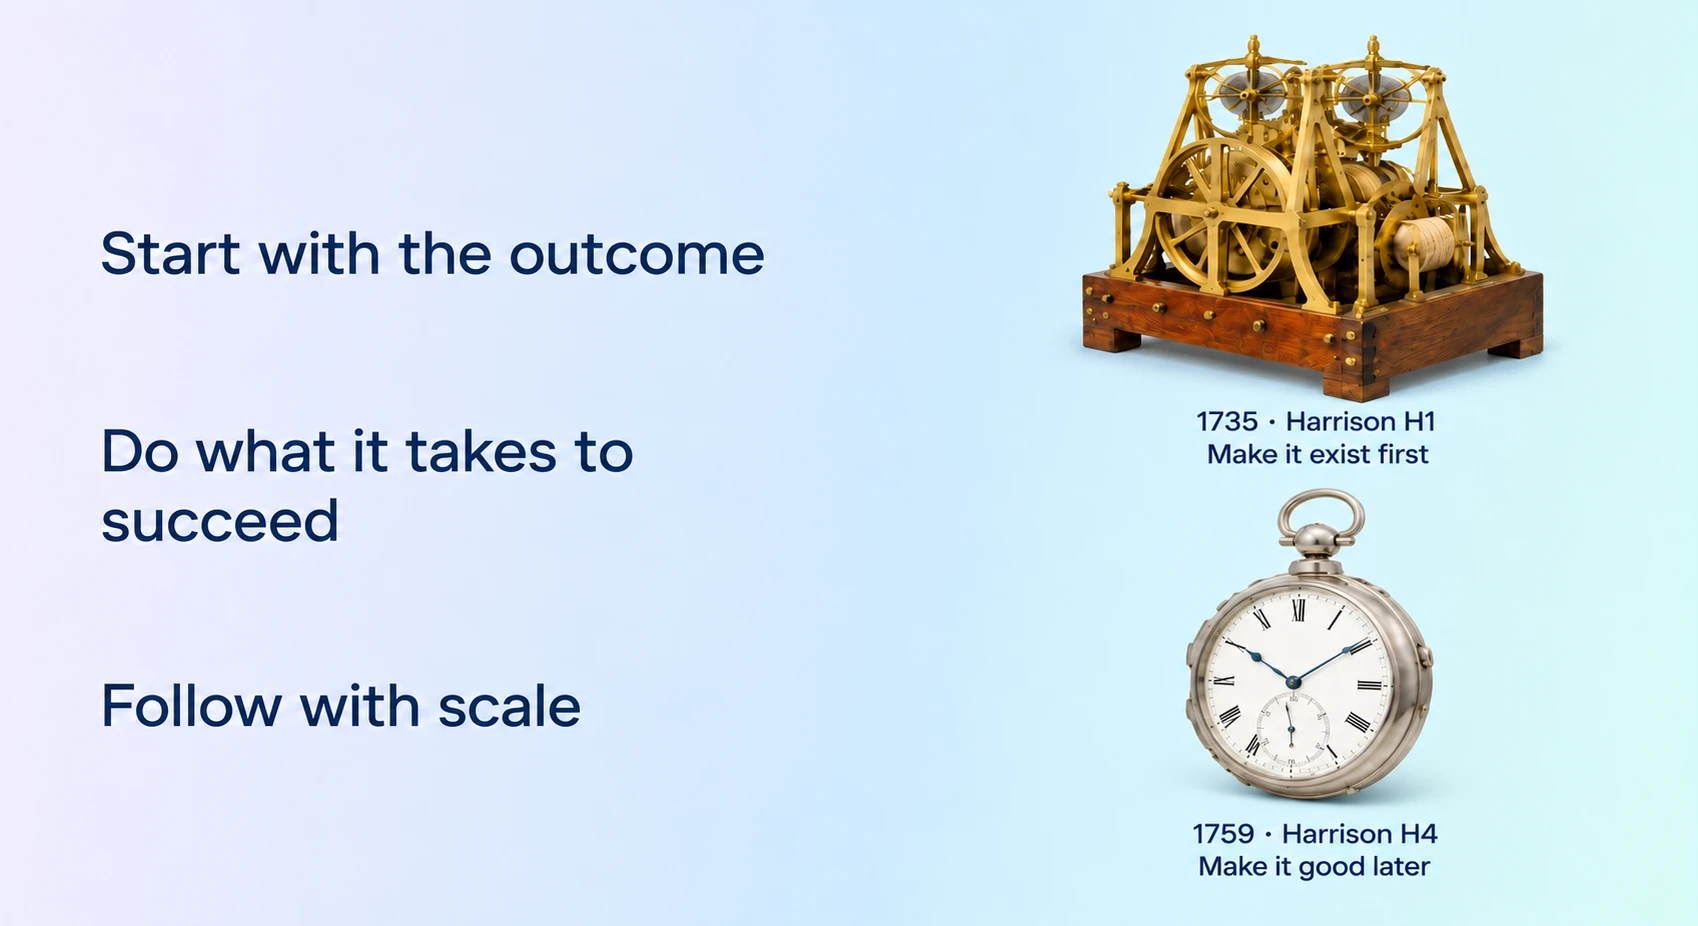
Uma demonstração impressionante pode ganhar muito espaço antes que alguém pergunte se ela funciona no mundo real.
Nosso trabalho é resolver o problema do cliente com um padrão de qualidade que possamos garantir em produção.
Em meados de 2025, tínhamos cerca de 15 Forward Deployed Engineers trabalhando com um grande cliente do setor de semicondutores em mais de 10 casos de uso. A ambição era tornar o processo de verificação do cliente nativo de IA, abrangendo:
Geração de testes direcionados
Análise de causa raiz e depuração
Um assistente de arquitetura
A verificação pode representar cerca de 70% do esforço de um projeto nesse setor. A oportunidade era enorme, e havia muitos pontos de partida possíveis.
Alguns Forward Deployed Engineers haviam entrado na OpenAI poucos dias antes e nunca tinham trabalhado no setor de semicondutores. Eles passaram a atuar junto à equipe de verificação do cliente, estudaram projeto de chips nas horas vagas e criaram avaliações com os engenheiros para testar se a IA conseguia gerar testes úteis e diagnosticar corretamente falhas nos chips.
Em paralelo a esse aprendizado, criamos harnesses personalizados para cada caso de uso. Nos primeiros três a seis meses, todos chegaram à produção e começaram a ser adotados pelos usuários. A recompensa veio ao ver as métricas:
Cerca de 48% de economia de tempo com a geração de testes direcionados por IA.
Melhoria mediana de 22% no desempenho com a otimização de kernels.
Semanas de depuração reduzidas a horas
Quando apresentamos todos esses resultados, o diretor de hardware perguntou: "Vocês trabalhavam como projetistas de chips antes de vir para cá?"
Nossos Forward Deployed Engineers não precisam conhecer o setor no primeiro dia, mas é responsabilidade deles aprender.
À medida que os assistentes de programação aceleram o desenvolvimento de software, entender o negócio do cliente se torna ainda mais importante. Formamos equipes que combinam generalistas e especialistas de cada área.
É preciso ter conhecimento suficiente para tomar decisões bem fundamentadas e curiosidade suficiente para questionar as premissas sobre o status quo.
Nas ciências da vida, por exemplo, a formação científica dos nossos Forward Deployed Engineers os ajuda a conquistar a confiança de pesquisadores que trabalham em tarefas pré-clínicas de descoberta de medicamentos, como validação e priorização de alvos, análise de expressão gênica e reconstrução de rotas de síntese química. Esse conhecimento permite que eles contribuam com análises fundamentadas sobre como melhorar esses fluxos de trabalho.
Havíamos mostrado que esses fluxos de trabalho podiam gerar valor, mas cada um ainda exigia muita integração personalizada para ser estendido a outra equipe. O próximo desafio era preservar esses resultados e, ao mesmo tempo, facilitar a implantação e a manutenção do software.
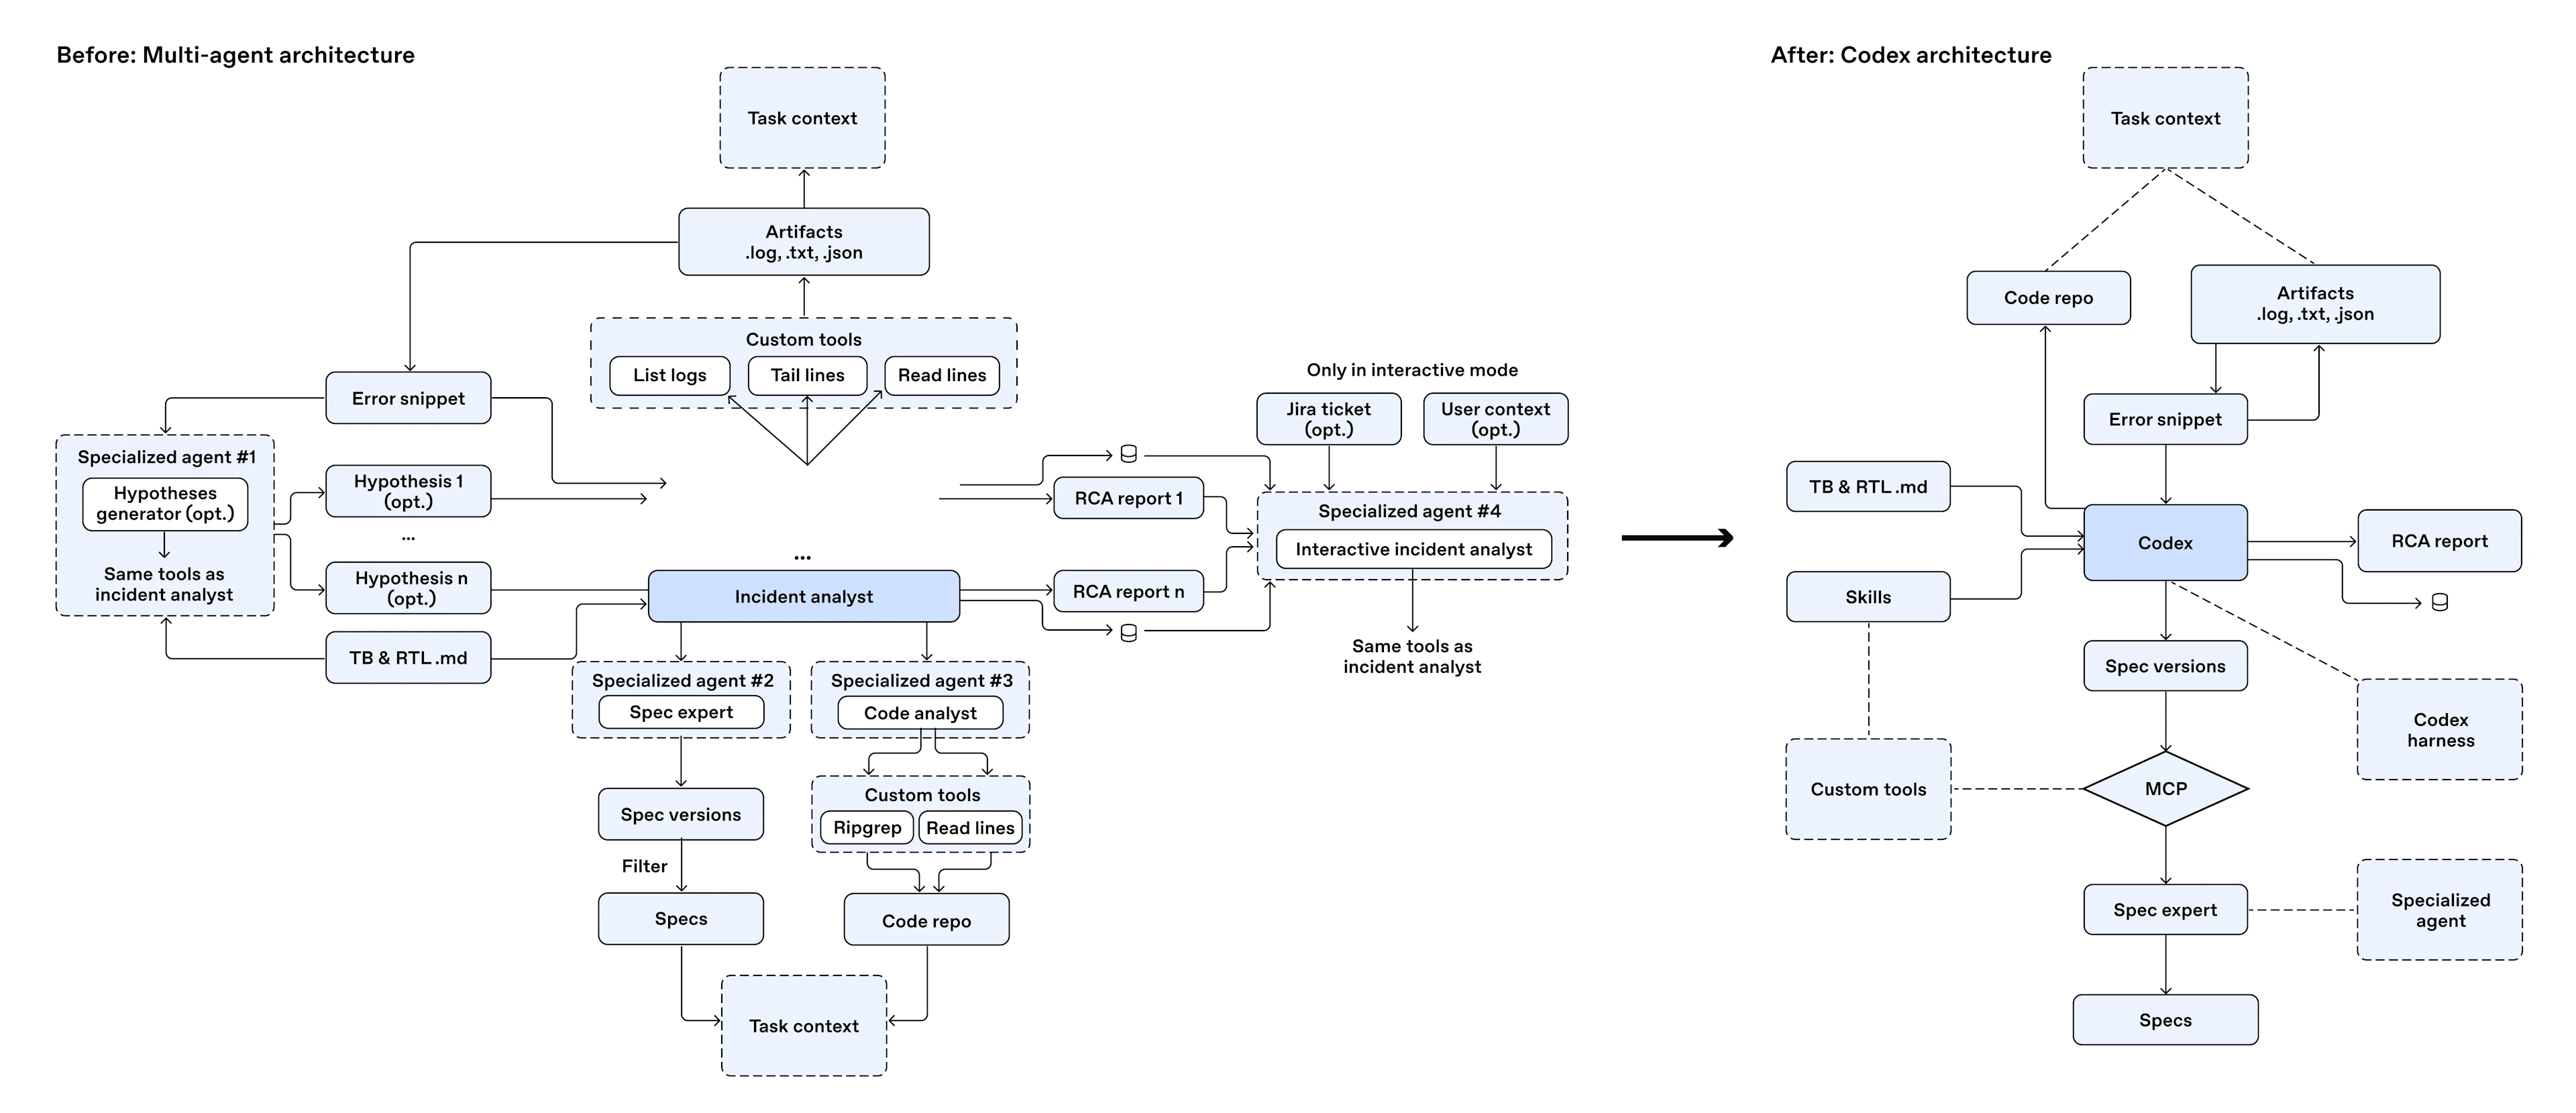
A essa altura, o Codex já havia ampliado suas capacidades. Um Forward Deployed Engineer testou reconstruir a aplicação com base nele e, depois, trabalhou com a equipe para migrar os casos de uso para um harness comum, com o Codex no centro.
Aplicações personalizadas se tornaram plugins e skills criados sobre primitivas comuns do Codex. O Codex também se tornou a interface, permitindo desativar as interfaces de terminal e de linha de comando separadas que havíamos criado para cada caso de uso.
Conseguimos remover cerca de 90% do código personalizado de cada projeto, e isso mudou a forma como construíamos, mantínhamos e escalávamos esses fluxos de trabalho:
Podíamos aproveitar as melhorias centralizadas do Codex, reduzindo a quantidade de código de integração necessária para cada caso de uso
As principais funcionalidades foram agrupadas em skills e plugins, facilitando o compartilhamento entre equipes e o controle centralizado pelo Centro de Excelência em IA. Isso significava que estender a solução de uma equipe para outra podia ser tão simples quanto trocar os conectores e servidores MCP, criar novas avaliações — para as quais também tínhamos uma skill — e começar a usar.
Em um exemplo de agosto de 2026, a implantação inicial levou dois meses. Estender a solução a uma segunda equipe levou um dia. À medida que ampliávamos a escala, as equipes seguintes começavam a usar a solução mais rapidamente. Essa tendência continuou: em um caso de uso de agosto de 2026, a segunda equipe levou um dia para começar, enquanto a implantação inicial havia levado dois meses.
Essa é uma forma de nos tornarmos obsoletos. O trabalho que fizemos para chegar à produção estabeleceu o que realmente importava. À medida que o produto de base melhorava, podíamos substituir grande parte da nossa implementação personalizada e preservar o valor que ela entregava.
É por isso que a ordem importa. Os LLMs nos permitem construir rápido. Use essa velocidade para colocar algo valioso nas mãos dos usuários, descobrir o que se sustenta na prática e, depois, ampliar a escala do que funciona.
O mesmo princípio se aplica a todos os projetos com clientes.
O OpenAI Presence, nosso produto para agentes de voz e chat corporativos, surgiu de implantações reais em clientes. O trabalho começou com o Swarm(abre em uma nova janela) e evoluiu através do A API de agentes e, hoje, um cliente já gerencia mais da metade de suas chamadas com IA.
Ao colocar essas implementações em produção, aprendemos quais problemas exigiam uma solução personalizada e quais componentes básicos outras equipes poderiam usar. Incorporamos esses elementos básicos ao Presence, facilitando para os desenvolvedores a automação de fluxos de trabalho regulamentados sem a necessidade de reconstruir a infraestrutura subjacente. Cada implementação ajudou a moldar o produto e proporcionou ao próximo cliente um ponto de partida melhor.
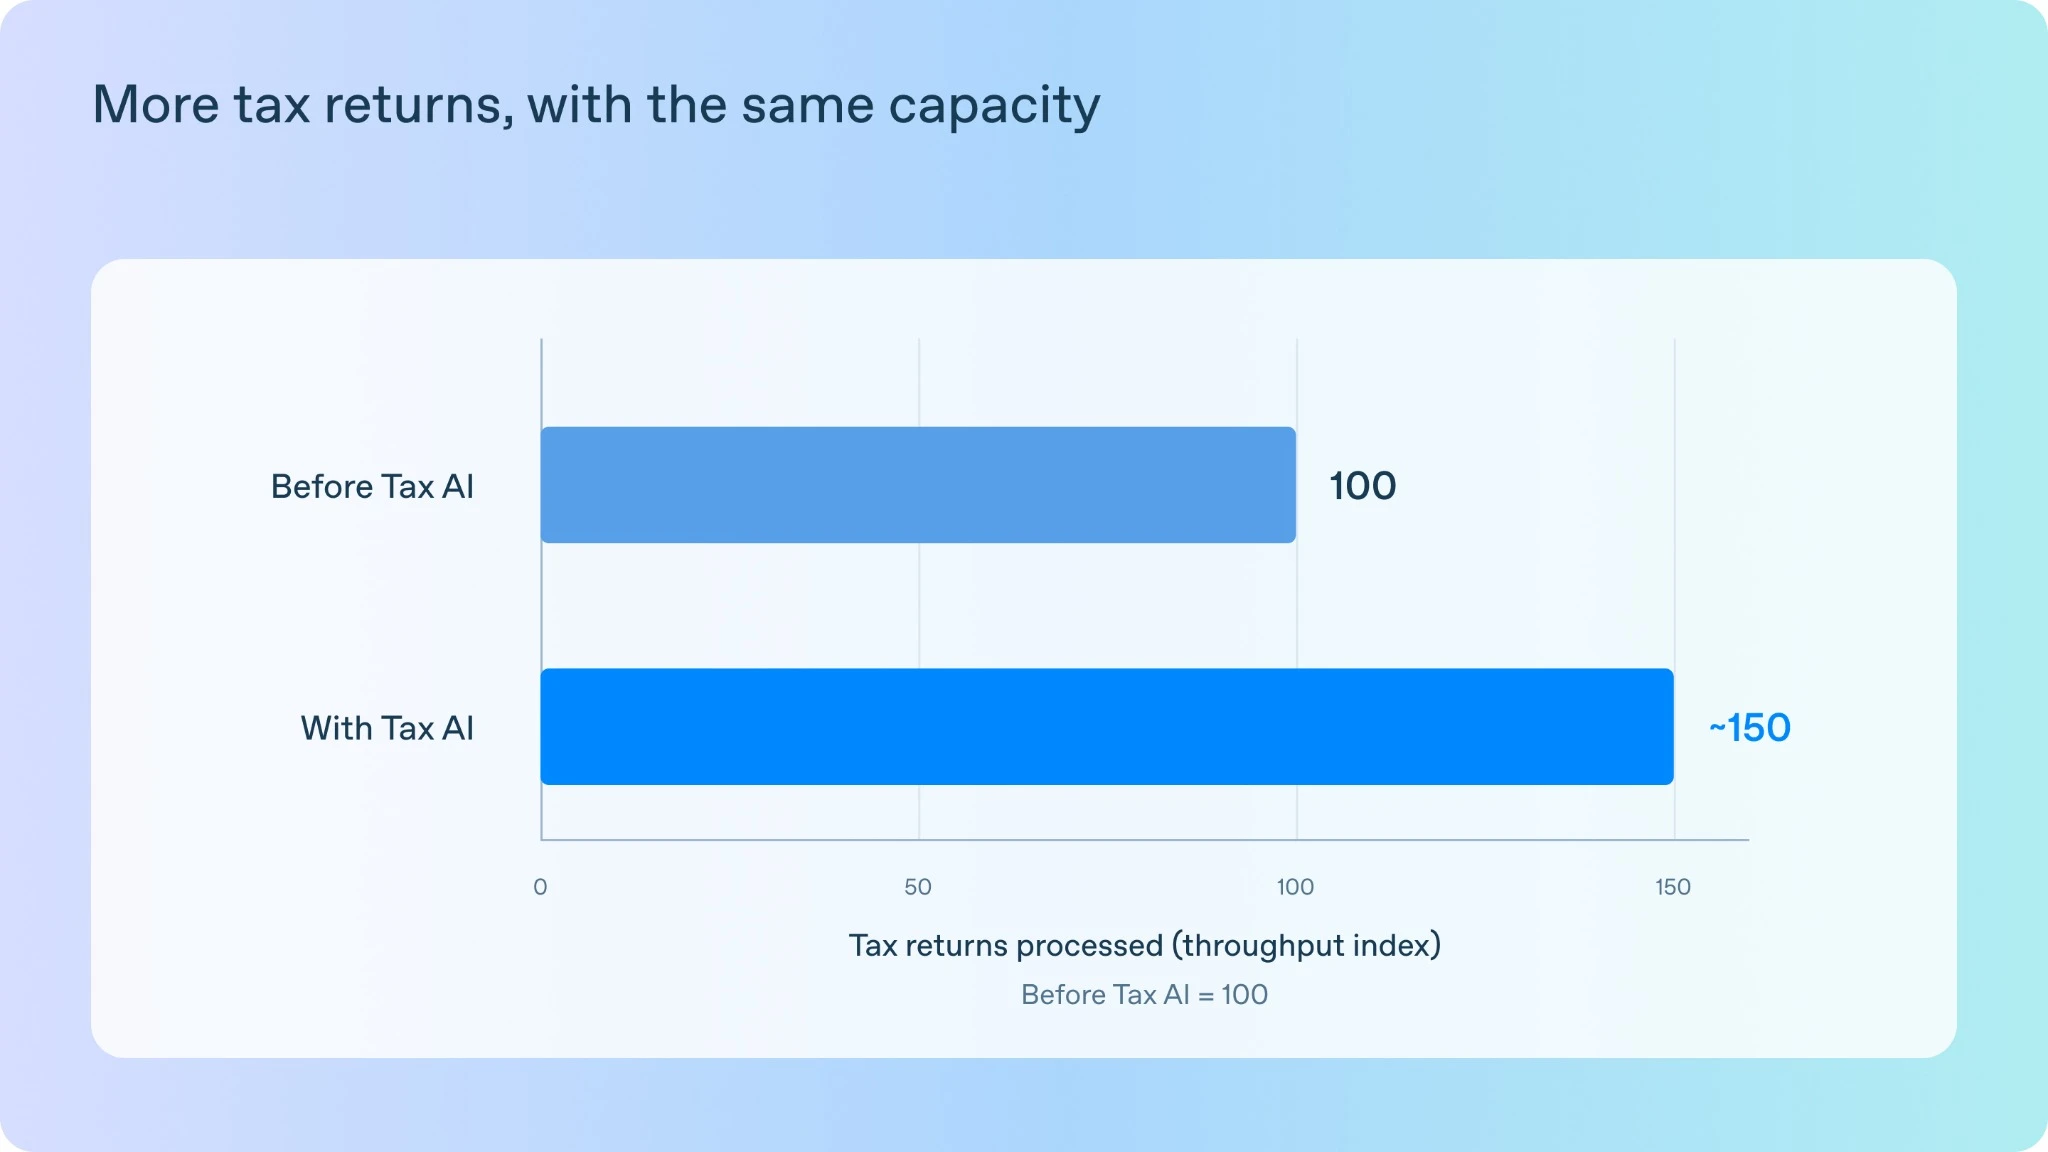
Com A Thrive Holdings, os funcionários de desenvolvimento de campo (FDEs) da OpenAI e pesquisadores trabalharam em conjunto com engenheiros e contadores para desenvolver uma IA tributária para escritórios de contabilidade em Creta. Durante o projeto piloto, a Tax IA processou 7.000 declarações de impostos e aumentou a taxa de processamento em cerca de 50%.
Um dos maiores desafios foi automatizar a declaração de impostos sobre imóveis alugados, o que exigiu seis semanas de revisão por engenheiros e profissionais da área para atingir 90% de precisão e recall. O trabalho criou padrões reutilizáveis que facilitaram a extensão da IA Tributária a outras tabelas tributárias complexas.
As equipes agora estão aplicando a mesma abordagem à contabilidade, auditoria e suporte de TI — construindo sistemas que melhoram por meio do feedback dos profissionais e do uso no mundo real.
Às vezes, um produto melhor nos permite simplificar o que construímos, mas, em outras, o próprio modelo ainda não consegue realizar o trabalho.
Se construirmos apenas o que os modelos atuais já permitem, não descobriremos as lacunas de inteligência que a equipe de Pesquisa precisa superar a seguir. Por isso, muitos dos nossos projetos importantes começam nesses limites, com o cliente, os Forward Deployed Engineers e a equipe de Pesquisa comprometidos em superá-los juntos.
Já havíamos desenvolvido uma plataforma de atendimento ao cliente com uma grande empresa de telecomunicações, e ela queria estendê-la ao atendimento por voz.
O atendimento por voz representava cerca de 90% do volume de atendimento ao cliente da empresa. Resolver esses casos sem intervenção humana custava mais do que no chat e trazia novos desafios técnicos: lidar com sotaques, acertar o tom e atingir níveis de latência e precisão adequados para produção. Acertar nisso faria uma diferença significativa para o negócio.
Durante a definição do escopo, nosso modelo obteve cerca de 60% nas principais avaliações que usávamos para verificar se ele conseguiria realizar o trabalho em produção. Havíamos chegado ao limite das suas capacidades. Era preciso melhorar a chamada de função e o cumprimento de instruções em cenários de atendimento ao cliente.
Explicamos isso ao cliente e envolvemos a equipe de Pesquisa no trabalho. A equipe de Forward Deployed Engineers trabalhou com o cliente para construir a plataforma e definir o que o modelo precisava fazer. A equipe de Pesquisa trabalhou para suprir as lacunas de capacidade, e versões sucessivas do modelo nos permitiram testar o progresso em relação aos requisitos do cliente.
Ao longo de seis meses, o desempenho nas principais avaliações passou de cerca de 60% para 80% e, depois, para mais de 90%, atingindo os níveis necessários para produção.
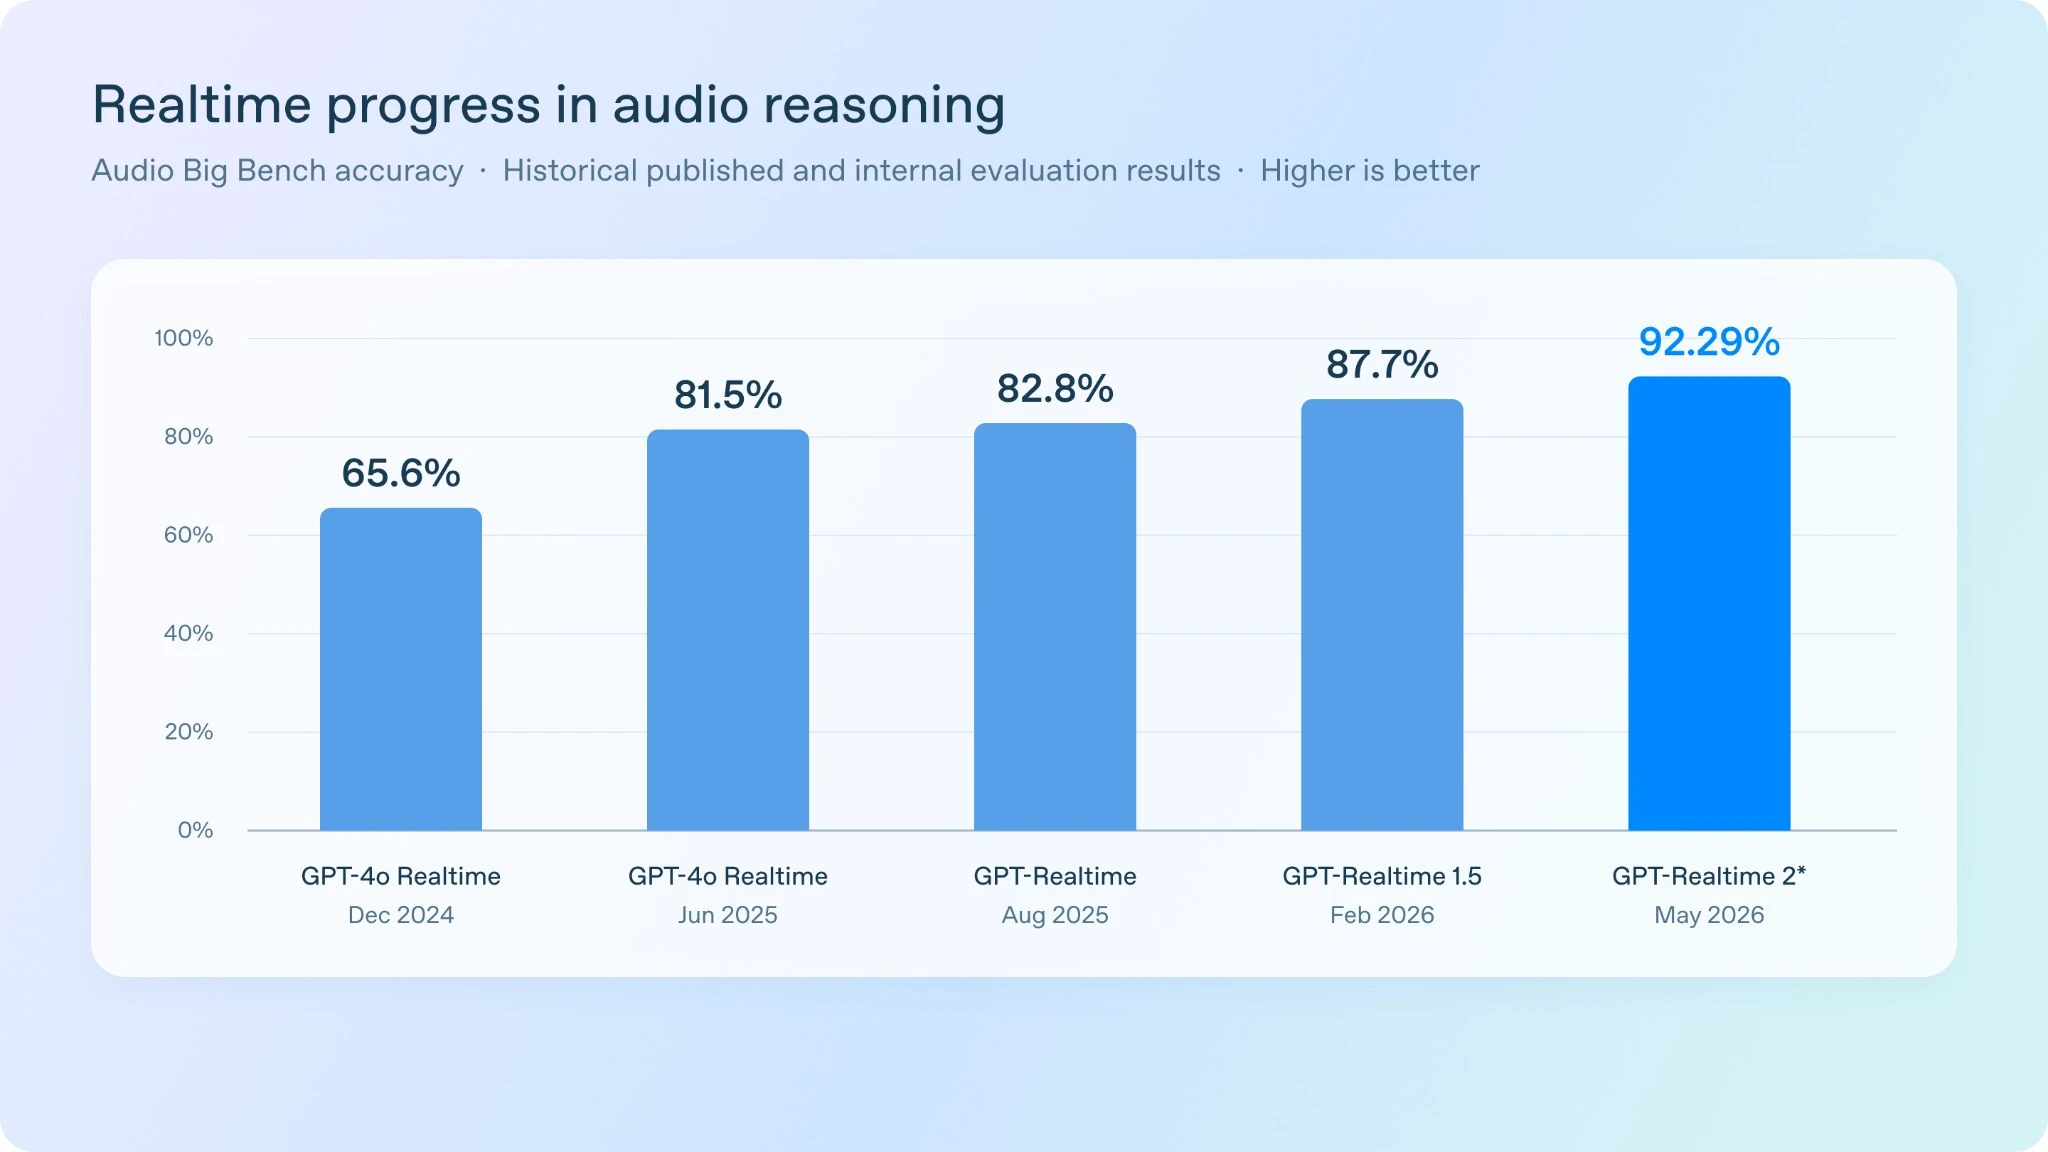
O modelo de voz resultante agora dá suporte à implantação desse cliente, a outras implantações personalizadas de atendimento ao cliente e a implantações gerenciadas pelo Presence. Um problema encontrado no negócio de um cliente ajudou a identificar melhorias que poderiam atender a muitos outros.
Cada parte foi importante. O cliente se comprometeu a trabalhar em um problema que o modelo ainda não conseguia resolver. A equipe de Forward Deployed Engineers acompanhou o trabalho de perto para definir o problema, construir a plataforma e conduzir o projeto do início ao fim. A equipe de Pesquisa aprimorou as capacidades fundamentais do modelo.
Essa é a outra forma de nos tornarmos obsoletos: ajudar a transformar um problema que os modelos atuais não conseguem resolver em uma capacidade que os modelos futuros poderão oferecer. O retorno do nosso trabalho vai além das horas que dedicamos a cada cliente.
Entrei na OpenAI para ajudar a tornar a IA útil no trabalho cotidiano das pessoas. Isso continua guiando a equipe. Costumo dizer à equipe que, na maioria dos casos de desenvolvimento de LLMs, a navalha de Occam se aplica: a solução mais simples é a melhor. Em uma empresa que se define pela pesquisa de ponta e em um setor marcado por exageros, queremos construir soluções que funcionem de forma confiável e nas quais os profissionais possam confiar no dia a dia.
O objetivo é que cada projeto melhore o que vem depois: um produto mais fácil de implantar, um modelo capaz de lidar com uma tarefa mais difícil ou menos trabalho personalizado para o próximo cliente.
Se você tem um problema difícil que quer resolver, adoraríamos trabalhar com você. Se você quer ajudar a resolver esses problemas, adoraríamos ter você na equipe.
Então, o que fazemos quando o Codex consegue dar conta do trabalho que levamos meses para desenvolver?
Vamos em busca do problema mais difícil.