מדידה מדויקת של יכולות המודלים שלנו חשובה לקבלת החלטות מבוססות בנושאי פריסה ובטיחות, לרבות החלטות במסגרת Preparedness Framework(נפתח בחלון חדש) של OpenAI. עם כל השקת מודל, אנו מדווחים על תוצאות במגוון מבחני השוואה חיצוניים ופנימיים כדי לעקוב אחר התקדמות המודלים. כאשר יש בהערכות ליקויים המשפיעים על התוצאות, הן עלולות ליצור תמונה שגויה של היכולות, לעוות את הבסיס להצדקת הבטיחות ולהשפיע על סדרי העדיפויות במחקר.
לאחרונה בדקנו בעיות יסוד בתכנון ובזיהום נתונים ב-SWE-bench Verified, אחד ממבחני ההשוואה הנפוצים ביותר לתכנות, ומצאנו שההערכה כבר אינה מספקת מידע משמעותי על יכולות פיתוח תוכנה. באותה עת עודדנו את הקהילה הרחבה לעבור ל-SWE-Bench Pro.
SWE-Bench Pro(נפתח בחלון חדש) נועד לשפר את SWE-bench Verified באמצעות בחינת מודלים במשימות תכנות ממושכות יותר ומציאותיות יותר, כדי לעקוב טוב יותר אחר יכולות תכנות אג'נטי. כמו ב-SWE-bench Verified, המשימות מופקות באופן תוכנתי מהיסטוריית השינויים בתכונות של תוכנות במאגרים ציבוריים ופרטיים. המודלים נדרשים לממש פתרון שעובר בדיקות חדשות לתכונה מסוימת, בלי לפגוע בפונקציונליות הקיימת. בתת-הקבוצה הציבורית, הכוללת 731 משימות, מודלים בחזית התחום השתפרו משיעור הצלחה של 23.3% ל-80.3% בתוך שמונה חודשים.
מאז ערכנו ביקורת דומה על SWE-Bench Pro, ובחנו את מערך הנתונים באמצעות תהליך לניתוח פריטי נתונים. התהליך בחן ניסיונות של מודלים לבצע את המשימה, מטא-נתונים של המשימה ותיעוד כשלים, כדי לסמן ליקויים אפשריים בהערכה. לאחר מכן, כל משימה שסומנה נבדקה בכמה סבבים של סוכני חקירה ונסקרה באופן עצמאי בידי חמישה מהנדסי תוכנה מנוסים. מקרים של אי-הסכמה הועברו להמשך בירור.
מצאנו עדויות לבעיות שפוסלות משימות בחלק ניכר ממערך הנתונים. תהליך ניתוח פריטי הנתונים שלנו סימן 200 משימות פגומות (27.4%), ואילו מיזם התיוג האנושי זיהה 249 משימות כאלה (34.1%).
הבעיות השתייכו בעיקר לארבע קטגוריות:
בדיקות מחמירות מדי1 אוכפות פרטי מימוש מסוימים שאינם מצוינים בפרומפט, ופוסלות פתרונות רבים שנכונים מבחינה תפקודית.
פרומפטים לא מפורטים דיים2 משמיטים דרישות שהבדיקות הסמויות אוכפות ושאי אפשר להסיק באופן סביר.
בדיקות עם כיסוי חלקי אינן בודקות את התכונה המבוקשת במידה מספקת, ולכן גם תיקונים לא שלמים יכולים לעבור אותן.
פרומפט מטעה מכוון מודלים להתנהגות שגויה או סותר את דרישות הבדיקות.
הממצאים שלנו מצביעים על הקושי לבנות מבחני השוואה מאתגרים אך הוגנים, ועל התועלת הגוברת של סוכנים בבדיקות איכות נתונים בהיקף נרחב. לאור התוצאות, אנו מעריכים שכ-30% מהמשימות ב-SWE-bench Pro פגומות, וממליצים למפתחי מודלים לבחון את התוצאות בזהירות.
מטרתנו היא להבטיח שכישלונות במשימות ישקפו מגבלות אמיתיות של המודל, ושהצלחות במשימות ישקפו פתרונות שלמים ותקפים לדרישות הפרומפט. כדי לבדוק את איכות הנתונים המשמשים להערכה, יצרנו תהליך אבטחת איכות שבוחן אם כל פריט נתונים משקף במדויק את יכולות המודל.
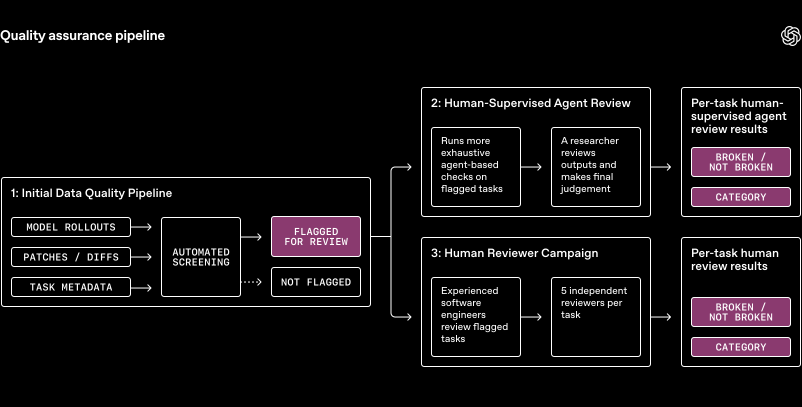
תהליך ראשוני לבדיקת איכות הנתונים מסמן בעיות לסקירה. אנו מאמתים את הממצאים באמצעות ביקורת מעמיקה יותר של המשימות שסומנו בסיוע סוכנים, ובאמצעות מיזם תיוג אנושי בשיתוף מהנדסים מנוסים.
מסנן אוטומטי ראשוני בוחן את ההוראות שניתנו למודל, את ניסיונותיו לפתור את המשימה ואת הבדיקות המשמשות למתן ציון לניסיונות האלה, כדי לסמן דוגמאות שיש חשד שהן פגומות או בעייתיות. המסנן סימן 286 משימות שעשויות להיות פגומות. לאחר מכן ערכנו סקירה מעמיקה יותר של תת-הקבוצה הזו בשתי דרכים: סקירה באמצעות סוכנים בפיקוח אנושי, הכוללת בדיקות נרחבות בעזרת סוכני חקירה והכרעה אנושית סופית; ומיזם תיוג אנושי בשיתוף מפתחי תוכנה מנוסים.
כל בעיה שסומנה נבדקת באמצעות סוכני חקירה מבוססי Codex, שקיבלו גישה למאגר ולסביבה של המשימה. כך הם יכולים להבחין בין עמימות סבירה במשימה, שלרוב אפשר לפתור באמצעות עיון בקוד סמוך ובמוסכמות המאגר, לבין חוסר אמיתי בפירוט הדרישות. הסוכן יכול להריץ בדיקות, לבחון קבצים במאגר ולחקור את ניסיונות המודלים ואת סוגי הכשלים הנפוצים שלהם במשימה. לאחר כמה חזרות עצמאיות על הביקורות המעמיקות האלה, חוקר סקר את הסיכומים, קיבל החלטה סופית ותייג את הבעיות הסבירות.
במקביל, ערכנו מיזם תיוג אנושי של תת-הקבוצה שסומנה. עבדנו עם מהנדסי תוכנה מנוסים, שלפני סקירת המשימות קיבלו הכשרה בנושא מטרות מבחן ההשוואה, סיווג הבעיות ומקרי קצה. כל משימה נסקרה בידי חמישה מהנדסים.
הסוקרים גיבשו חוות דעת עצמאית על סמך תיאור הבעיה הגלוי, מקרי הבדיקה ופתרון הייחוס שנחשב לנכון (המכונה gold patch), לפני שנעזרו בניתוח שהפיק התהליך או בתמליל כהקשר תומך. לאחר מכן הסוקרים הקצו תווית ודירוג חומרה על סמך ראיות קונקרטיות, והעבירו לסקירה נוספת מקרים של אי-הסכמה או של רמת ביטחון נמוכה בקביעה.
סוקרים אנושיים נטו לסמן משימות כפגומות יותר מסוכני החקירה. הייתה גם אי-הסכמה מסוימת בין שני מסלולי הסקירה בנוגע לקטגוריות, אך באף משימה שסומנה לא הייתה ״לא פגומה״ התווית הנפוצה ביותר שהעניקו הסוקרים האנושיים. ב-74% מהמקרים הייתה התאמה בין הקטגוריות שסומנו בתהליך הסקירה באמצעות סוכנים לבין קביעות הסוקרים.
בהשוואה לתהליך הסקירה באמצעות סוכנים, הסוקרים האנושיים גם נטו יותר לבחור כמה תוויות למשימה. הדבר מצביע על כך שמצאו במשימות כמה סוגי פגמים, או שהמשימות לא התאימו באופן מובהק לקטגוריה אחת. מכאן עולה שהתהליך המשלב סוכנים וסוקר הוביל לתיוג שמרני: הוא זיהה את אותם סוגי כשלים כלליים שזיהו בני האדם, אך מנה פחות מקרים שבהם הסוקרים זיהו בעיות נוספות או חופפות. הפער הגדול ביותר היה בבדיקות עם כיסוי חלקי: הסוקרים האנושיים בחרו בהן כבעיה הנפוצה ביותר ב-9.4% ממשימות מבחן ההשוואה, לעומת 4.1% בתהליך הסקירה באמצעות סוכנים.
סוגי כשלים
הבעיות שזיהינו, לצד מקרים דומים ב-SWE-bench Verified, מדגישות את החשיבות של בדיקה קפדנית של מבחני השוואה. דיווחי בעיות ובקשות משיכה במאגרי קוד פתוח נוצרו במקור לצורך שיתוף פעולה בין בני אדם, לעיתים במסגרת התכתבויות ממושכות בין מתחזקי הפרויקט לבין התורמים לו. כתוצאה מכך, תיאורי הבעיות, הקוד שמוזג ובדיקות היחידה לא תמיד תואמים זה לזה באופן שיוצר משימות ברורות ומבודדות להערכה מהימנה של מודלים. בפרט, בדיקות שנכללות בבקשות משיכה עלולות להיות מחמירות מדי, משום שהן נכתבות כדי לאמת שינוי מסוים, ולא כדי להגדיר אמת מידה לפתרון המשימה שאינה תלויה במימוש.
בה בעת, כיום קל יותר לזהות ליקויים בהערכה מאשר אפילו לפני זמן קצר. ככל שיכולות המודלים משתפרות, אפשר להשתמש בהם כדי לבחון פרומפטים, בדיקות, תיקוני קוד, תיעודי ריצה ומקרי קצה באופן מעמיק ועקבי הרבה יותר. כך אפשר לחשוף בעיות במבחני השוואה שבעבר היה יקר או לא מעשי לאתר בהיקף נרחב.
אנו מקווים שקהילת ההערכה הרחבה תפתח מבחני השוואה חדשים, שייבנו בידי מפתחי תוכנה מנוסים במיוחד כדי לבחון יכולות של מודלים. גישה זו יכולה לשמר את הרף הגבוה ואת הקרבה למציאות שאנו מבקשים במדידת יכולות המודלים, ומאפשרת פיקוח אנושי טוב יותר לאורך התהליך. לאור הבעיות שנחשפו בניתוח זה, אנו חוזרים בנו מהמלצתנו הקודמת לאמץ את SWE-Bench Pro.
בסופו של דבר, הערכה צריכה לספק מידע משמעותי באמצעות מבחני השוואה שקשה לתמרן, שקל לתת בהם אמון ושמשקפים באמת את יכולות המודל או את מידת התאמתו לכוונות ולערכים אנושיים. מאחר שהתוצאות האלה משמשות בסיס להחלטות הפריסה והבטיחות של OpenAI, ההערכות שאנו עוקבים אחריהן צריכות להיות תקפות ולספק מידע מועיל.