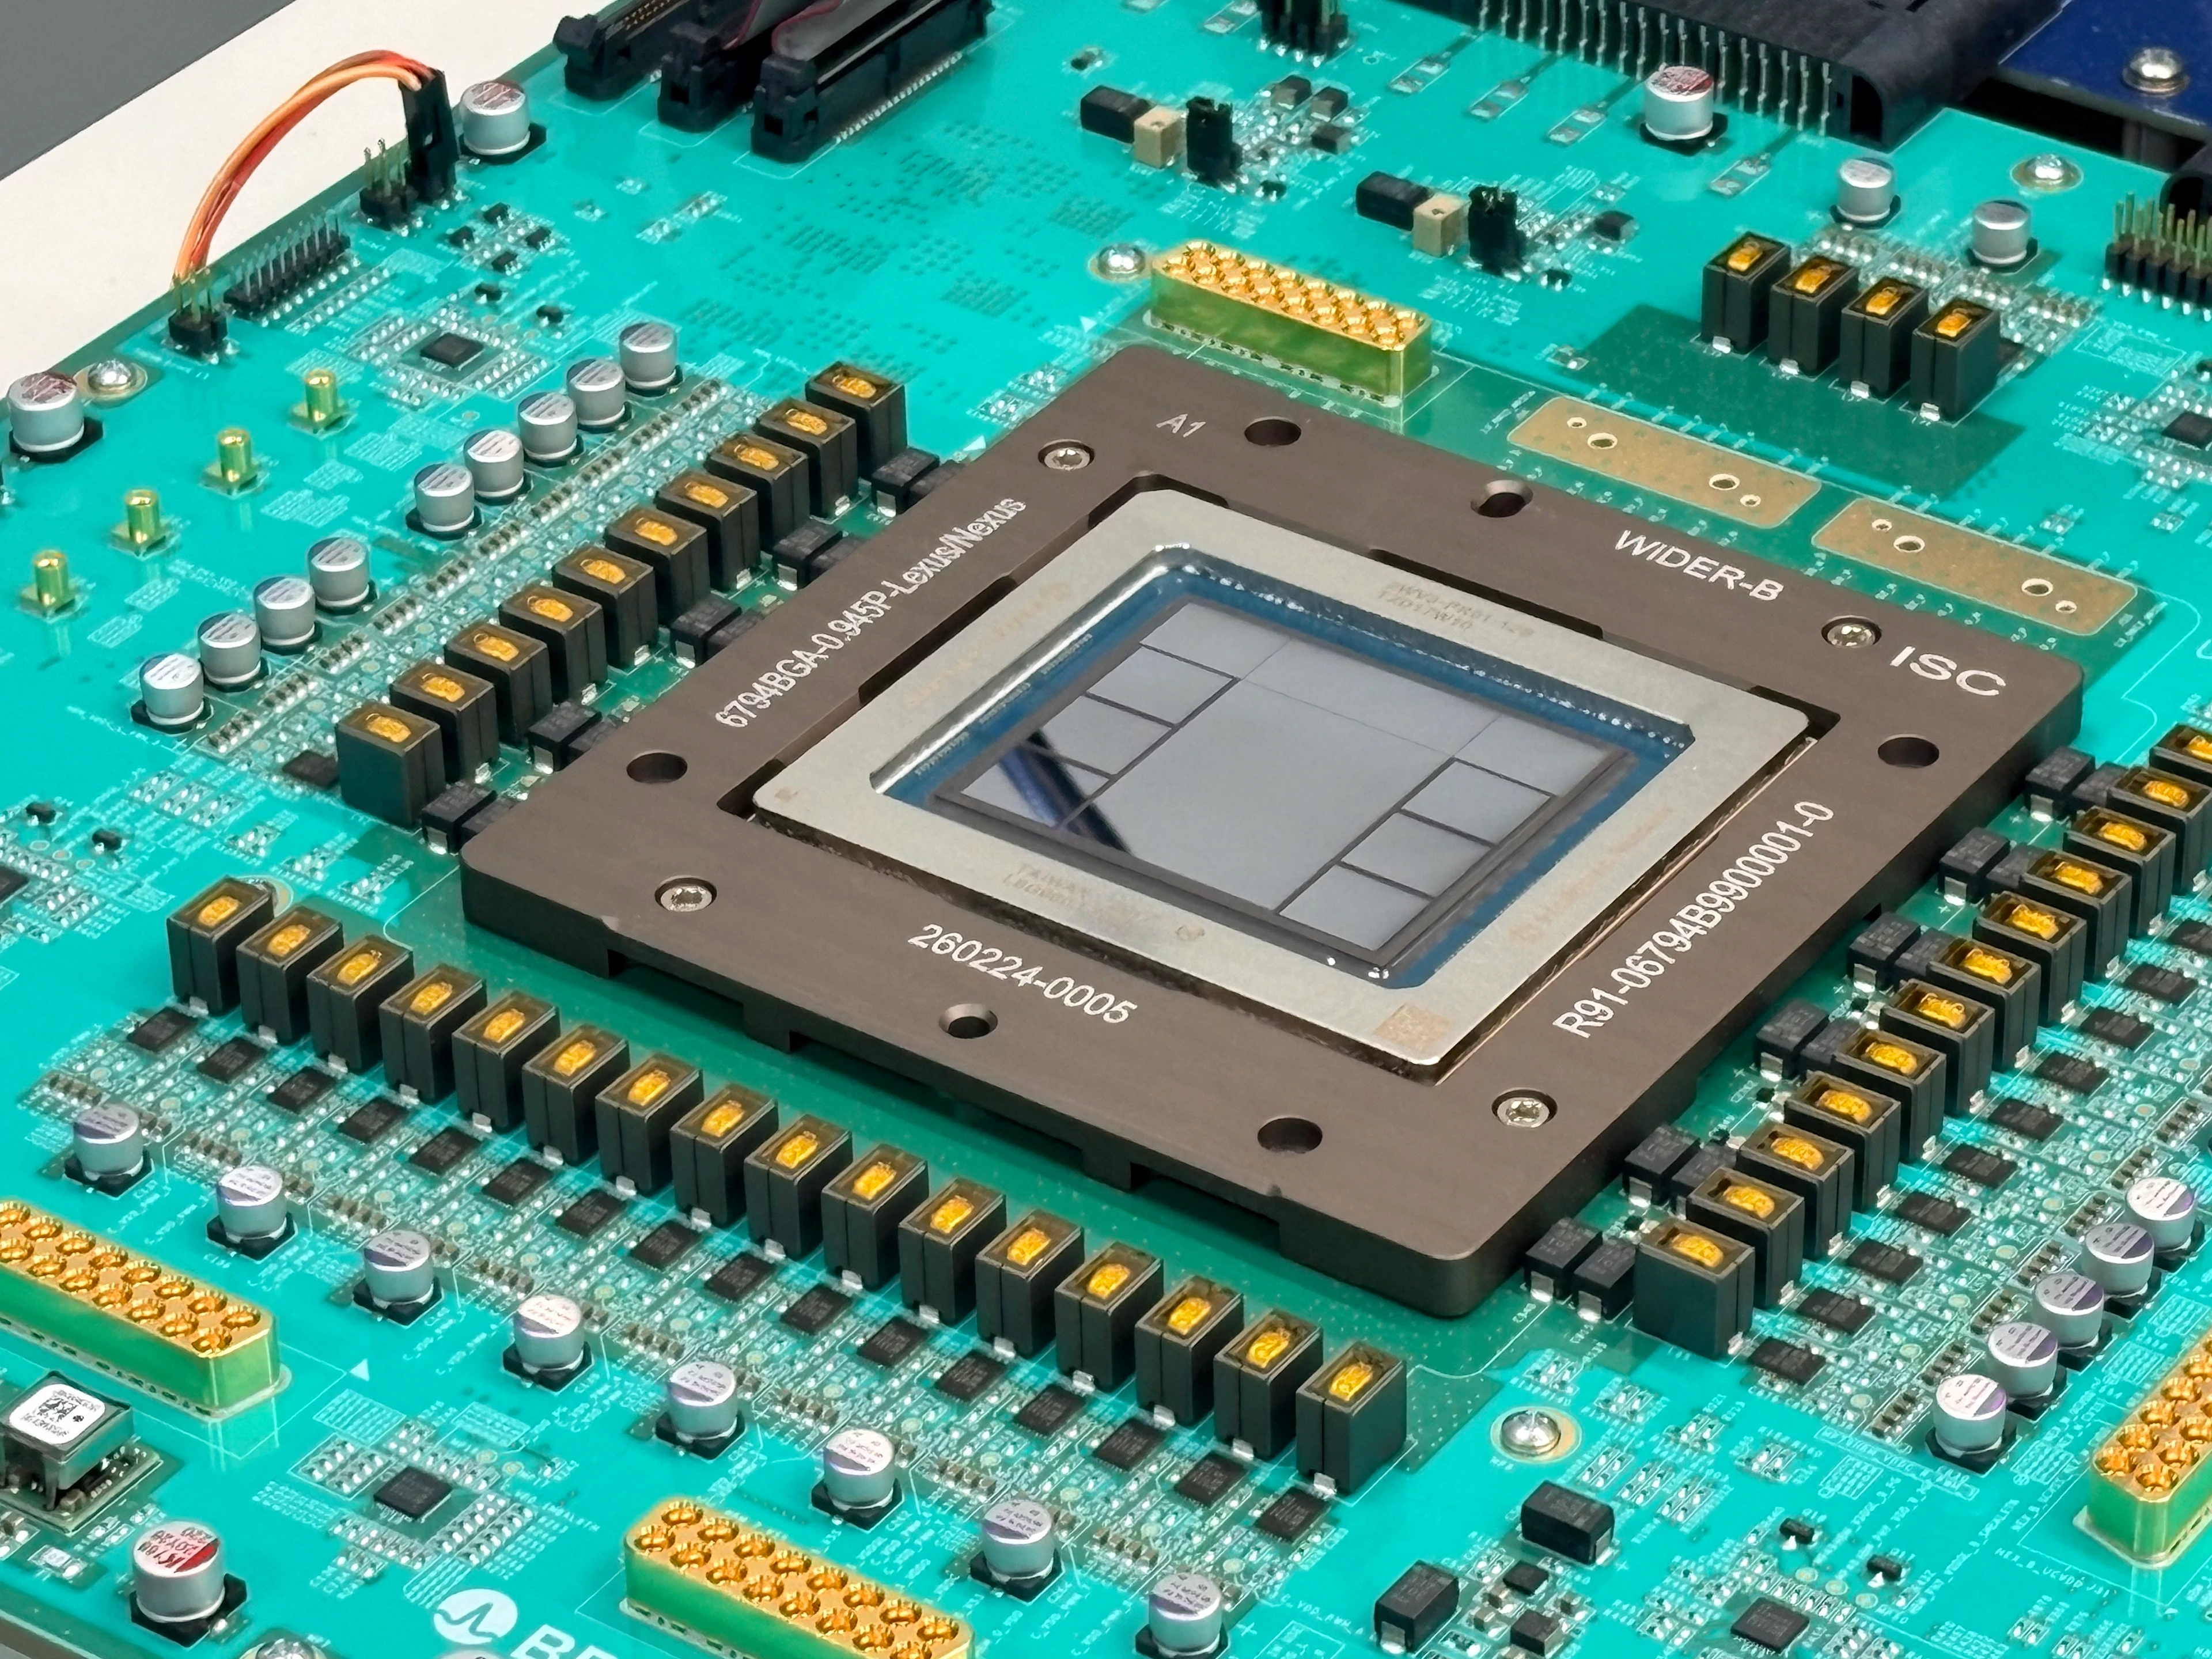
מאז ההכרזה על Jalapeño, שבב ההסקה הראשון שתוכנן במיוחד עבור OpenAI, אנחנו בודקים את השבב ואת המערכת שנבנתה סביבו. התוצאות מראות התקדמות משמעותית בביצועים: Jalapeño יכול לבצע יותר עבודת בינה מלאכותית ליחידת הספק, ובמקביל להחזיר תשובות מהר יותר. Jalapeño מספק גם תפוקה גבוהה יותר וגם זמן השהיה קצר יותר בארכיטקטורה אחת, בעוד שמערכות חומרה קיימות נאלצות לעיתים קרובות להתפשר על אחד לטובת האחר.
עבור לקוחות, המשמעות יכולה להיות תשובות מהירות יותר, סוכנים תגובתיים יותר וגישה אמינה יותר לשירות גם כשהביקוש גדל. המשימה שלנו היא להבטיח שבינה מלאכותית כללית תועיל לאנושות כולה. השיפורים האלה יעזרו להפוך בינה מלאכותית בעלת יכולות הולכות וגדלות לזולה יותר ולזמינה לקהל רחב יותר.
המודלים של OpenAI גם האיצו את הפיתוח של Jalapeño. דורות קודמים עזרו לצוות לתכנן את השבב ולהביא אותו להפעלה ראשונית, והמודלים העדכניים שלנו מאיצים את תהליכי המיטוב והתכנות שלו. הביצועים של Jalapeño באים לידי ביטוי ב־GPT‑OSS 120B, ב־DeepSeek R1 וב־Kimi K2.5 1T, ומראים שהארכיטקטורה פועלת במודלים שפותחו הן בתוך OpenAI והן מחוצה לה. בכל שלושת המודלים, Jalapeño ביצע פי 1.5 עד 1.9 יותר עבודת בינה מלאכותית לוואט בתפוקת שיא, עם זמן השהיה מקצה לקצה קצר פי 1.7 עד 3.6 מזה של המערכות שאליהן הושווה. בעומסי עבודה אינטראקטיביים במיוחד, הוא סיפק ביצועים גבוהים פי 2.1 עד 4.1.
Jalapeño גם מעיד על יתרון רחב יותר, שנובע מתכנון כל שכבות המערכת יחד. OpenAI יכולה לתכנן יחד מודלים, מוצרים, תוכנה להרצת מודלים, שבבים, זיכרון, רשתות ומערכות, ולהשתמש בידע שנצבר מעומסי עבודה אמיתיים כדי לשפר כל שכבה במערכת. Jalapeño הוא שבב בפיתוח עצמי שכבר פועל ומציג תוצאות מדודות, והוא תחילתה של פלטפורמה רב־דורית. בחודשים הקרובים נרחיב את השימוש ב־Jalapeño כדי לספק ללקוחות שלנו מוצרים מהירים יותר, יעילים יותר ובעלי יכולות מתקדמות יותר.
אנחנו מעריכים את הביצועים בתנאים של חוויית משתמש זהה, ומודדים כמה עבודת בינה מלאכותית מועילה כל מערכת יכולה להשלים ליחידת הספק, תוך עמידה בדרישות זמן ההשהיה של לקוחות וסוכנים אינטראקטיביים. הדבר חשוב במיוחד לסוכנים, שצריכים להשלים שלבים רבים ברצף, ולכן עיכובים עלולים להצטבר לאורך המשימה כולה.
כדי להבין את הביצועים של Jalapeño בפועל, בדקנו אותו ב־InferenceX, מבחן ביצועים ציבורי של SemiAnalysis שמודד את מלוא תהליך הטיפול בבקשת בינה מלאכותית. השווינו את Jalapeño למערכות בינה מלאכותית מובילות הזמינות מסחרית, לאורך טווח העבודה שנבדק — מהרצת מודלים בתפוקה גבוהה ועד לשימוש אינטראקטיבי במיוחד עם זמן השהיה קצר. Jalapeño סיפק שילוב טוב יותר של תפוקה, יעילות אנרגטית וזמן השהיה. אף שלעיתים מדווחים על ביצועים לשבב, לדעתנו ביצועים ליחידת הספק הם מדד שימושי יותר.
בכל שלושת המודלים הזמינים לציבור, Jalapeño סיפק שילוב טוב יותר של ביצועים לוואט וזמן השהיה לאורך טווח העבודה שנבדק, ובכך התמקם על חזית פארטו. כדי להשוות את המערכות באופן עקבי, נרמלנו את התוצאות לפי ההספק הנקוב שפורסם עבור השבב של כל מאיץ. ההספק הנקוב של Jalapeño הוא 700 וואט, אך צריכת ההספק המתמשכת שנמדדה בעומסי העבודה שנבדקו לא עלתה על 550 וואט.
Jalapeño הציג ביצועים חזקים ב־GPT‑OSS 120B, ב־DeepSeek R1 670B וב־Kimi K2.5 1T. ב־Kimi, המודל הגדול ביותר הזמין לציבור שבדקנו, הוא סיפק ביצועי שיא לוואט גבוהים פי כ־1.5 וזמן השהיה מקצה לקצה קצר פי 3.4 בהשוואה למערכת שאליה הושווה. בבדיקות הפנימיות שלנו, היתרון של Jalapeño גדל עוד יותר במודלי החזית של OpenAI. הדבר מעיד שערכה של הארכיטקטורה עולה ככל שעומסי העבודה גדולים ותובעניים יותר.
התכנון של Jalapeño התחיל בשאלה: איזו חומרה היינו בונים אילו תפקידה העיקרי היה להריץ מודלי שפה עכשוויים ועתידיים, ובמיוחד סוכנים אינטראקטיביים? השיפור בביצועי Jalapeño נובע מתכנון משותף של השבב, הזיכרון, הרשת, התוכנה והמערכת בקנה מידה של ארון שרתים, בהתאם לעומסי עבודה אמיתיים של מודלי שפה. הסקה במודלי שפה מתבצעת בכמה שלבים נפרדים, שלכל אחד מהם צווארי בקבוק שונים. שלב המילוי המקדים, שבו המערכת מעבדת פרומפט, דורש משאבי חישוב רבים. לעומתו, שלב הפענוח, שבו המערכת יוצרת את התשובה טוקן אחר טוקן, מוגבל יותר על ידי רוחב הפס של הזיכרון. גם התקשורת עלולה להוסיף השהיה כשצריך להעביר נתונים בין ליבות ושבבים, כך שחלק מיחידות העיבוד נותרות ללא עבודה בזמן ההמתנה. מערכת שמצטיינת בשלב אחד עלולה לאבד את היתרון הזה בזמן ההמתנה לנתונים או העברת מצב המודל בין משאבים שונים.
תכננו את Jalapeño כך שיצמצם ככל האפשר העברת נתונים ועיכובים בתקשורת. כך אפשר למקם באופן מפורש את מצב המודל, כולל מטמון ה־KV המשמש ליצירת תשובה, ולהשאיר אותו מקומי, בזמן שהמערכת מפעילה את השילוב המתאים של משאבי חישוב, זיכרון ורשת לכל שלב בהסקה. הרשת היא חלק בלתי נפרד מהארכיטקטורה. התחום הרחב שלה מאפשר לכל עומס העבודה להישאר בתוך מערכת מקושרת אחת, מצמצם את העברת הנתונים ומסייע לשמור על טיפול מהיר ויעיל בבקשה מתחילתה ועד סופה. התוצאה היא מאיץ מאוזן, שמשאביו ניתנים להקצאה גמישה. הוא יכול לתמוך בארכיטקטורות מודלים משתנות, להצטיין הן במילוי המקדים והן בפענוח, ולהסתגל לשינויים באיזון ביניהם — מאפיין מרכזי של עומסי עבודה אג'נטיים.
לבינה מלאכותית היה תפקיד ישיר בפיתוח Jalapeño. היא אפשרה לצוות לעבור מהתכנון הראשוני למסירת התכנון לייצור בתוך תשעה חודשים, באמצעות בחינת מימושים, קיצור מחזורי התכנון, המדידה והאימות, ושיפור מתמשך של עומסי העבודה של המודלים. בינה מלאכותית גם סייעה למטב את המעגלים האריתמטיים של השבב, וכך אפשרה לצוות לשלב בו יותר ביצועי חישוב תוך עמידה בלוח הזמנים.
Jalapeño תוכנן כפלטפורמה לתכנות שהיא ברורה וצפויה, הן לבני אדם והן לבינה מלאכותית. מהנדסים יכולים לתאר את העבודה באמצעות טנסורים מקומיים, תקשורת מפורשת וסנכרון צפוי. לאחר מכן, בינה מלאכותית יכולה למטב את המיפוי, המיקום, התזמון והתיאום של העבודה ברחבי המערכת. המבנה הברור והצפוי הזה נותן לבינה מלאכותית דרך מעשית להתמודד עם תכנות מקבילי — בעיה שנחשבת מורכבת באופן מסורתי.
תמיכה בכל משפחת מודלים חדשה עדיין מחייבת קרנלים חדשים ואופטימיזציות ייעודיות למודל. בעזרת Codex עם GPT‑Astra, הצוות הביא בתוך חודשיים שלושה מודלים בעלי משקולות פתוחות לרמת ביצועים גבוהה, אף שלא נכללו בתוכנית הייצור המקורית של Jalapeño. הדבר הדגים הן את גמישות הארכיטקטורה והן את המהירות שבה בינה מלאכותית יכולה לעזור לנו לתכנת אותה. בבלוקים נבחרים של קשב ותערובת מומחים ב־GPT‑OSS, מימושים שנוצרו בבינה מלאכותית פעלו מהר פי 1.5 עד 1.8 מהמימושים הקיימים שכתבו מומחים אנושיים. הנתונים האלה מתייחסים לבלוקים שנבחרו ולא למודל המלא, אך הם מצביעים על אפשרות למחזור פיתוח חדש ועוצמתי.
ערכה של תשתית בינה מלאכותית נובע מהעבודה המועילה שהיא מאפשרת לבצע בעולם האמיתי. בזכות היכולת להפיק יותר עבודה מועילה מאותם משאבי חשמל וחומרה, Jalapeño יכול לעזור לנו לתת מענה לביקוש רב יותר ולהוזיל את העלות של השגת תוצאה מוצלחת. עבור OpenAI, הדבר יכול לשפר את המינוף התפעולי, בכך שיאפשר להיקף העבודה המועילה ולהכנסות לצמוח מהר יותר מעלות מתן השירות. הוא יכול גם לתמוך באימוץ נרחב יותר ובהמשך ההשקעה במודלים, במוצרים ובתשתיות טובים יותר. הסקה מהירה יותר יכולה לאפשר מחזורי שיפור מהירים יותר ושימושים חדשים.
Jalapeño מרחיב את האפשרויות להסקה יעילה עם זמן השהיה קצר:
הסקה במצב מהיר במיוחד, ברמות יעילות שבעבר היו זמינות רק במצב מהיר
הסקה במצב מהיר, ברמות יעילות שבעבר היו זמינות רק במצב אצווה
יעילות גבוהה יותר להסקה במצב אצווה
אנחנו מתכננים להתחיל לפרוס את Jalapeño בתשתית המחשוב של OpenAI עד סוף השנה. זהו הדור הראשון בתוכנית פיתוח רב־דורית: הדור השני נמצא בשלבי פיתוח מתקדמים, והדור השלישי הולך ומתגבש. כל דור יתבסס על הידע שנצבור וימשיך לשפר הן את היעילות והן את המהירות.
כדי לעמוד בביקוש הגובר לבינה מלאכותית, נזדקק ליותר משאבי מחשוב מכל מקור זמין. נמשיך לפרוס בהיקף נרחב מאיצים של NVIDIA ושל שותפים אחרים, הן לעומסי עבודה של אימון והן להסקה. המשימה שלנו היא להבטיח שבינה מלאכותית כללית תועיל לאנושות כולה.
לקראת הפריסה, אנחנו ממשיכים בבדיקות הכשירות לייצור, בהבשלת התוכנה, בהיערכות להפעלת Jalapeño בקנה מידה רחב ובאימות הביצועים במודלים נוספים. התוצאות עד כה מראות מה אפשר להשיג כשמתכננים את המערכת כולה כמכלול: agentic AI עם תגובתיות ויכולות משופרות, שמגיע ביעילות רבה יותר ליותר אנשים.
חזית התפוקה לקילוואט
InferenceX · GPT‑OSS‑120B · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB200 1,200 W
תפוקת שיא ותפוקה בתנאים זהים
InferenceX · GPT‑OSS‑120B · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB200 1,200 W
שיא גבוה יותר של טוקנים משולבים/שנייה/קילוואט
≈1.9×
85,448 לעומת 44,960 משולבים / קילוואט
זמן השהיה קצר יותר מקצה לקצה
≈1.7×
1.03 שניות לעומת 1.80 שניות
TBT מינימלי קצר יותר
≈2.7×
0.69 לעומת 1.87 מילישניות (1,459 לעומת 535 טוקנים/שנייה/משתמש)
תפוקה גבוהה יותר ב־TBT הקודם
≈53.7×
22,935 לעומת 427 משולבים / קילוואט (ב־535.28 טוקנים/שנייה/משתמש)
חזית התפוקה לקילוואט
InferenceX · DeepSeek R1 MXFP4 · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB300 1,400 W
תפוקת שיא ותפוקה בתנאים זהים
InferenceX · DeepSeek R1 MXFP4 · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB300 1,400 W
שיא גבוה יותר של טוקנים משולבים/שנייה/קילוואט
≈1.7×
19,641 לעומת 11,781 משולבים / קילוואט
זמן השהיה קצר יותר מקצה לקצה
≈3.6×
1.65 שניות לעומת 5.99 שניות
TBT מינימלי קצר יותר
≈4.1×
1.43 לעומת 5.90 מילישניות (700 לעומת 169 טוקנים/שנייה/משתמש)
תפוקה גבוהה יותר ב־TBT הקודם
≈104.3×
12,258 לעומת 118 משולבים / קילוואט (ב־169.41 טוקנים/שנייה/משתמש)
חזית התפוקה לקילוואט
InferenceX · Kimi K2.5 MXFP4 · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB300 1,400 W
תפוקת שיא ותפוקה בתנאים זהים
InferenceX · Kimi K2.5 MXFP4 · ערכים נומינליים 8k/1k · STP · TDP של המארז: Jalapeño 700 W; GB300 1,400 W
שיא גבוה יותר של טוקנים משולבים/שנייה/קילוואט
≈1.5×
18,195 לעומת 11,862 משולבים / קילוואט
זמן השהיה קצר יותר מקצה לקצה
≈3.4×
1.56 שניות לעומת 5.31 שניות
TBT מינימלי קצר יותר
≈3.8×
1.44 לעומת 5.48 מילישניות (694 לעומת 182 טוקנים/שנייה/משתמש)
תפוקה גבוהה יותר ב־TBT הקודם
≈56.1×
6,744 לעומת 120 משולבים / קילוואט (ב־182.46 טוקנים/שנייה/משתמש)