מציגים את LifeSciBench
מבחן הערכה שכתבו וסקרו מומחים, המבוסס על מחקר במדעי החיים בעולם האמיתי
מערכות agentic AI מסוגלות יותר ויותר לבצע משימות מדעיות. עם זאת, התועלת שלהן לחוקרי מדעי החיים תלויה ביכולתן להתמודד עם מורכבות המחקר בפועל. עבודה זו דומה רק לעיתים רחוקות לשאלה בודדת של שליפת עובדה או לבעיית חיזוי מוגדרת היטב. חוקרים מפרשים ראיות חלקיות, מיישבים תוצאות סותרות, מתכננים ניסויים מורכבים, פותרים תקלות בבדיקות, מעריכים סיכונים ביישום קליני ומחליטים על הצעד הבא בתנאי אי-ודאות.
מבחני ההערכה הקיימים אינם משקפים יכולות אלה במלואן. הערכות רבות במדעי החיים מתמקדות בתחומים צרים או במיומנויות בודדות, ומניבות שאלות במבנה קבוע עם תשובות ייחוס חד-משמעיות. אף שהן מועילות, לרוב אינן בוחנות באמת אם מודל יכול לתרום למגוון הרחב של עבודת מחקר.
פיתחנו את LifeSciBench כדי לסייע בצמצום הפער הזה. כל משימה מבוססת על שיקול דעתם של מדענים פעילים במדעי החיים, בעלי הכשרה ברמת דוקטורט וניסיון ישיר בקידום תוכניות לגילוי תרופות בביוטכנולוגיה ובפארמה.
LifeSciBench כולל 750 משימות שחיברו מומחים, בשבעה תהליכי עבודה ובשבעה תחומים ביולוגיים.
1,062
חומרי עזר למשימות
173
מדענים שתרמו
19,020
קריטריונים במחוונים
453
סוקרים מומחים
מה LifeSciBench מודד
LifeSciBench מודד אם מערכות בינה מלאכותית יכולות לתמוך במשימות מחקר מציאותיות במדעי החיים, ולא רק לענות על שאלות בביולוגיה. כדי להגדיר את סיווגי המבחן, סקרנו מדענים פעילים במדעי החיים לגבי תהליכי העבודה הנפוצים ביותר אצלם במחקר יישומי. קיבצנו את תשובותיהם לשבע קטגוריות חוזרות: עבודה עם ראיות, ניתוח, תכנון ואופטימיזציה, reasoning מדעי, אימות ותפעול, יישום קליני ותקשורת מדעית.
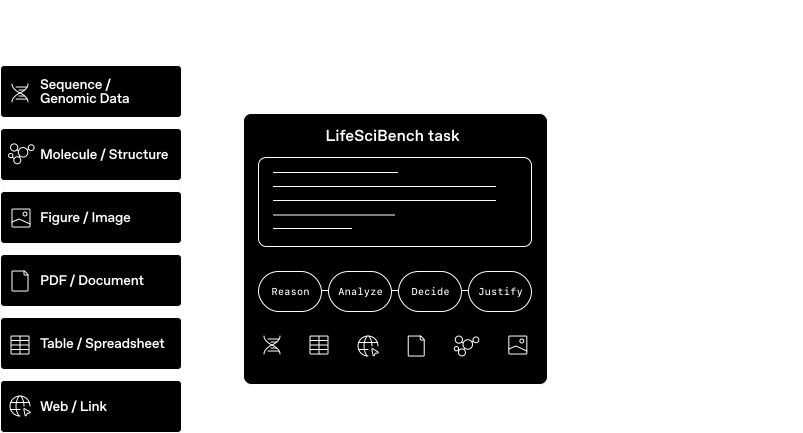
כל משימה בנויה כבקשה שמדען עשוי להפנות לעמית בעל ידע: פרומפט מדעי, הקשר או חומרי עזר רלוונטיים ותשובה פתוחה. מחוונים שכתבו מומחים בוחנים אם מודל מפיק תשובה נכונה לבעיה מסוימת, עם רמת הפירוט, ההנמקה, ההסתייגויות והעיצוב שמדען מצפה להם.
בניית מערך הנתונים
LifeSciBench מעריך reasoning מדעי לצד מיומנויות מעשיות, מוגדרות פחות, הנחוצות לשימוש מדעי בפועל. המשימות דורשות מהמודלים להתמודד עם בעיות מחקר מציאותיות: לפרש ראיות, להפעיל שיקול דעת מבוסס ידע בתחום ולהציג מסקנות שיועילו לסוקרים מומחים. משימות רבות דורשות גם התמודדות עם אי-ודאות והסקת מסקנות מקובצי נתונים תומכים, במקום הסתמכות על טקסט הפרומפט בלבד.
המבחן נועד לשקף את מורכבות העבודה במדעי החיים. בסך הכול, 79% מהמשימות דורשות כמה שלבי reasoning או קבלת החלטות, עם ממוצע של ארבעה שלבים למשימה. LifeSciBench כולל 1,062 חומרי עזר מצורפים: איורים, קובצי PDF, טבלאות, קובצי רצפים, קובצי מבנים או נתונים כימיים והפניות ברשת. יותר ממחצית מהמשימות (53%) דורשות מהמודלים לפרש או לשלב מידע מחומר עזר אחד לפחות.
את המשימות יצרו 173 מדענים מומחים מתחומים שונים במדעי החיים. לכל מדען הייתה הכשרה ברמת דוקטורט וניסיון בתעשיית הביוטכנולוגיה או התרופות. המשימות יכלו לעבור כמה סבבי תיקון שנדרשו לפני קבלתן, ללא הגבלה קבועה. משימות שהתקבלו עברו בממוצע שישה סבבי סקירה אוטומטית בהובלת המחברים ולפחות שני סבבי סקירת מומחים. הסקירות התבססו על תשובה נכונה הניתנת לאימות או על הסכמה רחבה של מומחים, עם הסכמה של לפחות 90% מהסוקרים בתחום הרלוונטי. התהליך סייע להבטיח שהמשימות שהתקבלו יהיו מבוססות מדעית, ברורות דיין לניקוד ומייצגות מחקר יישומי.
ניקוד ופירוט המחוונים
משימות LifeSciBench מנוקדות לפי מחוון מפורט וייעודי לכל משימה, המפרק את התשובה הצפויה לטענות מדעיות, חישובים, החלטות, הנמקות ועוד. המחוונים שפיתחו מומחים כוללים 19,020 קריטריונים — 25 בממוצע למשימה — להערכת נכונות מדעית ותועלת להחלטות מחקריות.
כך משתקף אופן הערכת העבודה המדעית בפועל: משימות רבות במדעי החיים אינן ניתנות לניקוד לפי התשובה הסופית בלבד. תשובה עשויה להגיע למסקנה הכללית הנכונה ועדיין להיחשב חלקית אם, למשל, התעלמה ממגבלה מרכזית של הבדיקה או לא העלתה מיוזמתה דקויות ביולוגיות בעלות השלכות משמעותיות. מנגד, תשובה חלקית עשויה לכלול reasoning איכותי גם אם אינה פותרת את המשימה במלואה.
המחוונים המפורטים משקפים את הדקויות האלה. LifeSciBench בוחן לא רק את דיוק התשובה הסופית, אלא גם אם המודל הגיע אליה בדרך תקפה מדעית ושימושית מבחינה מעשית.
תיקוף LifeSciBench
תיקפנו את LifeSciBench באמצעות סקירת מומחים בלתי תלויה. המשוב התקבל מ-453 סוקרים שלא היו מעורבים בכתיבת המשימות. 97% מהסוקרים היו בעלי Ph.D. או דוקטורט מקביל, עם ממוצע של 12 שנות ניסיון בתחום ו-14 פרסומים שעברו ביקורת עמיתים; 88% דיווחו שקיבלו לפחות פרס אחד או מלגה אחת.
הסוקרים דירגו אם כל משימה משקפת את התכונות הנחוצות לשאלת הערכה איכותית: התאמה למחקר בפועל, בחינה ראויה של reasoning מדעי ומומחיות בתחום, עיגון בראיות או בהסכמת מומחים ותועלת כוללת להערכת ביצועי המודל. שיעור ההסכמה עלה על 96% בכל קטגוריה.
הערות הסוקרים חיזקו את הדירוגים הכמותיים:
תוצאות
אנו מדווחים על שני מדדים משלימים. שיעור ההצלחה הוא אחוז המשימות שבהן המודל עומד בסף ההצלחה של 70% למשימה. הציון הוא ממוצע הניקוד במחוון, המעניק ניקוד חלקי לקריטריונים בודדים גם כשהמשימה אינה נפתרת במלואה. שניהם חשובים, משום שתשובה למשימה מדעית עשויה להיות נכונה חלקית או מועילה בלי לעמוד בכל הדרישות לתשובה מלאה.
ביצועי המודלים משתנים מאוד לפי סוג המשימה, תהליך העבודה ופורמט התשובה.
היכן מערכות בינה מלאכותית מפגינות חוזקות ראשוניות
LifeSciBench מראה שמודלי חזית חזקים יחסית במיוחד במשימות של סינתזה מדעית, תקשורת ופרשנות מובנית. שיעורי ההצלחה המוחלטים עדיין צנועים, ולכן תחומים אלה רחוקים ממיצוי. עם זאת, GPT‑Rosalind מתקדם משמעותית לעומת GPT‑5.5 ומעלה את שיעור ההצלחה הכולל לפי הסף המדויק מ-25.7% ל-36.1%.
השיפורים הבולטים ביותר ביכולות המודלים ניכרים בתקשורת מדעית וביישום קליני. למשל, שיעור ההצלחה בתקשורת מדעית עולה מ-56.3% ב-GPT‑5.5 ל-71.1% ב-GPT‑Rosalind. זו קטגוריה קטנה (n=9) שיש לפרש בזהירות, אך היא מצביעה על שיפור מהיר ביכולת מודלי חזית לארגן ראיות ולהפיק הסברים משכנעים למומחים. יישום קליני — תהליך פיתוח התרופות ״מהמעבדה למיטת החולה״ — מציג דפוס דומה: עלייה מ-36.8% ב-GPT‑5.5 ל-57.7% ב-GPT‑Rosalind, המעידה על שיפור מהיר ביכולת לקשר ראיות פרה-קליניות להשלכות קליניות.
התוצאות ברמת המחוון מצביעות על אותה מגמה. במשימות הדורשות תוצרים שימושיים למומחים או כאלה שניתן לפעול לפיהם, GPT‑Rosalind מקבל 44.7%, לעומת 29.1% ל-GPT‑5.5. במשימות הדורשות התמודדות עם אי-ודאות והסתייגויות, הציון שלו הוא 44.8%, לעומת 29.3%. דפוס זה מצביע על כך שמודלים מועילים במיוחד כשהראיות לתחום המשימה מוגדרות היטב ונדרש שיקול דעת מדעי מובנה.
GPT‑Rosalind מוביל בביצועים במשימות בעלות ערך מדעי שזיהו מומחים מהתעשייה ומהאקדמיה.
GPT‑Rosalind משפר את הביצועים לעומת GPT‑5.5 בתהליכי עבודה מרכזיים במדעי החיים, עם השיפורים הבולטים ביותר ביישום קליני ובתקשורת מדעית.
היכן מערכות בינה מלאכותית עדיין מתקשות
הביצועים עדיין חלשים בהרבה בעבודה מדעית עתירת חומרי עזר, תכנון ומגבלות תפעוליות. בפרט, תכנון, אופטימיזציה וחיזוי נותרו מהתהליכים הקשים ביותר, עם שיעור הצלחה של 30.7% ל-GPT‑Rosalind; גם ניתוח קשה במידה דומה, עם 30.3%.
השימוש בחומרי עזר הוא פער בולט במיוחד. אף ש-GPT‑Rosalind עולה על GPT‑5.5 במשימות עתירות חומרי עזר, שיעור ההצלחה שלו עדיין יורד מ-45.1% במשימות טקסט בלבד ל-28.1% במשימות עם חומרי עזר או כתובות URL. GPT‑5.5 מציג אותו דפוס, עם ירידה מ-29.9% ל-21.9%. ניתוח מפורט יותר מאשר שמודלי חזית מתקשים לחלץ מידע מאיורים מורכבים או מקובצי רצפים גדולים ולשלב אותו בתשובה הסופית.
שיעורי ההצלחה יורדים כשהמשימות דורשות reasoning מעוגן במקורות או עבודה עם חומרי עזר
גם לפורמט התשובה יש חשיבות. במשימות הדורשות פלט מדויק ברמת הרצף, המבנה או הקונסטרוקט, שיעורי ההצלחה נמוכים יותר: GPT‑Rosalind מגיע רק ל-14.8% במשימות מספריות ול-24.0% בפלטי רצף או מבנה. גם משימות יצירת קונסטרוקטים מועדות לכשל: GPT‑Rosalind מגיע ל-27.3%, עם שיפור מועט לעומת GPT‑5.5. חלק מהפער עשוי לנבוע מניקוד מחמיר יותר במשימות עם תשובה מדויקת, שבהן הבדלים קטנים בחישוב או בעיצוב עלולים להוריד תשובה מתחת לסף ההצלחה. ובכל זאת, לכשלים אלה משמעות מדעית: תהליכי עבודה רבים במדעי החיים דורשים תוצרים מדויקים מספיק לשימוש ישיר, למשל בתכנון תורם ל-CRISPR/HDR או בתכנון siRNA.
לעיתים קרובות המודלים גם מתקדמים חלק מהדרך בלי לפתור את המשימה במלואה. בכ-14% מהמשימות, המודלים זכו לניקוד משמעותי במחוון אף שלא עמדו בסף ההצלחה המדויק. ב-GPT‑Rosalind היו 109 משימות עם שיעור הצלחה נמוך מ-20%, אך עם לפחות 50% מהניקוד במחוון. בפועל, מודלים עשויים לזהות ראיות רלוונטיות או להפיק תשובה חלקית סבירה, אך להיכשל כי החמיצו מגבלה מרכזית, השתמשו בראיות שגויות, ביצעו חישוב חלקי או לא קישרו את ה-reasoning שלהם להחלטה סופית מועילה מדעית.
מגבלות והצעדים הבאים
LifeSciBench הוא צעד למדידת התועלת של מערכות בינה מלאכותית במחקר במדעי החיים, אך אינו תחליף לבחינת מודלים בסביבות מחקר פעילות. המבחן מתמקד במשימות עצמאיות המשקפות תהליכי עבודה חוזרים בתעשייה, אך תחומי התמחות מדעיים וסוגי משימות רבים נותרים מחוץ להיקפו הנוכחי. מחקר אמיתי הוא תהליך איטרטיבי: מדענים אוספים ראיות חדשות, מעדכנים השערות, מתכננים ניסויי המשך ומתאימים את תוכניותיהם לתוצאות המתקבלות.
לכן יש לפרש ביצועים חזקים ב-LifeSciBench כראיה ליכולת ברמת משימה מציאותית, ולא כמדד ישיר להשפעה על המחקר בהמשך. המבחן מבוסס על תהליכי עבודה בתעשייה, אך אינו משקף את מלוא הגיוון והדינמיקה של תוכניות מחקר פעילות, שבהן ההתקדמות תלויה בגורמים המתפתחים לאורך זמן.
הצעד הבא הוא לקשר את הביצועים במבחן למחקרי שימוש בתהליכי מחקר פעילים. אף ש-LifeSciBench פותח עם מדענים פעילים, כדי למדוד אם מערכות בינה מלאכותית מאיצות גילוי או משפרות תוצאות מו״פ, יש לבחון את השימוש במודלים ואת ביצועיהם בסביבות מחקר אמיתיות, לאורך זמן ובכמה סבבים של reasoning, משוב וניסויי המשך.