חיזוי התנהגות מודלים לפני ההשקה באמצעות סימולציית פריסה
שימוש בהקשרי שיחה מציאותיים כדי לאמוד טוב יותר התנהגות לא רצויה של מודלים לפני ההשקה.
לפני השקת מודל חדש, מעבדות צריכות להבין לא רק מה הוא מסוגל לעשות, אלא גם כיצד הוא צפוי להתנהג בשימוש בעולם האמיתי, ובכלל זה היכן הוא עלול ליצור סיכונים חדשים. ככל שהיכולות מתקדמות, הדבר נעשה חשוב עוד יותר. במסגרת סקירת הבטיחות שלנו לפני הפריסה, אנחנו נעזרים בהערכות ממוקדות, ב־red teaming ובבדיקות נוספות כדי להבין את התנהגות המודל. כעת התחלנו להשתמש בשיטה שמדמה פריסות של מודלים לפני שהן מתרחשות. היא מספקת אינדיקציה משלימה: הצצה מוקדמת, בתנאים דמויי פריסה, לאופן שבו מודל מועמד עשוי להתנהג לפני שהוא מגיע למשתמשים.
סימולציית פריסה היא שיטה להדמיית פריסה עתידית לפני שהיא מתרחשת. אנחנו עושים זאת באמצעות הרצה חוזרת של שיחות קודמות עם מודל מועמד חדש, תוך שמירה על פרטיות. כך אנחנו יכולים לבחון כיצד המודל החדש מגיב בהקשרים מציאותיים לפני השקתו, ובכלל זה האם מתעוררות התנהגויות לא רצויות חדשות ובאיזו תדירות הן עשויות להופיע.
בכמה פריסות של מודלי Thinking מסדרת GPT‑5, סימולציית פריסה שיפרה את האומדנים שלנו לשיעורי התנהגויות לא רצויות של מודלים, סייעה לחשוף צורות חדשות של חוסר הלימה לפני ההשקה, ועזרה לצמצם את הסיכון שמודלים יוכלו לזהות שהם נבחנים. יישמנו את השיטה גם על רצפי פעולה אג'נטיים מאתגרים. הראינו שאפשר להרחיב אותה מעבר לצ'אט רגיל, לסביבות מורכבות יותר של סוכנים המשתמשים בכלים, ושאפשר להשתמש בה גם להערכת סיכונים לפני פריסות פנימיות של מודלים.
כבר השתמשנו בתובנות מסימולציית פריסה במהלך פיתוח מודלים כדי לזהות נקודות עיוורון בהערכות מסורתיות ולסייע בגיבוש אמצעים לצמצום סיכונים ובהחלטות על פריסה. ככל שנקל על הפעלת התהליך, אנחנו מצפים שהוא ימלא תפקיד גדול יותר בפיתוח מודלים בעתיד.
הערכות לפני פריסה הנהוגות בתעשייה מורכבות בדרך כלל משילוב של פרומפטים סינתטיים, פרומפטים שנכתבו ידנית או פרומפטים משימוש בפועל, שנבחרו במכוון בשל הקושי שלהם, חומרת הסיכון או אופיים העוין. להערכות האלה היו בדרך כלל שתי מטרות שלובות: לבחון כיצד המודל מגיב במבחני קיצון במצבים שהסיכוי להתרחשותם בתעבורת השימוש לאחר הפריסה קטן מאוד; ולגבש הבנה כללית של התנהגויות לא רצויות של המודל, לרבות גילוי התנהגויות חדשות וחיזוי תדירותן בזמן הפריסה.
הערכות מסורתיות נותרו חיוניות למטרה הראשונה, אך סימולציית פריסה היא התקדמות משמעותית במטרה השנייה, בכל הנוגע לסיכונים שאינם סיכוני זנב. בניסויים שלנו, אי אפשר לצפות שהגישה תמדוד התנהגויות שמתרחשות בתדירות נמוכה מאחת ל־200,000 הודעות. כוחה של סימולציית פריסה נובע מכך שהיא עוקפת כמה אתגרים מרכזיים בהערכות מסורתיות:
כיסוי: קשה להיות בטוחים שפרומפטים להערכה יכסו את כל סוגי ההתנהגות הלא רצויה האפשריים של המודל. מדידת סוגים חדשים של התנהגות לא רצויה מחייבת ליצור הערכות חדשות ולדעת אילו נזקים צריך למדוד. הדבר עשוי לדרוש זמן ועבודה רבים, ועם הזמן ההערכות עלולות להגיע לרוויה.
הטיות בחירה: הערכות מסורתיות נבנות בדרך כלל סביב התנהגויות לא רצויות מסוימות של מודלים, שנבחרות באופן שמטה את ההערכה לעבר הקשרים שכבר התרחשו בעבר. לכן האומדנים שלהן עשויים לספק פחות מידע על שכיחות ההתנהגויות האלה על פני מלוא התפלגות השימוש לאחר הפריסה.
המודלים יכולים לזהות שמדובר במבחן: מודלים נעשים מסוגלים יותר ויותר לזהות שהם נבחנים, מה שעלול לעוות את התנהגותם ובהמשך גם את מדידות הבטיחות שלנו. רבות מההערכות המסורתיות שבהן אנחנו משתמשים ב־OpenAI מבוססות גם הן על תעבורת שימוש בפועל ואינן סובלות מהבעיה הזאת, אך זהו חשש נפוץ בהערכות מסורתיות רבות המשמשות בתעשייה.
הטכניקה המרכזית שמאחורי סימולציית פריסה פשוטה: אנחנו לוקחים שיחות מהזמן האחרון לאחר הפריסה, מסירים את תגובת העוזר המקורית של המודל הישן, ומייצרים אותה מחדש באמצעות מודל מועמד להשקה. אנחנו מעריכים את ההשלמות באמצעות חיפוש אחר דפוסי כשל חדשים, ואומדים את תדירות ההתנהגות הלא רצויה בזמן הפריסה על סמך תדירותה בהתפלגות דמוית הפריסה הזאת. אנחנו יכולים לבצע את אותן מדידות לאחר ההשקה, על תעבורת שימוש אמיתית, וכך לאמת את התחזיות שלנו מלפני הפריסה.
סימולציית פריסה מצמצמת במידה ניכרת את שלוש המגבלות שצוינו לעיל: השימוש בהתפלגות פרומפטים להערכה שמייצגת את השימוש מהזמן האחרון נותן מענה להטיית הדגימה. סימולציית פריסה עם פרומפטים מייצגים יכולה גם לצמצם את החששות לגבי הכיסוי: ככל שמדמים יותר תעבורה, מקבלים כיסוי רחב יותר של התנהגויות לא רצויות של המודל. הקשר הזה בין משאבי חישוב לכיסוי חשוב, משום שהוא מאפשר לשפר את איכות הערכת הסיכונים בציר הזה באמצעות תוספת משאבי חישוב, במקום העבודה הידנית הנדרשת לבניית הערכות נוספות. נראה גם שמודלים אינם מסוגלים להבחין בין שיחות שהתקבלו באמצעות סימולציית פריסה לבין תעבורת שימוש אמיתית לאחר הפריסה.
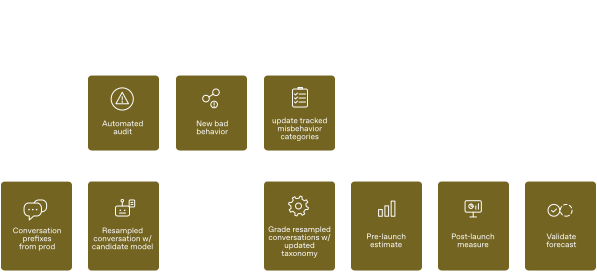
איור 1: סקירה של תהליך סימולציית הפריסה שלנו
תחום | הערכות מסורתיות | סימולציית פריסה |
|---|---|---|
כיסוי | מתאימות יותר לסיכונים נדירים אך חמורים, שחשוב לנו לוודא שיש להם כיסוי | מתאימה יותר להבנת מגוון הסיכונים שאנחנו צפויים לראות בתעבורת השימוש לאחר הפריסה |
ייצוגיות / הטיה | ממוקדות בהערכת סיכונים מסוימים מהעבר או סיכונים צפויים, גם כשמדובר בהתנהגויות ששכיחותן לאחר הפריסה נמוכה ביותר | מייצגת סיכונים שמתרחשים מעל סף שכיחות מסוים בתעבורת השימוש הנוכחית לאחר הפריסה |
מודעות לבחינה | ייתכנו סימנים ברורים לכך שמדובר במבחן, למשל בנתונים סינתטיים, אלא אם ההערכות נבנות מנתוני פריסה | נראה שהקשר דמוי פריסה מצמצם משמעותית מודעות לבחינה |
מאמץ | יצירת התפלגויות פרומפטים ומערכי בדיקה מותאמים דורשת הרבה יותר עבודה ידנית | דורשת השקעה חד־פעמית בתשתית, ולאחר מכן עושה שימוש חוזר בתחיליות שיחה מהפריסה ובמעריכי התנהגויות לא רצויות מוכרות |
השוואה כללית בין הערכות מסורתיות לסימולציית פריסה
כדי להעריך את סימולציית הפריסה, רשמנו מראש תחזיות לתדירות בזמן הפריסה של 20 סוגי התנהגות לא רצויה ב־GPT‑5.4 Thinking. ערכנו גם מחקרים בדיעבד על פריסות נוספות של מודלי Thinking מסדרת GPT‑5. התנהגויות המודלים שאנחנו מנתחים כוללות הן חוסר הלימה והן קטגוריות של תוכן אסור שעליהן אנחנו מדווחים בכרטיסי מערכת, למשל מודל שמשקר בנוגע לכלים או מפיק תוכן מיני אסור. בתוצאות האלה אנחנו עוקבים רק אחר 20 קטגוריות של התנהגות לא רצויה של מודלים, ומחפשים התנהגויות חדשות רק בתחום חוסר ההלימה. עם זאת, סימולציית פריסה היא טכניקה כללית שאפשר ליישם כדי לדמות כל מאפיין של מודל בזמן הפריסה.
תעבורת השימוש בפועל שנעזרנו בה הגיעה גם היא ממודלי Thinking מסדרת GPT‑5. לפני שהרצנו את ההערכות, הסרנו באופן אוטומטי מזהים המקושרים לחשבונות ומידע מזהה. בהתאם למדיניות הפרטיות שלנו, ניתחנו רק תעבורת ChatGPT של משתמשים שמאפשרים להשתמש בנתונים שלהם לשיפור המודלים. אנחנו מדווחים רק על ממצאים מצרפיים מההערכות האלה. בסך הכול ניתחנו כ־1.3 מיליון שיחות שהוסרו מהן פרטים מזהים, מפריסות של GPT‑5 Thinking ועד GPT‑5.4, בתקופה שבין אוגוסט 2025 למרץ 2026.
אנחנו בוחנים את איכות הערכת הסיכונים שסימולציית פריסה מפיקה לפני הפריסה בשלוש דרכים עיקריות:
כיסוי הקטגוריות: האם הביקורת לאחר ההשקה חשפה התנהגויות חשובות של חוסר הלימה שלא נכללו במערך הקטגוריות הראשוני שלנו להתנהגויות לא רצויות?
דיוק בחיזוי כיוון השינוי: האם הסימולציה חזתה נכון אם שכיחותן של התנהגויות מוכרות תעלה או תרד לאחר הפריסה?
כיול השיעורים: האם האומדנים שלנו לפני הפריסה היו קרובים לשיעורים שבהם צפינו בהמשך, לאחר הפריסה? כיול טוב של השיעורים דורש יותר מדיוק בחיזוי כיוון השינוי, ולכן זהו רף האיכות הגבוה ביותר.
אנחנו גם מודדים עד כמה מודלים מסוגלים לזהות שהם נמצאים בהערכה במהלך סימולציית פריסה, ובודקים עד כמה השיטה עמידה לסוגים שונים של תעבורת שימוש לאחר הפריסה ולסביבות מאתגרות של שימוש בכלים.
בפריסות של מודלי Thinking מסדרת GPT‑5, סימולציית פריסה התעלתה על שיטות הבסיס המבוססות על פרומפטים מאתגרים בקביעת שיעור הסיכון בפועל, הצליחה לחשוף מניפולציית מחשבון לפני ההשקה, ונראה שייתכן שהמודל לא היה מסוגל להבחין בינה לבין פריסה אמיתית.
סקירה של התחזיות שלנו. להמחשה של כל התחזיות לפריסות של מודלי Thinking מסדרת GPT‑5, ראו איור 2. התחזיות עבור GPT‑5.4 Thinking נרשמו מראש, ואילו יתר התחזיות הופקו בדיעבד. במבט מצרפי, לתחזיות שלנו הייתה שגיאה כפלית חציונית של פי 1.5. לדוגמה, אם שיעור ההתנהגות הלא רצויה הוא 10 מתוך 100 אלף, מדובר באומדן של 15 או 6.67 מתוך 100 אלף. אף ששגיאות הזנב של השיטה שלנו יכולות להיות גדולות בערך פי 10, אנחנו צופים שאפשר לצמצם אותן במידה ניכרת באמצעות שיפורים נוספים בתהליך הסימולציה, כפי שנדון בהמשך.

איור 2. תחזיות של סימולציית פריסה לתדירות התנהגות לא רצויה בזמן הפריסה, על סמך נתוני פריסות קודמות. הסימון 5.1 → 5 מציין שאנחנו דוגמים מחדש תחיליות שיחה מ־GPT‑5 באמצעות GPT‑5.1, כלומר מדמים את הפריסה של GPT‑5.1 על סמך נתונים מ־GPT‑5. השיעור הגבוה ביותר של התנהגות חסרת הלימה היה של ״מניפולציית מחשבון״ ב־GPT‑5.1, שעליה דנו בעבר(נפתח בחלון חדש).
השוואת התחזיות של סימולציית פריסה לשיטות בסיס. בהערכת סיכונים לפני פריסה, הקטגוריות שהכי חשוב לאמוד נכון הן אלה שבהן חל שינוי גדול בשכיחות לאחר פריסת המודל, למשל שינוי של פי 1.5 או יותר. בתת־קבוצה זו, סימולציית פריסה טובה משמעותית משיטות הבסיס הן בחיזוי אם שכיחותה של התנהגות לא רצויה מסוימת תעלה או תרד עם פריסת המודל (איור 3, משמאל), והן באומדן השכיחות המדויקת שלה בזמן הפריסה (איור 3, מימין). אנחנו משתמשים בשתי שיטות בסיס עיקריות: שיטת פרומפטים מאתגרים, שבה אנחנו משתמשים כיום לכרטיסי מערכת ולהחלטות על השקה; ושיטה נאיבית המשתמשת בשיעורים מהפריסה הקודמת כאומדנים למודל החדש.
Figure 3. Deployment Simulation predicts both the direction of incidence changes (left) and exact production rates (right) better than static evals.
מקורות לשגיאת סימולציה בתהליך שלנו. חקרנו גם את מקורות השגיאה הקיימים בתהליך שלנו כיום. בפרט, שגיאות זנב גדולות מקשות להסתמך על התהליך לצורך החלטות על פריסה. למשל, כשמתקבלת תחזית לעלייה גדולה בהתנהגות לא רצויה מסוג מסוים, ואם ידוע שבתהליך יש שגיאות גדולות אפילו מדי פעם, מתעורר ספק אם מדובר באומדן מהימן או בתוצאה מלאכותית של התהליך. יש שני מקורות עיקריים לשגיאה אפשרית:
שגיאה הנובעת מנאמנות סביבת הדגימה מחדש למציאות: כדי לאמוד במדויק את השיעורים בשימוש בפועל, תהליך הסימולציה שלנו צריך להיות מציאותי ככל האפשר. זו בחלקה בעיה הנדסית — דגימה מהמודל באמצעות אותם תהליכים המשמשים לתעבורת השימוש בפועל — ובחלקה אתגר מעניין הנוגע לכלים שדורשים גישת קריאה וכתיבה למשאבים חיצוניים שמשתנים כל הזמן, כגון חיפוש ברשת או אינטראקציה עם קבצים מקומיים. אפשר לבודד את השגיאה הנובעת מנאמנות הסימולציה למציאות באמצעות השוואת תחזיות מפריסה אמיתית ומהסימולציה שלה, כלומר הדמיית הפריסה של מודל שכבר נפרס.
שגיאה עקב שינוי בהתפלגות הפרומפטים: חשש מרכזי בסימולציית פריסה הוא שפריסה של כל מודל תגרום לשינוי בהתפלגות הקלטים, במיוחד אם המשתמשים יתאימו את עצמם לאפשרויות החדשות שהמודל מציע. אנחנו מבודדים את שגיאת התפלגות הפרומפטים באמצעות השוואת אומדנים מסימולציית פריסה המבוססת על פרומפטים מהזמן האחרון, לעומת פרומפטים מהפריסה שהתממשה בפועל.
כפי שמוצג באיור 4, מצאנו שחלק גדול מהשגיאה בתהליך שלנו — ובמיוחד שגיאות הזנב — נובע כיום ממידת הנאמנות של הסימולציה למציאות. אלה חדשות טובות, משום שאנחנו צופים שבדרך כלל יהיה קל יותר לשפר את נאמנות הסימולציה למציאות מאשר לצמצם את השינוי בהתפלגות הפרומפטים. מצאנו גם שאפשר לצמצם את השגיאה הנובעת משינוי בהתפלגות הפרומפטים באמצעות שימוש בנתונים העדכניים ביותר מהפריסה הקודמת. פרטים נוספים מופיעים במאמר המחקר.
איור 4: נראה שמידת הנאמנות של סביבת הדגימה מחדש למציאות היא מקור השגיאה הגדול ביותר באומדנים שלנו, במיוחד בשגיאות הקיצוניות ביותר.
ביקורת אוטומטית זיהתה את הסוג החדש היחיד של חוסר הלימה שהופיע בפריסות האלה. בחלון הפריסות שחקרנו, תהליך הביקורת האוטומטי שלנו, המבוסס על פריסות מדומות, היה חושף את ״מניפולציית המחשבון״ לפני ההשקה. זה היה הסוג החדש היחיד של חוסר הלימה שזיהינו בתעבורת ChatGPT שנותחה. מניפולציית מחשבון היא סוג של reward hacking שבו המודל משתמש בכלי דפדפן כמחשבון, אך מציג את הפעולה כחיפוש. אין פירוש הדבר שביקורת בקנה מידה גדול תזהה כל כשל חדש, אבל הוא ממחיש מדוע הקשרים מציאותיים חשובים: הם יכולים לעורר התנהגויות שמערכי הערכה מצומצמים יותר עשויים לעולם לא לחשוף ישירות, גם אם ההתנהגויות האלה לא הופיעו בתעבורה המקורית ששימשה בסיס לסימולציה.
יתרון נוסף של שימוש בהקשרים דמויי פריסה הוא האפשרות לצמצם עיוותים שנוצרים כשמודלים מזהים שהם נבחנים. במחקרים קודמים, גם אנחנו וגם אחרים(נפתח בחלון חדש) מצאנו שלעיתים קרובות מודלים מודעים לכך שהם נבחנים. לדוגמה, מודלים עשויים לשקול בשרשרת המחשבה שלהם במה בוחנים אותם, מה עשוי למצוא חן בעיני המעריך, ואם הם מתנהגים שלא כראוי — האם יתפסו אותם. הדבר מציב בעיה להערכות הלימה: אם מודל מתנהג כראוי רק משום שהוא חושב שהוא נבחן, איך נוכל לבטוח בכך שיתנהג בבטחה לאחר שיבין שנפרס לשימוש?
אנחנו מראים שסימולציית פריסה מפחיתה משמעותית את רמות המודעות לבחינה שמודלים מפגינים, בהשוואה להערכות מסורתיות שאינן מבוססות על נתוני פריסה אמיתיים. אנחנו מודדים מודעות לבחינה בשלוש דרכים: מבקשים ממודל לסווג אם רצף פעולה הגיע משימוש בפועל או מהערכה; מנטרים את שרשרת המחשבה לאיתור אמירות מפורשות על כך שנבחנת ההלימה שלו; ומחפשים גם מטא־גיימינג(נפתח בחלון חדש) — כל reasoning הנוגע לפיקוח. תעבורת הפריסה המדומה תאמה במידה רבה את תעבורת הפריסה האמיתית בכל שלושת המדדים. לדוגמה, GPT‑5.2 סיווג תעבורת שימוש אמיתית כדמוית הערכה ב־5.4% מהמקרים, ותעבורה מדומה ב־5.1% מהמקרים. לעומת זאת, הערכות מסורתיות, כמו SWE-Bench או MonorepoBench שמורכבות בעיקר מדוגמאות סינתטיות, סווגו כהערכות בכמעט 100% מהמקרים.
איור 5. השוואת מודעות לבחינה: תעבורת שימוש אמיתית ותעבורה מדומה מציגות שיעורים דומים של זיהוי הערכה, מודעות לבחינת הלימה שבאה לידי ביטוי מילולי ומטא־גיימינג, ואילו במערכי נתונים מסורתיים להערכה נמדדים שיעורים גבוהים בהרבה.
כדי לבדוק אם אפשר להרחיב את השיטה מעבר למצבי צ'אט רגילים, חקרנו גם הדמיית פריסות בסביבות מאתגרות של תכנות אג'נטי. בפרט, אנחנו משתמשים ב־120,000 רצפי פעולה אג'נטיים של עובדים בשימוש פנימי ב־GPT‑5.4, כדי לדמות פריסה פנימית של סוכני תכנות המבוססים על GPT‑5.5. הדבר משרת שתי מטרות: הוא מראה שאפשר להשתמש בסימולציית פריסה גם להערכת סיכונים בפריסות פנימיות, ומדגים שאפשר להגיע לנאמנות גבוהה למציאות גם בסביבות אג'נטיות, באמצעות הדמיה קפדנית של כלים.
לעיל הסברנו שנאמנות הסימולציה למציאות היא אחד ממקורות השגיאה העיקריים בתהליך הנוכחי שלנו. אחד האתגרים ביצירת סימולציות פריסה מציאותיות הוא הצורך שהכלים יפעלו באופן מציאותי, גם כשהם זקוקים לגישת קריאה וכתיבה למשאבים חיצוניים שמשתנים כל הזמן, למשל בחיפוש ברשת או באינטראקציה עם קבצים מקומיים.
הדבר מאתגר במיוחד בסביבות כמו פריסות אג'נטיות: רצף פעולה יחיד של סוכן עשוי להיות תלוי במאות קריאות לכלים, במצב המאגר, בתגובות מהרשת או בתקלות חולפות. לכן דגימה מחדש עם גישה לכלים אמיתיים היא מאתגרת ואף עלולה להיות מסוכנת. לאור זאת, במקום להפעיל קריאות לכלים על מערכות חיות, אנחנו מדמים אותן באמצעות LLM אחר. אנחנו מראים שהענקת אפשרויות נוספות ל־LLM הזה חיונית למציאותיות, ולכן גם לאיכות האומדנים.
אנחנו מספקים למודל שמדמה את הכלים את רצף הפעולה המקורי מהתור האחרון, את המאגר כפי שהיה בזמן השיחה, מסד נתונים של זוגות קריאה לכלי ותגובה, ומחברים לקריאה בלבד. במבחן שבו מודל מבחין ניסה להבדיל בין רצפי פעולה מדומים לאמיתיים, המציאותיות השתפרה משיעור ניצחון של 11.6% ל־49.5%, קרוב לרמת הניחוש האקראי של 50%.
איור 6: אפשר להפוך את הדגימה מחדש למציאותית עד שכמעט אי אפשר להבחין בינה לבין דגימה אמיתית, גם בסביבות עתירות כלים, כשמדמים קריאות לכלים עם אפשרויות מורחבות.
כעדות נוספת לנאמנות הסימולציה למציאות, כשמדמים תעבורת Thinking של GPT‑5.4 Codex באמצעות GPT‑5.4, שיעורי חוסר ההלימה נמצאים כמעט כולם בטווחי השגיאה. לעומת זאת, בבדיקות שלנו לפני הפריסה, GPT‑5.5 הפגין יותר חוסר הלימה ברוב הקטגוריות.
איור 7: עם הדמיית כלים, שיעורי ההתנהגות בשיחות שנדגמו מחדש באמצעות GPT‑5.4 ובתעבורת השימוש האמיתית ב־GPT‑5.4 דומים למדי — מה שמעיד על נאמנות גבוהה של סביבת הדגימה מחדש למציאות. ראו את כרטיס המערכת של GPT‑5.5(נפתח בחלון חדש) להקשר נוסף על הקטגוריות.
התוצאות האלה מצביעות על כך שאפשר להרחיב את סימולציית הפריסה לסביבות מורכבות של סוכנים, כשסביבת הכלים שסביבם מדומה בנאמנות מספקת למציאות.
שאלה טבעית היא אם מבקרים חיצוניים יכולים ליהנות מחלק מאותם יתרונות בלי גישה לתעבורת שימוש פרטית. בדקנו זאת באמצעות 100,000 שיחות מ־WildChat ששימשו כתחיליות שיחה. WildChat היה פחות מדויק מנתוני השימוש בפועל של OpenAI מהזמן האחרון, אך עדיין סיפק מידע מועיל: לנתוני השימוש העדכניים הייתה שגיאה כפלית ממוצעת נמוכה יותר מזו של WildChat (פי 1.75 לעומת פי 2.44), ואילו האומדנים של WildChat נשארו לעיתים קרובות בטווח של בערך פי 3 מהשיעורים בפועל וזיהו את המודל הטוב יותר בשיעור גבוה מניחוש אקראי. אנחנו רואים בהערכות בסגנון WildChat השלמה מבטיחה לסימולציית פריסה שמריצים המפתחים. לתוצאות נוספות בנושא, ראו את הפוסט הנלווה בבלוג ההלימה(נפתח בחלון חדש).
סימולציית פריסה היא השלמה להערכות עוינות, ל־red teaming ולניתוח ממוקד של סיכוני זנב, ולא תחליף להם. זיהוי של חלק מההתנהגויות הלא רצויות של מודלים נשען על היכולת לנטר את שרשרת המחשבה: אם מודלים עתידיים יחשבו באופן פחות ברור לקריאה, ישמיטו שלבים מרכזיים או ילמדו להסוות כוונות, ייתכן שלא נוכל לזהות את צורות ההתנהגות הלא רצויה האלה. נוסף על כך, משום שנתוני השימוש בפועל הם פרטיים, למפתחים יש כיום גישה טובה יותר להקשרים מייצגים מאשר למבקרים חיצוניים. מערכי נתונים ציבוריים טובים יותר יוכלו לצמצם את הפער.
סימולציית פריסה מועילה במיוחד להתנהגויות שמתרחשות בתדירות גבוהה מספיק כדי להופיע בתחיליות השיחה שנדגמו. כשל שמתרחש פעם בעשרה מיליון שיחות כנראה לא יתגלה בהרצה של מיליון דגימות, ולכן הערכות עוינות, red teaming וניתוח ממוקד של סיכוני זנב עדיין נחוצים. אנחנו מתמקדים כיום בהדמיית תגובה יחידה של העוזר, משום שבניסויים ראשוניים לא מצאנו שהדמיית כמה תורות משפרת משמעותית את האומדנים שלנו. ייתכן שזה יהיה תחום חשוב לשיפור נאמנות הסימולציה למציאות בעתיד.
השיטה תלויה גם בהתפלגות תחיליות השיחה — תמהיל השיחות שנדגמות מחדש. ייתכן שתעבורת העבר לא תשקף את האופן שבו משתמשים מתקשרים עם מודל בעל יכולות מתקדמות יותר לאחר שינוי משמעותי במוצר, השקת כלי חדש, אירוע עולמי או שינוי עונתי. הניתוח במאמר המלא מצביע על כך שאפשר לצמצם את הבעיה באמצעות שימוש בנתונים העדכניים ביותר הזמינים.
סימולציית פריסה היא גישה חדשה להערכת סיכונים לפני פריסה, שעוזרת למעבדות חזית ולמעריכים לחזות כיצד מודלי שפה עשויים להתנהג בעולם האמיתי ולהבין את הסיכונים שהם מציבים לפני פריסתם. היא משלימה הערכות בטיחות קיימות, red teaming וניתוח ממוקד באמצעות שכבת חיזוי שדומה יותר לשימוש בפועל. שכבה זו יכולה לשפר את אומדני ההתנהגות לאחר הפריסה, לצמצם את השפעות המודעות לבחינה ולאפשר לבדוק לאחר ההשקה את התחזיות שנעשו לפניה. בשילוב עם הערכות מסורתיות, סימולציית פריסה יכולה לסייע להפוך את הערכת הסיכונים של מודלים למציאותית יותר, כמותית יותר ומועילה יותר להחלטות על פריסה.