עבור בינה מלאכותית קולית, לדעת מתי לדבר קשה יותר ממה שזה נשמע. בני אדם מעבירים את רשות הדיבור זה לזה בשבריר שנייה וללא מאמץ, אבל מערכות קודמות של בינה מלאכותית קולית לא הצליחו לעמוד בקצב הזה. הארכיטקטורה שלהן התבססה על תורות דיבור והסתמכה על מודלים זעירים לזיהוי תורות. המשימה שלהם לא הייתה פשוטה: ניחוש מוקדם מדי קוטע את המשתמש; ניחוש מאוחר מדי גורם לתגובה להרגיש איטית. רק אחרי שהגלאי קיבל החלטה, מודל ה-LLM הגדול בהרבה יכול היה להתחיל לעבוד.
GPT‑Live, הדור השלישי של המערכת הקולית שלנו, מוציא את גלאי התורות מנתיב האודיו. המודל הקולי שלו פועל בתקשורת דו־כיוונית מלאה, כלומר הוא יכול להקשיב ולדבר בו־זמנית. כך מתבטל הצורך בגלאי נפרד, והשיחה מרגישה מיידית וטבעית יותר. כשנדרש reasoning מעמיק יותר או שימוש בכלים, GPT‑Live יכול גם להתייעץ עם מודלי החזית שלנו, כמו GPT‑5.5, בלי לפגוע ברצף השיחה. יחד, היכולות האלה מעניקות ל-GPT‑Live שילוב חסר תקדים של תגובה מהירה בשיחה ותבונה.
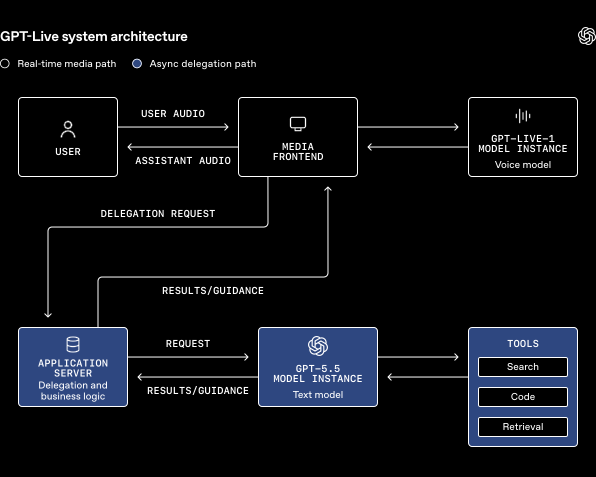
כדי לספק את החוויה הזאת בקנה מידה גדול, נדרשה ארכיטקטורת מערכת חדשה שהותאמה להשהיה נמוכה. בניגוד להסקה טיפוסית במתכונת בקשה־תגובה, המערכת שלנו מזרימה אודיו נכנס אל המודל הקולי ודיבור יוצא בחזרה למשתמש, ובמקביל מטפלת בהאצלת משימות בנתיב אסינכרוני נפרד. במהלך ששת החודשים האחרונים תכננו מחדש את הסקת המודל, ניהול ההקשר ותעבורת המדיה, כדי לשמור על זרימה חלקה של הדיבור מקצה לקצה.
הארכיטקטורה גם יוצרת הפרדה ברורה בין הנתיב הקולי המרכזי לבין הלוגיקה היישומית. כך קל להתאים את התנהגות היישום בלי להשפיע על מהירות התגובה. התשתית הזאת מפעילה מגוון הולך וגדל של יכולות ב-ChatGPT Voice, כולל היכולת שהושקה לאחרונה לשלוט במחשב שלכם ולתאם בין הסוכנים שלכם באפליקציית ChatGPT למחשב.
בפוסט הזה נסביר מדוע מערכות קודמות המבוססות על תורות דיבור לא יכלו לתת מענה לצרכים שלנו, וכיצד בנינו את המערכת החדשה לתגובה מהירה בכל שכבה. נסקור הסקה ששומרת מצב, ניהול הקשר דינמי, האצלת משימות אסינכרונית ואופטימיזציה ברמת הפרוטוקול — שכולם פועלים יחד כדי ש-GPT‑Live ירגיש באמת חי.
ארכיטקטורות קוליות קודמות ירשו ממודלי LLM לטקסט את המבנה המבוסס על תורות, אך כל תור יוצג כגוש אודיו נפרד במקום כטקסט. במערכות משורשרות, המרת דיבור לטקסט, מודל ה-LLM והמרת טקסט לדיבור פעלו בזה אחר זה. הפעולה הסדרתית הזאת הוסיפה השהיה והתעלמה מרמזים כמו טון וקצב הדיבור.
מודלי speech-to-speech שיפרו את הגישה הזאת באמצעות עיבוד ישיר של אודיו. אימון המודל להבין ולהפיק דיבור באופן מובנה אפשר לו לשמר פרטים שאובדים בתמלול ולהגיב מהר יותר. אבל המערכת עדיין הסתמכה על גלאי התורות כדי להחליט מתי אפשר להתחיל בהסקה. המודל טיפל בחלק גדול יותר מהאינטראקציה, אבל האינטראקציה נשארה מבוססת על תורות.
GPT‑Live מעביר את השליטה בשיחה למודל הקולי: אודיו זורם אל המודל וממנו, ובמקביל reasoning מעמיק יותר ושימוש בכלים מתבצעים באופן אסינכרוני. התפקיד העיקרי של המערכת הוא לקיים לולאת מדיה ללא הפרעות. פעולות אחרות, כמו הפעלת מודלי חזית ושמירת השיחה באחסון מתמשך, מתבצעות מחוץ לנתיב בזמן אמת.
לא תמיד פשוט לשמור על לולאת המדיה הזאת ללא הפרעות. כל עיכוב בתעבורה, בעיבוד או בהסקה עלול להפוך להפסקה או לשיבוש שנשמעים באודיו. המערכת הקודמת, שהתבססה על תורות דיבור, יכלה לסבול מידה מסוימת של שונות במועד הגעת גוש אודיו. לעומת זאת, מערכת מדיה בזמן אמת צריכה להעביר כל פריים של אודיו במועדו.
העבודה הקודמת על ChatGPT Voice ועל Realtime API סיפקה לנו בסיס חשוב. כבר בנינו מחדש את התשתית הקולית שלנו כדי להזרים אודיו ווידאו ישירות אל המערכות שלנו ומהן, עם השהיה נמוכה וצפויה יותר. GPT‑Live לקח את התכנון הזה צעד נוסף קדימה: הזרמת מדיה עד למודל עצמו, דרך מערכת הסקה חדשה ששומרת מצב ונבנתה לשיחה רציפה.
אבל הסקה בהזרמה הייתה רק חלק מהפתרון. כדי שתעבוד היטב בסביבת הייצור, היינו צריכים גם להבטיח העברה אמינה של אודיו מיישום הלקוח למערך ההסקה, ולהתמודד עם האתגרים הכרוכים בשמירת מצב.
אחת ההחלטות המוקדמות שקיבלנו הייתה להפריד במפורש בין זרימת המדיה לבין הלוגיקה היישומית והעסקית. האודיו נע בין יישום הלקוח למודל הקולי בנתיב מהיר וייעודי. האצלת משימות, שימוש בכלים ופעולות יישומיות אחרות מתבצעים מעבר לממשק RPC אסינכרוני. קריאה איטית לכלי או שירות איטי בשכבת העורף יכולים לעכב את התוצאה שלהם, אך לא לעצור את זרימת המדיה.
ההפרדה הזאת גם יוצרת במערכת גבול ברור לצורך התאמה אישית. יישומים יכולים לשנות את הכלים, המדיניות והתנהגות שכבת העורף שלהם, בלי להשפיע על שכבת חזית המדיה שאחראית לשמור על זרימת האודיו. הנתיב בזמן אמת נשאר מצומצם, צפוי וממוקד בפעולות שחייבות להתבצע בזמן אמת.
כתבנו את שכבת חזית המדיה ואת לוגיקת ההסקה ב-Go, במקום המימוש הקודם ב-Python עם asyncio. כך השתפרה משמעותית רציפות העברת הפריימים: ה-p95 של המערכת החדשה השתווה ל-p50 של המערכת הקודמת.
WebRTC מספק את הבסיס לתעבורה. הוא תוכנן להעברת מדיה בהשהיה נמוכה, ויכול להמשיך לפעול גם כשיש אובדן מנות, סטיית שעון ושינויים בחיבור של יישום הלקוח. אם מנות מגיעות באיחור, WebRTC יכול להאריך מעט את האודיו כדי למנוע פערים, ואז להאיץ לזמן קצר את ההשמעה כדי להסתנכרן מחדש עם זמן אמת.
באמצעות צמצום האגירה והחסימות בכל רחבי המערכת, אנחנו יכולים לספק תגובה בתוך פחות משנייה — כפי שאנשים מצפים בשיחה.
הסקה ששומרת מצב כרוכה בפשרות תפעוליות משלה. סשן קולי עשוי להישאר פעיל זמן רב, אך ההקשר שלו הולך וגדל, ומופעי מודל מופעלים ומושבתים בהתאם לביקוש.
כדי להתמודד עם האתגרים האלה, בנינו מנגנון להעברה חלקה בין מופעי מודל. כשנדרש מעבר, אנחנו יכולים להכין מופע מודל חלופי לצד המופע הקיים, להזין ולעבד בו מראש את ההקשר הנוכחי של הסשן, להריץ הסקה בשניהם במקביל ולעבור למופע החדש כשהוא מוכן לחלוטין.
אותו מנגנון בסיסי תומך גם ב-compaction דינמי. ככל שהשיחה נמשכת, ההקשר המצטבר שלה עלול בסופו של דבר לחרוג ממגבלת ההקשר של המודל. compaction יכול לצמצם את גודל ההקשר כך שיעמוד במגבלה, אבל הפעולה אורכת זמן. ומכיוון שהפעולה משנה הקשר קודם, היא גם מבטלת את תוקפו של מטמון המפתח־ערך (KV) של המודל, שבו נשמרים מפתחות וערכים של מנגנון הקשב מטוקנים שכבר עובדו. בנייה מחדש של המצב הזה מחייבת הזנה ועיבוד מקדימים נוספים, שמוסיפים השהיה.
במקום זאת, אנחנו מתייחסים ל-compaction כאל עוד מעבר מנוהל. בזמן שמופע המודל המקורי ממשיך בשיחה, המערכת מצמצמת את ההקשר ומכינה מופע מודל חלופי עם ההקשר החדש. ברגע שהמופע הזה מוכן, אפשר לעבור אליו בלי שום הפרעה בזרימת המדיה. כך המערכת יכולה לתמוך בשיחות ממושכות ולצמצם את ההקשר בכל פעם שנדרש.

העבודה הכבדה מתבצעת מחוץ לנתיב בזמן אמת, כך שגם בעת העברה בין מופעים, השיחה לא מאבדת את הקצב.
היכולת של GPT‑Live להפעיל מודלי חזית קיימים מעניקה לו עוצמה רבה, ובפועל מפרידה בין ״דיבור״ לבין ״חשיבה״ מעמיקה יותר. אבל כדי שארכיטקטורה של שני מודלים תרגיש כמו מערכת אחת, היה עלינו לפתור שתי בעיות הנדסיות קשורות.
האצלת משימות לעבודה מעמיקה יותר
GPT-Live מספק תגובות מהירות וטבעיות, בזמן ש-GPT-5.5 מטפל בחיפוש ברקע
ראשית, התוצאות חייבות לחזור מהר מספיק כדי להועיל לשיחה המתנהלת, ולכן היינו צריכים למזער את ההשהיה לאורך כל נתיב האצלת המשימות — מניתוב ועיבוד פרומפטים ועד הסקה וקריאות לכלים. במקביל, מערכות בחלקים אחרים של המוצר עדיין זקוקות להודעות נפרדות, ולכן היינו צריכים לייצג את השיחה המתמשכת בצורה שהן יוכלו להבין.
כשנשלחת משימה למודל אחר, אנחנו פועלים לקצר את הזמן עד שמודל החזית מפיק משהו מועיל לשיחה. המודל הקולי יכול לשמור לזמן קצר על רצף השיחה בזמן שמודל חזית חושב או משתמש בכלים, אבל הוא לא יכול להסוות תגובה איטית ללא הגבלת זמן. לכן כללנו את כל מחזור האצלת המשימות — ניתוב, עיבוד פרומפטים, הסקה וקריאות לכלים — בתקציב זמן התגובה.
האופטימיזציה הראשונה היא להכין את מודל החזית ואת כל הכלים הדרושים לו לפני שמתקבלת בקשה להאצלת משימה. כשסשן קולי מתחיל, שרת היישום יוצר סשן הסקה למודל החזית ומזין ומעבד בו מראש את ההקשר הראשוני של השיחה, כך שעיבוד הפרומפט מסתיים במלואו לפני האצלת הבקשה הראשונה.
לאחר מכן אנחנו שומרים את סשן ההסקה זמין לאורך כל השיחה הקולית, ומנתבים בקשות עוקבות בעקביות לאותו סשן. בשילוב עם מטמון פרומפטים, השיטות האלה מקצרות את ההשהיה, ועדיין מאפשרות התאוששות קלה מכשל של תהליך עבודה.
גם מאמץ ה-reasoning, מגבלות הפלט, סכמות הכלים וסבבי התקשורת בין המודל לכלים משפיעים על הזמן עד שתוצאה מועילה מגיעה לשיחה, וכיווננו אותם כדי לקבל תגובות מהירות יותר. באמצעות צמצום העבודה הנדרשת בנתיב האצלת המשימות, אפשרנו למודל הקולי לשלב במהירות תוצאות ממודלי החזית שלנו.
אף שהמודל הקולי פועל על זרמי דיבור רציפים, רבות מהמערכות סביבו עדיין פועלות לפי תורות של משתמש ועוזר, ובהן ממשק השיחה של ChatGPT וחלקים מתשתיות האנליטיקה והבטיחות שלנו. לכן שרת היישום מפרק את השיחה, שיש בה חפיפות ולעיתים גם אי־בהירות, להודעות נפרדות.
כשהאודיו מגיע, השרת נעזר בתמלולים חלקיים ובאותות תזמון כדי להסיק מי מחזיק ברשות הדיבור ולבנות תור של הודעות. ההודעה החדשה ביותר נשארת זמנית: הטקסט, התזמון והשיוך שלה לדובר יכולים להשתנות ככל שמגיע עוד דיבור. לאחר שדובר מחזיק ברשות הדיבור זמן מספיק כדי שהשיוך יהיה אמין, השרת מקבע את ההודעה המתאימה.
דיבור בו־זמני מסבך את התהליך. תגובה קצרה של העוזר שמסמנת הקשבה בזמן שהמשתמש מדבר, כמו ״ממ־המ״ או ״בסדר״, לא צריכה בהכרח להפוך להודעה בפני עצמה. לעומת זאת, התערבות של העוזר שיש בה תוכן ממשי לרוב כן צריכה להפוך להודעה נפרדת. בדומה לכך, אנחנו נותנים עדיפות ללכידות של תגובות העוזר המוצגות, גם כשהמשתמש מדבר באמצע.
כל מדיניות חלוקה למקטעים מחייבת איזון בין עדכניות לוודאות. קיבוע מוקדם מדי יוצר היסטוריה מקוטעת וסדר לא יציב; המתנה ממושכת מדי מעכבת את התמלולים ואת היכולות שתלויות בהם. לכן המערכת מחזיקה שני ייצוגים קשורים של השיחה: ייצוג משוער של המצב הנוכחי ורישום מוסמך של מה שנאמר. תצוגת השיחה בממשק היישום יכולה להתמודד עם עדכונים, ולכן היא משתמשת בייצוג המשוער. אבל רישום בצינור עיבוד האנליטיקה מחייב תמלול סופי.
כך שאר המערכות של ChatGPT מקבלות ייצוג יציב של השיחה, בלי לכפות חלוקה לתורות על הנתיב הקולי בזמן אמת.
מהירות התגובה חשובה כבר מהרגע שבו המשתמש לוחץ על הכפתור. ב-GPT‑Live, המערכת חייבת להקים את נתיב המדיה ולהתחיל להזרים אודיו דרך המודל לפני שהשיחה יכולה להתחיל. כך כל שלב ברצף האתחול הופך לחלק מהנתיב הקריטי.
כאמור, WebRTC מספק בסיס חזק לפעולה בזמן אמת, אבל התחלת סשן WebRTC רגיל דורשת מספר מפתיע של לחיצות יד בין פרוטוקולים וסבבי תקשורת ברשת. WebRTC קדם לדגש על צמצום סבבי התקשורת שעיצב פרוטוקולים מאוחרים יותר, כמו QUIC. כתוצאה מכך, הפרוטוקולים שבבסיסו לפעמים מבצעים עבודה כפולה כשהם פועלים יחד. למשל, כל פרוטוקול כלל מנגנון משלו להגנה מפני DoS, גם כאשר לא היה בו צורך בהקשר של מכלול פרוטוקולי WebRTC.
ניתחנו את מכלול הפרוטוקולים ופיתחנו את WebRTC Abridged Roundtrip Protocol (WARP(נפתח בחלון חדש)), שמצמצם את אתחול המדיה והנתונים משישה סבבי תקשורת ברשת לסבב אחד בלבד. WARP משיג זאת באמצעות שיפורי פרוטוקול בעלי תאימות לאחור: שילוב לחיצת היד של DTLS בתעבורת ICE (SPED(נפתח בחלון חדש)), שימוש בלחיצת היד המהירה יותר של DTLS 1.3(נפתח בחלון חדש), תיאום מראש של לחיצת היד של SCTP (SNAP(נפתח בחלון חדש)) ותיאום מראש של ערוצי נתונים במקום שימוש ב-DCEP(נפתח בחלון חדש).
תכננו את WARP כמערכת של מפרטים פתוחים, בשיתוף עם עמיתים מקהילת WebRTC, כדי שגם שאר האקוסיסטם יוכל ליהנות מהעבודה הזאת. אנחנו מקדמים את ההצעות במסגרת קבוצת העבודה TSVWG של IETF. תמיכה ב-WARP כבר נוספה גם ל-libwebrtc וגם ל-Pion, והעבודה על שילובו במימושים אחרים של WebRTC נמשכת.

לאחר שביצענו אופטימיזציה ללחיצת היד של המדיה, בלט עיכוב אחד שנותר: חילופי האיתותים שנועדו לשתף פרמטרי SDP לפני ש-WebRTC יכול להתחבר. כדי להוציא את חילופי האיתותים האלה מהנתיב הקריטי, פיתחנו מנגנון שאנחנו קוראים לו Instant Connect. הוא מתאם את הפרמטרים האלה מראש, בלי לשריין קיבולת בשרת ובלי לשנות דבר במימושי WebRTC הקיימים.
Instant Connect פועל לצד תהליך האיתות הרגיל. אם הפרמטרים שתואמו מראש תקפים, השרת יכול ליצור את הסשן בפועל כשמנת המדיה הראשונה מגיעה. אם הם מיושנים או לא תקפים, תהליך האיתות כבר מתנהל, ולכן יישום הלקוח יכול לעבור למסלול הרגיל בלי השהיה נוספת.
יחד, Instant Connect ו-WARP מקצרים באופן ניכר את הזמן מהרגע שהמשתמש מבקש להתחיל ועד לזרימת מדיה בזמן אמת. כשחילופי ה-SDP נמצאים מחוץ לנתיב הקריטי ו-WARP מקצר את לחיצת היד של התעבורה, יישום הלקוח יכול כעת להתחיל סשן באמצעות מנת UDP אחת. השרת יכול להגיב מיד, ולאפשר לשאר המערכת להתחיל לעשות את מה שבאמת חשוב למשתמש: להקשיב ולהגיב.
מערכת יכולה להיראות מהירה על הנייר, ובכל זאת להיתקע תחת תעבורה קולית אמיתית. לפני שאפשרנו ל-GPT‑Live לשוחח עם משתמשים, הרצנו בדיקה שקטה שניתבה חלק קטן, שהלך וגדל בהדרגה, מסשני ChatGPT Voice בסביבת הייצור גם לחוויית המצב הקולי המתקדם הקיימת וגם למערכת החדשה שלנו. המצב הקולי המתקדם המשיך לשרת את המשתמשים כרגיל, ואילו במסלול המקביל הורצה הסקה במצב קריאה בלבד. כך נחשפה המערכת ליישומי לקוח, לרשתות, למשכי סשנים ולפריסה גאוגרפית מהעולם האמיתי, בלי לשנות את מה שהמשתמשים שמעו.
אחד הלקחים הראשונים היה שאי אפשר למדוד קיבולת רק לפי תפוקת ה-GPU. סשנים קוליים נשארים פתוחים ושולחים פריימים ברציפות, ולכן גם רכיבי הטיפול בזרמים בצד ה-CPU, התורים ונתיבי הרשת צריכים לגדול לצד מערך ההסקה. בעומס אמיתי, רכיב תומך הגיע לרוויה מוקדם מכפי שחזינו בבדיקות העומס, וגרם לבקשות הסקה להצטבר ולזמני ההשהיה להתארך עוד ועוד. שינינו את שאלת הקיבולת מ-״בכמה בקשות יכול GPU לטפל?״ ל-״בכמה סשנים מקבילים יכולה המערכת לתמוך תוך העברת כל פריים בזמן?״
הבדיקה גם הבהירה שהמיקום הגאוגרפי הוא שיקול מרכזי. ניתוב סשן למשאבי מחשוב מרוחקים עלול להוסיף השהיה בכמה נקודות במהלך האתחול וההזרמה. התחלנו לבדוק פריסות של מודלים יחד עם הקיבולת האזורית ותצורת ניתוב התעבורה, ואז לנתח את זמני ההשהיה לפי האזור הגאוגרפי שממנו הגיעה התעבורה. קירוב ההסקה למשתמשים עזר, אך גם חיזק את הלקח הרחב יותר: מהירות התגובה מקצה לקצה תלויה בכל שירות בנתיב, ולא רק בשרת המודל.
כשלים אחרים התגלו רק לאורך מחזורי חיים מציאותיים של סשנים. סשנים ממושכים חשפו עומס על הזיכרון ועל האחסון המתמשך. התחברויות מחדש העמידו למבחן את ה-compaction ואת שחזור המצב. ניתוקים שגרתיים של יישומי לקוח חשפו תנאי מרוץ בלחיצת היד לסגירת החיבור. הבעיות האלה כמעט שלא הופיעו בבדיקות עומס קצרות, משום שהן היו תלויות בזמן, במצב שנצבר ובאינטראקציות בין שירותים.
לבסוף, הבדיקות בסביבת הייצור אילצו אותנו לשפר את יכולות הניטור ואת מנגנוני הבקרה על הפריסה. מצאנו מדדים שערבבו בין מקורות שונים של השהיה, לוחות בקרה שנתונים מצרפיים בהם הסתירו מנועים בודדים שלא פעלו כשורה, ופערי תצורה בין המערכות שנבדקו לאלה שנפרסו. בתגובה, הוספנו טלמטריה מפורטת יותר, אימות מול תצורות שידוע שהן תקינות, הגדלת תעבורה בשלבים ויכולת לבודד או להשבית במהירות נתיבים בודדים. הבדיקה השקטה הפכה לחזרה מוקדמת לקראת ההשקה: לא רק כדי לבחון כמה תעבורה המערכת יכולה לקבל, אלא גם באיזו מהירות נוכל לזהות כשל, להגביל את השפעתו ולהתאושש ממנו.
כדי להפעיל את GPT‑Live בהיקף של ChatGPT, נדרשה מערכת חדשה לגמרי שנבנתה סביב עיקרון יסודי אחד: האודיו חייב לזרום. הסקה בהזרמה מזינה את המודל הדו־כיווני באודיו ברציפות. נתיב מדיה ייעודי מבטיח העברה אמינה של פריימים. האצלת משימות אסינכרונית מאפשרת לחשיבה מעמיקה יותר להתבצע במקביל. תעבורה שעברה אופטימיזציה שומרת על תגובה מהירה לאורך כל הדרך עד למשתמש.
הארכיטקטורה שמאחורי GPT‑Live כבר הופכת לפלטפורמה רחבה יותר לאינטראקציה בזמן אמת. היא מפעילה את ChatGPT Voice, שמתרחב משיחה לתיאום אג'נטי, ותשמש בסיס ל-GPT‑Live API שיושק בקרוב. עם הזמן, היא תאפשר לחוויות קוליות לפעול במגוון רחב יותר של מכשירים, אפליקציות ואופני קלט ופלט, בלי לוותר על המיידיות שמעניקה לשיחה קולית תחושה חיה.
אם אלה האתגרים ההנדסיים שמעניין אתכם לפתור, בואו לעבוד איתנו.