GeneBench-Pro રજૂ કરી રહ્યાં છીએ
કમ્પ્યુટેશનલ બાયોલોજીમાં AI એજન્ટો અસ્પષ્ટતામાંથી કેવી રીતે માર્ગ કાઢે છે અને મહત્વપૂર્ણ પરિણામો ધરાવતા નિર્ણયો કેવી રીતે લે છે તે માપતું સંશોધન-સ્તરનું બેન્ચમાર્ક.
વૈજ્ઞાનિક ડેટા ભાગ્યે જ સૂચનાઓ સાથે આવે છે. સંશોધકોએ નક્કી કરવું જોઈએ કે કોઈ પેટર્ન જીવવિજ્ઞાનને પ્રતિબિંબિત કરે છે કે માત્ર નોઇઝ છે, ડેટા પૂછવામાં આવેલા પ્રશ્નને સમર્થન આપી શકે છે કે નહીં, અને દરેક પરિણામે તેઓ આગળ શું કરે તેમાં કેવી રીતે ફેરફાર લાવવો જોઈએ. AI એજન્ટ્સ જટિલ વિશ્લેષણો હાથ ધરવા માટે વધતી જતી ક્ષમતા ધરાવે છે, પરંતુ વાસ્તવિક વૈજ્ઞાનિક સંશોધન માત્ર તથ્યો યાદ કરવા અથવા પૂર્વનિર્ધારિત કાર્યપ્રવાહનું અનુસરણ કરવા પર જ નહીં, પરંતુ આવા ઉચ્ચ-ક્રમના મૂલ્યાંકનાત્મક નિર્ણયો લેવા પર પણ આધાર રાખે છે.
આજે, અમે GeneBench-Pro રજૂ કરી રહ્યા છીએ—એક પડકારજનક, સંશોધન-સ્તરીય બેન્ચમાર્ક, જે એ બાબતની ચકાસણી કરે છે કે મોડલ વાસ્તવિક દુનિયાની કમ્પ્યુટેશનલ બાયોલોજી માટે જરૂરી એવા નિર્ણય-પ્રધાન વિશ્લેષણને સંભાળી શકે છે કે નહીં. તે GeneBench(નવી વિન્ડોમાં ખૂલે છે) નું વિસ્તરણ છે જે જીનોમિક્સ, ક્વોન્ટિટેટિવ બાયોલોજી અને ટ્રાન્સલેશનલ મેડિસિન જેવા ક્ષેત્રોમાં વધુ મુશ્કેલ અને વાસ્તવિક કાર્યોને આવરી લે છે, જે કમ્પ્યુટેશનલ બાયોલોજીમાં વૈજ્ઞાનિક સંશોધનની જટિલતા, પુનરાવર્તિત પ્રકૃતિ અને અસ્પષ્ટતાને દર્શાવે છે.
અત્યાર સુધી, સિસ્ટમ-સ્તરના એવા નિર્ણય લેવાની પ્રક્રિયાઓનું કોઈ ખાસ સચોટ મૂલ્યાંકન થયું નથી, જે વાસ્તવિક દુનિયાના કમ્પ્યુટેશનલ સંશોધનને મુશ્કેલ બનાવે છે. આમાં અસ્પષ્ટતાને સંભાળવી, ધારણાઓમાં સુધારો કરવો, વિશ્લેષણનો યોગ્ય માર્ગ પસંદ કરવો અને પરિણામ ક્યારે નિર્ણય લેવા માટે તૈયાર છે તે જાણવું શામેલ છે. કારણ કે આ કૌશલ્યોને ઔપચારિક રીતે વ્યાખ્યાયિત કરવું મુશ્કેલ છે, તેમનું કડક રીતે મૂલ્યાંકન કરવું પણ મુશ્કેલ છે, જ્યારે તેમાં રહેલી નબળાઈઓ AIની કુલ કામગીરીને વધતા પ્રમાણમાં મર્યાદિત કરી રહી છે.
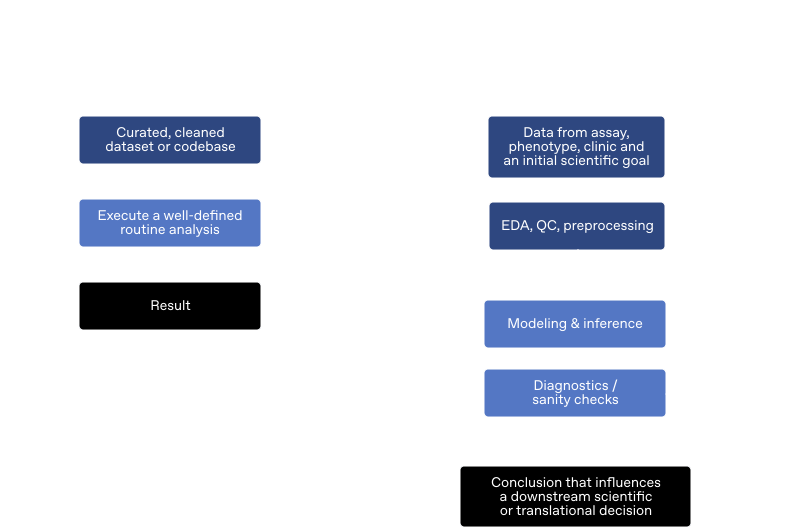
GeneBench-Pro આ ઉચ્ચ-સ્તરની ક્ષમતાઓને ચોક્કસ રીતે માપવા માટે રચાયેલ છે. GeneBench-Pro માં, અમે “સંશોધન રુચિ”ને એવા વિવેકાધીન નિર્ણયોની સાંકળો તરીકે વ્યાખ્યાયિત કરીએ છીએ જે વિશ્લેષણને આકાર આપે છે: ડેટા કયા પ્રશ્નોને સમર્થન આપી શકે છે, પ્રારંભિક ડાયગ્નોસ્ટિક્સે મોડલ અથવા એસ્ટિમૅન્ડમાં કેવી રીતે ફેરફાર કરવો જોઈએ, અને પ્રારંભિક યોજનામાં ક્યારે સુધારો કરવાની જરૂર પડે છે. દરેક GeneBench-Pro સમસ્યા મોડલને વાસ્તવિક અને અવ્યવસ્થિત ડેટાસેટ, સંક્ષિપ્ત પ્રયોગાત્મક સંદર્ભ, અને અનુવર્તી નિર્ણય સાથે જોડાયેલ લક્ષ્ય એસ્ટિમૅન્ડ આપે છે. સાચો જવાબ આપવા માટે, મોડલે ડેટાનું અન્વેષણ કરવું, યોગ્ય વિશ્લેષણાત્મક અભિગમ પસંદ કરવો, પ્રયોગોની પુનરાવર્તિત પ્રક્રિયામાં જોડાવું અને અંતિમ જવાબ આપવો જરૂરી છે.
જીવવિજ્ઞાનમાં, ડેટા જનરેશનનો ખર્ચ (દા.ત., જિનોમ સિક્વેન્સિંગ) નોંધપાત્ર રીતે ઘટ્યો છે, અને કેટલાક સંશોધકો હવે દલીલ કરે છે(નવી વિન્ડોમાં ખૂલે છે) કે મર્યાદિત કરતું પરિબળ હવે સેમ્પલ કલેક્શન નથી, પરંતુ ડાઉનસ્ટ્રીમ કમ્પ્યુટેશન અને વિશ્લેષણ છે. GeneBench-Pro તે અડચણને દૂર કરવામાં થતી પ્રગતિનું મૂલ્યાંકન કરવા માટે બનાવવામાં આવ્યું છે, જેમાં કમ્પ્યુટેશનલ બાયોલોજીની પરિસ્થિતિઓ અને પદ્ધતિઓની વિશાળ શ્રેણીને આવરી લેતા 129 પ્રશ્નો છે.
Domain Atlas: 129 સમસ્યાઓ 10 ડોમેન અને 21 સબ-ડોમેનમાં
બેન્ચમાર્ક સમસ્યા વિશે જાણવા માટે ઉપરના કોઈ બિંદુ પર ક્લિક કરો.
આ એટલાસ GeneBench-Pro ની વ્યાપકતાનો પૂર્વાવલોકન આપે છે. 10 પ્રતિનિધિ પ્રશ્નોને વધુ વિગતવાર સમજવા માટે કેસ સ્ટડીઝ પેજ ની મુલાકાત લો.
GeneBench-Pro સામાન્ય બેન્ચમાર્ક નિષ્ફળતાઓને ટાળવા માટે પણ ડિઝાઇન કરવામાં આવ્યું છે. ઘણા લાંબા ગાળાના જીવવિજ્ઞાન બેન્ચમાર્ક્સ અવ્યવસ્થિત ઐતિહાસિક ડેટાસેટ્સના આધારે બહુ-પગલાંવાળા પ્રશ્નો બનાવે છે, જ્યાં વિશ્લેષણમાંથી પસાર થવાનો એકમાત્ર સાચો માર્ગ ન હોઈ શકે. એક એજન્ટ કોઈ એક સમર્થનીય કટઓફ પસંદ કરી શકે, જ્યારે બીજો કોઈ અલગ પરંતુ તેટલો જ સમર્થનીય વિકલ્પ પસંદ કરી શકે, જે મોડલના પ્રદર્શનમાં કોઈ મૂળભૂત તફાવતો કરતાં બેન્ચમાર્ક બનાવનાર દ્વારા કરવામાં આવેલી મનસ્વી પસંદગીઓને વધુ પ્રતિબિંબિત કરે છે. ઉલટું પણ થઈ શકે છે: જો કોઈ સમસ્યા આંકડાકીય રીતે ખૂબ જ અસંવેદનશીલ હોય, તો એજન્ટ વિશ્લેષણમાં મૂળભૂત ભૂલો કરી શકે છે અને તેમ છતાં પાસ ગણાય તેવું પરિણામ આપી શકે છે.
નિષ્ફળતાના આ પ્રકારોથી બચવા માટે, GeneBench-Pro ની દરેક સમસ્યા કૃત્રિમ રીતે બનાવવામાં આવે છે: અમને સંપૂર્ણ કારણાત્મક માળખાની જાણ હોય છે અને અમે ડેટા જનરેટ કરવાની પ્રક્રિયાનું સીધું સિમ્યુલેશન કરીએ છીએ. તે અમને દરેક સમસ્યાની જટિલતાને સમાયોજિત કરવા, વ્યક્તિગત વિશ્લેષણાત્મક પસંદગીઓમાં વાજબી તફાવતો હોવા છતાં સ્વીકાર્ય સંખ્યાત્મક પરિણામો મળે તેની ખાતરી કરવા, અને એબ્લેશન અભ્યાસો દ્વારા ચકાસવા સક્ષમ બનાવે છે કે સંભવિત લાગે છતાં ખોટા વિશ્લેષણો નિષ્ફળ જાય છે. ત્યારબાદ, માહિતી લીકેજ અને અનિચ્છિત ઉકેલ માર્ગોની તપાસ કરવા માટે અમે વિગતવાર ટ્રેસ વિશ્લેષણો દ્વારા સમસ્યાના ડ્રાફ્ટ્સનું ઑડિટ કરીએ છીએ. આનાથી અમને વિશ્વાસ મળે છે કે સાચો જવાબ મેળવવો યોગ્ય વિશ્લેષણાત્મક માર્ગ પસંદ કરવા પર આધાર રાખે છે, કોઈ ટૂંકી માર્ગનો લાભ લેવા પર અથવા લેખકની મનસ્વી પસંદગીને મેળ પાડવા પર નહીં.

અમે 129 GeneBench-Pro પ્રશ્નોમાંથી 82 પ્રશ્નો બાહ્ય વિષય-ક્ષેત્ર નિષ્ણાતોને મોકલ્યા, જેમાં સ્નાતકોત્તર વિદ્યાર્થીઓ, પોસ્ટડોક્ટોરલ સંશોધકો, ઉદ્યોગ ક્ષેત્રના વૈજ્ઞાનિકો અને પ્રોફેસરોનો સમાવેશ થાય છે. સમીક્ષકોએ દરેક સમસ્યાની વાસ્તવિકતા, લક્ષિત જવાબ ઓળખી શકાય એવો હતો કે નહીં, અને પદ્ધતિઓ તથા અંદાજકો યોગ્ય હતા કે નહીં તેનું મૂલ્યાંકન કર્યું. પ્રતિસાદનો ઉપયોગ સમસ્યાઓ સુધારવા માટે કરવામાં આવ્યો હતો.
“મેં સમીક્ષા કરેલા પ્રશ્નો અનુભવી માર્ગદર્શક તરફથી મળતા વારંવારના પ્રતિસાદ વિના ઉકેલવા સ્નાતકોત્તર વિદ્યાર્થી માટે પડકારજનક રહ્યા હોત. આ ડેટામાં તકનીકી અને ક્વોલિટી કંટ્રોલની એવી સમસ્યાઓ હતી, જેને સફળતાપૂર્વક ઉકેલવા માટે સંભવિત જોખમોને ધ્યાનમાં રાખીને ખૂબ જ વિચારપૂર્વક અને ઝીણવટભર્યું ડેટા વિશ્લેષણ કરવું જરૂરી હતું; તે માત્ર સ્વચ્છ અને સુવ્યવસ્થિત ડેટા પર કોઈ તૈયાર પદ્ધતિ લાગુ કરવા જેટલું સરળ કામ નહોતું.”
“ભલે વર્તમાન મોડલ શરૂઆતથી અંત સુધી સ્વતંત્ર વિશ્લેષણ વિશ્વસનીય રીતે કરવા સક્ષમ ન હોય, તેમ છતાં જે મોડલ GeneBench-Pro સમસ્યાઓ પર સારું પ્રદર્શન કરે છે, તે ચોક્કસપણે સંશોધકોને સાચી કાર્યપદ્ધતિ નક્કી કરવામાં અને ડેટાનું અન્વેષણ કરવામાં મદદ કરી શકશે. હું જોઈ શકું છું કે તે સંશોધનની ગતિ, સઘનતા અને પુનરુત્પાદનીયતામાં ઘણો સુધારો કરી રહ્યું છે.”
દરેક GeneBench-Pro પ્રશ્ન એક સ્વયંસંપૂર્ણ વૈજ્ઞાનિક વિશ્લેષણ છે. એજન્ટોને એક અલગ વર્કસ્પેસની ઍક્સેસ મળે છે, જેમાં ટૂંકો પ્રોમ્પ્ટ, ડેટા ફાઇલો અને પ્રમાણભૂત બાયોઇન્ફોર્મેટિક્સ સ્ટેક હોય છે. આ સ્ટેકમાં Python, વૈજ્ઞાનિક કમ્પ્યુટિંગ લાઇબ્રેરીઓ અને PLINK 2.0 જેવી બેઝિક જીનોમિક્સ પેકેજોનો સમાવેશ થાય છે (જોકે આ સમસ્યાઓને ઉકેલવા માટે ડોમેન-વિશિષ્ટ ટૂલિંગની જરૂર હોતી નથી).
કારણ કે અમે ડેટા-જનરેશનની સંપૂર્ણ પ્રક્રિયા પર નિયંત્રણ રાખીએ છીએ, અમે જાણીતા લક્ષ્યો સામે સચોટતાનું નિર્ધારિત રીતે મૂલ્યાંકન કરી શકીએ છીએ, જેથી પ્રમાણભૂત રૂબ્રિક-આધારિત મૂલ્યાંકનમાં જોવા મળતી મોડલ-પસંદગીની પરિવર્તનશીલતા અને શબ્દબાહુલ્યની અસરો ટાળી શકાય છે.
દરેક સમસ્યા સાથે સમૃદ્ધ મેટાડેટા પણ આવે છે, જેમાં અભિપ્રેત વિશ્લેષણ માળખું, જોડેલી ડેટા ફાઇલો, વિગતવાર બહુ-પૃષ્ઠ કેસ સ્ટડી અને નિષ્ણાત સમીક્ષાના પરિણામોનો સમાવેશ થાય છે. અમે Hugging Face(નવી વિન્ડોમાં ખૂલે છે) પર 10 પ્રતિનિધિત્વાત્મક GeneBench-Pro પ્રશ્નોને સંપૂર્ણપણે ઓપન-સોર્સ કરી રહ્યાં છીએ, અને તેમને બ્રાઉઝ કરવા માટે ઇન્ટરેક્ટિવ વેબ ઇન્ટરફેસ પણ ઉપલબ્ધ કરાવી રહ્યા છીએ. અંતે, અમે નજીકના ભવિષ્યમાં સ્વતંત્ર, તૃતીય-પક્ષ બેન્ચમાર્કિંગ માટે Artificial Analysis(નવી વિન્ડોમાં ખૂલે છે) ને 50 પ્રશ્નોનો ઉપસેટ પ્રદાન કરીશું.
અમારું સૌથી સશક્ત મોડલ, GPT‑5.6 Sol, સર્વોચ્ચ રિઝનિંગ સ્તરે 28.7% નો પાસદર હાંસલ કરે છે (Pro મોડ સક્ષમ હોય ત્યારે 31.5%). અમે મૂળ GeneBench બનાવવાનું શરૂ કર્યું ત્યારેની સરખામણીએ આ તીવ્ર વધારો છે; તે સમયે, અમારું શ્રેષ્ઠ અત્યાધુનિક મોડલ, GPT‑5, 5%થી ઓછો સ્કોર કરતું હતું. આ બેન્ચમાર્ક પરની પ્રગતિ સૂચવે છે કે અત્યાધુનિક મોડલ્સ ઝડપથી સુધરી રહ્યા છે, ઓછા મૂર્ત, સિસ્ટમ્સ-સ્તરીય વૈજ્ઞાનિક રિઝનિંગમાં પણ. હાલની ગતિએ, આ બેન્ચમાર્ક વર્ષના અંત સુધીમાં સંતૃપ્ત થઈ શકે છે.
પરિણામો ટેસ્ટ-ટાઇમ કમ્પ્યુટને સ્કેલ કરવાના પ્રભાવને પણ દર્શાવે છે. સૌથી નીચા રિઝનિંગ સ્તરે, GPT‑5.6 Sol માત્ર એક અંકનો પાસરેટ પ્રાપ્ત કરે છે. સર્વોચ્ચ રિઝનિંગ સ્તરે, GPT‑5.6 Sol GPT‑5.2 કરતાં લગભગ છ ગણા જેટલા પ્રશ્નો ઉકેલે છે. લગભગ બે-તૃતીયાંશ જેટલા ટોકન વાપરતી વખતે આવું કરે છે.
મોડલ ફેમિલીઝ વચ્ચેની તુલનાઓ સૂચવે છે કે GPT મોડલ્સ પરિમાણાત્મક અનિશ્ચિતતા હેઠળ ઉચ્ચ-સ્તરીય વૈજ્ઞાનિક રિઝનિંગમાં સૌથી મજબૂત સિસ્ટમોમાં સામેલ છે. GPT‑5.6, GPT‑5.5 અને GLM 5.2 જેવા અગ્રણી ઓપન-સોર્સ મોડલ વચ્ચેનું પ્રદર્શનનું અંતર કોડિંગ બેન્ચમાર્ક્સ(નવી વિન્ડોમાં ખૂલે છે) ના આધારે અંદાજ લગાડ્યા કરતા ઘણું વધારે છે. આ દર્શાવે છે કે ઓપન-સોર્સ મોડલ વ્યાપક રિઝનિંગ ક્ષમતાની તુલનામાં કોડિંગ માટે વધુ વિશિષ્ટ છે.
વિકાસ દરમિયાન સમસ્યાઓનું મૂલ્યાંકન કરવા અને તેમને વધુ સુદૃઢ બનાવવા માટે અમે અત્યાધુનિક GPT મોડલનો ઉપયોગ કર્યો. આથી, અમને શંકા હતી કે GeneBench-Pro અન્ય મોડલ ફેમિલીઝની તુલનામાં GPT મોડલ્સ વિરુદ્ધ પક્ષપાતી હોઈ શકે છે. જોકે, સ્પર્ધક મોડલ્સ રિલીઝ સમયે અનુરૂપ GPT મોડલના પ્રદર્શનની સર્વોત્તમ બરાબરી કરતા હતા, અને સામાન્ય રીતે નોંધપાત્ર રીતે પાછળ રહી જતા હતા.
આ મૂલ્યાંકન પરિણામો—GPT‑5.6 Sol (Pro) પર 31.5% જેટલા ઊંચા—GeneBench-Pro પ્રશ્નોની કઠિનતાને ધ્યાનમાં લેતાં નોંધપાત્ર છે. એક સર્વેક્ષણમાં, અમારા સમીક્ષકોએ અંદાજ લગાવ્યો કે સામાન્ય GeneBench-Pro સમસ્યા પૂર્ણ કરવા માટે માનવ નિષ્ણાતને લગભગ 20–40 કલાક લાગશે. સાવચેતીભર્યા અંદાજે પ્રતિ કલાક $200 (₹15,000) મુજબ, એક જ સમસ્યાનો માનવીય શ્રમ ખર્ચ હજારો ડોલરમાં પહોંચી જાય છે. વર્તમાન AI એજન્ટો હજુ પણ માનવીય નિષ્ણાતોને બદલવા માટે ખૂબ અવિશ્વસનીય છે, પરંતુ ખર્ચમાં તફાવત મોટો છે, જેમાં ઇન્ફરન્સ ખર્ચ દર સમસ્યા દીઠ માત્ર થોડા ડોલર (₹કેટલાક સો રૂપિયા) છે. તેનો અર્થ એ થાય છે કે હાલની ક્ષમતાઓ પર આંશિક સ્વચાલન પણ નોંધપાત્ર આર્થિક અને વૈજ્ઞાનિક મૂલ્ય સર્જી શકે છે.
“માપદંડો વિવિધ પ્રકારના જૈવિક પ્રશ્નોથી પ્રેરિત છે, પરંતુ વાસ્તવિક પડકાર એ અન્વેષણાત્મક ડેટા વિશ્લેષણ અને આ શોધો પર રિઝનિંગ કરવાથી આવે છે: પેટર્ન અને આર્ટિફેક્ટ્સની ઓળખ કરવી, અને ડેટાને બાકાત રાખવો કે સમાયોજિત કરવો તે નક્કી કરવું. આ વાસ્તવિક જૈવિક ડેટાસેટ્સના અવ્યવસ્થિત સ્વરૂપને મળતું આવે છે. આ મૂલ્યાંકનોની સમીક્ષા કરવાથી એ સ્પષ્ટ થાય છે કે એજન્ટ-આધારિત વૈજ્ઞાનિક સમસ્યા ઉકેલવા માટે સ્પષ્ટ ઉકેલદાતા કરારો કેટલા મહત્વપૂર્ણ છે. પ્રોમ્પ્ટની અલગ શબ્દરચના અથવા કાર્યનું સ્પષ્ટીકરણ કયા વિશ્લેષણો અનુમતિપાત્ર જણાય છે તેના પર ભારે અસર કરી શકે છે.”
“મને [પ્રશ્નો] મોટાભાગે ગમ્યા. તેમામાં સામાન્ય રીતે આનું મિશ્રણ રહેતું હતું: (1) વિષયનું જરૂરી જ્ઞાન, જેમ કે પ્રાચીન DNA માં C>T બાયસ, (2) ડેટામાં વિસંગતતાઓ, જેમ કે એન્સેસ્ટ્રી સ્વેપ્સ, (3) કામ માટે યોગ્ય વિશ્લેષણાત્મક ટૂલ્સનું જ્ઞાન અને તેને કેવી રીતે અમલમાં મૂકવા તેની સમજ. એવું લાગ્યું કે મોટાભાગના એજન્ટો (2) પર નિષ્ફળ ગયા. તેઓ ડેટા સંબંધિત સમસ્યાઓ અંગે પૂરતી સાવચેતી રાખતા નથી. કદાચ તે વર્તમાન મોડલ્સની કોઈ નબળાઈને ઉજાગર કરે છે. અને મોટા પ્રમાણમાં જૈવિક ડેટામાં અનિયમિતતાઓ હોય છે.”
તેમ છતાં, અત્યાધુનિક મોડલ હજુ પણ આ સમસ્યાઓમાં ત્રીજું ભાગથી ઓછા ઉકેલ કરે છે, જે સુધારણા માટે ઘણો અવકાશ છે. મોડલ પડકારજનક સમસ્યાઓ પર આંશિક પ્રગતિ કરી શકે છે, પરંતુ તેઓ અનુમાનિત લૂપ પૂર્ણ કરવામાં સંઘર્ષ કરે છે. નિષ્ફળતાનો આ પેટર્ન માનવીય નિષ્ણાતો અને નવોદિતો વચ્ચેના તફાવતને પ્રતિબિંબિત કરે છે. નિષ્ણાતો પોતાના અનુભવનો ઉપયોગ કરીને સમસ્યાને માળખાબદ્ધ રીતે સમજે છે અને તેમનો અભિગમ અનુકૂળ બનાવે છે, જ્યારે નવશીખિયાઓ અવલોકનો કરે છે પરંતુ તેમને સમસ્યાના વ્યાપક સંદર્ભમાં સંકલિત કરવામાં મુશ્કેલી અનુભવે છે.
લગભગ સંપૂર્ણ પ્રદર્શન પ્રાપ્ત કરવા માટે એવા મૂલ્યાંકનોની જરૂર પડશે જે પ્રગતિને વિશ્વસનીય રીતે માપે અને તે પણ ઓળખી કાઢે કે મોડલ હજુ ક્યાં નિષ્ફળ જાય છે. GeneBench-Pro જેવા બેન્ચમાર્ક્સ ક્ષમતામાં રહેલી અસ્પષ્ટ ખામીને એવી બાબતમાં ફેરવવામાં મદદ કરી શકે છે, જેનું અમે નિદાન કરી શકીએ અને સુધારી શકીએ.
જો એજન્ટો આ પ્રકારના વિશ્લેષણને વિશ્વસનીય રીતે સ્વચાલિત કરી શકે, તો તેઓ વૈજ્ઞાનિક શોધને નોંધપાત્ર રીતે વેગ આપી શકે. માનવ જનેટિક પુરાવા પહેલેથી જ લક્ષ્ય પ્રાથમિકતા અને ટ્રાન્સલેશનલ ફોલો-અપ માટે કેન્દ્રસ્થ છે, કારણ કે આનુવંશિક સમર્થન ધરાવતી પદ્ધતિઓ મંજૂર સારવાર તરફ દોરી જવાની શક્યતા ઘણી વધારે હોય છે.
આ દરમિયાન, સિક્વેન્સિંગ ખર્ચમાં ભારે ઘટાડો થયો છે, અને બાયોબૅંક-સ્તરના ડેટાસેટ્સ હવે મોલેક્યુલર, ફીનોટાઇપિક અને હેલ્થ-રેકોર્ડ માહિતી અભૂતપૂર્વ વ્યાપકતામાં જોડે છે. મર્યાદિત પરિબળ હવે ડેટા જનરેશનથી બદલાઈને માહિતીને કાર્યક્ષમ આંતરદૃષ્ટિમાં પરિવર્તિત કરવા તરફ સ્થળાંતરિત થઈ રહ્યું છે. એવા મોડલ જે હાલમાં માનવ નિષ્ણાતોની ટીમો દ્વારા સંભાળવામાં આવતા વિશ્લેષણો સતત રીતે કરી શકે છે, તે પરિકલ્પનાઓની પ્રાથમિક છટણી, લક્ષ્યોનું અનુસરણ અને ડેટા જનરેશન અને નિર્ણય-લેવાની પ્રક્રિયા વચ્ચેના પુનરાવર્તન ચક્રને ઝડપી બનાવીને ઔદ્યોગિક સંશોધનમાં પરિવર્તન લાવી શકે છે.
GeneBench-Pro એ અનુભવી લોકો પાસે રહેલી સારી વૈજ્ઞાનિક સમજમાં સામેલ વધુ અમૂર્ત કુશળતાઓનું મૂલ્યાંકન કરવાનો પ્રારંભિક પ્રયાસ દર્શાવે છે. આ કુશળતાઓ તેમને સૌથી આશાસ્પદ પ્રારંભિક વિશ્લેષણોને વિશે અંતર્જ્ઞાન મેળવવામાં અને તેને ઓળખવામાં, જ્યારે ડેટા પ્રારંભિક ધારણાઓથી વિરુદ્ધ હોય ત્યારે તેમના વિચારોમાં સુધારો કરવામાં, અને એવા નિષ્કર્ષ પર પહોંચવામાં મદદ કરે છે જેના પર ડાઉનસ્ટ્રીમ ક્લિનિકલ, શૈક્ષણિક અથવા વ્યવસાયિક નિર્ણયો નિર્ભર હોઈ શકે છે.
અમે અપેક્ષા રાખીએ છીએ કે જેમ જેમ મોડલની ક્ષમતાઓ આગળ વધશે, તેમ તેમ અમૂર્તતાના આ ઊંચા સ્તરો પર મોડલની ક્ષમતાઓને ચકાસતા બેન્ચમાર્ક્સ વધુ ઉપયોગી બનશે, ખાસ કરીને એવા બેન્ચમાર્ક્સ કરતાં આગળ જઈને, જે માત્ર પુસ્તકી જ્ઞાન અથવા રૂટિન વિશ્લેષણો કરવાની ક્ષમતાની ચકાસણી કરે છે.


