OpenAI સાથે એમ્પ્લિટ્યુડમાં 1–2 દિવસમાં ઉત્પાદન સુધારા
મુખ્યત્વે OpenAI મોડલ પર આધારિત એમ્પ્લિટ્યુડનો પહેલ કરતો ઉત્પાદન એજન્ટ વેવ શું બનાવવું તે ઓળખે છે, કોડિંગ એજન્ટોની મદદથી ફેરફારો અમલમાં મૂકવામાં ટીમોને સહાય કરે છે અને તેની અસર માપે છે.
160%
એક દિવસ પછી નિયંત્રણ જૂથની સરખામણીમાં એજન્ટ સાથેની ક્રિયાપ્રતિક્રિયામાં વધારો
1–2 દિવસ
વેવ સાથે ઉત્પાદનમાં સુધારો અમલમાં મૂકવાનો અંદાજિત સમય
51%
એમ્પ્લિટ્યુડના ડેટા વિજ્ઞાન એજન્ટના મૂલ્યાંકનમાં GPT‑6.1 Sol માટે કાર્ય સોંપણી દીઠ મોડલના સરેરાશ ખર્ચમાં ઘટાડો.
$1.34
એમ્પ્લિટ્યુડના તક તપાસકર્તાના મૂલ્યાંકનમાં GPT‑6.1 Sol માટે મોડલનો ખર્ચ.
લોકો ખરેખર પોતાનાં ઉત્પાદનોનો ઉપયોગ કેવી રીતે કરે છે તે સમજવામાં એમ્પ્લિટ્યુડ હંમેશાં ટીમોને મદદ કરતું આવ્યું છે. તેનો પહેલ કરીને કામ કરતો ઉત્પાદન એજન્ટ વેવ, આ સમજના આધારે સુધારા અમલમાં મૂકવામાં ટીમોને મદદ કરે છે. એમ્પ્લિટ્યુડના જણાવ્યા પ્રમાણે, વેવ લગભગ 80% જેટલું OpenAIનાં મોડલથી સંચાલિત છે, જેમાં GPT‑6.1 Sol, GPT‑6 Luna અને GPT‑Image‑2.5 Flareનો સમાવેશ થાય છે. વેવ ઉત્પાદન વિશે મળેલી સૂઝ પરથી અમલીકરણની યોજનાઓ બનાવે છે, જેને ટીમો Codex સહિતના કોડિંગ એજન્ટોને મોકલી શકે છે, અને પછી તેની અસર માપે છે.
એમ્પ્લિટ્યુડનો અંદાજ છે કે વેવની મદદથી ટીમો ઉત્પાદનમાં સુધારા લગભગ એક મહિનાને બદલે 1–2 દિવસમાં અમલમાં મૂકી શકે છે. એમ્પ્લિટ્યુડના પોતાના મુખ્ય પૃષ્ઠ પર વેવે સૂચન કાર્ડને વ્યક્તિગત બનાવવામાં મદદ કરી, જેનાથી કાર્ડ દ્વારા મોકલાતા સંદેશાઓમાં 160%નો વધારો થયો.
“હવે AI એવું ઉપયોગી કામ શોધી શકે છે જે તેને સોંપવાનું અમે ક્યારેય વિચાર્યું પણ ન હોય. OpenAIનાં મોડલ સમસ્યાની તપાસ કરી શકે છે, કોડ લખી અને ચલાવી શકે છે અને પરિણામોના આધારે આગળ શું અજમાવવું તે નક્કી કરી શકે છે.”
વેવ એ એમ્પ્લિટ્યુડનો પહેલ કરીને કામ કરતો ઉત્પાદન એજન્ટ છે. ટીમો તેને ઉત્પાદનનું કોઈ ક્ષેત્ર સોંપે છે અને કયાં લક્ષ્યો તથા માપદંડોમાં સુધારો કરવો છે તે જણાવે છે. વેવ એમ્પ્લિટ્યુડના ડેટા, સત્રોના પુનઃપ્રસારણ, ગ્રાહકોના પ્રતિસાદ અને કોડને એકસાથે લાવીને સુધારાની તકો ઓળખે છે અને તેમની અગ્રતા નક્કી કરે છે, ઉકેલો વિકસાવે છે અને લોકો તથા કોડિંગ એજન્ટો સાથે અમલીકરણનું સંકલન કરે છે. ત્યારબાદ તે પરિણામો પર નજર રાખે છે અને તેમાંથી મળેલી શીખને આધારે આગળના સુધારાની દિશા નક્કી કરે છે.
આ કાર્યપ્રવાહમાં એમ્પ્લિટ્યુડ જુદાં જુદાં કાર્યો માટે OpenAIનાં અલગ અલગ મોડલનો ઉપયોગ કરે છે. GPT‑6.1 Sol તક વ્યવસ્થાપકને અને કોડ તથા ડેટાની ઊંડાણપૂર્વક તપાસને સહાય પૂરી પાડે છે. GPT‑6 Luna કોડ તપાસવા અને નાની મૂલ્યાંકન તપાસો કરવા જેવાં વારંવારનાં, ઓછા ખર્ચવાળાં કાર્યો સંભાળે છે. GPT‑Image‑2.5 Flare સત્રોના પુનઃપ્રસારણમાંથી લીધેલાં સ્ક્રીનશૉટને દૃશ્ય સંદર્ભ તરીકે વાપરીને ઉત્પાદનનાં નમૂનારૂપ દૃશ્યો બનાવે છે.
જ્યારે કોઈ તક અમલીકરણ માટે તૈયાર હોય, ત્યારે ટીમો તેને વેવમાંથી સીધી Codex સહિતના કોડિંગ એજન્ટોને મોકલી શકે છે. સાથે તકનીકી યોજના અને સ્વીકૃતિના માપદંડો હોય છે, જે અમલીકરણને દિશા આપે છે.
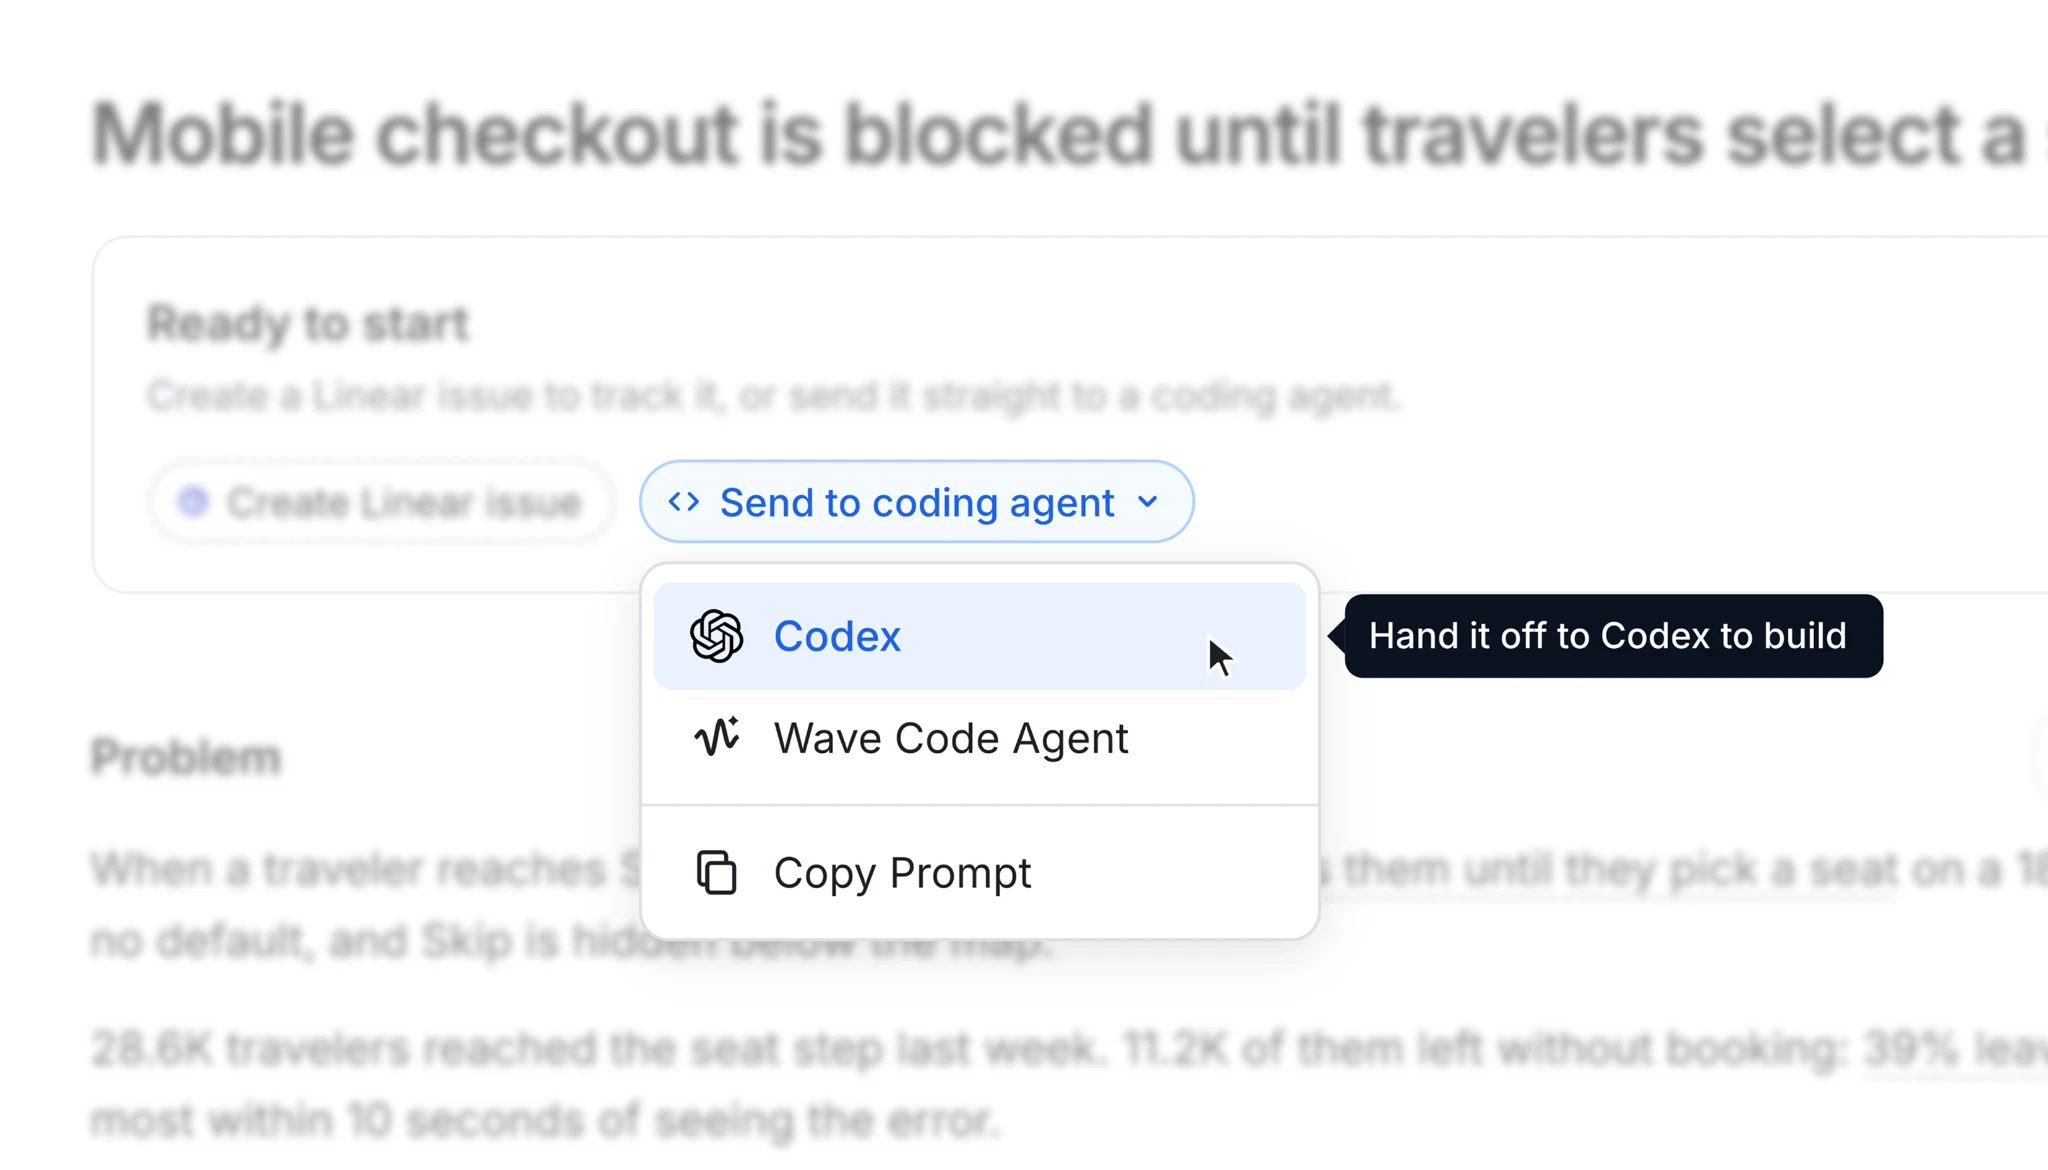
એમ્પ્લિટ્યુડના મુખ્ય AI ઉત્પાદન વ્યવસ્થાપક જેકબ ન્યૂમેન સમજાવે છે, “વેવ પાછળનો વિચાર એ છે કે તમને એક સંકલિત મંચ મળે, જેના એજન્ટો વિશાળ પ્રમાણમાં સત્રોના પુનઃપ્રસારણ, વિશ્લેષણ અને કોડની ઝીણવટથી તપાસ કરીને ઉત્પાદનો સુધારવાની તકો શોધે.”
એમ્પ્લિટ્યુડે પોતાના મુખ્ય પૃષ્ઠ પર વેવનું પરીક્ષણ કર્યું. ત્યાં સામાન્ય સૂચન કાર્ડનો હેતુ વપરાશકર્તાઓને AI એજન્ટ સાથે વાતચીત શરૂ કરવામાં મદદ કરવાનો હતો. વેવને જાણવા મળ્યું કે લોકો ઘણી વાર તેમને અવગણતા હતા: સત્રોનાં 100 પુનઃપ્રસારણના નમૂનામાં 80 વપરાશકર્તાઓએ પોતાના પ્રશ્નો ટાઇપ કર્યા અને માત્ર 12 જણે સૂચન પસંદ કર્યું.
વેવે તાજેતરના આલેખો, ડૅશબોર્ડ અથવા વપરાશકર્તા જે પૃષ્ઠ પરથી આવ્યો હોય તેના આધારે કાર્ડને વ્યક્તિગત બનાવવાનું સૂચવ્યું. તેણે ફેરફારનું દૃશ્ય ઉદાહરણ આપ્યું અને તકનીકી યોજના બનાવી. તેમાં મનગમતું ટાઇપ કરવાની સુવિધા જાળવવી અને વ્યક્તિગત સૂચનો માટે જરૂરી સંદર્ભ ન હોય ત્યારે સામાન્ય સૂચનો દર્શાવવાનો સમાવેશ થતો હતો. ટૂંકી સમીક્ષા પછી ટીમે કામ કોડિંગ એજન્ટને સોંપ્યું અને ફેરફારનું A/B પરીક્ષણ કર્યું.
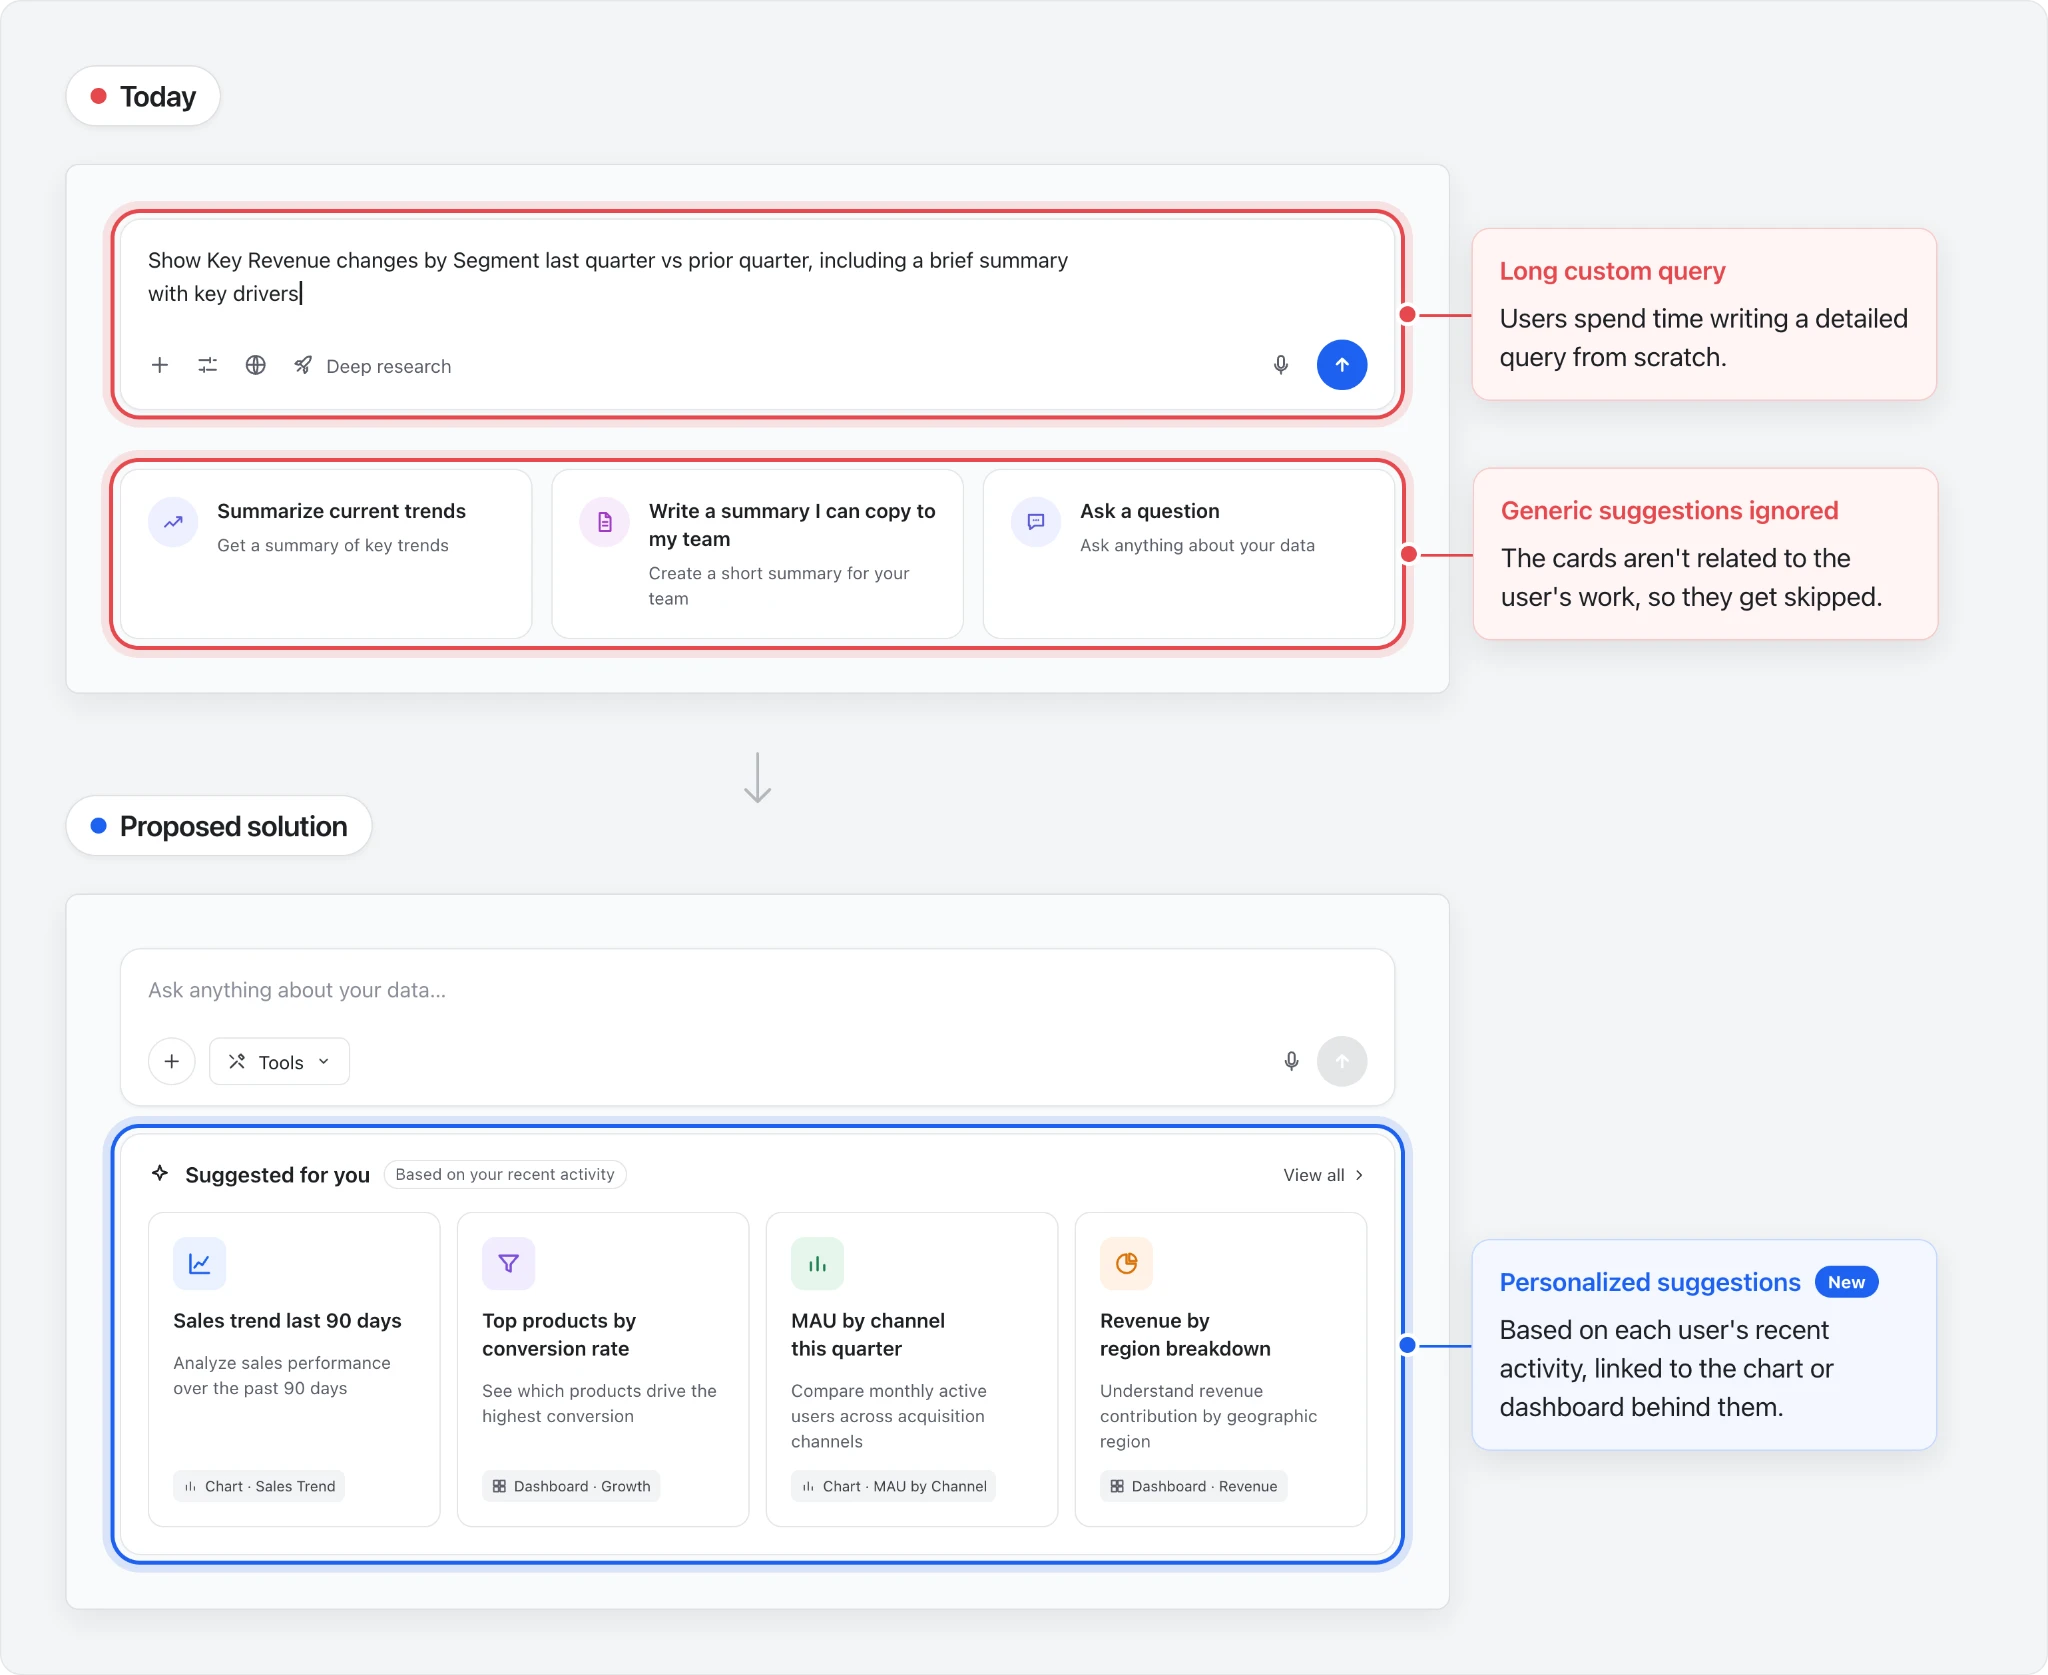
એમ્પ્લિટ્યુડે જાહેર કરેલાં પ્રયોગનાં પરિણામો અનુસાર, એક દિવસ પછી નિયંત્રણ જૂથની સરખામણીમાં મુખ્ય પૃષ્ઠનાં સૂચન કાર્ડ દ્વારા મોકલાયેલા સંદેશાઓમાં 160%નો વધારો થયો. એમ્પ્લિટ્યુડના વરિષ્ઠ મુખ્ય AI ઇજનેર એરિક કાર્લસન સમજાવે છે, “આ એક ઉત્તમ ઉદાહરણ છે કે કેવી રીતે ક્રાંતિકારી ન લાગતી અને તેથી અવગણાતી બાબતો પણ સુવિધાઓનો ઉપયોગ અણધારી રીતે વધારી શકે છે.”
વેવનાં જુદાં જુદાં કાર્યો માટે તેનાં મોડલ પાસેથી જુદી જુદી ક્ષમતાઓ જરૂરી બને છે. ઊંડાણપૂર્વકની તપાસ માટે મજબૂત রিজনিং અને નક્કર આધાર ધરાવતા નિષ્કર્ષો જરૂરી છે. સેંકડો વાર કરવાની નાની તપાસ ઝડપી અને ઓછા ખર્ચવાળી હોવી જોઈએ. એમ્પ્લિટ્યુડ દરેક કાર્ય માટે ગુણવત્તા, પ્રતિસાદ સમય અને ખર્ચનું મૂલ્યાંકન કરે છે અને પછી તે મુજબ મોડલને કામ સોંપે છે.
“OpenAIએ અમને મજબૂત রিজনিং ધરાવતાં મોડલ અને નાનાં, ઝડપી મોડલ બંને આપ્યાં, જેથી અમે સમગ્ર ઉત્પાદનમાં ગુણવત્તા, પ્રતિસાદ સમય અને અનુમાન ગણનાના ખર્ચ વચ્ચે સંતુલન રાખી શક્યા.”
વેવના તક તપાસકર્તા માટે એમ્પ્લિટ્યુડે મૂલ્યાંકન કર્યું કે મોડલ તારણોની પુષ્ટિ કરે છે કે નહીં, ખોટાં સકારાત્મક પરિણામો ટાળે છે કે નહીં, મૂલ્યાંકનકર્તાનો પ્રતિસાદ સામેલ કરે છે કે નહીં, સાધનો નિષ્ફળ જાય ત્યારે કામ ફરી શરૂ કરી શકે છે કે નહીં અને દાવાને પુરાવા સાથે સુસંગત રાખે છે કે નહીં. GPT‑6.1 Solને એકંદરે 5માંથી 4.06 ગુણ મળ્યા, જ્યારે ત્રણ વૈકલ્પિક મોડલને 3.62, 3.52 અને 2.94 ગુણ મળ્યા. તે તપાસના પાંચેય માપદંડોમાં આગળ રહ્યું અને તેનો તપાસનો મધ્યક સમય સૌથી ઓછો, 54 મિનિટ હતો.
વેવના ડેટા વિજ્ઞાન એજન્ટના અલગ મૂલ્યાંકનમાં GPT‑6.1 Solને 100માંથી 67.5 ગુણ મળ્યા, જ્યારે અન્ય એક અગ્રણી મોડલને 69.3 ગુણ મળ્યા. કાર્ય સોંપણી દીઠ મોડલનો સરેરાશ ખર્ચ અનુક્રમે $1.28 અને $2.63 હતો. GPT‑6.1 Solને સાધન વપરાશની નિર્ધારિત શરતોના પાલન, અંદાજ અને અનિશ્ચિતતા તથા પુરાવા આધારિત ગ્રાઉન્ડિંગમાં પણ વધુ ગુણ મળ્યા.
કોડ તપાસવા અને નાની મૂલ્યાંકન તપાસો કરવા જેવાં મોટા પ્રમાણમાં થતાં કામો માટે એમ્પ્લિટ્યુડ GPT‑6 Luna વાપરે છે, જેથી પ્રતિસાદ સમય અને ખર્ચ ઓછા રહે. નિષ્ણાત એજન્ટો વચ્ચે કામ વહેંચવાથી ટીમ વધુ ખર્ચાળ রিজনিংનો ઉપયોગ માત્ર જે કાર્યોમાં તેની સૌથી વધુ જરૂર હોય ત્યાં કરી શકે છે.
રૂપરેખાઓ અને નમૂનારૂપ દૃશ્યો બનાવવા માટેના મૂલ્યાંકનમાં, ઉકેલની રૂપરેખાઓ માટે OpenAIના ઇમેજ જનરેશન મોડલને 100માંથી 80.3 ગુણ મળ્યા, જ્યારે અન્ય ઇમેજ જનરેશન મોડલને 63.9 ગુણ મળ્યા. એમ્પ્લિટ્યુડના મૂલ્યાંકનમાં 15 તકો માટે સંદેશાવ્યવહારની ગુણવત્તા, મૂળ ઉત્પાદન સાથેની સુસંગતતા, સૂચનાઓનું પાલન, લખાણ અને વપરાશકર્તા ઇન્ટરફેસની સુવાચ્યતા તથા દૃશ્ય સુસંગતતાને આવરી લેવાયાં હતાં.
વિવિધ ઉદ્યોગોના ગ્રાહકો ઉત્પાદનમાં સુધારા ઓળખવા અને અમલમાં મૂકવા માટે પહેલેથી જ વેવના બીટા સંસ્કરણનો ઉપયોગ કરી રહ્યા છે. વેવ સત્રો અને વિશ્લેષણના ડેટાનું વિશ્લેષણ કરે છે, પછી પ્રસ્તાવિત ઉકેલ, તકનીકી યોજના અને સ્વીકૃતિના માપદંડો સાથે ભલામણો તૈયાર કરે છે.
તે પછી કેટલું કામ સ્વચાલિત કરવું તે ટીમો નક્કી કરી શકે છે. મોટાભાગની ટીમો ભૂલો સુધારવાનું કામ સીધું કોડિંગ એજન્ટોને મોકલે છે, જ્યારે નવી સુવિધાઓ અને વધુ જોખમ ધરાવતાં મોટાં પગલાંની માનવીય સમીક્ષા થાય છે.
જે ફેરફારો ખરેખર અમલમાં મુકાય છે, તેમાં શોધથી અમલ સુધીનો સમય ટૂંકો હોઈ શકે છે: ગ્રાહકોએ શરૂ કરેલાં પ્રયોગો, ફ્લૅગ અને માર્ગદર્શિકાઓમાંથી ચારમાંથી એક વેવે તક ઓળખી એ જ દિવસે અમલમાં આવ્યું, અડધાં ચાર દિવસથી ઓછા સમયમાં અને ત્રણમાંથી બે એક અઠવાડિયામાં અમલમાં આવ્યાં.
આપેલા મુખ્ય તબક્કાઓ વચ્ચેના મૂલ્યોનો અંદાજ લગાવ્યો છે; વક્રરેખા દૃષ્ટાંતરૂપ છે, વ્યક્તિગત અવલોકનો નથી.
સ્કેટ્સ કહે છે, “OpenAI સાથે અમારી મહત્ત્વાકાંક્ષા એ છે કે કંપનીઓ સૉફ્ટવેર બનાવે ત્યારે જાતે સુધરતાં ઉત્પાદનો બનાવવાનું જ ધોરણ બને.” OpenAIનાં મોડલ જેમ જેમ রিজনিং અને કોડિંગમાં વધુ સક્ષમ બનશે, તેમ ટીમો તપાસ અને અમલીકરણનું વધુ કામ એજન્ટોને સોંપી શકશે. પરિણામે વધુ સારાં ઉત્પાદનો વપરાશકર્તાઓ સુધી વધુ ઝડપથી પહોંચશે. એમ્પ્લિટ્યુડને આનો અનુભવ પહેલેથી જ થઈ રહ્યો છે: ટીમ અન્ય પ્રાથમિકતાઓ પર કામ કરતી હોય ત્યારે એજન્ટો તેના પોતાના ઉત્પાદનમાં સુધારા શોધે છે અને અમલમાં મૂકવામાં મદદ કરે છે. “મને લાગે છે કે જ્યારે સૉફ્ટવેર ઉત્પાદનને વધુ સારું બનાવવા ટીમોની સાથે કામ કરવા લાગશે, ત્યારે તેઓ કેટલું બધું કરી શકે છે તે જોઈને તેમને નવાઈ લાગશે.”