Amplitude améliore ses produits en 1–2 jours avec OpenAI
Reposant surtout sur les modèles d’OpenAI, Wave, l’agent produit proactif d’Amplitude, identifie ce qu’il faut développer, aide les équipes à déployer les changements avec des agents de programmation et mesure leur impact.
160 %
Hausse de l’engagement avec l’agent par rapport au groupe témoin après un jour
1–2 jours
Délai estimé pour déployer une amélioration produit avec Wave
51 %
Réduction du coût moyen du modèle par exécution pour GPT‑6.1 Sol dans l’évaluation de l’agent de science des données d’Amplitude.
1,34 $
Coût du modèle GPT‑6.1 Sol dans l’évaluation de l’agent d’analyse des opportunités d’Amplitude.
Amplitude aide depuis toujours les équipes à comprendre comment les utilisateurs se servent réellement de leurs produits. Son agent produit proactif, Wave, aide les équipes à transformer ces enseignements en améliorations déployées. Selon Amplitude, Wave repose à environ 80 % sur les modèles d’OpenAI, notamment GPT‑6.1 Sol, GPT‑6 Luna et GPT‑Image‑2.5 Flare. Wave transforme les enseignements sur le produit en plans de mise en œuvre que les équipes peuvent transmettre à des agents de programmation, dont Codex, puis en mesure l’impact.
Amplitude estime que Wave peut aider les équipes à déployer des améliorations produit en 1 à 2 jours, contre environ un mois auparavant. Sur la propre page d’accueil d’Amplitude, Wave a contribué à personnaliser les cartes de suggestions, entraînant une hausse de 160 % des envois depuis ces cartes.
« L’IA peut désormais trouver des tâches utiles que nous n’avions jamais pensé à lui confier. Les modèles d’OpenAI peuvent étudier un problème, écrire et exécuter du code, puis utiliser les résultats pour décider de la prochaine approche à essayer. »
Wave est l’agent produit proactif d’Amplitude. Les équipes lui indiquent un domaine du produit ainsi que les objectifs et les indicateurs qu’elles souhaitent améliorer. Wave rassemble les données d’Amplitude, les enregistrements de sessions, les retours clients et le code pour identifier et hiérarchiser les opportunités, élaborer des solutions et coordonner leur mise en œuvre avec les équipes et les agents de programmation. Il suit ensuite les résultats et utilise ces enseignements pour orienter la prochaine série d’améliorations.
Pour ce processus, Amplitude utilise différents modèles d’OpenAI selon les tâches. GPT‑6.1 Sol prend en charge le gestionnaire d’opportunités et les analyses approfondies du code et des données. GPT‑6 Luna gère les tâches fréquentes et moins coûteuses, comme l’examen du code et l’exécution de vérifications d’évaluation simples. GPT‑Image‑2.5 Flare génère des maquettes produit en utilisant comme références visuelles des captures d’écran issues des enregistrements de sessions.
Lorsqu’une opportunité est prête à être concrétisée, les équipes peuvent l’envoyer directement depuis Wave à des agents de programmation, dont Codex, avec un plan technique et des critères d’acceptation pour guider la mise en œuvre.
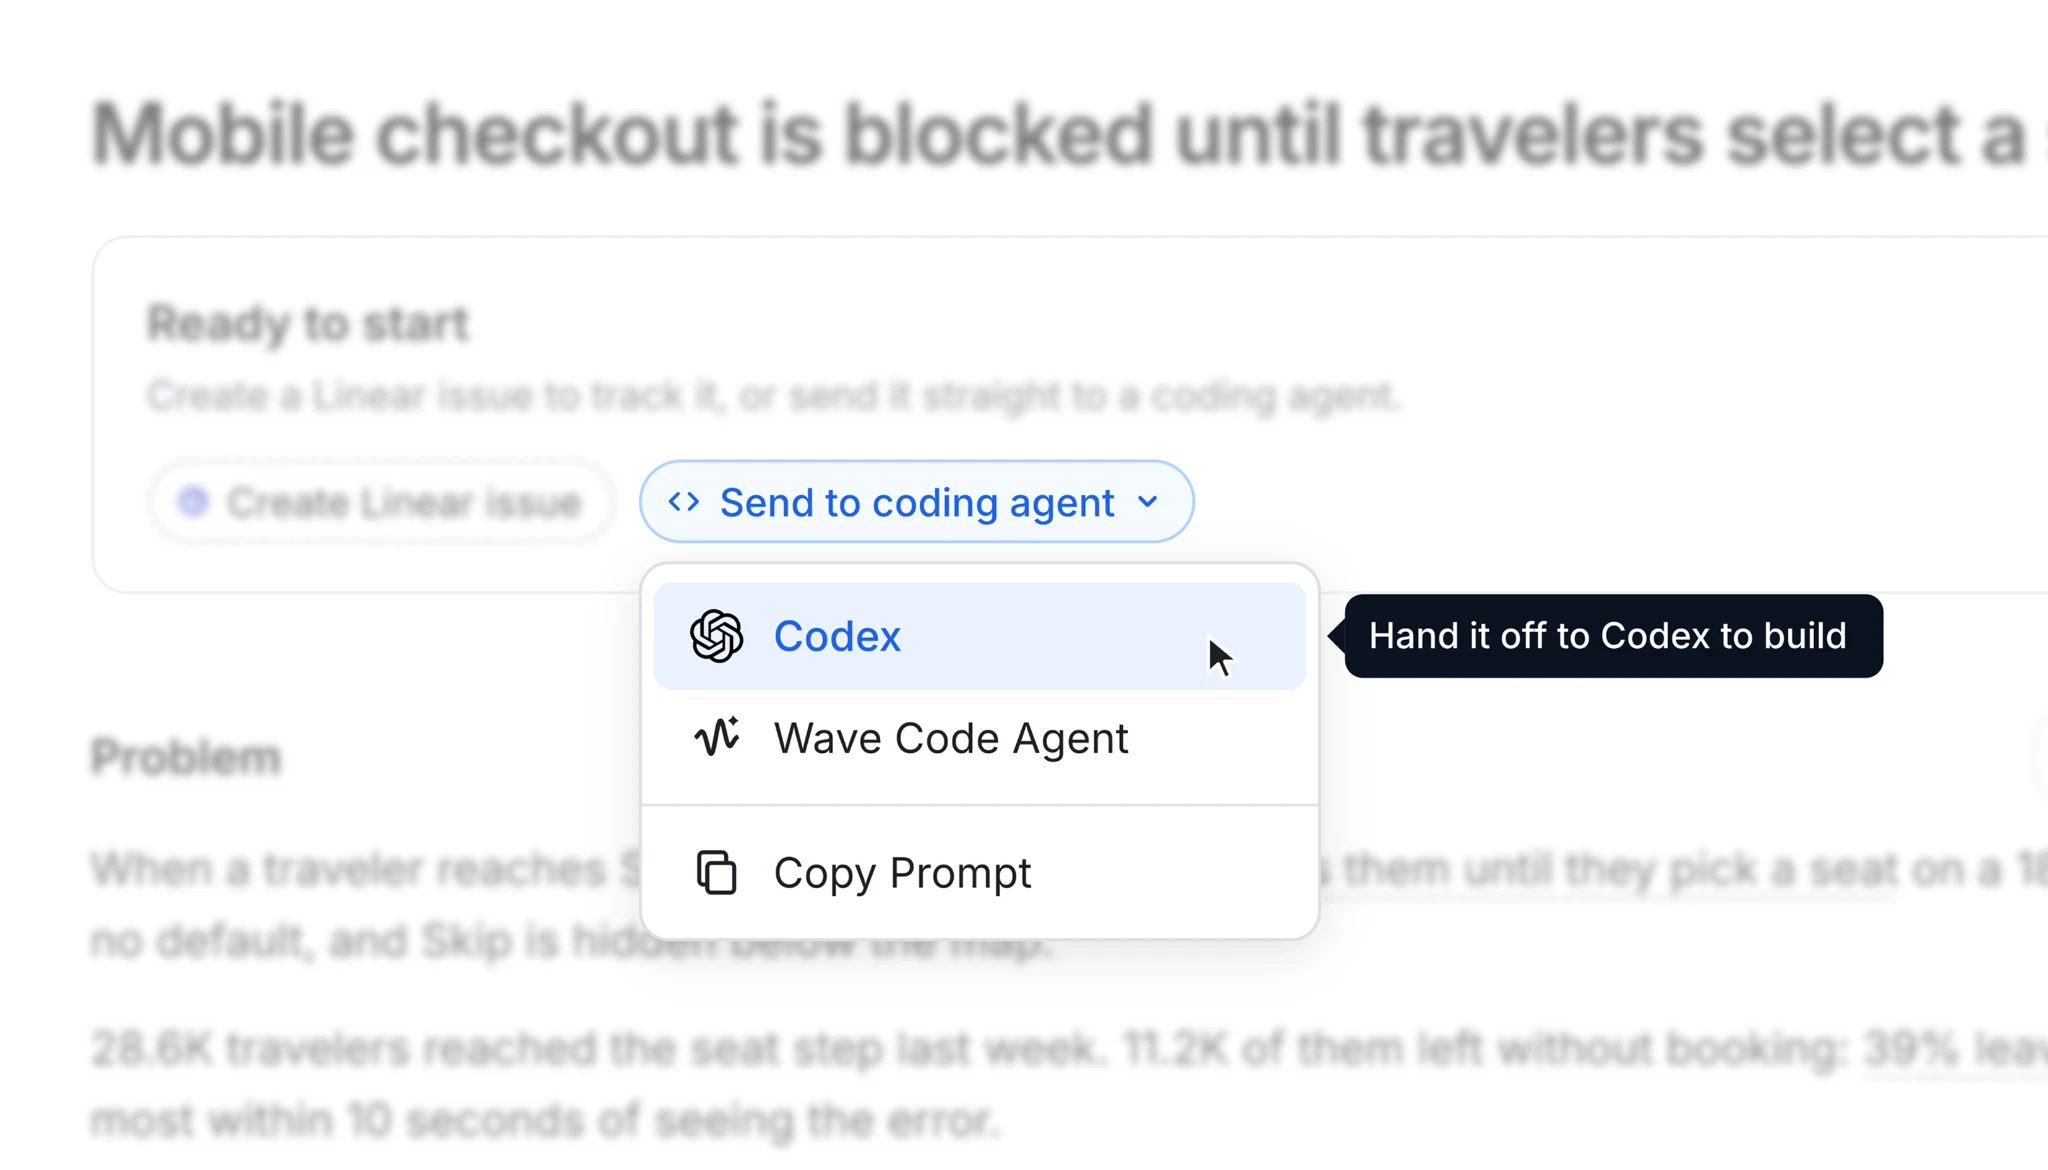
« L’idée de Wave, c’est de disposer d’une plateforme unifiée avec des agents qui passent au crible d’immenses quantités d’enregistrements de sessions, de données analytiques et de code pour trouver des opportunités d’améliorer les produits », explique Jacob Newman, responsable produit IA principal chez Amplitude.
Amplitude a testé Wave sur sa propre page d’accueil, où des cartes de suggestions génériques étaient censées aider les utilisateurs à démarrer une conversation avec un agent d’IA. Wave a découvert que les utilisateurs les ignoraient souvent : sur un échantillon de 100 enregistrements de sessions, 80 utilisateurs avaient saisi leurs propres questions et seuls 12 avaient sélectionné une suggestion.
Wave a proposé de personnaliser les cartes à partir de graphiques ou de tableaux de bord récents, ou de la page d’où venait l’utilisateur. Il a illustré la modification et produit un plan technique, prévoyant notamment de conserver la saisie libre et d’afficher des suggestions génériques en l’absence de contexte de personnalisation. Après un bref examen, l’équipe a confié le travail à un agent de programmation et soumis la modification à un test A/B.
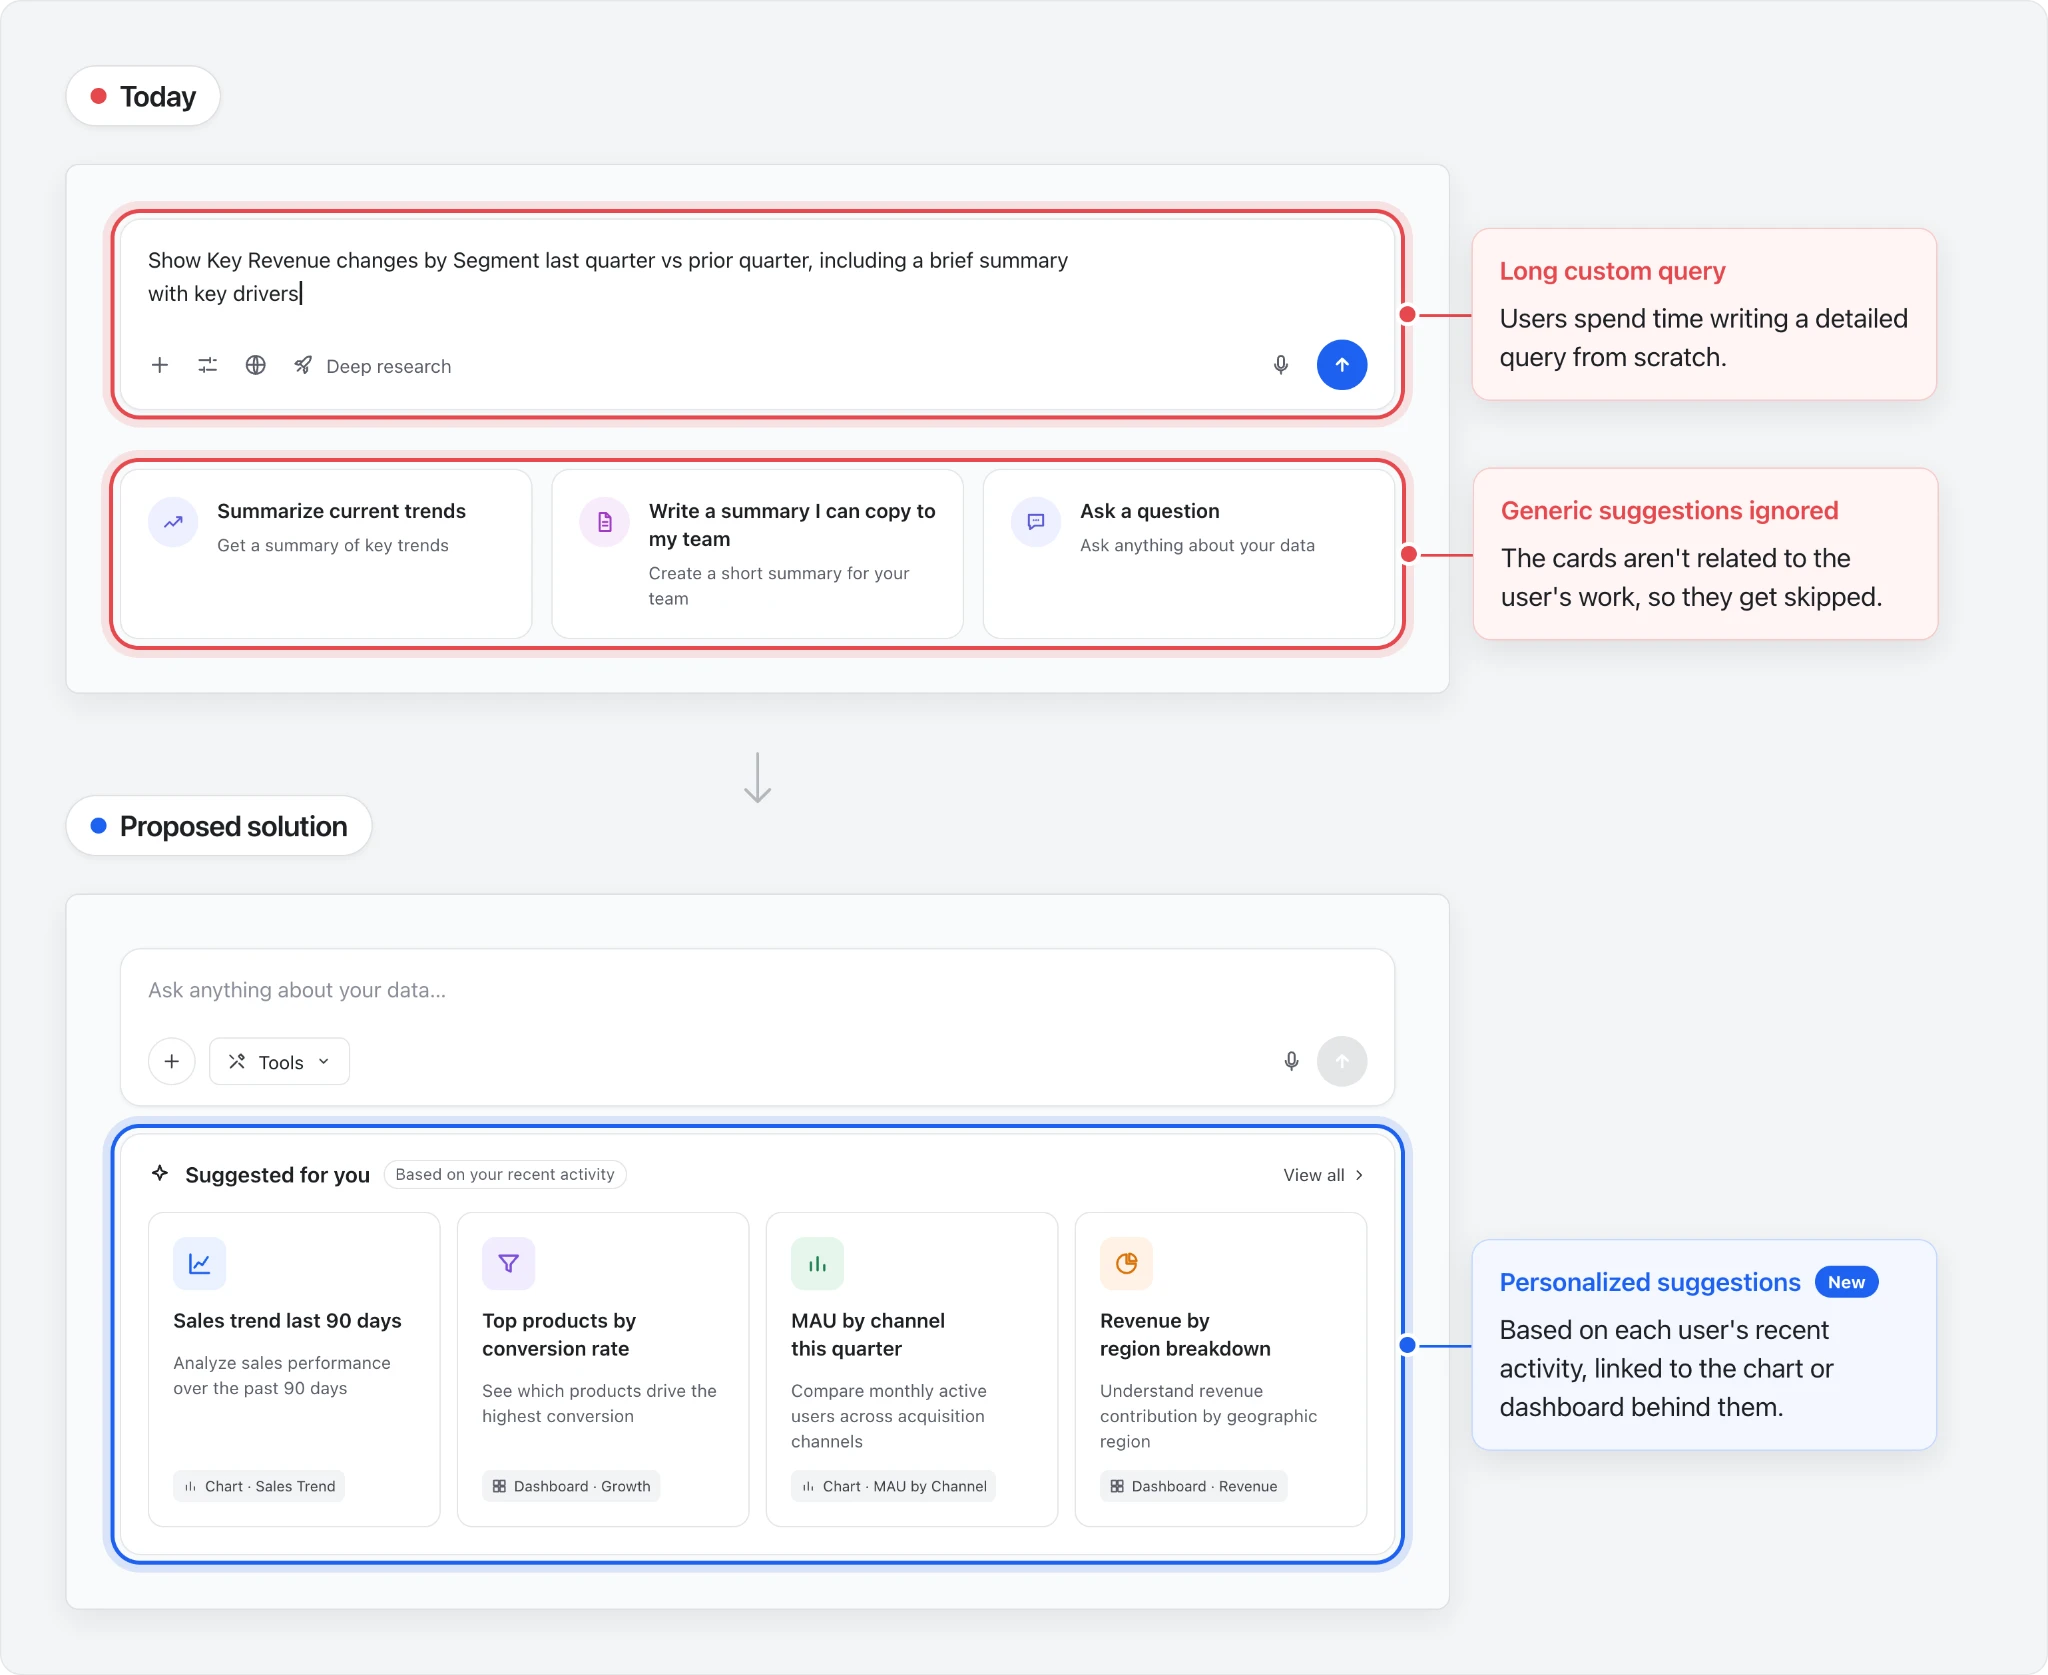
D’après le bilan de l’expérimentation partagé par Amplitude, le nombre de messages envoyés depuis les cartes de suggestions de la page d’accueil a augmenté de 160 % par rapport au groupe témoin après un jour. « C’est un excellent exemple de la façon dont des éléments qui n’ont rien de révolutionnaire et que l’on néglige peuvent accroître l’adoption des fonctionnalités de manière inattendue », explique Eric Carlson, ingénieur principal senior en IA chez Amplitude.
Les tâches de Wave imposent des exigences différentes à ses modèles. Une analyse approfondie exige un raisonnement solide et des conclusions bien étayées. Une vérification simple répétée des centaines de fois doit être rapide et peu coûteuse. Amplitude évalue la qualité, la latence et le coût pour chaque tâche, puis attribue les modèles en conséquence.
« OpenAI nous a fourni à la fois de puissants modèles de raisonnement et des modèles plus petits et plus rapides, ce qui nous a permis d’équilibrer qualité, latence et coût d’inférence dans l’ensemble du produit »
Pour l’agent d’analyse des opportunités de Wave, Amplitude a évalué si les modèles corroboraient leurs conclusions, évitaient les faux positifs, intégraient les retours de l’évaluateur, surmontaient les défaillances des outils et veillaient à la concordance entre affirmations et preuves. GPT‑6.1 Sol a obtenu une note globale de 4,06 sur 5, contre 3,62, 3,52 et 2,94 pour trois modèles alternatifs. Il est arrivé en tête sur les cinq critères d’analyse et a affiché la durée médiane d’analyse la plus courte, à 54 minutes.
Lors d’une évaluation distincte de l’agent de science des données de Wave, GPT‑6.1 Sol a obtenu 67,5 sur 100, contre 69,3 pour un autre modèle de premier plan, avec un coût moyen du modèle de 1,28 $ contre 2,63 $ par exécution. GPT‑6.1 Sol a aussi obtenu de meilleures notes pour le respect des contrats d’interface des outils, l’estimation et l’incertitude, ainsi que l’ancrage dans les preuves.
Pour les tâches à grand volume, comme l’examen du code et l’exécution de vérifications d’évaluation simples, Amplitude utilise GPT‑6 Luna afin de limiter la latence et le coût. Répartir le travail entre des agents spécialisés permet à l’équipe de réserver le raisonnement plus coûteux aux tâches qui en ont le plus besoin.
Pour la génération de maquettes filaires et visuelles, le modèle de génération d’images d’OpenAI a obtenu 80,3 sur 100 pour les maquettes filaires de solutions, contre 63,9 pour un autre modèle de génération d’images. L’évaluation d’Amplitude portait sur la qualité de la communication, la fidélité au produit, le respect des instructions, la lisibilité du texte et de l’interface, ainsi que la cohérence visuelle, sur 15 opportunités.
Des clients de divers secteurs utilisent déjà Wave en version bêta pour identifier et déployer des améliorations produit. Wave analyse les données de session et les données analytiques, puis formule des recommandations accompagnées d’une proposition de correctif, d’un plan technique et de critères d’acceptation.
Les équipes peuvent ensuite contrôler le niveau d’automatisation. La plupart des équipes confient directement les corrections de bugs aux agents de programmation, tandis que les nouvelles fonctionnalités et les initiatives plus ambitieuses font l’objet d’un examen humain.
Pour les changements effectivement déployés, le passage de la découverte à l’exécution peut être rapide : parmi les expérimentations, indicateurs de fonctionnalité et guides lancés par les clients, un sur quatre a été mis en ligne le jour même où Wave a identifié l’opportunité, la moitié en moins de quatre jours et deux sur trois en une semaine.
Interpolation à partir des jalons fournis ; la courbe est illustrative et ne représente pas des observations individuelles.
« Avec OpenAI, nous voulons que la création de produits capables de s’améliorer d’eux-mêmes devienne la norme dans le développement logiciel en entreprise », explique Spenser Skates. À mesure que les modèles d’OpenAI progressent en raisonnement et en programmation, les équipes pourront confier davantage de tâches d’analyse et de mise en œuvre aux agents. Elles pourront ainsi proposer plus rapidement de meilleurs produits aux utilisateurs. Amplitude en voit déjà les effets : les agents repèrent des améliorations à apporter à son propre produit et contribuent à leur mise en œuvre, tandis que l’équipe se concentre sur d’autres priorités. « Je pense que les équipes seront surprises de tout ce qu’elles peuvent accomplir lorsque leur logiciel travaille avec elles à l’amélioration du produit. »