Qué significa ser ingeniero de implementación para clientes en OpenAI
Qué hacemos, cómo trabajamos y cómo resolvemos los problemas más difíciles de las empresas para lograr un impacto real.
Por: Colin Jarvis, responsable de ingeniería de implementación para clientes en OpenAI
Cuando salió Codex, alguien del equipo me preguntó: «¿Qué hacemos cuando Codex pueda resolver de una sola vez los casos de uso que hemos pasado los últimos meses desarrollando?»
Esa pregunta va al núcleo de lo que significa ser ingeniero de implementación para clientes en OpenAI. Trabajamos junto a los clientes para comprender sus problemas más difíciles y crear soluciones en las que puedan confiar. Lo que aprendemos contribuye a dar forma a nuestros productos y proporciona al equipo de investigación problemas concretos que resolver.
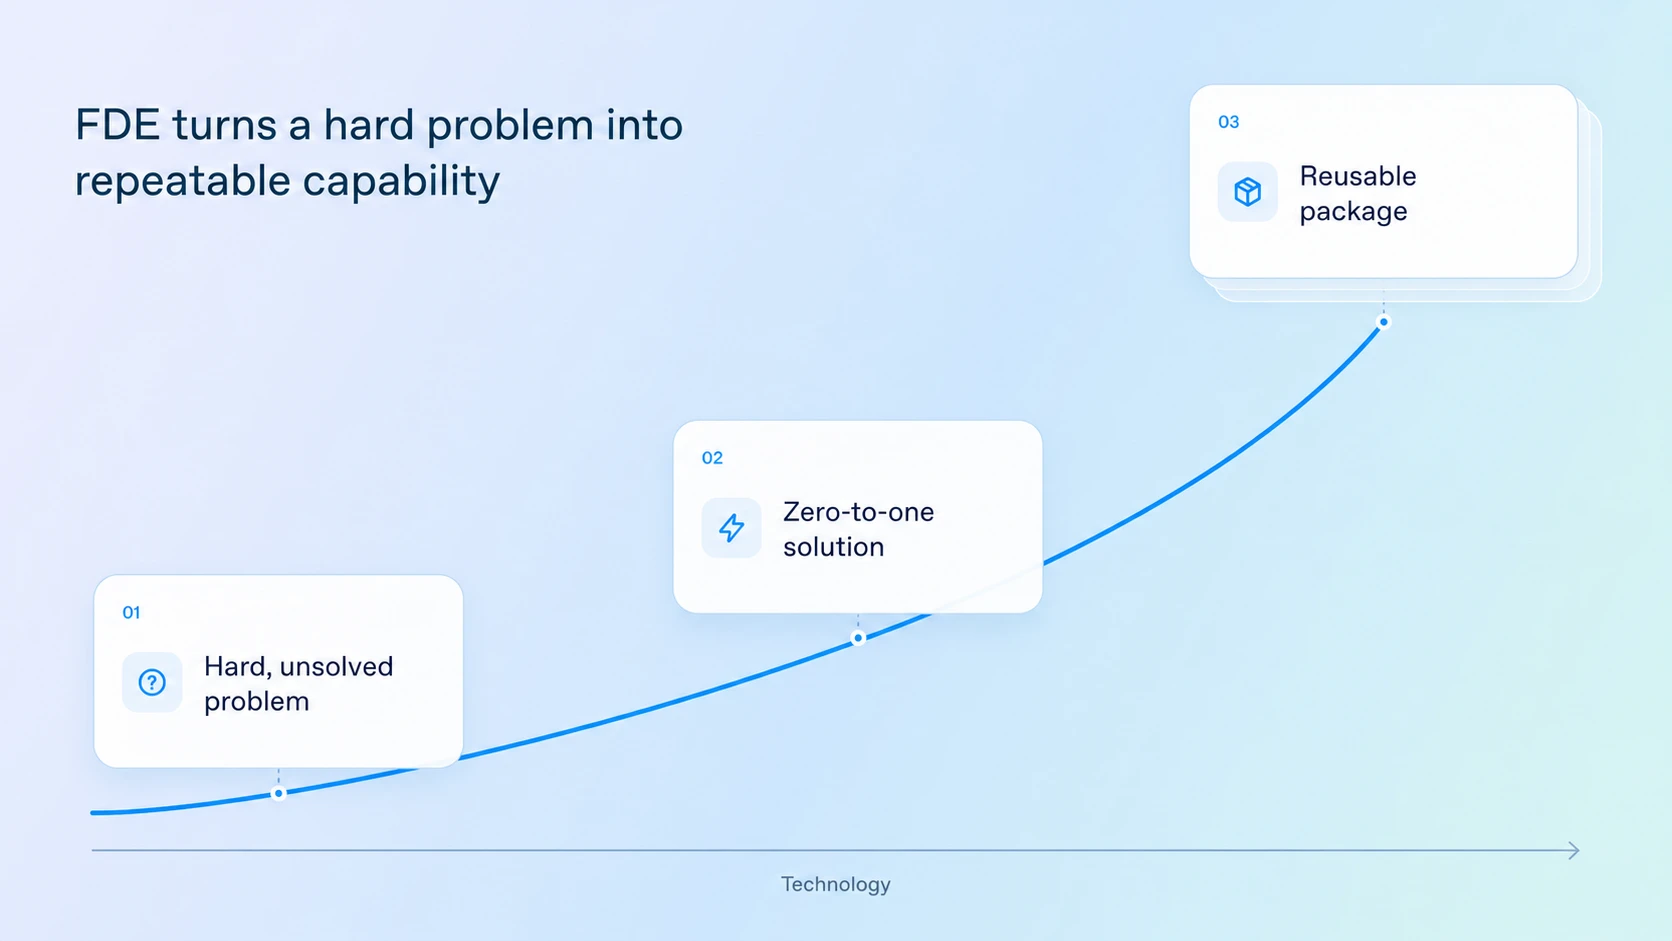
Eso es progreso. Si cada dos meses logramos que nuestro trabajo deje de ser necesario, nuestro equipo de ingenieros de implementación para clientes está cumpliendo su cometido.
Fundé el equipo a principios de 2025 para cerrar lo que llamamos «la brecha de implementación»: la distancia entre lo que los modelos parecen capaces de hacer y lo que las personas pueden utilizar de forma fiable en su trabajo.
Las capacidades de los modelos han avanzado más rápido que los sistemas y procesos necesarios para aprovecharlas. A veces, la pieza que falta es un producto. Otras veces, un modelo obtiene buenos resultados en una prueba de referencia, pero no puede realizar la tarea con las variables y limitaciones del mundo real.
Nos centramos en los problemas más difíciles de los clientes. Cuando nuestros modelos ya pueden realizar la tarea, trabajamos con el equipo de producto y con el cliente para que la solución se pueda replicar. Cuando se quedan cortos, colaboramos con los clientes y con el equipo de investigación para definir las carencias e introducir mejoras. Nuestro objetivo es que cada colaboración ofrezca al siguiente cliente un mejor punto de partida. Si mejoramos esa base hasta que nuestros clientes ya no necesiten ingenieros de implementación para clientes para resolver este tipo de problema la próxima vez, habremos hecho bien nuestro trabajo.
El reto de John Deere, una empresa agrícola con 200 años de historia, era cómo ofrecer asesoramiento personalizado a más agricultores.
Un ejemplo es See & Spray, su tecnología de control de malas hierbas de precisión, que utiliza cámaras y aprendizaje automático para identificar y pulverizar las malas hierbas en lugar de tratar campos enteros, lo que permite reducir el uso de productos químicos hasta un 70 %.
Pero obtener esos beneficios depende de que los agricultores sepan configurar la tecnología, planificar la temporada y adaptar sus prácticas a medida que cambian las condiciones.
John Deere implementó las API de OpenAI para ofrecer ese apoyo de forma personalizada y a gran escala.
La IA puede responder a las preguntas de los agricultores en lenguaje natural, ofrecer orientación y recomendaciones de configuración adaptadas a sus necesidades, detectar cuándo los equipos podrían no estar rindiendo al máximo y ayudarles a comprender el valor que obtienen de la tecnología.
La oportunidad va más allá de una interacción puntual: ofrecer orientación pertinente a lo largo de toda la relación con el cliente, para ayudar a los agricultores a aprovechar mejor sus equipos y mejorar al mismo tiempo la eficiencia y la sostenibilidad.
Este es el tipo de reto que los ingenieros de implementación para clientes de OpenAI tratan de resolver: ayudar a las organizaciones a convertir las capacidades de la IA en sistemas que aporten valor práctico en entornos reales y complejos.
Pero los problemas suelen estar muy abiertos, puede que no haya una referencia validada y no existe un manual que seguir. Todo el mundo quiere crear algo que nunca ha existido. Menos personas están dispuestas a hacer lo necesario para conseguirlo.
Encontrar ingenieros de implementación para clientes con talento y elevar a la vez el listón de lo que consideramos «suficientemente bueno» ha exigido experimentar y poner en práctica lo aprendido de forma constante.
Al inicio de cada sesión del equipo de ingenieros de implementación para clientes, muestro una diapositiva con un valor fundamental: «Empieza por el resultado, haz lo necesario para conseguirlo y, después, amplía la escala».
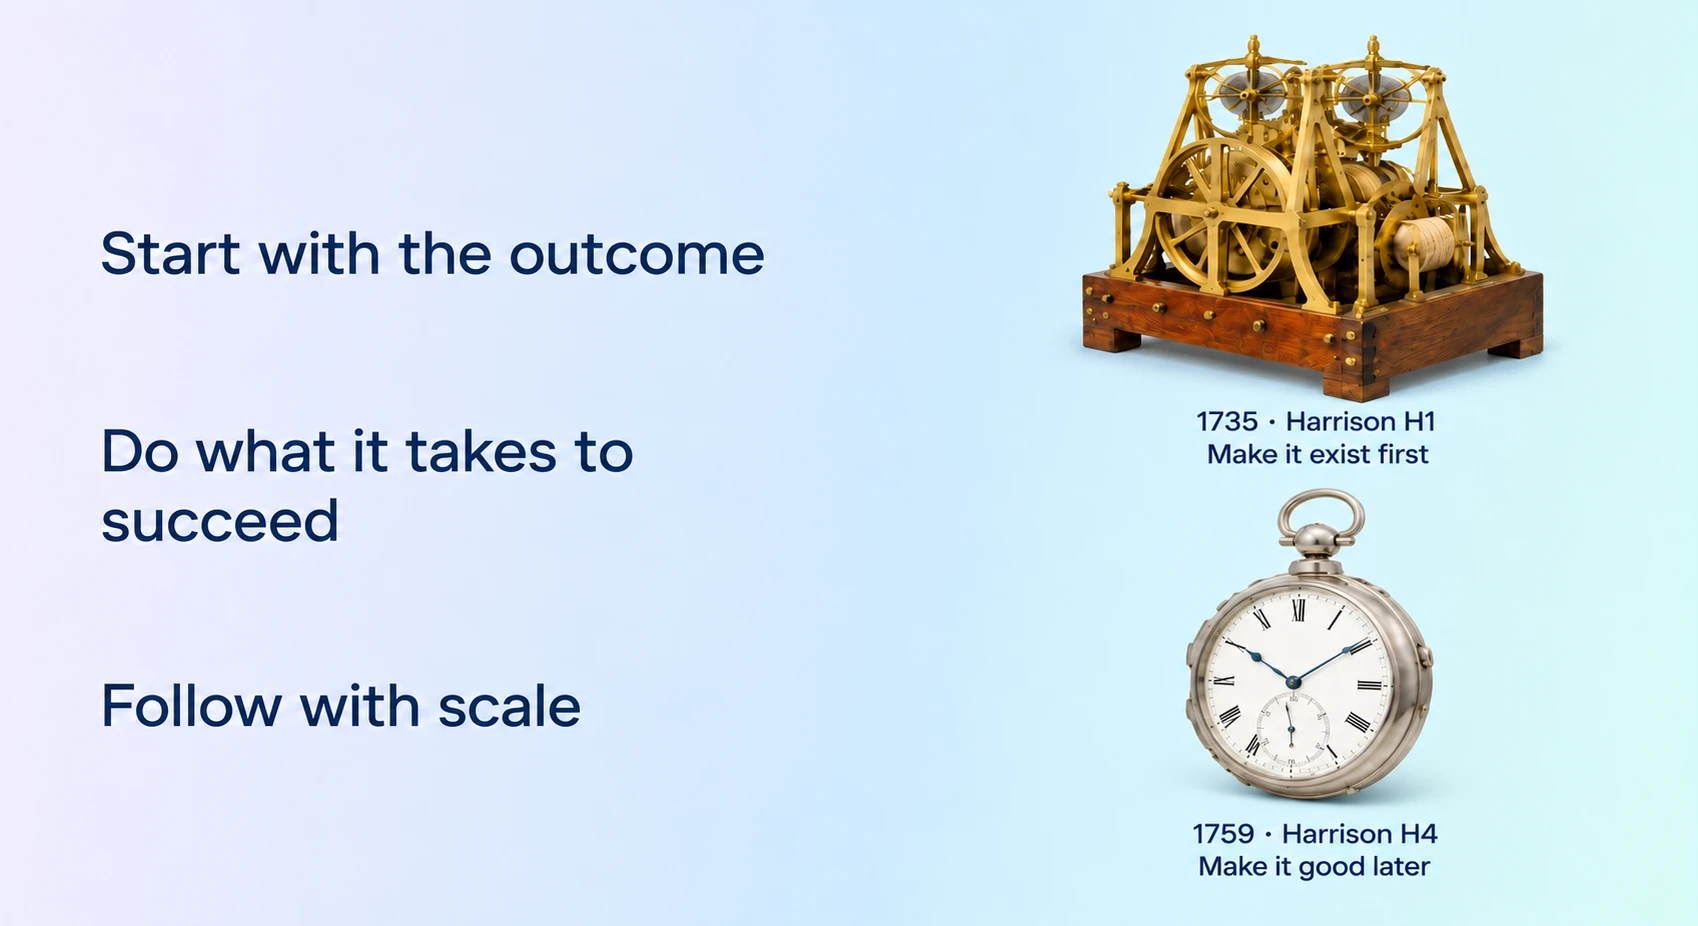
Una demostración impresionante puede llegar muy lejos antes de que alguien pregunte si funciona en el mundo real.
Nuestro trabajo consiste en resolver el problema del cliente con un nivel de calidad que podamos respaldar en producción.
A mediados de 2025, teníamos unos 15 ingenieros de implementación para clientes trabajando con una gran empresa de semiconductores en más de 10 casos de uso. El objetivo era convertir su proceso de verificación en un proceso basado en la IA desde su concepción, que abarcara:
Generación de pruebas dirigidas
Análisis de causas raíz y depuración
Un asistente de arquitectura
En este sector, la verificación puede suponer alrededor del 70 % del esfuerzo de un proyecto. La oportunidad era enorme y había muchos puntos de partida posibles.
Algunos ingenieros de implementación para clientes se habían incorporado a OpenAI apenas unos días antes y nunca habían trabajado en el sector de los semiconductores. Se integraron en el equipo de verificación del cliente, estudiaron diseño de chips en su tiempo libre y desarrollaron evaluaciones junto con los ingenieros para comprobar si la IA podía generar pruebas útiles y diagnosticar correctamente los fallos de los chips.
En paralelo a ese aprendizaje, creamos arneses personalizados para cada caso de uso. En los primeros tres a seis meses, todos llegaron a producción y empezaron a utilizarse. La recompensa llegó al ver las métricas:
Alrededor de un 48 % de ahorro de tiempo gracias a la generación de pruebas dirigidas mediante IA.
Una mejora mediana del rendimiento del 22 % gracias a la optimización de kernels.
Semanas de depuración reducidas a horas
Cuando presentamos todos estos resultados, el director de hardware preguntó: «¿Trabajabais como diseñadores de chips antes de venir aquí?»
Nuestros ingenieros de implementación para clientes no necesitan conocer el sector desde el primer día, pero es su responsabilidad aprender sobre él.
A medida que los asistentes de programación aceleran el desarrollo de software, comprender el negocio del cliente cobra aún más importancia. Formamos equipos que combinan perfiles generalistas y expertos en el ámbito.
Necesitas conocimientos suficientes para tomar decisiones fundadas y curiosidad suficiente para cuestionar lo que se da por sentado sobre la situación actual.
En las ciencias de la vida, por ejemplo, la formación científica de nuestros ingenieros de implementación para clientes les ayuda a ganarse la confianza de investigadores que trabajan en tareas preclínicas de descubrimiento de fármacos, como la validación y priorización de dianas, el análisis de la expresión génica y la reconstrucción de rutas de síntesis química. Esa experiencia les permite aportar un criterio fundamentado sobre cómo mejorar esos flujos de trabajo.
Habíamos demostrado que estos flujos de trabajo podían aportar valor, pero cada uno seguía requiriendo demasiado trabajo de integración a medida para extenderlo a otro equipo. El siguiente reto era mantener esos resultados y, al mismo tiempo, facilitar la implementación y el mantenimiento del software.
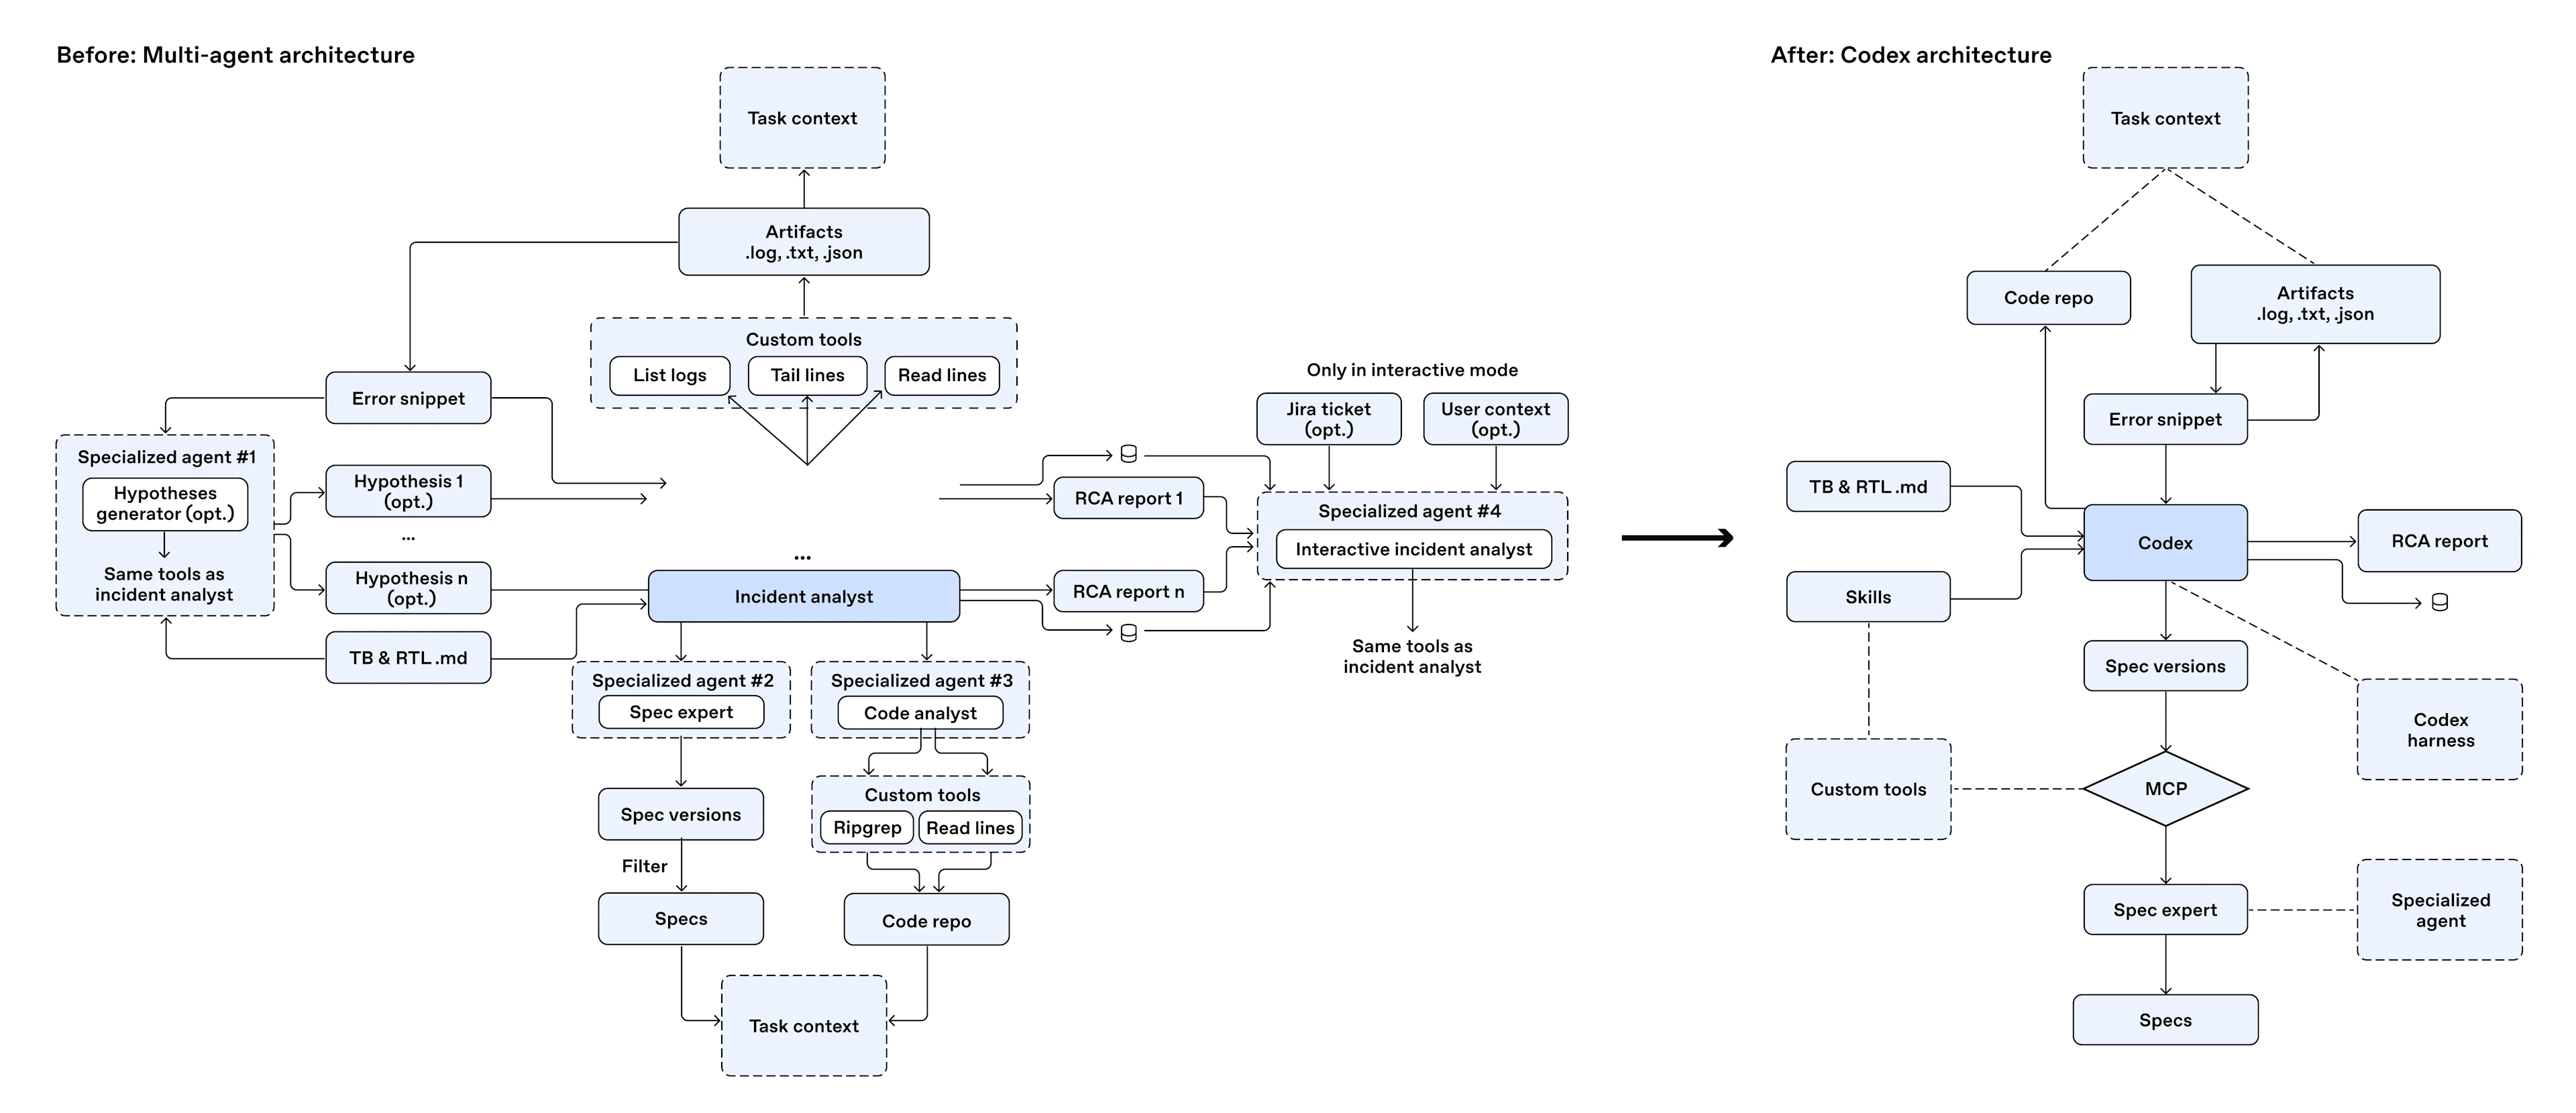
Para entonces, las capacidades de Codex habían aumentado. Un ingeniero de implementación para clientes probó a reconstruir su aplicación en torno a Codex y después trabajó con el equipo para trasladar los casos de uso a un arnés común con Codex como núcleo.
Las aplicaciones a medida se convirtieron en plugins y skills basados en primitivas comunes de Codex. Codex también pasó a ser la interfaz, lo que nos permitió retirar las interfaces de usuario de terminal y de línea de comandos independientes que habíamos desarrollado para cada caso de uso.
Pudimos eliminar aproximadamente el 90 % del código personalizado de cada proyecto, y eso cambió nuestra forma de crear, mantener y ampliar estos flujos de trabajo:
Podíamos aprovechar las mejoras centralizadas de Codex y reducir la cantidad de código de integración necesario para cada caso de uso
Las funcionalidades clave se agruparon en skills y plugins para facilitar su uso compartido entre equipos y su control centralizado por parte del centro de excelencia en IA. Esto significaba que extender la solución de un equipo a otro podía ser tan sencillo como incorporar nuevos conectores o servidores MCP, crear nuevas evaluaciones —para lo que también teníamos una habilidad— y ponerla en marcha.
En un caso de agosto de 2026, la implementación inicial llevó dos meses. Extender la solución a un segundo equipo llevó un día. Los siguientes equipos se incorporaron más rápido a medida que ampliábamos la escala. Esta tendencia ha continuado: en un caso de uso de agosto de 2026, la incorporación del segundo equipo llevó un día, frente a los dos meses de la implementación inicial.
Esa es una forma de hacer que nuestro trabajo deje de ser necesario. El trabajo que habíamos realizado para llegar a producción dejó claro qué era lo importante. A medida que mejoraba el producto subyacente, podíamos sustituir gran parte de nuestra implementación a medida sin perder el valor que aportaba.
Por eso importa el orden. Los LLM nos permiten desarrollar con rapidez. Aprovecha esa velocidad para poner algo valioso en manos de los usuarios, descubrir qué funciona en la práctica y, después, ampliar lo que da resultado.
El mismo principio se aplica a todas las colaboraciones.
OpenAI Presence, nuestro producto para agentes de voz y chat empresariales, surgió de despliegues reales de clientes. El trabajo comenzó con Swarm(se abre en una ventana nueva) y evolucionó a través de la API Agents, y hoy un cliente gestiona más de la mitad de sus llamadas con IA.
Llevar esos despliegues a producción nos enseñó qué problemas necesitaban una solución personalizada y qué bloques de construcción podían usar otros equipos. Incorporamos esos bloques básicos a Presence, facilitando a los desarrolladores la automatización de flujos de trabajo regulados sin reconstruir la infraestructura subyacente. Cada despliegue ayudaba a moldear el producto y ofrecía al siguiente cliente un mejor punto de partida.
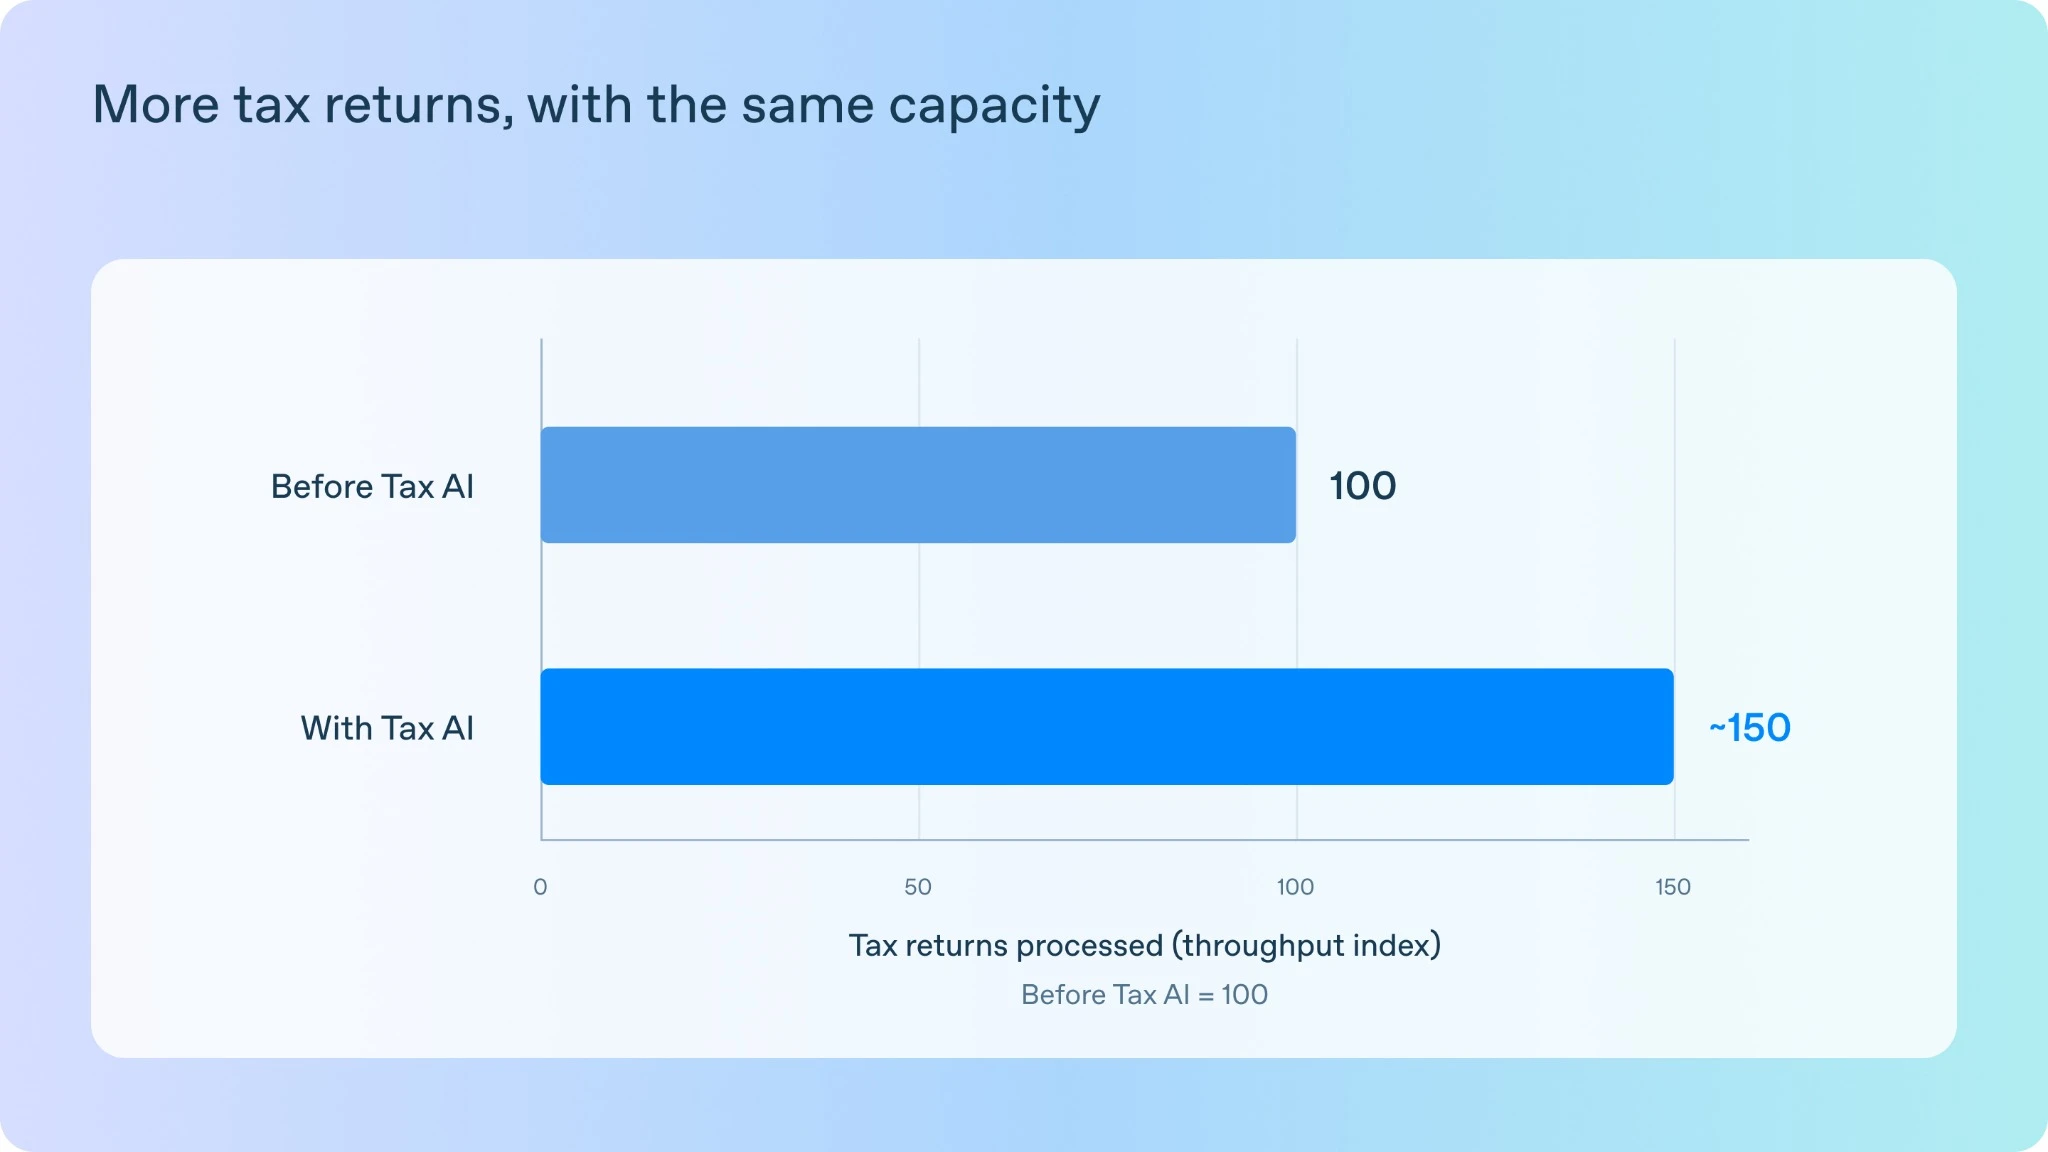
Con Thrive Holdings, los ingenieros de implementación para clientes y los investigadores de OpenAI trabajaron junto a ingenieros y contables para desarrollar Tax AI para las firmas contables de Crete. Durante su piloto, Tax AI procesó 7000 declaraciones de impuestos y aumentó el rendimiento en aproximadamente un 50 %.
Uno de los mayores retos fue automatizar las declaraciones de propiedades en alquiler, que requirió seis semanas de ingeniería y revisión por parte de profesionales para alcanzar un 90 % de precisión y exhaustividad. El trabajo creó patrones reutilizables que facilitaron la extensión de Tax AI a otros anexos fiscales complejos.
Los equipos aplican ahora el mismo enfoque en contabilidad, auditoría y soporte informático: construyen sistemas que mejoran a través de la retroalimentación de los profesionales y el uso en el mundo real.
A veces, un producto mejor nos permite simplificar lo que hemos creado, pero otras veces es el propio modelo el que aún no puede realizar la tarea.
Si solo desarrollamos lo que los modelos actuales ya permiten hacer, no descubriremos las carencias de inteligencia que el equipo de investigación debe subsanar a continuación. Por eso, muchas de nuestras colaboraciones importantes empiezan en esos límites, con el cliente, los ingenieros de implementación para clientes y el equipo de investigación comprometidos a superarlos juntos.
Ya habíamos desarrollado una plataforma de atención al cliente con una gran empresa de telecomunicaciones, y querían ampliarla al canal de voz.
La voz representaba alrededor del 90 % de su volumen de atención al cliente. Resolver estos casos sin intervención humana resultaba más caro que en el chat y planteaba nuevos retos técnicos: gestionar los acentos y el tono, y lograr una latencia y una precisión adecuadas para producción. Conseguirlo supondría una mejora sustancial para su negocio.
Al definir el alcance del proyecto, nuestro modelo obtenía alrededor del 60 % en las evaluaciones clave que utilizábamos para determinar si podía desempeñar su función en producción. Habíamos llegado al límite de sus capacidades. Había que mejorar la llamada a funciones y el seguimiento de instrucciones en situaciones de atención al cliente.
Se lo explicamos al cliente e incorporamos al equipo de investigación al proyecto. Los ingenieros de implementación para clientes colaboraron con el cliente para crear la plataforma y definir qué debía hacer el modelo. El equipo de investigación trabajó para subsanar las carencias del modelo, cuyas versiones sucesivas nos permitieron comprobar los avances frente a los requisitos del cliente.
En seis meses, el rendimiento en las evaluaciones clave pasó de alrededor del 60 % al 80 % y después superó el 90 %, hasta alcanzar los niveles necesarios para producción.
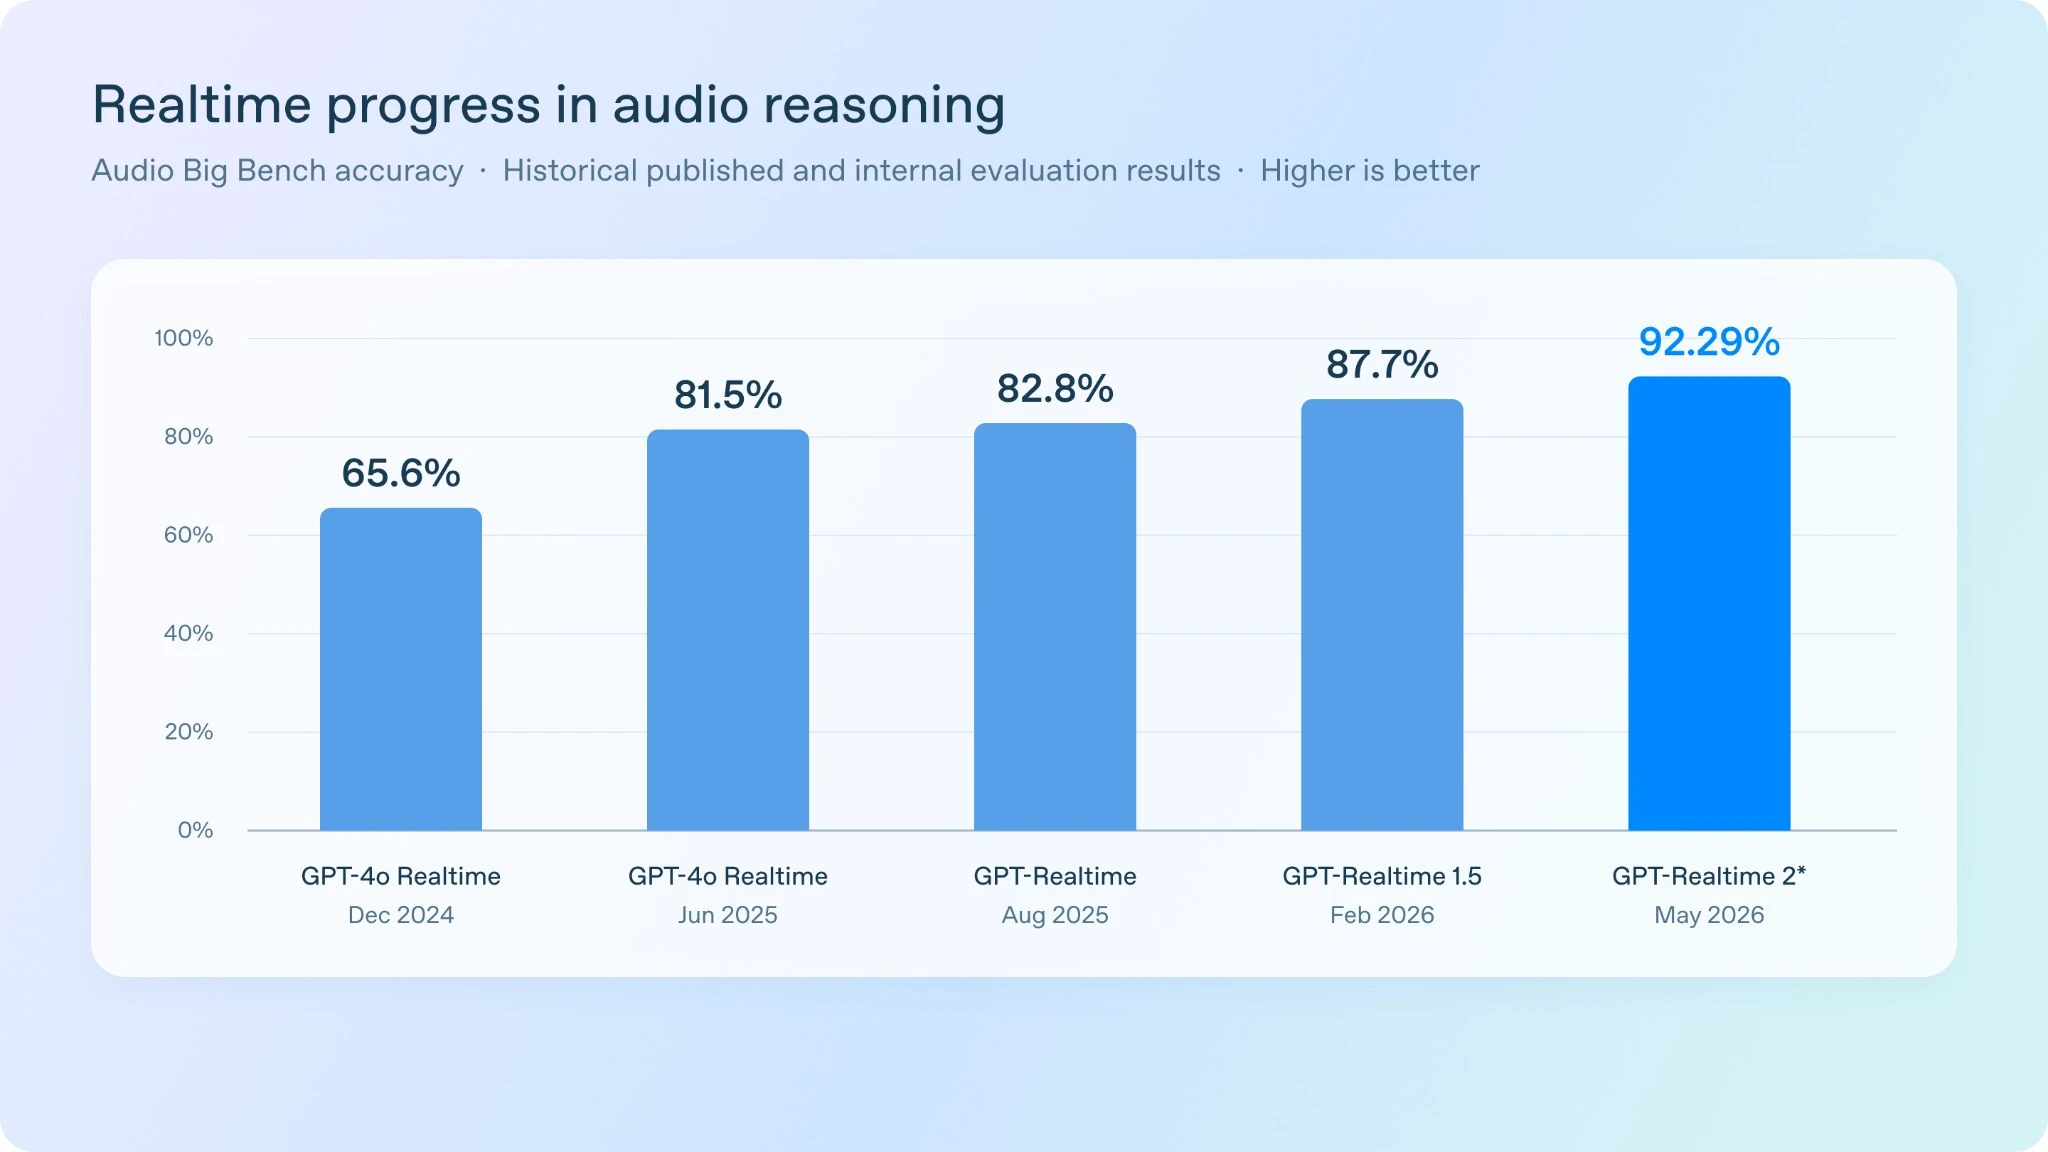
El modelo de voz resultante sustenta ahora la implementación de ese cliente, otras implementaciones personalizadas de atención al cliente e implementaciones gestionadas a través de Presence. Un problema detectado en el negocio de un cliente ayudó a identificar mejoras que podían beneficiar a muchos otros.
Cada parte fue importante. El cliente se comprometió a trabajar en un problema que el modelo aún no podía resolver. Los ingenieros de implementación para clientes mantuvieron una colaboración lo bastante estrecha como para definir el problema, crear la plataforma e impulsar el proyecto de principio a fin. El equipo de investigación mejoró las capacidades del modelo subyacente.
Esta es la otra forma de hacer que nuestro trabajo deje de ser necesario: ayudar a convertir un problema que los modelos actuales no pueden resolver en una capacidad que los modelos futuros puedan ofrecer. El valor de nuestro trabajo va más allá de las horas que dedicamos a un cliente concreto.
Me incorporé a OpenAI para ayudar a que la IA fuera útil en el trabajo diario de las personas. Eso sigue guiando al equipo. A menudo le digo al equipo que, en la mayoría de los casos, en el desarrollo de LLM se aplica la navaja de Occam: la solución más sencilla es la mejor. En una empresa que se define por su investigación de vanguardia y en un sector lastrado por las exageraciones, queremos crear soluciones que funcionen de forma fiable y en las que los profesionales puedan confiar en su día a día.
El objetivo es que cada colaboración mejore lo que viene después: un producto más fácil de implementar, un modelo capaz de abordar una tarea más difícil o menos trabajo a medida para el siguiente cliente.
Si tienes un problema difícil que quieres resolver, nos encantaría trabajar contigo. Si quieres ayudar a resolver esos problemas, nos encantaría que te unieras a nosotros.
Entonces, ¿qué hacemos cuando Codex puede encargarse del trabajo que hemos tardado meses en desarrollar?
Ir en busca de un problema más difícil.