Què vol dir ser enginyer de desplegament al client a OpenAI
Què fem, com treballem i com resolem els problemes més difícils de les empreses per generar un impacte real.
Per Colin Jarvis, responsable d'enginyeria de desplegament al client d'OpenAI
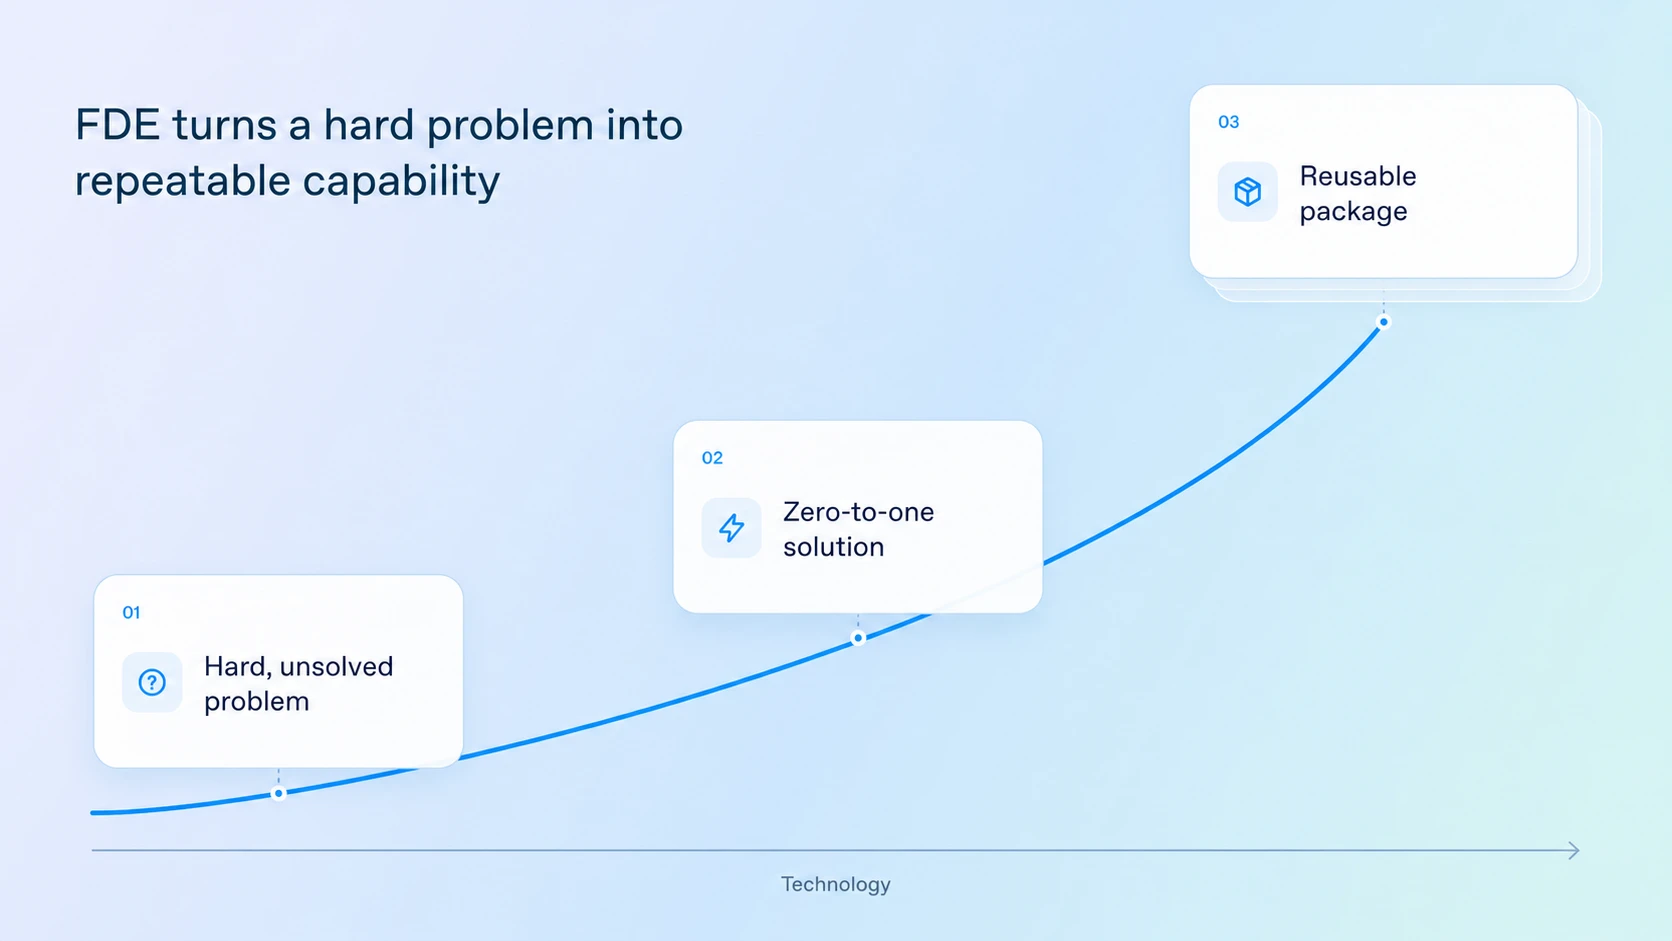
Quan va sortir el Codex, algú de l'equip em va preguntar: "Què fem quan el Codex pot resoldre de cop els casos d'ús que hem estat desenvolupant els darrers mesos?"
Aquesta pregunta va al fons del que vol dir ser enginyer de desplegament al client a OpenAI. Treballem al costat dels clients per entendre els seus problemes més complexos i crear solucions en les quals puguin confiar. El que aprenem ajuda a donar forma als nostres productes i ofereix problemes concrets per resoldre a l'equip de recerca.
Això és progrés. Si cada dos mesos fem que deixem de ser necessaris, és que el nostre equip d'enginyers de desplegament al client està fent la seva feina.
Vaig fundar l'equip a principis del 2025 per tancar el que anomenem "la bretxa de desplegament": la distància entre el que els models semblen capaços de fer i el que les persones poden utilitzar de manera fiable per fer la seva feina.
Les capacitats dels models han avançat més de pressa que els sistemes i processos necessaris per posar-les en pràctica. De vegades, la peça que falta és un producte. De vegades, un model obté bons resultats en una prova de referència, però no pot fer la feina amb les variables i limitacions del món real.
Ens centrem en els problemes més complexos dels clients. Quan els nostres models ja poden fer la feina, treballem amb l'equip de producte i amb el client perquè la solució es pugui replicar. Quan no arriben prou lluny, treballem amb els clients i amb l'equip de recerca per definir les mancances i introduir-hi millores. El nostre objectiu és que cada projecte deixi un punt de partida millor al client següent. Si elevem el nivell de base fins al punt que els clients ja no necessiten enginyers de desplegament al client per resoldre aquesta mena de problemes la propera vegada, voldrà dir que hem fet bé la feina.
El repte de John Deere, una empresa del sector agrícola amb 200 anys d'història, era saber com podia oferir assessorament personalitzat als agricultors a gran escala.
Un exemple és See & Spray, la seva tecnologia de control de males herbes de precisió, que fa servir càmeres i aprenentatge automàtic per identificar i ruixar les males herbes en comptes de tractar camps sencers, cosa que permet reduir l'ús de productes químics fins a un 70 %.
Però obtenir aquests beneficis depèn del fet que els agricultors sàpiguen configurar la tecnologia, planificar la temporada i adaptar les pràctiques a mesura que canvien les condicions.
John Deere va implementar les API d'OpenAI per ajudar a oferir aquest suport de manera personalitzada i a gran escala.
La IA pot respondre a les preguntes dels agricultors en llenguatge natural, oferir orientacions i recomanacions de configuració personalitzades, detectar quan els equips podrien no estar aprofitant tot el seu potencial i ajudar els agricultors a entendre el valor que obtenen de la tecnologia.
L'oportunitat va més enllà d'una interacció puntual, ja que permet oferir orientacions pertinents al llarg de tota la relació amb el client per ajudar els agricultors a aprofitar millor els equips i, alhora, a millorar l'eficiència i la sostenibilitat.
Aquest és el tipus de repte que els enginyers de desplegament al client d'OpenAI treballen per resoldre: ajudar les organitzacions a convertir les capacitats de la IA en sistemes que aportin valor pràctic en entorns reals i complexos.
Però els problemes sovint estan poc definits, pot ser que no hi hagi cap veritat de referència establerta i no hi ha cap manual a seguir. Tothom vol crear alguna cosa que no hagi existit mai, però no tanta gent vol fer el que cal per aconseguir-ho.
Trobar enginyers de desplegament al client amb talent i alhora elevar el llindar del que considerem "prou bo" ha exigit experimentar i posar en pràctica constantment el que aprenem.
Al començament de cada sessió de l'equip d'enginyers de desplegament al client, mostro una diapositiva amb un valor fonamental: "Comença pel resultat, fes el que calgui per aconseguir-lo i, després, amplia'n l'escala".
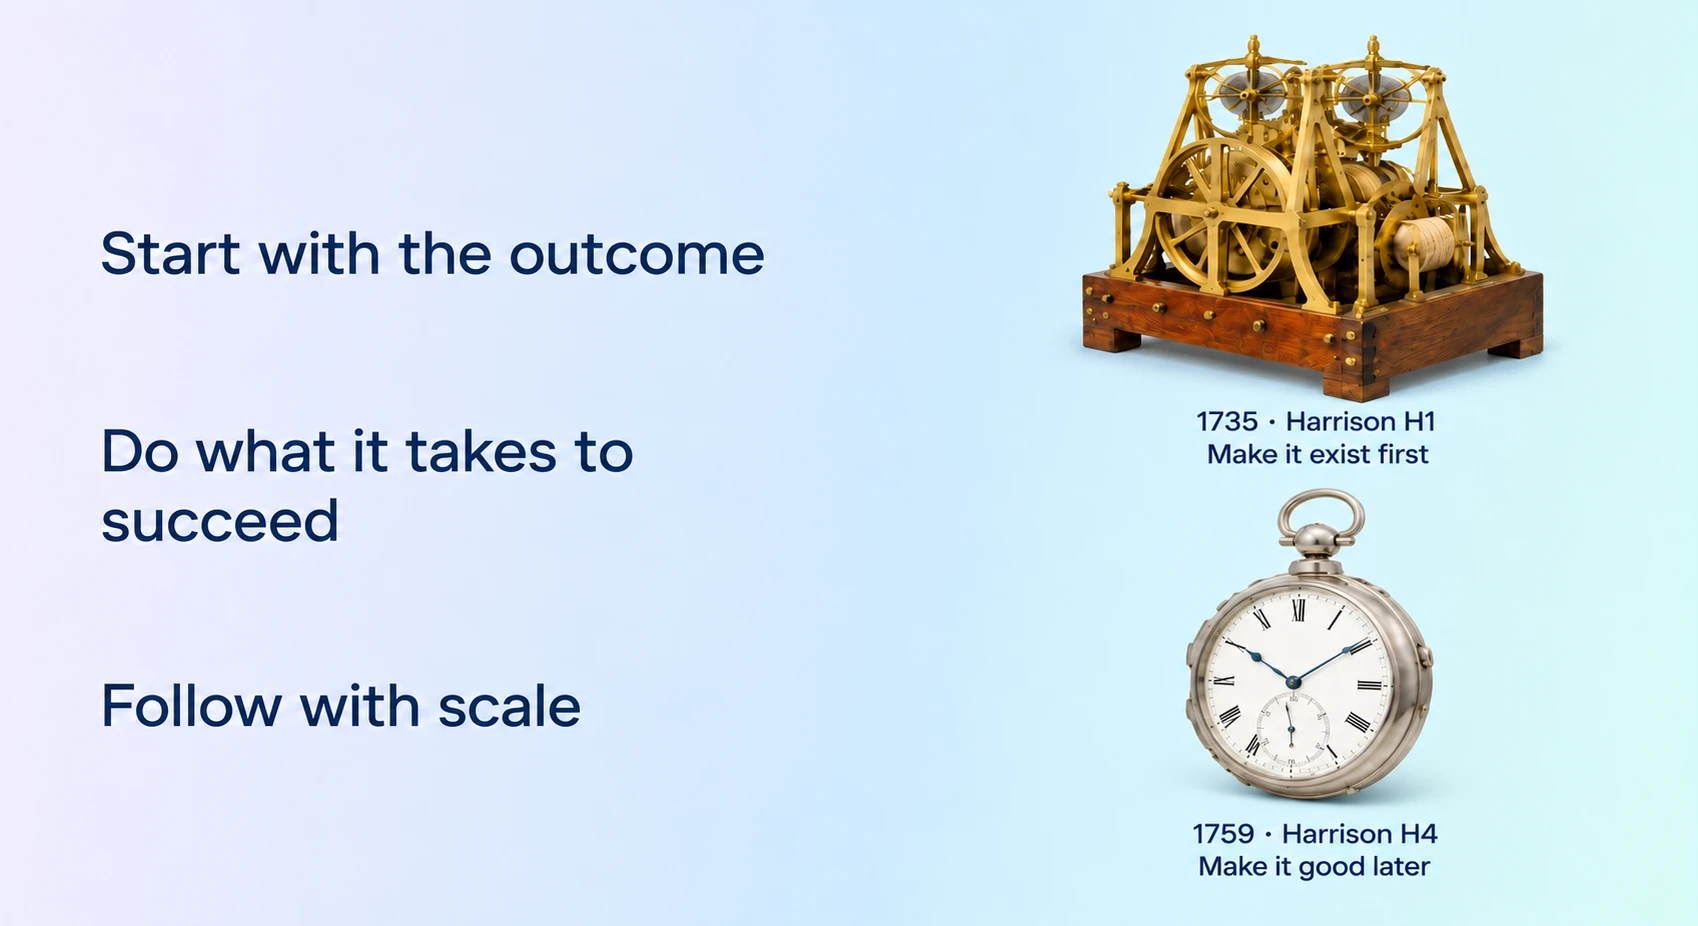
Una demostració impressionant pot arribar molt lluny abans que ningú es pregunti si funciona en el món real.
La nostra feina és resoldre el problema del client amb un nivell de qualitat que puguem avalar en producció.
A mitjan 2025, teníem uns 15 enginyers de desplegament al client treballant amb un gran client del sector dels semiconductors en més de 10 casos d'ús. L'objectiu era fer que el seu procés de verificació es basés en la IA des de l'origen i inclogués:
La generació de proves dirigides
L'anàlisi de les causes arrel i depuració
Un assistent d'arquitectura
En aquest sector, la verificació pot representar prop del 70 % de l'esforç d'un projecte. L'oportunitat era enorme, i hi havia molts punts de partida possibles.
Alguns enginyers de desplegament al client s'havien incorporat a OpenAI tot just uns dies abans i no havien treballat mai en el sector dels semiconductors. Es van integrar a l'equip de verificació del client, van estudiar disseny de xips en el temps lliure i van crear avaluacions amb els enginyers per comprovar si la IA podia generar proves útils i diagnosticar correctament les fallades dels xips.
En paral·lel a aquest aprenentatge, vam crear entorns d'execució a mida per a cada cas d'ús. Durant els primers entre 3 i 6 mesos, tots van arribar a producció i els primers usuaris els van començar a fer servir. La recompensa va ser veure les mètriques:
Prop d'un 48 % d'estalvi de temps gràcies a la generació de proves dirigides amb IA.
Una millora mitjana del rendiment del 22 % gràcies a l'optimització de nuclis.
Setmanes de depuració reduïdes a hores.
Quan vam presentar tots aquests resultats, el director de maquinari ens va preguntar: "Abans de venir aquí, havíeu treballat com a dissenyadors de xips?".
Els nostres enginyers de desplegament al client no han de conèixer el sector des del primer dia, però tenen la responsabilitat d'aprendre'n.
A mesura que els assistents de programació acceleren el desenvolupament de programari, entendre el negoci del client esdevé encara més important. Formem equips que combinen generalistes i experts en àmbits concrets.
Cal tenir prou coneixements per prendre decisions fonamentades i prou curiositat per qüestionar el que es dona per fet sobre la manera actual de fer les coses.
En les ciències de la vida, per exemple, la formació científica dels nostres enginyers de desplegament al client els ajuda a guanyar-se la confiança dels investigadors que treballen en tasques preclíniques de descobriment de fàrmacs, com ara la validació i priorització de dianes, l'anàlisi de l'expressió gènica i la reconstrucció de rutes de síntesi química. Aquesta expertesa els permet aportar un criteri fonamentat sobre com es podrien millorar aquests fluxos de treball.
Havíem demostrat que aquests fluxos de treball podien aportar valor, però encara requerien massa feina d'integració a mida per poder-los estendre a un altre equip. El repte següent era preservar aquests resultats i, alhora, fer que el programari fos més fàcil de desplegar i mantenir.
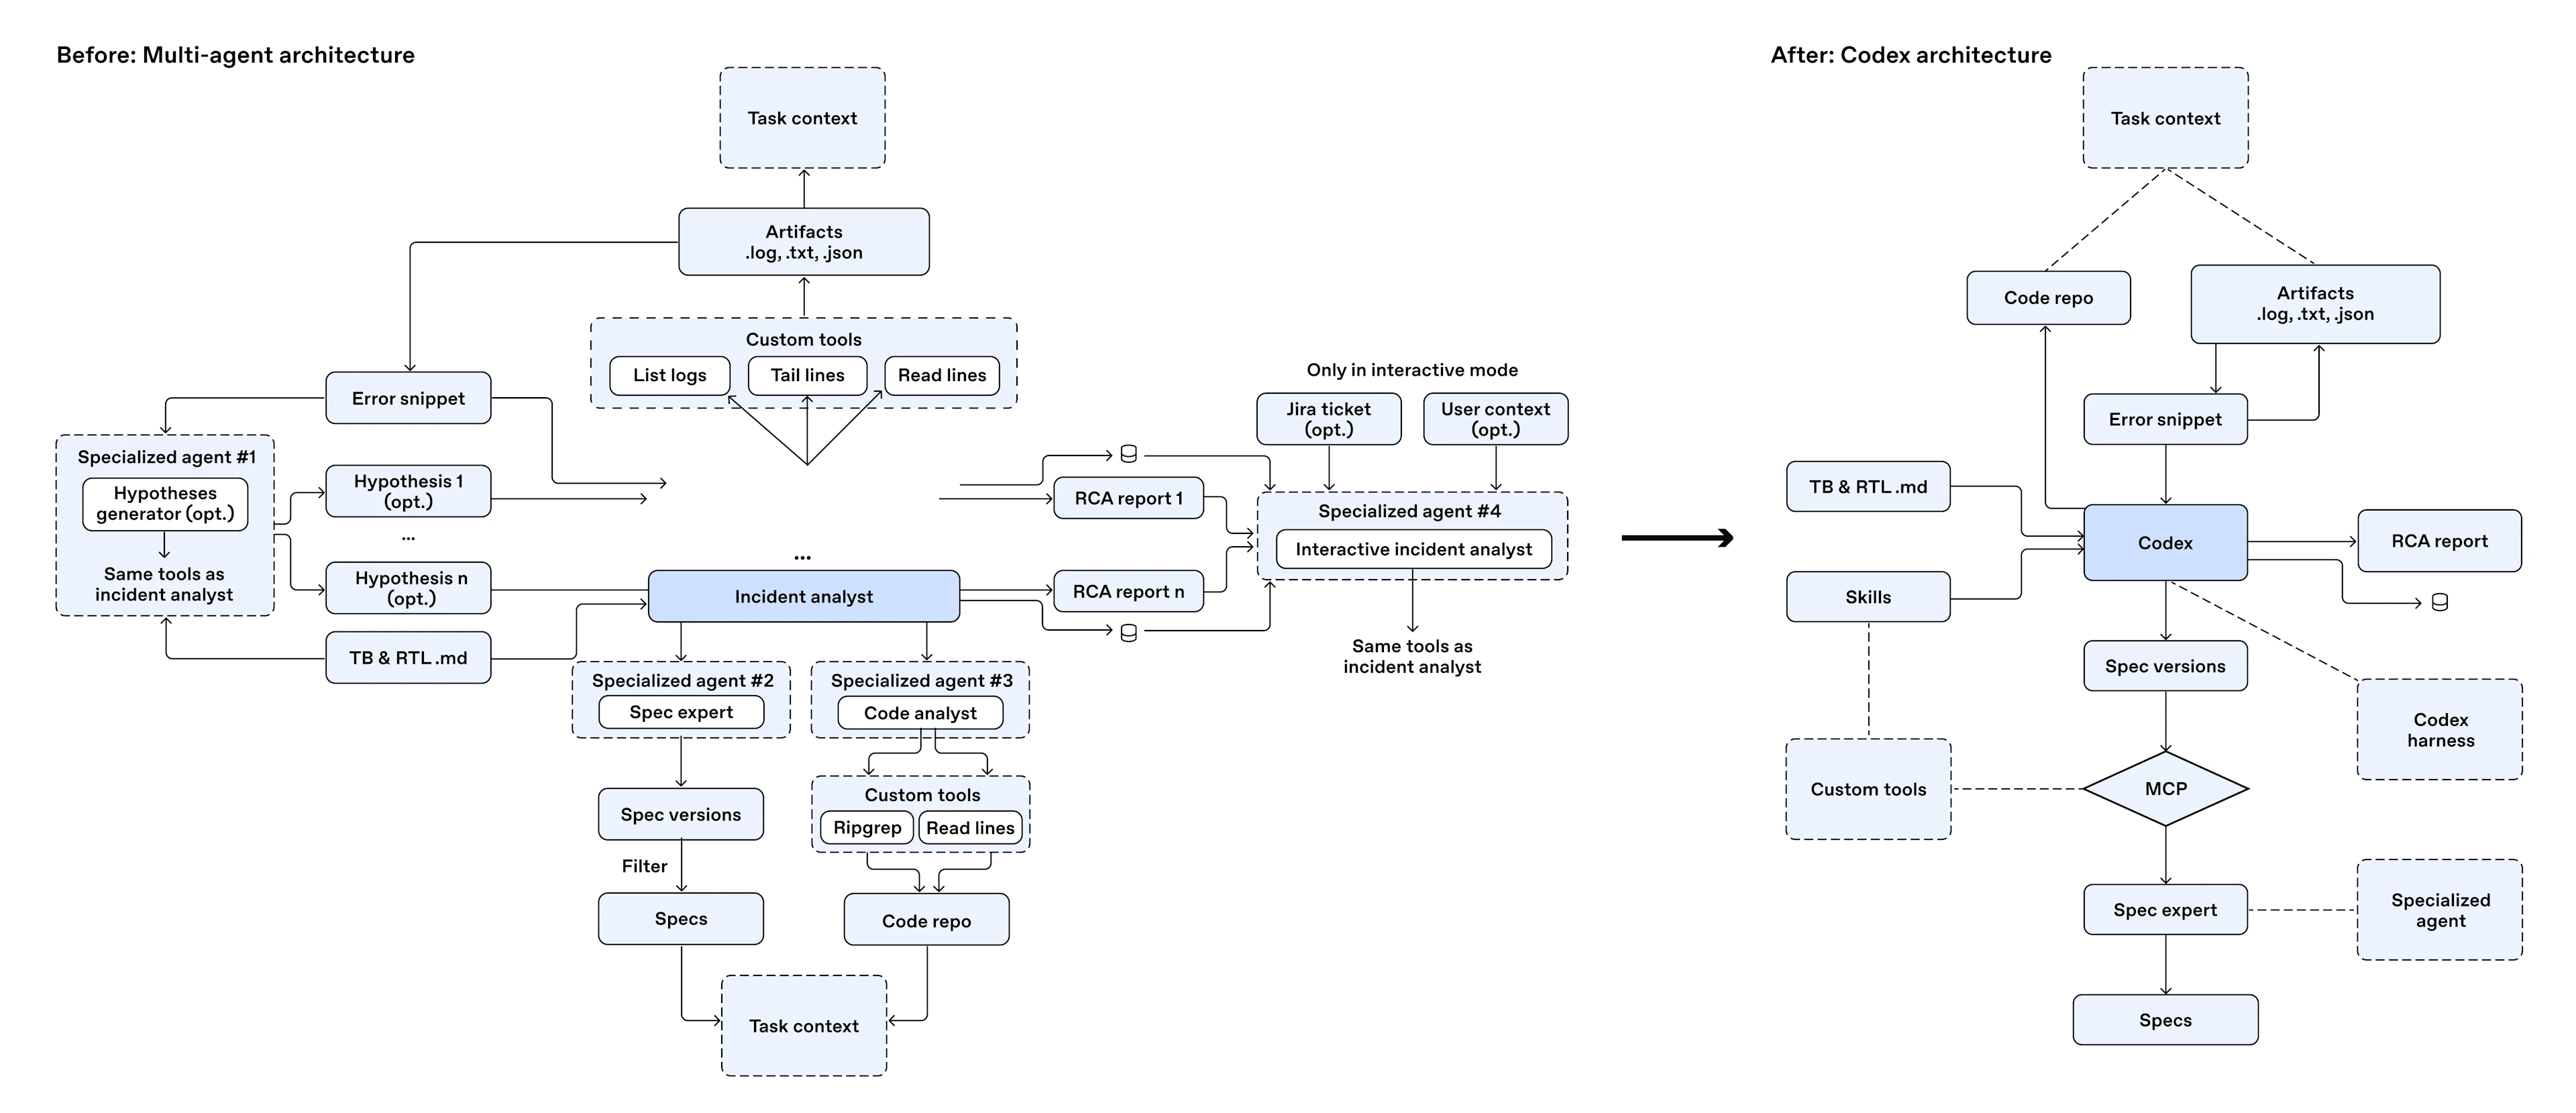
En aquell moment, les capacitats del Codex ja havien augmentat. Un enginyer de desplegament al client va provar de reconstruir la seva aplicació al voltant del Codex i, després, va treballar amb l'equip per traslladar els casos d'ús a un entorn d'execució comú amb el Codex en una posició central.
Les aplicacions a mida es van convertir en connectors i habilitats creats a partir de components bàsics comuns del Codex. El Codex també es va convertir en la interfície, cosa que ens va permetre retirar les interfícies de terminal i de línia d'ordres independents que havíem creat per a cada cas d'ús.
Vam poder eliminar aproximadament el 90 % del codi a mida de cada projecte, i això va canviar la nostra manera de crear, mantenir i ampliar aquests fluxos de treball:
Podíem aprofitar les millores centralitzades del Codex i reduir la quantitat de codi d'integració necessari per a cada cas d'ús
Les funcionalitats clau es van agrupar en habilitats i connectors, cosa que facilitava compartir-les entre equips i controlar-les de manera centralitzada des del centre d'excel·lència en IA. Això volia dir que ampliar la solució d'un equip a un altre podia ser tan senzill com substituir els connectors o servidors MCP per uns de nous, crear noves avaluacions (per a les quals també teníem una habilitat) i posar-se en marxa.
En un cas de l'agost del 2026, el desplegament inicial va trigar dos mesos. Estendre la solució a un segon equip va trigar un dia. Els equips següents s'hi incorporaven més de pressa a mesura que ampliàvem l'escala. Aquesta tendència s'ha mantingut: en un cas d'ús de l'agost del 2026, la incorporació del segon equip va trigar un dia, després d'un desplegament inicial de dos mesos.
Aquesta és una manera de fer que deixem de ser necessaris. El treball que havíem fet per arribar a producció va permetre establir què era important. A mesura que millorava el producte subjacent, podíem substituir bona part de la implementació a mida i conservar el valor que aportava.
Per això l'ordre importa. Els LLM ens permeten crear de pressa. Aprofita aquesta velocitat per posar una solució valuosa a les mans dels usuaris, descobrir què funciona a la pràctica i, després, ampliar-ne l'escala.
El mateix principi s'aplica a tots els projectes amb clients.
OpenAI Presence, el nostre producte per a agents de veu i conversa empresarials, va sorgir d'implementacions en clients reals. El treball va començar amb Swarm(s'obre en una finestra nova) i va evolucionar a través de l'API d'agents, i avui un client gestiona més de la meitat de les seves trucades amb IA.
Posar aquestes implementacions en producció ens va ensenyar quins problemes necessitaven una solució personalitzada i quins components bàsics podien utilitzar altres equips. Vam incorporar aquests components bàsics a Presence, cosa que facilita als desenvolupadors l'automatització de fluxos de treball regulats sense haver de reconstruir la infraestructura subjacent. Cada desplegament va ajudar a donar forma al producte i va oferir al client següent un millor punt de partida.
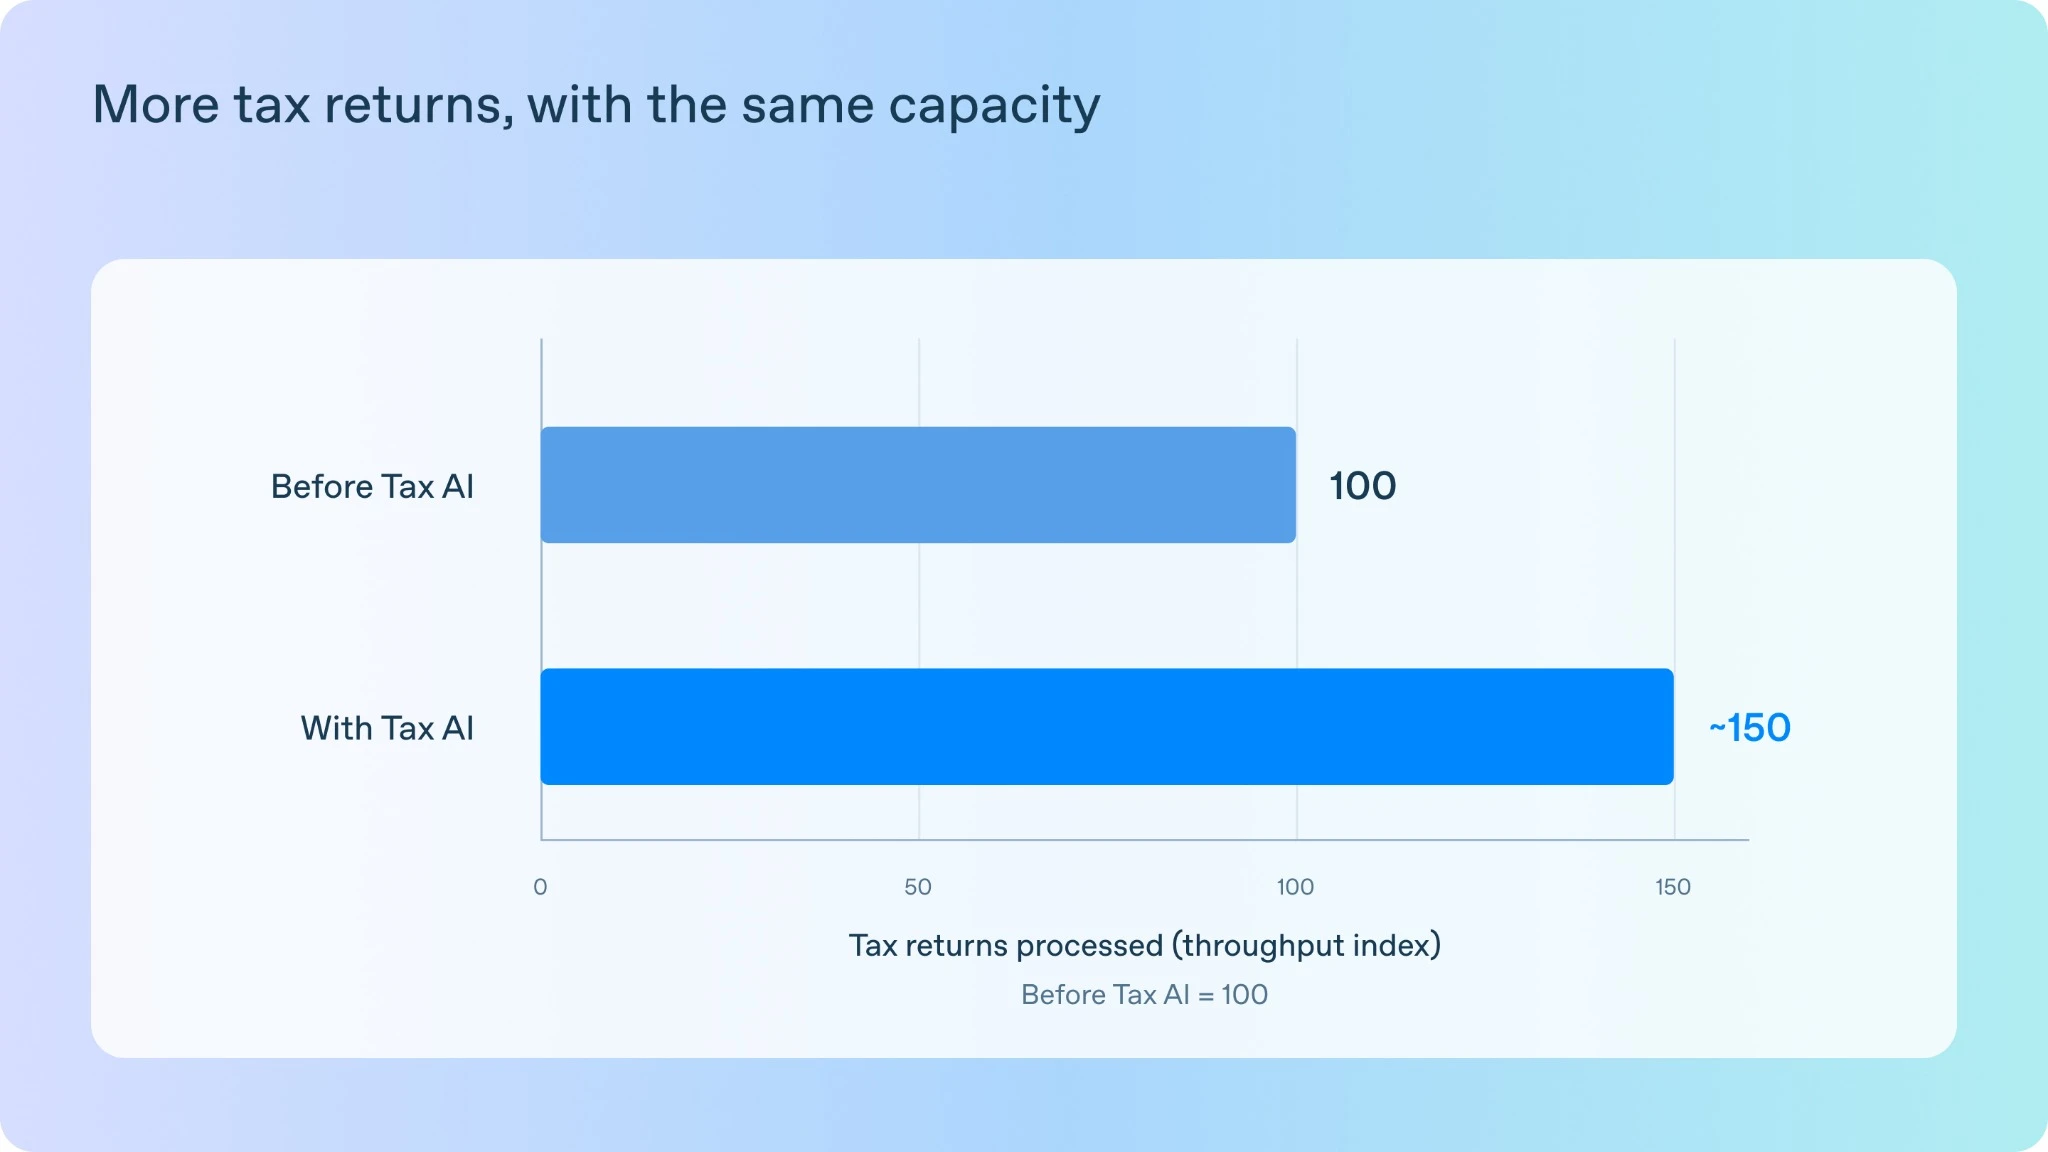
Amb Thrive Holdings, els enginyers de desplegament al client i investigadors d'OpenAI van treballar juntament amb enginyers i comptables per crear una IA fiscal per a les empreses comptables de Creta. Durant la prova pilot, la IA fiscal va processar 7.000 declaracions d'impostos i va augmentar el rendiment en aproximadament un 50 %.
Un dels reptes més difícils va ser l'automatització de les devolucions dels immobles de lloguer, que va requerir sis setmanes d'enginyeria i una revisió professional per assolir una precisió i una recuperació del 90 %. El treball va crear patrons reutilitzables que van facilitar l'extensió de la IA fiscal a altres esquemes fiscals complexos.
Els equips ara apliquen el mateix enfocament a la comptabilitat, l'auditoria i el suport informàtic: creen sistemes que milloren a partir dels comentaris dels professionals i l'ús en el món real.
De vegades, un producte millor ens permet simplificar el que hem creat, però d'altres és el model mateix el que encara no pot fer la feina.
Si només creem el que els models actuals ja fan possible, no descobrirem les mancances d'intel·ligència que l'equip de recerca haurà de superar a continuació. Per això, molts dels nostres projectes clau comencen en aquests límits, amb el compromís del client, dels enginyers de desplegament al client i de l'equip de recerca de treballar plegats per superar-los.
Ja havíem desenvolupat una plataforma d'atenció al client amb un gran client del sector de les telecomunicacions, que volia ampliar-la al canal de veu.
El canal de veu representava prop del 90 % del seu volum d'atenció al client. Resoldre aquests casos sense intervenció humana era més costós que fer-ho per xat i comportava nous reptes tècnics: calia que el tractament dels accents, el to, la latència i la precisió assolissin el nivell necessari per a un entorn de producció. Aconseguir-ho tindria un impacte considerable en el seu negoci.
Durant la definició de l'abast, el nostre model obtenia prop d'un 60 % en les avaluacions clau que fèiem servir per determinar si podria complir la seva funció en producció. Havíem arribat al límit de les seves capacitats. Calia millorar la crida a funcions i el seguiment d'instruccions en situacions d'atenció al client.
Ho vam explicar al client i vam incorporar l'equip de recerca al projecte. L'equip d'enginyers de desplegament al client va col·laborar amb el client per crear la plataforma i definir què havia de fer el model. L'equip de recerca va treballar per superar les mancances de capacitat, amb versions successives del model que ens permetien comprovar els avenços respecte dels requisits del client.
Al llarg de sis mesos, els resultats de les avaluacions clau van passar de prop del 60 % al 80 % i, després, a més del 90 %, fins a assolir els nivells necessaris per a la producció.
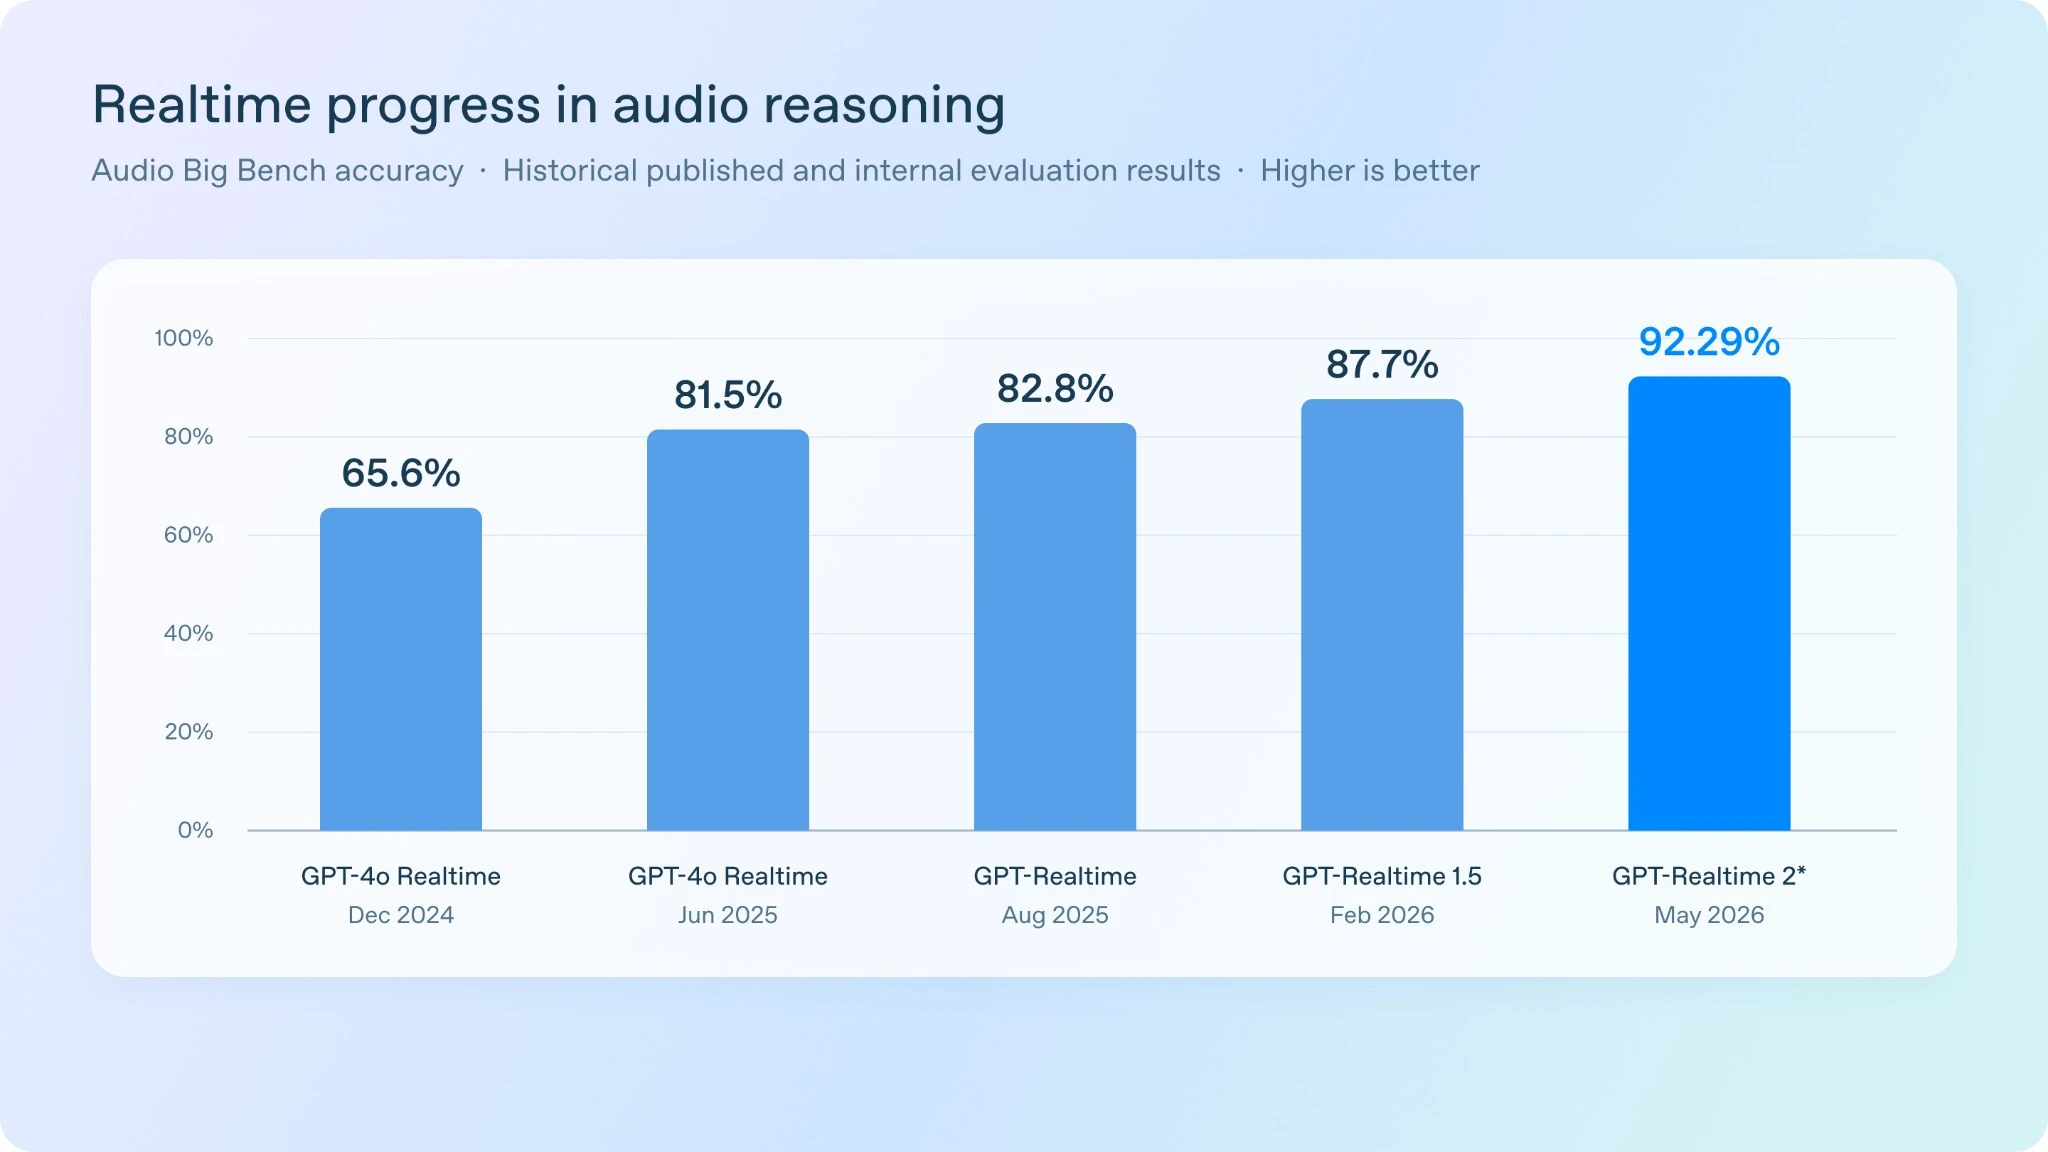
El model de veu resultant ara dona suport al desplegament d'aquest client, a altres desplegaments d'atenció al client a mida i a desplegaments gestionats per mitjà de Presence. Un problema detectat en el negoci d'un client va ajudar a identificar millores que podien servir a molts d'altres.
Cada part hi tenia un paper important. El client es va comprometre a treballar en un problema que el model encara no podia resoldre. L'equip d'enginyers de desplegament al client va mantenir una col·laboració prou estreta per definir el problema, crear la plataforma i impulsar el projecte de principi a fi. L'equip de recerca va millorar les capacitats del model subjacent.
Aquesta és l'altra manera de fer que deixem de ser necessaris: ajudar a convertir un problema que els models actuals no poden resoldre en una capacitat que els models futurs podran oferir. El retorn del nostre treball va més enllà de les hores que dediquem a cada client.
Em vaig incorporar a OpenAI per ajudar a fer que la IA fos útil en la feina quotidiana de les persones. Això continua guiant l'equip. Sovint dic a l'equip que, en la majoria de casos de desenvolupament de LLM, s'aplica la navalla d'Occam: la solució més senzilla és la millor. En una empresa que es defineix per la recerca capdavantera i en un sector marcat per les exageracions, volem crear solucions que funcionin de manera fiable i en les quals els professionals puguin confiar.
L'objectiu és que cada projecte millori el que vindrà després: un producte més fàcil de desplegar, un model capaç d'abordar una tasca més difícil o menys feina a mida per al client següent.
Si tens un problema difícil que vols resoldre, ens encantaria treballar amb tu. Si vols ajudar a resoldre aquests problemes, ens encantaria que t'unissis a nosaltres.
Aleshores, què fem quan el Codex ja pot fer la feina per a la qual hem passat mesos creant solucions?
Busquem un problema més difícil.