DALL·E: Създаване на изображения от текст
Обучихме невронна мрежа, наречена DALL·E, която създава изображения от текстови надписи за широк набор от понятия, изразени на естествен език.
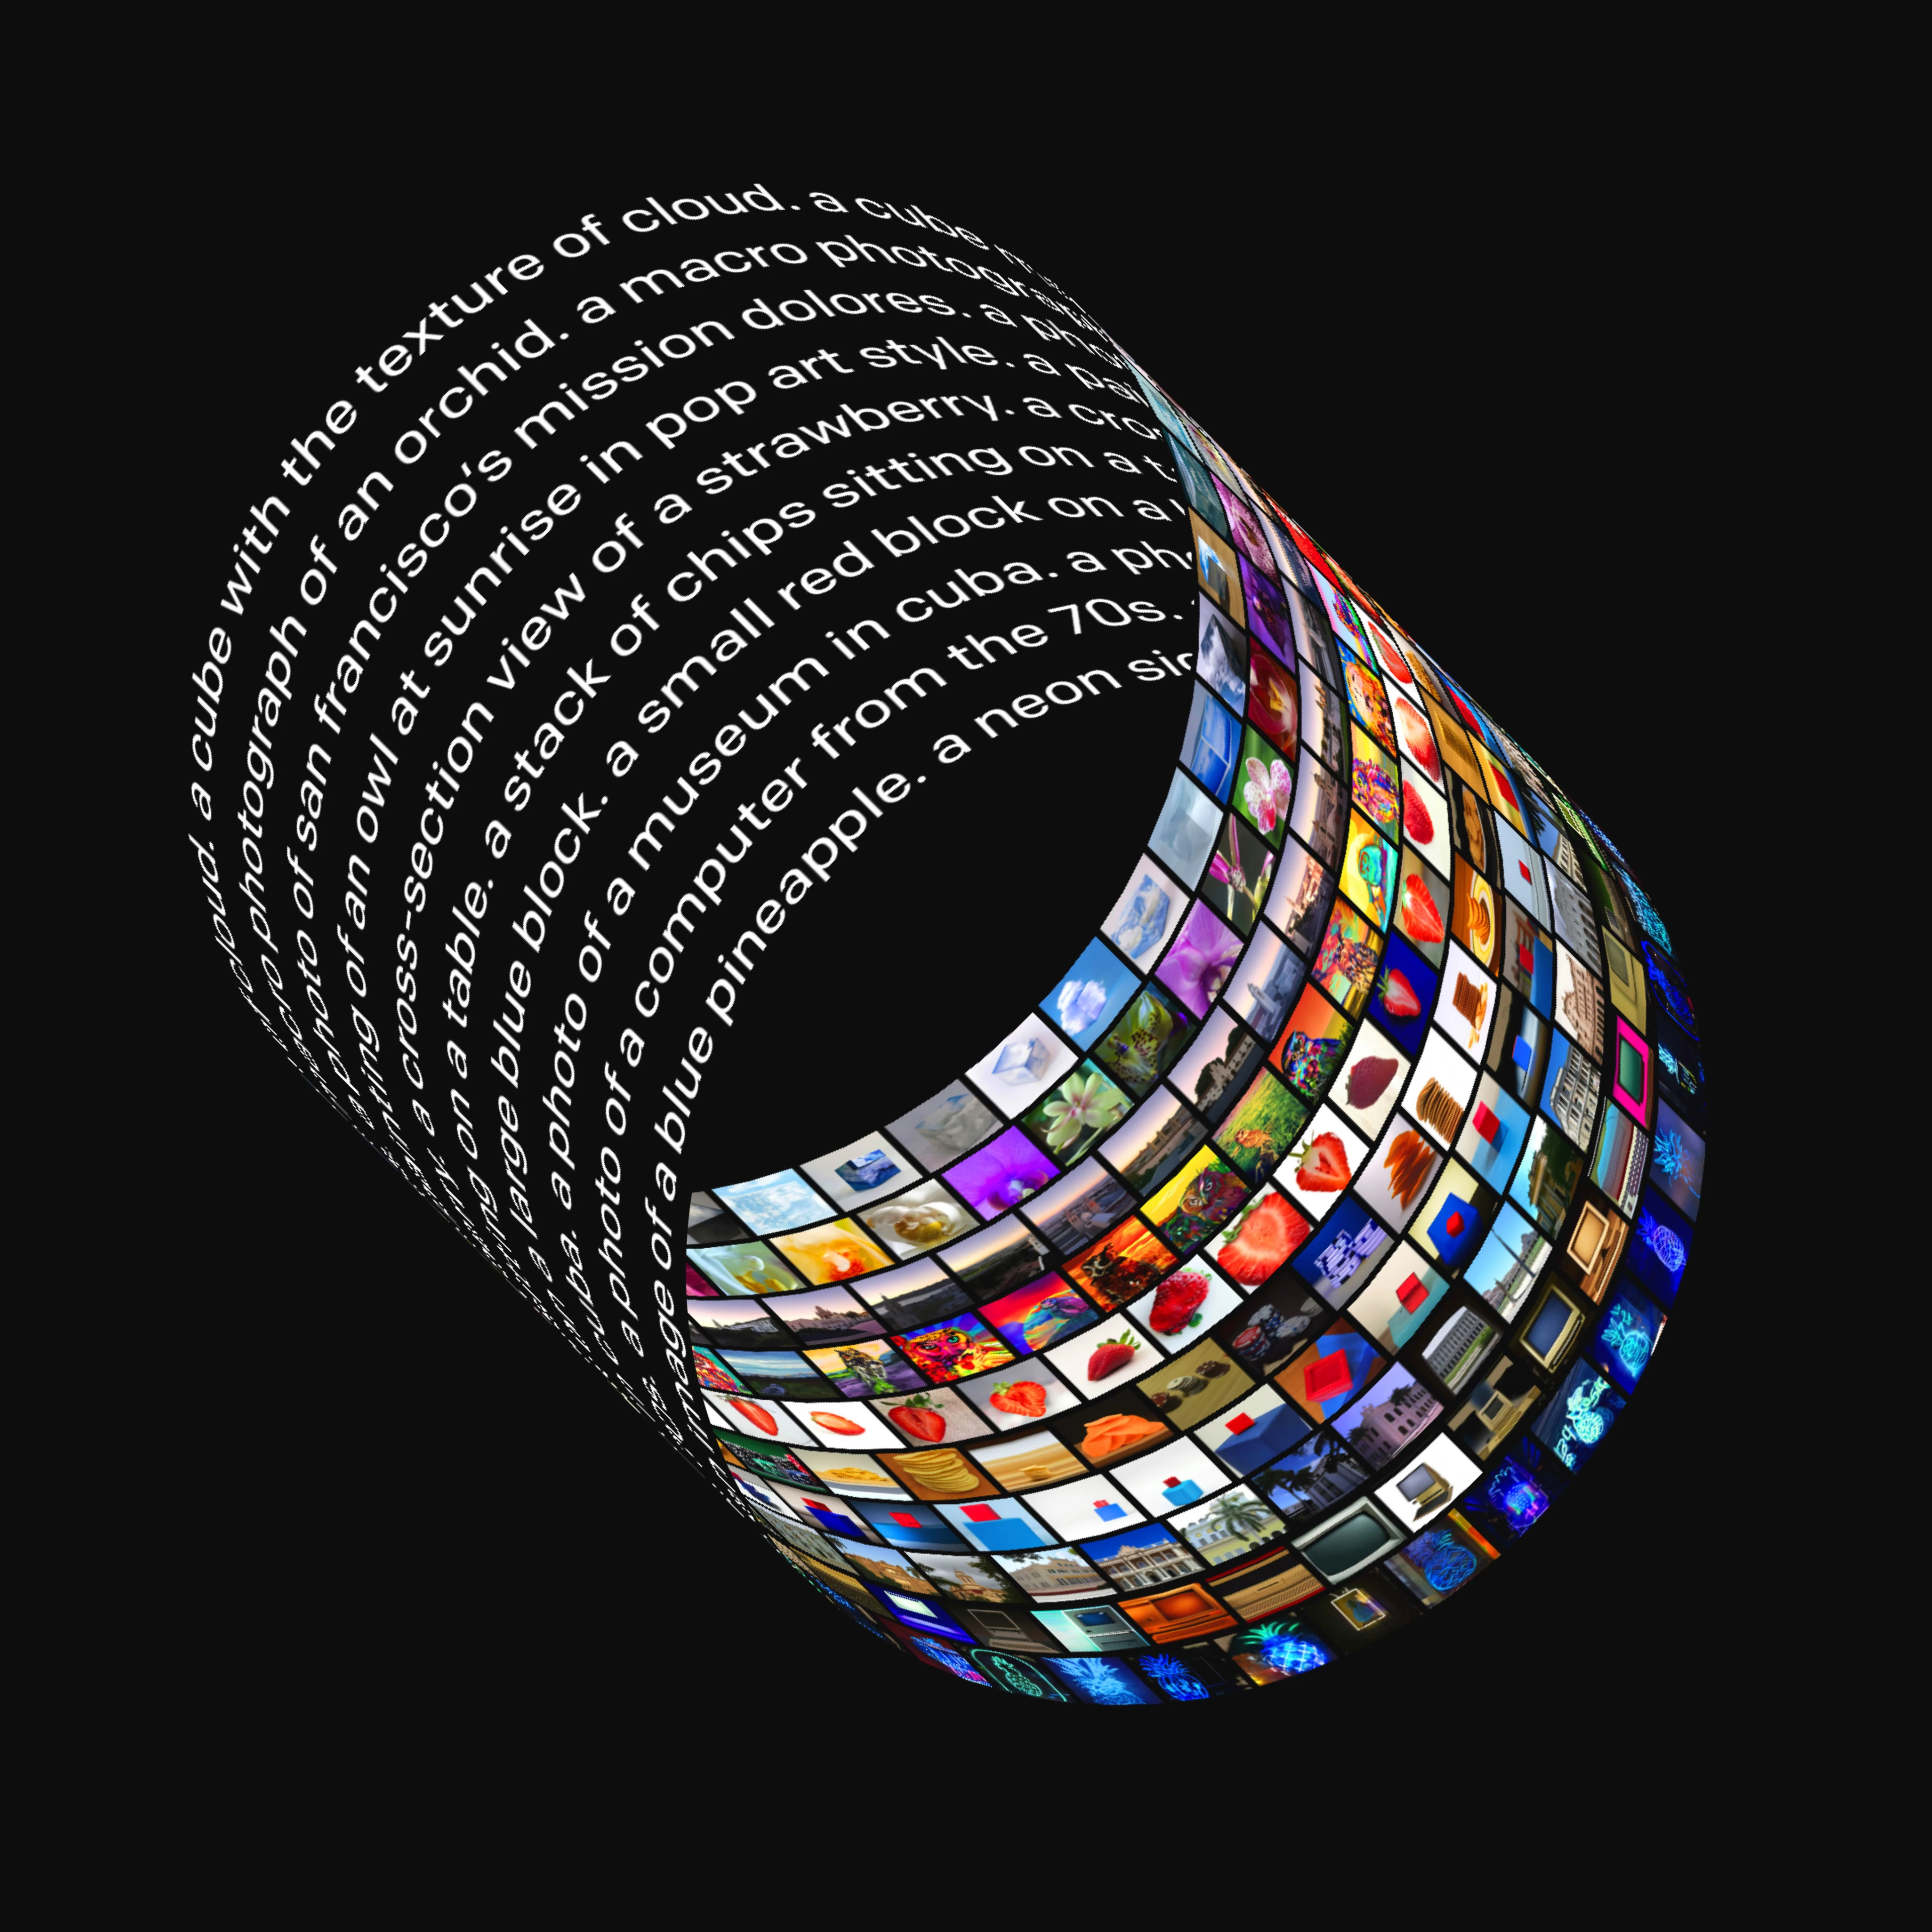
Илюстрация: Джъстин Джей Уанг
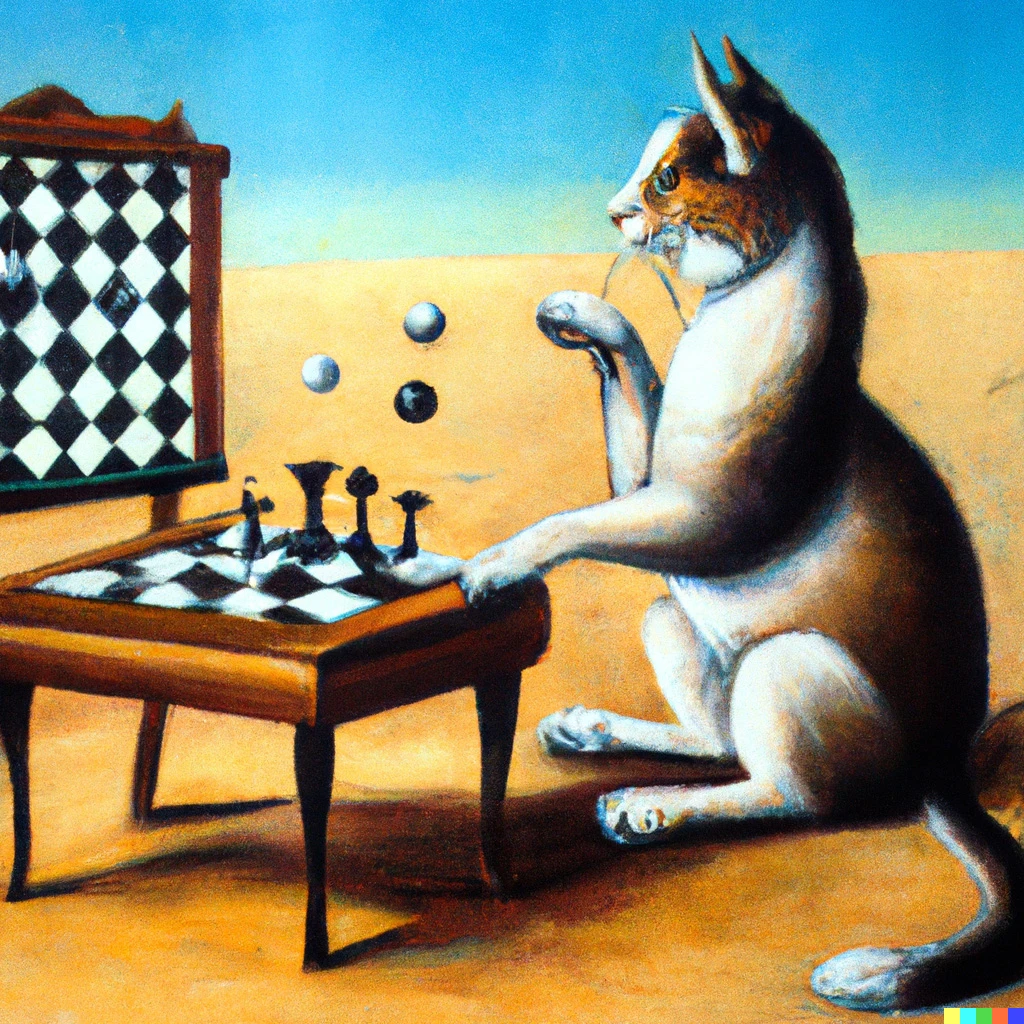
DALL·E е версия на GPT‑3(отваря се в нов прозорец) с 12 милиарда параметъра, обучена да генерира изображения от текстови описания, като използва набор от данни с двойки текст–изображение. Установихме, че има разнообразен набор от възможности, включително създаване на антропоморфни версии на животни и обекти, комбиниране на несвързани концепции по правдоподобен начин, визуализиране на текст и прилагане на трансформации към съществуващи изображения.
Вижте също: DALL·E 2, който генерира по-реалистични и точни изображения с 4 пъти по-висока разделителна способност.
GPT‑3 показа, че езикът може да се използва за инструктиране на голяма невронна мрежа да изпълнява различни задачи за генериране на текст. Image GPT показа, че същият тип невронна мрежа може да се използва и за генериране на изображения с висока степен на достоверност. Разширяваме тези открития, за да покажем, че манипулирането на визуални концепции чрез езика вече е на една ръка разстояние.
Подобно на GPT‑3, DALL·E е трансформаторен езиков модел. Той получава както текста, така и изображението като един поток от данни, съдържащ до 1280 токена, и е обучен чрез максимално правдоподобие за генериране на всички токени, един след друг. A
Тази процедура за обучение позволява на DALL·E не само да генерира изображение от нулата, но и да регенерира всяка правоъгълна област от съществуващо изображение, която се простира до долния десен ъгъл, по начин, който съответства на текстовата подкана.
Ние признаваме, че работата с генеративни модели има потенциал за значително и широко обществено въздействие. В бъдеще планираме да анализираме как модели като DALL·E се отнасят към обществени въпроси, като например икономическото въздействие върху определени работни процеси и професии, възможността за предубеждение в изходите от модела и дългосрочните етични предизвикателства, свързани с тази технология.
Установихме, че DALL·E е в състояние да създава правдоподобни изображения за голямо разнообразие от изречения, които изследват композиционната структура на езика. Илюстрираме това, използвайки серия от интерактивни визуализации в напред раздел. Извадките, показани за всеки надпис във визуализацията, са получени чрез избиране на първите 32 от 512 след пренареждане с CLIP, но не използваме никаква ръчна селекция, освен миниатюрите и самостоятелните изображения, които се появяват отвън.B
Тестваме способността на DALL·E да променя няколко атрибута на даден обект, както и броя на появяванията му.
Едновременното управление на множество обекти, техните атрибути и пространствените им взаимоотношения представлява ново предизвикателство. Например, разгледайте фразата „таралеж, който носи червена шапка, жълти ръкавици, синя риза и зелени панталони.“ За да изтълкува правилно това изречение, DALL·E трябва не само да състави правилно всяка част от облеклото с животното, но и да образува асоциации (шапка, червена), (ръкавици, жълти), (риза, синя) и (панталон, зелен), без да ги смесва C
Тестваме способността на DALL·E да прави това за относително позициониране, подреждане на обекти и управление на множество атрибути.
Въпреки че DALL·E предлага известно ниво на контрол върху атрибутите и позициите на малък брой обекти, успеваемостта може да зависи от начина, по който е формулиран надписът. С въвеждането на повече обекти DALL·E е склонен да обърква асоциациите между обектите и техните цветове и процентът на успеваемост рязко намалява. Също така отбелязваме, че DALL·E е крехък по отношение на преформулирането на надписа в тези сценарии: алтернативните, семантично еквивалентни надписи често не дават правилни интерпретации.
Открихме, че DALL·E позволява също така контрол върху гледната точка на сцената и 3D стила, в който се рендерира сцената.
За да задълбочим това, тестваме способността на DALL·E да рисува многократно главата на добре позната фигура под всеки ъгъл от поредица от еднакво разположени ъгли и откриваме, че можем да възстановим плавна анимация на въртящата се глава.
Изглежда, че DALL·E може да прилага някои видове оптични изкривявания на сцените, както виждаме с опциите „изглед с рибешко око“ и „сферична панорама“. Това ни мотивира да направим изследване на способността му за генериране на отражения.
Пробите от стиловете „екстремно близък план“ и „рентген“ ни накараха да изследваме по-задълбочено способността на DALL·E да възпроизвежда вътрешната структура с напречни сечения и външната структура с макро фотографии.
Задачата за превод на текст към изображения е недостатъчно конкретна: на едно заглавие обикновено съответстват безкрайно много вероятни изображения, така че изображението не е еднозначно определено. Например, разгледайте надписа „картина на капибара, седяща на поле по изгрев слънце.“ В зависимост от ориентацията на капибарата може да се наложи да се нарисува сянка, въпреки че тази подробност никога не се споменава изрично. Изследваме способността на DALL·E да разрешава недоизяснени случаи в три аспекта: промяна на стил, обстановка и време; рисуване на един и същ обект в различни ситуации; и генериране на изображение на обект с написан върху него специфичен текст.
С различна степен на надеждност DALL·E осигурява достъп до подмножество от възможностите на 3D рендеринг двигателя чрез естествен език. Той може самостоятелно да контролира атрибутите на малък брой обекти и в ограничена степен – колко на брой са те и как са разположени един спрямо друг. Също така може да контролира местоположението и ъгъла, от който се изобразява сцената, и може да осъществи генериране на известни обекти в съответствие с точните спецификации за ъгъл и условия на осветление.
За разлика от 3D рендеринг двигателя, чиито въвеждания трябва да бъдат посочени недвусмислено и в пълни подробности, DALL·E често е в състояние да „попълни празнините“, когато надписът подсказва, че изображението трябва да съдържа определена подробност, която не е изрично посочена.
След това изследваме използването на предходните възможности за моден и интериорен дизайн.
Композиционният характер на езика ни позволява да обединяваме понятия, за да описваме както реални, така и въображаеми неща. Установяваме, че DALL·E също има способността да комбинира различни идеи, за да синтезира обекти, някои от които е малко вероятно да съществуват в реалния свят. Изследваме тази способност в два случая: трансфериране на качества от различни концепции върху животни и проектиране на продукти чрез вдъхновение от несвързани концепции.
В предишния раздел изследвахме способността на DALL·E да комбинира несвързани концепции при генериране на изображения на обекти от реалния свят. Тук изследваме тази способност в контекста на изкуството за три вида илюстрации: антропоморфизирани версии на животни и предмети, животински химери и емоджита.
GPT‑3 може да бъде инструктиран да изпълнява много видове задачи само въз основа на описание и подсказка за генериране на отговор, предоставена в подкана, без никакво допълнително обучение. Например, когато бъде подканен с фразата „ето изречението „човек, който разхожда кучето си в парка“, преведено на френски:“, GPT‑3 отговаря „un homme qui promène son chien dans le parc.“ Тази способност се нарича разсъждаване с нула повторения. Установихме, че DALL·E разширява тази способност до визуалния домейн и е в състояние да изпълнява няколко вида задачи за превод от изображение към изображение, когато е подканен по правилния начин.
Не предвиждахме, че тази способност ще се прояви, и не направихме никакви промени в невронната мрежа или процедурата на обучение, за да я насърчим. Мотивирани от тези резултати, ние измерваме способностите на DALL·E за решаване на аналогични задачи, като го тестваме с прогресивните матрици на Рейвън – визуален тест за интелигентност, широко използван през 20-и век.
Установяваме, че DALL·E е научил за географски факти, забележителности и квартали. Неговите знания за тези концепции са изненадващо точни в някои отношения и неточни в други.
В допълнение към изследването на знанията на DALL·E за концепции, които се променят в пространството, ние също така изследваме знанията му за концепции, които се променят във времето.
DALL·E е прост само декодиращ трансформатор, който получава както текста, така и изображението като един поток от 1280 токена – 256 за текста и 1024 за изображението – и ги моделира всички авторегресивно. Маската на вниманието във всеки от 64-те си слоя за самовнимание позволява на всеки токен на изображение да присъства на всички текстови токени. DALL·E използва стандартната причинно-следствена маска за текстовите токени и разредено внимание за токените на изображения с редова, колонна или конволюционна схема на внимание, в зависимост от слоя. Предоставяме повече подробности за архитектурата и процедурата за обучение в нашата статия(отваря се в нов прозорец).
Синтезът на текст в изображение е активна област на изследване от пионерската работа на Reed et. al,1, чийто подход използва GAN, обусловен от вграждане на текст. Вгражданията се създават от енкодер, предварително обучен с помощта на контрастна загуба, за разлика от CLIP. StackGAN3 и StackGAN++4 използват многомащабни GAN, за да увеличат разделителната способност на изображението и да подобрят визуалната достоверност. AttnGAN5 включва внимание между характеристиките на текста и изображението и предлага контрастна загуба при съпоставяне на характеристиките на текста и изображението като допълнителна цел. Интересно е да се сравни с нашето пренареждане с CLIP, което се извършва офлайн. Други работи2, 6 и 7 включват допълнителни източници на наблюдение по време на обучението, за да се подобри качеството на изображението. Накрая, работата на Nguyen et. al8 и Cho et. al9 изследва стратегии за генериране на изображения, базирани на вземане на проби, които използват предварително обучени мултимодални дискриминативни модели.
Подобно на извадката за отхвърляне, използвана във VQVAE-2(отваря се в нов прозорец), ние използваме CLIP, за да пренаредим най-добрите 32 от 512 извадки за всеки надпис във всички интерактивни визуализации. Тази процедура може да се разглежда и като вид търсене, ръководено от езика16, и може да окаже значително въздействие върху качеството на извадката.
Бележки под линия
- A
Токен е всеки символ от дискретен речник; за хората всяка английска буква е токен от 26-буквена азбука. Речникът на DALL-E съдържа токени за концепции, свързани както с текст, така и с изображения. По-конкретно, всеки надпис на изображение се представя с помощта на максимум 256 BPE-кодирани токени с размер на речника 16384, а изображението се представя с помощта на 1024 токени с размер на речника 8192.
По време на обучението изображенията се обработват предварително до разделителна способност 256x256. Подобно на VQVAE, всяко изображение се компресира до мрежа от 32x32 дискретни латентни кодове с помощта на дискретен VAE, който предварително обучихме с помощта на непрекъсната релаксация. Установихме, че обучението с използване на релаксация премахва необходимостта от изрична кодова книга, загуба на EMA или трикове като възстановяване на мъртъв код и може да се мащабира до големи размери на речника.
- B
Допълнителни подробности са предоставени в по-късен раздел.
- 17
Референции
- 1
Reed, S., Akata, Z., Yan, X., Logeswaran, L., Schiele, B., Lee, H. (2016). “Generative adversarial text to image synthesis(отваря се в нов прозорец)”. In ICML 2016.
- 2
Reed, S., Akata, Z., Mohan, S., Tenka, S., Schiele, B., Lee, H. (2016). “Learning what and where to draw(отваря се в нов прозорец)”. In NIPS 2016.
- 3
Zhang, H., Xu, T., Li, H., Zhang, S., Wang, X., Huang X., Metaxas, D. (2016). “StackGAN: Text to photo-realistic image synthesis with stacked generative adversarial networks(отваря се в нов прозорец)”. In ICCY 2017.
- 4
Zhang, H., Xu, T., Li, H., Zhang, S., Wang, X., Huang, X., Metaxas, D. (2017). “StackGAN++: realistic image synthesis with stacked generative adversarial networks(отваря се в нов прозорец)”. In IEEE TPAMI 2018.
- 5
Xu, T., Zhang, P., Huang, Q., Zhang, H., Gan, Z., Huang, X., He, X. (2017). “AttnGAN: Fine-grained text to image generation with attentional generative adversarial networks(отваря се в нов прозорец).
- 6
Li, W., Zhang, P., Zhang, L., Huang, Q., He, X., Lyu, S., Gao, J. (2019). “Object-driven text-to-image synthesis via adversarial training(отваря се в нов прозорец)”. In CVPR 2019.
- 7
Koh, J. Y., Baldridge, J., Lee, H., Yang, Y. (2020). “Text-to-image generation grounded by fine-grained user attention(отваря се в нов прозорец)”. In WACV 2021.
- 8
Nguyen, A., Clune, J., Bengio, Y., Dosovitskiy, A., Yosinski, J. (2016). “Plug & play generative networks: conditional iterative generation of images in latent space(отваря се в нов прозорец).
- 9
Cho, J., Lu, J., Schwen, D., Hajishirzi, H., Kembhavi, A. (2020). “X-LXMERT: Paint, caption, and answer questions with multi-modal transformers(отваря се в нов прозорец)”. EMNLP 2020.
- 10
Kingma, Diederik P., and Max Welling. “Auto-encoding variational bayes(отваря се в нов прозорец).” arXiv preprint (2013).
- 11
Rezende, Danilo Jimenez, Shakir Mohamed, and Daan Wierstra. “Stochastic backpropagation and approximate inference in deep generative models(отваря се в нов прозорец).” arXiv preprint (2014).
- 12
Jang, E., Gu, S., Poole, B. (2016). “Categorical reparametrization with Gumbel-softmax(отваря се в нов прозорец)”.
- 13
Maddison, C., Mnih, A., Teh, Y. W. (2016). “The Concrete distribution: a continuous relaxation of discrete random variables(отваря се в нов прозорец)”.
- 14
van den Oord, A., Vinyals, O., Kavukcuoglu, K. (2017). “Neural discrete representation learning(отваря се в нов прозорец)”.
- 15
Razavi, A., van der Oord, A., Vinyals, O. (2019). “Generating diverse high-fidelity images with VQ-VAE-2(отваря се в нов прозорец)”.
- 16
Andreas, J., Klein, D., Levine, S. (2017). “Learning with Latent Language(отваря се в нов прозорец)”.
- 17
- 18
- 19
Gayler, R. (1998). “Multiplicative binding, representation operators & analogy(отваря се в нов прозорец)”.
- 20
Kanerva, P. (1997). “Fully distributed representations(отваря се в нов прозорец)”.