科學資料很少會附帶使用說明。研究人員必須判斷某個模式反映的是生物學現象還是雜訊、資料是否足以支撐所提出的問題,以及每項結果應如何改變下一步行動。AI 智慧體越來越能執行複雜分析,但真實的科學研究不只是回想事實或遵循預先定義的工作流程,也仰賴這些更高層次的判斷。
今天,我們推出 GeneBench-Pro——一項具挑戰性的研究級基準測試,用來測試模型是否能處理真實世界計算生物學所需、仰賴大量判斷的分析。它在 GeneBench(在新視窗中開啟) 的基礎上擴展,涵蓋基因體學、定量生物學與轉譯醫學中更困難也更貼近現實的任務,捕捉計算生物學科學研究的複雜性、迭代性與模糊性。
到目前為止,針對讓真實世界計算研究變得困難的系統層級判斷,仍少有令人信服的評估。這些判斷包括處理模糊性、修正假設、選擇正確的分析路徑,以及知道何時結果已足以支撐決策。由於這些技能難以形式化,即使它們的弱點日益限制 AI 的整體表現,也同樣難以嚴謹評估。
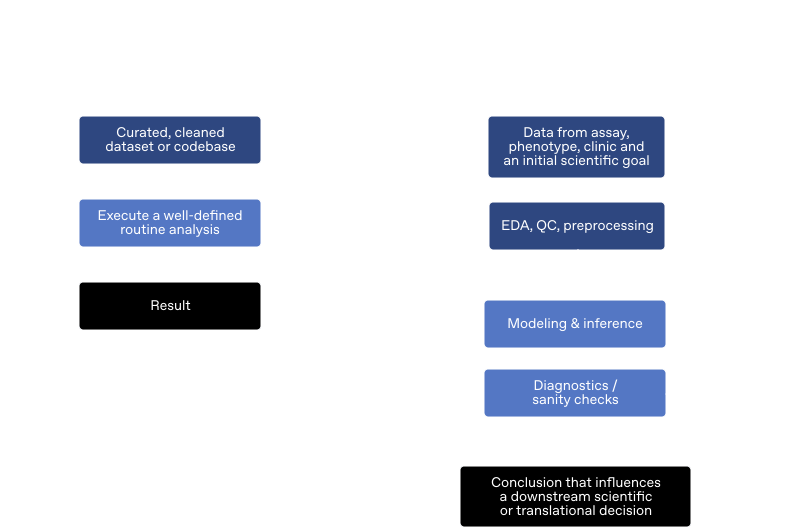
GeneBench-Pro 旨在精確衡量這些更高層次的能力。在 GeneBench-Pro 中,我們將「研究品味」定義為塑造分析的一連串判斷:資料能支持哪些問題、早期診斷應如何改變模型或估計目標,以及何時需要修訂初始計劃。每個 GeneBench-Pro 問題都會提供模型一個真實且雜亂的資料集、簡短的實驗背景,以及與下游決策相關的目標估計量。為了正確作答,模型必須探索資料、選擇適當的分析方法、進行迭代式實驗流程,並給出最終答案。
在生物學中,產生資料的成本(例如基因組定序)已大幅下降,且有些研究人員現在主張(在新視窗中開啟),限制因素不再是樣本收集,而是下游計算與分析。GeneBench-Pro 旨在評估處理這項瓶頸的進展,包含 129 個問題,涵蓋廣泛的計算生物學情境與方法。
網域圖譜:129 個問題分布於 10 個網域及 21 個子網域
點選上方的圓點以了解基準問題。
這份圖集提供了 GeneBench-Pro 廣度的概覽。前往案例研究頁面,更深入探索 10 個代表性問題。
GeneBench-Pro 也被設計來避免常見的基準測試失效。許多長時程生物學基準測試,會圍繞雜亂的歷史資料集建構多步驟問題,而這類分析可能沒有唯一正確的路徑。一個智慧體可能選擇某個可辯護的截斷值,另一個則選擇不同但同樣可辯護的選項,這反映的可能更多是基準測試建立者的任意選擇,而非模型表現的根本差異。相反的情況也可能發生:如果問題對數值太不敏感,智慧體即使在分析中犯下根本性錯誤,仍可能產生通過的結果。
為了避免這些失效模式,每個 GeneBench-Pro 問題都以合成方式建立:我們知道完整的因果結構,並直接模擬資料生成過程。這讓我們能調整每個問題的複雜度,確保主觀分析選擇上的合理差異仍會產生可接受的數值結果,並透過消融研究驗證看似合理但錯誤的分析會失敗。接著,我們透過詳細的軌跡分析審核問題草稿,以檢查資訊洩漏與非預期的解題路徑。這讓我們有信心,答對取決於選擇正確的分析路徑,而不是利用捷徑或迎合作者的任意偏好。

我們將 129 個 GeneBench-Pro 問題中的 82 個送交外部領域專家,包括研究生、博士後研究員、產業科學家與教授。審閱者評估每個問題的真實性、目標答案是否可識別,以及方法與估計器是否適當。回饋被用來改進問題。
“我審閱的問題,如果沒有經驗豐富的指導者反覆提供回饋,對研究生來說會是相當具挑戰性的任務。資料中包含技術與品質控制問題,需要在了解潛在陷阱的情況下,進行深思熟慮且反覆檢視的資料分析,才能成功完成;這並不是把某個現成方法套用到乾淨且整理完善的資料上而已。”
“即使目前的模型還無法可靠地從頭到尾獨立執行分析,在 GeneBench-Pro 問題上表現良好的模型,顯然能協助研究人員判斷正確工作流程並探索資料。我可以想見,這會大幅提升研究的速度、完整性與可重現性。”
每個 GeneBench-Pro 問題都是一項自成一體的科學分析。智慧體可使用一個隔離的工作區,其中包含簡短提示詞、資料檔案,以及標準生物資訊堆疊,包括 Python、科學計算函式庫,以及 PLINK 2.0 等基本基因體學套件(雖然這些問題不需要特定領域工具)。
由於我們控制完整的資料生成過程,因此可以根據已知目標以確定性方式評分正確性,避免標準依評分規準評估中常見的模型選擇變異與冗長效應。
每個問題也附有豐富的中繼資料,包括預期分析結構、附加資料檔案、詳細的多頁案例研究,以及專家審閱結果。我們在 Hugging Face(在新視窗中開啟) 上完整開源 10 個代表性 GeneBench-Pro 問題,並提供互動式網頁介面供瀏覽。最後,我們近期將向 Artificial Analysis(在新視窗中開啟) 提供一個包含 50 題的子集,用於獨立第三方基準測試。
我們最強的模型 GPT‑5.6 Sol,在最高推理層級下達到 28.7% 的通過率(啟用 Pro 模式時為 31.5%)。這比我們開始建立原始 GeneBench 時大幅提升;當時我們最好的前沿模型 GPT‑5 得分低於 5%。這項基準測試上的進展顯示,前沿模型正快速改進,即使是在較難具體衡量的系統層級科學推理上也是如此。依照目前速度,這項基準測試可能在年底前達到飽和。
結果也顯示了擴展測試時計算的影響。在最低推理層級下,GPT‑5.6 Sol 的通過率只有個位數。在最高推理層級下,GPT‑5.6 Sol 解出的問題數幾乎是 GPT‑5.2 的六倍,同時使用的 Token 約少三分之一。
跨模型家族比較顯示,在定量不確定性下進行高層次科學推理時,GPT 模型屬於最強的系統之一。GPT‑5.6、GPT‑5.5 與 GLM 5.2 等領先開源模型之間的表現差距,明顯大於我們從程式設計基準測試(在新視窗中開啟)外推時的預期,這表示開源模型更專精於程式設計,而非更廣泛的推理能力。
在開發過程中,我們使用前沿 GPT 模型來評估並強化問題。因此,我們曾懷疑 GeneBench-Pro 相較於其他模型家族,可能會對 GPT 模型不利。然而,競爭模型充其量只能追平相應 GPT 模型在發布時的表現,而且往往明顯落後。
考量 GeneBench-Pro 問題的難度,這些評估結果——GPT‑5.6 Sol(Pro)最高達 31.5%——相當引人注目。在一項調查中,審閱者估計,一個典型的 GeneBench-Pro 問題需要人類專家約 20–40 小時才能完成。若以每小時 200 美元的保守估算,單一問題的人力成本就會達到數千美元。目前的 AI 智慧體仍然不夠可靠,無法取代人類專家,但成本差距很大,每個問題的推論成本只有數美元。這表示,即使以目前能力進行部分自動化,也可能創造有意義的經濟與科學價值。
“這些基準測試的出發點涵蓋各式各樣的生物學問題,但真正的挑戰來自探索性資料分析,以及基於這些發現進行推理:辨識模式與假象,並判斷資料應該排除還是調整。這很像真實生物資料集的雜亂本質。審閱這些評估後,更凸顯了清楚的求解器契約對於以智慧體為基礎的科學問題解決有多重要。不同的提示詞措辭或任務規格,會大幅影響哪些分析看起來是被允許的。”
“我大致上喜歡[這些問題]。這些題目通常通時包含:(1)對主題的必要知識,例如古 DNA 中的 C>T 偏差;(2)資料不一致,例如祖源對調;(3)知道這項工作適合哪些分析工具,以及如何實作。看起來多數智慧體都在(2)上失敗了。它們對資料問題不夠謹慎。這也許凸顯了目前模型的一項弱點。而且許多生物資料都有不規則之處。”
不過,前沿模型仍解不出三分之二以上的問題,顯示仍有很大的改進空間。模型能在具挑戰性的問題上取得部分進展,但難以完成推論閉環。這種失敗模式反映了人類專家與新手之間的差異。專家會運用經驗來界定問題並調整方法;新手則能做出觀察,卻難以將其整合到問題的更大脈絡中。
要達到近乎完美的表現,需要既能可靠衡量進展、又能找出模型仍在哪裡失敗的評估。像 GeneBench-Pro 這樣的基準測試,可以幫助把模糊的能力缺口轉化為可診斷、可改進的問題。
如果智慧體能可靠地自動化這類分析,就可能大幅加速科學發現。人類遺傳證據已經是標的優先排序與轉譯後續追蹤的核心,因為有遺傳支持的機制更有可能帶來獲准治療。
同時,定序成本已大幅下降,而生物銀行規模的資料集如今以前所未有的廣度,連結分子、表型與健康紀錄資訊。限制因素正從資料生成,轉向如何把資訊轉化為可行洞見。若模型能穩定執行目前由人類專家團隊處理的分析,就可能透過加速假設篩選、標的追蹤,以及資料生成與決策之間的迭代週期,改變產業研究。
GeneBench-Pro 是一項初步努力,旨在評估資深研究者在良好科學判斷中所具備的更抽象技能。這些技能讓他們能直覺掌握並找出最有前景的初步分析,在資料與初始假設相牴觸時迭代並修正思考,並得出下游臨床、學術或商業決策可能仰賴的結論。
我們預期,隨著模型能力進步,能探測模型在這些更高抽象層次能力的基準測試,將會越來越有用,超越那些只測試書本知識或執行例行分析能力的測試。


