OpenAI سے ایمپلی ٹیوڈ کی مصنوعات میں بہتری، صرف 1–2 دن میں
بنیادی طور پر OpenAI ماڈلز پر مبنی ایمپلی ٹیوڈ کا خود پہل کرنے والا پروڈکٹ ایجنٹ، ویو، طے کرتا ہے کہ کیا بنانا ہے، کوڈنگ ایجنٹس کے ذریعے تبدیلیاں نافذ کرانے میں ٹیموں کی مدد کرتا ہے اور اثرات ناپتا ہے.
160%
ایک دن بعد کنٹرول گروپ کے مقابلے میں ایجنٹ کے ساتھ تعامل میں اضافہ
1–2 دن
ویو کی مدد سے پروڈکٹ میں بہتری متعارف کرانے کا تخمینی وقت
51%
ایمپلی ٹیوڈ کی ڈیٹا سائنس ایجنٹ کی جانچ میں GPT‑6.1 Sol کے لیے فی تفویض ماڈل کی اوسط لاگت میں کمی.
$1.34
ایمپلی ٹیوڈ کی مواقع کے محقق کی جانچ میں GPT‑6.1 Sol کی ماڈل لاگت.
ایمپلی ٹیوڈ ہمیشہ سے ٹیموں کو یہ سمجھنے میں مدد دیتا آیا ہے کہ لوگ ان کی مصنوعات کو حقیقت میں کیسے استعمال کرتے ہیں. اس کا خود پہل کرنے والا پروڈکٹ ایجنٹ، ویو، ٹیموں کو ان بصیرتوں کی بنیاد پر بہتریاں متعارف کرانے میں مدد دیتا ہے. ایمپلی ٹیوڈ کے مطابق ویو تقریباً 80% تک OpenAI کے ماڈلز پر چلتا ہے، جن میں GPT‑6.1 Sol، GPT‑6 Luna اور GPT‑Image‑2.5 Flare شامل ہیں. ویو پروڈکٹ سے حاصل ہونے والی بصیرتوں کو عملی منصوبوں میں ڈھالتا ہے، جنہیں ٹیمیں Codex سمیت کوڈنگ ایجنٹس کو بھیج سکتی ہیں، اور پھر ان کے اثرات کی پیمائش کرتا ہے.
ایمپلی ٹیوڈ کا تخمینہ ہے کہ ویو کی مدد سے ٹیمیں پروڈکٹ میں بہتری متعارف کرانے کا وقت تقریباً ایک مہینے سے گھٹا کر 1–2 دن کر سکتی ہیں. ایمپلی ٹیوڈ کے اپنے ابتدائی صفحے پر ویو نے تجاویز کے کارڈز کو ذاتی نوعیت کا بنانے میں مدد دی، جس سے کارڈز کے ذریعے بھیجے گئے پیغامات میں 160% اضافہ ہوا.
”AI اب ایسے مفید کام تلاش کر سکتی ہے جو ہم نے کبھی اسے سونپنے کا سوچا بھی نہیں تھا. OpenAI کے ماڈلز کسی مسئلے کی تحقیق کر سکتے ہیں، کوڈ لکھ کر چلا سکتے ہیں اور نتائج کی بنیاد پر طے کر سکتے ہیں کہ آگے کیا آزمایا جائے.“
ویو، ایمپلی ٹیوڈ کا خود پہل کرنے والا پروڈکٹ ایجنٹ ہے. ٹیمیں اسے پروڈکٹ کا کوئی شعبہ بتاتی ہیں، ساتھ ہی وہ اہداف اور پیمانے بھی جن میں وہ بہتری چاہتی ہیں. ویو، ایمپلی ٹیوڈ کے ڈیٹا، سیشن ریکارڈنگز، صارفین کی آرا اور کوڈ کو یکجا کرتا ہے تاکہ مواقع کی نشاندہی اور ترجیح بندی کرے، حل تیار کرے اور لوگوں اور کوڈنگ ایجنٹس کے ساتھ عمل درآمد میں ہم آہنگی پیدا کرے. پھر یہ نتائج پر نظر رکھتا ہے اور ان سے حاصل ہونے والی معلومات کو اگلے مرحلے کی بہتریوں کی بنیاد بناتا ہے.
اس طریقۂ کار کے پس پردہ، ایمپلی ٹیوڈ مختلف کاموں کے لیے OpenAI کے مختلف ماڈلز استعمال کرتا ہے. GPT‑6.1 Sol مواقع کے منتظم کو معاونت دیتا ہے اور کوڈ اور ڈیٹا کی گہری تحقیق میں مدد کرتا ہے. GPT‑6 Luna بار بار انجام دیے جانے والے کم لاگت کام سنبھالتا ہے، جیسے کوڈ کا معائنہ اور چھوٹی جانچیں کرنا. GPT‑Image‑2.5 Flare سیشن ریکارڈنگز کے اسکرین شاٹس کو بصری حوالوں کے طور پر استعمال کرتے ہوئے پروڈکٹ کے نمونہ ڈیزائن بناتا ہے.
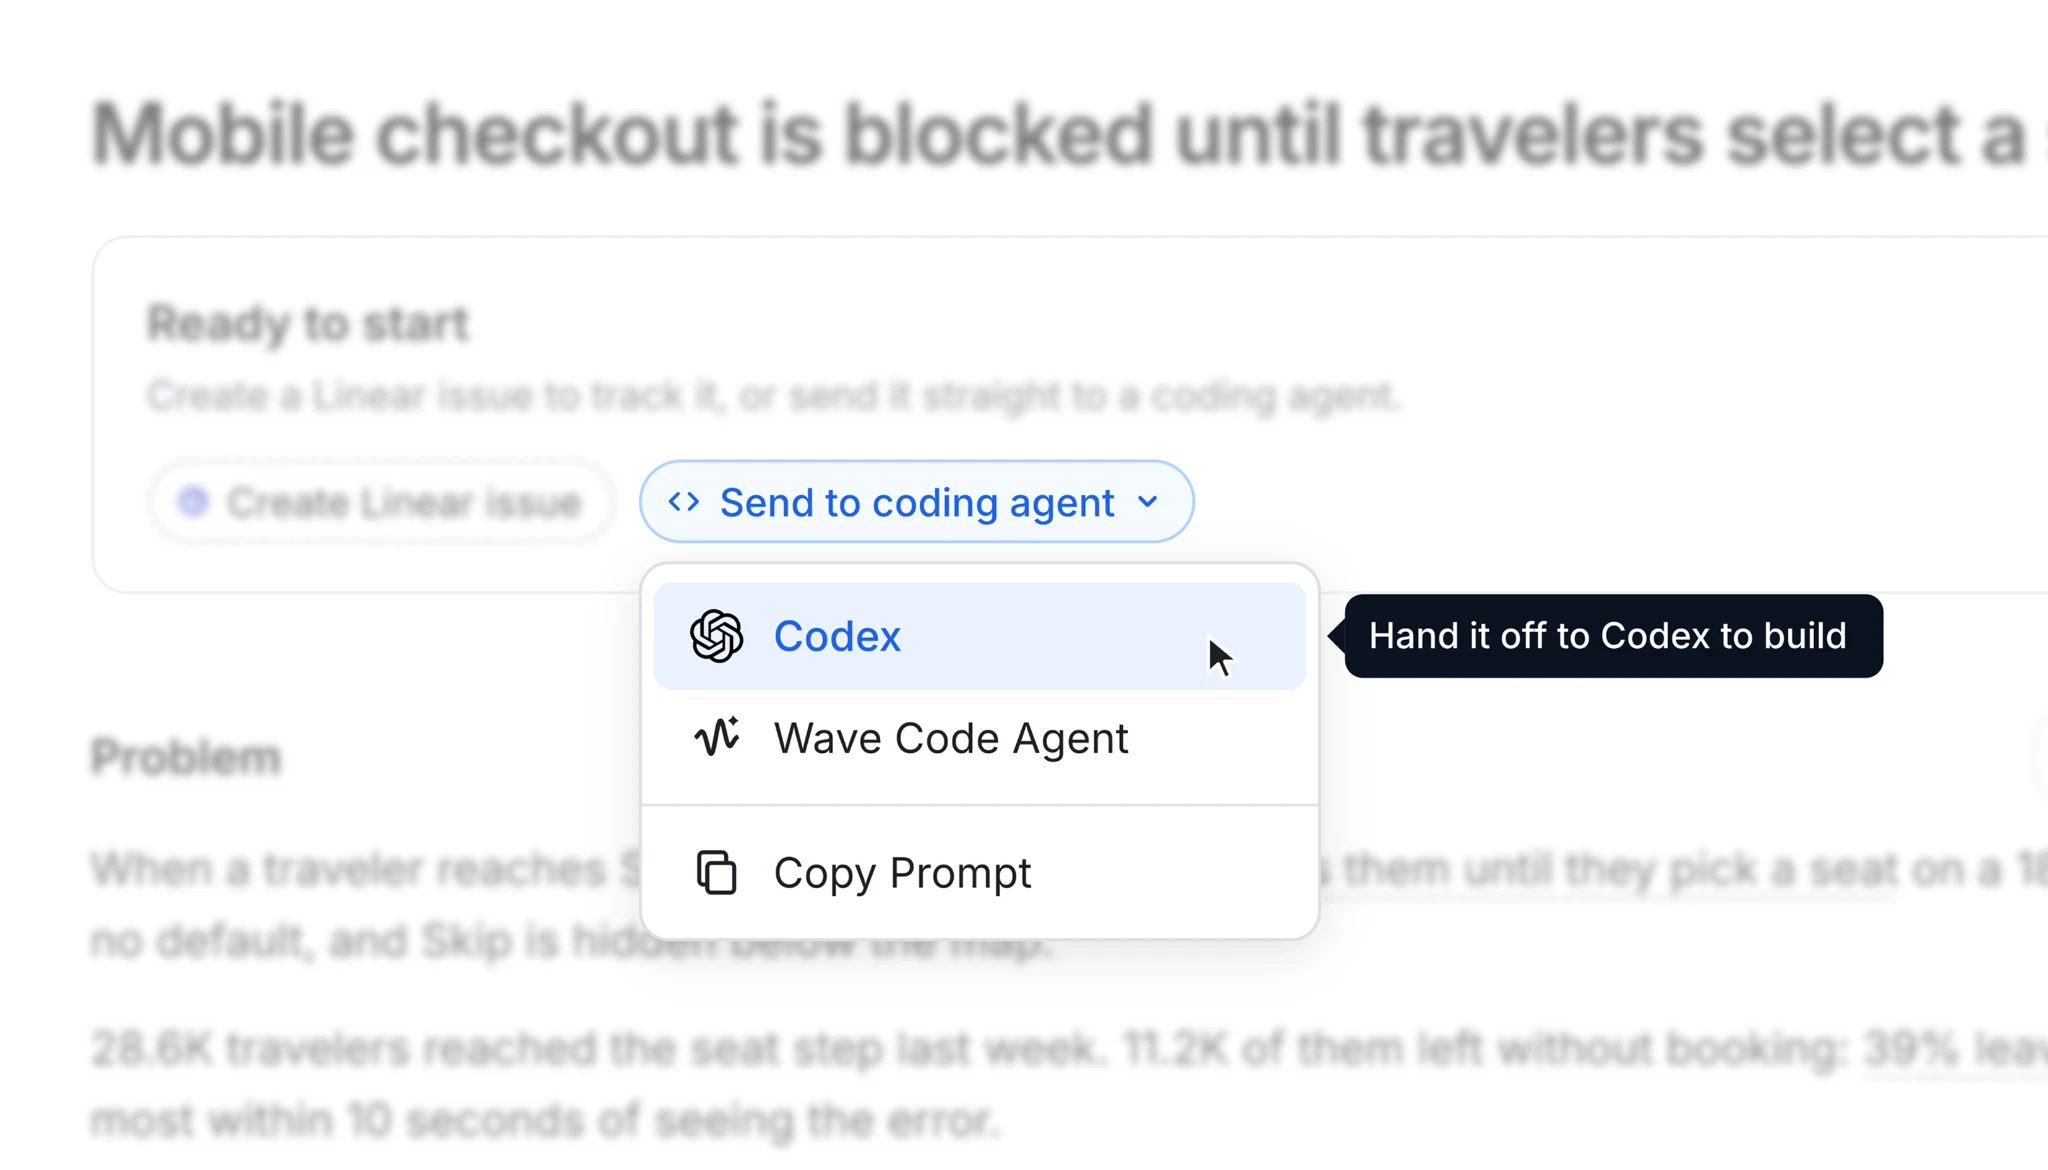
جب کسی موقع پر کام شروع کرنے کی تیاری مکمل ہو جائے تو ٹیمیں اسے ویو سے براہ راست Codex سمیت کوڈنگ ایجنٹس کو بھیج سکتی ہیں، ساتھ میں تکنیکی منصوبہ اور قبولیت کے معیارات بھی ہوتے ہیں جو عمل درآمد میں رہنمائی کرتے ہیں.
ایمپلی ٹیوڈ میں پرنسپل AI پروڈکٹ مینیجر جیکب نیومین بتاتے ہیں: ”ویو کا تصور یہ ہے کہ آپ کے پاس ایک متحد پلیٹ فارم ہو، جس کے ایجنٹس بڑی تعداد میں سیشن ریکارڈنگز، تجزیاتی معلومات اور کوڈ کو کھنگال کر مصنوعات میں بہتری کے مواقع تلاش کریں.“
ایمپلی ٹیوڈ نے ویو کو اپنے ابتدائی صفحے پر آزمایا، جہاں عمومی تجاویز کے کارڈز کا مقصد صارفین کو AI ایجنٹ سے گفتگو شروع کرنے میں مدد دینا تھا. ویو کو معلوم ہوا کہ لوگ اکثر انہیں نظر انداز کرتے تھے: 100 سیشن ریکارڈنگز کے ایک نمونے میں، 80 صارفین نے اپنے سوالات خود لکھے اور صرف 12 نے کوئی تجویز منتخب کی.
ویو نے تجویز پیش کی کہ حالیہ چارٹس، ڈیش بورڈز یا اس صفحے کی بنیاد پر کارڈز کو ذاتی نوعیت کا بنایا جائے جہاں سے صارف آیا تھا. اس نے تبدیلی کا بصری نمونہ اور ایک تکنیکی منصوبہ تیار کیا، جس میں خود سوال لکھنے کی آزادی برقرار رکھنا اور ذاتی نوعیت کی تجاویز کے لیے سیاق دستیاب نہ ہونے پر عمومی تجاویز دکھانا شامل تھا. ایک مختصر جائزے کے بعد ٹیم نے کام ایک کوڈنگ ایجنٹ کے سپرد کیا اور تبدیلی کی A/B جانچ کی.
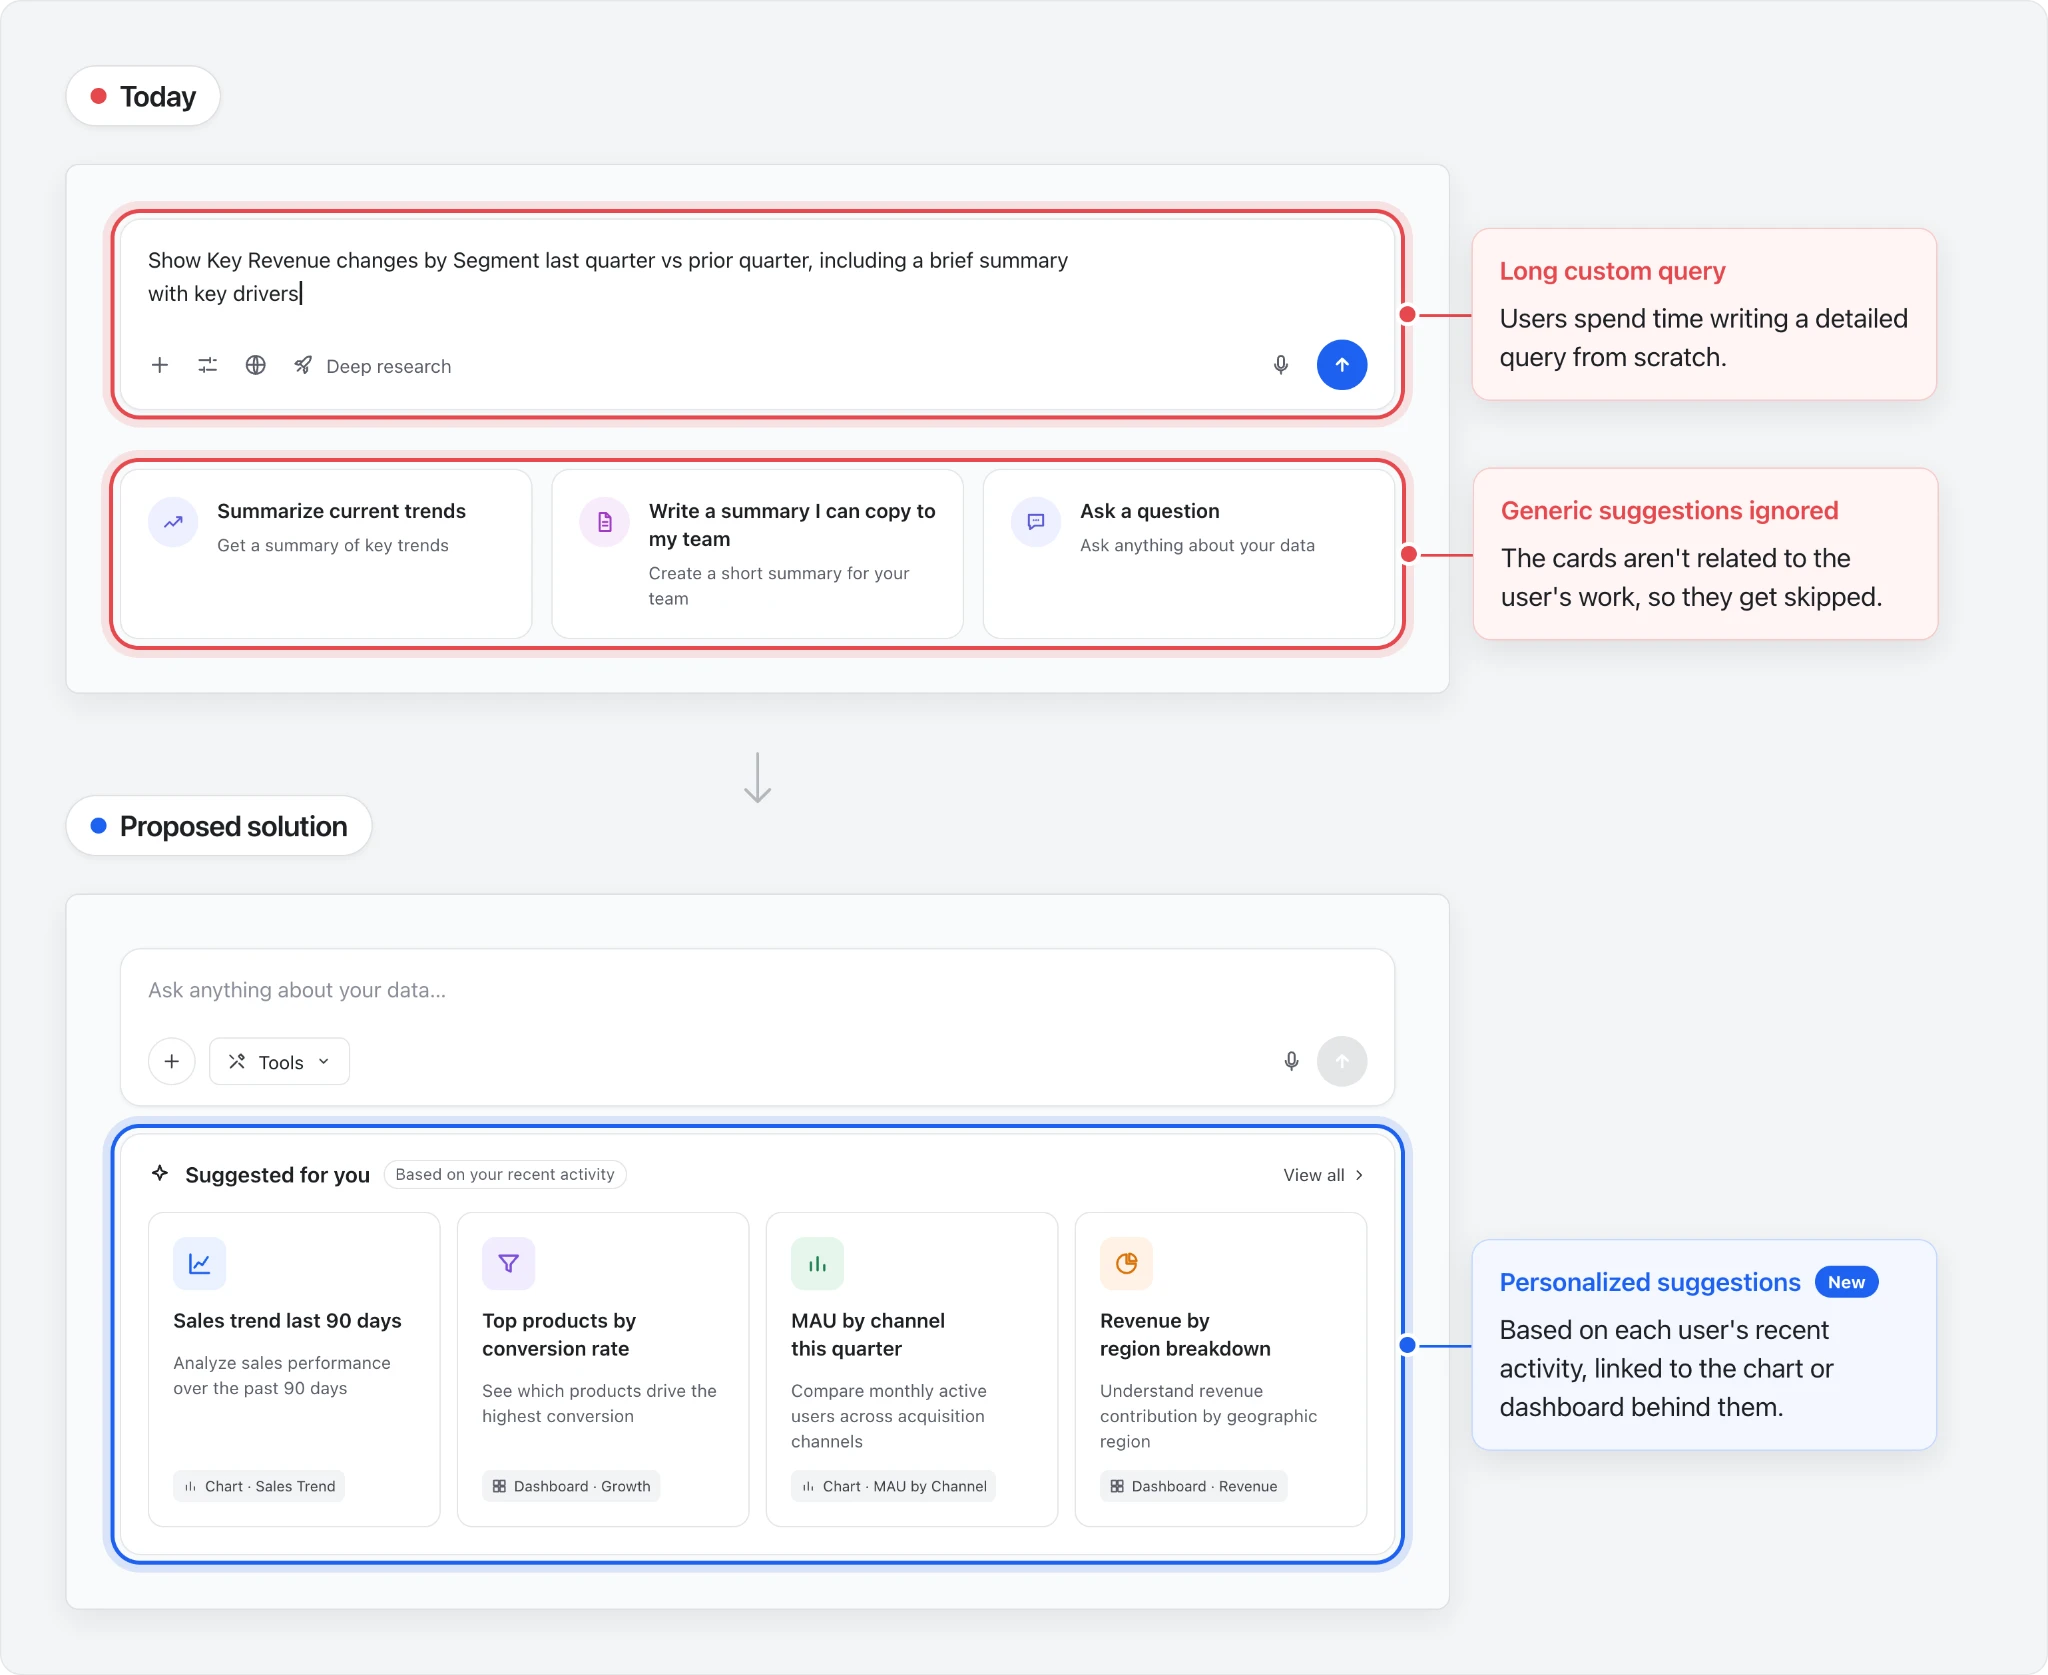
ایمپلی ٹیوڈ کے شیئر کردہ تجرباتی نتائج کے مطابق، ایک دن بعد ابتدائی صفحے کے تجویز کارڈز کے ذریعے بھیجے گئے پیغامات میں کنٹرول گروپ کے مقابلے میں 160% اضافہ ہوا. ایمپلی ٹیوڈ کے سینیئر پرنسپل AI انجینئر ایرک کارلسن بتاتے ہیں: ”یہ اس بات کی عمدہ مثال ہے کہ ایسی معمولی چیزیں، جنہیں بس نظر انداز کر دیا جاتا ہے، خصوصیات کے استعمال میں غیر متوقع اضافہ کر سکتی ہیں.“
ویو کے مختلف کام اس کے ماڈلز سے مختلف صلاحیتوں کا تقاضا کرتے ہیں. گہری تحقیق کے لیے مضبوط ریزننگ اور ٹھوس شواہد پر مبنی نتائج درکار ہوتے ہیں. سینکڑوں بار دہرائی جانے والی چھوٹی سی جانچ کو تیز رفتار اور کم خرچ ہونا چاہیے. ایمپلی ٹیوڈ ہر کام کے لیے معیار، جواب کے انتظار کے وقت اور لاگت کا جائزہ لیتا ہے، پھر اسی کے مطابق ماڈلز منتخب کرتا ہے.
”OpenAI نے ہمیں طاقتور ریزننگ ماڈلز کے ساتھ چھوٹے، تیز رفتار ماڈلز بھی دیے، جس سے ہم پوری پروڈکٹ میں معیار، جواب کے انتظار کے وقت اور ماڈل چلانے کی لاگت میں توازن رکھ سکے“
ویو کے مواقع کے محقق کے لیے ایمپلی ٹیوڈ نے جانچا کہ آیا ماڈلز نتائج کی تائید کے لیے مزید شواہد لاتے ہیں، غلط مثبت نتائج سے بچتے ہیں، جانچ کنندہ کی رائے شامل کرتے ہیں، ٹولز کی ناکامی کے بعد کام بحال کرتے ہیں اور دعووں کو شواہد کے مطابق رکھتے ہیں. GPT‑6.1 Sol نے مجموعی طور پر 5 میں سے 4.06 نمبر حاصل کیے، جبکہ تین متبادل ماڈلز کے نمبر 3.62، 3.52 اور 2.94 رہے. یہ تحقیق کے پانچوں معیارات میں آگے رہا اور اس کا درمیانی تحقیقی وقت بھی سب سے کم، یعنی 54 منٹ تھا.
ویو کے ڈیٹا سائنس ایجنٹ کی ایک الگ جانچ میں GPT‑6.1 Sol نے 100 میں سے 67.5 نمبر حاصل کیے، جبکہ ایک دوسرے سرکردہ ماڈل نے 69.3 نمبر حاصل کیے؛ فی تفویض ماڈل کی اوسط لاگت بالترتیب $1.28 اور $2.63 تھی. GPT‑6.1 Sol نے ٹول کے طے شدہ ضوابط کی پابندی، تخمینے اور غیر یقینی کیفیت، اور شواہد پر گراؤنڈنگ میں بھی زیادہ نمبر حاصل کیے.
کوڈ کا معائنہ کرنے اور چھوٹی جانچیں چلانے جیسے کثرت سے انجام پانے والے کاموں کے لیے ایمپلی ٹیوڈ GPT‑6 Luna استعمال کرتا ہے، تاکہ جواب کے انتظار کا وقت اور لاگت کم رہیں. ماہر ایجنٹس میں کام تقسیم کرنے سے ٹیم زیادہ مہنگی ریزننگ کو ان کاموں کے لیے مختص کر سکتی ہے جنہیں اس کی سب سے زیادہ ضرورت ہے.
خاکے اور نمونہ ڈیزائن بنانے کی جانچ میں OpenAI کے امیج جنریشن ماڈل نے حل کے خاکوں کے لیے 100 میں سے 80.3 نمبر حاصل کیے، جبکہ ایک دوسرے امیج جنریشن ماڈل کے نمبر 63.9 تھے. ایمپلی ٹیوڈ کی جانچ میں 15 مواقع پر ابلاغ کے معیار، اصل پروڈکٹ سے مطابقت، ہدایات کی پابندی، متن اور صارف انٹرفیس کی خواندگی، اور بصری یکسانیت کو پرکھا گیا.
مختلف صنعتوں کے صارفین پہلے ہی ویو کے بیٹا نسخے کو مصنوعات میں بہتری کے مواقع تلاش کرنے اور انہیں متعارف کرانے کے لیے استعمال کر رہے ہیں. ویو سیشن اور تجزیاتی ڈیٹا کا تجزیہ کرتا ہے، پھر مجوزہ حل، تکنیکی منصوبے اور قبولیت کے معیارات کے ساتھ سفارشات تیار کرتا ہے.
اس کے بعد ٹیمیں طے کر سکتی ہیں کہ عمل کس حد تک خودکار ہو. زیادہ تر ٹیمیں خرابیوں کی اصلاح کا کام سیدھا کوڈنگ ایجنٹس کو بھیج دیتی ہیں، جبکہ نئی خصوصیات اور بڑے، پرخطر منصوبوں کا انسانی جائزہ لیا جاتا ہے.
جو تبدیلیاں متعارف کرانے کے مرحلے تک پہنچتی ہیں، ان میں موقع کی دریافت سے عمل درآمد تک کا سفر مختصر ہو سکتا ہے: صارفین کے شروع کردہ تجربات، فلیگز اور رہنما مواد میں سے ہر چار میں ایک اسی دن فعال ہو گیا جس دن ویو نے موقع کی نشاندہی کی، نصف چار دن سے کم وقت میں اور ہر تین میں سے دو ایک ہفتے کے اندر فعال ہوئے.
فراہم کردہ سنگ میلوں کے درمیان قدروں کا تخمینہ لگایا گیا ہے؛ منحنی خط محض وضاحتی ہے، انفرادی مشاہدات نہیں.
اسکیٹس کہتے ہیں: ”OpenAI کے ساتھ ہمارا مقصد یہ ہے کہ کمپنیاں سافٹ ویئر بناتے وقت خود کو بہتر بنانے والی مصنوعات تیار کریں.“ جیسے جیسے OpenAI کے ماڈلز ریزننگ اور کوڈنگ میں بہتر ہوں گے، ٹیمیں تحقیق اور عمل درآمد کا زیادہ کام ایجنٹس کو سونپ سکیں گی، جس کے نتیجے میں بہتر مصنوعات صارفین تک زیادہ تیزی سے پہنچیں گی. ایمپلی ٹیوڈ یہ تبدیلی پہلے ہی دیکھ رہا ہے: جب ٹیم دوسری ترجیحات پر کام کرتی ہے تو ایجنٹس اس کی اپنی پروڈکٹ میں بہتری کے مواقع تلاش کرتے ہیں اور انہیں عملی شکل دینے میں مدد کرتے ہیں. ”میرے خیال میں ٹیمیں یہ دیکھ کر حیران ہوں گی کہ جب ان کا سافٹ ویئر پروڈکٹ کو بہتر بنانے میں ان کے شانہ بشانہ کام کرے تو وہ کتنا کچھ انجام دے سکتی ہیں.“