Terminal X і GPT‑6.1: 88,6% збігів з оцінками інвесторів
Eval Agent від Terminal X оцінює результати за 54 критеріями та з GPT‑6.1 Sol виявляє на 25% більше відхилень від інвестиційного мандата фонду.
25%
Вища частка виявлених відповідей агента, що виходять за межі інвестиційного мандата фонду, з GPT‑6.1 Sol порівняно з найближчою за результатами моделлю
2,4 млн $
Економія одного клієнта на комплексній перевірці та інвестиційних робочих процесах у річному обчисленні
+220 б. п.
Вища частка збігів оцінок агента з оцінками експертів-людей на GPT‑6.1 Sol порівняно з найближчою за результатами моделлю
30%
Нижча вартість запиту з GPT‑6.1 Sol порівняно з найближчою за результатами моделлю
Перевага інвестиційної компанії формується з кожною угодою, але знання й досвід, на яких ґрунтуються рішення, зазвичай зосереджені в головах кількох провідних інвесторів. Коли вони йдуть, компанія накопичує те, що Terminal X(відкривається у новому вікні) називає боргом пам’яті: документи можуть залишитися, але логіка рішень втрачається.
Операційна система Capital Memory від Terminal X покликана зменшити цей борг. Інженери компанії, які працюють безпосередньо у клієнтів, — колишні фахівці з фінансів та інвестицій у JPMorgan і Blackstone. Разом з інвестиційними командами клієнта вони проєктують агентну архітектуру й закладають інвестиційні підходи компанії в агентів, які належать самій компанії та працюють на її обладнанні або у власній хмарі.
Моделі OpenAI, зокрема GPT‑6.1 Sol і GPT‑6 Luna, забезпечують міркування цих агентів. А Eval Agent від Terminal X оцінює результати роботи агентів за стандартами компанії. GPT‑6.1 Sol допомогла Eval Agent виявити приблизно на 25% більше рекомендацій, що відхилялися від інвестиційного мандата фонду, і виконувала ті самі робочі процеси з приблизно на 30% нижчою вартістю запиту, ніж найближча за результатами модель.
«Здатність GPT-6.1 Sol до міркування в межах великого контексту та економне використання токенів дають нам змогу будувати процеси глибшого оцінювання. Завдяки цьому наші агенти оцінювання роблять інвестиційні судження вимірюваними й доступними для аудиту».
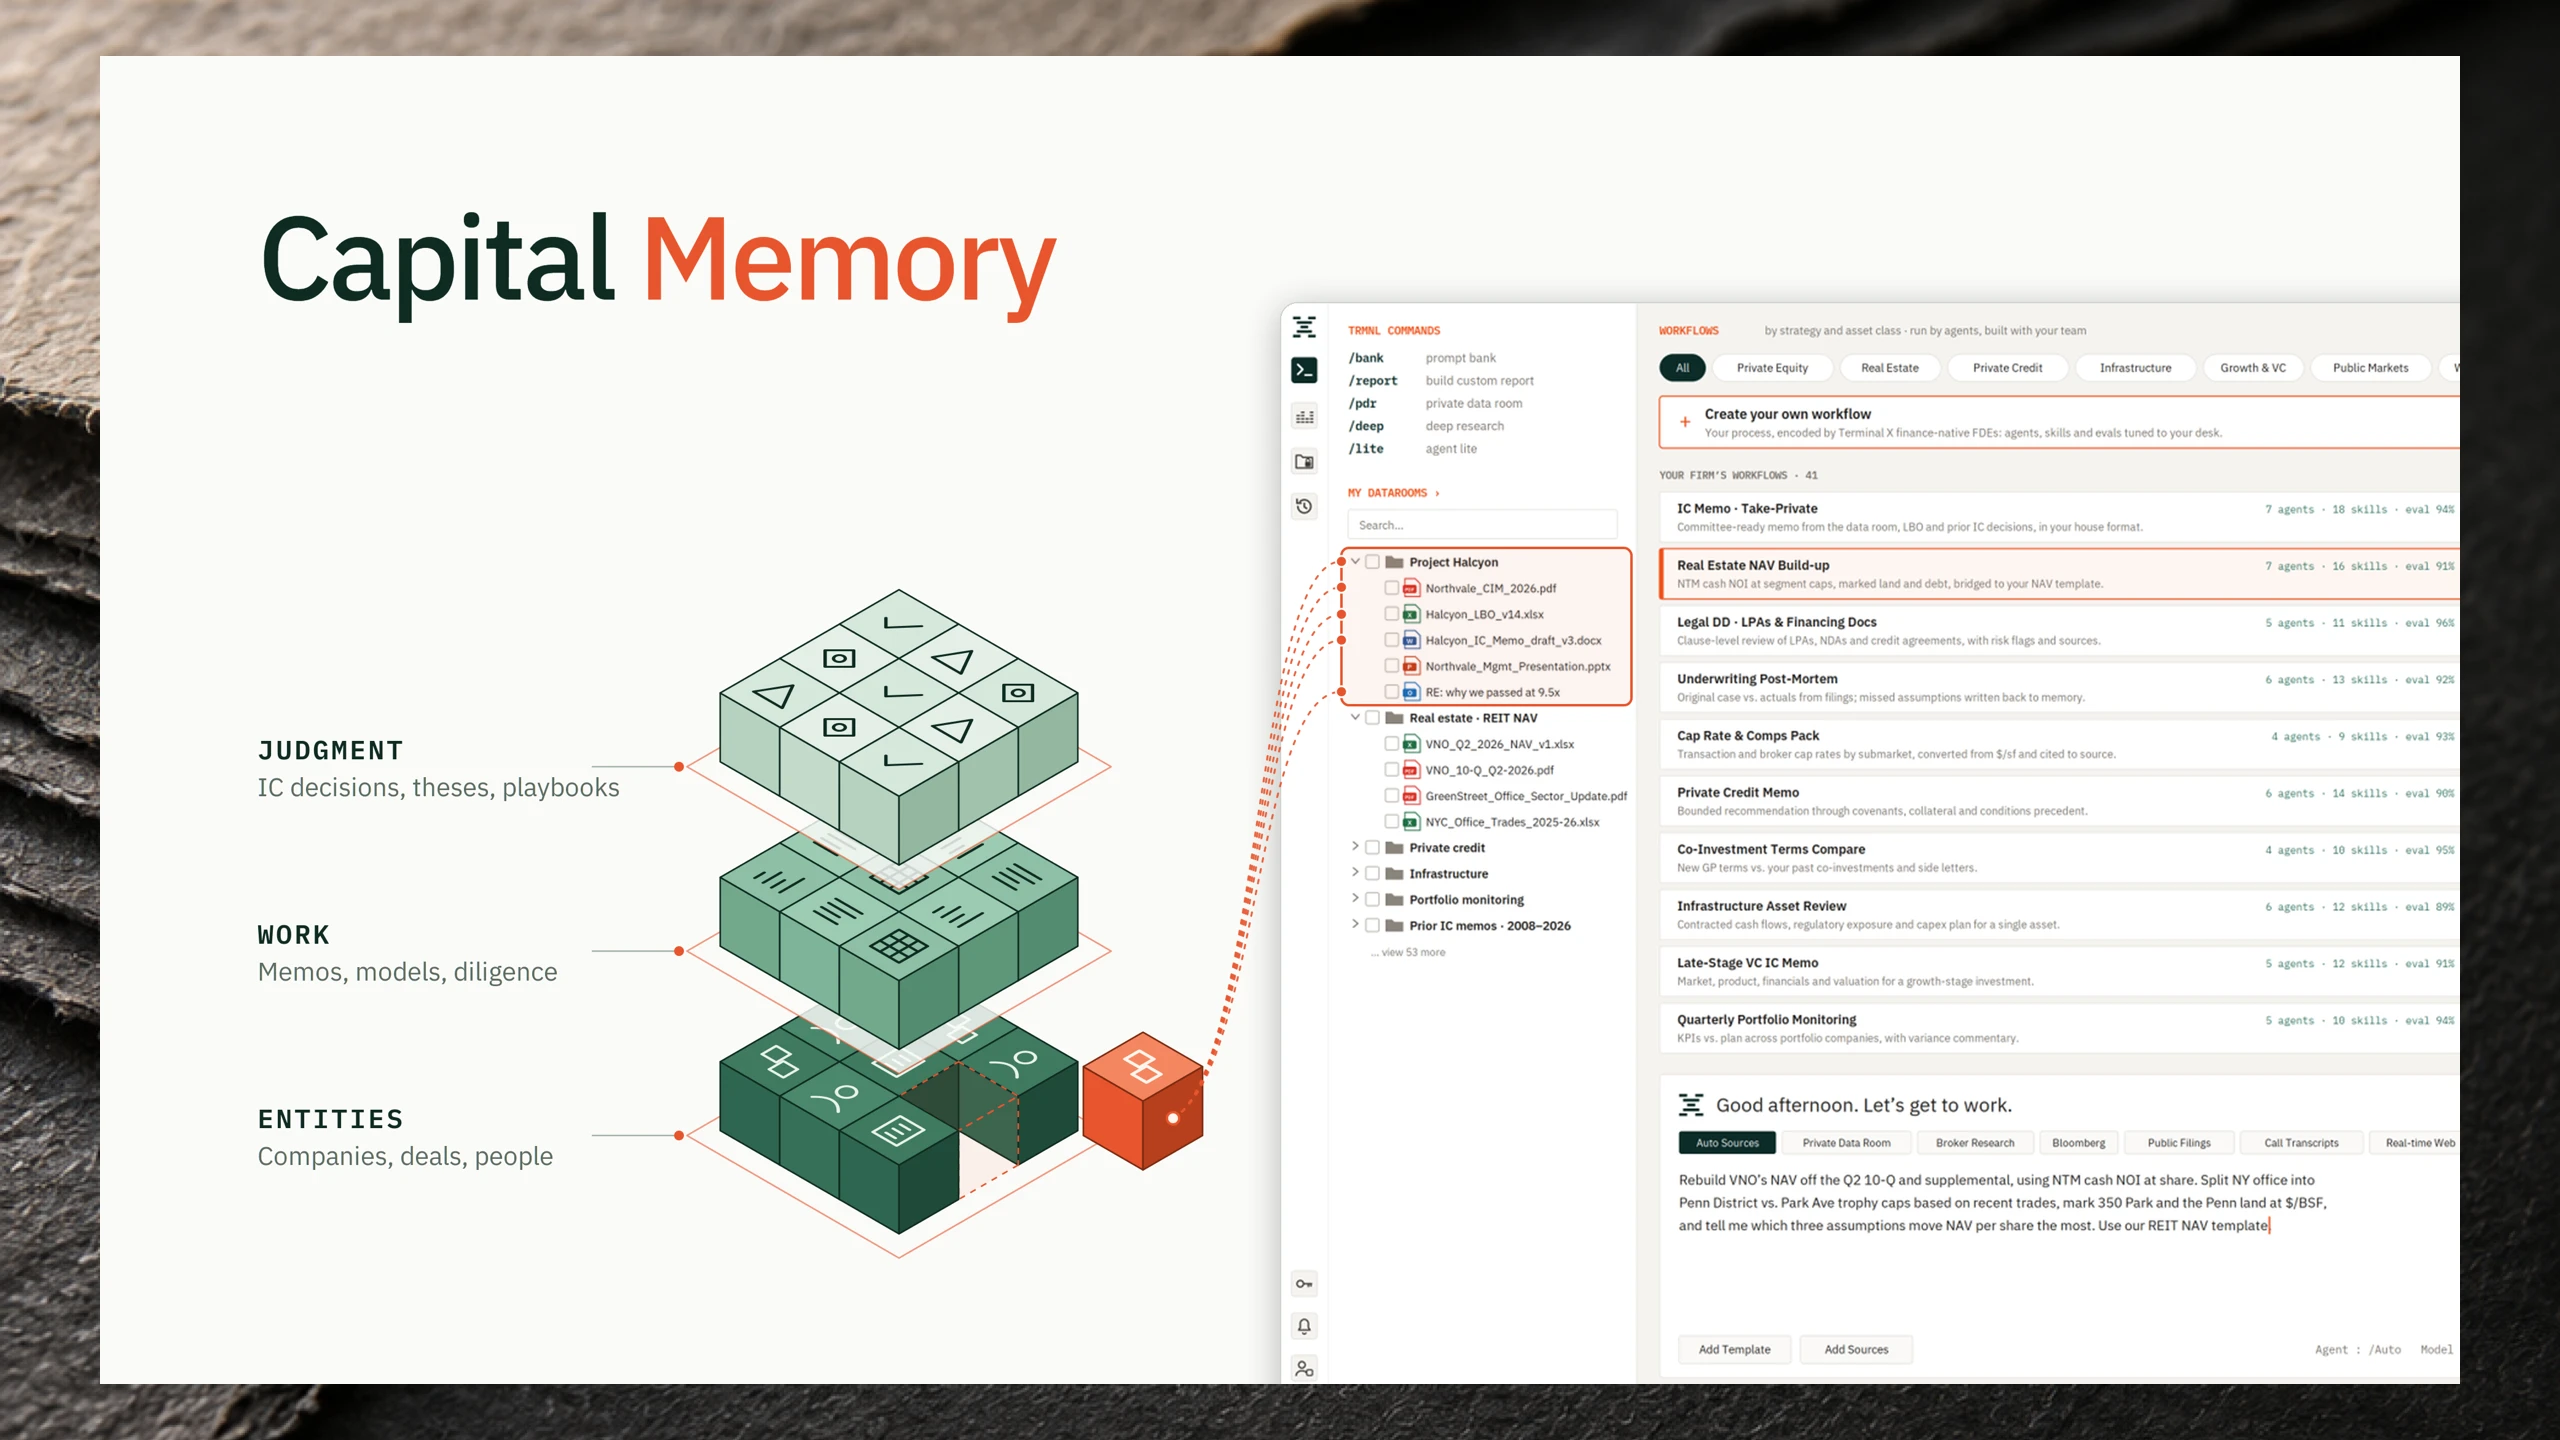
Для кожного клієнта Terminal X створює агентів, покликаних інвестувати так, як це роблять найкращі інвестори його компанії. Інженери Terminal X тижнями працюють в офісі клієнта: відтворюють логіку підготовки меморандумів, яким довіряє компанія, та фіксують процеси, які ніколи не документувалися. Наприклад, як кредитний підрозділ перевіряє позичальника або до яких джерел звертається команда спільного інвестування перед підготовкою меморандуму.
Далі ці процеси закладають у сотні агентів, налаштованих під класи активів і стратегії, із субагентами для кожного етапу інвестування. GPT‑6.1 Sol виконує етапи, які потребують зважених суджень і величезного ліміту контексту: формує інвестиційну тезу, визначає ключові чинники та оцінює відповідність інвестиційному мандату компанії. GPT‑6 Luna виконує масові операції, де економне використання токенів важливіше за глибину аналізу.
Агенти працюють у приватній кімнаті даних кожної компанії — спеціальному середовищі для обміну конфіденційними інвестиційними даними та керування ними. Агенти обробляють документи англійською, корейською, японською та китайською мовами й зберігають засвоєне як корпоративну пам’ять: запис з історією версій про те, як певний підрозділ ухвалює рішення певного типу. Він охоплює попередні аналізи, рішення комітету, інструкції для робочих процесів і позиції компанії.
Інженери перетворюють кожен запис пам’яті на відтворюваний робочий процес на платформі Terminal X. Там кожен запит у робочому середовищі можна перевірити за повною історією: виконаними кроками, отриманими джерелами, використаною моделлю та її міркуваннями.
За даними Terminal X, цей підхід дає клієнтам значну економію. Зокрема, одна компанія прямих інвестицій повідомила про заощадження в розмірі 2,4 млн доларів у річному обчисленні завдяки автоматизації комплексної перевірки та підготовки інвестиційних меморандумів.
Щоб перевіряти відповіді агентів на відповідність власним стандартам компанії, Terminal X створила Eval Agent. Це скоординований робочий процес на базі GPT‑6.1 Sol та інших моделей OpenAI, який аналізує кожну відповідь агента так, як віцепрезидент перевіряє роботу аналітика.
Eval Agent перевіряє кожен результат за 54 критеріями. Він з’ясовує: чи взято числові показники, дані про зіставні компанії, консенсус-прогнози й цитати з належних джерел? Чи переконлива аргументація? Чи узгоджується рекомендація з позицією компанії?
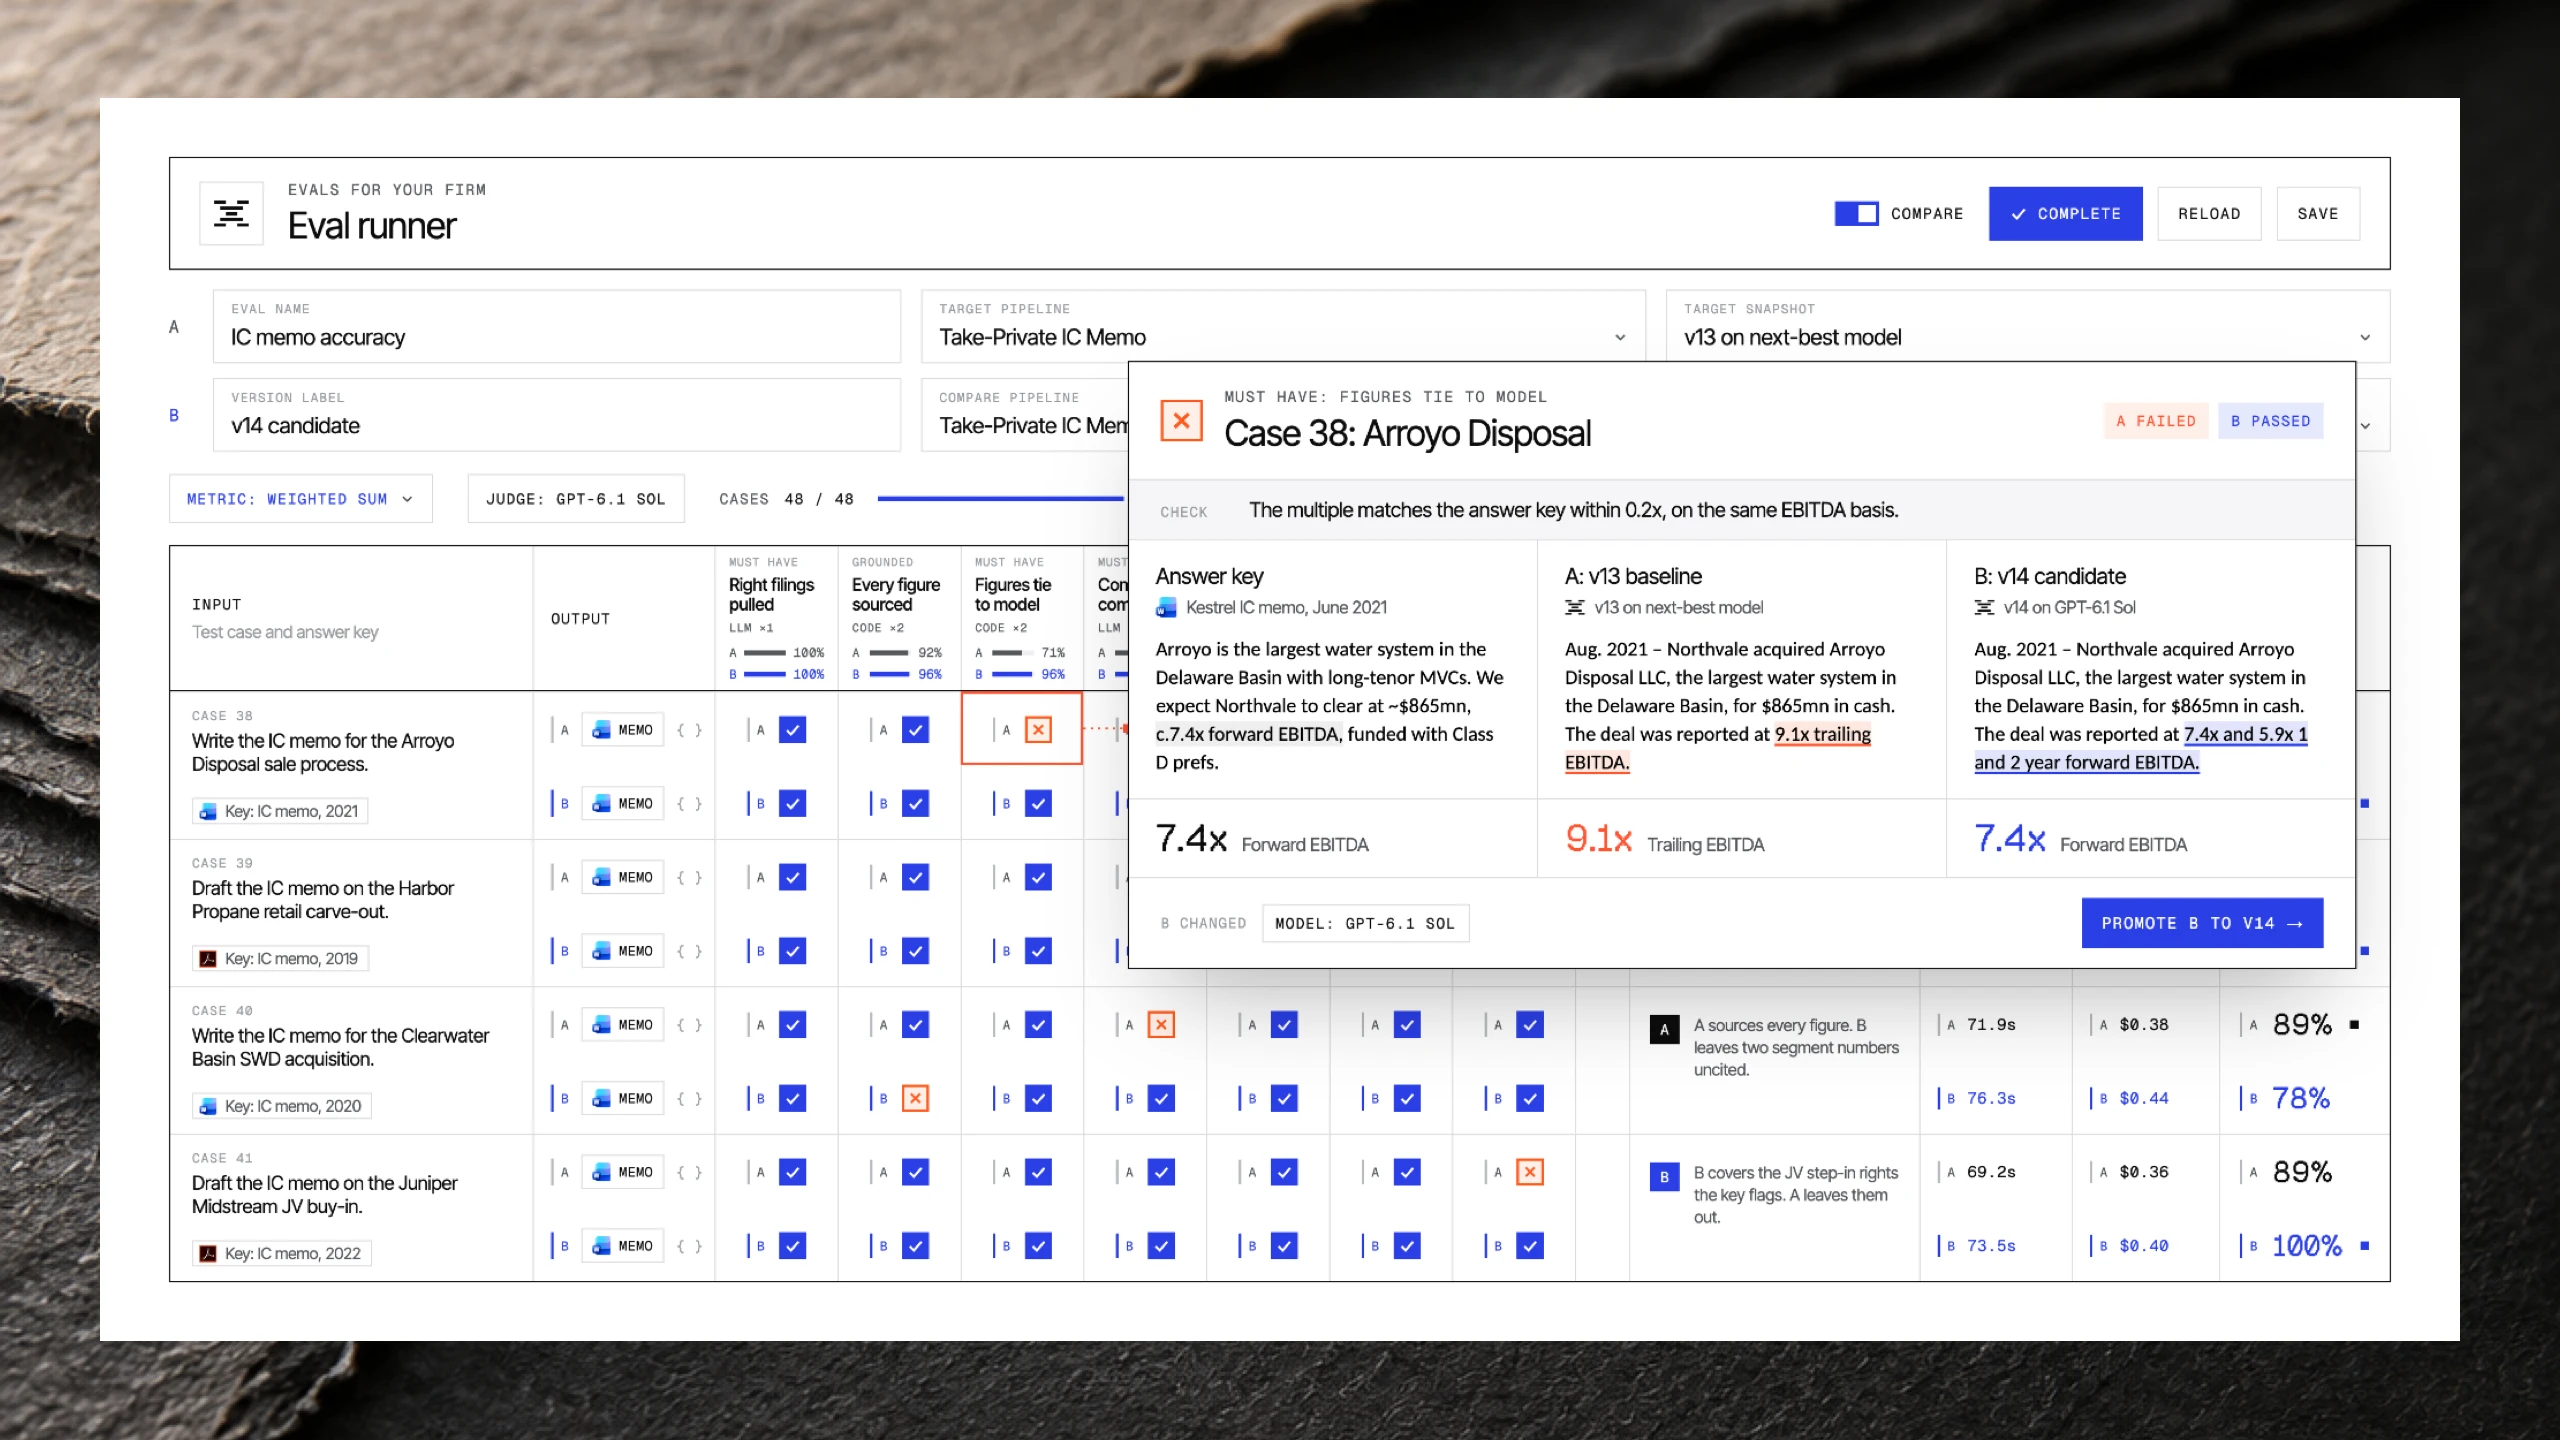
За кожним критерієм результат або проходить перевірку, або ні. Кожна невдала перевірка супроводжується поясненням в один рядок і кращим джерелом або виправленим текстом та стає записом пам’яті. Наприклад, пропущене джерело, хибно обраний об’єкт для порівняння або інвестиційна теза, що відхиляється від позиції компанії, стають новою інструкцією для робочого процесу чи тестовим випадком для відповідного підрозділу.
«Кожна відповідь проходить оцінювання, і кожне виправлення аналітика дає системі трохи більше знань про те, як працює ця компанія», — каже Кен Лі, співзасновник і технічний директор Terminal X. «Тож що довше компанія користується системою, то більше та мислить як її власна команда».
Terminal X обирає моделі за результатами власного оцінювання. Серед 500 перевірених оцінок висновки Eval Agent на базі GPT‑6.1 Sol збігалися з висновками досвідченого експерта у 88,6% випадків проти 86,4% у найближчої за результатами моделі — поліпшення на 220 базисних пунктів.
Один із типів помилок, які GPT‑6.1 Sol виявляла краще, — відхилення від інвестиційної стратегії. Наприклад, мандат фонду викупу компаній передбачає пошук публічних компаній для викупу й виведення з біржі, чиї акції торгуються з дисконтом до вартості чистих активів (NAV), оцінювання їхнього бізнесу та структурування фінансування. Коли сценарні моделі вказують на розворот ринку, у рекомендаціях щодо угод натомість з’являються інвестиції в проблемний борг або фінансування для порятунку компаній. Eval Agent на базі GPT‑6.1 Sol виявив приблизно на 25% більше таких відхилень, ніж найближча за результатами модель.
Економне використання токенів у GPT‑6.1 Sol під час роботи з великим контекстом дало Terminal X змогу побудувати процес глибшої перевірки в межах того самого бюджету. Спочатку інвестиційну тезу перевіряють на відповідність мандату фонду, а потім — його нещодавнім угодам. У разі непевних висновків перевірку повторюють, а агент узгоджує результати, перш ніж подати звіт.
Така глибша перевірка виявила проблеми в угодах, які зіставна модель схвалила за один прохід. GPT‑6.1 Sol також виконувала ті самі робочі процеси з приблизно на 30% нижчою вартістю запиту, ніж найближча за результатами модель, за подібної швидкості.
За допомогою GPT‑6.1 Sol і GPT‑6 Luna Terminal X створила 1700 записів корпоративної пам’яті, виконала понад 1 мільйон спеціально налаштованих робочих процесів, а кількість її активних користувачів за тиждень сягнула 81% від кількості активних користувачів за місяць.
Наступний крок Terminal X — поширити корпоративну пам’ять із рівня підрозділів на окремих фахівців, щоб фіксувати підходи кожного інвестиційного професіонала так, як він їх застосовує, а не лише описує.
Для Хюна, співзасновника й генерального директора Terminal X, саме в цьому й суть: «У наступному десятилітті перемагатимуть компанії, які зберігатимуть власну логіку ухвалення рішень у вигляді даних. Наше завдання — зробити цю логіку вимірюваною, щоб її можна було зберігати, вдосконалювати й використовувати повторно».