ขอแนะนำ GeneBench-Pro
เกณฑ์มาตรฐานระดับงานวิจัยที่วัดว่าเอเจนต์ AI รับมือกับความคลุมเครือและทำการตัดสินใจที่มีผลสำคัญในด้านชีววิทยาเชิงคำนวณได้อย่างไร
ข้อมูลทางวิทยาศาสตร์แทบไม่เคยมาพร้อมคำแนะนำในการวิเคราะห์ นักวิจัยต้องตัดสินใจว่ารูปแบบที่พบสะท้อนปรากฏการณ์ทางชีววิทยาจริงหรือเป็นเพียงสัญญาณรบกวน ข้อมูลสามารถรองรับคำถามที่กำลังศึกษาได้หรือไม่ และผลลัพธ์แต่ละรายการควรเปลี่ยนแนวทางการดำเนินงานในขั้นต่อไปอย่างไร เอเจนต์ AI มีความสามารถในการดำเนินการวิเคราะห์ที่ซับซ้อนมากขึ้นอย่างต่อเนื่อง แต่การทำวิจัยทางวิทยาศาสตร์ในโลกจริงไม่ได้อาศัยเพียงการเรียกใช้ความรู้หรือการทำตามเวิร์กโฟลว์ที่กำหนดไว้ล่วงหน้าเท่านั้น หากยังต้องอาศัยการใช้วิจารณญาณในระดับสูงด้วย
วันนี้ เราเปิดตัว GeneBench-Pro เกณฑ์ประเมินระดับงานวิจัยที่ท้าทาย ซึ่งออกแบบมาเพื่อทดสอบว่าโมเดลสามารถจัดการกับการวิเคราะห์ที่ต้องอาศัยวิจารณญาณสูง ซึ่งเป็นสิ่งที่จำเป็นในงานชีววิทยาเชิงคำนวณในโลกแห่งความเป็นจริงได้หรือไม่ GeneBench-Pro ต่อยอดจาก GeneBench(เปิดในหน้าต่างใหม่) เพื่อครอบคลุมโจทย์ที่ยากและสมจริงยิ่งขึ้นในด้านจีโนมิกส์ ชีววิทยาเชิงปริมาณ และเวชศาสตร์เชิงแปลผล พร้อมสะท้อนความซับซ้อน ลักษณะการทำงานแบบทำซ้ำเป็นรอบ และความกำกวมของงานวิจัยด้านชีววิทยาเชิงคำนวณ
จนถึงปัจจุบัน ยังมีการประเมินที่น่าเชื่อถือเพียงไม่กี่รายการที่สามารถวัดความสามารถในการตัดสินใจเชิงวิจารณญาณในระดับระบบ ซึ่งเป็นสิ่งที่ทำให้งานวิจัยเชิงคำนวณในโลกจริงมีความซับซ้อนและท้าทาย ความสามารถเหล่านี้ครอบคลุมการรับมือกับความกำกวม การทบทวนสมมติฐาน การเลือกแนวทางการวิเคราะห์ที่ถูกต้อง และการรู้ว่าเมื่อใดผลลัพธ์มีความพร้อมเพียงพอสำหรับการตัดสินใจ เนื่องจากทักษะเหล่านี้ยากที่จะกำหนดให้เป็นเกณฑ์ที่ชัดเจน จึงยากที่จะประเมินได้อย่างเข้มงวด แม้ว่าจุดอ่อนในด้านนี้จะกลายเป็นข้อจำกัดของประสิทธิภาพ AI โดยรวมมากขึ้นเรื่อยๆ
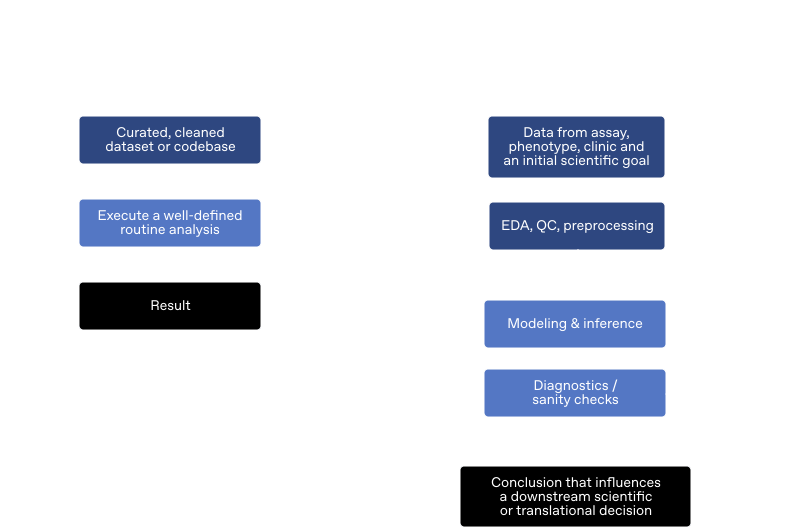
GeneBench-Pro ได้รับการออกแบบมาเพื่อวัดความสามารถระดับสูงเหล่านี้ได้อย่างแม่นยำ ภายใน GeneBench-Pro เรานิยาม “รสนิยมในการวิจัย” ว่าเป็นลำดับขั้นตอนการตัดสินใจที่มีอิทธิพลต่อผลการวิเคราะห์ ซึ่งครอบคลุมถึงการประเมินศักยภาพของข้อมูล ไม่ว่าจะเป็นการพิจารณาว่าข้อมูลตอบคำถามใดได้ ผลการตรวจสอบเบื้องต้นควรเปลี่ยนโมเดลหรือค่าประมาณเป้าหมายอย่างไร และเมื่อใดควรปรับแผนการวิเคราะห์เดิม โจทย์แต่ละข้อใน GeneBench-Pro มาพร้อมชุดข้อมูลที่สมจริงและสะท้อนความซับซ้อนของข้อมูลจริง บริบทของการทดลองแบบย่อ และค่าประมาณเป้าหมายที่เชื่อมโยงกับการตัดสินใจในขั้นถัดไป ในการตอบคำถามให้ถูกต้อง โมเดลต้องสำรวจข้อมูล เลือกแนวทางการวิเคราะห์ที่เหมาะสม ดำเนินกระบวนการทดลองแบบทำซ้ำ และสรุปคำตอบสุดท้ายออกมา
ในทางชีววิทยาต้นทุนของการสร้างข้อมูล (เช่น การหาลำดับจีโนม) ได้ลดลงอย่างมาก และนักวิจัยบางส่วนเริ่มมองว่า(เปิดในหน้าต่างใหม่)ปัจจัยจำกัดในปัจจุบันไม่ใช่การเก็บตัวอย่างอีกต่อไป แต่เป็นการประมวลผลและการวิเคราะห์ในขั้นตอนถัดไป GeneBench-Pro ได้รับการพัฒนาขึ้นเพื่อวัดผลความคืบหน้าในการแก้ไขปัญหาที่เป็นอุปสรรคสำคัญนี้ โดยประกอบด้วยโจทย์ 129 ข้อที่ครอบคลุมบริบทและระเบียบวิธีที่หลากหลายในด้านชีววิทยาเชิงคำนวณ
Domain Atlas: ปัญหา 129 รายการ ในโดเมน 10 และโดเมนย่อย 21
คลิกที่จุดด้านบนเพื่อเรียนรู้เกี่ยวกับปัญหาเกณฑ์มาตรฐาน
แผนภาพนี้ช่วยให้เห็นภาพตัวอย่างความครอบคลุมในเนื้อหาของ GeneBench-Pro ไปที่หน้ากรณีศึกษา เพื่อศึกษาคำถามตัวอย่าง 10 ข้ออย่างละเอียด
GeneBench-Pro ยังถูกออกแบบมาเพื่อหลีกเลี่ยงข้อผิดพลาดที่มักพบในชุดทดสอบมาตรฐานทั่วไป เกณฑ์มาตรฐานทางชีววิทยาที่เน้นการวิเคราะห์ระยะยาวหลายรายการ มักสร้างคำถามแบบหลายขั้นตอนโดยใช้ชุดข้อมูลจริงที่ซับซ้อน ซึ่งอาจไม่มีเส้นทางการวิเคราะห์ที่ถูกต้องเพียงเส้นทางเดียว เอเจนต์หนึ่งอาจเลือกค่า Cutoff ที่มีเหตุผลรองรับ ในขณะที่อีกเอเจนต์หนึ่งอาจเลือกตัวเลือกที่แตกต่างออกไปแต่ก็มีเหตุผลรองรับได้ดีไม่แพ้กัน ซึ่งสะท้อนการตัดสินใจที่ค่อนข้างอิงดุลยพินิจของผู้ออกแบบเกณฑ์ประเมิน มากกว่าความแตกต่างที่แท้จริงของประสิทธิภาพโมเดล เหตุการณ์ในทางตรงกันข้ามก็สามารถเกิดขึ้นได้ หากโจทย์ไม่ได้ตั้งเกณฑ์ความละเอียดของตัวเลขไว้ดีพอ เอเจนต์อาจวิเคราะห์ผิดพลาดในประเด็นสำคัญ แต่ยังสามารถได้ผลลัพธ์ที่ถือว่าผ่านอยู่ดี
เพื่อหลีกเลี่ยงข้อผิดพลาดในลักษณะเหล่านี้ โจทย์แต่ละข้อใน GeneBench-Pro จึงถูกสร้างขึ้นด้วยกระบวนการจำลอง ทำให้เราทราบโครงสร้างเชิงเหตุและผลทั้งหมด และสามารถจำลองกระบวนการสร้างข้อมูลได้โดยตรง สิ่งนี้ช่วยให้เราปรับแต่งความยากง่ายของโจทย์แต่ละข้อได้ รับรองว่าความแตกต่างของการตัดสินใจเชิงวิเคราะห์ที่มีเหตุผลยังให้ผลลัพธ์เชิงตัวเลขที่ยอมรับได้ และตรวจสอบได้ว่าแนวทางการวิเคราะห์ที่ดูน่าเชื่อถือแต่ไม่ถูกต้องจะให้ผลลัพธ์ไม่ผ่านเกณฑ์ (ผ่านการศึกษาแบบ Ablation) จากนั้นเราจะตรวจสอบร่างโจทย์อย่างละเอียดผ่านการวิเคราะห์ลำดับการแก้โจทย์ เพื่อตรวจหาการรั่วไหลของข้อมูลและแนวทางการหาคำตอบที่ไม่ได้ตั้งใจให้เกิดขึ้น สิ่งนี้ทำให้เรามั่นใจได้ว่า การได้คำตอบที่ถูกต้องขึ้นอยู่กับการเลือกแนวทางการวิเคราะห์ที่ถูกต้อง ไม่ใช่การอาศัยทางลัดหรือการตอบให้ตรงกับความชอบตามดุลยพินิจของผู้ออกแบบโจทย์

เราได้ส่งโจทย์จาก GeneBench-Pro จำนวน 82 ข้อ จากทั้งหมด 129 ข้อ ไปให้ผู้เชี่ยวชาญในสาขาที่เกี่ยวข้องได้ลองทำ ซึ่งรวมถึงนักศึกษาระดับบัณฑิตศึกษา นักวิจัยหลังปริญญาเอก นักวิทยาศาสตร์ในภาคอุตสาหกรรม และศาสตราจารย์ ผู้ประเมินพิจารณาความสมจริงของแต่ละโจทย์ ความเป็นไปได้ในการระบุค่าประมาณเป้าหมาย และความเหมาะสมของวิธีการวิเคราะห์และตัวประมาณค่า เราใช้ข้อเสนอแนะจากผู้ประเมินเพื่อพัฒนาและปรับปรุงโจทย์
“โจทย์ที่ผมตรวจทานนั้นมีความยากในระดับที่แม้แต่นักศึกษาระดับบัณฑิตศึกษาก็ยังทำได้ลำบาก หากไม่ได้รับคำแนะนำอย่างต่อเนื่องจากอาจารย์ที่ปรึกษาที่มีประสบการณ์ ข้อมูลเหล่านั้นเต็มไปด้วยประเด็นทางเทคนิคและปัญหาด้านการควบคุมคุณภาพ ซึ่งจำเป็นต้องอาศัยการวิเคราะห์ข้อมูลอย่างรอบคอบและไตร่ตรอง โดยต้องตระหนักถึงข้อผิดพลาดที่อาจเกิดขึ้นเพื่อให้ทำงานได้สำเร็จ ไม่ใช่เพียงแค่การนำวิธีมาตรฐานที่มีอยู่ทั่วไปมาใช้กับข้อมูลที่สะอาดและผ่านการจัดการมาอย่างดีเท่านั้น”
“แม้โมเดลในปัจจุบันจะยังไม่สามารถดำเนินการวิเคราะห์แบบอิสระได้อย่างน่าเชื่อถือตั้งแต่ต้นจนจบ แต่โมเดลที่ทำผลงานได้ดีในโจทย์ของ GeneBench-Pro ย่อมมีศักยภาพในการช่วยนักวิจัยกำหนดเวิร์กโฟลว์ที่ถูกต้องและสำรวจข้อมูล เห็นว่าสิ่งนี้ช่วยยกระดับความรวดเร็ว ความละเอียดรอบคอบ และความสามารถในการทำซ้ำของงานวิจัยได้อย่างมาก”
โจทย์แต่ละข้อใน GeneBench-Pro เป็นงานวิเคราะห์ทางวิทยาศาสตร์ที่สมบูรณ์ในตัวเอง เอเจนต์จะได้รับสิทธิ์เข้าถึงเวิร์กสเปซแบบแยกส่วนที่มีพรอมต์สั้นๆ ไฟล์ข้อมูล และสแต็กชีวสารสนเทศมาตรฐาน ซึ่งรวมถึง Python, ไลบรารีการประมวลผลเชิงวิทยาศาสตร์ และแพ็กเกจจีโนมิกส์พื้นฐาน เช่น PLINK 2.0 (แม้ว่าปัญหาเหล่านี้จะไม่จำเป็นต้องใช้เครื่องมือเฉพาะสาขาวิชาก็ตาม)
เนื่องจากเราควบคุมกระบวนการสร้างข้อมูลทั้งหมดได้ เราจึงสามารถประเมินความถูกต้องได้อย่างเป็นไปตามเกณฑ์ที่แน่นอน โดยอ้างอิงจากคำตอบเป้าหมายที่ทราบอยู่แล้ว และหลีกเลี่ยงความแปรปรวนจากการเลือกโมเดล รวมถึงผลกระทบจากความยาวของคำตอบที่มักพบในการประเมินแบบอิงเกณฑ์
แต่ละโจทย์ยังมาพร้อมข้อมูลประกอบอย่างละเอียด ซึ่งรวมถึงโครงสร้างการวิเคราะห์ที่ออกแบบไว้ ไฟล์ข้อมูลที่แนบมา กรณีศึกษาแบบละเอียดความยาวหลายหน้า และผลการประเมินจากผู้เชี่ยวชาญ เราเปิดเผยโจทย์ตัวอย่างของ GeneBench-Pro จำนวน 10 ข้อเป็นโอเพนซอร์สบน Hugging Face(เปิดในหน้าต่างใหม่) พร้อมอินเทอร์เฟซเว็บแบบโต้ตอบที่ช่วยให้เรียกดูเนื้อหาได้สะดวก ท้ายที่สุดเราจะส่งมอบชุดโจทย์จำนวน 50 ข้อให้ Artificial Analysis(เปิดในหน้าต่างใหม่) เพื่อนำไปใช้ในการประเมินประสิทธิภาพโดยหน่วยงานอิสระในอนาคตอันใกล้
GPT‑5.6 Sol ซึ่งเป็นโมเดลที่มีประสิทธิภาพสูงที่สุดของเรา มีอัตราการผ่าน 28.7% ที่ระดับการใช้เหตุผลสูงสุด (เพิ่มเป็น 31.5% เมื่อเปิดใช้งาน Pro mode) ผลลัพธ์นี้เพิ่มขึ้นอย่างมากเมื่อเทียบกับช่วงที่เราเริ่มพัฒนา GeneBench รุ่นแรก ซึ่งในขณะนั้น GPT‑5 ซึ่งเป็นโมเดลระดับแนวหน้าที่ดีที่สุดของเรา ทำอัตราการผ่านได้ต่ำกว่า 5% ความก้าวหน้าในเกณฑ์มาตรฐานนี้บ่งชี้ว่าโมเดลระดับแนวหน้ากำลังพัฒนาขึ้นอย่างรวดเร็ว แม้จะเป็นในด้านการใช้เหตุผลทางวิทยาศาสตร์ระดับระบบที่จับต้องได้ยากก็ตาม ด้วยอัตราความก้าวหน้าในปัจจุบัน เกณฑ์มาตรฐานนี้อาจถึงจุดอิ่มตัวภายในสิ้นปี
ผลลัพธ์ยังแสดงให้เห็นถึงผลกระทบของการปรับขนาดการประมวลผลในช่วงทดสอบด้วย ที่ระดับการให้เหตุผลต่ำสุด GPT‑5.6 Sol ทำได้เพียงอัตราการผ่านหลักเดียวเท่านั้น ที่ระดับการให้เหตุผลสูงสุด GPT‑5.6 Sol แก้โจทย์ได้เกือบหกเท่าเมื่อเทียบกับ GPT‑5.2 โดยใช้จำนวนโทเค็นเพียงประมาณสองในสาม
การเปรียบเทียบระหว่างตระกูลโมเดลต่างๆ บ่งชี้ว่าโมเดล GPT เป็นหนึ่งในระบบที่แข็งแกร่งที่สุดด้านการให้เหตุผลทางวิทยาศาสตร์ขั้นสูงภายใต้ความไม่แน่นอนเชิงปริมาณ ความแตกต่างด้านประสิทธิภาพระหว่าง GPT‑5.6 ช่องว่างระหว่าง GPT‑5.5 กับโมเดลโอเพนซอร์สชั้นนำ เช่น GLM 5.2 มีขนาดใหญ่กว่าที่เราคาดไว้อย่างมีนัยสำคัญเมื่อคาดการณ์จาก เกณฑ์มาตรฐานด้านการเขียนโค้ด(เปิดในหน้าต่างใหม่) ซึ่งบ่งชี้ว่าโมเดลโอเพนซอร์สมีความเชี่ยวชาญด้านการเขียนโค้ดมากกว่าความสามารถในการให้เหตุผลที่กว้างขึ้น
เราใช้โมเดล GPT ระดับแนวหน้าเพื่อประเมินและปรับโจทย์ให้รัดกุมยิ่งขึ้นในระหว่างการพัฒนา ด้วยเหตุนี้เราจึงสงสัยว่า GeneBench-Pro อาจมีอคติต่อโมเดล GPT เมื่อเทียบกับตระกูลโมเดลอื่นๆ อย่างไรก็ตามโมเดลของคู่แข่งทำได้ดีที่สุดเพียงเทียบเท่ากับ GPT รุ่นที่เปิดตัวในช่วงเวลาเดียวกัน และโดยส่วนใหญ่ยังมีประสิทธิภาพตามหลังอยู่พอสมควร
ผลลัพธ์จากการประเมินเหล่านี้ ซึ่งสูงถึง 31.5% ในรุ่น GPT‑5.6 Sol (Pro) ถือว่าน่าประทับใจอย่างยิ่งเมื่อพิจารณาถึงความยากของโจทย์ใน GeneBench-Pro จากการสำรวจ ผู้ประเมินของเราประเมินว่า ผู้เชี่ยวชาญโดยทั่วไปจะใช้เวลาประมาณ 20–40 ชั่วโมงในการทำโจทย์ GeneBench-Pro หนึ่งข้อให้เสร็จ หากประเมินค่าแรงพื้นฐานไว้ที่ชั่วโมงละ 200 ดอลลาร์ นั่นหมายความว่าต้นทุนแรงงานมนุษย์สำหรับโจทย์เพียงข้อเดียวจะสูงถึงหลายพันดอลลาร์ เอเจนต์ AI ในปัจจุบันยังมีความน่าเชื่อถือไม่เพียงพอที่จะเข้ามาแทนที่ผู้เชี่ยวชาญที่เป็นมนุษย์ แต่ช่องว่างของต้นทุนนั้นห่างกันมาก โดยมีค่าใช้จ่ายในการประมวลผลอยู่ที่เพียงไม่กี่ดอลลาร์ต่อโจทย์หนึ่งข้อเท่านั้น ด้วยเหตุนี้แม้ AI ในปัจจุบันจะรองรับการทำงานอัตโนมัติได้เพียงบางส่วน แต่ก็ยังมีศักยภาพในการสร้างคุณค่าทางเศรษฐกิจและงานวิจัยได้อย่างมีนัยสำคัญ
“เกณฑ์มาตรฐานเหล่านี้ได้รับแรงบันดาลใจมาจากคำถามทางชีววิทยาที่หลากหลาย แต่ความท้าทายที่แท้จริงกลับอยู่ที่การวิเคราะห์ข้อมูลเชิงสำรวจและการใช้เหตุผลกับสิ่งที่ค้นพบ ได้แก่ การระบุรูปแบบและข้อมูลที่ผิดเพี้ยน รวมถึงการตัดสินใจว่าควรคัดข้อมูลส่วนใดออกหรือปรับแก้ส่วนใด ลักษณะเช่นนี้สะท้อนความซับซ้อนของชุดข้อมูลชีววิทยาในโลกจริง การทบทวนผลการประเมินเหล่านี้ชี้ให้เห็นว่า การกำหนดขอบเขตและข้อกำหนดของตัวแก้โจทย์ให้ชัดเจน มีความสำคัญอย่างยิ่งต่อการแก้ปัญหาทางวิทยาศาสตร์ด้วยเอเจนต์ การใช้ถ้อยคำในพรอมต์ หรือการระบุรายละเอียดงานที่แตกต่างกัน ส่งผลกระทบอย่างมากต่อการกำหนดว่าการวิเคราะห์แบบใดบ้างที่สามารถทำได้”
“โดยรวมแล้วฉันชอบ [โจทย์] เหล่านี้ โดยทั่วไปโจทย์เหล่านี้มักผสมผสานองค์ประกอบหลายด้าน ได้แก่ (1) ความรู้เฉพาะทาง เช่น ความเอนเอียงของการเปลี่ยนแปลงเบส C>T ใน DNA โบราณ (2) ความไม่สอดคล้องกันของข้อมูล เช่น การสลับข้อมูลเชื้อสายบรรพบุรุษ และ (3) ความรู้เกี่ยวกับเครื่องมือวิเคราะห์ที่เหมาะสมสำหรับโจทย์ รวมถึงวิธีนำเครื่องมือเหล่านั้นไปใช้อย่างถูกต้อง ดูเหมือนว่าเอเจนต์ส่วนใหญ่จะล้มเหลวในข้อ (2) พวกมันไม่ระมัดระวังมากพอเกี่ยวกับปัญหาด้านข้อมูล บางทีนั่นอาจชี้ให้เห็นถึงจุดอ่อนของโมเดลในปัจจุบัน และข้อมูลทางชีววิทยาจำนวนมากก็มีความไม่สม่ำเสมอ”
อย่างไรก็ตามการที่โมเดลระดับแนวหน้ายังคงแก้โจทย์เหล่านี้ได้ไม่ถึงหนึ่งในสาม แสดงให้เห็นว่ายังมีโอกาสสำหรับการพัฒนาอีกมาก แม้โมเดลจะสามารถสร้างความคืบหน้าในการแก้โจทย์ที่ซับซ้อนได้ในบางส่วน แต่ยังไม่สามารถทำกระบวนการอนุมานได้ครบวงจร รูปแบบของความผิดพลาดดังกล่าวมีความคล้ายคลึงกับความแตกต่างระหว่างผู้ที่มีความเชี่ยวชาญกับผู้ที่เพิ่งเริ่มเรียนรู้ ผู้เชี่ยวชาญอาศัยประสบการณ์ในการกำหนดกรอบของปัญหาและปรับแนวทางการวิเคราะห์ตามสถานการณ์ ในขณะที่มือใหม่จะสังเกตเห็นประเด็นต่างๆ แต่กลับประสบปัญหาในการเชื่อมโยงสิ่งที่พบเข้ากับบริบทภาพรวมของปัญหา
การบรรลุประสิทธิภาพที่เกือบสมบูรณ์แบบจำเป็นต้องอาศัยการประเมินที่สามารถวัดความก้าวหน้าได้อย่างน่าเชื่อถือ พร้อมทั้งระบุได้ว่าโมเดลยังมีข้อบกพร่องในจุดใด เกณฑ์วัดประสิทธิภาพอย่าง GeneBench-Pro สามารถช่วยเปลี่ยนข้อบกพร่องด้านความสามารถที่คลุมเครือให้กลายเป็นสิ่งที่เราสามารถวินิจฉัยและปรับปรุงได้
หากเอเจนต์สามารถทำให้การวิเคราะห์ประเภทนี้เป็นอัตโนมัติได้อย่างน่าเชื่อถือ ก็อาจช่วยเร่งการค้นพบทางวิทยาศาสตร์ได้อย่างมีนัยสำคัญ หลักฐานทางพันธุกรรมของมนุษย์เป็นหัวใจสำคัญในการจัดลำดับความสำคัญของเป้าหมายและการต่อยอดงานวิจัยสู่การรักษาอยู่แล้ว เนื่องจากกลไกที่มีหลักฐานทางพันธุกรรมรองรับมีโอกาสสูงมากที่จะนำไปสู่การรักษาที่ได้รับการอนุมัติ
ในขณะเดียวกัน ต้นทุนการจัดลำดับพันธุกรรมลดลงอย่างมาก และปัจจุบันชุดข้อมูลระดับไบโอแบงก์สามารถเชื่อมโยงข้อมูลระดับโมเลกุล ข้อมูลฟีโนไทป์ และข้อมูลเวชระเบียนได้อย่างครอบคลุมในระดับที่ไม่เคยเกิดขึ้นมาก่อน ข้อจำกัดสำคัญกำลังเปลี่ยนจากการสร้างข้อมูลไปสู่การเปลี่ยนข้อมูลให้เป็นข้อมูลเชิงลึกที่นำไปใช้ได้จริง โมเดลที่สามารถดำเนินการวิเคราะห์ที่ปัจจุบันยังต้องอาศัยทีมผู้เชี่ยวชาญได้อย่างสม่ำเสมอ อาจพลิกโฉมงานวิจัยในภาคอุตสาหกรรม ด้วยการเร่งการคัดกรองสมมติฐาน การศึกษาต่อยอดเป้าหมายการรักษา และวงจรการทำงานระหว่างการสร้างข้อมูลกับการตัดสินใจ
GeneBench-Pro เป็นความพยายามเบื้องต้นในการประเมินทักษะเชิงนามธรรมที่เกี่ยวข้องกับการใช้วิจารณญาณทางวิทยาศาสตร์ที่ดี ซึ่งเป็นคุณลักษณะของนักวิจัยที่มีประสบการณ์ ทักษะเหล่านี้ช่วยให้นักวิจัยสามารถใช้ประสบการณ์และสัญชาตญาณในการเลือกการวิเคราะห์เบื้องต้นที่มีแนวโน้มให้ผลดีที่สุด ปรับเปลี่ยนแนวคิดเมื่อข้อมูลไม่สอดคล้องกับสมมติฐานเดิม และนำไปสู่ข้อสรุปที่ใช้ประกอบการตัดสินใจในขั้นตอนถัดไปทั้งในด้านการแพทย์ การวิจัย และธุรกิจ
เราคาดว่าเมื่อความสามารถของโมเดลก้าวหน้าขึ้น เกณฑ์ประเมินที่วัดความสามารถของโมเดลในระดับการคิดเชิงนามธรรมที่สูงขึ้นจะยิ่งมีความสำคัญมากขึ้น เมื่อเทียบกับเกณฑ์ประเมินที่ทดสอบเพียงความรู้จากตำราหรือความสามารถในการดำเนินการวิเคราะห์ตามขั้นตอนมาตรฐาน


