Terminal X når 88,6 % samsyn med erfarna investerare med GPT‑6.1
Terminal X:s Eval Agent bedömer svar utifrån 54 kriterier och upptäcker 25 % fler avvikelser från fondens mandat med GPT‑6.1 Sol.
25 %
Högre upptäcktsgrad när agentsvar avviker från fondens mandat med GPT‑6.1 Sol jämfört med den näst bästa modellen
2,4 milj. USD
Besparingar på årsbasis för en kund inom due diligence och investeringsflöden
+220 baspunkter
Högre överensstämmelse mellan agenters och mänskliga granskares bedömningar med GPT‑6.1 Sol jämfört med den näst bästa modellen
30 %
Lägre kostnad per fråga med GPT‑6.1 Sol jämfört med den näst bästa modellen
Ett investeringsbolags försprång byggs upp affär för affär, men bedömningarna bakom besluten finns oftast bara i huvudet på några få erfarna investerare. När de slutar uppstår det som Terminal X(öppnas i ett nytt fönster) kallar en minnesskuld: bolaget har kanske kvar dokumenten, men förlorar resonemangen.
Terminal X:s operativsystem Capital Memory är utformat för att minska den skulden. Företagets kundnära ingenjörer, som tidigare arbetat med finans och investeringar på JPMorgan och Blackstone, arbetar på plats med varje kunds investeringsteam. De utformar bolagets agentarkitektur och kodar in dess investeringsmetodik i agenter som bolaget självt äger och som körs lokalt eller i dess eget moln.
OpenAI-modeller, däribland GPT‑6.1 Sol och GPT‑6 Luna, står för resonemangen i dessa agenter. Terminal X:s Eval Agent bedömer sedan agenternas svar utifrån bolagets krav. GPT‑6.1 Sol hjälpte Eval Agent att upptäcka cirka 25 % fler rekommendationer som avvek från fondens mandat och körde samma arbetsflöden till cirka 30 % lägre kostnad per fråga än den näst bästa modellen.
”GPT-6.1 Sols förmåga att resonera över långa kontexter och använda token effektivt gör att vi kan bygga mer djupgående utvärderingsflöden. Det hjälper våra Eval Agents att göra investeringsbedömningar mätbara och granskningsbara.”
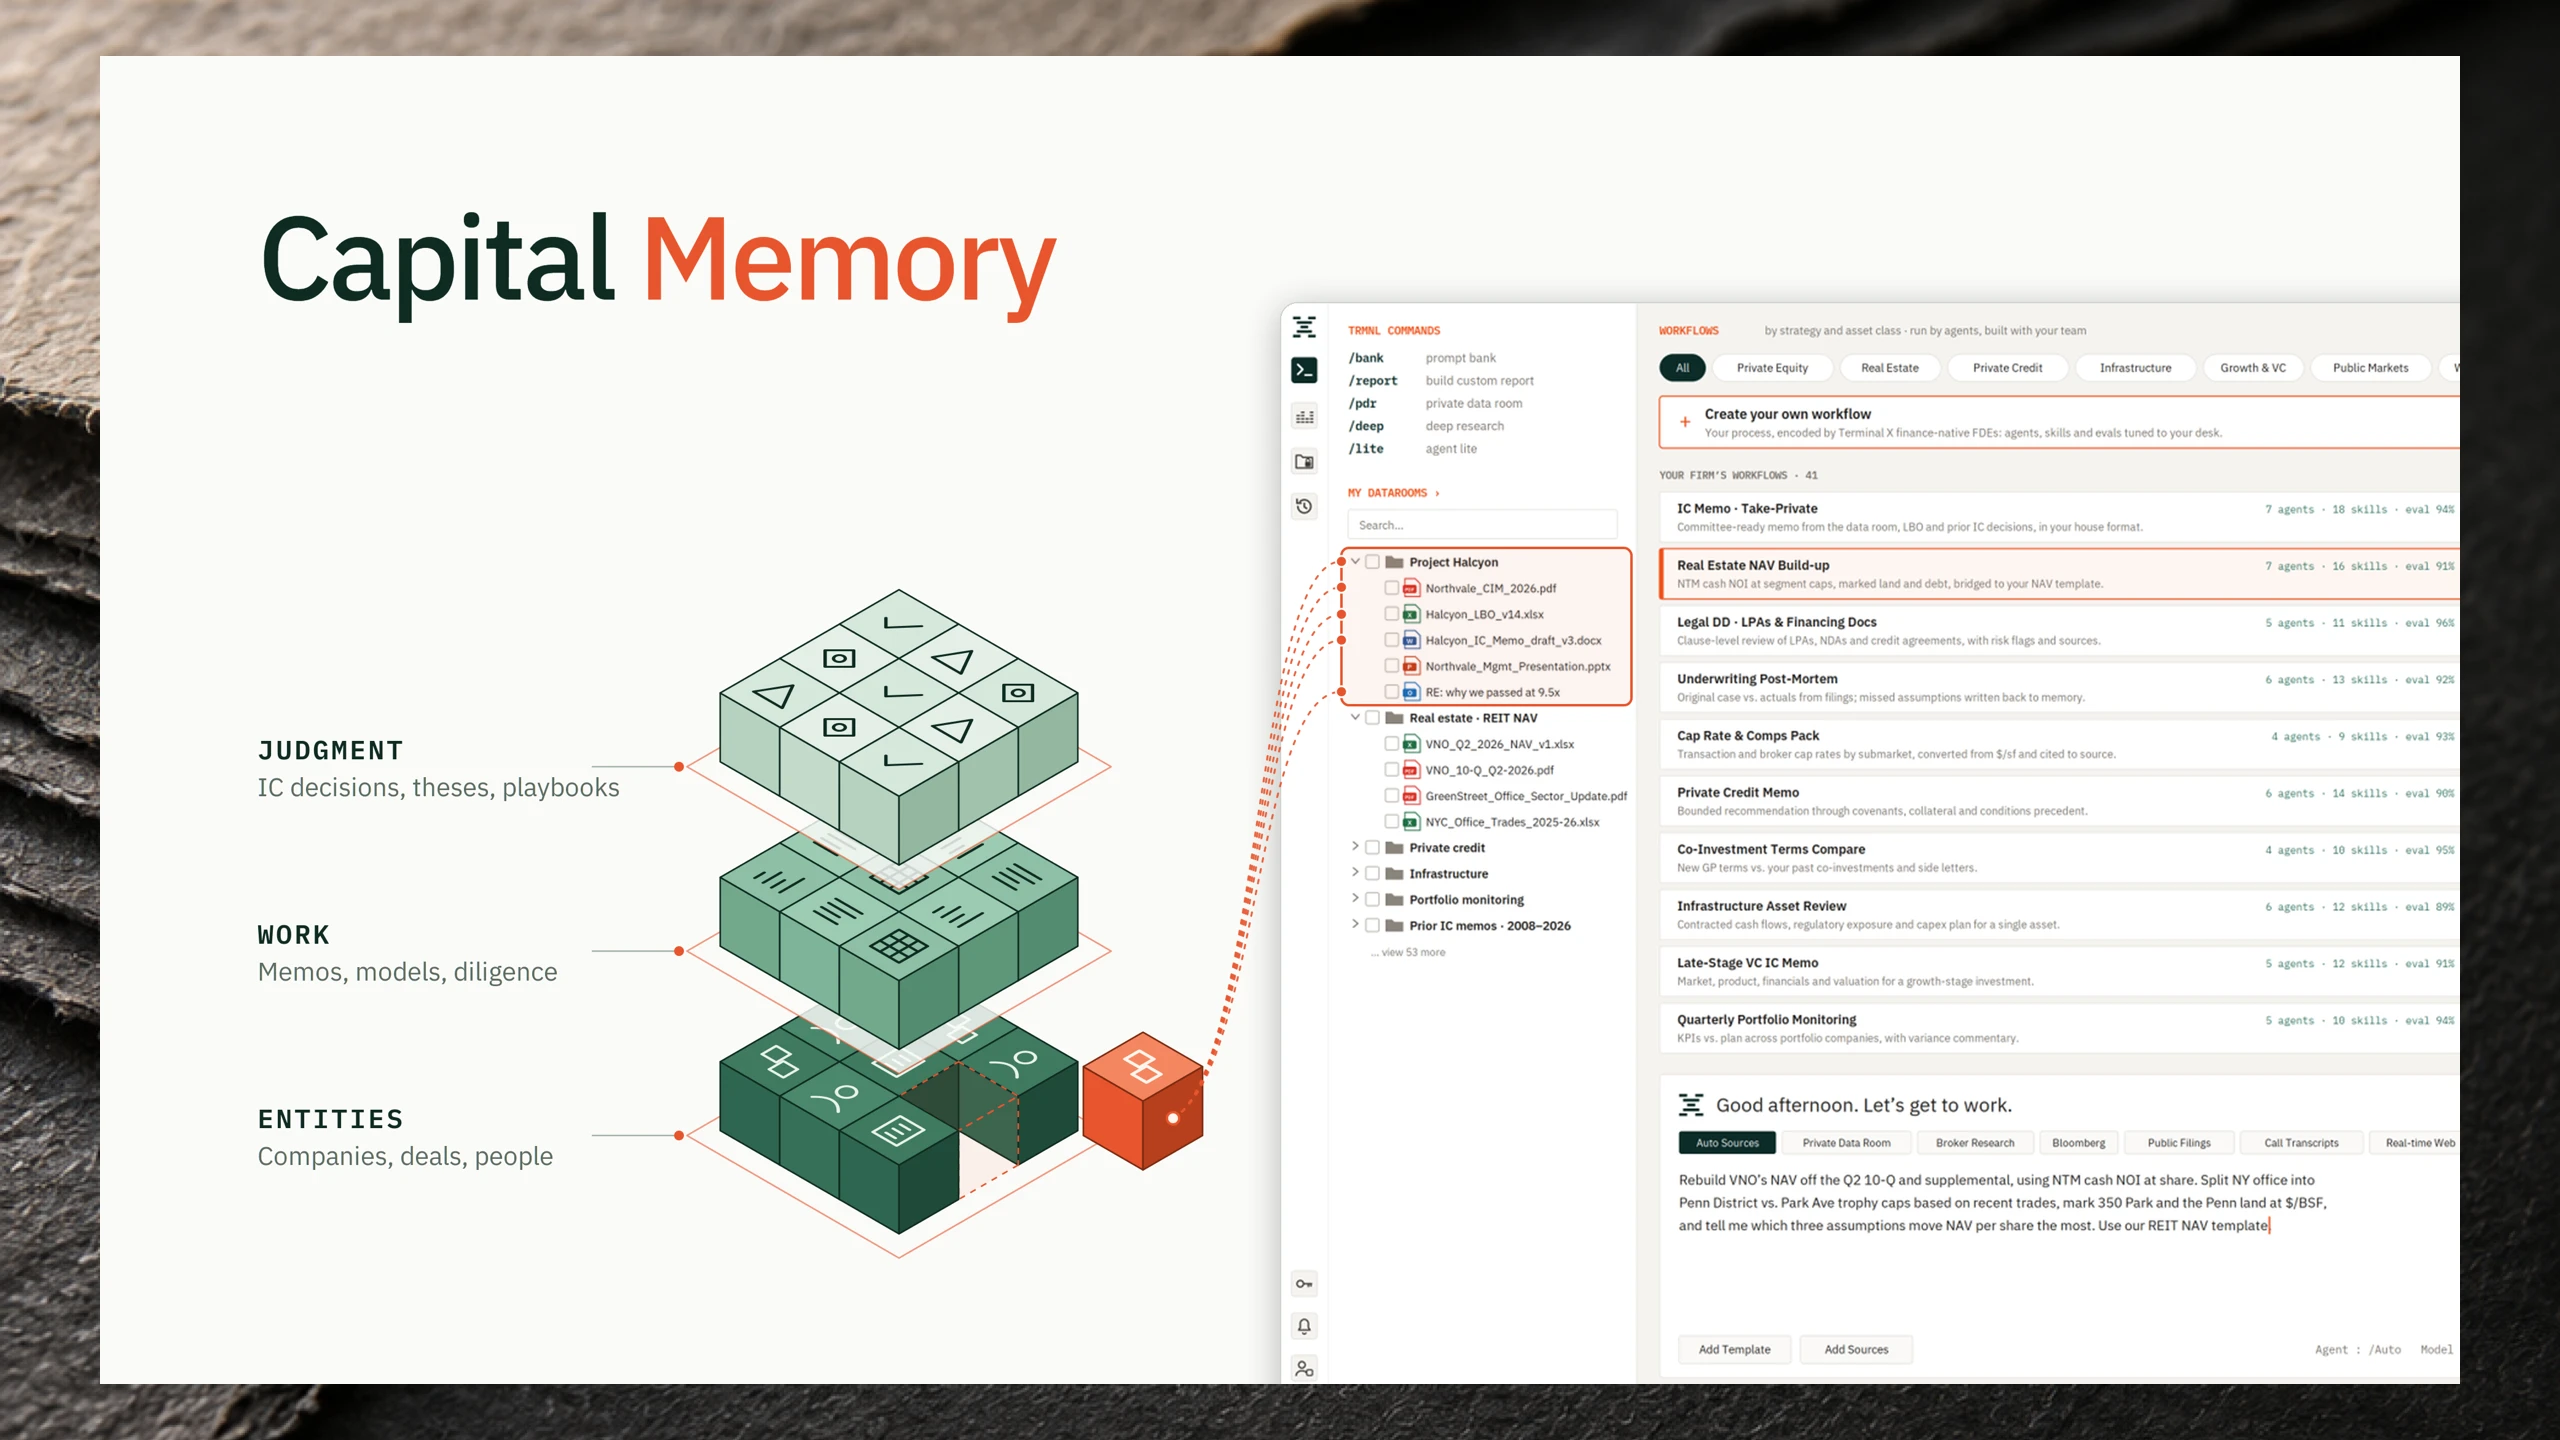
För varje kund bygger Terminal X agenter som är utformade för att investera på samma sätt som bolagets bästa investerare. Terminal X:s ingenjörer tillbringar flera veckor på plats hos kunden. De kartlägger arbetet bakom bolagets betrodda investeringsunderlag och fångar upp processer som aldrig dokumenterats, till exempel hur kreditteamet granskar en låntagare eller vilka källor teamet för saminvesteringar hämtar in inför ett investeringsunderlag.
Sedan kodas processerna in i hundratals agenter, anpassade efter tillgångsslag och strategi, med underagenter för varje steg i investeringsprocessen. GPT‑6.1 Sol hanterar stegen som kräver omdöme och ett mycket stort kontextfönster: att formulera en sammanhållen investeringstes, identifiera viktiga överväganden och bedöma hur väl investeringen passar bolagets mandat. GPT‑6 Luna sköter stegen med stora volymer där effektiv tokenanvändning är viktigare än djup.
Agenterna arbetar i varje bolags privata datarum, en särskild miljö där företag kan dela och hantera känsliga investeringsdata. Agenterna bearbetar dokument på engelska, koreanska, japanska och kinesiska och lagrar det de lär sig som ett företagsminne: en versionshanterad dokumentation av hur ett visst team fattar en viss typ av beslut. Där ingår tidigare analyser, kommittébeslut, instruktioner för arbetsflöden och bolagets gemensamma investeringssyn.
Ingenjörerna omvandlar varje minne till ett repeterbart arbetsflöde på Terminal X:s plattform. Där kan varje fråga i produktion granskas med full spårbarhet: vilka steg som utförts, vilka källor som hämtats, vilken modell som använts och vilka resonemang som förts.
Enligt Terminal X gör kunderna betydande besparingar med detta arbetssätt. Ett private equity-bolag rapporterade till exempel besparingar motsvarande 2,4 miljoner dollar på årsbasis genom automatiserade arbetsflöden för due diligence och investeringsunderlag.
Terminal X byggde Eval Agent för att kontrollera agenternas svar mot bolagets egna krav. Det är ett orkestrerat arbetsflöde som använder GPT‑6.1 Sol och andra OpenAI-modeller för att granska varje agentsvar på samma sätt som en senior chef granskar en analytikers arbete.
Eval Agent kontrollerar varje svar mot en bedömningsmatris med 54 kriterier. Den frågar: Har siffror, jämförelseobjekt, konsensusestimat och citat hämtats från rätt källor? Håller argumentationen? Är rekommendationen förankrad i bolagets gemensamma investeringssyn?
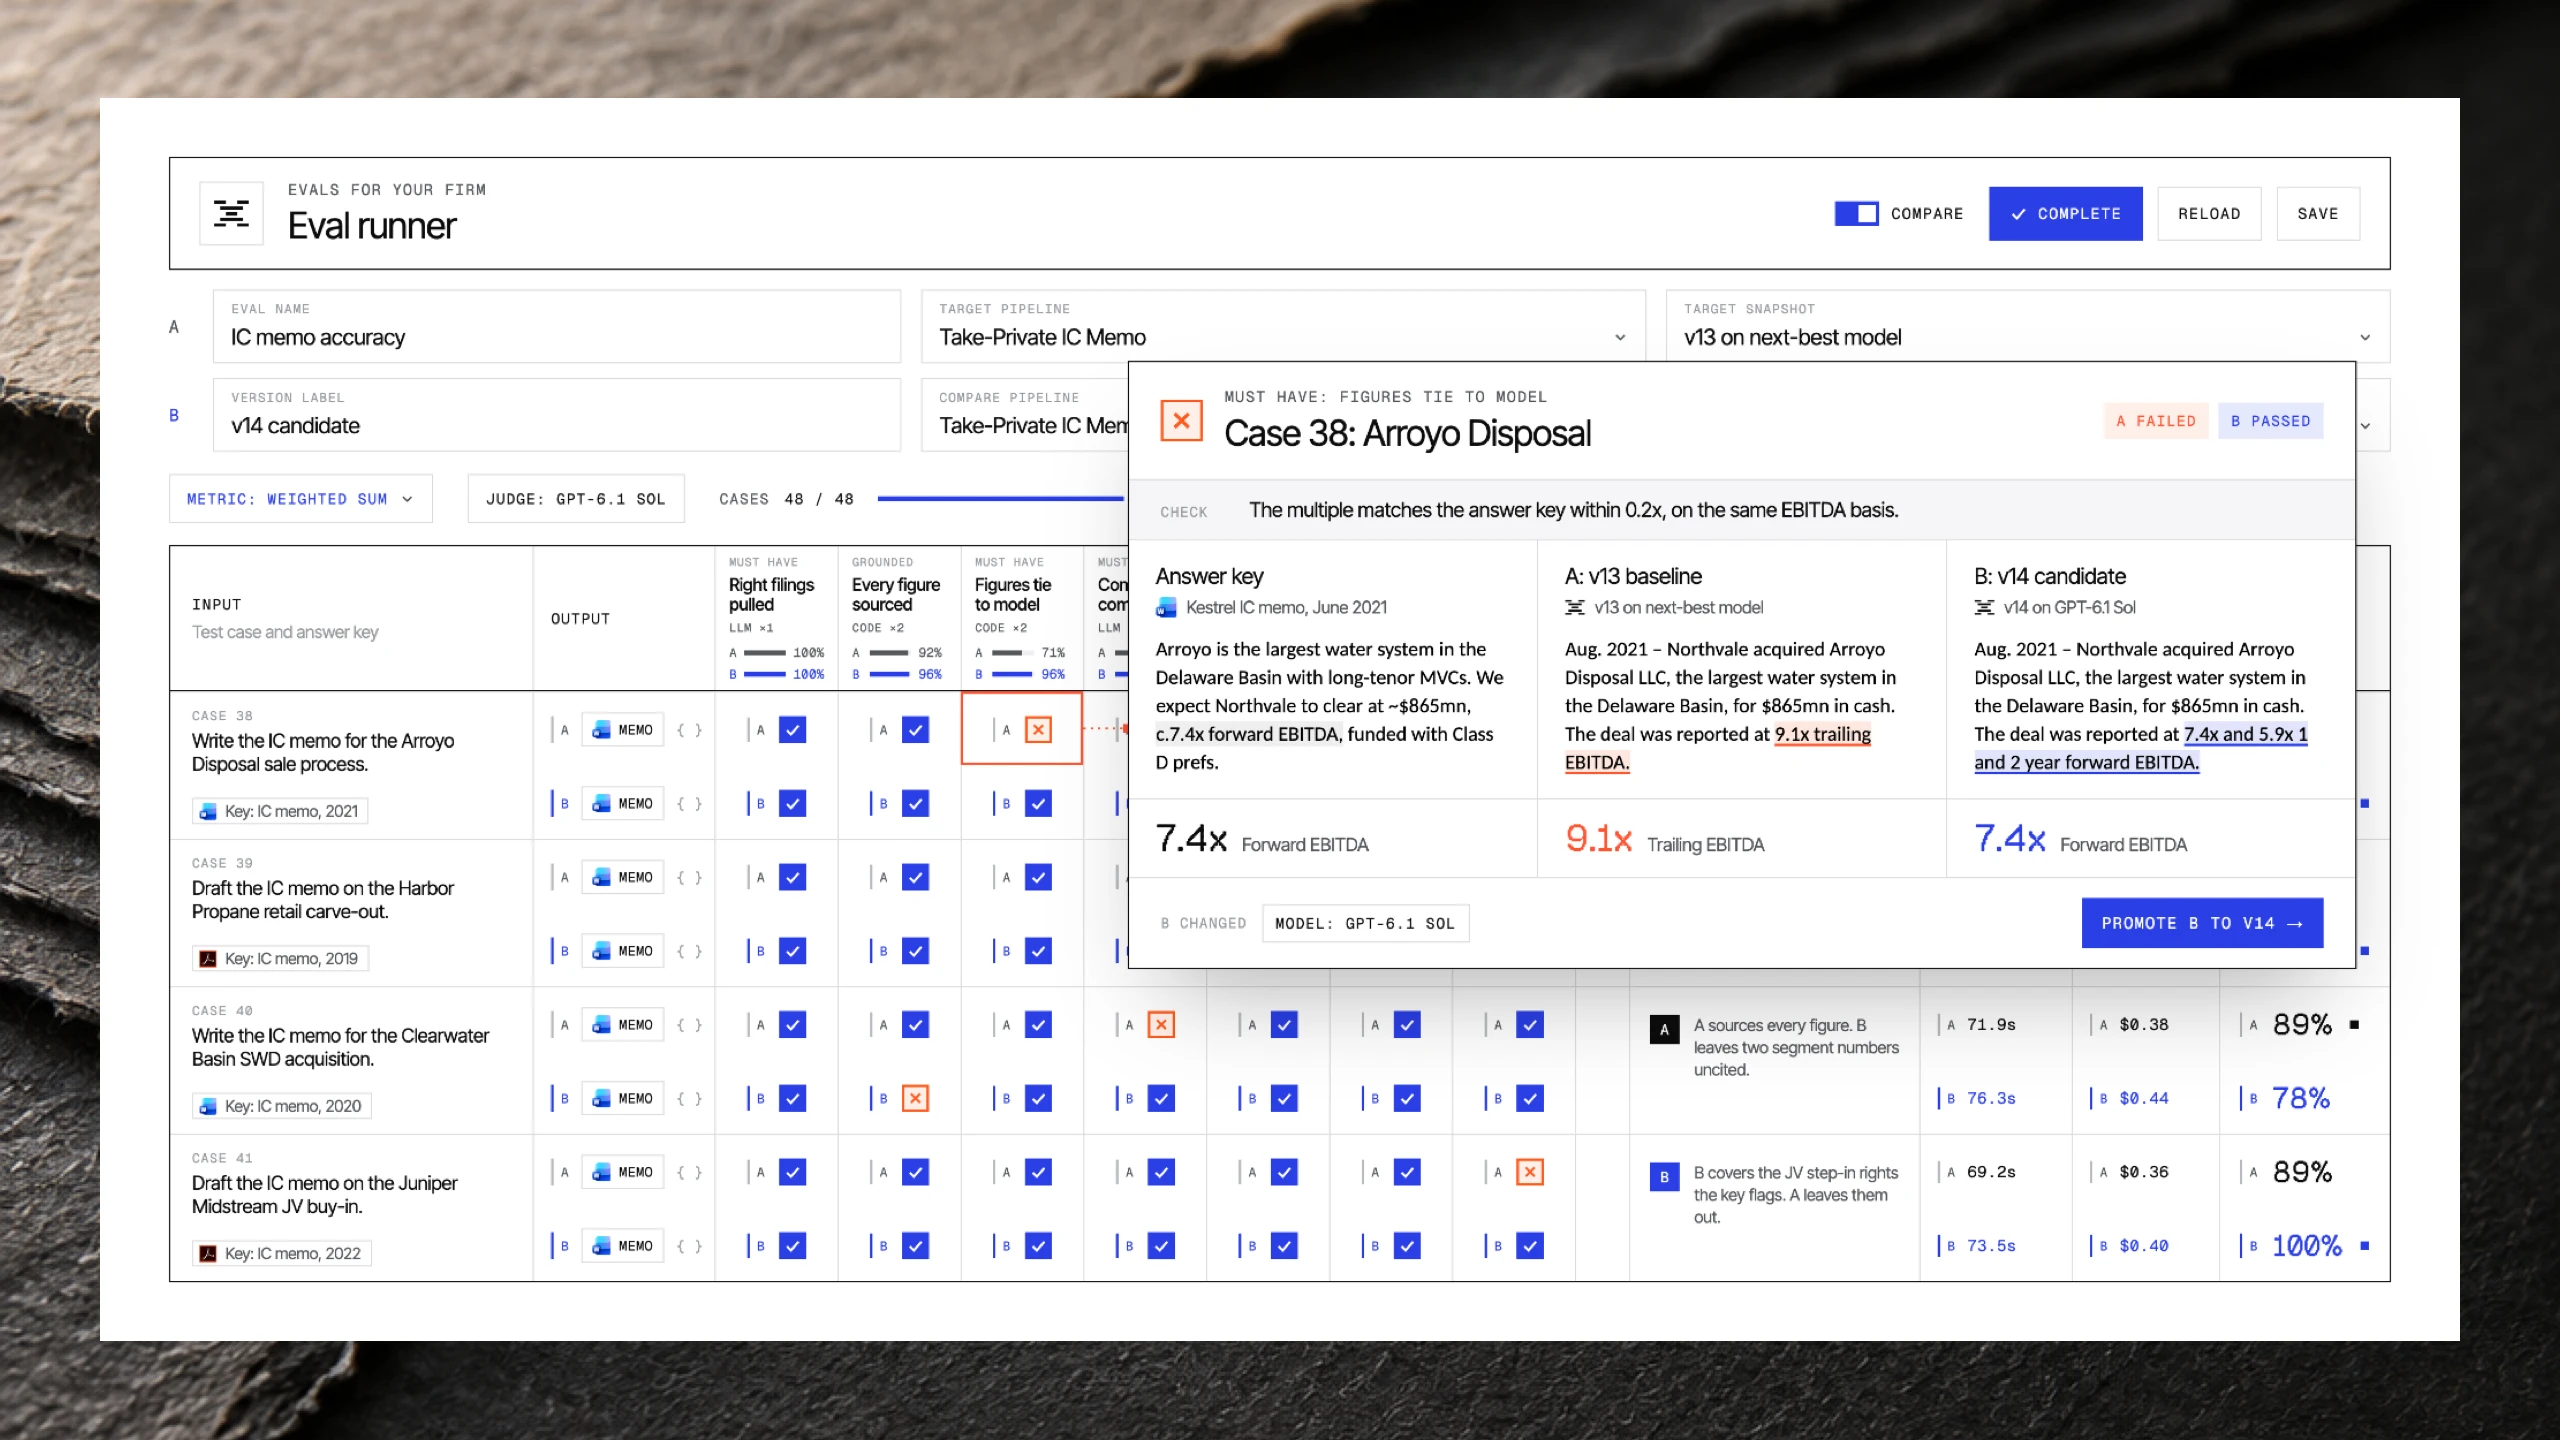
Varje kontroll ger godkänt eller underkänt. Varje underkänt resultat får en motivering på en rad och en bättre källa eller korrigerad text, och sparas som ett minne. En missad källa, ett felaktigt jämförelseobjekt eller en investeringstes som avviker från bolagets gemensamma investeringssyn kodas till exempel in som en ny instruktion i arbetsflödet eller ett nytt testfall för det teamet.
”Varje svar utvärderas, och varje korrigering som analytikern gör lär systemet lite mer om hur bolaget arbetar”, säger Ken Lee, medgrundare och teknikchef på Terminal X. ”Ju längre ett bolag använder det, desto mer tänker det alltså som deras eget team.”
Terminal X väljer modeller utifrån sina egna utvärderingsresultat. Av 500 utvärderade bedömningar stämde Eval Agents slutsats med GPT‑6.1 Sol överens med den erfarna mänskliga granskarens i 88,6 % av fallen, jämfört med 86,4 % för den näst bästa modellen – en förbättring på 220 baspunkter.
En typ av fel där GPT‑6.1 Sol presterade bättre var avvikelser från investeringsinriktningen. En utköpsfonds mandat kan till exempel vara att hitta börsbolag som handlas med substansrabatt för att köpa ut dem från börsen, bedöma verksamhetens värde och risker samt strukturera finansieringen. När scenariomodeller pekar på en marknadsvändning börjar affärsförslagen i stället rekommendera investeringar i nödlidande krediter eller räddningsfinansiering. Eval Agent med GPT‑6.1 Sol upptäckte cirka 25 % fler av dessa avvikelser än den näst bästa modellen.
GPT‑6.1 Sols effektiva tokenanvändning vid arbete med långa kontexter gjorde att Terminal X kunde bygga ett mer djupgående granskningsflöde inom samma budget. Investeringstesen prövas först mot fondens mandat och sedan mot dess senaste affärer. Osäkra bedömningar görs om, och agenten stämmer av resultaten mot varandra innan de rapporteras.
Den mer djupgående granskningen flaggade affärer som en jämförbar modell hade släppt igenom vid en enda genomgång. GPT‑6.1 Sol körde också samma arbetsflöden till cirka 30 % lägre kostnad per fråga än den näst bästa modellen, med liknande hastighet.
Med GPT‑6.1 Sol och GPT‑6 Luna har Terminal X skapat 1 700 företagsminnen, kört över 1 miljon anpassade arbetsflöden och nått ett antal veckoaktiva användare som motsvarar 81 % av de månadsaktiva användarna.
Terminal X:s nästa steg är att utöka företagsminnena från team till individer, så att varje investeringsexperts bedömningsgrunder fångas upp som de tillämpas i praktiken, inte bara som de beskrivs.
För Hyun, medgrundare och vd för Terminal X, är det själva poängen: ”Bolagen som vinner under det kommande decenniet kommer att äga sin bedömningsförmåga i form av data. Vårt jobb är att göra den bedömningsförmågan mätbar, så att den kan bevaras, förbättras och återanvändas.”