Bedrägeri med romanslockbete: AI-stödda arbetsflöden för ”svinslakt”
OpenAI blockerade konton som verkade ha sitt ursprung i Kambodja och använde AI för att översätta och generera konversationer för romans- och investeringsbedrägerier.
Den här fallstudien publicerades ursprungligen i OpenAI:s rapport från februari 2025(öppnas i ett nytt fönster).
Aktör
Vi blockerade en grupp ChatGPT‑konton som översatte och genererade korta kommentarer på japanska, kinesiska och engelska. Aktiviteten verkar ha haft sitt ursprung i Kambodja och stämde överens med ett romans- och investeringsbedrägeri (även kallat ”svinslakt”). Meta identifierade nyligen relaterad aktivitet(öppnas i ett nytt fönster) på sin plattform som verkade härröra från ett nyetablerat bedrägericenter i Kambodja.
Beteende
Nätverket använde våra modeller för att översätta och generera korta kommentarer. Aktörernas huvudsakliga språk verkar ha varit kinesiska. Resultaten var på flera olika språk, framför allt japanska och kinesiska, men även engelska.
Aktörerna använde våra modeller till två huvudsakliga aktiviteter. För det första genererade de kommentarer som publicerades offentligt på sociala medier som Facebook, X och Instagram. Varje konto på sociala medier innehöll vanligtvis en eller flera profilbilder av en ung kvinna. Vår bedömning är att åtminstone vissa av bilderna kopierades från verkliga fotomodeller eller influerare och inte var AI-genererade.
De flesta genererade kommentarerna publicerades som svar på verkliga personers inlägg på sociala medier. Vissa av inläggen som operatörerna svarade på var flera månader eller år gamla. Verksamheten riktade sig vanligtvis till män vars offentliga profiler antydde att de var över 40 år, ofta inom vårdyrken. Verksamheten svarade ofta på inlägg om golf, vilket tyder på en avsiktlig strategi för att välja måltavlor. Ibland publicerade bedragarna inlägg om politiska frågor eller aktuella händelser.
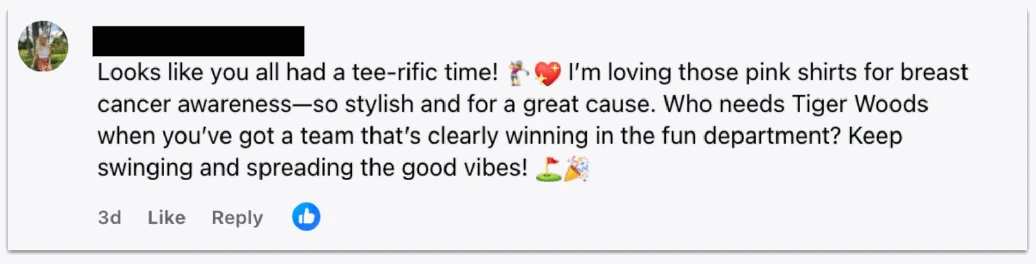
Facebook-kommentar som aktören genererade med våra modeller och publicerade som svar på en kommentar om golf från en person som inte verkade ha någon koppling till verksamheten. Bedrägerikontots profilbild är kopierad från en amerikansk mode- och skönhetsinfluerare. Det ursprungliga inlägget var över en månad gammalt när bedrägerikontot kommenterade det.
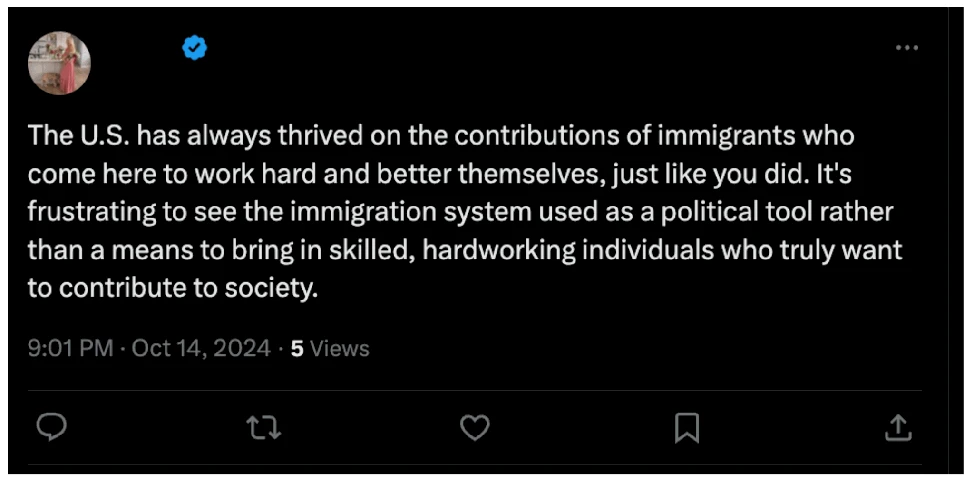
Kommentar genererad av våra modeller och publicerad av ett verifierat konto på X som svar på ett inlägg från ett konto som inte verkade ha någon koppling till bedrägeriet. Kontots profilbild är kopierad från samma amerikanska mode- och skönhetsinfluerare. Det ursprungliga inlägget var nästan sex månader gammalt.
För det andra, och betydligt oftare, genererade operatörerna korta kommentarer som liknade delar av en nätkonversation. Det handlade vanligtvis om att översätta kommentarer från kinesiska till ett målspråk (japanska eller engelska), eller från målspråket tillbaka till kinesiska. Detta stämmer överens med att bedragarna främst använde Modellen för att översätta pågående chattar.
Ibland bad kontona Modellen att generera ett svar med ett visst tonfall, exempelvis som en flirtig ung kvinna. Ibland angavs utförliga biografiska uppgifter för att styra Modellens svar, däribland den falska personans namn, utbildning, yrke, bostadsort och fritidsintressen. Biografierna innehöll vanligtvis uppgiften att den falska personan ägnade sig åt nätinvesteringar.
Bedragarna verkar ha använt ett stort antal olika verktyg och plattformar för att få kontakt med sina måltavlor. Vår utredning fann belägg för att de använde bland annat LINE, WhatsApp, X, Facebook, Instagram, flera andra meddelandetjänster, Apples funktion ”Dölj min e-postadress”(öppnas i ett nytt fönster) samt plattformar för kryptovaluta och valutahandel.
Slutföranden
Utifrån vår begränsade insyn i aktiviteten verkar bedragarna ha följt ett vanligt arbetsflöde för att föra sina måltavlor från första kontakt till bedrägliga investeringar:
Offentlig kontakt: Bedragarna kommenterade måltavlans inlägg på sociala medier. Kommentarerna avslutades ofta med en fråga som ”Vad tycker du om [ämne]?”, sannolikt för att öka chansen till kontakt. I ett fåtal fall kommenterade de politik, men oftare pratade de om golf.
Troliga direktmeddelanden: Bedragarna genererade sedan korta kommentarer i samtalston. Vi har inte full insyn i hur och var dessa användes, men kommentarerna stämde överens med en situation där bedragaren och måltavlan började utbyta direktmeddelanden.
Säkra meddelanden: Bedragarna genererade snart, ofta inom några dagar, meddelanden som föreslog att samtalet skulle flyttas till en säkrare meddelandeapp. Ibland motiverades det med att bedragaren inte litade på sociala medier. Andra gånger användes en praktisk ursäkt, till exempel att personen snart skulle resa till en plats utan tillgång till sociala medier.
Romantisk kontakt: Bedragarna skrev och översatte alltmer kärleksfulla och intima meddelanden. Om måltavlorna bad om foton på ”kvinnan” de chattade med kom bedragarna med ursäkter.
Ekonomisk involvering: Bedragarna skrev och översatte meddelanden där de skröt om att ha tjänat stora summor pengar på nätinvesteringar i valuta, kryptovaluta eller guld. Det framställdes ofta som resultatet av att ha följt råd från en släkting som arbetade inom finansbranschen. Bedragaren uppmanade måltavlan att börja investera på samma sätt och erbjöd sig att vägleda personen genom processen.
Bedrägeri: Bedragarna skrev och översatte meddelanden för att försöka övertyga offret att överföra pengar till en handelsapp och uppmuntrade personen genom att överdriva hur stor vinst investeringarna gav. Varje gång offret försökte ta ut sin ”vinst” kom bedragaren med en ursäkt, till exempel att en avgift först måste betalas.
Aktivitetsmönstret stämmer överens med offentligt tillgänglig rapportering(öppnas i ett nytt fönster) om hur sådana bedrägerier vanligtvis går till.
Påverkan
Aktiviteten verkar ha omfattat många misslyckade försök. Vissa av konversationerna som bedragarna bearbetade med våra modeller slutade med att måltavlan pekade ut aktiviteten som ett bedrägeri eller bad bedragaren att lämna personen i fred. Vi identifierade även inlägg som bedragarna hade publicerat på sociala medier men som inte fick någon respons alls.
I vissa konversationer nämndes dock belopp på tusentals dollar, eller motsvarande i andra valutor, som storleken på enskilda transaktioner. Med tanke på hur operatörerna använde våra modeller har vi ingen insyn i om dessa finansiella transaktioner genomfördes. Hänvisningarna i konversationerna tyder dock på att bedragarna i åtminstone vissa fall lyckades lura sina måltavlor på pengar.
OpenAI:s policyer förbjuder uttryckligen att resultat från våra verktyg används för bedrägerier. Vi arbetar aktivt med branschkollegor och myndigheter för att förstå hur AI används i skadliga aktiviteter och för att motverka bedrägerier som missbrukar våra tjänster. Som en del av detta arbete har vi delat information om de bedrägerinätverk vi stoppade med branschkollegor och berörda myndigheter.