Utvecklarens guide till GPT‑5.6
Tekniska lärdomar från startupföretag i produktion
Modellfamiljen GPT‑5.6 gör agentprestanda på banbrytande nivå betydligt mer överkomlig och flyttar samtidigt fram gränsen för vad som är möjligt.
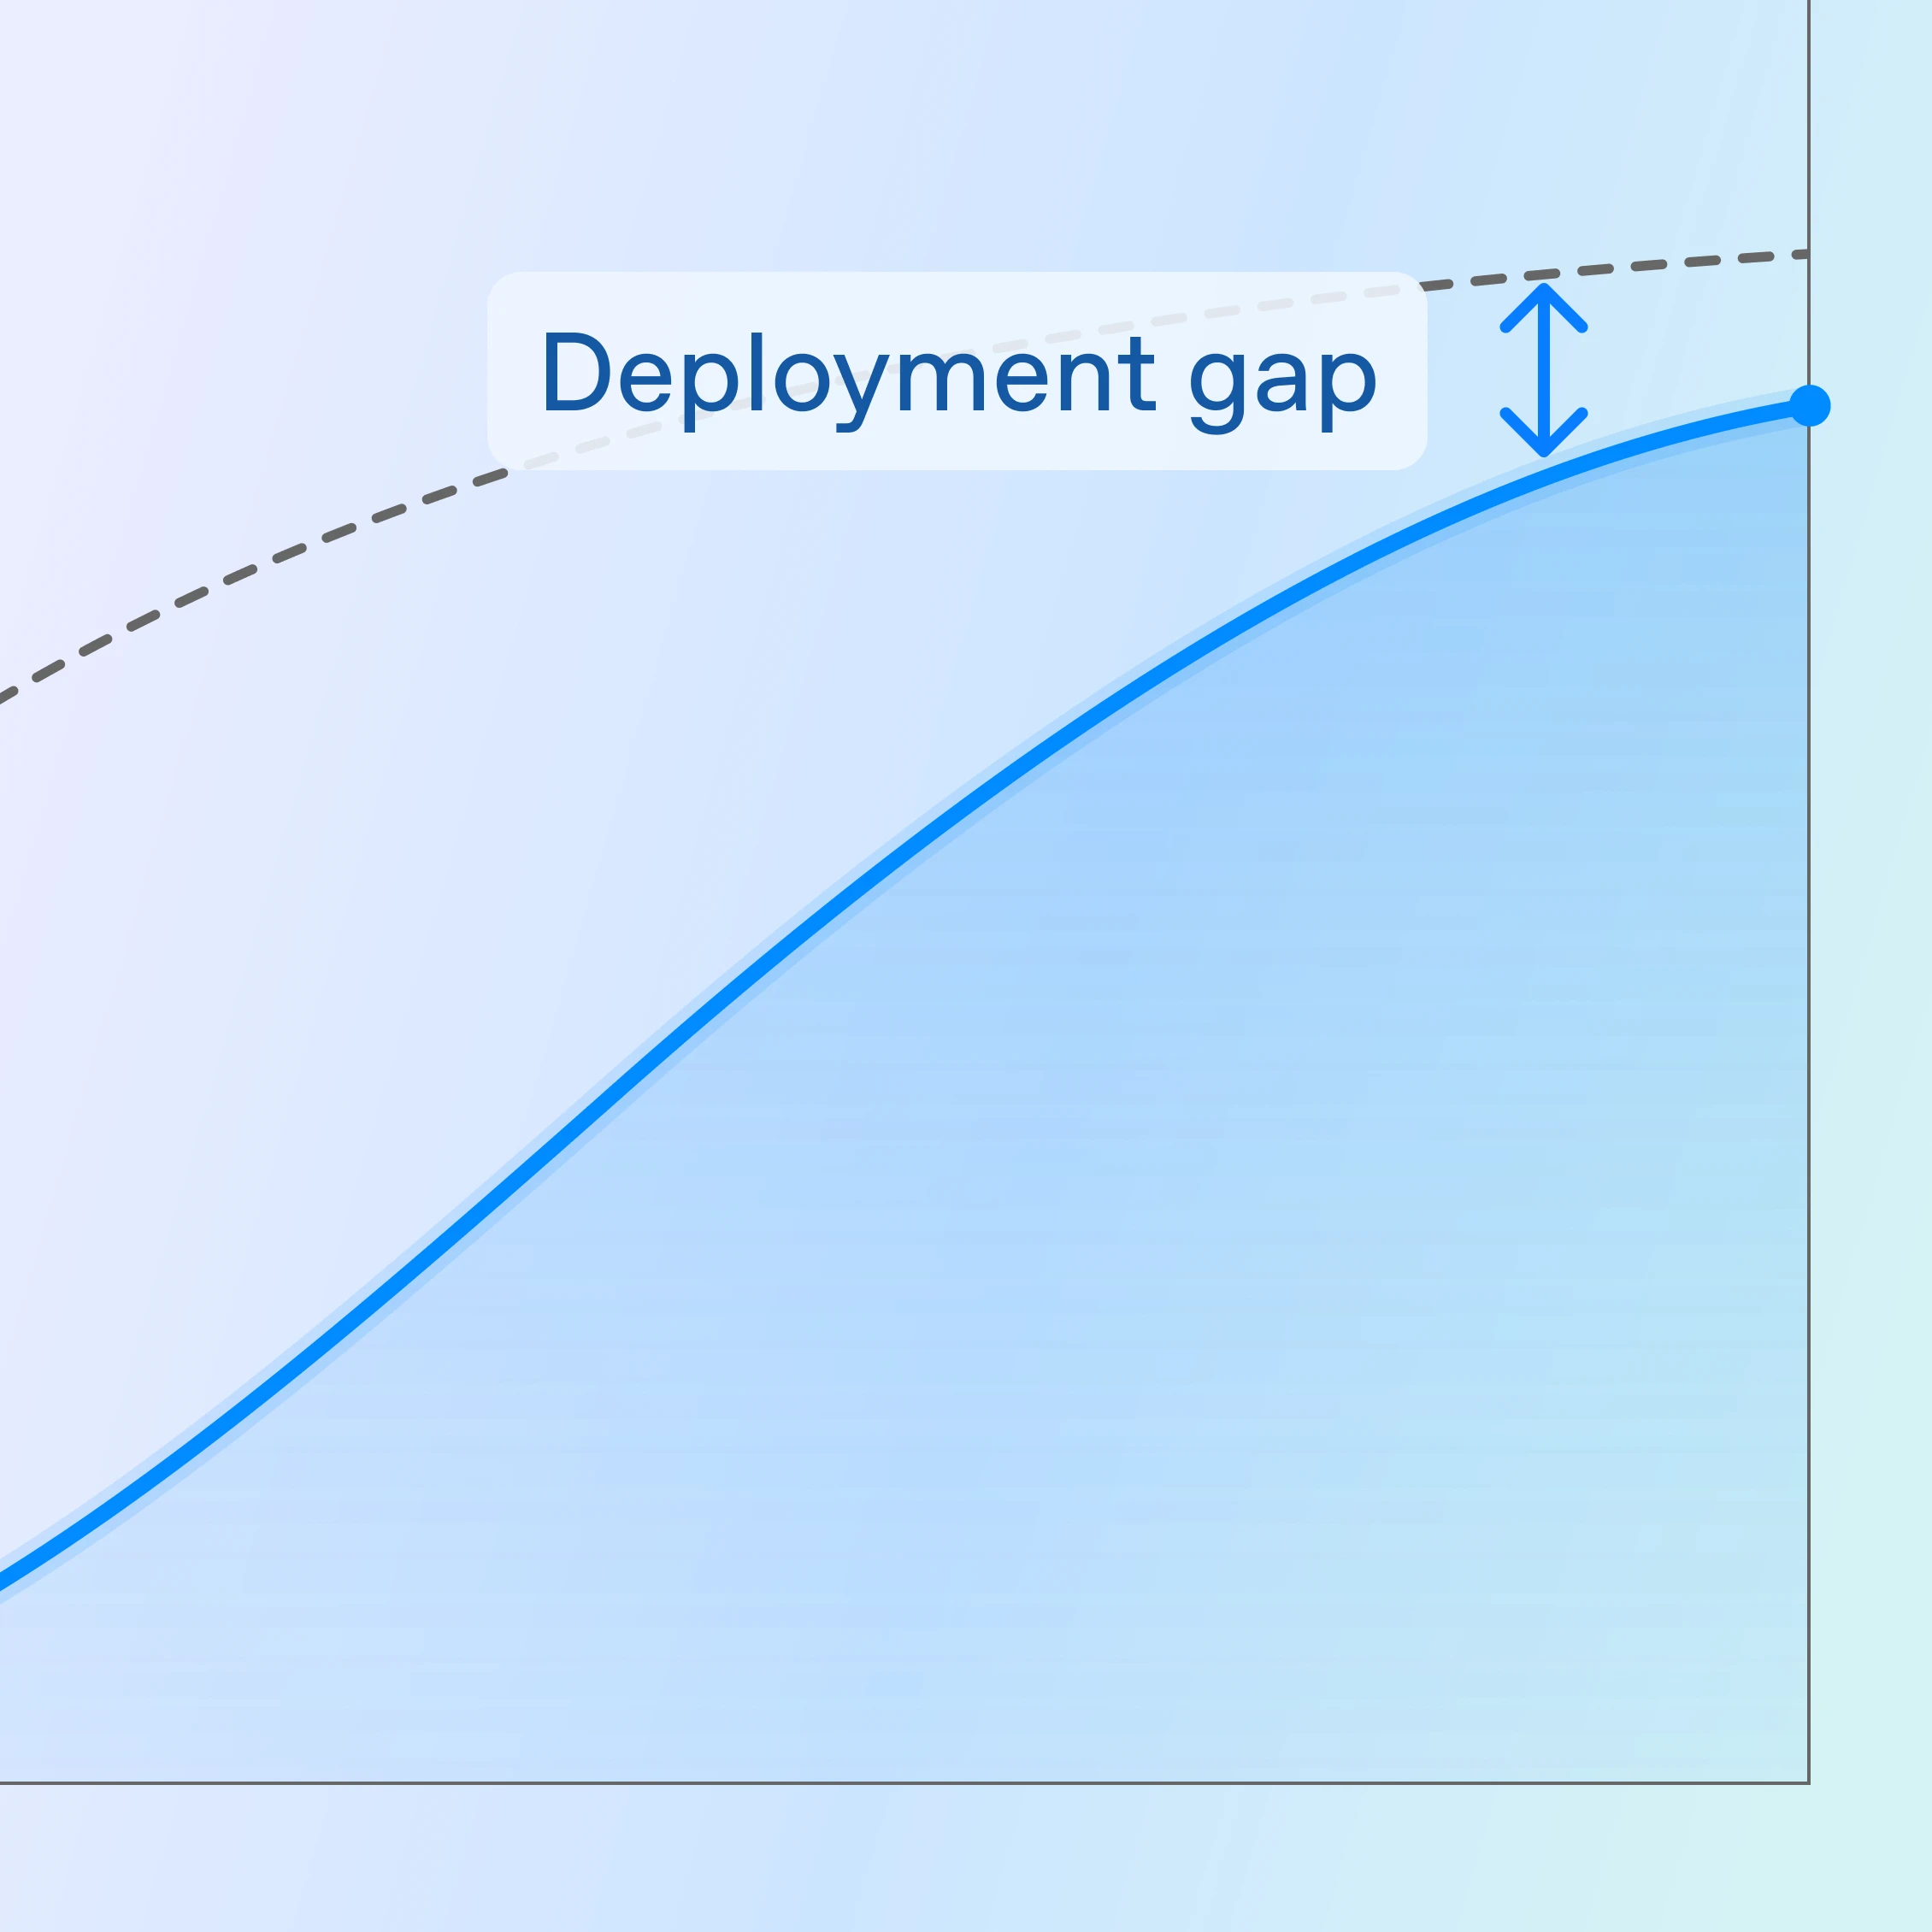
I den här guiden visar vi hur startupföretag bygger snabbare och mer kapabla agenter till en bråkdel av kostnaden genom smartare modellval och nya API-kontroller för kontinuitet i resonemang, orkestrering av flera agenter och programmatisk verktygsanropning.
Sedan GPT‑5 har varje ny modellgeneration strävat efter att hantera mer långvariga uppgifter med färre token. GPT‑5.6 fortsätter i samma riktning: starkare agentprestanda och lägre kostnader, med minimala ändringar i den underliggande körmiljön.
Den övergripande kostnadseffektiviteten förbättras ytterligare genom högre precision vid lägre resonemangsnivåer. I Agents’ Last Exam presterade exempelvis GPT‑5.6 Sol med ”låg” resonemangsnivå bättre än GPT‑5.5 med ”hög” resonemangsnivå när körmiljön hölls konstant. Vi har sett liknande framgångar i produktionstester, där startupföretag rapporterar betydande kostnadsminskningar i en rad arbetsflöden efter att ha sänkt resonemangsnivån från de tidigare standardinställningarna.
Historiskt sett har en uppgradering till en flaggskeppsmodell med högsta tillgängliga resonemangsnivå varit det bästa alternativet för långvariga användningsfall. Det har till stor del berott på att dessa modeller är betydligt bättre än kostnadsoptimerade modeller på att hantera längre kontexter och verktygsanrop. Detta har förändrats med 5.6-familjen: med mer beräkningskraft vid körning kan Luna och Terra ofta prestera i nivå med GPT‑5.4 och 5.5 till en betydligt lägre kostnad.
Ta uppgifterna i BrowseComp, ett sökbaserat riktmärke som testar en modells förmåga att hitta svåråtkomliga fakta. För tre månader sedan fick GPT‑5.5 (Extra hög) 84,36 % i detta riktmärke till en totalkostnad på 33,27 USD. Vid lanseringen ger GPT‑5.6 Luna (Extra hög) i princip samma prestanda: 84,04 % till en kostnad av 1,33 USD. Sedan dess har vi sänkt priserna ytterligare. Läs mer om våra senaste prissänkningar.
De mindre modellerna i 5.6-familjen passar väl för arbetsbelastningar med stora volymer, tidskänsliga interaktioner och återkommande steg i agentbaserade arbetsflöden. Om du exempelvis driver ett legaltechföretag som tolkar handskrivna anteckningar före agentbaserad analys behöver du inte längre använda en banbrytande modell för hela användningsfallet. Nu kan Terra eller Luna sköta extraktionen och ge betydande kostnadsbesparingar.
Utöver att förbättra GPT‑5.6 direkt från start lanserade vi även nya byggstenar i Responses API som möjliggör ytterligare vinster. Vi tränade GPT‑5.6 från början till slut med tre kompletterande arkitekturåtgärder som gör det möjligt för agenter att arbeta effektivare:
Återanvänd redan utfört arbete: genom att låta resonemang bevaras(öppnas i ett nytt fönster) mellan modellens turer och använda inbyggd komprimering(öppnas i ett nytt fönster) för att komprimera långvariga konversationer kan modellen hålla arbetet sammanhängande under längre uppgiftsförlopp utan att bli förvirrad eller behöva återskapa tidigare kontext.
Parallell uppdelning där det passar: med inbyggd orkestrering av flera agenter(öppnas i ett nytt fönster) går det att samordna flera agenter i parallella arbetsflöden och slutföra komplexa uppgifter snabbare.
Flytta deterministiskt arbete till kod: använd programmatisk verktygsanropning(öppnas i ett nytt fönster) för att filtrera, sammanställa och orkestrera verktygsutdata utanför modellens kontextfönster. Då kan modellens token reserveras för bedömningar, samtidigt som kostnad, svarstid och kontextförsämring minskar.
När de används tillsammans kan skillnaden bli dramatisk. I ARC-AGI-3 fick GPT‑5.6 Sol exempelvis 13,3 % med standardkörmiljön. När bevarade resonemang och komprimering aktiverades steg resultatet däremot till 38,3 % – samtidigt som ungefär sex gånger färre utdatatoken användes. Inga ändringar av modellen, men nästan tre gånger så hög prestanda. Du kan läsa mer i vår undersökning av körmiljön för ARC-AGI-3.
Agentbaserade arbetsflöden omfattar ofta två typer av arbete:
Uppgifter som kräver omdöme
Arbete som främst består i att flytta, filtrera och kombinera data
När en agent hämtar 100 rapporter, filtrerar dem efter datum och identifierar relevanta transaktioner ska modellen inte behöva resonera kring varje mellanresultat i sitt kontextfönster. Med programmatisk verktygsanropning kan GPT‑5.6 skriva JavaScript för att orkestrera verktyg, köra oberoende anrop parallellt och bearbeta deras utdata utanför kontextfönstret. Modellen kan då fokusera på det som kräver intelligens: att göra bedömningar.
I komplexa uppgifter som kan parallelliseras går det både snabbare att slutföra uppgiften och att nå högre intelligens genom att fördela åtgärder och resonemang mellan flera agenters arbetsflöden. I sådana konfigurationer ansvarar huvudagenten för att orkestrera underagenterna och delegera uppgifter till dem. Underagenterna arbetar parallellt mot sina mål och skickar slutligen tillbaka sina resultat till huvudagenten för en slutlig sammanställning. Team kan börja använda flera agenter direkt genom att aktivera flera agenter(öppnas i ett nytt fönster) i Responses API. Det är också så kapacitetsinställningen Ultra i ChatGPT fungerar.
“Qualia använder team av agenter för öppna forskningsproblem, och med GPT‑5.6 Sol föll allt på plats. Den var markant bättre än GPT‑5.5, blev klar snabbare än nästan alla andra modeller vi testade och blev snabbt vår förstahandsmodell från OpenAI.”
“GPT‑5.6 är den bästa orkestreraren vi har sett från OpenAI. Vi gav den sex specifikationer samtidigt – den skulle skriva, bygga och resonera kring dem alla – och den höll reda på allt utan att kvaliteten föll samman.”
Även om GPT‑5.6 har en god uppfattning om hur många underagenter som är lämpliga och när de bör startas, går beteendet med flera agenter att styra i hög grad. Genom att instruera modellen om när underagenter ska anropas ökar sannolikheten att agenter bara startas när den extra tokenförbrukningen ger bättre prestanda.
För hela modellfamiljen har promptcachens TTL förlängts till minst 30 minuter, och cachebrytpunkter kan nu anges deterministiskt inom en modells kontextfönster. Det har gjort det möjligt för startupföretag att avsevärt förbättra andelen cacheträffar.
Utöver att ange cachebrytpunkter ökar fortsatt användning av en lämplig prompt_cache_key(öppnas i ett nytt fönster) sannolikheten att förfrågningar hamnar på samma inferensmotor som tidigare hanterade samma prefix, vilket minskar svarstiden.
Det som sticker ut i dessa exempel är hur mycket ekonomin kring att bygga agenter har förändrats.
Användningsfall som tidigare krävde en banbrytande modell i varje steg kan nu uppnå jämförbara eller bättre resultat till en bråkdel av kostnaden genom mindre modeller, justerad resonemangsnivå och effektiva arkitekturval.
Vi ser fram emot att få se vad ni bygger!
- 2026
- API-plattform
Om författarna
Den här guiden har tagits fram av Samarth Madduru(öppnas i ett nytt fönster), Prashant Mital(öppnas i ett nytt fönster), Dave Leo(öppnas i ett nytt fönster) och Julien Reiman(öppnas i ett nytt fönster), utifrån deras erfarenheter av nära samarbete med startupföretag som byggt på GPT‑5.6, från tidiga tester till produktion.