Jalapeño: resultados iniciais mostram velocidade e eficiência líderes do setor em inferência de IA
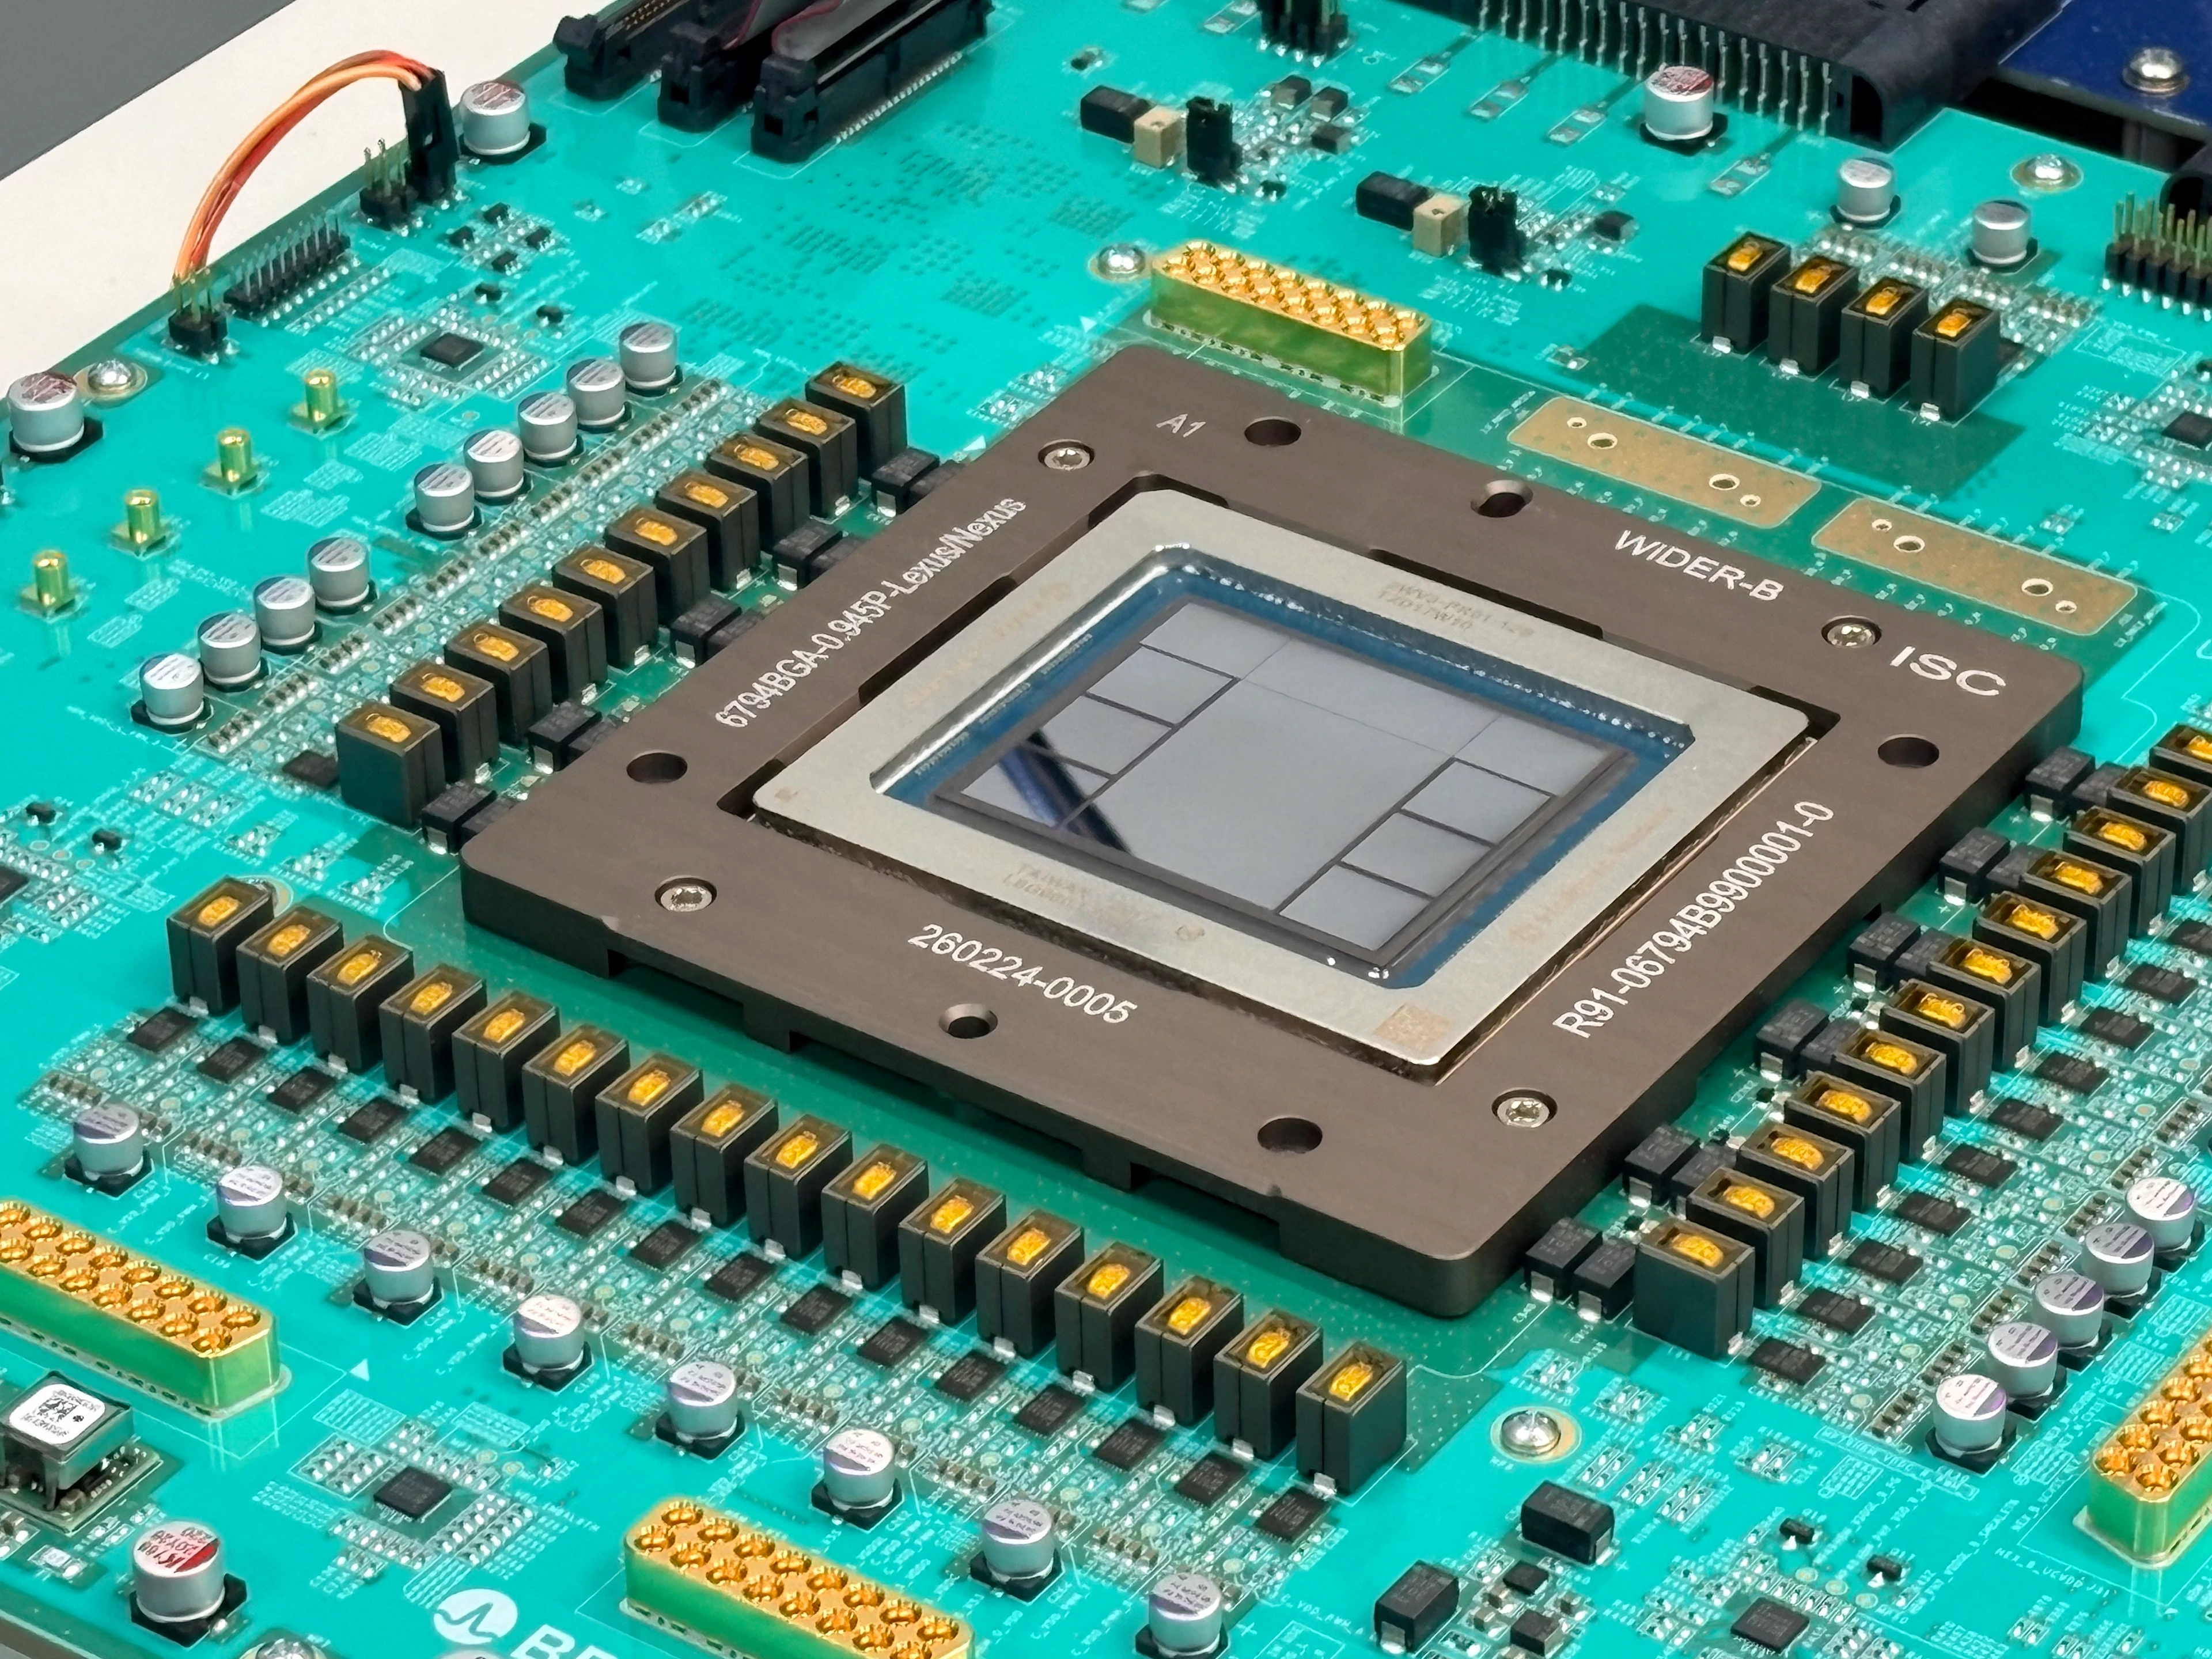
Desde que anunciamos o Jalapeño, o primeiro chip de inferência personalizado da OpenAI, temos testado o chip e o sistema construído em torno dele. Os resultados mostram um avanço significativo de desempenho: o Jalapeño consegue processar mais trabalho de IA por unidade de potência e, ao mesmo tempo, retornar respostas com mais rapidez. Com uma única arquitetura, o Jalapeño oferece maior taxa de processamento e menor latência, enquanto os sistemas de hardware atuais geralmente precisam fazer uma escolha entre as duas.
Para os clientes, isso pode significar respostas mais rápidas, agentes mais responsivos e acesso mais confiável à medida que a demanda aumenta. Nossa missão é garantir que a inteligência artificial geral beneficie toda a humanidade. Esses ganhos ajudarão a reduzir o custo de sistemas de IA cada vez mais capazes e a ampliar sua disponibilidade.
Os modelos da OpenAI também aceleraram o desenvolvimento do Jalapeño. As gerações anteriores ajudaram a equipe a projetar e colocar o chip em operação, enquanto nossos modelos mais recentes estão acelerando sua otimização e programação. O desempenho do Jalapeño abrange o GPT‑OSS 120B, o DeepSeek R1 e o Kimi K2.5 1T, mostrando que a arquitetura funciona com modelos desenvolvidos dentro e fora da OpenAI. Nos três modelos, o Jalapeño processou de 1,5 a 1,9 vezes mais trabalho de IA por watt no pico da taxa de processamento e apresentou latência de ponta a ponta de 1,7 a 3,6 vezes menor que a dos sistemas de comparação. Em cargas de trabalho altamente interativas, o desempenho foi de 2,1 a 4,1 vezes maior.
O Jalapeño também evidencia uma vantagem mais ampla decorrente da integração de toda a stack. A OpenAI pode projetar de forma integrada modelos, produtos, software de inferência, chips, memória, redes e sistemas, usando o que aprende com cargas de trabalho reais para melhorar cada camada da stack. O Jalapeño é um chip próprio em funcionamento, com resultados medidos, e marca o início de uma plataforma multigeracional. Nos próximos meses, ampliaremos a implantação do Jalapeño para oferecer produtos mais rápidos, capazes e eficientes aos nossos clientes.
Avaliamos o desempenho com uma experiência do usuário equivalente, medindo quanto trabalho útil de IA cada sistema consegue concluir por unidade de potência e mantendo a latência necessária para clientes e agentes interativos. Isso é especialmente importante para agentes, que precisam concluir muitas etapas em sequência, pois os atrasos podem se acumular ao longo de uma tarefa inteira.
Para entender o desempenho do Jalapeño na prática, nós o testamos no InferenceX, um benchmark público da SemiAnalysis que mede o processamento completo de uma solicitação de IA. Comparamos o Jalapeño a sistemas de IA líderes disponíveis comercialmente em toda a faixa de operação testada, desde a operação com alta taxa de processamento até o uso altamente interativo e de baixa latência. O Jalapeño apresentou uma combinação superior de taxa de processamento, eficiência energética e latência. Embora o desempenho às vezes seja informado por chip, acreditamos que a métrica mais útil seja o desempenho por unidade de potência.
Nos três modelos públicos, o Jalapeño apresentou uma combinação superior de desempenho por watt e latência em toda a faixa de operação testada, posicionando-se na fronteira de Pareto. Para comparar os sistemas de maneira consistente, normalizamos os resultados usando a potência nominal publicada para o chip de cada acelerador. A potência nominal do Jalapeño é de 700 watts, embora sua potência sustentada medida tenha permanecido igual ou inferior a 550 watts nas cargas de trabalho testadas.
O Jalapeño apresentou um desempenho sólido com o GPT‑OSS 120B, o DeepSeek R1 670B e o Kimi K2.5 1T. No Kimi, o maior modelo público que testamos, ele apresentou desempenho máximo por watt aproximadamente 1,5 vez maior e latência de ponta a ponta 3,4 vezes menor que o sistema de comparação. Em nossos testes internos, a vantagem do Jalapeño aumentou ainda mais nos modelos de ponta da OpenAI, o que sugere que a arquitetura se torna mais valiosa conforme as cargas de trabalho ficam maiores e mais exigentes.
O Jalapeño foi projetado desde o início a partir da seguinte pergunta: que hardware criaríamos se sua principal função fosse executar modelos de linguagem modernos e futuros, especialmente agentes interativos? Os ganhos do Jalapeño resultam do projeto integrado do chip, da memória, da rede, do software e do sistema em escala de rack, com base em cargas de trabalho reais de modelos de linguagem. A inferência de modelos de linguagem passa por várias fases distintas, cada uma com gargalos diferentes. O pré-preenchimento, quando o sistema processa um prompt, exige muita capacidade computacional; já a decodificação, quando o sistema gera a resposta token por token, é mais limitada pela largura de banda da memória. A comunicação também pode aumentar a latência quando os dados precisam transitar entre núcleos e chips, deixando algumas unidades de processamento ociosas durante a espera. Um sistema que se destaca em uma fase pode perder essa vantagem enquanto aguarda dados ou transfere o estado do modelo entre diferentes recursos.
Projetamos o Jalapeño para minimizar a movimentação de dados e os atrasos de comunicação. Isso permite posicionar explicitamente e manter local o estado do modelo, incluindo o cache KV usado durante a geração de uma resposta, enquanto o sistema ativa a combinação adequada de capacidade computacional, memória e rede para cada fase da inferência. A rede é parte integral da arquitetura. A ampla abrangência dessa rede permite que toda a carga de trabalho permaneça em um único sistema conectado, minimizando a movimentação de dados e ajudando a manter a solicitação completa rápida e eficiente do início ao fim. O resultado é um acelerador equilibrado e versátil, capaz de oferecer suporte a mudanças nas arquiteturas dos modelos, destacar-se tanto no pré-preenchimento quanto na decodificação e se adaptar à variação do equilíbrio entre essas fases — uma característica marcante das cargas de trabalho baseadas em agentes.
A IA teve participação direta no desenvolvimento do Jalapeño, permitindo que a equipe passasse do projeto inicial ao tapeout em nove meses por meio da exploração de implementações, do encurtamento dos ciclos de projeto, medição e verificação e da iteração contínua com cargas de trabalho de modelos. A IA também ajudou a otimizar os circuitos aritméticos do chip, permitindo que a equipe incorporasse mais desempenho computacional ao chip dentro do prazo.
O Jalapeño foi projetado como um alvo de programação claro e previsível para humanos e IA. Os engenheiros podem descrever o trabalho por meio de tensores locais, comunicação explícita e sincronização previsível. A IA pode então otimizar como esse trabalho é mapeado, alocado, escalonado e coordenado em todo o sistema. Essa estrutura clara e previsível oferece à IA uma forma viável de enfrentar o problema tradicionalmente difícil da programação paralela.
O suporte a cada nova família de modelos ainda exige novos kernels e otimizações específicas para cada modelo. Usando o Codex com o GPT‑Astra, a equipe levou três modelos com pesos abertos que não faziam parte do plano de produção original do Jalapeño a um alto nível de desempenho em dois meses. Isso demonstrou tanto a flexibilidade da arquitetura quanto a velocidade com que a IA pode nos ajudar a programá-la. Em blocos específicos de atenção e de mistura de especialistas do GPT‑OSS, as implementações geradas por IA foram de 1,5 a 1,8 vezes mais rápidas que as implementações existentes desenvolvidas por especialistas humanos. Esses números se aplicam aos blocos selecionados, não ao modelo completo, mas apontam para um novo e poderoso ciclo de desenvolvimento.
A infraestrutura de IA é valiosa pelo trabalho útil que viabiliza no mundo real. Ao produzir mais trabalho útil com a mesma potência e o mesmo hardware, o Jalapeño pode nos ajudar a atender a uma demanda maior e reduzir o custo de entregar um resultado bem-sucedido. Para a OpenAI, isso pode melhorar a alavancagem operacional ao permitir que o trabalho útil e a receita cresçam mais rápido que o custo operacional. Isso também pode favorecer uma adoção mais ampla e o investimento contínuo em modelos, produtos e infraestrutura melhores. Uma inferência mais rápida pode viabilizar iterações mais ágeis e novos casos de uso.
O Jalapeño amplia as possibilidades de inferência eficiente e de baixa latência:
Inferência no modo ultrarrápido com níveis de eficiência antes disponíveis apenas no modo rápido
Inferência no modo rápido com níveis de eficiência antes disponíveis apenas no modo em lote
Maior eficiência para inferência no modo em lote
Planejamos começar a implantar o Jalapeño na infraestrutura computacional da OpenAI até o fim do ano. É a primeira geração de um plano multigeracional: a Gen 2 está em estágio avançado de desenvolvimento, e a Gen 3 começa a tomar forma. Cada geração aproveitará nossos aprendizados e promoverá novos avanços em eficiência e velocidade.
Atender à crescente demanda por IA exigirá mais capacidade computacional de todas as fontes disponíveis. Continuaremos implantando amplamente aceleradores da NVIDIA e de outros parceiros para cargas de trabalho de treinamento e inferência. Nossa missão é garantir que a inteligência artificial geral beneficie toda a humanidade.
Enquanto nos preparamos para a implantação, continuamos qualificando o sistema para produção, amadurecendo o software, preparando-nos para operar o Jalapeño em larga escala e validando o desempenho com mais modelos. Os resultados até agora mostram o que é possível quando projetamos o sistema completo de forma integrada: IA mais responsiva, capaz e baseada em agentes, oferecida com mais eficiência a mais pessoas.
Fronteira de taxa de processamento por kW
InferenceX · GPT‑OSS‑120B · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB200 1.200 W
Taxa de processamento no pico e em velocidade equivalente
InferenceX · GPT‑OSS‑120B · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB200 1.200 W
Maior pico de TPS mistos/kW
≈1,9×
85.448 vs. 44.960 tokens mistos/kW
Menor latência de ponta a ponta
≈1,7×
1,03 s vs. 1,80 s
TBT mínimo mais baixo
≈2,7×
0,69 vs. 1,87 ms (1.459 vs. 535 tok/s/user)
Maior taxa de processamento no TBT anterior
≈53,7×
22.935 vs. 427 tokens mistos/kW (a 535,28 tok/s/user)
Fronteira de taxa de processamento por kW
InferenceX · DeepSeek R1 MXFP4 · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB300 1.400 W
Taxa de processamento no pico e em velocidade equivalente
InferenceX · DeepSeek R1 MXFP4 · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB300 1.400 W
Maior pico de TPS mistos/kW
≈1,7×
19.641 vs. 11.781 tokens mistos/kW
Menor latência de ponta a ponta
≈3,6×
1,65 s vs. 5,99 s
TBT mínimo mais baixo
≈4,1×
1,43 vs. 5,90 ms (700 vs. 169 tok/s/user)
Maior taxa de processamento no TBT anterior
≈104,3×
12.258 vs. 118 tokens mistos/kW (a 169,41 tok/s/user)
Fronteira de taxa de processamento por kW
InferenceX · Kimi K2.5 MXFP4 · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB300 1.400 W
Taxa de processamento no pico e em velocidade equivalente
InferenceX · Kimi K2.5 MXFP4 · nominal 8k/1k · STP · TDP do encapsulamento: Jalapeño 700 W; GB300 1.400 W
Maior pico de TPS mistos/kW
≈1,5×
18.195 vs. 11.862 tokens mistos/kW
Menor latência de ponta a ponta
≈3,4×
1,56 s vs. 5,31 s
TBT mínimo mais baixo
≈3,8×
1,44 vs. 5,48 ms (694 vs. 182 tok/s/user)
Maior taxa de processamento no TBT anterior
≈56,1×
6.744 vs. 120 tokens mistos/kW (a 182,46 tok/s/user)