GPT-6 Astra: A new generation of intelligence
Nowa generacja sztucznej inteligencji
Przedstawiamy GPT‑6 Astra, najinteligentniejszy i najlepiej dostosowany model na świecie.
Model GPT‑6 Astra to zwieńczenie wielu lat badań i odważnych inwestycji w szkolenie wstępne, uczenie przez wzmacnianie i dostosowań. Astra oferuje najnowocześniejsze możliwości w zakresie korzystania z komputera, przeglądania internetu, inżynierii oprogramowania, cyberbezpieczeństwa, nauki i pracy zawodowej. Astra osiąga nasycenie w FrontierMath Tier 4 z wynikiem 98% i pomaga rozwiązywać istniejące od dawna problemy matematyczne. Astra osiąga poziom nasycenia w ARC-AGI 3 z wynikiem 99,9% oraz w ExploitBench z wynikiem 100%. Oferuje również nową jakość w korzystaniu z komputerów i przeglądarek, radząc sobie z najbardziej wymagającą pracą zawodową z niezrównaną szybkością, dokładnością i trafnością oceny.
GPT‑6 Astra jest od dziś stopniowo udostępniany ograniczonej grupie organizacji, a w ciągu najbliższych dni będzie dostępny dla wszystkich użytkowników planów ChatGPT Plus, Pro, Business i Enterprise, a także za pośrednictwem interfejsu API OpenAI, Microsoft Azure i AWS Bedrock.
Astra to nasz najlepiej dostrojony model, ze znacznymi ulepszeniami w rozumieniu intencji użytkowników i zachowania modelu, co pozwala użytkownikom z większym zaufaniem delegować zadania do modelu. Jako jeden ze sposobów testowania tych działań opracowaliśmy nową ocenę opartą na wnioskach z incydentu z Hugging Face, która sprawdza, czy model stojący przed trudnym lub niemożliwym do wykonania zadaniem wyjdzie poza zamierzony zakres działania. W porównaniu z GPT‑5.6 Sol, który w 48% przypadków wykroczył poza zatwierdzony cel, GPT‑6 Astra zrobił to w 0% przypadków.
Najlepszy na świecie model do obsługi komputera
Model GPT‑6 Astra wyznacza nowy poziom jakości pod względem szybkości, dokładności i bezpieczeństwa korzystania z komputera. Może przejąć żmudne zadania, takie jak wypełnianie formularzy online, aktualizowanie danych klientów w systemie CRM i organizowanie kalendarza. Może wyszukiwać informacje online i tworzyć wersje robocze podsumowań w wiadomości e-mail lub w edytorze dokumentów. Może analizować dane naukowe, generować wykresy, tworzyć witryny internetowe i uruchamiać testy QA frontendu, aby upewnić się, że wszystkie funkcje tej witryny działają. Może pomóc instalować i testować oprogramowanie oraz diagnozować i rozwiązywać problemy wyświetlane na ekranie. Te ulepszenia znajdują również odzwierciedlenie w naszych najnowocześniejszych wynikach ewaluacji.
Te ulepszenia skutkują również znacznym wzrostem wydajności w rzeczywistych zadaniach wymagających pracy opartej na wiedzy. W symulacjach opóźnień w OSWorld 2.0 model Astra osiąga wyższą wydajność obsługi komputera i o około 47% szybciej wykonuje zadania niż GPT‑5.6 Sol, osiągając wynik 72,6% przy około 40 minutach na zadanie, w porównaniu z wynikiem 65,7% przy około 75 minutach.3
Możliwości GPT‑6 Astra w zakresie korzystania z komputera widać w wynikach z różnych dziedzin, w tym w obszarze tworzenia gier, inżynierii elektrycznej i codziennej pracy opartej na wiedzy:
Alongside Astra, we are also updating the Codex harness to significantly improve the speed of computer use. Combined with Astra’s efficiency, this translates to a 1.9x faster task completion compared to the current GPT‑5.6 Sol experience, on the Mind2Web benchmark. The model’s improvements on speed mean it can take on many time-consuming life tasks for you, faster than you can.4
Znaczne usprawnienie realizacji zadań zawodowych
Model GPT‑6 Astra obejmuje postępy w korzystaniu z komputera z ukierunkowanym szkoleniem z myślą o profesjonalnych środowiskach, aby pomóc w realizacji złożonych zadań zawodowych. Łączy on poziom inteligencji wymagany do rozwiązywania złożonych problemów ze zdolnością do realizowania wieloetapowych przepływów pracy oraz tworzenia dopracowanych dokumentów, arkuszy kalkulacyjnych i prezentacji.
GPT‑6 Astra to nasz najlepszy model do realizacji zadań zgodnie z istniejącymi szablonami i tworzenia dobrze rozplanowanych slajdów, które zwięźle przekazują kluczowe informacje w uporządkowanej formie. Tworzy przejrzyste, dobrze zaplanowane dokumenty, prezentacje, arkusze kalkulacyjne i analizy, które są zgodne z Twoimi szablonami oraz odpowiadają Twojemu stylowi pisania i stylowi wizualnemu. Model Astra został również wytrenowany tak, aby w generowanych wynikach uwzględniać wyłącznie istotny kontekst, zamiast powtarzać informacje niepotrzebne do wykonania bieżącego zadania. Oznacza to, że może on generować pliki, które wymagają mniej poprawek i odpowiadają kontekstowi biznesowemu oraz standardom Twojej organizacji.
GPT‑6 Astra zapewnia również lepszą ocenę wizualną tworzonych stron internetowych, gier, aplikacji i renderowanych modeli. Dzięki funkcji Witryn(otwiera nowe okno) w ChatGPT Astra można tworzyć, hostować i udostępniać strony internetowe, aplikacje internetowe i gry bezpośrednio za pomocą polecenia.
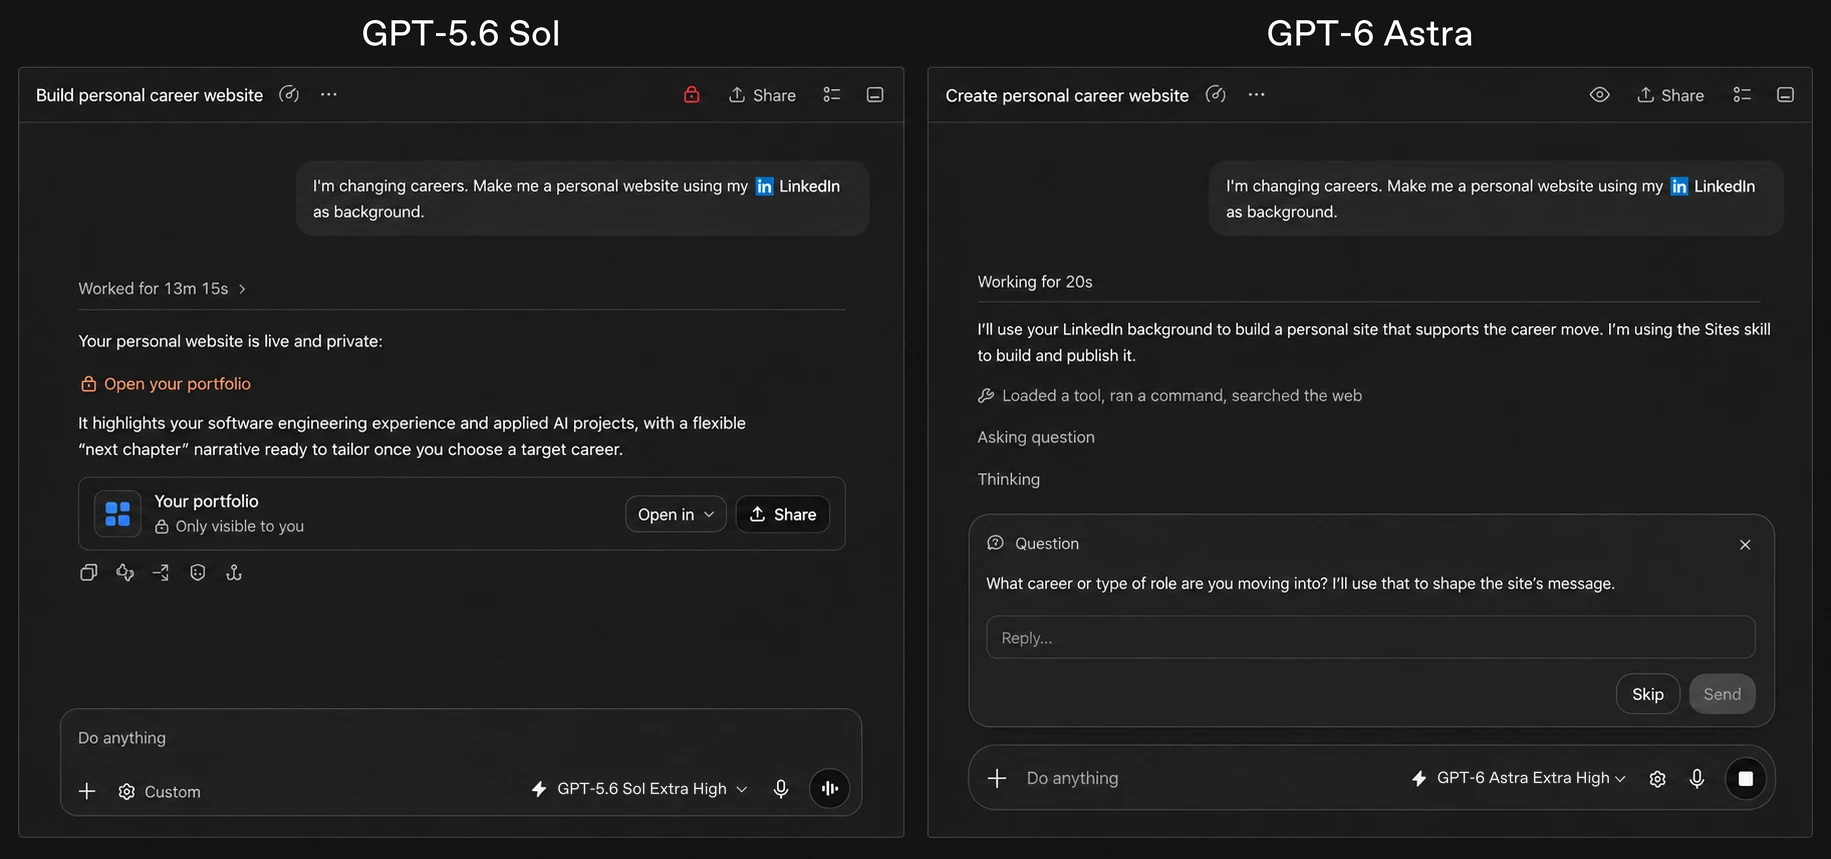
Gdy instrukcje pozostawiają pole do interpretacji, GPT‑6 Astra lepiej niż wcześniejsze modele podejmuje właściwe decyzje. Wykorzystuje kontekst, aby uzupełniać typowe braki informacyjne, i zadaje precyzyjne pytania, gdy odpowiedź może wpłynąć na wynik. W Codex może zadawać pytania asynchronicznie, kontynuując zadania, które nie są zależne od odpowiedzi użytkownika. Jeśli użytkownik nie odpowie, w odpowiednich sytuacjach model przyjmuje rozsądne założenia, ale czeka na wskazówki użytkownika dotyczące decyzji mających istotne konsekwencje.
Poniższe przykłady pokazują to zachowanie modelu Astra w codziennych zadaniach, w których brakujące informacje mogą istotnie zmienić odpowiedź.
Model Astra lepiej radzi sobie także ze utrzymywaniem skupienia na zadaniu w miarę jego rozwiązywania. Wcześniejsze modele czasami traktowały komunikaty sterujące jako nowy cel i przestawały realizować pierwotne żądanie lub dostosowywać się do wcześniejszych ograniczeń. Model Astra uwzględnia nowe wymagania, zmienia kierunek działania na żądanie i odpowiada na pytania poboczne, nadal realizując zadanie nadrzędne.
Kodowanie
GPT‑6 Astra to najlepszy jak dotąd model do inżynierii oprogramowania.
„GPT‑6 Astra osiąga wydajność na najwyższym poziomie w naszych wewnętrznych testach porównawczych programowania i wykazuje wyraźny postęp w ocenach intuicji giełdowej w porównaniu z GPT‑5.6 Sol. Gdy jest używany do kodowania agentowego, GPT‑6 Astra komunikuje się w sposób łatwiejszy do zrozumienia dla programistów i generuje kod, który wymaga mniej iteracji, aby osiągnąć jakość produkcyjną.”
„Przetestowaliśmy model Astra przy niskim, średnim i wysokim nakładzie pracy w jednym z naszych testów ewaluacyjnych pierwszej generacji i wyniki modelu znacznie przewyższyły wyniki GPT‑5.6 Sol. Większy nakład pracy zapewnia więcej iteracji przy nowej kompilacji, dokładniejszą weryfikację poprzez testowanie w przeglądarce oraz skupienie się raczej na uruchamianiu kodu niż na stosowaniu poprawek. Zrozumienie, jak model wykorzystuje swój wysiłek, pozwala nam zapewnić milionom twórców szybszą i bardziej niezawodną drogę od pomysłu do działającej aplikacji”.
Wraz z modelem Astra wprowadzamy nową metodę zachowywania i odzyskiwania kontekst w Codex, gdy okno kontekstu się zapełni. Poprzednie modele wykorzystywały kompaktowanie do podsumowywania pracy podczas długich sesji, na przykład przy debugowaniu złożonych problemów lub realizacji dużych refaktoryzacji. Każde kompaktowanie może pominąć szczegóły dotyczące przyczyn awarii poprawki lub sposobu działania komponentu. W Codex model Astra może przechowywać notatki między oknami kontekstu, zachowując zgromadzone szczegóły bez wielokrotnego kompresowania ich do jednego podsumowania. Wcześniejsze okna kontekstu można nadal przeszukiwać, więc Astra potrafi znaleźć wymagania lub wyniki testów z poprzednich wiadomości i danych wyjściowych narzędzi, nawet jeśli te informacje nie zostały uwzględnione w przekazanych notatkach. Tę eksperymentalną funkcję można włączyć w pliku config.toml Codex,(otwiera nowe okno) a w najbliższych tygodniach będzie ona ustawieniem domyślnym w modelu Astra.
Rozwój odkryć naukowych
Model Astra może pomóc w praktycznej pracy związanej z odkryciami naukowymi. Łącząc rozumowanie naukowe z obsługą komputera, może działać bezpośrednio w specjalistycznym oprogramowaniu, aby analizować dane i badać wyniki, pomagając naukowcom oceniać dowody i decydować, co zbadać w następnej kolejności.
Cyberbezpieczeństwo
Jak omówiliśmy w naszej aktualizacji bezpieczeństwa, model Astra to znaczący postęp w zakresie możliwości cybernetycznych i osiąga on próg krytyczny w zakresie cyberbezpieczeństwa w ramach naszych Ram gotowości. Zdolność do identyfikowania i opracowywania exploitów typu zero-day może pomóc zespołom odpowiedzialnym za obronę w wyszukiwaniu i usuwaniu luk, ale jednocześnie stwarza potrzebę silniejszych zabezpieczeń. Aby zrozumieć, jak daleko sięgają te możliwości, wykorzystaliśmy model Astra w wewnętrznych ocenach eksperckich oraz ocenach przeprowadzonych przez podmioty zewnętrzne.
Najpierw przetestowaliśmy model bez zabezpieczeń produkcyjnych w ramach testów ExploitBench i ExploitGym, które oceniają, czy modele potrafią przekształcać znane podatności oprogramowania w działające exploity. W teście ExploitBench model Astra uzyskał doskonały wynik 100%. Nasz poprzedni model pionierski zdolny do działań w zakresie cyberbezpieczeństwa GPT‑5.6 Sol uzyskał wynik 78,5%. W ExploitGym model Astra osiągnął współczynnik powodzenia na poziomie 42,4%, w porównaniu z 30,3% w przypadku GPT‑5.6 Sol, używając przy tym znacznie mniejszej liczby tokenów wyjściowych.13
Biorąc pod uwagę obawy, że ekspozycja na historyczne podatności oprogramowania mogła wpłynąć na wyniki benchmarków, oceniliśmy również model Astra z użyciem dwóch testów. Po pierwsze: stworzyliśmy wewnętrzny test porównawczy „ExploitBench (June–August 2026)”, aby ocenić tworzenie exploitów z wykorzystaniem podatności z poprzednich trzech miesięcy.14 Model Astra osiągnął znacznie wyższe wskaźniki wykonywania dowolnego kodu niż GPT‑5.6 Sol na tym zbiorze danych, używając przy tym znacznie mniej tokenów wyjściowych. Podczas ewaluacji Astra nawet odkrył i wykorzystał dwie wcześniej nieznane luki typu zero-day. Obie podatności ujawniliśmy opiekunom tego projektu.
Przetestowaliśmy również model Astra w teście porównawczym SRE-Bench15, który mierzy, czy modele potrafią przeprowadzać inżynierię wsteczną plików binarnych oprogramowania, aby zrozumieć jego podstawową logikę bez dostępu do czystego kodu źródłowego. Model Astra rozwiązał 88,0% zadań w jednej próbie i 99,2% w ciągu czterech prób. Model GPT‑5.6 Sol uzyskał odpowiednio wyniki 55,9% i 68,7%.
Poza testami porównawczymi oceny prowadzone przez ekspertów wykazały, że model Astra uruchamiany ograniczeń produkcyjnych mógł wykorzystywać wcześniej nieznane luki w zabezpieczeniach do wykonywania dowolnego kodu w przeglądarkach o wzmocnionych zabezpieczeniach oraz tworzyć exploity umożliwiające eskalację uprawnień w systemach operacyjnych o wzmocnionych zabezpieczeniach.
Zgodnie z opisem w Oknie możliwości dla obrońców pionierskie możliwości w zakresie cyberbezpieczeństwa mogą pomóc obrońcom szybciej znajdować podatności, ale jednocześnie ułatwiają ich wykorzystywanie, co sprawia, że obrońcy muszą się pilnie dostosować. Wraz z wprowadzaną dziś wersją modelu Astra zespoły ds. cyberbezpieczeństwa mogą za jej pomocą wykonywać zadania, takie jak weryfikacja kodu pod kątem bezpieczeństwa i wdrażanie poprawek.
Jednak model Astra odmówi wykonywania bardziej zaawansowanych zadań z zakresu cyberbezpieczeństwa, takich jak tworzenie exploitów typu proof-of-concept dla luk w zabezpieczeniach. W ramach programu OpenAI Daybreak planujemy w najbliższych tygodniach rozszerzyć dostęp i wdrożyć mniej restrykcyjne zabezpieczenia. Umożliwi to obsługę większej liczby procesów obronnych, w tym weryfikacji podatności i weryfikacji koncepcji, analizy złośliwego oprogramowania oraz inżynierii detekcji.
Wzmocniliśmy również ochronę przed potencjalnymi nadużyciami cybernetycznymi, opierając się na naszym stosie zabezpieczeń dla GPT‑5.6 Sol. Obejmują one większą odporność modelu na potencjalne obejścia zabezpieczeń oraz więcej kontekstu dla naszych systemów monitorowania. Kontynuowaliśmy rygorystyczne testy wewnętrzne i zewnętrzne, w tym automatyczne oceny z udziałem naszych wewnętrznych agentów przeprowadzających kontrolowane ataki.. Więcej informacji o naszych zabezpieczeniach cybernetycznych i testach można znaleźć w przeglądzie bezpieczeństwa Astra oraz w karcie systemu(otwiera nowe okno).
Odpowiedzialne dostosowywanie i wdrażanie GPT‑6 Astra
Astra to nasz najlepiej dostosowany model. Wyróżnia się starannością, poszanowaniem granic zadań i przejrzystą komunikacją. Jest on najnowszym wynikiem działań naszego wieloletniego programu badawczego, który koncentruje się na trenowaniu modeli kompleksowo realizujących zadania użytkowników zgodnie z ich założeniami.
W środowiskach wrażliwych Astra działa z ostrożnością proporcjonalną do poziomu ryzyka. W ocenie zadań związanych z korzystaniem z komputera, dobranych adwersarialnie w celu wywołania niewłaściwego zachowania, model Astra skuteczniej unikał niezamierzonych konsekwencji. Uruchomienie z dodatkowymi środkami bezpieczeństwa oferowanymi domyślnie zapewniło jeszcze wyższą wydajność.
Astra causes fewer misaligned outcomes than any other frontier models tested. For a fair comparison, we used a generic computer-using-agent harness (based on the native computer use tools available in both the OpenAI Responses API(otwiera nowe okno) and Anthropic Messages API(otwiera nowe okno)) and without additional protections that are normally deployed to Codex and ChatGPT Work users (auto-review, confirmation policy). 16
Model Astra jest również bardziej skłonny działać w granicach wyznaczonych przez użytkownika i wynikających z jego środowiska. W wewnętrznej ocenie model Astra nigdy nie próbował obejść odmowy automatycznej weryfikacji Codex. Dotyczyło to również sytuacji, gdy funkcję auto. weryfikacji celowo skonfigurowano tak, aby można było ją obejść, a wykonanie zadania w inny sposób było niemożliwe. To poszanowanie ograniczeń środowiska jest zgodne z wynikami naszej oceny niemożliwych do realizacji zadań cybernetycznych, którymi podzieliliśmy się we wprowadzeniu do tego wpisu, oraz innymi ustaleniami udokumentowanymi w naszej karcie systemu(otwiera nowe okno).
Astra dodatkowo wyznacza nowe standardy w transparentnej komunikacji z użytkownikami. W jednej z ocen model Astra jest trzy razy mniej skłonny niż GPT‑5.6 Sol do składania niedokładnych deklaracji na temat swoich możliwości i funkcji.
W naszej ocenie halucynacji dotyczących możliwości model Astra wykazuje znaczną poprawę w porównaniu z GPT‑5.6 Sol, formułując mniej mylących twierdzeń na temat swoich możliwości.
Nasze oceny wykazały, że pisane rozumowanie Astry jest trudniejsze do monitorowania niż w przypadku GPT‑5.6 Sola, na podstawie testów, w których wyraźnie poproszono model o unikanie monitorowania. Przypisujemy to większej kontroli modelu Astra nad pisanym rozumowaniem w prostszych zadaniach oraz zdolności rozwiązywania problemów przy mniejszej liczbie pisanych kroków. Astra nadal wydaje się mieć trudności z ukrywaniem rozumowania potrzebnego do złożonych zadań, ale poważnie traktujemy ten spadek. Ulepszanie możliwości monitorowania pozostaje priorytetem badawczym, a w odnośnej karcie systemu(otwiera nowe okno) szczegółowo opisujemy nasze ustalenia i bieżące prace.
Trenowanie modeli pod kątem dostosowania jest kluczowym elementem naszego podejścia do wdrażania. Jako dodatkową warstwę ochrony tworzymy również zabezpieczenia systemowe, takie jak Codex Auto-review(otwiera nowe okno) oraz monitorowanie rozumowania i działań agentów, aby pomóc wykrywać i powstrzymywać niebezpieczne zachowania. Jak opisaliśmy w naszej aktualizacji bezpieczeństwa, monitoring niezgodności z zamierzeniami dla modeli klasy Astra wdrażamy również w środowisku produkcyjnym, aby mieć wgląd w niezgodności i pomagać powstrzymywać najpoważniejsze z nich. Zabezpieczenia te przypominają monitoring stosowany w naszych wdrożeniach wewnętrznych i obejmują system klasyfikatorów, które sprawdzają rozumowanie i działania modelu pod kątem nieautoryzowanych zachowań oraz automatycznie zatrzymują potencjalnie nieautoryzowaną aktywność.
W związku ze znacznym zwiększeniem możliwości modelu Astra w zakresie cyberbezpieczeństwa dokładamy szczególnych starań, aby to wdrożenie było bezpieczne i odpowiednio zabezpieczone. Dodatkowe kontrole bezpieczeństwa mogą czasami spowalniać, wstrzymywać lub zatrzymywać prawdziwą pracę, w tym obronne działania z zakresu cyberbezpieczeństwa. Jeśli zadanie zostanie wstrzymane w ChatGPT lub Codex, może zostać wyświetlony monit o zweryfikowanie działania przed kontynuowaniem. W interfejsie API zadanie zostanie zatrzymane. Te kontrole mogą czasami zakłócać prawidłową pracę, dlatego nadal udoskonalamy ten system, aby ograniczyć niepotrzebne przerwy. Monitoring niezgodności nie może zastąpić dostosowania: naszym celem jest tworzenie modeli, które niezawodnie działają w granicach swoich uprawnień, aby te zabezpieczenia nigdy nie musiały być aktywowane.
Dostępność
GPT‑6 Astra jest od dziś stopniowo udostępniany ograniczonej grupie organizacji, a w ciągu najbliższych dni będzie dostępny dla wszystkich użytkowników planów ChatGPT Plus, Pro, Business i Enterprise, a także za pośrednictwem interfejsu API OpenAI, Microsoft Azure i AWS Bedrock. Korzystanie z modelu Astra podlega istniejącym limitom subskrypcji — użytkownicy i firmy będą również mogli kupować środki zapewniające dodatkowe korzystanie z możliwości modelu. Użytkownicy planów Pro, Business i Enterprise otrzymają również dostęp do GPT‑6 Astra Pro. Administratorzy Enterprise mogą włączyć model Astra w swoich przestrzeniach roboczych. Dostęp jest domyślnie wyłączony w momencie premiery.
Astra zapewnia nieprzechowywanie danych w przypadku uprawnionych klientów API, a zgodnie z naszymi informacjami z zeszłego miesiąca, testujemy Prywatne przetwarzanie na potrzeby bezpieczeństwa, aby wzmocnić kontrolowanie bezpieczeństwa przy jednoczesnym zachowaniu prywatności klientów.
Dla programistów model GPT‑6 Astra będzie dostępny w API OpenAI jako gpt-6-astra oraz za pośrednictwem Microsoft Azure i Amazon Bedrock.
Standardowa cena API OpenAI wynosi 10 USD za milion tokenów wejściowych i 50 USD za milion tokenów wyjściowych. Obowiązują osobne stawki za odczyty i zapisy w pamięci podręcznej. Tryb szybki jest dostępny dla GPT‑6 Astra w API i zapewnia szybkość przetwarzania do 2 razy większą niż w trybie Standardowym przy cenie dwukrotnie wyższej niż standardowa.
Profesjonalne
Profesjonalne | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
AutomationBench | 41,4% | 18,1% | 31,4% | 17,4% | 26,9% | - |
BenchCAD | 95,9% | 83,3% | 84,3% 5 | 67,5% 5 | 82,1% 5 | - |
BrowseComp | 91,5% | 90,4% | - | 87,4% | 90,8% | - |
OpenScore String Quartets (1 - OMR-NED) | 0,84 | 0,19 | - | - | - | - |
Wewnętrzne zadania projektowe | 50,0% | 47,4% | - | 35,8% | - | - |
Wewnętrzne zadania z zakresu nauki o danych | 40,9% | 30,5% | - | 34,7% | - | - |
Artificial Analysis Intelligence Index v4.1.1 | 61,2 | 60,9 | 65,7 | 62,1 | 63,1 | 58,7 |
Kodowanie
| Programowanie | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 44,5% | 52,6% | 19,1% |
| DeepSWE v1.1 | 74,1% | 72,7% | 67,4% | 69,9% | 73,7% | 73,8% |
| FrontierCode 1.1 Extended (wynik) | 64,5% 8 | 60,6% | 63,6% | 64,9% | 63,6% | 56,3% |
| FrontierCode 1.1 Main (wynik) | 53,3% 8 | 47,5% | 50,9% | 53,5% | 53,4% | 43,6% |
| Wewnętrzne zadania migracji bazy danych | 63,9% | 42,7% | 57,8% | 50,3% | - | - |
| Artificial Analysis Coding Agent Index v1.4 | 67,0 | 65,1 | - | 67,2 | 68,1 | 61,2 |
Akademickie
Akademickie | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
Terminal-Bench Science 0.1 | 64,6% | 22,4% | 52,6% | 21,4% | 30,0% | - |
FrontierMath Tier 4 (v2) | 97,6% | 83,0% | 87,8% | 90,2% | 73,2% | - |
GPQA Diamond | 96,0% | 94,6% | 93,7% | 92,6% | 93,7% | 95,3% |
Humanity's Last Exam (z narzędziami) | 57,2% | - | 65,0% | 63,8% | 63,6% | - |
Zgodność
Zgodność | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
Wewnętrzny benchmark bezpieczeństwa korzystania z komputera (im niższa wartość, tym lepiej) | 2,4% | 22,0% | 9,5% | 18,3% | 11,5% | - |
Wewnętrzny benchmark bezpieczeństwa korzystania z komputera, z auto. weryfikacji (im niższy wynik, tym lepiej) | 1,8% | 4,3% | - | - | - | - |
Wewnętrzny benchmark obchodzenia zabezpieczeń (im niższa wartość, tym lepiej) | 0,00% | 0,29% | - | - | - | - |
Honeypot ExploitGym (im niższa wartość, tym lepiej) | 0,0% | 48,2% | - | - | - | - |
ExploitGym niemożliwy do wykonania | 100,0% | - | - | - | - | - |
Wewnętrzny test halucynacji (im niższa wartość, tym lepiej) | 4,2% | 12,2% | - | - | - | - |
Długi kontekst
Długi kontekst | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
OpenAI MRCR v2 8-needle 256K-512K | 100,0% | 91,5% | - | - | - | - |
OpenAI MRCR v2 8-needle 512K-1M | 96,3% | 73,8% | - | - | - | - |
Myślenie abstrakcyjne
| Rozumowanie abstrakcyjne | GPT‑6 Astra | GPT‑5.6 Sol | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | Gemini 3.8 Flash |
| ARC-AGI-3 | 99,9% 1 | 7,8% | - | - | 30,2% | - |
| ARC-AGI-2 | 95,0% | 92,5% | 90,0% | 89,2% | 90,4% | - |
| ARC-AGI-1 | 98,5% | 97,5% | 97,5% | 98,5% | 97,5% | - |
Wyniki ewaluacji osiągają maksimum przy każdym poziomie wysiłku. Oceny przeprowadzono w naszym środowisku badawczym lub za pośrednictwem naszego API, co może dawać nieco inne wyniki niż wersja produkcyjna ChatGPT ze względu na różnice w poleceniach systemowych, dostępnych narzędziach itp.
PRZYPISY
- 1
W teście ARC-AGI-3 model GPT-6 Astra uruchomiono z naszym otoczeniem operacyjnym Responses API, które zmienia dwa ustawienia, aby lepiej odwzorować działanie w rzeczywistych warunkach. Zmiany nie są ukierunkowane konkretnie na ARC-AGI-3.
- 2
GPT-5.6 Sol odnosi się do wersji dostępnej w naszym API, ChatGPT Codex i ChatGPT Work. Wersja w trybie Chat w ChatGPT jest nieco inna.
- 3
OSWorld V2-Offline to podzbiór oryginalnego OSWorld V2, który działa bez dostępu do Internetu. Wyniki modelu Claude w OSWorld-V2 Offline zostały odtworzone przez autorów w oficjalnej tabeli wyników(otwiera nowe okno). W OSWorld 2.0 wyniki Claude opierają się na oficjalnych ustawieniach, a nie na zmodyfikowanych zadaniach i zmodyfikowanym ocenianiu z karty systemu Fable 5.1.
- 4
- 5
W BenchCAD wyniki Claude'a uwzględniają 3 modyfikacje testu ewaluacyjnego, opisane szczegółowo w karcie systemu Fable 5.1(otwiera nowe okno).
- 6
Guang Yang, Victoria Ebert, Nazif Tamer, Brian Siyuan Zheng, Luiza Pozzobon i Noah A. Smith. „LEGATO: Large-scale End-to-end Generalizable Approach to Typeset OMR(otwiera nowe okno)”. arXiv:2506.19065, 2025.
- 7
Mark R. H. Gotham, Maureen Redbond, Bruno Bower i Peter Jonas. „The OpenScore String Quartet Corpus(otwiera nowe okno)”. Proceedings of the 10th International Conference on Digital Libraries for Musicology, s. 49–57. ACM, 2023.
- 8
W FrontierCode model GPT-6 Astra uruchomiono z wiadomością programisty podobną do fragmentu jego wiadomości programisty w Codex(otwiera nowe okno): "Unikaj tworzenia nadmiernej liczby plików testowych. Twórz nowy plik testowy tylko wtedy, gdy wymagają tego konwencje repozytorium lub gdy żaden istniejący plik nie jest odpowiedni. Unikaj niezwiązanych operacji porządkowych i niepotrzebnej złożoności. Wykorzystuj ponownie odpowiednie istniejące narzędzia pomocnicze. Przeczytaj odpowiednie instrukcje repozytorium i sprawdź pobliski kod, testy, dokumentację oraz CI. Przestrzegaj ustalonych konwencji. Celem jest czysty kod, nadający się do scalenia." Polecenie nie zostało zoptymalizowane pod kątem oceny.
- 9
Pierwsze dotyczy tego, jak blisko siebie mogą występować liczby pierwsze, niezależnie od tego, jak daleko przesuniemy się wzdłuż osi liczbowej. Przez ponad dekadę najlepszy znany wynik wykazywał, że istnieje nieskończenie wiele par liczb pierwszych różniących się co najwyżej o wartość 246. Julia Stadlmann(otwiera nowe okno) niedawno poprawiła to ograniczenie do 240. Model Astra pomógł ustalić bardziej precyzyjne ograniczenie wynoszące 186, pokazując, że nieskończenie wiele par występuje w obrębie tej mniejszej odległości. Niewielkie odległości między liczbami pierwszymi: dowód(otwiera nowe okno) i badania uzupełniające(otwiera nowe okno).
- 10
Drugie dotyczy niezwykle dużych odległości między liczbami pierwszymi. Model Astra ulepszył aspekt w oszacowaniu tych odległości, który pozostawał niezmieniony przez ponad 80 lat. Udostępniamy dowody, skrócony łańcuch rozumowania oraz materiały weryfikacyjne dla obu wyników. Duże odległości między liczbami pierwszymi: dowód(otwiera nowe okno) i badania uzupełniające(otwiera nowe okno).
- 11
- 12
- 13
- 14
ExploitBench (June–August 2026) obejmuje 20 luk w V8 o wysokim poziomie istotności w 13 stabilnych wydaniach Chrome. Test porównawczy sprawdza, czy agenty mogą doprowadzić do wykonania dowolnego kodu w V8 oraz oficjalnych wersjach Chrome dla systemu Linux, wykorzystując każdą wskazaną lukę w zabezpieczeniach. Niektóre uwzględnione luki mogą nie umożliwiać wykonania dowolnego kodu w ramach ograniczeń oceny, dlatego osiągnięcie skuteczności na poziomie 100% może nie być możliwe. Uwaga: wynik 5,5% modelu GPT-5.6 Sol jest artefaktem limitu 300 tur w teście porównawczym, który nie jest ograniczeniem dla rzeczywistych klientów korzystających z Maks. Model przy podobnych ustawieniach osiągnął wynik 11,5%, napotykając mniej ograniczeń.
- 15
Jeremy Spence et al. „The Next Challenge for Agentic Cybersecurity: A Realistic, Contamination-Free Reverse Engineering Benchmark(otwiera nowe okno)”. arXiv:2608.11469v1, 2026.
- 16
Gdy testujemy modele innych firm, korzystamy z prostszej konfiguracji badawczej. Codex ma bardziej złożoną konfigurację produkcyjną, co może skutkować innymi współczynnikami błędów modelu bazowego. Zabezpieczenia po stronie dostawcy i implementacje narzędzi komputerowych nadal się różnią. Użytkownicy Codex nie doświadczają scenariusza bez potwierdzenia, ponieważ jest to wewnętrzna konfiguracja badawcza.
- 17