Terminal X: GPT‑6.1 gir 88,6 % enighet med erfarne investorer
Terminal Xs Eval Agent vurderer resultater etter 54 kriterier og oppdager 25 % flere avvik fra fondets mandat med GPT‑6.1 Sol.
25 %
Flere agentsvar som faller utenfor fondets mandat, oppdages med GPT‑6.1 Sol enn med den nest beste modellen
2,4 mill. USD
Besparelser på årsbasis for én kunde på arbeidsflyter for selskapsgjennomgang og investering
+220 basispunkter
Større enighet mellom agent og menneskelige kontrollører med GPT‑6.1 Sol enn med den nest beste modellen
30 %
Lavere kostnad per forespørsel med GPT‑6.1 Sol enn med den nest beste modellen
Et investeringsselskaps konkurransefortrinn bygges opp transaksjon for transaksjon, men vurderingene bak hver beslutning finnes som regel bare i hodene til noen få erfarne investorer. Når de slutter, pådrar selskapet seg det Terminal X(åpnes i et nytt vindu) kaller hukommelsesgjeld: Selskapet beholder kanskje dokumentene, men mister resonneringen.
Operativsystemet Capital Memory fra Terminal X er utviklet for å betale ned denne gjelden. Selskapets ingeniører jobber ute hos kundene og har bakgrunn fra finans og investering i JPMorgan og Blackstone. De samarbeider tett med hver kundes investeringsteam, utformer selskapets agentarkitektur og koder investeringspraksisen inn i agenter som selskapet selv eier og kjører lokalt eller i egen sky.
OpenAI-modeller, blant annet GPT‑6.1 Sol og GPT‑6 Luna, håndterer resonneringen i disse agentene. Og Terminal Xs Eval Agent vurderer agentenes resultater opp mot selskapets standarder. Med GPT‑6.1 Sol oppdaget Eval Agent rundt 25 % flere anbefalinger som avvek fra fondets mandat, og kjørte de samme arbeidsflytene med omtrent 30 % lavere kostnad per forespørsel enn den nest beste modellen.
«GPT-6.1 Sols resonnering over lang kontekst og effektive bruk av token gjør at vi kan bygge grundigere evalueringsprosesser. Dette hjelper våre Eval Agents med å gjøre investeringsvurderinger målbare og etterprøvbare.»
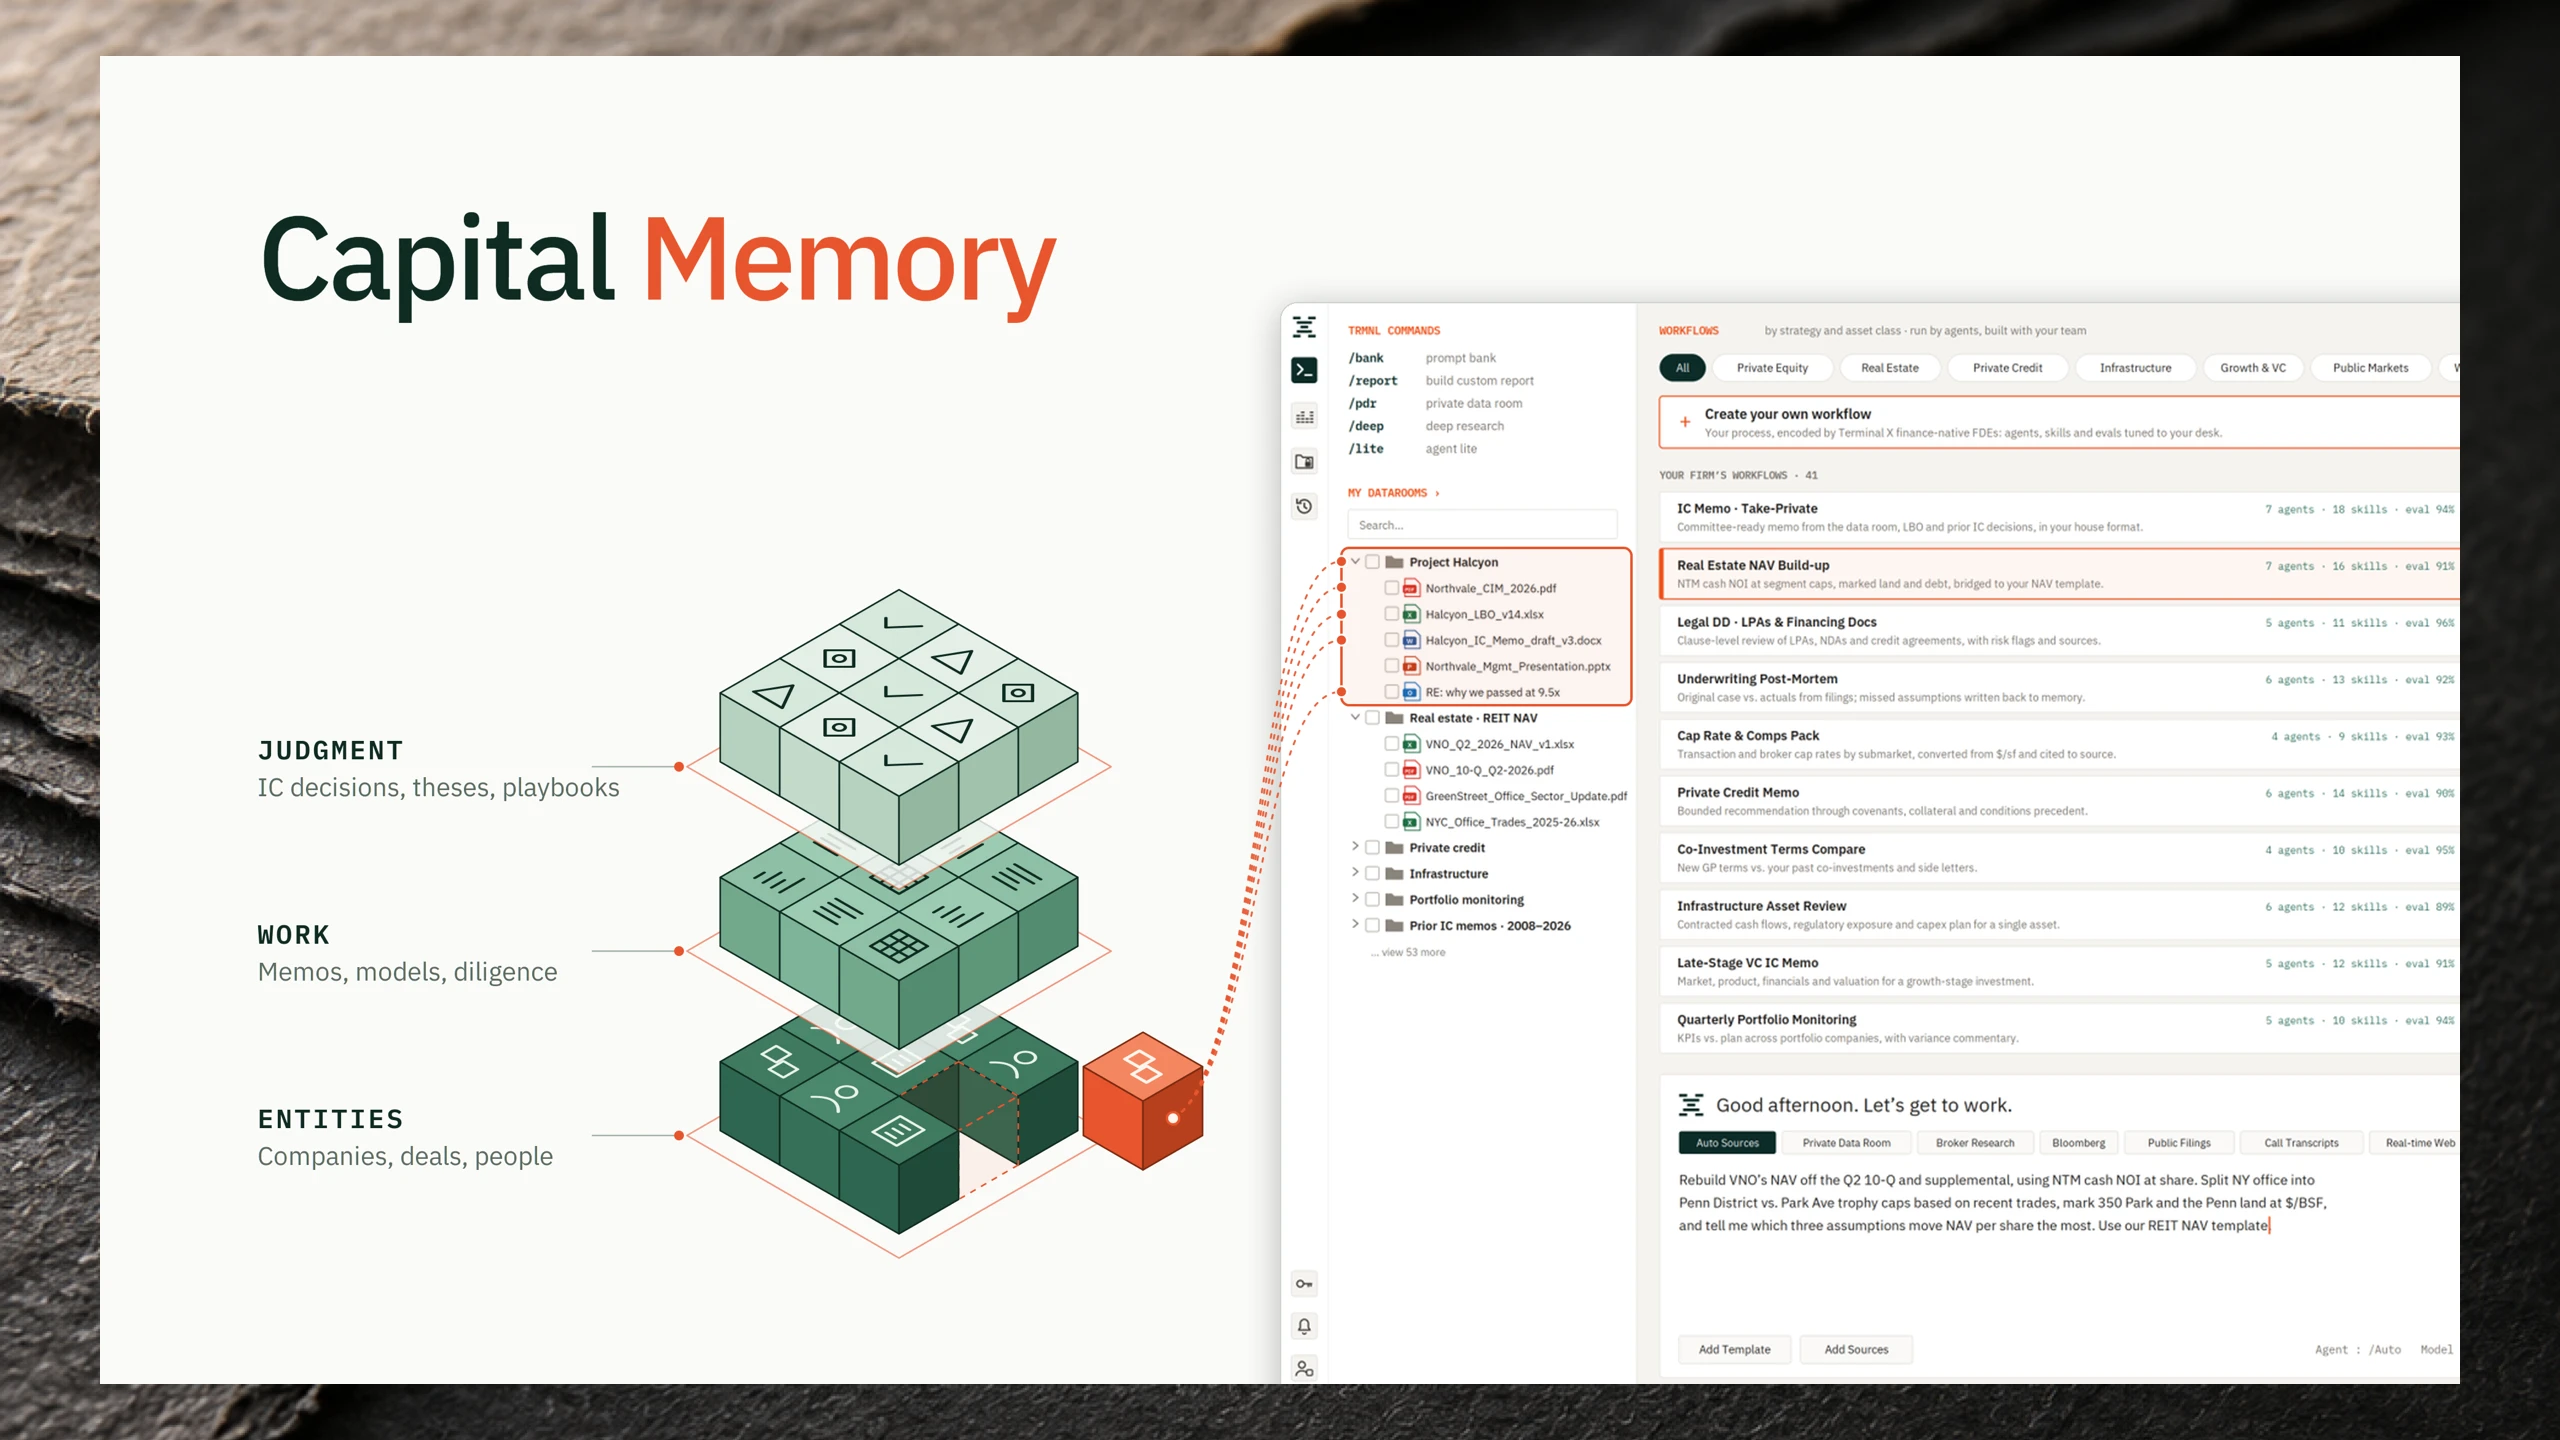
For hver kunde bygger Terminal X agenter som er utformet for å investere slik selskapets beste investorer gjør. Terminal Xs ingeniører tilbringer flere uker hos kunden. De analyserer selskapets velprøvde notater for å forstå hvordan de ble til, og kartlegger prosesser som aldri har blitt skrevet ned – for eksempel hvordan kreditt-teamet vurderer en låntaker, eller hvilke kilder teamet for saminvestering innhenter før de skriver et notat.
Deretter kodes disse prosessene inn i hundrevis av agenter, tilpasset aktivaklasse og strategi, med underagenter for hver fase av investeringen. GPT‑6.1 Sol håndterer fasene som krever vurderingsevne og et svært stort kontekstvindu: å sammenfatte investeringstesen, identifisere viktige hensyn og vurdere om investeringen er i tråd med selskapets mandat. GPT‑6 Luna kjører trinnene med høyt volum, der effektiv bruk av token er viktigere enn dybde.
Agentene arbeider i hvert selskaps private datarom, et eget miljø der bedrifter kan dele og håndtere sensitive investeringsdata. Agentene behandler dokumenter på engelsk, koreansk, japansk og kinesisk, og lagrer det de lærer, som et firmaminne: en versjonert oversikt over hvordan et bestemt team tar en bestemt type beslutning, inkludert tidligere analyser, komitébeslutninger, arbeidsflytinstruksjoner og selskapets investeringssyn.
Ingeniørene gjør hvert minne om til en repeterbar arbeidsflyt på Terminal Xs plattform. Der kan hver forespørsel i produksjon etterprøves med et fullstendig revisjonsspor: trinnene som ble utført, kildene som ble hentet, modellen som ble brukt, og resonneringen.
Ifølge Terminal X oppnår kundene betydelige besparelser med denne tilnærmingen. Blant dem er et private equity-selskap som rapporterte besparelser tilsvarende 2,4 millioner dollar på årsbasis ved å automatisere arbeidsflyter for selskapsgjennomgang og investeringsnotater.
Terminal X bygget en Eval Agent for å kontrollere agentenes svar opp mot selskapets egen standard. Det er en orkestrert arbeidsflyt basert på GPT‑6.1 Sol og andre OpenAI-modeller, utformet for å lese hvert agentresultat slik en investeringsleder leser en analytikers arbeid.
Eval Agent kontrollerer hvert resultat mot et vurderingsskjema med 54 kriterier. Den spør: Er tallene, sammenligningsgrunnlaget, konsensusestimatene og sitatene hentet fra riktige kilder? Holder argumentasjonen? Er anbefalingen i tråd med selskapets investeringssyn?
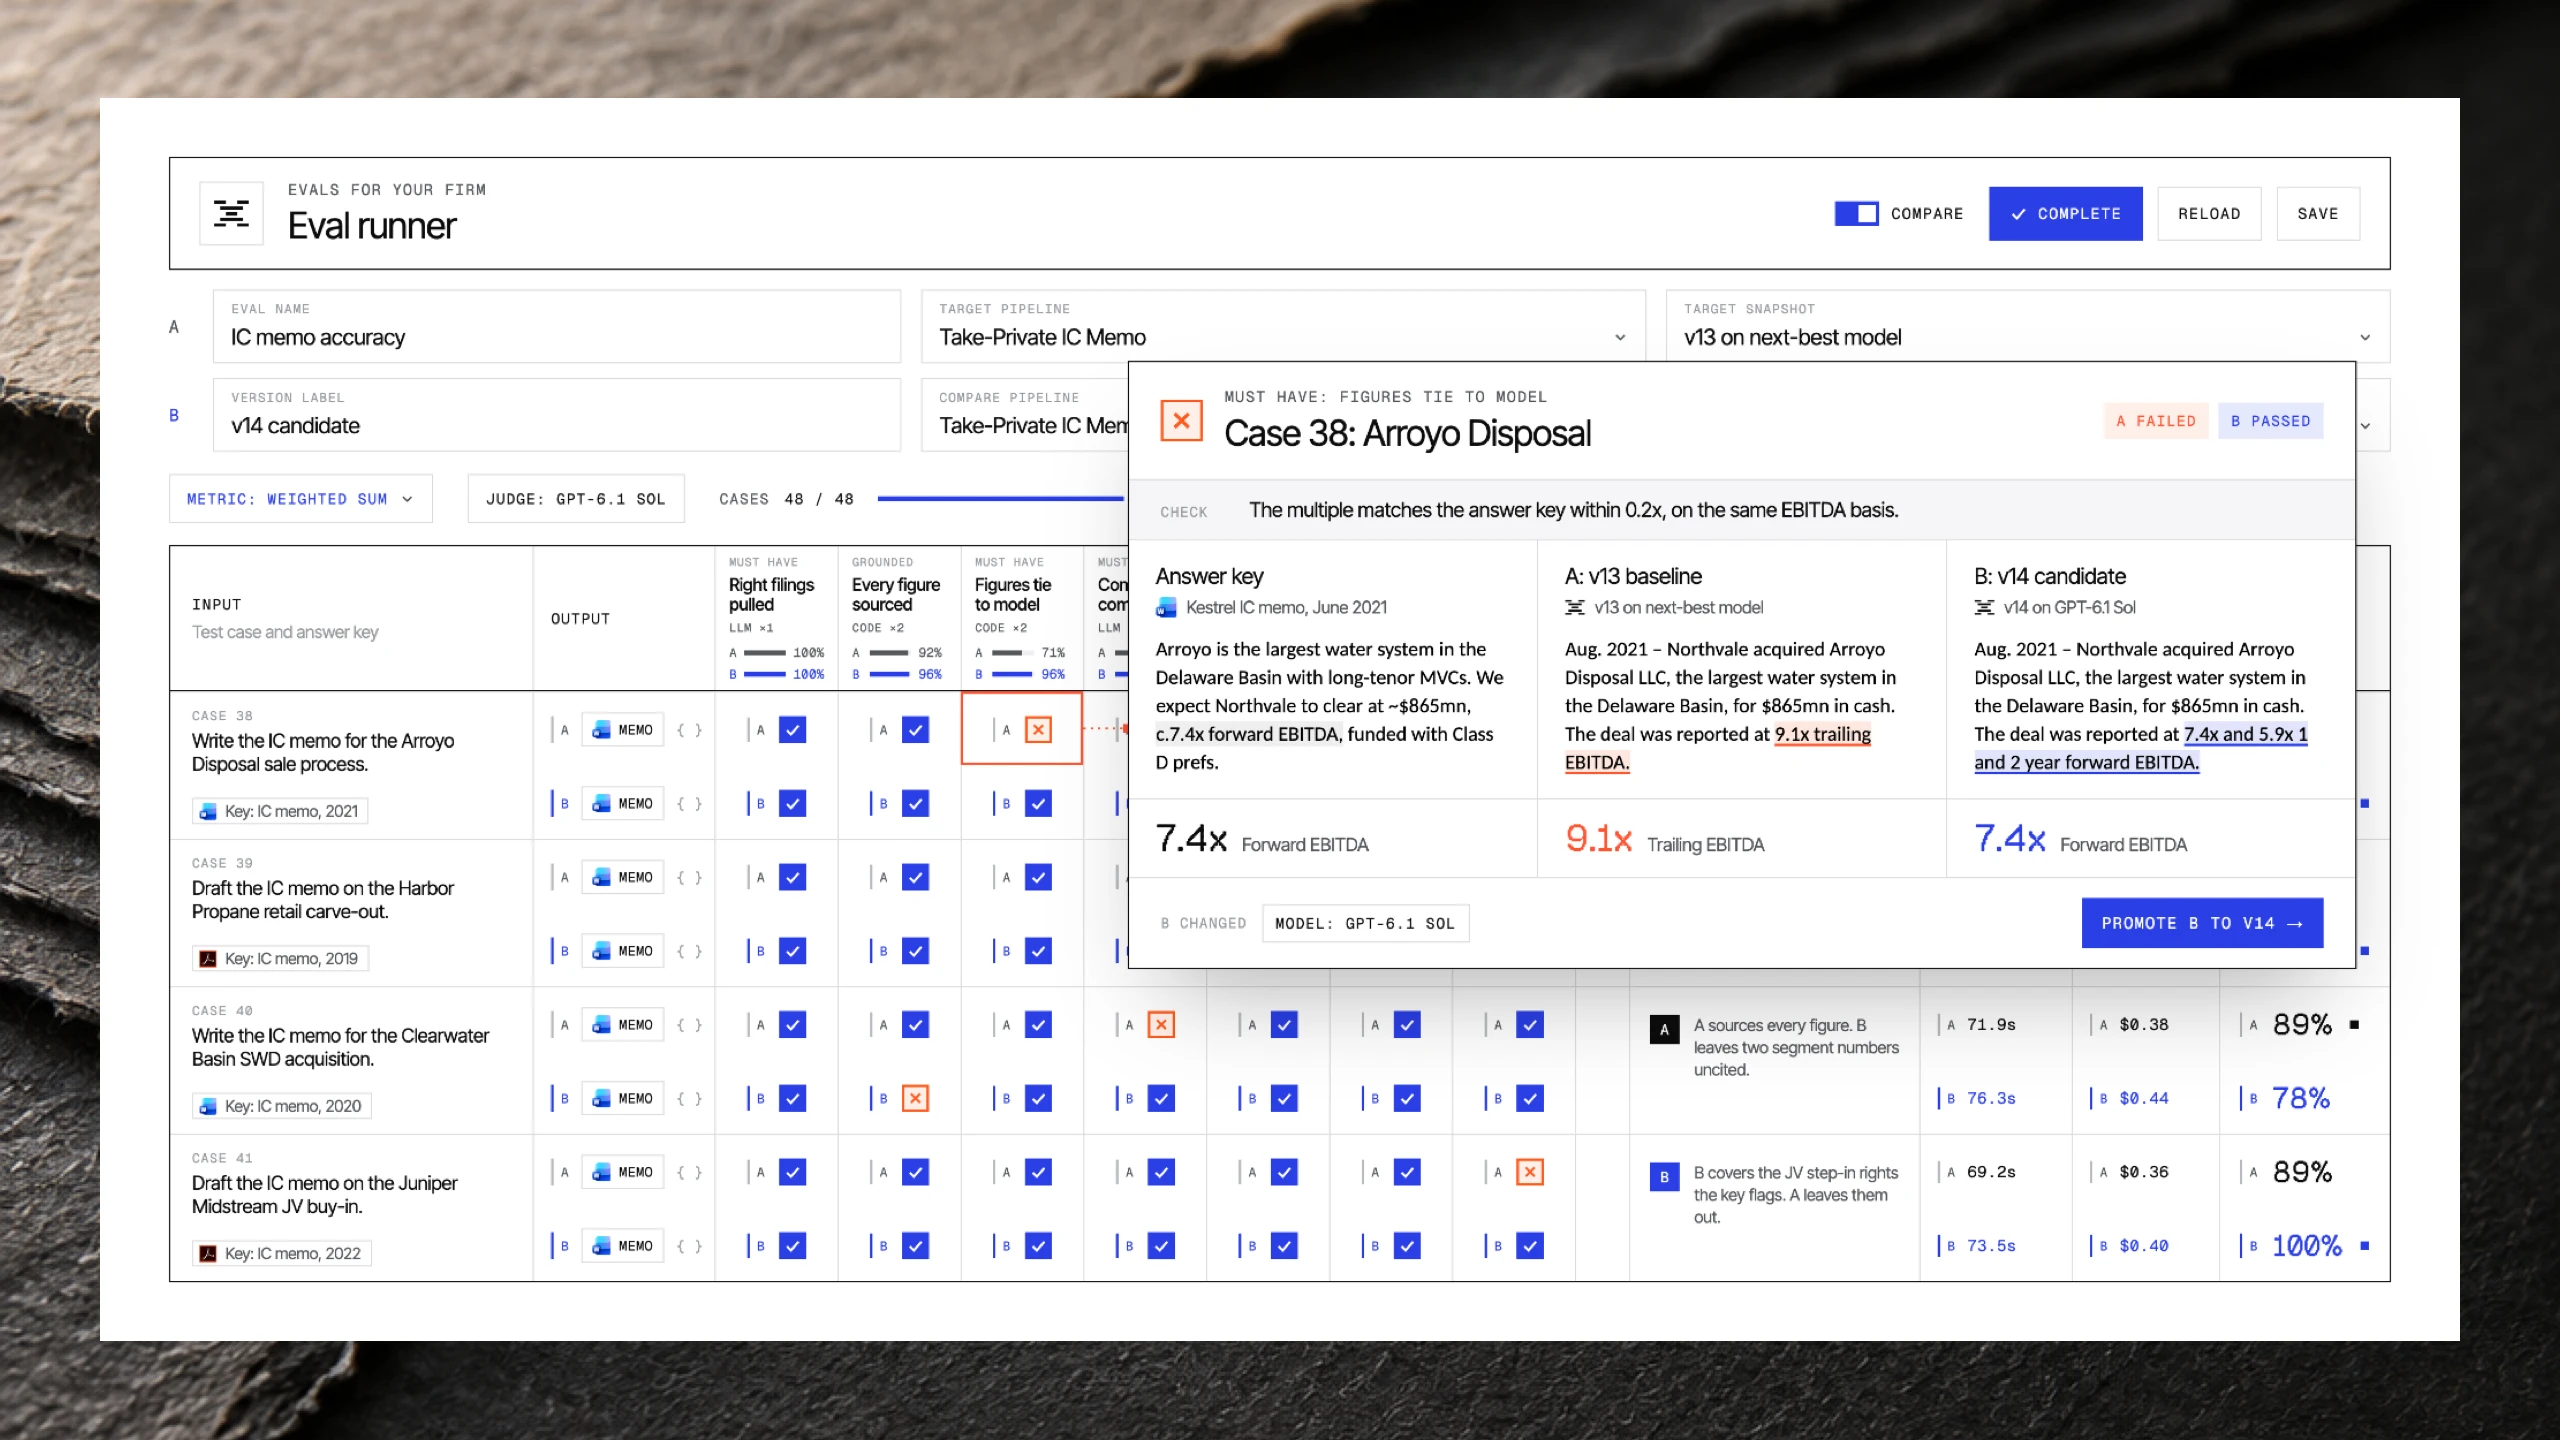
Hver kontroll gir enten godkjent eller ikke godkjent. Hvert avvik får en begrunnelse på én linje og en bedre kilde eller korrigert tekst, og lagres som et minne. For eksempel blir en oversett kilde, et feil sammenligningsobjekt eller en investeringstese som avviker fra selskapets investeringssyn, kodet som en ny instruksjon i arbeidsflyten eller et nytt testtilfelle for det aktuelle teamet.
«Hvert svar blir evaluert, og alt analytikeren retter, lærer systemet litt mer om hvordan selskapet jobber», sier Ken Lee, medgründer og teknologidirektør i Terminal X. «Så jo lenger et selskap bruker det, desto mer tenker det som deres eget team.»
Terminal X velger modeller ut fra egne evalueringsresultater. I 500 evaluerte vurderinger var Eval Agent på GPT‑6.1 Sol enig med den erfarne menneskelige kontrolløren i 88,6 % av tilfellene, mot 86,4 % for den nest beste modellen – en forbedring på 220 basispunkter.
Én type feil der GPT‑6.1 Sol gjorde det bedre, var avvik fra investeringsstilen. Et oppkjøpsfond kan for eksempel ha som mandat å finne kandidater for oppkjøp og avnotering som handles under netto eiendelsverdi (NAV), vurdere virksomhetens risiko og verdi og strukturere finansieringen. Når scenariomodeller tyder på et omslag i markedet, begynner transaksjonsforslagene å anbefale investeringer i gjeld fra selskaper i økonomiske vanskeligheter eller redningsfinansiering. Eval Agent på GPT‑6.1 Sol fanget opp rundt 25 % flere slike avvik enn den nest beste modellen.
GPT‑6.1 Sols effektive bruk av token ved arbeid med lang kontekst gjorde det mulig for Terminal X å bygge en grundigere kontrollprosess innenfor samme budsjett. Investeringstesen testes først opp mot fondets mandat, deretter mot de siste transaksjonene. Usikre vurderinger kjøres på nytt, og agenten sammenholder resultatene før den rapporterer.
Denne grundigere kontrollen flagget transaksjoner som en sammenlignbar modell hadde godkjent etter én gjennomgang. GPT‑6.1 Sol kjørte også de samme arbeidsflytene med rundt 30 % lavere kostnad per forespørsel enn den nest beste modellen, med omtrent samme hastighet.
Med GPT‑6.1 Sol og GPT‑6 Luna har Terminal X bygget 1 700 firmaminner, kjørt over 1 million tilpassede arbeidsflyter og nådd et antall ukentlig aktive brukere som tilsvarer 81 % av de månedlig aktive brukerne.
Terminal Xs neste steg er å utvide firmaminnene fra teamnivå til individnivå, slik at hver investeringsprofesjonells standard fanges opp slik den praktiseres, ikke bare slik den beskrives.
For Hyun, medgründer og administrerende direktør i Terminal X, er det nettopp dette som er poenget: «Selskapene som vinner det neste tiåret, vil eie sin egen vurderingsevne i form av data. Vår jobb er å gjøre denne vurderingsevnen målbar, slik at den kan bevares, forbedres og brukes på nytt.»