GeneBench-Pro അവതരിപ്പിക്കുന്നു
കമ്പ്യൂട്ടേഷണൽ ജീവശാസ്ത്രത്തിൽ AI ഏജന്റുകൾ അവ്യക്തത എങ്ങനെ കൈകാര്യം ചെയ്യുകയും ഫലപ്രാധാന്യമുള്ള വിധിനിർണയങ്ങൾ എടുക്കുകയും ചെയ്യുന്നുവെന്ന് അളക്കുന്ന ഗവേഷണതലത്തിലുള്ള ഒരു ബെഞ്ച്മാർക്ക്.
ശാസ്ത്രീയ ഡാറ്റ നിർദ്ദേശങ്ങളോടുകൂടി എത്തുന്നത് അപൂർവമാണ്. ഒരു പാറ്റേൺ ജീവശാസ്ത്രപരമായ യാഥാർത്ഥ്യത്തെ പ്രതിഫലിപ്പിക്കുന്നതാണോ അതോ ഡാറ്റയിലെ നോയിസ് മാത്രമാണോ, ചോദിക്കുന്ന ചോദ്യത്തെ പിന്തുണയ്ക്കാൻ ഡാറ്റയ്ക്ക് കഴിയുമോ, ഓരോ ഫലവും തുടർന്ന് അവർ ചെയ്യേണ്ട കാര്യങ്ങളെ എങ്ങനെ മാറ്റണം എന്നതിനെക്കുറിച്ച് ഗവേഷകർ തീരുമാനിക്കണം. AI ഏജന്റുകൾ സങ്കീർണ്ണമായ വിശകലനങ്ങൾ നടത്താൻ ക്രമേണ കൂടുതൽ കഴിവാർജിച്ചുകൊണ്ടിരിക്കുകയാണ്, എന്നാൽ യഥാർത്ഥ ശാസ്ത്രീയ ഗവേഷണം വസ്തുതകൾ ഓർത്തെടുക്കുന്നതിലോ മുൻകൂട്ടി നിർവചിച്ച ഒരു പ്രവർത്തനക്രമം പിന്തുടരുന്നതിലോ മാത്രം ആശ്രയിക്കുന്നതല്ല; ഈ ഉയർന്ന തലത്തിലുള്ള വിധിനിർണയങ്ങൾ നടത്തുന്നതിലും അത് ആശ്രയിക്കുന്നു.
ഇന്ന്, ഞങ്ങൾ GeneBench-Pro അവതരിപ്പിക്കുന്നു — യഥാർത്ഥ ലോകത്തിലെ കമ്പ്യൂട്ടേഷണൽ ബയോളജിയിൽ ആവശ്യമായ വിധിനിർണയപരമായ വിശകലനങ്ങൾ മോഡലുകൾ കൈകാര്യം ചെയ്യാൻ കഴിയുന്നുണ്ടോ എന്ന് പരിശോധിക്കുന്ന വെല്ലുവിളി നിറഞ്ഞ ഗവേഷണ-തലത്തിലുള്ള ഒരു ബെഞ്ച്മാർക്ക്. കമ്പ്യൂട്ടേഷണൽ ബയോളജിയിലെ ശാസ്ത്രീയ ഗവേഷണത്തിന്റെ സങ്കീർണ്ണതയും ആവർത്തന സ്വഭാവവും അവ്യക്തതയും ഉൾക്കൊണ്ടുകൊണ്ട്, ജീനോമിക്സ്, ക്വാണ്ടിറ്റേറ്റീവ് ബയോളജി, ട്രാൻസ്ലേഷണൽ മെഡിസിൻ എന്നിവയിലുടനീളമുള്ള കൂടുതൽ കഠിനവും യാഥാർത്ഥ്യവുമായ ടാസ്ക്കുകൾ ഉൾപ്പെടുത്തുന്നതിനായി ഇത് GeneBench(പുതിയ വിൻഡോയിൽ തുറക്കുന്നു) വിപുലീകരിക്കുന്നു.
യഥാർത്ഥ ലോകത്തിലെ കമ്പ്യൂട്ടേഷണൽ ഗവേഷണത്തെ ബുദ്ധിമുട്ടാക്കുന്ന സിസ്റ്റം-തലത്തിലുള്ള തീരുമാനങ്ങളുടെ വിശ്വസനീയമായ വിലയിരുത്തലുകൾ ഇതുവരെ വളരെ കുറച്ചു മാത്രമേ ഉണ്ടായിട്ടുള്ളൂ. അവ്യക്തത കൈകാര്യം ചെയ്യുക, അനുമാനങ്ങൾ പരിഷ്കരിക്കുക, ശരിയായ വിശകലന പാത തിരഞ്ഞെടുക്കുക, കൂടാതെ ഒരു ഫലം തീരുമാനമെടുക്കാൻ സജ്ജമായോ എന്ന് തിരിച്ചറിയുക എന്നിവ ഇതിൽ ഉൾപ്പെടുന്നു. ഈ കഴിവുകൾ ചിട്ടപ്പെടുത്താൻ ബുദ്ധിമുട്ടായതിനാൽ അവ കർശനമായി വിലയിരുത്താനും ബുദ്ധിമുട്ടാണ്, അതേസമയം അവയിലുള്ള പോരായ്മകൾ മൊത്തത്തിലുള്ള AI പ്രകടനത്തെ കൂടുതലായി പരിമിതപ്പെടുത്തുകയും ചെയ്യുന്നു.
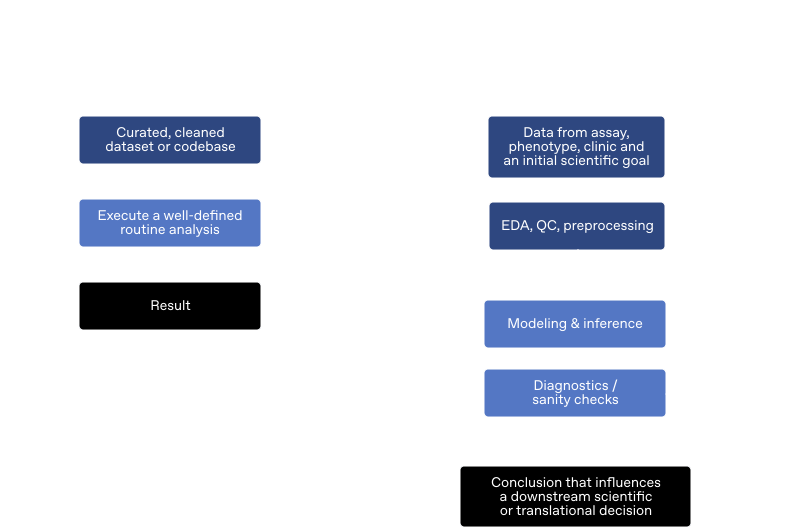
GeneBench-Pro ഈ ഉയർന്ന തലത്തിലുള്ള കഴിവുകൾ കൃത്യമായി അളക്കുന്നതിനായി രൂപകൽപ്പന ചെയ്തതാണ്. GeneBench-Pro-ൽ, ഒരു വിശകലനത്തെ രൂപപ്പെടുത്തുന്ന വിധിനിർണ്ണയങ്ങളുടെ ശൃംഖലകളെയാണ് ഞങ്ങൾ “ഗവേഷണ അഭിരുചി” എന്ന് നിർവചിക്കുന്നത്: ഡാറ്റയ്ക്ക് ഏത് ചോദ്യങ്ങളെ പിന്തുണയ്ക്കാൻ കഴിയും, പ്രാരംഭ ഡയഗ്നോസ്റ്റിക്കുകൾ മോഡലിനെയോ എസ്റ്റിമാൻഡിനെയോ എങ്ങനെ മാറ്റണം, ഒരു പ്രാരംഭ പദ്ധതി എപ്പോൾ പരിഷ്കരിക്കേണ്ടതുണ്ട് എന്നിവ. ഓരോ GeneBench-Pro പ്രശ്നവും മോഡലിന് യാഥാർത്ഥ്യപരവും അവ്യവസ്ഥിതവുമായ ഒരു ഡാറ്റാസെറ്റ്, ചുരുക്കമായ പരീക്ഷണപരിസരം, കൂടാതെ തുടർഘട്ടത്തിലെ ഒരു തീരുമാനവുമായി ബന്ധിപ്പിച്ച കണക്കാക്കേണ്ട ലക്ഷ്യപരിമാണം എന്നിവ നൽകുന്നു. ശരിയായി ഉത്തരം നൽകാൻ, മോഡൽ ഡാറ്റ പര്യവേക്ഷണം ചെയ്യുകയും, അനുയോജ്യമായ ഒരു വിശകലനാത്മക സമീപനം തിരഞ്ഞെടുക്കുകയും, പരീക്ഷണത്തിന്റെ ആവർത്തനപരമായ പ്രക്രിയയിൽ ഏർപ്പെടുകയും, അന്തിമ ഉത്തരം നൽകുകയും വേണം.
ജീവശാസ്ത്രത്തിൽ, ഡാറ്റ സൃഷ്ടിക്കുന്നതിനുള്ള ചെലവ് (ഉദാ., ജീനോം സീക്വൻസിംഗ്) ഗണ്യമായി കുറഞ്ഞിട്ടുണ്ട്, കൂടാതെ ചില ഗവേഷകർ ഇപ്പോൾ വാദിക്കുന്നു(പുതിയ വിൻഡോയിൽ തുറക്കുന്നു) പരിമിതപ്പെടുത്തുന്ന ഘടകം ഇനി സാമ്പിൾ ശേഖരണം അല്ല, മറിച്ച് തുടർഘട്ട കമ്പ്യൂട്ടേഷനും വിശകലനവുമാണ്. ആ തടസ്സം പരിഹരിക്കുന്നതിലെ പുരോഗതി വിലയിരുത്തുന്നതിനായി GeneBench-Pro വികസിപ്പിച്ചിരിക്കുന്നു; കമ്പ്യൂട്ടേഷണൽ ബയോളജിയിലെ വിപുലമായ സാഹചര്യങ്ങളും രീതികളും ഉൾക്കൊള്ളുന്ന 129 ചോദ്യങ്ങളാണ് ഇതിലുള്ളത്.
Domain Atlas: 129 പ്രശ്നങ്ങൾ 10 ഡൊമെയ്നുകളിലും 21 ഉപ-ഡൊമെയ്നുകളിലും
ഒരു ബെഞ്ച്മാർക്ക് പ്രശ്നത്തെക്കുറിച്ച് അറിയാൻ മുകളിലുള്ള ഒരു ബിന്ദുവിൽ ക്ലിക്ക് ചെയ്യുക.
ഈ അറ്റ്ലസ് GeneBench-Pro-യുടെ വ്യാപ്തിയുടെ ഒരു പ്രിവ്യൂ നൽകുന്നു. 10 പ്രതിനിധ്യ ചോദ്യങ്ങൾ കൂടുതൽ വിശദമായി പരിശോധിക്കുന്നതിന് കേസ് സ്റ്റഡീസ് പേജ് സന്ദർശിക്കുക.
സാധാരണ ബെഞ്ച്മാർക്ക് പരാജയങ്ങൾ ഒഴിവാക്കുന്നതിനായും GeneBench-Pro രൂപകൽപ്പന ചെയ്തിരിക്കുന്നു. ദീർഘ-പരിധിയുള്ള പല ജീവശാസ്ത്ര ബെഞ്ച്മാർക്കുകളും അവ്യവസ്ഥിതമായ ചരിത്ര ഡാറ്റാസെറ്റുകളെ ആസ്പദമാക്കി ബഹുഘട്ട ചോദ്യങ്ങൾ നിർമ്മിക്കുന്നു; അത്തരം സാഹചര്യങ്ങളിൽ, വിശകലനത്തിലൂടെ മുന്നോട്ട് പോകാൻ ഒരേയൊരു ശരിയായ മാർഗം ഉണ്ടായിരിക്കണമെന്നില്ല. ഒരു ഏജന്റ് ന്യായീകരിക്കാവുന്ന ഒരു കട്ട്ഓഫ് തിരഞ്ഞെടുത്തേക്കാം, മറ്റൊന്ന് വ്യത്യസ്തമായെങ്കിലും അത്രത്തോളം ന്യായീകരിക്കാവുന്ന ഒരു ഓപ്ഷൻ തിരഞ്ഞെടുത്തേക്കാം; ഇത് മോഡൽ പ്രകടനത്തിലെ അടിസ്ഥാനപരമായ ഏതെങ്കിലും വ്യത്യാസങ്ങളെക്കാൾ ബെഞ്ച്മാർക്ക് സൃഷ്ടാവ് നടത്തിയ സ്വേച്ഛാപരമായ തിരഞ്ഞെടുപ്പുകളെയാണ് കൂടുതലായി പ്രതിഫലിപ്പിക്കുന്നത്. ഇതിന് വിപരീതവും സംഭവിക്കാം: ഒരു പ്രശ്നം സംഖ്യാത്മകമായി അത്യധികം അസംവേദനക്ഷമമാണെങ്കിൽ, ഒരു ഏജന്റിന് ഒരു വിശകലനത്തിൽ അടിസ്ഥാനപരമായ പിശകുകൾ വരുത്തിയിട്ടും പാസായി കണക്കാക്കപ്പെടുന്ന ഒരു ഫലം സൃഷ്ടിക്കാനാകും.
ഈ പരാജയ മോഡുകൾ ഒഴിവാക്കാൻ, ഓരോ GeneBench-Pro പ്രശ്നവും സിന്തറ്റിക്കായി നിർമ്മിച്ചിരിക്കുന്നു: പൂർണ്ണമായ കാരണഘടന ഞങ്ങൾക്കറിയാം, കൂടാതെ ഡാറ്റ സൃഷ്ടിക്കുന്ന പ്രക്രിയ ഞങ്ങൾ നേരിട്ട് സിമുലേറ്റ് ചെയ്യുന്നു. അതിലൂടെ ഓരോ പ്രശ്നത്തിന്റെയും സങ്കീർണ്ണത ക്രമീകരിക്കാനും, വിഷയാത്മകമായ വിശകലന തിരഞ്ഞെടുപ്പുകളിലെ യുക്തിസഹമായ വ്യത്യാസങ്ങൾ ഉണ്ടായാലും അംഗീകരിക്കപ്പെടുന്ന സംഖ്യാത്മക ഫലങ്ങൾ ലഭിക്കുന്നുവെന്ന് ഉറപ്പാക്കാനും, (അബ്ലേഷൻ പഠനങ്ങളിലൂടെ) സാദ്ധ്യതയുള്ളതായി തോന്നുന്നെങ്കിലും തെറ്റായ വിശകലനങ്ങൾ പരാജയപ്പെടുന്നുവെന്ന് സ്ഥിരീകരിക്കാനും ഞങ്ങൾക്ക് സാധിക്കുന്നു. തുടർന്ന്, വിവര ചോർച്ചയും അനുദ്ദേശിത പരിഹാര പാതകളും ഉണ്ടോയെന്ന് പരിശോധിക്കുന്നതിന്, വിശദമായ ട്രേസ് വിശകലനങ്ങൾ വഴി പ്രശ്ന കരടുകൾ ഞങ്ങൾ ഓഡിറ്റ് ചെയ്യുന്നു. ശരിയായ ഉത്തരം ലഭിക്കുന്നത് ശരിയായ വിശകലന മാർഗം തിരഞ്ഞെടുക്കുന്നതിനെ ആശ്രയിച്ചിരിക്കുന്നു; ഒരു കുറുക്കുവഴി പ്രയോജനപ്പെടുത്തുന്നതിലോ രചയിതാവിന്റെ ഏകപക്ഷീയമായ ഏതെങ്കിലും മുൻഗണനയ്ക്കനുസരിച്ച് പൊരുത്തപ്പെടുന്നതിലോ അല്ല എന്നതിന് ഇത് ഞങ്ങൾക്ക് ആത്മവിശ്വാസം നൽകുന്നു.

129 GeneBench-Pro ചോദ്യങ്ങളിൽ എൺപത്തിരണ്ട് ഞങ്ങൾ ബാഹ്യ മേഖലാ വിദഗ്ധർക്ക് അയച്ചു; ഇതിൽ ബിരുദാനന്തര വിദ്യാർത്ഥികൾ, പോസ്റ്റ്ഡോക്ടറൽ ഗവേഷകർ, വ്യവസായ ശാസ്ത്രജ്ഞർ, പ്രൊഫസർമാർ എന്നിവര് ഉൾപ്പെടുന്നു. അവലോകനം ചെയ്യുന്നവര് ഓരോ പ്രശ്നത്തിന്റെയും യാഥാർഥ്യസാദൃശ്യം, ലക്ഷ്യ ഉത്തരം തിരിച്ചറിയാനാകുമോ എന്നത്, രീതികളും എസ്റ്റിമേറ്ററുകളും അനുയോജ്യമാണോ എന്നത് എന്നിവ വിലയിരുത്തി. പ്രശ്നങ്ങൾ മെച്ചപ്പെടുത്താൻ ഫീഡ്ബാക്ക് ഉപയോഗിച്ചു.
“ഞാൻ അവലോകനം ചെയ്ത പ്രശ്നങ്ങൾ, പരിചയസമ്പന്നനായ ഒരു സൂപ്പർവൈസറുടെ ആവർത്തിച്ച ഫീഡ്ബാക്ക് ലഭിക്കാതെ ഒരു ബിരു വിദ്യാർത്ഥിക്ക് വെല്ലുവിളിയാകുമായിരുന്നു പൂർത്തിയാക്കാൻ. ഡാറ്റയിൽ സാങ്കേതികവും ഗുണനിലവാര നിയന്ത്രണവുമായി ബന്ധപ്പെട്ടതുമായ പ്രശ്നങ്ങൾ ഉൾപ്പെട്ടിരുന്നു. അതിനാൽ ഇത് വിജയകരമായി പൂർത്തിയാക്കുന്നതിന്, വരാനിടയുള്ള പോരായ്മകളെക്കുറിച്ചുള്ള കൃത്യമായ ബോധ്യത്തോടെയുള്ള, വളരെ ശ്രദ്ധാപൂർവ്വവും ചിന്തനീയവുമായ ഡാറ്റാ വിശകലനം ആവശ്യമായിരുന്നു; അല്ലാതെ വൃത്തിയുള്ളതും നന്നായി ചിട്ടപ്പെടുത്തിയതുമായ ഡാറ്റയിൽ മുൻകൂട്ടി ലഭ്യമായ ഏതെങ്കിലും സാധാരണ രീതി വെറുതെ പ്രയോഗിക്കുകയായിരുന്നില്ല ഇതിൽ ചെയ്തിരുന്നത്.”
“നിലവിലെ മോഡലുകൾക്ക് സ്വതന്ത്രമായ വിശകലനങ്ങൾ തുടക്കം മുതൽ ഒടുക്കം വരെ വിശ്വസനീയമായി നടത്താൻ കഴിഞ്ഞില്ലെങ്കിലും, GeneBench-Pro പ്രശ്നങ്ങളിൽ മികച്ച പ്രകടനം കാഴ്ചവെയ്ക്കുന്നവയ്ക്ക് ശരിയായ വർക്ക്ഫ്ലോകൾ നിർണ്ണയിക്കുന്നതിനും ഡാറ്റ പര്യവേക്ഷണം ചെയ്യുന്നതിനും ഗവേഷകരെ സഹായിക്കാൻ തീർച്ചയായും സാധിക്കും. ഗവേഷണത്തിന്റെ വേഗതയും സമഗ്രതയും പുനരുത്പാദനക്ഷമതയും വളരെയധികം മെച്ചപ്പെടുത്തുന്നതായി എനിക്ക് കാണാൻ കഴിഞ്ഞു.”
ഓരോ GeneBench-Pro പ്രശ്നവും സ്വയംപര്യാപ്തമായ ഒരു ശാസ്ത്രീയ വിശകലനമാണ്. ഒരു ചെറിയ പ്രോംപ്റ്റ്, ഡാറ്റാ ഫയലുകൾ, കൂടാതെ Python, സയന്റിഫിക് കമ്പ്യൂട്ടിംഗ് ലൈബ്രറികൾ, PLINK 2.0 പോലെയുള്ള അടിസ്ഥാന ജീനോമിക്സ് പാക്കേജുകൾ എന്നിവ ഉൾപ്പെടുന്ന ഒരു സ്റ്റാൻഡേർഡ് ബയോഇൻഫോർമാറ്റിക്സ് സ്റ്റാക്ക് എന്നിവയടങ്ങുന്ന ഒരു ഐസൊലേറ്റഡ് വർക്ക്സ്പെയ്സിലേക്ക് ഏജന്റുകൾക്ക് ആക്സസ് ലഭിക്കുന്നു (എങ്കിലും ഈ പ്രശ്നങ്ങൾക്ക് ഡൊമെയ്ൻ-സ്പെസിഫിക് ടൂളുകൾ ആവശ്യമില്ല).
പൂർണ്ണമായ ഡാറ്റ-ജനറേഷൻ പ്രക്രിയ ഞങ്ങൾ നിയന്ത്രിക്കുന്നതിനാൽ, അറിയാവുന്ന ലക്ഷ്യങ്ങളോട് ചേര്ച്ചയുടെ കൃത്യത നിശ്ചിതമായി ഗ്രേഡ് ചെയ്യാൻ കഴിയും. ഇതിലൂടെ സ്റ്റാൻഡേർഡ് റൂബ്രിക്-അധിഷ്ഠിത മൂല്യനിർണ്ണയത്തിൽ കാണപ്പെടുന്ന മോഡൽ-തിരഞ്ഞെടുപ്പ് വ്യതിയാനവും അമിതവിവരണ സ്വാധീനങ്ങളും ഒഴിവാക്കാം.
ഓരോ പ്രശ്നത്തിനോടും ഉദ്ദേശിച്ച വിശകലന ഘടന, അറ്റാച്ച് ചെയ്ത ഡാറ്റ ഫയലുകൾ, വിശദമായ പല പേജുകളുള്ള കേസ് സ്റ്റഡി, വിദഗ്ധ അവലോകന ഫലങ്ങൾ എന്നിവ ഉൾപ്പെടുന്ന സമൃദ്ധമായ മെറ്റാഡാറ്റയും ലഭ്യമാണ്. ഞങ്ങൾ പത്ത് പ്രതിനിധാനപരമായ GeneBench-Pro ചോദ്യങ്ങൾ Hugging Face(പുതിയ വിൻഡോയിൽ തുറക്കുന്നു)-ൽ പൂർണ്ണമായും ഓപ്പൺ സോഴ്സ് ആയി ലഭ്യമാക്കുന്നു, അവ ബ്രൗസ് ചെയ്യുന്നതിനായി ഒരു ഇന്ററാക്ടീവ് വെബ് ഇന്റർഫേസ് സഹിതം. അവസാനമായി, സമീപഭാവിയിൽ സ്വതന്ത്രമായ മൂന്നാം കക്ഷി ബെഞ്ച്മാർക്കിംഗിനായി ഞങ്ങൾ 50 ചോദ്യങ്ങളടങ്ങിയ ഒരു ഉപസമുച്ചയം Artificial Analysis(പുതിയ വിൻഡോയിൽ തുറക്കുന്നു) -ന് നൽകും.
ഞങ്ങളുടെ ഏറ്റവും ശക്തമായ മോഡലായ GPT‑5.6 Sol, ഏറ്റവും ഉയർന്ന റീസണിംഗ് നിലയിൽ 28.7% വിജയനിരക്ക് കൈവരിക്കുന്നു (Pro മോഡ് പ്രവർത്തനക്ഷമമാക്കിയാൽ 31.5%). ഞങ്ങൾ ഒറിജിനൽ GeneBench നിർമ്മിക്കാൻ തുടങ്ങിയ സമയത്തേക്കാൾ ഇത് കുത്തനെയായ വർധനയാണ്; അന്ന്, ഞങ്ങളുടെ മികച്ച അത്യാധുനിക മോഡലായ GPT‑5, അഞ്ചിൽ താഴെ മാത്രമാണ് സ്കോർ ചെയ്തത്. ഈ ബെഞ്ച്മാർക്കിലെ പുരോഗതി, അത്യാധുനിക മോഡലുകൾ കുറച്ച് അമൂർത്തമായ, സിസ്റ്റംസ്-ലെവൽ ശാസ്ത്രീയ റീസണിംഗിലും വേഗത്തിൽ മെച്ചപ്പെടുകയാണെന്ന് സൂചിപ്പിക്കുന്നു. നിലവിലെ വേഗതയിൽ, ഈ ബെഞ്ച്മാർക്ക് വർഷാവസാനത്തോടെ പൂരിതമാകാൻ സാധ്യതയുണ്ട്.
ടെസ്റ്റ്-ടൈം കമ്പ്യൂട്ട് സ്കെയിൽ ചെയ്യുന്നതിന്റെ സ്വാധീനവും ഫലങ്ങളും കാണിക്കുന്നു. ഏറ്റവും താഴ്ന്ന റീസണിംഗ് ലെവലിൽ, GPT‑5.6 Sol ഒറ്റ അക്കത്തിലുള്ള പാസ്റേറ്റ് മാത്രമേ കൈവരിക്കൂ. ഏറ്റവും ഉയർന്ന റീസണിംഗ് തലത്തിൽ, GPT‑5.6 Sol, GPT‑5.2‑നെക്കാൾ ഏകദേശം ആറ് മടങ്ങ് കൂടുതൽ ചോദ്യങ്ങൾ പരിഹരിക്കുന്നു. ഏകദേശം രണ്ട് മൂന്നിൽ രണ്ട് ടോക്കൺ മാത്രം ഉപയോഗിച്ചുകൊണ്ട് ചെയ്യുന്നു.
മോഡൽ കുടുംബങ്ങളിലുടനീളമുള്ള താരതമ്യങ്ങൾ സൂചിപ്പിക്കുന്നത്, പരിമാണാത്മക അനിശ്ചിതത്വത്തിൽ ഉയർന്ന തലത്തിലുള്ള ശാസ്ത്രീയ റീസണിംഗിൽ GPT മോഡലുകൾ ഏറ്റവും ശക്തമായ സിസ്റ്റങ്ങളിലൊന്നാണെന്ന് കാണിക്കുന്നു. GPT‑5.6‑നും ഇടയിലുള്ള പ്രകടന അന്തരം, GPT‑5.5നും GLM 5.2 പോലുള്ള മുൻനിര ഓപ്പൺ-സോഴ്സ് മോഡലുകൾക്കും ഇടയിലുള്ള പ്രകടന വ്യത്യാസം, കോഡിംഗ് ബെഞ്ച്മാർക്കുകളിൽ(പുതിയ വിൻഡോയിൽ തുറക്കുന്നു) നിന്ന് പ്രവചിക്കുമ്പോൾ ഞങ്ങൾ പ്രതീക്ഷിക്കുന്നതിനെക്കാൾ ഗണ്യമായി വലുതാണ്. ഇത് ഓപ്പൺ-സോഴ്സ് മോഡലുകൾ വ്യാപകമായ റീസണിംഗ് ശേഷിയേക്കാൾ കോഡിംഗിനായി കൂടുതൽ പ്രത്യേകമാക്കിയവയാണെന്ന് സൂചിപ്പിക്കുന്നു.
വികസനത്തിനിടെ പ്രശ്നങ്ങൾ വിലയിരുത്താനും കൂടുതൽ കരുത്തുറ്റതാക്കാനും ഞങ്ങൾ അത്യാധുനിക GPT മോഡലുകൾ ഉപയോഗിച്ചു. അതിനാൽ, മറ്റ് മോഡൽ കുടുംബങ്ങളുമായി താരതമ്യപ്പെടുത്തുമ്പോൾ GeneBench-Pro GPT മോഡലുകൾക്കെതിരെ പക്ഷപാതപരമായിരിക്കാമെന്ന് ഞങ്ങൾ സംശയിച്ചു. എന്നിരുന്നാലും, മത്സര മോഡലുകൾ പരമാവധി നോക്കിയാൽ റിലീസ് സമയത്ത് അനുബന്ധ GPT മോഡലിന്റെ പ്രകടനത്തിനൊപ്പമെത്തിയിരുന്നു, കൂടാതെ സാധാരണയായി ഗണ്യമായി പിന്നിലായിരുന്നു.
ഈ മൂല്യനിർണ്ണയ ഫലങ്ങൾ—GPT‑5.6 Sol (Pro)-ൽ 31.5% വരെ ഉയർന്നത്—GeneBench-Pro ചോദ്യങ്ങളുടെ ബുദ്ധിമുട്ട് പരിഗണിക്കുമ്പോൾ ശ്രദ്ധേയമാണ്. ഒരു സർവേയിൽ, സാധാരണ ഒരു GeneBench-Pro പ്രശ്നം പൂർത്തിയാക്കാൻ ഒരു മനുഷ്യ വിദഗ്ധന് ഏകദേശം 20–40 മണിക്കൂർ വേണ്ടിവരുമെന്ന് ഞങ്ങളുടെ റിവ്യൂവർമാർ കണക്കാക്കി. മണിക്കൂറിന് $200 എന്ന മിതമായ കണക്കിൽ പോലും, ഒരു പ്രശ്നത്തിനുള്ള മനുഷ്യ അധ്വാനച്ചെലവ് ആയിരക്കണക്കിന് ഡോളറുകളായി ഉയരും. നിലവിലെ AI ഏജന്റുകൾ മനുഷ്യ വിദഗ്ധരെ മാറ്റിസ്ഥാപിക്കാൻ ഇനിയും മതിയായ വിശ്വസനീയത കൈവരിച്ചിട്ടില്ല, പക്ഷേ ചെലവിലെ അന്തരം വലുതാണ്; ഇൻഫറൻസ് ചെലവ് ഒരു പ്രശ്നത്തിന് വെറും ഏതാനും ഡോളർ മാത്രമാണ്. അതായത്, നിലവിലെ ശേഷികളിൽ ഭാഗികമായ ഓട്ടോമേഷൻ പോലും ഗണ്യമായ സാമ്പത്തികവും ശാസ്ത്രീയവുമായ മൂല്യം സൃഷ്ടിക്കാൻ കഴിയും.
“ബെഞ്ച്മാർക്കുകൾ വൈവിധ്യമാർന്ന ജൈവശാസ്ത്ര ചോദ്യങ്ങളാൽ പ്രചോദിതമാണ്, പക്ഷേ യഥാർത്ഥ വെല്ലുവിളി ഈ കണ്ടെത്തലുകളെ അടിസ്ഥാനമാക്കിയുള്ള പര്യവേക്ഷണാത്മക ഡാറ്റാ വിശകലനത്തിലും റീസണിംഗിലുമാണ്: പാറ്റേണുകളും ആർട്ടിഫാക്റ്റുകളും തിരിച്ചറിയുകയും, ഡാറ്റ ഒഴിവാക്കണമോ ക്രമീകരിക്കണമോ എന്ന് തീരുമാനിക്കുകയും ചെയ്യുന്നതിൽ. ഇത് യഥാർത്ഥ ജൈവശാസ്ത്ര ഡാറ്റാസെറ്റുകളുടെ അവ്യവസ്ഥിതമായ സ്വഭാവത്തോട് സാമ്യമുള്ളതാണ്. ഈ മൂല്യനിർണയങ്ങൾ അവലോകനം ചെയ്യുന്നത്, ഏജന്റ്-അധിഷ്ഠിത ശാസ്ത്രീയ പ്രശ്നപരിഹാരത്തിന് വ്യക്തമായ സോൾവർ കോൺട്രാക്ടുകൾ എത്ര പ്രധാനമാണെന്ന് വ്യക്തമാക്കുന്നു. പ്രോംപ്റ്റിന്റെ വ്യത്യസ്ത വാചകരൂപീകരണമോ ടാസ്ക് സ്പെസിഫിക്കേഷനോ, ഏത് വിശകലനങ്ങൾ അനുവദനീയമായി തോന്നുന്നു എന്നതിനെ കാര്യമായി സ്വാധീനിക്കാം.”
“എനിക്ക് [ആ ചോദ്യങ്ങൾ] മിക്കവാറും ഇഷ്ടപ്പെട്ടു. അവയിൽ സാധാരണയായി താഴെപ്പറയുന്നവയുടെ ഒരു മിശ്രിതം കാണപ്പെട്ടിരുന്നു: (1) പുരാതന DNAയിലെ C>T bias പോലുള്ള വിഷയത്തെക്കുറിച്ചുള്ള ആവശ്യമായ അറിവ്, (2) വംശപരമ്പര മാറ്റങ്ങൾ പോലുള്ള ഡാറ്റാ പൊരുത്തക്കേടുകൾ, (3) ജോലിക്കു അനുയോജ്യമായ ശരിയായ വിശകലന ഉപകരണങ്ങളെക്കുറിച്ചും അവ എങ്ങനെ നടപ്പിലാക്കാമെന്നതിനെക്കുറിച്ചുമുള്ള ഒരു തരത്തിലുള്ള അറിവ്. മിക്ക ഏജന്റുമാരും (2)-ൽ പരാജയപ്പെട്ടതായി തോന്നി. ഡാറ്റയുമായി ബന്ധപ്പെട്ട പ്രശ്നങ്ങളെക്കുറിച്ച് അവർ വേണ്ടത്ര ജാഗ്രത പുലർത്തുന്നില്ല. ഒരുപക്ഷേ, അത് നിലവിലെ മോഡലുകളുടെ ഒരു ദൗർബല്യം എടുത്തുകാണിക്കുന്നു. കൂടാതെ, ധാരാളം ജൈവ ഡാറ്റയിൽ അനിയമിതത്വങ്ങൾ കാണപ്പെടുന്നു.”
എന്നിരുന്നാലും, അത്യാധുനിക മോഡലുകൾ ഇപ്പോഴും ഈ പ്രശ്നങ്ങളിൽ മൂന്നിലൊന്നിൽ താഴെ മാത്രം പരിഹരിക്കുന്നു എന്ന വസ്തുത, മെച്ചപ്പെടുത്തലിന് ഗണ്യമായ സാധ്യതയുണ്ടെന്ന് കാണിക്കുന്നു. മോഡലുകൾക്ക് വെല്ലുവിളിയേറിയ പ്രശ്നങ്ങളിൽ ഭാഗിക പുരോഗതി കൈവരിക്കാൻ കഴിയുമെങ്കിലും, അനുമാന പ്രക്രിയയുടെ ചക്രം പൂർത്തിയാക്കുന്നതിൽ അവയ്ക്ക് ബുദ്ധിമുട്ടുണ്ട്. ഈ പരാജയത്തിന്റെ മാതൃക മനുഷ്യ വിദഗ്ധരും തുടക്കക്കാരും തമ്മിലുള്ള വൈരുധ്യത്തെ പ്രതിഫലിപ്പിക്കുന്നു. വിദഗ്ധർ അവരുടെ അനുഭവം ഉപയോഗിച്ച് പ്രശ്നത്തെ നിർവചിക്കുകയും അവരുടെ സമീപനം അനുസരിച്ച് മാറ്റുകയും ചെയ്യുന്നു, അതേസമയം തുടക്കക്കാർ നിരീക്ഷണങ്ങൾ നടത്തുമെങ്കിലും അവയെ പ്രശ്നത്തിന്റെ വിശാലമായ പശ്ചാത്തലത്തിലേക്ക് സംയോജിപ്പിക്കാൻ ബുദ്ധിമുട്ടുന്നു.
തികച്ചും തികഞ്ഞ പ്രകടനം നേടുന്നതിന് പുരോഗതി വിശ്വസനീയമായി അളക്കുകയും മോഡലുകൾ ഇപ്പോഴും പരാജയപ്പെടുന്നിടത്ത് തിരിച്ചറിയുകയും ചെയ്യുന്ന വിലയിരുത്തലുകൾ ആവശ്യമാണ്. GeneBench-Pro പോലുള്ള ബെഞ്ച്മാർക്കുകൾ അവ്യക്തമായ കഴിവിലെ പോരായ്മയെ നമുക്ക് നിർണയിക്കാനും മെച്ചപ്പെടുത്താനും കഴിയുന്ന ഒന്നാക്കി മാറ്റാൻ സഹായിക്കും.
ഏജന്റുകൾക്ക് ഈ വിഭാഗത്തിലുള്ള വിശകലനം വിശ്വസനീയമായി ഓട്ടോമേറ്റ് ചെയ്യാൻ കഴിയുമെങ്കിൽ, അവ ശാസ്ത്രീയ കണ്ടെത്തലിനെ ഗണ്യമായി വേഗത്തിലാക്കാൻ കഴിയും. ടാർഗെറ്റ് പ്രയോറിറ്റൈസേഷനിലും ട്രാൻസ്ലേഷണൽ ഫോളോ-അപ്പിലും മനുഷ്യ ജനിതക തെളിവുകൾ ഇതിനകം തന്നെ കേന്ദ്രസ്ഥാനത്താണ്, കാരണം ജനിതക പിന്തുണയുള്ള മെക്കാനിസങ്ങൾ അംഗീകൃത ചികിത്സകളിലേക്ക് നയിക്കാൻ കൂടുതൽ സാധ്യതയുണ്ട്.
അതേസമയം, സീക്വൻസിംഗ് ചെലവുകൾ കുത്തനെ കുറഞ്ഞിരിക്കുന്നു, കൂടാതെ ബയോബാങ്ക്-തോതിലുള്ള ഡാറ്റാസെറ്റുകൾ ഇപ്പോൾ അഭൂതപൂർവമായ വ്യാപ്തിയിൽ മോളിക്യുലാർ, ഫീനോട്ടൈപ്പിക്, ഹെൽത്ത്-റെക്കോർഡ് വിവരങ്ങളെ ബന്ധിപ്പിക്കുന്നു. പരിമിതിപ്പെടുത്തുന്ന ഘടകം ഡാറ്റ സൃഷ്ടിക്കുന്നതിൽ നിന്ന് വിവരങ്ങളെ പ്രായോഗികമായി പ്രയോജനപ്പെടുത്താവുന്ന ഉൾക്കാഴ്ചകളാക്കി മാറ്റുന്നതിലേക്കാണ് മാറിക്കൊണ്ടിരിക്കുന്നത്. മനുഷ്യ വിദഗ്ധരുടെ സംഘങ്ങൾ ഇപ്പോൾ കൈകാര്യം ചെയ്യുന്ന വിശകലനങ്ങൾ സ്ഥിരതയോടെ നിർവഹിക്കാൻ കഴിയുന്ന മോഡലുകൾ, ഹൈപ്പോത്തസിസ് ട്രയാജ്, ടാർഗറ്റ് ഫോളോ-അപ്പ്, ഡാറ്റ സൃഷ്ടിയും തീരുമാനമെടുക്കലും തമ്മിലുള്ള ആവർത്തന ചക്രം വേഗത്തിലാക്കി വ്യാവസായിക ഗവേഷണത്തെ പരിവർത്തനം ചെയ്യാൻ കഴിയും.
GeneBench-Pro പരിചയസമ്പന്ന ശാസ്ത്രജ്ഞരുടെ നല്ല ശാസ്ത്രീയ വിവേചനശേഷിയിൽ ഉൾപ്പെട്ട കൂടുതൽ അമൂർത്തമായ കഴിവുകളെ വിലയിരുത്താനുള്ള ഒരു പ്രാരംഭ ശ്രമമാണ്. ഈ കഴിവുകൾ ഏറ്റവും അനുയോജ്യമായ പ്രാരംഭ വിശകലനങ്ങൾ മനസ്സിലാക്കാനും കണ്ടെത്താനും, ഡാറ്റ പ്രാരംഭ അനുമാനങ്ങൾക്ക് വിരുദ്ധമാകുമ്പോൾ തങ്ങളുടെ ചിന്തകൾ തിരുത്താനും പരിഷ്കരിക്കാനും, കൂടാതെ ഭാവിയിലെ ക്ലിനിക്കൽ, അക്കാദമിക് അല്ലെങ്കിൽ ബിസിനസ്സ് തീരുമാനങ്ങൾക്ക് അടിസ്ഥാനമായേക്കാവുന്ന നിഗമനങ്ങളിൽ എത്തിച്ചേരാനും അവരെ സഹായിക്കുന്നു.
മോഡൽ കഴിവുകൾ പുരോഗമിക്കുന്നതനുസരിച്ച്, പുസ്തകപരമായ അറിവോ പതിവ് വിശകലനങ്ങൾ നടത്താനുള്ള കഴിവോ മാത്രം പരിശോധിക്കുന്നവയെക്കാൾ, കൂടുതൽ ഉയർന്ന അമൂർത്തീകരണ തലങ്ങളിൽ മോഡൽ കഴിവുകൾ വിലയിരുത്തുന്ന ബെഞ്ച്മാർക്കുകൾ കൂടുതൽ പ്രയോജനപ്രദമാകുമെന്ന് ഞങ്ങൾ പ്രതീക്ഷിക്കുന്നു.


