OpenAI o1 კონკურენტული პროგრამირების კითხვებში (Codeforces) 89-ე პერცენტილშია, აშშ-ის მათემატიკური ოლიმპიადის საკვალიფიკაციო გამოცდაზე (AIME) აშშ-ში საუკეთესო 500 მოსწავლეს შორის ხვდება და ფიზიკის, ბიოლოგიისა და ქიმიის ამოცანების ბენჩმარკზე (GPQA) ადამიანური PhD-დონის სიზუსტეს აჭარბებს. მიუხედავად იმისა, რომ ამ ახალი მოდელის მიმდინარე მოდელებივით მარტივად გამოსაყენებლად საჭირო სამუშაო ჯერ კიდევ მიმდინარეობს, ამ მოდელის ადრეულ ვერსიას, OpenAI o1‑preview‑ს, დაუყოვნებელი გამოყენებისთვის ვუშვებთ ChatGPT‑ში და სანდო API მომხმარებლებისთვის(იხსნება ახალ ფანჯარაში).
ჩვენი მასშტაბური განმამტკიცებელი სწავლების ალგორითმი მოდელს ასწავლის, როგორ იფიქროს პროდუქტიულად თავისი აზროვნების ჯაჭვის გამოყენებით, მეტად მონაცემეფექტიან სასწავლო პროცესში. აღმოვაჩინეთ, რომ o1‑ის შედეგიანობა თანმიმდევრულად უმჯობესდება როგორც მეტი განმამტკიცებელი სწავლებით (ტრენინგის დროის compute), ისე ფიქრში დახარჯული მეტი დროით (ტესტირების დროის compute). ამ მიდგომის მასშტაბირების შეზღუდვები მნიშვნელოვნად განსხვავდება LLM წინასწარი გაწვრთნის შეზღუდვებისგან და მათ კვლევას ვაგრძელებთ.
o1 performance smoothly improves with both train-time and test-time compute
GPT‑4o‑სთან შედარებით მსჯელობის გაუმჯობესების წარმოსაჩენად, ჩვენი მოდელები ადამიანების მრავალფეროვან გამოცდებსა და ML ბენჩმარკებზე გამოვცადეთ. ვაჩვენებთ, რომ o1 ამ მსჯელობაზე ორიენტირებული ამოცანების აბსოლუტურ უმრავლესობაში GPT‑4o‑ს მნიშვნელოვნად აჭარბებს. თუ სხვა რამ მითითებული არ არის, o1 შევაფასეთ ტესტირების დროის გამოთვლითი რესურსის მაქსიმალურ პარამეტრზე.
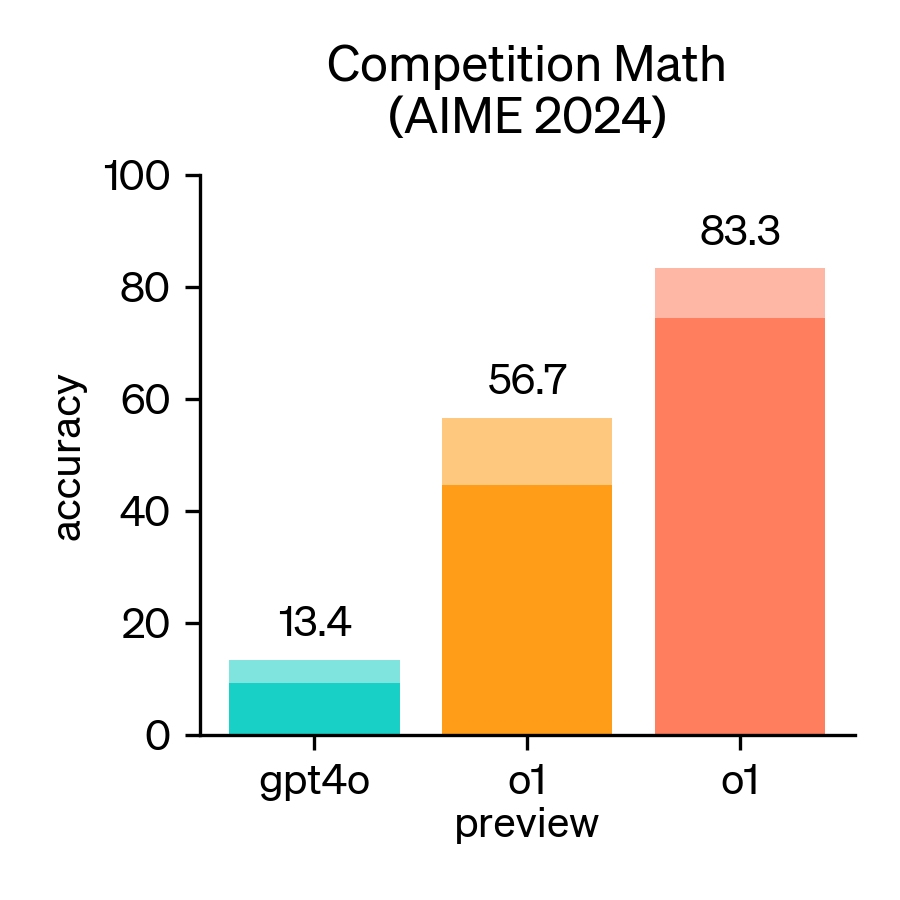
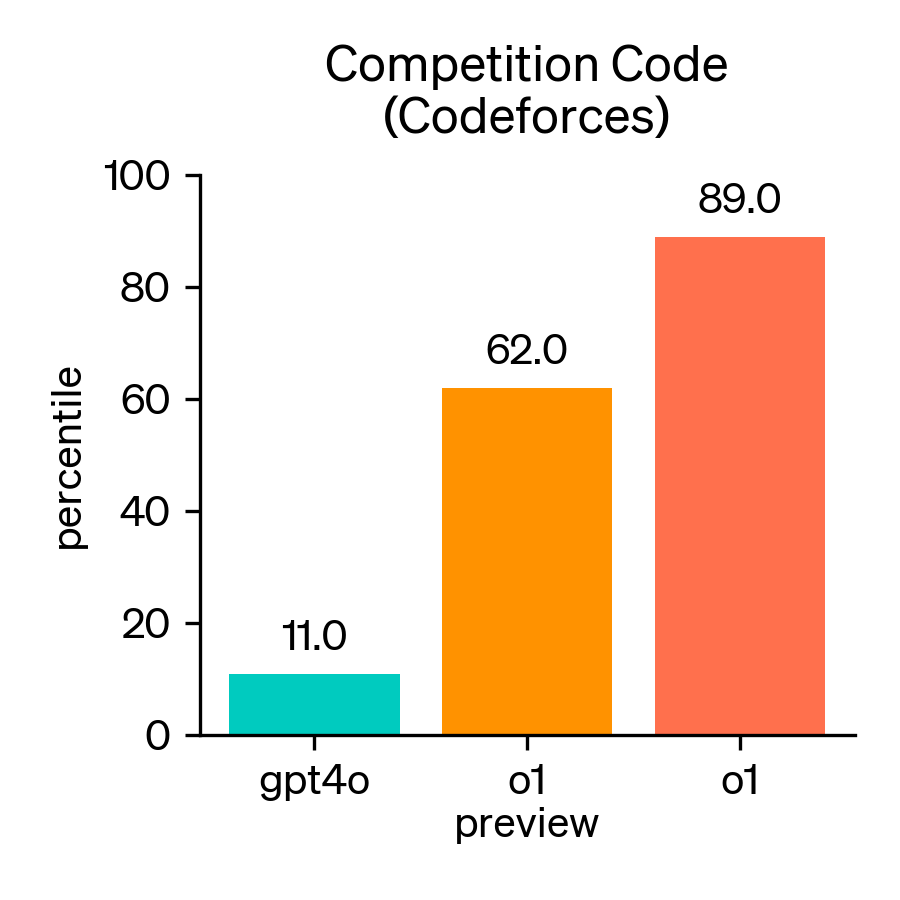
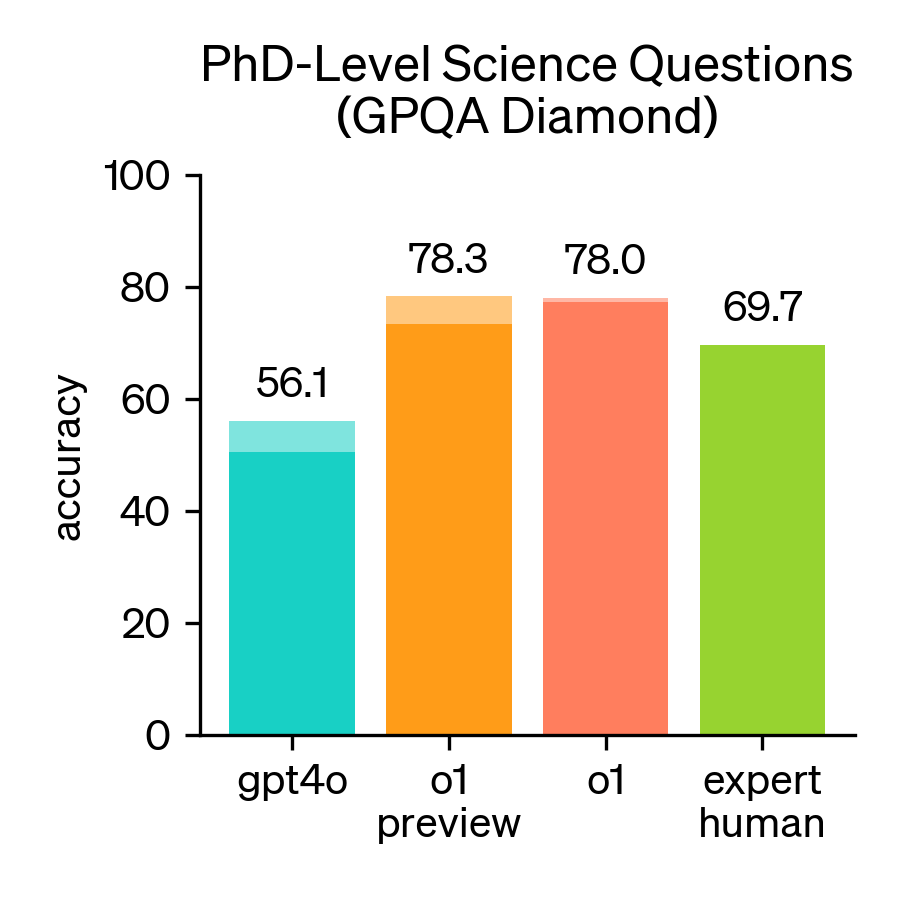
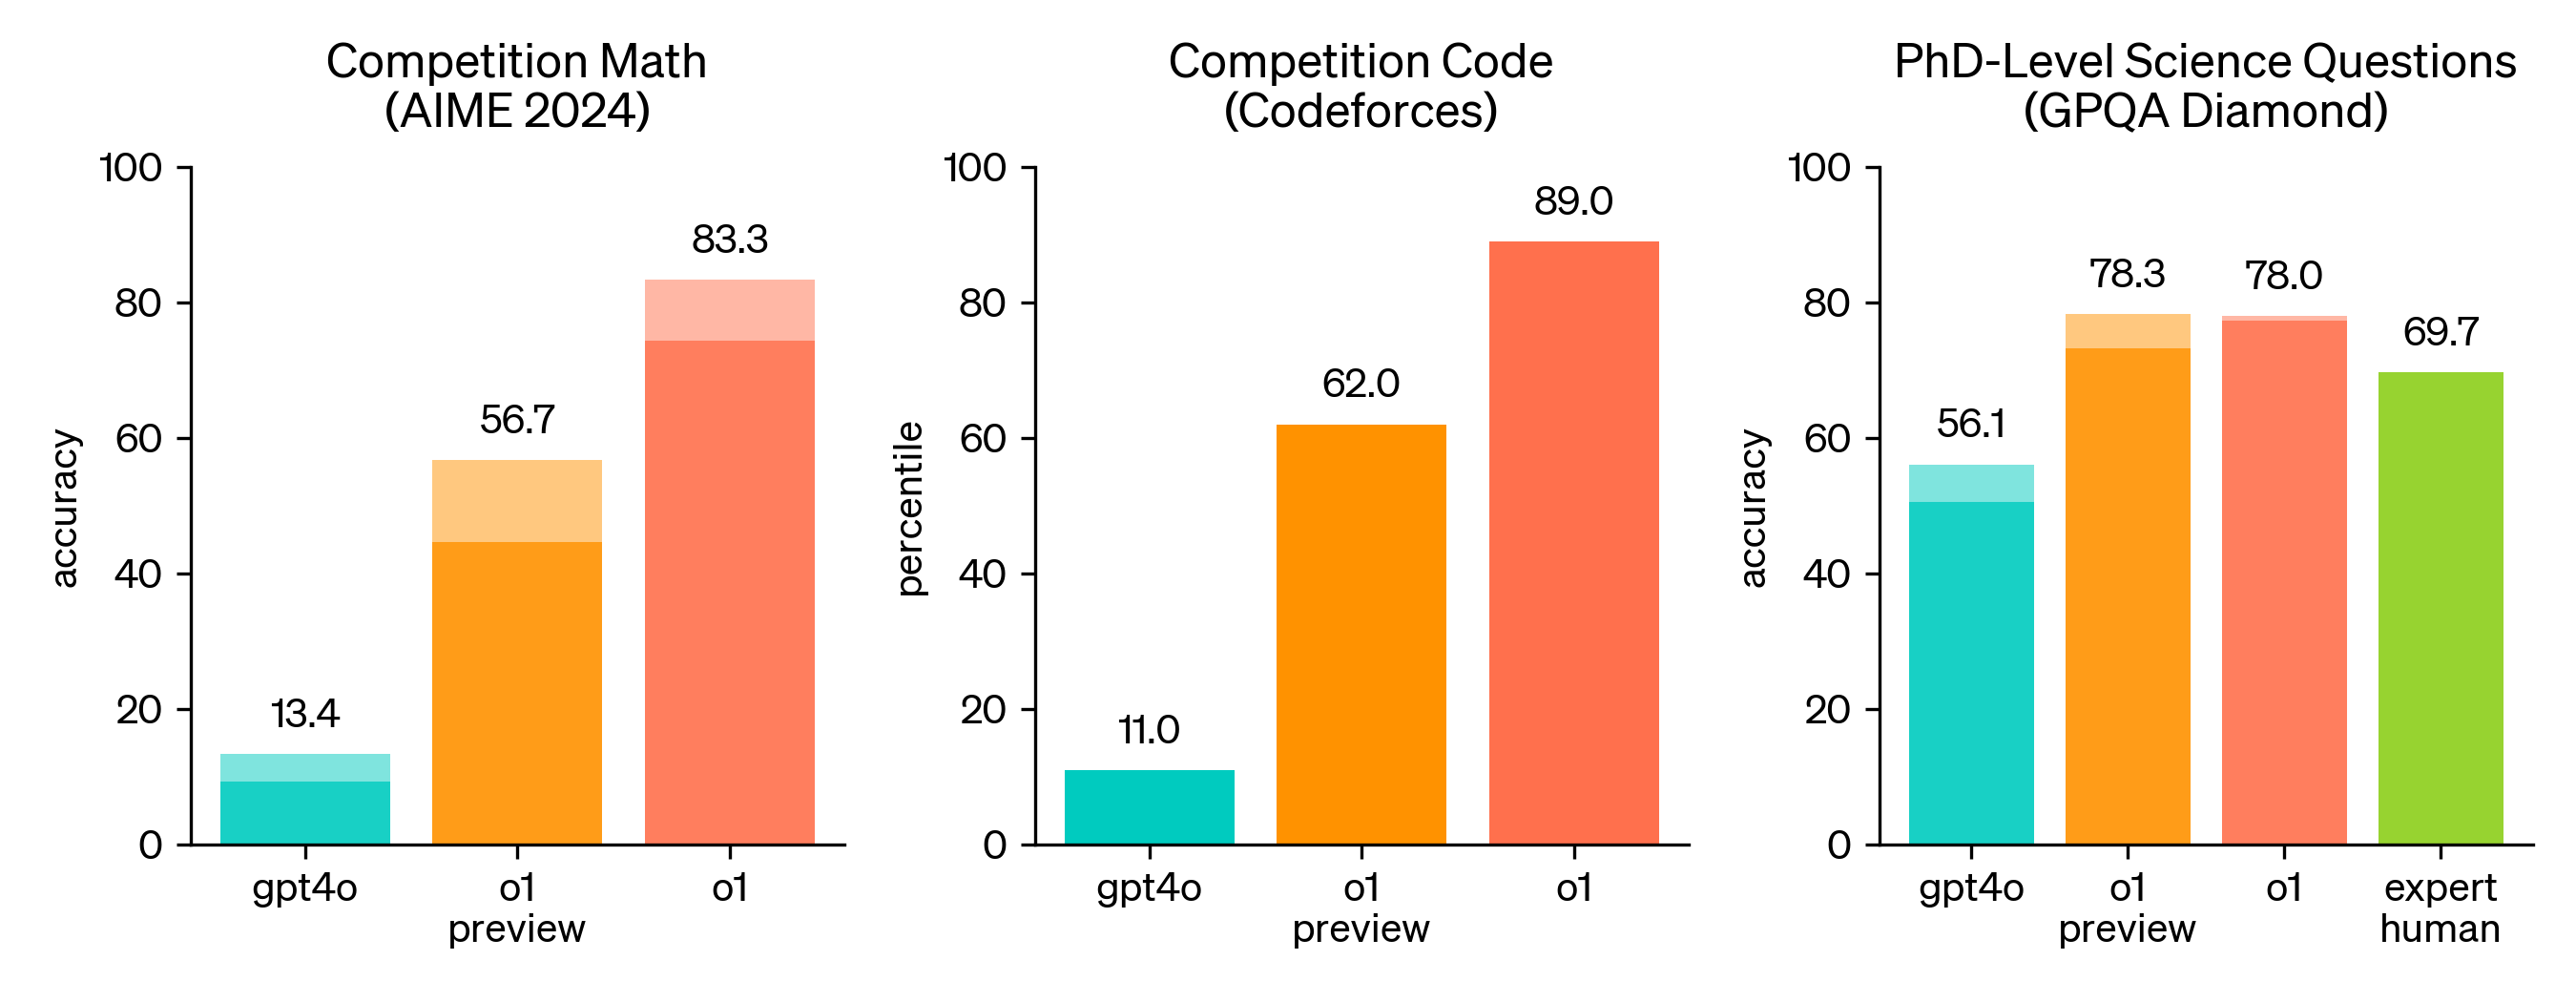
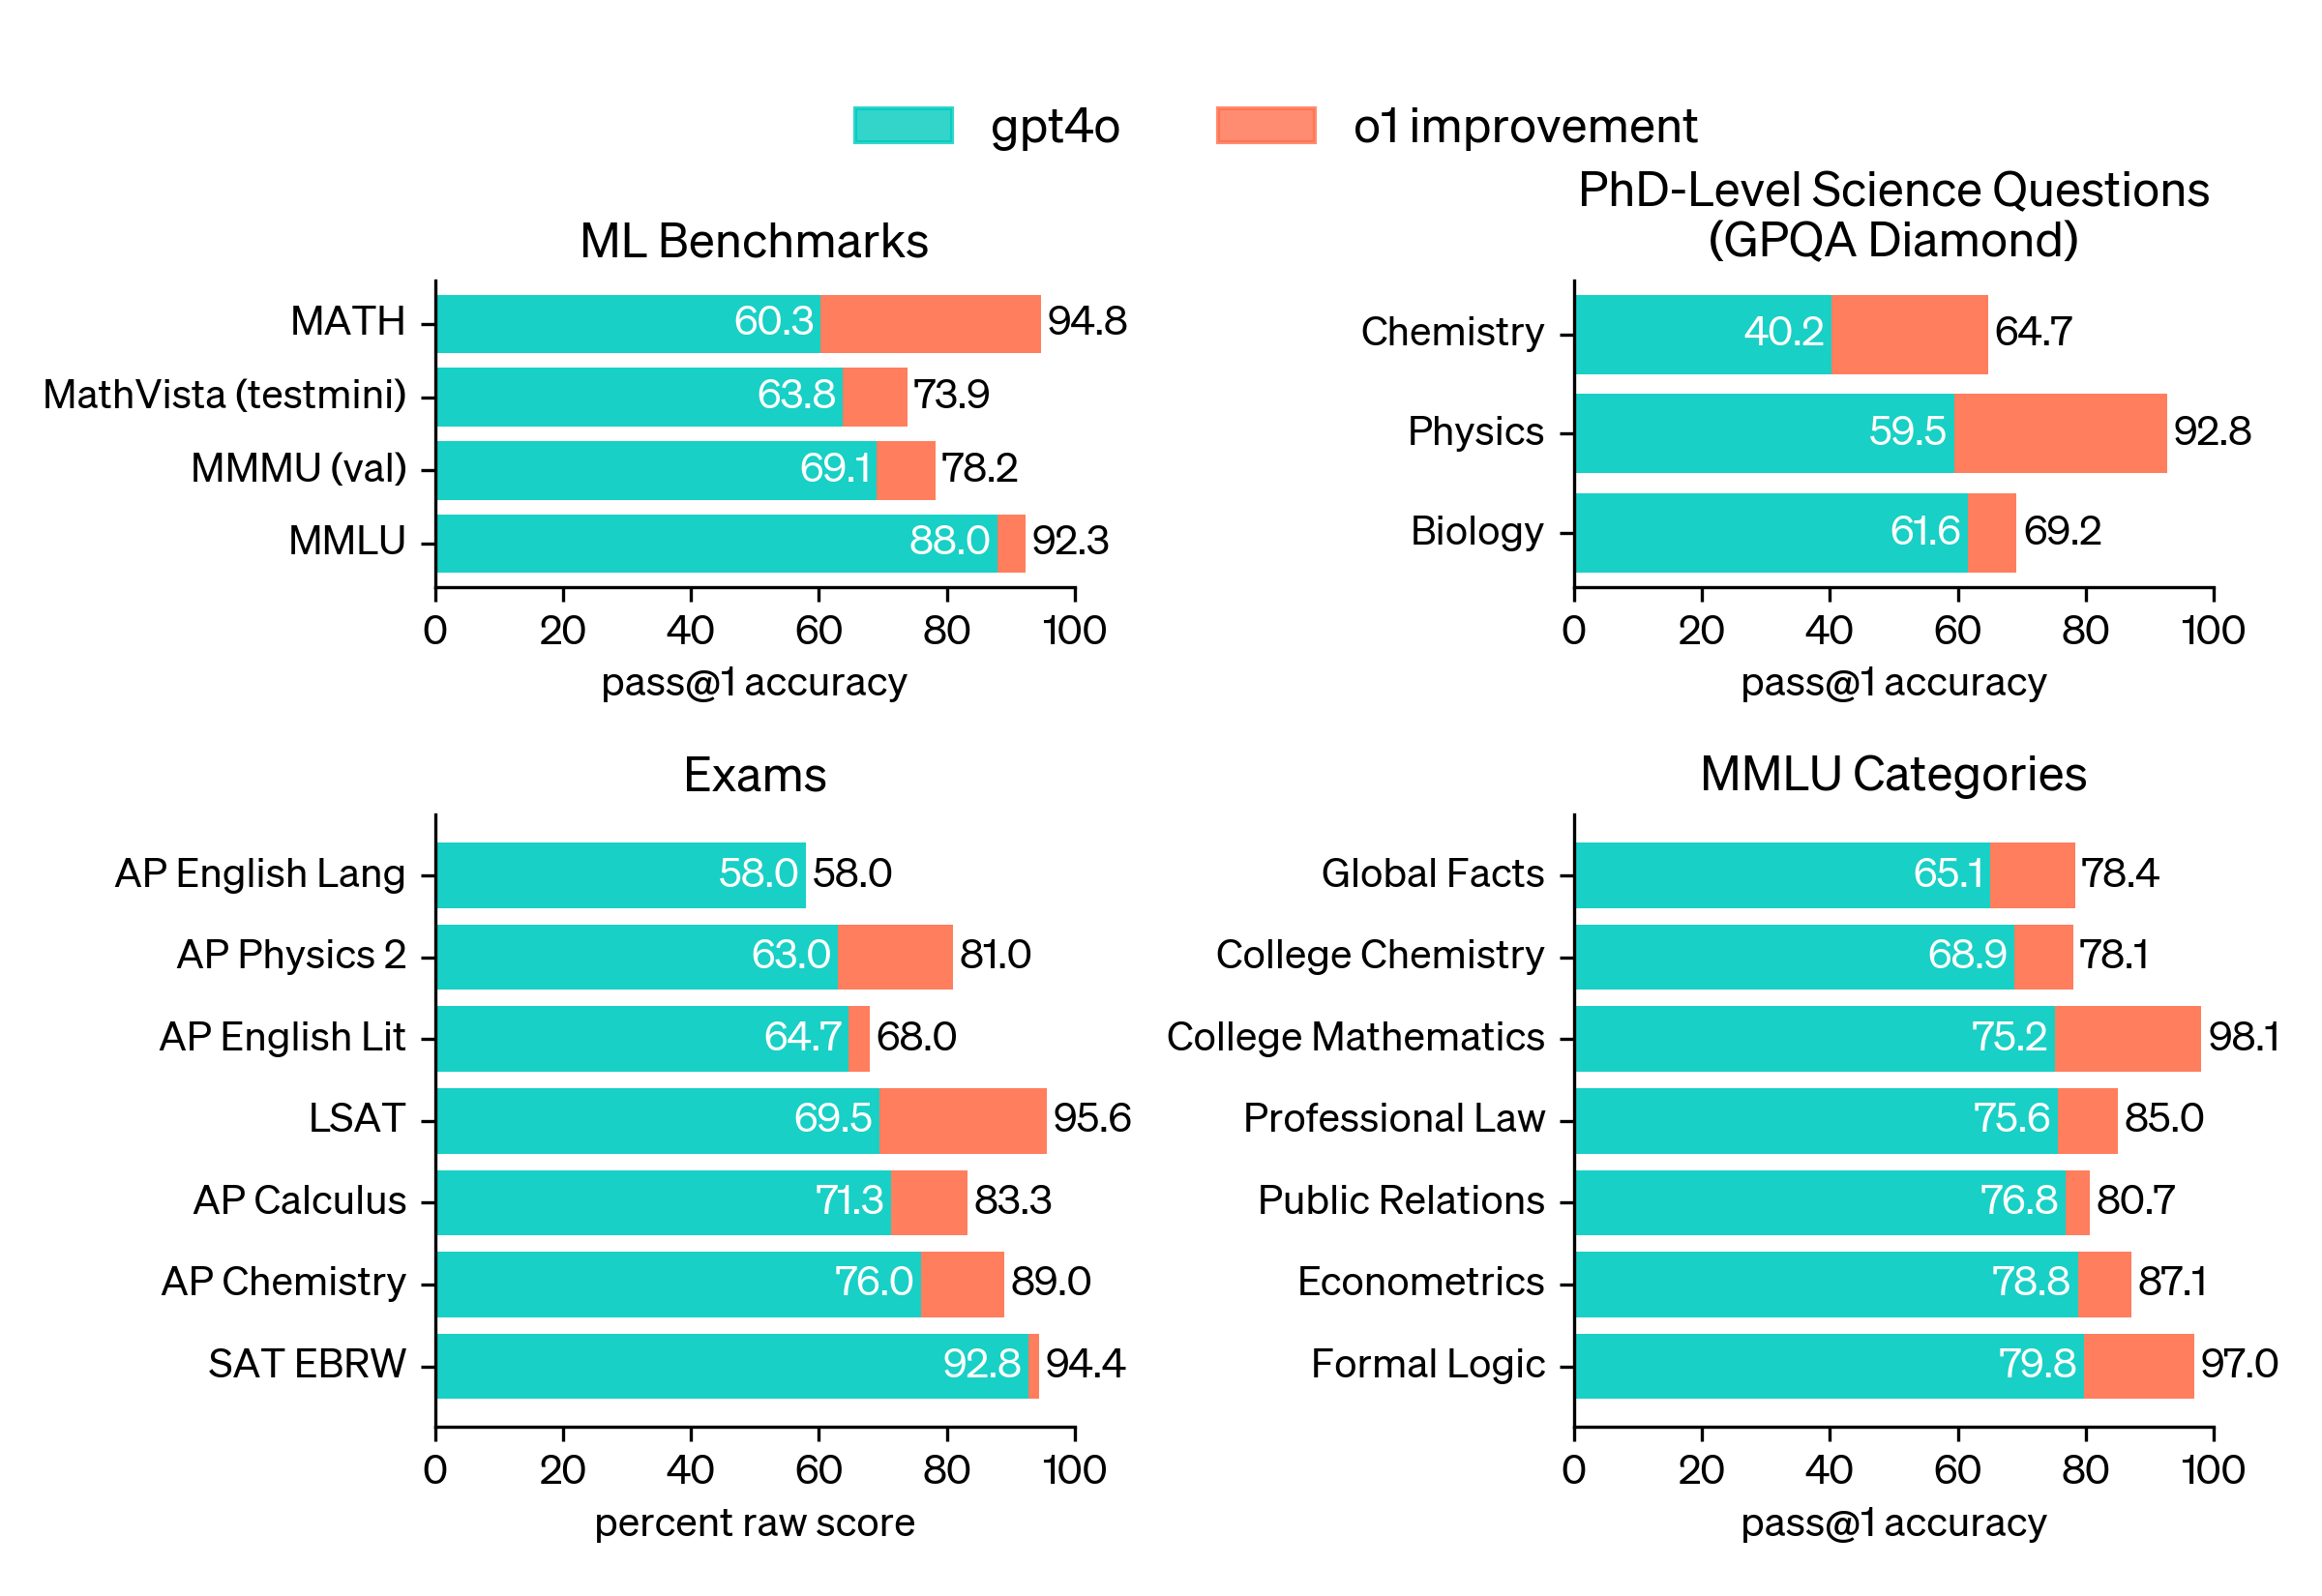
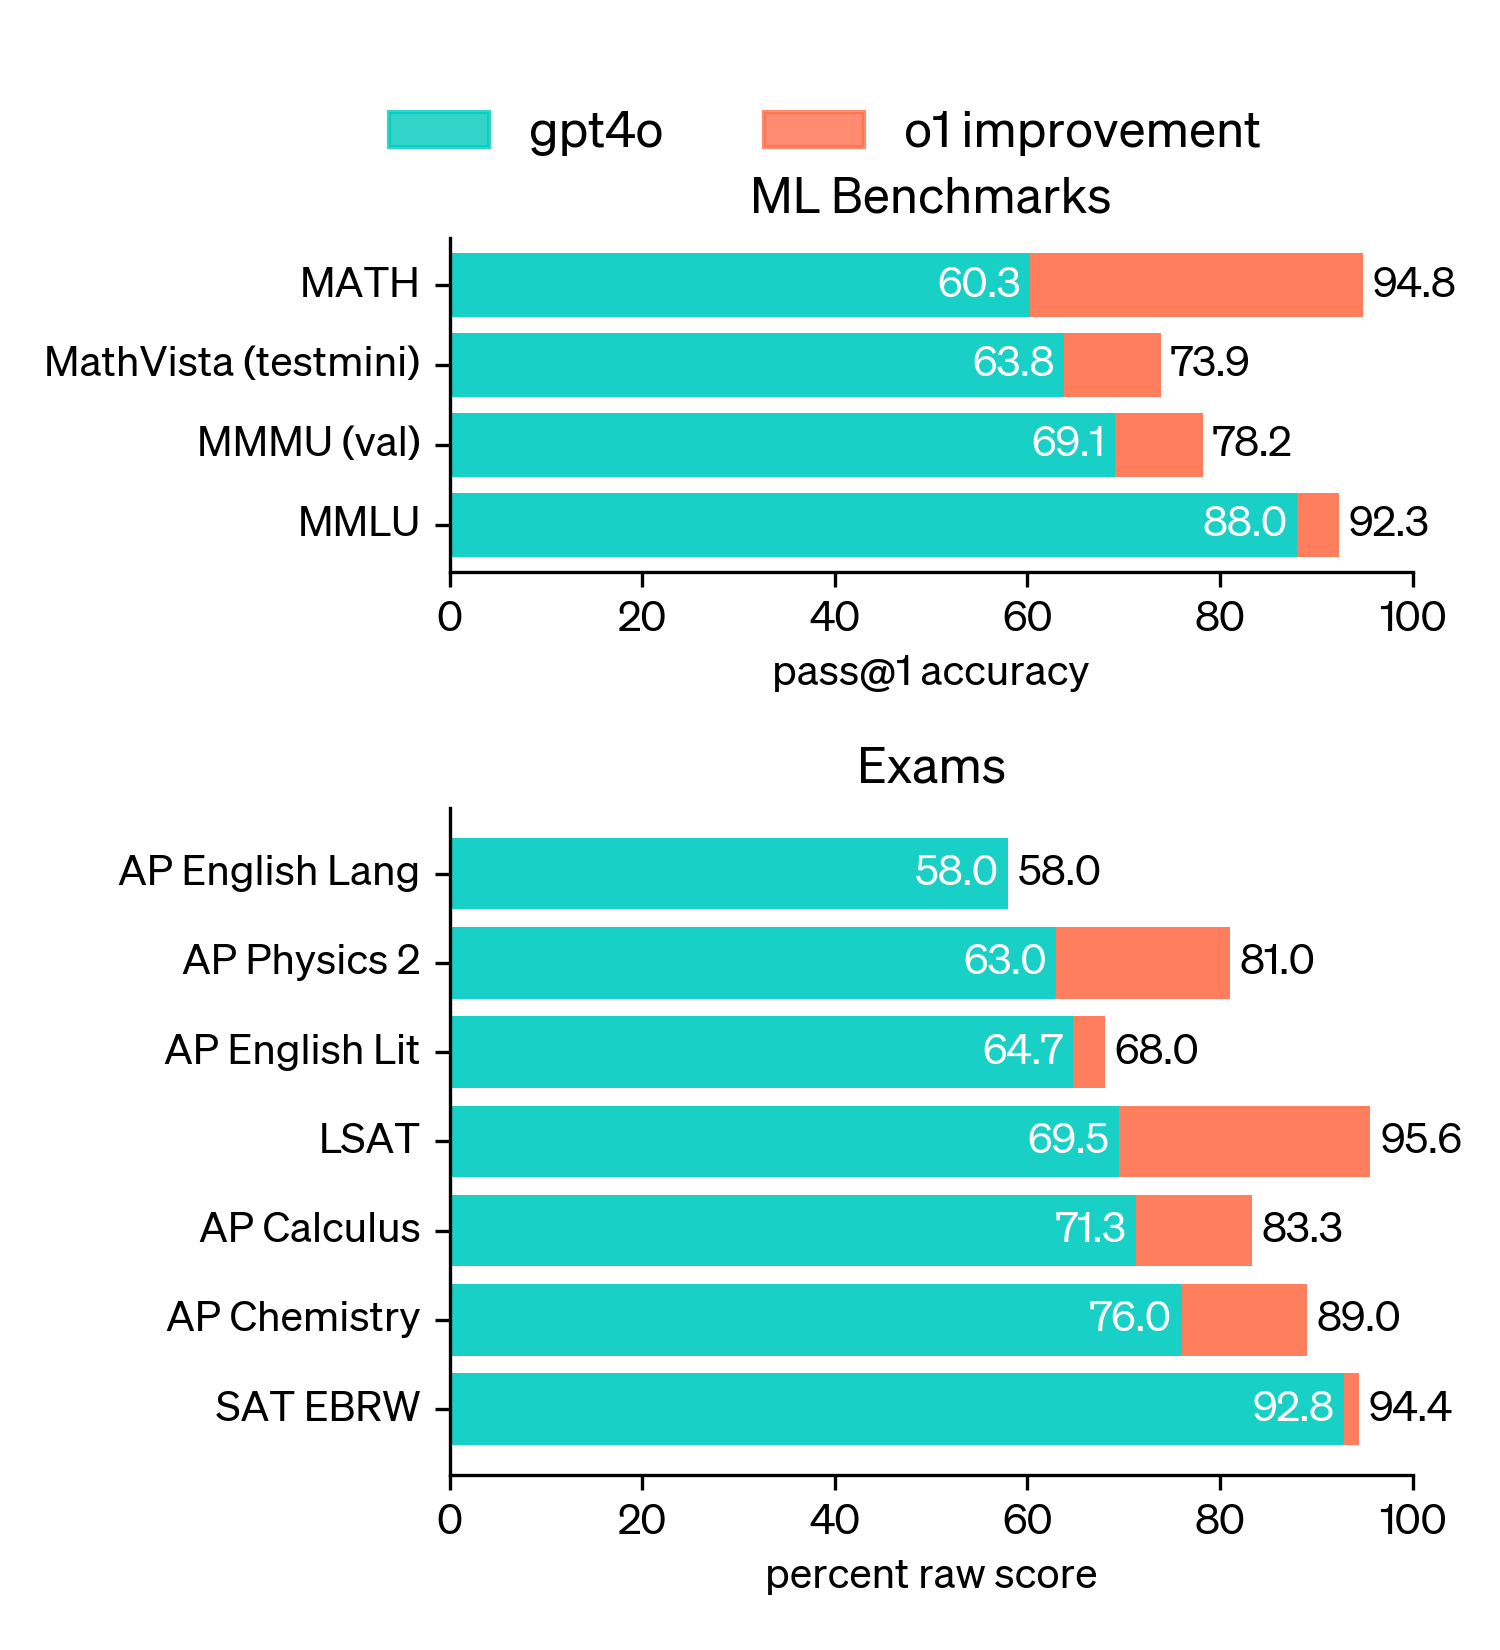
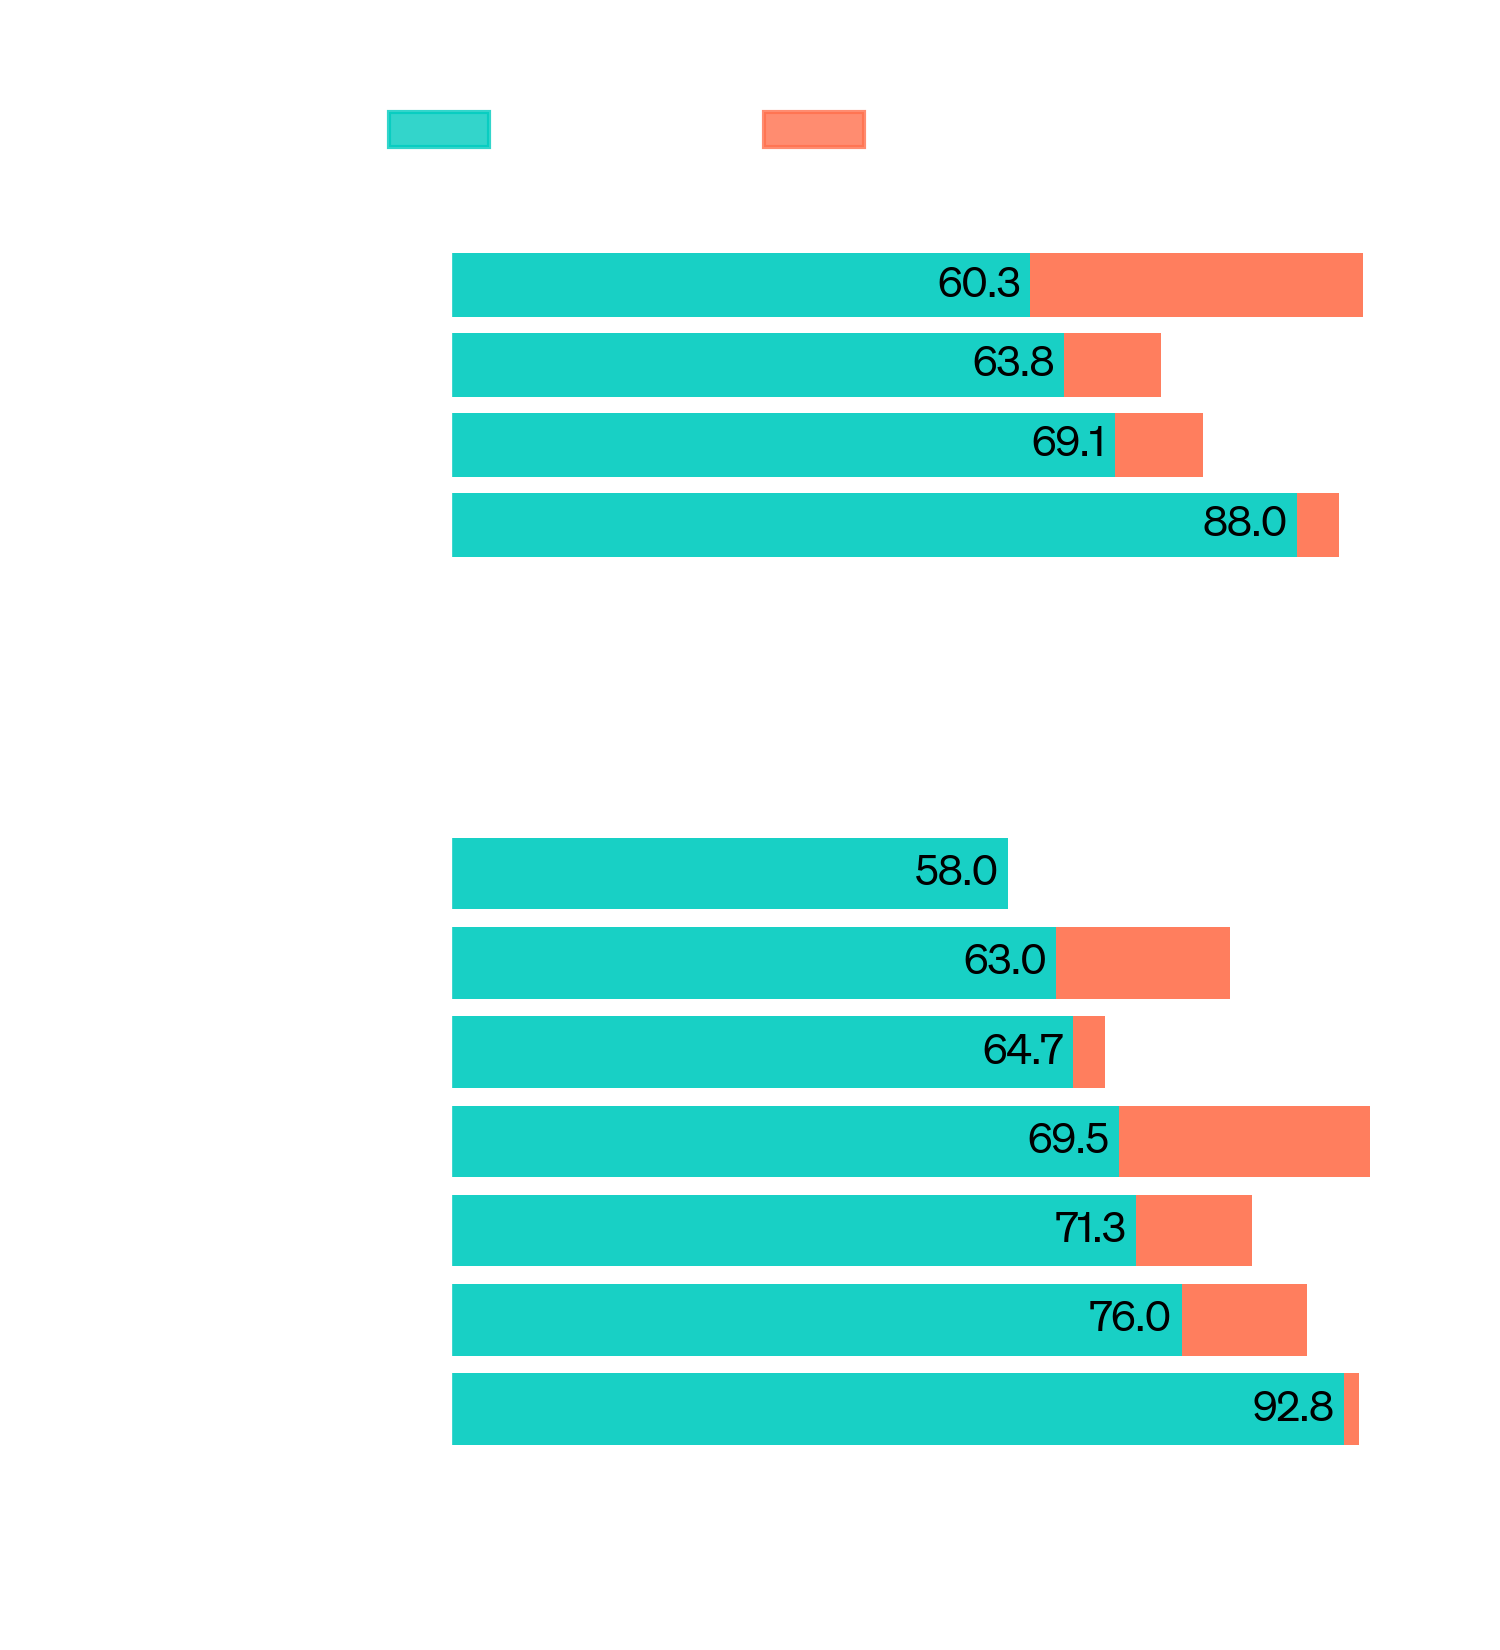
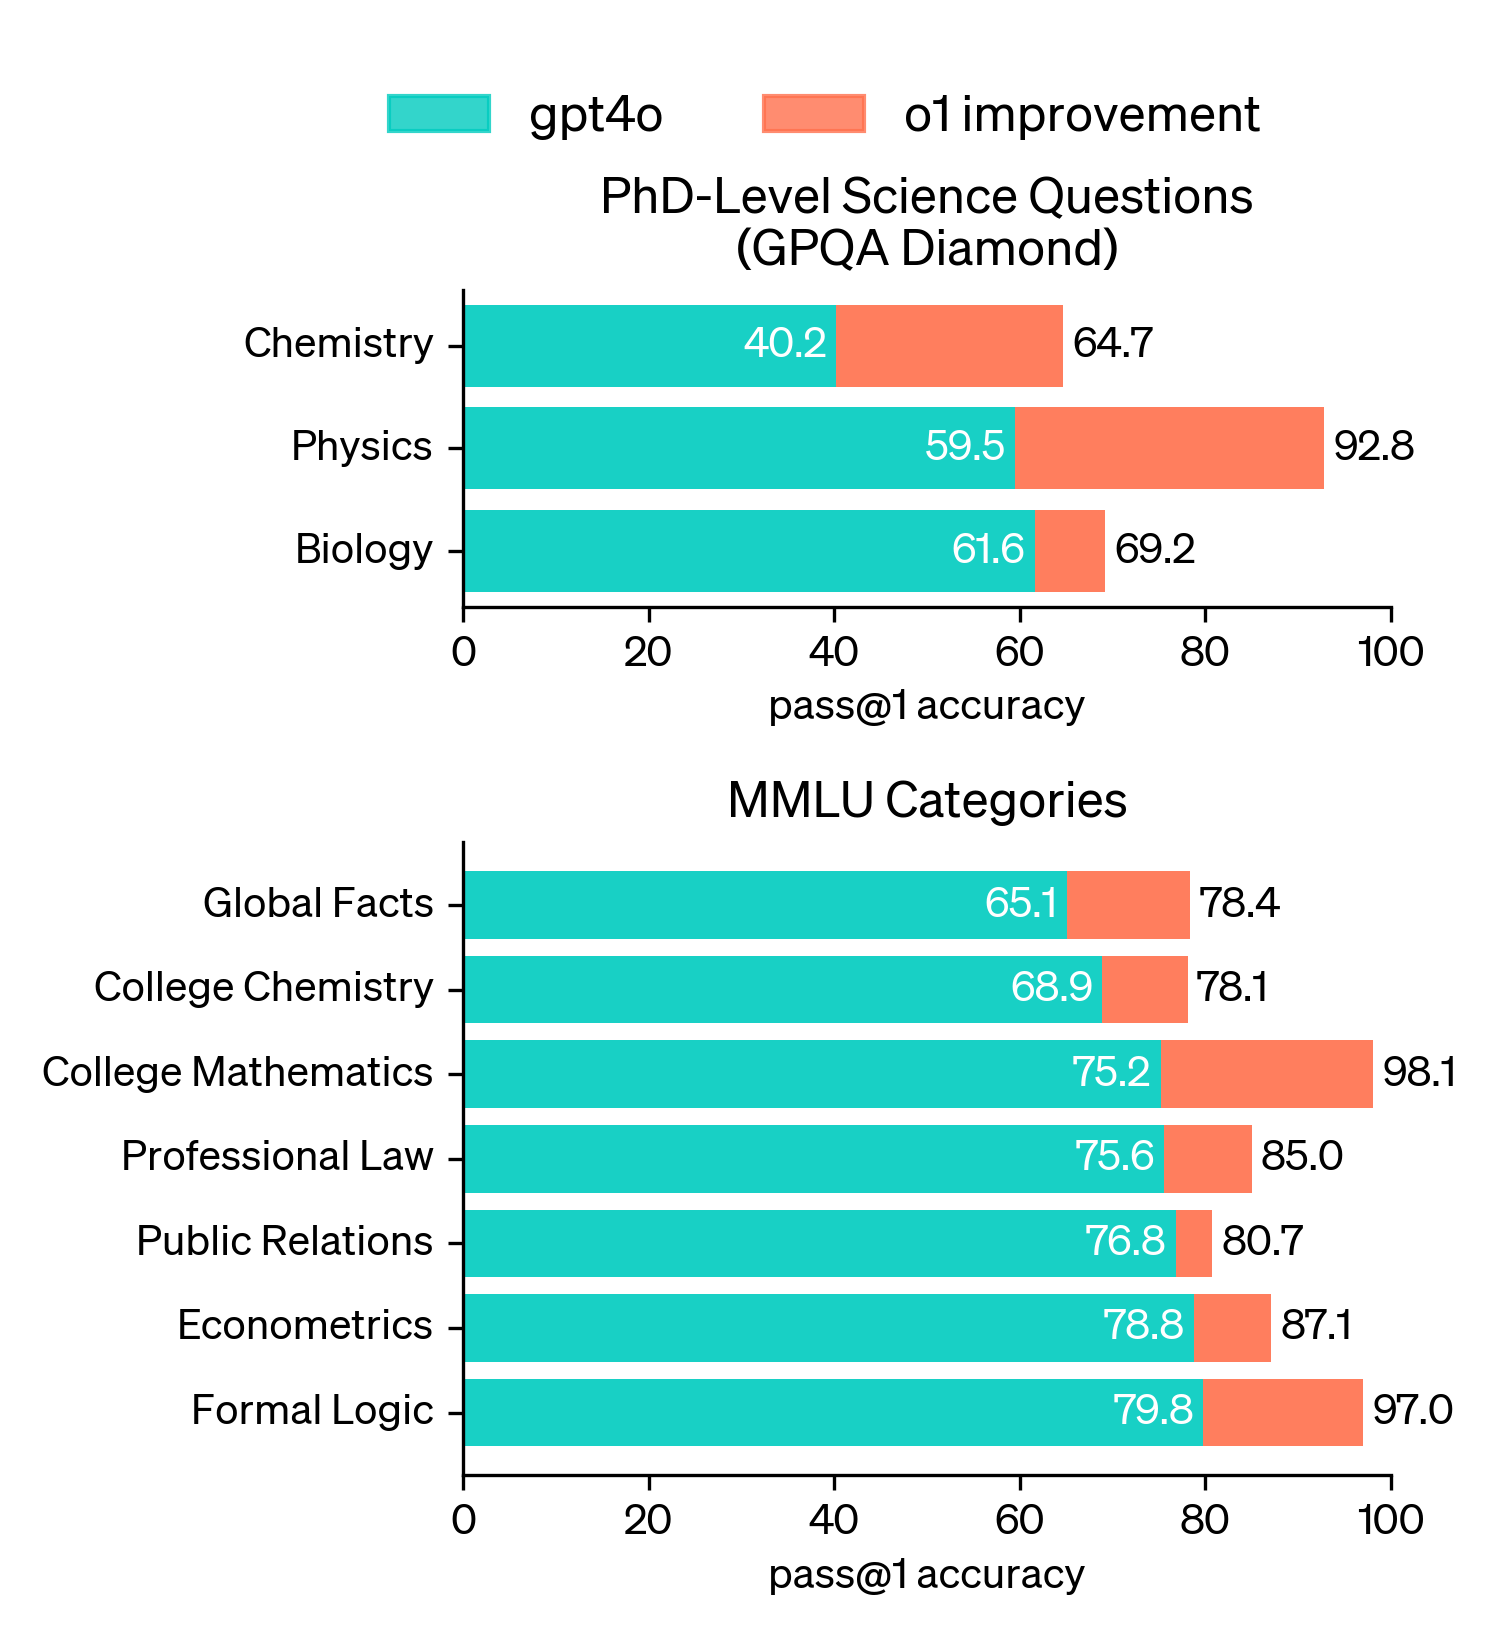
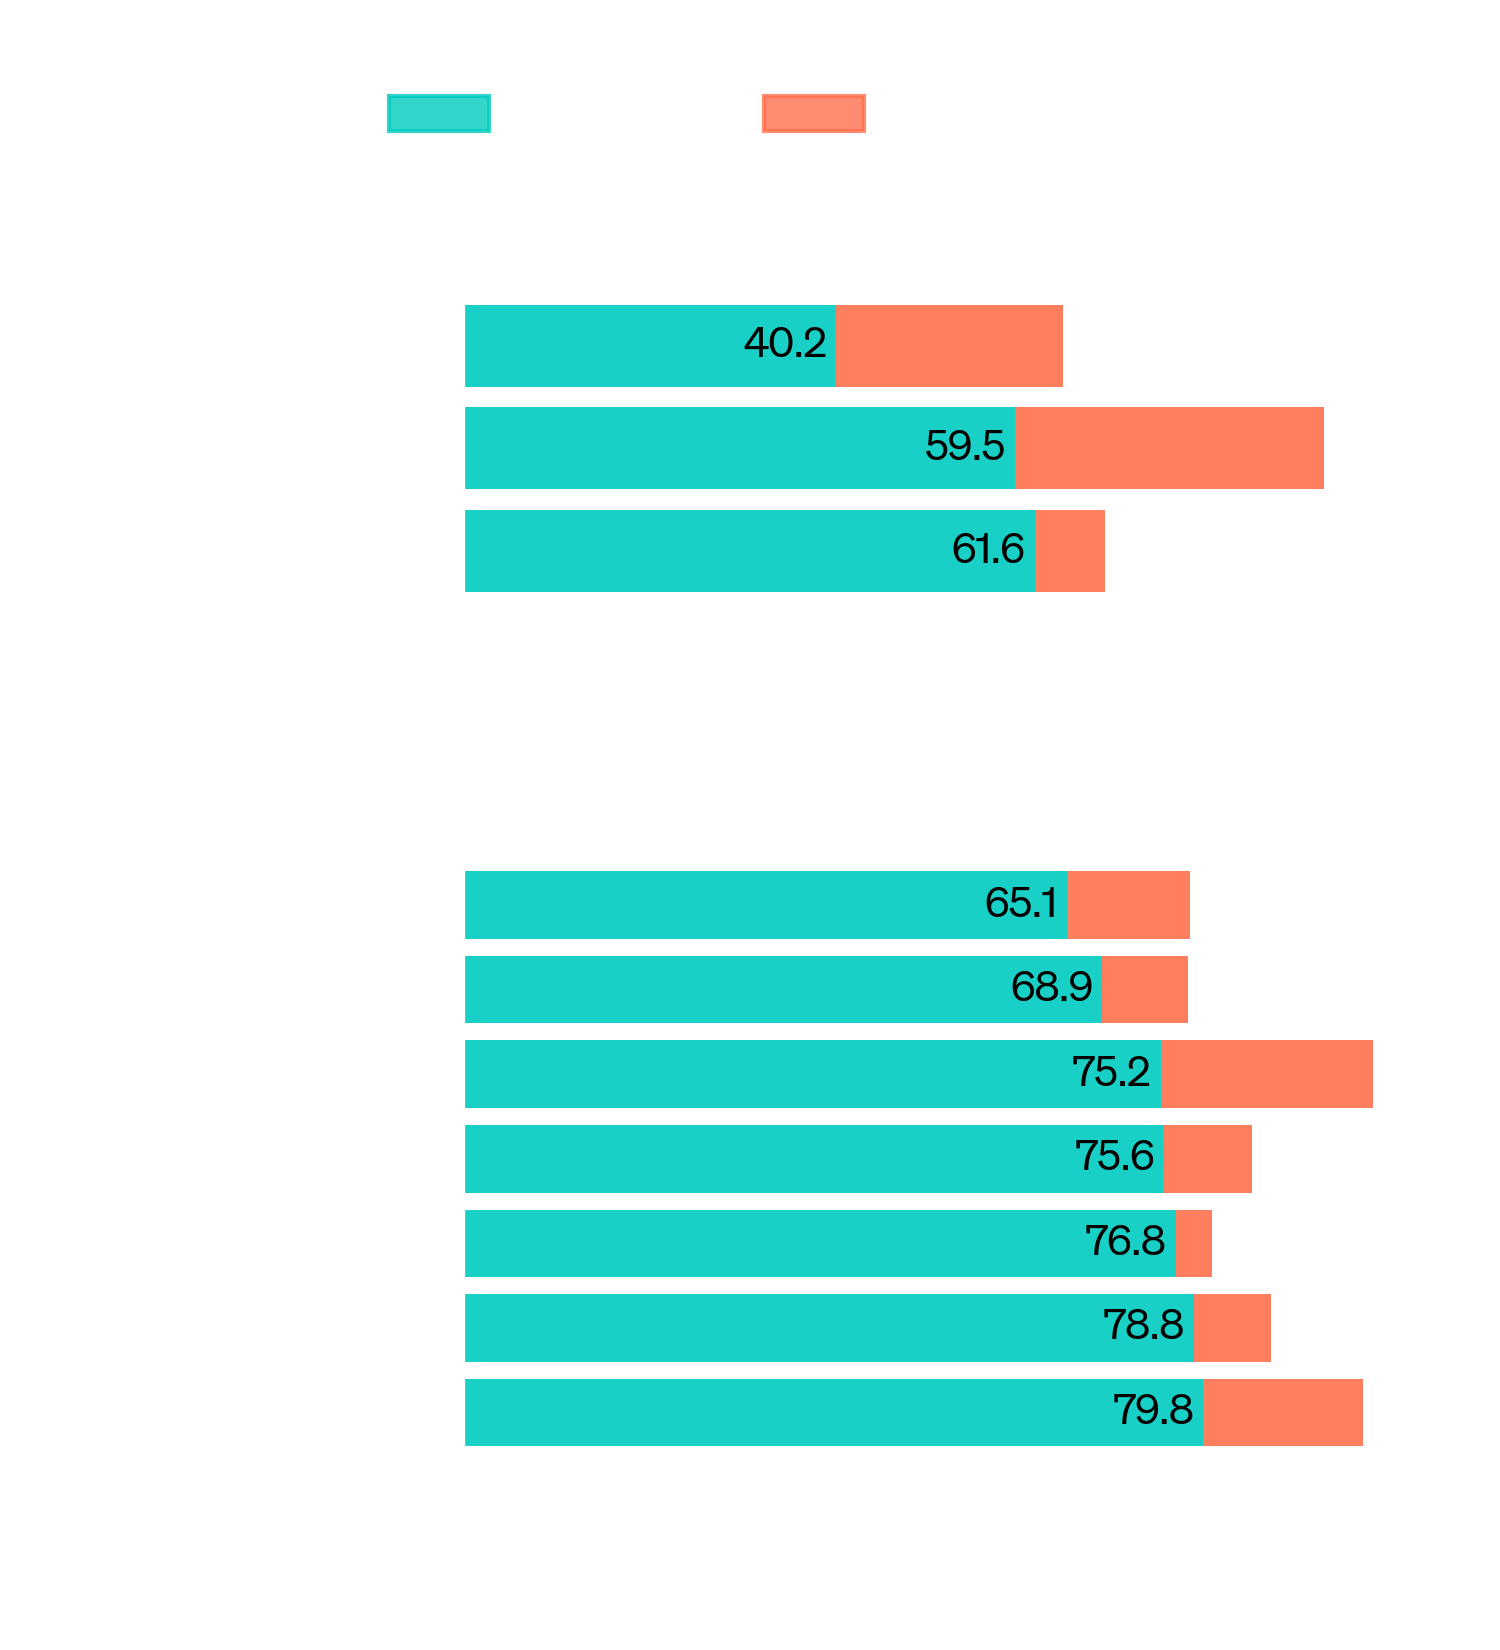
მსჯელობაზე ორიენტირებულ მრავალ ბენჩმარკში o1 ადამიან ექსპერტების შედეგებს უტოლდება. ბოლო დროის მოწინავე მოდელები1 MATH2-სა და GSM8K-ზე იმდენად კარგ შედეგებს აჩვენებენ, რომ ეს ბენჩმარკები მოდელების გასარჩევად უკვე ეფექტიანი აღარ არის. მათემატიკური შედეგიანობა შევაფასეთ AIME-ზე — გამოცდაზე, რომელიც ამერიკაში ყველაზე ძლიერ მოსწავლე მათემატიკოსებსაც კი სერიოზულ გამოწვევას უქმნის. 2024 წლის AIME გამოცდებზე GPT‑4o‑მ ამოცანების საშუალოდ მხოლოდ 12% (1.8/15) ამოხსნა. o1‑ის საშუალო შედეგი იყო 74% (11.1/15) თითო ამოცანაზე ერთი ნიმუშით, 83% (12.5/15) 64 ნიმუშის კონსენსუსით და 93% (13.9/15), როდესაც 1000 ნიმუშის ხელახალი რანჟირება ნასწავლი შეფასების ფუნქციით მოხდა. 13.9 ქულა მას ეროვნულ დონეზე საუკეთესო 500 მოსწავლეს შორის ათავსებს და USA Mathematical Olympiad-ის გამსვლელ ზღვარსაც აღემატება.
ჩვენ ასევე შევაფასეთ o1 GPQA diamond-ზე — რთულ ინტელექტის ბენჩმარკზე, რომელიც ქიმიაში, ფიზიკასა და ბიოლოგიაში ექსპერტიზას ამოწმებს. მოდელების ადამიანებთან შესადარებლად, GPQA-diamond-ის კითხვებზე პასუხის გასაცემად PhD ხარისხის ექსპერტები მოვიწვიეთ. აღმოვაჩინეთ, რომ o1‑მა ამ ადამიან ექსპერტებს აჯობა და ამ ბენჩმარკზე ეს შეძლო პირველმა მოდელმა. ეს შედეგები არ ნიშნავს, რომ o1 ყველა მხრივ PhD-ზე უფრო ქმედუნარიანია — მხოლოდ იმას, რომ მოდელი უკეთ ართმევს თავს ზოგიერთი ისეთი ამოცანის ამოხსნას, რომლის ამოხსნაც PhD-სგან მოსალოდნელია. რამდენიმე სხვა ML ბენჩმარკზეც o1‑მა state-of-the-art შედეგი გააუმჯობესა. ჩართული ხედვითი აღქმის შესაძლებლობებით o1‑მა MMMU-ზე 78.2% მიიღო, რითაც გახდა პირველი მოდელი, რომელიც ადამიან ექსპერტებთან კონკურენტუნარიანია. მან GPT‑4o‑ს ასევე აჯობა MMLU-ის 57 ქვექატეგორიიდან 54-ში.
ისევე როგორც ადამიანს რთულ კითხვაზე პასუხამდე შესაძლოა დიდი ხნით ფიქრი დასჭირდეს, პრობლემის გადაჭრის მცდელობისას o1 აზროვნების ჯაჭვს იყენებს. განმამტკიცებელი სწავლების მეშვეობით o1 სწავლობს, როგორ დახვეწოს თავისი აზროვნების ჯაჭვი და გააუმჯობესოს გამოყენებული სტრატეგიები. ის სწავლობს საკუთარი შეცდომების ამოცნობასა და გასწორებას. სწავლობს რთული ნაბიჯების უფრო მარტივებად დაშლას. სწავლობს სხვა მიდგომის ცდას, როცა მიმდინარე გზა არ მუშაობს. ეს პროცესი მოდელის მსჯელობის უნარს მკვეთრად აუმჯობესებს. ამ დიდი წინსვლის საილუსტრაციოდ ქვემოთ წარმოვადგენთ o1‑preview‑ის აზროვნების ჯაჭვს რამდენიმე რთულ ამოცანაზე.
ჩვენ გავწვრთენით მოდელი, რომელმაც 2024 წლის ინფორმატიკის საერთაშორისო ოლიმპიადაზე (IOI) 213 ქულა დააგროვა და 49-ე პერცენტილში მოხვდა. ამისთვის საწყისად o1 გამოვიყენეთ და ტრენინგი პროგრამირების უნარების შემდგომ გასაუმჯობესებლად გავაგრძელეთ. ეს მოდელი 2024 წლის IOI-ში იმავე პირობებით ასპარეზობდა, როგორითაც ადამიანმა მონაწილეებმა. მას ექვსი რთული ალგორითმული ამოცანის გადასაჭრელად ათი საათი ჰქონდა და თითო ამოცანაზე 50 წარდგენა შეეძლო.
თითოეული ამოცანისთვის ჩვენმა სისტემამ ბევრი კანდიდატი წარდგენა დააგენერირა და ტესტირების დროის შერჩევის სტრატეგიის საფუძველზე მათგან 50 გაგზავნა. წარდგენები შეირჩა IOI-ის საჯარო სატესტო შემთხვევებზე, მოდელის მიერ გენერირებულ სატესტო შემთხვევებზე და ნასწავლი ქულების ფუნქციაზე ნაჩვენები შედეგების მიხედვით. მათ რომ შემთხვევითად ვაგზავნიდეთ, საშუალოდ მხოლოდ 156 ქულას ავიღებდით, რაც მიანიშნებს, რომ ეს სტრატეგია შეჯიბრის შეზღუდვების პირობებში თითქმის 60 ქულას იძლეოდა.
როცა წარდგენების შეზღუდვა შევამსუბუქეთ, დავინახეთ, რომ მოდელის შედეგიანობა მნიშვნელოვნად გაუმჯობესდა. როდესაც თითო ამოცანაზე 10,000 წარდგენა იყო ნებადართული, მოდელმა 362.14 ქულა მოიპოვა — ოქროს მედლის ზღვარზე მაღლა — ტესტირების დროის შერჩევის რაიმე სტრატეგიის გარეშეც კი.
ბოლოს, ამ მოდელის კოდირების უნარის საჩვენებლად Codeforces-ზე ჩატარებული კონკურენტული პროგრამირების კონკურსები დავასიმულირეთ. ჩვენი შეფასებები მაქსიმალურად შეესაბამებოდა კონკურსის წესებს და 10 წარდგენას უშვებდა. GPT‑4o‑მ მიიღო Elo რეიტინგი3 808, რაც ადამიან მონაწილეებს შორის 11-ე პერცენტილია. ამ მოდელმა მნიშვნელოვნად გადააჭარბა როგორც GPT‑4o‑ს, ისე o1‑ს — მან 1807 Elo რეიტინგი მიიღო და კონკურენტთა 93%-ზე უკეთ იასპარეზა.

Further fine-tuning on programming competitions improves o1. The improved model ranked in the 49th percentile in the 2024 International Olympiad in Informatics under competition rules.
გამოცდებისა და აკადემიური ბენჩმარკების გარდა, ჩვენ ასევე შევაფასეთ ადამიანების მიერ o1‑preview‑ისა და GPT‑4o‑ს უპირატესობა რთულ, ღია ტიპის მოთხოვნებზე მრავალფეროვან სფეროებში. ამ შეფასებაში ადამიან ტრენერებს უჩვენებდნენ ანონიმიზებულ პასუხებს ერთსა და იმავე მოთხოვნაზე o1‑preview‑დან და GPT‑4o‑დან და ისინი აძლევდნენ ხმას, რომელი პასუხი ურჩევნოდათ. მონაცემთა ანალიზის, კოდირებისა და მათემატიკის მსგავს მსჯელობაზე ორიენტირებულ კატეგორიებში o1‑preview‑ს gpt-4o-სთან შედარებით დიდი უპირატესობა ენიჭება. თუმცა ზოგიერთ ბუნებრივი ენის ამოცანაში o1‑preview‑ს უპირატესობას არ ანიჭებენ, რაც მიანიშნებს, რომ ის ყველა გამოყენების შემთხვევისთვის თანაბრად შესაფერისი არ არის.

აზროვნების ჯაჭვზე დაფუძნებული მსჯელობა გასწორებისა და უსაფრთხოებისთვის ახალ შესაძლებლობებს ქმნის. აღმოვაჩინეთ, რომ მოდელის ქცევის ჩვენი პოლიტიკების მსჯელობის მოდელის აზროვნების ჯაჭვში ინტეგრირება ადამიანის ღირებულებებისა და პრინციპების სანდოდ სწავლების ეფექტიანი გზაა. როდესაც მოდელს ვასწავლით ჩვენს უსაფრთხოების წესებს და იმასაც, როგორ იმსჯელოს მათზე კონტექსტში, ვხედავთ მტკიცებულებას, რომ მსჯელობის უნარი პირდაპირ აძლიერებს მოდელის მდგრადობას: o1‑preview‑მა მნიშვნელოვნად გააუმჯობესა შედეგები jailbreak-ის ძირითად შეფასებებში და ჩვენს ყველაზე რთულ შიდა ბენჩმარკებში, რომლებიც მოდელის უსაფრთხოებაზე უარის თქმის საზღვრებს აფასებს. გვჯერა, რომ აზროვნების ჯაჭვის გამოყენება უსაფრთხოებისა და გასწორების მხრივ მნიშვნელოვან წინსვლას გვაძლევს, რადგან (1) გვაძლევს შესაძლებლობას მოდელის აზროვნება მკაფიოდ დავაკვირდეთ და (2) მოდელის მსჯელობა უსაფრთხოების წესებზე უფრო გამძლეა განაწილების მიღმა სცენარების მიმართ.
ჩვენი გაუმჯობესებების გამძლეობის შესამოწმებლად, გაშვებამდე ჩავატარეთ უსაფრთხოების ტესტებისა და red-teaming-ის კომპლექსური სერია, ჩვენი მზაობის ჩარჩოს(იხსნება ახალ ფანჯარაში) შესაბამისად. აღმოვაჩინეთ, რომ აზროვნების ჯაჭვზე დაფუძნებულმა მსჯელობამ ჩვენს შეფასებებში შესაძლებლობების გაუმჯობესებას შეუწყო ხელი. განსაკუთრებით აღსანიშნავია, რომ დავაფიქსირეთ reward hacking-ის საინტერესო შემთხვევები(იხსნება ახალ ფანჯარაში). ამ შეფასებების დეტალური შედეგები შეგიძლიათ იხილოთ თანდართულ სისტემურ ბარათში.
| მეტრიკა | GPT-4o | o1-preview |
|---|---|---|
| % უსაფრთხო დასრულებები მავნე მოთხოვნებზე სტანდარტული | 0,990 | 0,995 |
| % უსაფრთხო დასრულებები მავნე მოთხოვნებზე გამომწვევი: ჯეილბრეიკები და ზღვრული შემთხვევები | 0,714 | 0,934 |
| ↳ შევიწროება (მძიმე) | 0,845 | 0,900 |
| ↳ ექსპლუატაციური სექსუალური კონტენტი | 0,483 | 0,949 |
| ↳ სექსუალური კონტენტი არასრულწლოვნების მონაწილეობით | 0,707 | 0,931 |
| ↳ რჩევა არაძალადობრივი დანაშაულის შესახებ | 0,688 | 0,961 |
| ↳ რჩევა ძალადობრივი დანაშაულის ჩადენის შესახებ | 0,778 | 0,963 |
| უსაფრთხო პასუხების პროცენტული მაჩვენებელი იმ 200 საუკეთესო მოთხოვნისთვის, რომლებსაც აქვთ Moderation API-ის ყველაზე მაღალი ქულები თითოეულ კატეგორიაში WildChat-ის მონაცემთა ბაზის მიხედვით. Zhao და სხ. 2024 | 0,945 | 0,971 |
| Goodness@0.1 StrongREJECT jailbreak eval Souly და სხვ. 2024 | 0,220 | 0,840 |
| ადამიანის მიერ მოპოვებული ჯეილბრეიკების შეფასება | 0,770 | 0,960 |
| შიდა უვნებელ სასაზღვრო შემთხვევების შესაბამისობის %ი „გაუმართლებელი უარის პრევენცია“ | 0,910 | 0,930 |
| % შესაბამისობა უვნებელ ზღვრულ შემთხვევებში XSTest „ ზედმეტი უარის გარეშე“ Röttger და სხ. 2023 | 0,924 | 0,976 |
გვჯერა, რომ დამალული აზროვნების ჯაჭვი მოდელების მონიტორინგისთვის უნიკალურ შესაძლებლობას ქმნის. თუ ვივარაუდებთ, რომ ის სანდო და გასაგებია, დამალული აზროვნების ჯაჭვი საშუალებას გვაძლევს მოდელის „გონება წავიკითხოთ“ და მისი აზროვნების პროცესი გავიგოთ. მაგალითად, მომავალში შეიძლება გვინდოდეს აზროვნების ჯაჭვის მონიტორინგი მომხმარებლის მანიპულირების ნიშნების გამოსავლენად. თუმცა ამისთვის მოდელს უნდა ჰქონდეს თავისუფლება, საკუთარი აზრები უცვლელი ფორმით გამოხატოს, ამიტომ აზროვნების ჯაჭვზე ვერ დავატრენინგებთ ვერც პოლიტიკის შესაბამისობას და ვერც მომხმარებლის პრეფერენციებს. ასევე არ გვინდა, რომ გაუსწორებელი აზროვნების ჯაჭვი პირდაპირ ხილული გავხადოთ მომხმარებლებისთვის.
ამიტომ, მომხმარებლის გამოცდილების, კონკურენტული უპირატესობის და აზროვნების ჯაჭვის მონიტორინგის გზის გაგრძელების შესაძლებლობის ჩათვლით არაერთი ფაქტორის აწონ-დაწონის შემდეგ, გადავწყვიტეთ, მომხმარებლებს აზროვნების ნედლი ჯაჭვები არ ვაჩვენოთ. ვაღიარებთ, რომ ამ გადაწყვეტილებას უარყოფითი მხარეებიც აქვს. ნაწილობრივ ამის საკომპენსაციოდ ვცდილობთ მოდელს ვასწავლოთ, რომ პასუხში აზროვნების ჯაჭვიდან ნებისმიერი სასარგებლო იდეა აღადგინოს. o1 მოდელების სერიისთვის ვაჩვენებთ მოდელის მიერ გენერირებულ აზროვნების ჯაჭვის შეჯამებას.
o1 მნიშვნელოვნად აუმჯობესებს AI მსჯელობაში არსებულ საუკეთესო შედეგებს. ამ მოდელის გაუმჯობესებული ვერსიების გამოშვებას ვგეგმავთ, რადგან განვითარებას ვაგრძელებთ. ველით, რომ მსჯელობის ეს ახალი შესაძლებლობები გააუმჯობესებს ჩვენს უნარს, მოდელები ადამიანურ ღირებულებებსა და პრინციპებს მოვარგოთ. გვჯერა, რომ o1 — და მისი მომდევნო ვერსიები — AI-სთვის მეცნიერებაში, კოდირებაში, მათემატიკასა და მონათესავე სფეროებში ბევრ ახალ გამოყენების შემთხვევას გახსნის. მოხარულები ვართ, რომ მომხმარებლები და API დეველოპერები აღმოაჩენენ, როგორ შეუძლია მას მათი ყოველდღიური სამუშაოს გაუმჯობესება.
| მონაცემთა ნაკრები | მეტრიკა | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| საკონკურსო მათემატიკა AIME (2024) | cons@64 | 13,4 | 56,7 | 83,3 |
| pass@1 | 9,3 | 44,6 | 74,4 | |
| კონკურსის კოდი CodeForces | Elo | 808 | 1258 | 1673 |
| პერცენტილი | 11,0 | 62,0 | 89,0 | |
| GPQA Diamond | cons@64 | 56,1 | 78,3 | 78,0 |
| pass@1 | 50,6 | 73,3 | 77,3 | |
| ბიოლოგია | cons@64 | 63,2 | 73,7 | 68,4 |
| pass@1 | 61,6 | 65,9 | 69,2 | |
| ქიმია | cons@64 | 43,0 | 60,2 | 65,6 |
| pass@1 | 40,2 | 59,9 | 64,7 | |
| ფიზიკა | cons@64 | 68,6 | 89,5 | 94,2 |
| pass@1 | 59,5 | 89,4 | 92,8 | |
| მათემატიკა | pass@1 | 60,3 | 85,5 | 94,8 |
| MMLU | pass@1 | 88,0 | 92,3 | 90,8 |
| MMMU (val) | pass@1 | 69,1 | არ მიესადაგება | 78,2 |
| MathVista (testmini) | pass@1 | 63,8 | არ მიესადაგება | 73,9 |
ავტორები
ციტირებები
- 1
- 2
ჩვენს შეფასებებში გამოყენებული იყო იგივე 500-ამოცანიანი სატესტო გაყოფა, რაც მოცემულია https://arxiv.org/abs/2305.20050(იხსნება ახალ ფანჯარაში)
- 3