A Daybreak bővítése a kibervédelmi időablak szűkülésével
Új lehetőségeket mutatunk be a fejlett kiberképességek kiaknázására legújabb, kiberbiztonságra szakosodott modellünkkel, a GPT‑5.6‑Cyberrel.
A kiberbiztonság világa gyorsan változik: a fenyegetési szereplők egyre inkább MI-t használnak majd kibertámadások végrehajtására, korábban nem látott sebességgel és léptékben, akár teljesen önállóan is. E képességek terjedésével a védekezőknek egyre kevesebb idejük marad a felkészülésre. Válaszunk az, hogy az élvonalbeli intelligenciát világszerte megbízható védekezők kezébe adjuk, mielőtt a támadók széles körben bevetnék a támadó MI-képességeket.
Két hozzáférési szinttel bővítjük az OpenAI Daybreak szolgáltatást, hogy a jóváhagyott védekezők a munkájukhoz megfelelő képességeket kapják:
A Daybreak Blue hozzáférést ad az élvonalbeli, általános célú modellekhez, köztük a GPT‑5.6 Solhoz, az engedélyezett védelmi munkára szabott óvintézkedésekkel. A legtöbb védekezőnek ezt ajánljuk kiindulópontként; támogatja a sebezhetőségek felderítését, a biztonságos kódellenőrzést, a kártevőelemzést, az incidenskezelést és a javítások ellenőrzését.
A Daybreak Red hozzáférést biztosít célirányosan betanított kiberbiztonsági modelljeinkhez engedélyezett sebezhetőségkutatás, exploit-ellenőrzés és biztonsági tesztelés céljára.
Bemutatjuk továbbá a Daybreak Reden keresztül elérhető GPT‑5.6‑Cybert. A GPT‑5.6 Sol alapjaira épülő modellt több speciális kiberbiztonsági feladatban – például nulladik napi sebezhetőségek felderítésében és exploitláncok kidolgozásában – nyújtott képességeinek javítására, valamint bizonyos nagyobb kockázatú, kettős felhasználású kiberfeladatok visszautasításának csökkentésére tanítottuk.
A Daybreak fejlett kiberképességeket tesz elérhetővé
Ahogy korábban már ismertettük, a GPT‑5.6 Sol a legkorszerűbb teljesítményt nyújtja a kiberbiztonsági feladatokban. Éles környezetben rendszerszintű óvintézkedésekkel szűrjük a kiberbiztonsági kéréseket a visszaélések megelőzésére, ám ezek a jogszerű védelmi munkát is akadályozhatják. A Daybreak Blue hozzáférés megszünteti ezeket a korlátokat, így a védekezők többet hozhatnak ki a modellből valós biztonsági feladatokban, például incidensek észlelésében és kezelésében, vizsgálatokban, sebezhetőségkezelésben és biztonsági felmérésekben.
A GPT‑5.6 Sol rendszerszintű korlátok nélkül is visszautasít egyes, erősen kettős felhasználású kiberbiztonsági utasításokat, például éles rendszerek behatolástesztelését. Ennek kezelésére úgy tanítottuk be a Daybreak Red hozzáféréssel elérhető GPT‑5.6‑Cybert, hogy tovább csökkentse a visszautasításokat, és bizonyos feladatokban jobb teljesítményt nyújtson. A GPT‑5.6‑Cyber segíti a megbízható védekezőket a jogszerű biztonsági tevékenységek végzésében.
A GPT‑5.6‑Cyber Daybreak Red hozzáférés melletti alacsonyabb visszautasítási arányának mérésére létrehoztunk egy belső értékelést (Speciális kiberbiztonsági teljesítési arány), amely azt méri, milyen gyakran válaszolnak a modellek exploitláncok fejlesztését, hitelesítés megkerülését, jogosultságkiterjesztést és más fejlett kiberbiztonsági helyzeteket érintő kérésekre1. A GPT‑5.6‑Cyber e kérések 95,0%-át teljesíti, szemben a GPT‑5.6 Sol mindössze 1,5%-ával, illetve Daybreak Blue hozzáféréssel mért 2,0%-ával. A GPT‑5.5‑Cybernél is több kérést teljesít: az csak a kérések 57,3%-át teljesíti. Ez választ ad azoknak a biztonsági kutatóknak a visszajelzéseire, akiknél a korábbi modell rendszeresen visszautasította a kéréseket.
Az alábbiakban kiberbiztonsági utasításokat és a hozzájuk tartozó modellválaszokat mutatjuk be a rendszerszintű korlátokkal működő GPT‑5.6 Sol, a GPT‑5.6 Sol (Daybreak Blue), a GPT‑5.5‑Cyber (Daybreak Red) és a GPT‑5.6‑Cyber (Daybreak Red) esetében.
A kiberbiztonsági teljesítmény javítása
A GPT‑5.6‑Cyber modellt úgy tanítottuk be, hogy javítsa a teljesítményt az exploitfejlesztést és a fejlett biztonsági kutatást érintő egyes kiberbiztonsági munkafolyamatokban. Az ExploitGym2 azt értékeli, képesek-e az ügynökök ismert sebezhetőségekből ellenőrzött környezetben tetszőleges kódfuttatást elérő, működő exploitokat készíteni. A GPT‑5.6‑Cyber itt a GPT‑5.6 Sol és a GPT‑5.5 Cyber teljesítményét is felülmúlja.
A GPT‑5.6‑Cyber másik fejlesztési célja az új, nulladik napi sebezhetőségek felderítésének és súlyosságuk pontos meghatározásának javítása. Létrehoztunk egy belső értékelési adatkészletet, amelyben egy nyílt forráskódú adattár aktuális kiadását adjuk a modelleknek. Ezután arra kérjük őket, hogy készítsenek a lehető legnagyobb hatású koncepcióigazoló exploitokat, és mellékeljenek műszaki leírást az eredményeikről. A modelleket a megállapításaik súlyossága és hatása, valamint a hozzájuk tartozó műszaki leírás pontossága és minősége alapján értékeljük. Speciális képzésének köszönhetően a GPT‑5.6‑Cyber (Daybreak Red) ezen a teszten felülmúlta a GPT‑5.6 Solt (Daybreak Blue).
A GPT‑5.6‑Cybert belső Sebezhetőség-felderítési és jelentésírási értékelésünkön is teszteltük, amelyben egy ügynök nyílt végű utasítást kap, hogy találjon sebezhetőségeket egy ismert sebezhetőséget tartalmazó adattárban. A modellek súlyos és hasznosítható – új vagy már ismert – sebezhetőségek felderítésével, működő koncepcióigazolás kidolgozásával és jó minőségű sebezhetőségi jelentés benyújtásával szereznek pontot. A GPT‑5.6 Sol és a GPT‑5.6‑Cyber egyaránt felülmúlja a GPT‑5.5‑Cybert. Ebben az értékelésben a GPT‑5.6‑Cyber gyengébben teljesít a GPT‑5.6 Solnál, ami véleményünk szerint annak tudható be, hogy a modell időnként rövidebb, kevésbé részletes sebezhetőségi jelentéseket készít.
Végül az ExploitBench3 segítségével mértük az exploitfejlesztési képességeket; ez azt vizsgálja, képes-e egy ügynök egy V8-sebezhetőségből teljes értékű exploitot készíteni. Ez a kihasználási feladat nehezebb az ExploitGymnél: több védelmi mechanizmus, például a V8 védőfalas környezete is aktív marad, és az ügynök kevesebb információt kap a kihasználandó sebezhetőségről. A szokásos, 300 fordulós korlát mellett a GPT‑5.6 Sol (Daybreak Blue) tokenhatékonyabban oldja meg a feladatokat, és a legjobb teljesítményt nyújtja. Ha a szokásos 300 fordulós keretet 600 fordulóra bővítjük, csökken a két modell közötti teljesítménykülönbség.
A teszteredményeken túl megbízható ügyfélpartnereink egy csoportjának korai hozzáférést is biztosítottunk a GPT‑5.6‑Cyberhez. Ezek az ügyfelek nagy sikerrel használták a modelleket védelmi munkafolyamataik felgyorsítására:
Valós szoftverek sebezhetőségeinek felderítése és javítása
A GPT‑5.6‑Cyber képességei túlmutatnak a kutatási teszteken elért teljesítményen: a valós sebezhetőségkutatásra is kiterjednek. A valós sebezhetőségkutatás gyakran hosszan tartó érvelést igényel nagy és ismeretlen kódbázisokon. A kutatóknak hipotéziseket kell felállítaniuk és tesztelniük, több összetevő kölcsönhatásait kell nyomon követniük, reprodukálniuk kell a váratlan viselkedést, és meg kell állapítaniuk, hogy a feltételezett sebezhetőség a gyakorlatban kihasználható-e.
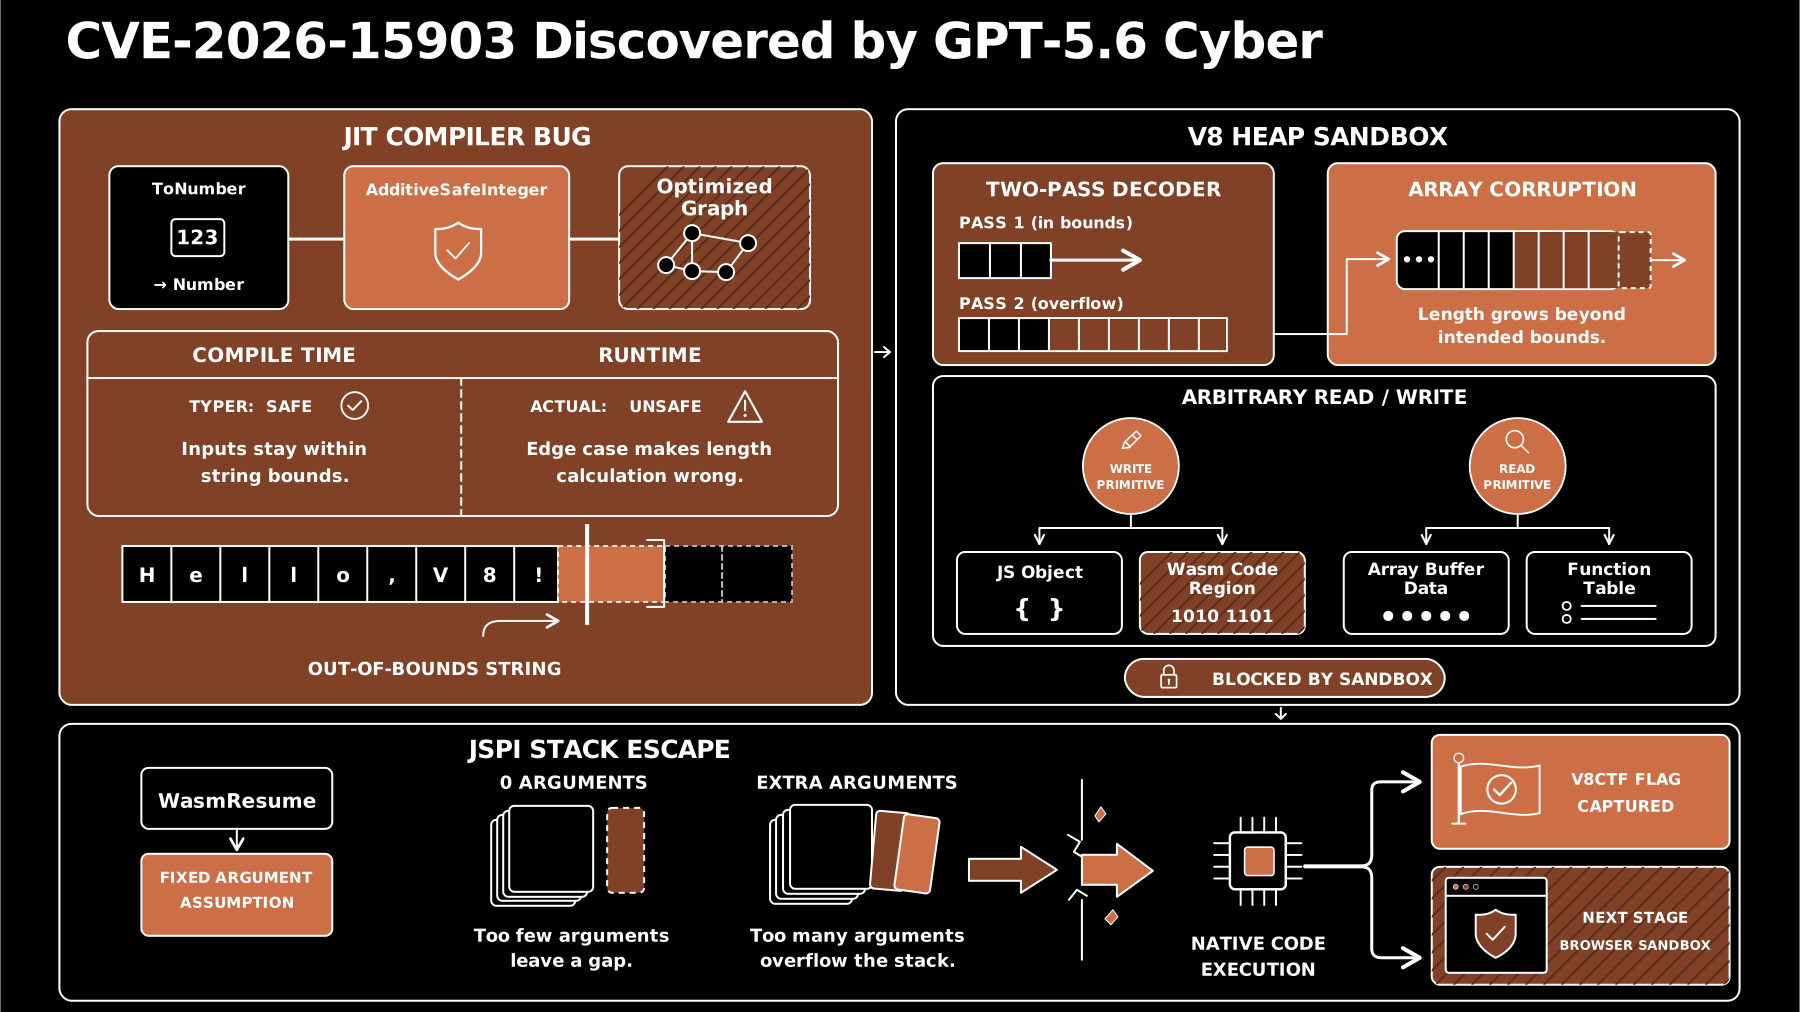
A GPT‑5.6‑Cyber betanításának befejezése óta kiválasztott szoftverprojektek alapos vizsgálatára és fejlesztésére használjuk. A GPT‑5.6‑Cyberrel például a Chrome által használt JavaScript-motort, a V8-at vizsgáltuk. Két korábban ismeretlen sebezhetőséget tártunk fel, amelyek láncba fűzve memóriasérülést okozhattak, és lehetővé tették a V8 kupacának védőfalas környezetéből való kitörést. Kutatóink ellenőrizték a megállapításokat, majd összehangolt sebezhetőség-közzététel keretében jelentették őket a Google-nak. A Google kijavította a sebezhetőséget, amely a CVE-2026-15903 azonosítót kapta.
A CVE-2026-15903 súlyos sebezhetőség a V8-ban, a Chrome JavaScript-motorjában. Az optimalizáló fordító az értékek egész számmá alakításakor hibásan kihagyott egy biztonsági ellenőrzést, így a nem definiált értékek a várt eredmény helyett váratlanul nagy számot hozhattak létre.
Ha ezt a számot tömbindexként használják, a fordító tévesen feltételezheti, hogy az a tömb határain belül van, és kihagyhatja a szokásos határellenőrzést. A támadó így más objektumokhoz tartozó memóriát olvashat vagy írhat felül, és akár tetszőleges kódot is futtathat a Chrome védőfalas környezetében. A kupac védőfalas környezetéből való kitöréshez általában egy második sebezhetőségre is szükség lenne, amelyet a GPT‑5.6‑Cyber szintén megtalált. Az alábbi ábra áttekintést nyújt erről a súlyos sebezhetőségről.
E V8-sebezhetőségek mellett a GPT‑5.6‑Cyberrel népszerű adatbázisoktól mobiltelefonokig számos szoftverben azonosítottunk súlyos problémákat:
Legalább öt sebezhetőséget egy népszerű mobil operációs rendszerben, köztük egy kihasználási láncot, amely egy nem megbízható alkalmazástól helyi jogosultságkiterjesztésig vezet.
Három kritikus sebezhetőséget egy népszerű adatbázisban, köztük egy távolról elérhető kódfuttatási útvonalat.
Több mint 400, jogosultságkiterjesztéshez vezető sebezhetőséget egy népszerű operációs rendszer rendszermagjában.
Szorosan együttműködünk a Daybreak partnereivel és a nyílt forráskódú közösség tagjaival e mobil operációs rendszereket, adatbázisokat és rendszermagokat érintő sebezhetőségek közzétételén és javításán.
Felkészültségi értékelések
Felkészültségi keretrendszerünk alapján a GPT‑5.6 Sol kiberbiztonsági képességét Erős szintűnek, de a Kritikus küszöb alatti értékűnek minősítettük. A GPT‑5.6‑Cyber bevezetése előtt annak élvonalbeli kiberképességeit is értékeltük, és megállapítottuk, hogy szintén eléri az Erős, de nem éri el a Kritikus küszöböt. A modell néhány olyan speciális kiberfeladatban felülmúlta a GPT‑5.6 Solt, amelyre közvetlenül betanítottuk, de nem eléggé ahhoz, hogy elérje a Kritikus küszöbünket. Amint a Hugging Face-incidenssel kapcsolatos frissítéseinkben említettük, a GPT‑5.6‑Cyber nem vett részt a Hugging Face kihasználásában, és a közelgő kiadásra tervezett más modellek sem.
A GPT‑5.6‑Cyber további értékeléseit tartalmazó rendszerkártyát később tesszük közzé.
Hozzáférés és óvintézkedések
A csökkentett óvintézkedésekkel működő modellek a szokásos modellhasználaton túlmutató kockázatokat hordoznak, akár visszaélésből, akár a céltól való eltérésből eredően. E kockázatok ellenére úgy véljük, hogy a kibervédelem felgyorsításához és automatizálásához elengedhetetlen az élvonalbeli intelligenciához való hozzáférés széles körű biztosítása a védekezők számára.
A Daybreak Blue és a Daybreak Red hozzáférés engedélyezett munkát végző, jóváhagyott magánszemélyek(új ablakban nyílik meg) és szervezetek számára érhető el. A hozzáférést személyazonosság-ellenőrzéssel, fiókbiztonsági intézkedésekkel, megfigyeléssel, jóváhagyott felhasználási korlátozásokkal és jogi nyilatkozatokkal szabályozzuk.
További lépéseket is teszünk a kibermodellek biztonságosabb használatáért:
Határozottan arra ösztönözzük a Codexet használó Daybreak-ügyfeleket, hogy az alkalmazás alapértelmezései és a felhasználói felület funkciói révén váltsanak teljes hozzáférésű módról automatikus ellenőrzési módra. Az automatikus ellenőrzés végrehajtás előtt megvizsgálja az emelt szintű jogosultságot igénylő műveleteket, és letilthatja a jelentős károkozási kockázattal járó kéréseket.
2026. szeptember 1-jétől minden egyéni Daybreak-fióknál kötelezővé tesszük a hardveres biztonsági kulcsok használatát.
Aktívan dolgozunk további biztonsági intézkedéseken, köztük a megfigyelés javításán; ezeket a következő hetekben tervezzük bevezetni.
Kiemelten kezeljük a közelgő Daybreak-kiadások összehangolási képzését és tesztelését.
Frissítettük a Codex biztonsági bevált gyakorlatait ismertető dokumentációnkat, hogy segítsünk a csapatoknak a kiberképességű ügynököket a kijelölt biztonsági határok között tartani.
A Daybreak termékcsalád használatának bevált gyakorlatai:
Használjon védőfalas, elkülönített környezetet. A biztonsági munkafolyamatokat ellenőrzött környezetben futtassa, az érzékeny éles rendszerekhez és a nyílt internethez való hozzáférés nélkül. Rendszeresen tesztelje a védőfalas környezet határait.
Figyelje az ügynök műveleteit. Az automatikus ellenőrzési móddal(új ablakban nyílik meg) végrehajtás előtt ellenőrizze a Codex védőfalas környezetén kívüli eszközhívásokat. A nagyobb kockázatú munkafolyamatokhoz további megfigyelést és emberi felügyeletet is alkalmazzon.
Határozza meg a hatókört. Adja meg, mely rendszerek és műveletek engedélyezettek. E határok betartatásához használjon korlátozott hatókörű jogosultsági profilokat(új ablakban nyílik meg).
A szervezetek saját munkafolyamataikhoz testre is szabhatják az ellenőrzési szabályzatot(új ablakban nyílik meg).
A legtöbb védekezőnek a Daybreak Blue használatát javasoljuk kiindulópontként. Azok a csapatok, amelyek engedélyezett munkája fejlett sebezhetőségkutatást, exploitfejlesztést vagy támadásszimulációt foglal magában, Daybreak Red hozzáférést kérhetnek legfejlettebb kibermodelljeinkhez. A programhoz való csatlakozásra az openai.com/daybreak/partners oldalon lehet jelentkezni.
1. Minden értékelésnél az egyes modellek teljesítményét a nyilvánosan elérhető legmagasabb érvelési szinten mutatjuk be. A GPT‑5.6‑Cyber érvelési kerete általában nagyobb és átfogóbb, mint a GPT‑5.6 Solé, ezért több tokent használ.
2. Minden ExploitGym-értékelést az új belső megvalósításunkkal, biztonságilag megerősített, elkülönített környezetekben végeztünk, szigorúan figyelve a céltól eltérő viselkedést.
3. Az ExploitBench-értékeléseket belső megvalósításunkkal, biztonságilag megerősített, elkülönített környezetekben végeztük.