LLM के साथ रीज़न करना सीखते हैं
हम पेश कर रहे हैं OpenAI o1, जो मुश्किल रीज़निंग करने के लिए रीइंफ़ोर्समेंट लर्निंग के साथ ट्रेंन किया गया एक नया बड़ा-सा लैंग्वेज मॉडल है. o1 जवाब देने से पहले सोचता है – यह यूज़र को रिस्पांस देने से पहले विचारों की एक लंबी इंटर्नल चेन बना सकता है.
This post introduced OpenAI o1.
The ChatGPT access information reflects the September 2024 launch. o1‑preview and o1‑mini have been retired from the API; o1 is deprecated. See the API deprecation schedule(एक नई विंडो में खुलेगा).
For the current experience:
OpenAI o1 ने कॉम्पिटिटिव प्रोग्रामिंग क्वेश्चंस (Codeforces) में 89वें पर्सेंटाइल में रैंक किया है, यूएसए मैथ ओलंपियाड (AIME) के लिए क्वालीफ़ायर में यूएस में टॉप के 500 छात्रों के बीच जगह पाई है, और फ़िज़िक्स, बायोलॉजी और केमिस्ट्री प्रॉब्लम्स (GPQA) के बेंचमार्क पर इंसानी PhD-लेवल की एक्यूरेसी को पार किया है. वहीं इस नए मॉडल को मौजूदा मॉडल की तरह इस्तेमाल में आसान बनाने के लिए ज़रूरी चीज़ों पर अभी काम चल रहा है, हम इसके ChatGPT में तुरंत इस्तेमाल और भरोसेमंद API यूज़र(एक नई विंडो में खुलेगा) के लिए इस मॉडल का शुरुआती वर्ज़न, OpenAI o1‑preview पेश कर रहे हैं.
हमारा लार्ज-स्केल रीइंफ़ोर्समेंट लर्निंग एल्गोरिदम मॉडल को सिखाता है कि बहुत ज़्यादा डेटा-एफ़िशिएंट ट्रेनिंग प्रोसेस में विचारों की अपनी चेन का इस्तेमाल करके प्रोडक्टिव तरीक़े से कैसे सोचना है. हमने पाया है कि ज़्यादा रीइंफ़ोर्समेंट लर्निंग (ट्रेन-टाइम कंप्यूट) और ज़्यादा समय लेकर सोचने (टेस्ट-टाइम कंप्यूट) के साथ o1 की परफ़ॉर्मेंस लगातार बेहतर होती जाती है. इस अप्रोच को बढ़ाने से जुड़ी रुकावटें LLM प्रीट्रेनिंग से काफ़ी अलग हैं, और हम उनकी लगातार जांच-पड़ताल कर रहे हैं.
o1 परफ़ॉर्मेंस बिना रोक-टोक के दोनों ट्रेन-टाइम और टेस्ट-टाइम कंप्यूट के साथ बेहतर हो जाती है
GPT‑4o में रीज़निंग में सुधार को हाइलाइट करने के लिए, हमने इंसानी एग्ज़ाम और ML बेंचमार्क के अलग-अलग सेट पर अपने मॉडल के टेस्ट किए. हमने दिखाया कि o1 इन रीज़निंग-प्रधान टास्क के बहुत बड़े हिस्से में GPT‑4o से काफ़ी बेहतर परफ़ॉर्म करता है. आमतौर पर हमने o1 का मूल्यांकन ज़्यादातर टेस्ट-टाइम कंप्यूट सेटिंग पर किया.
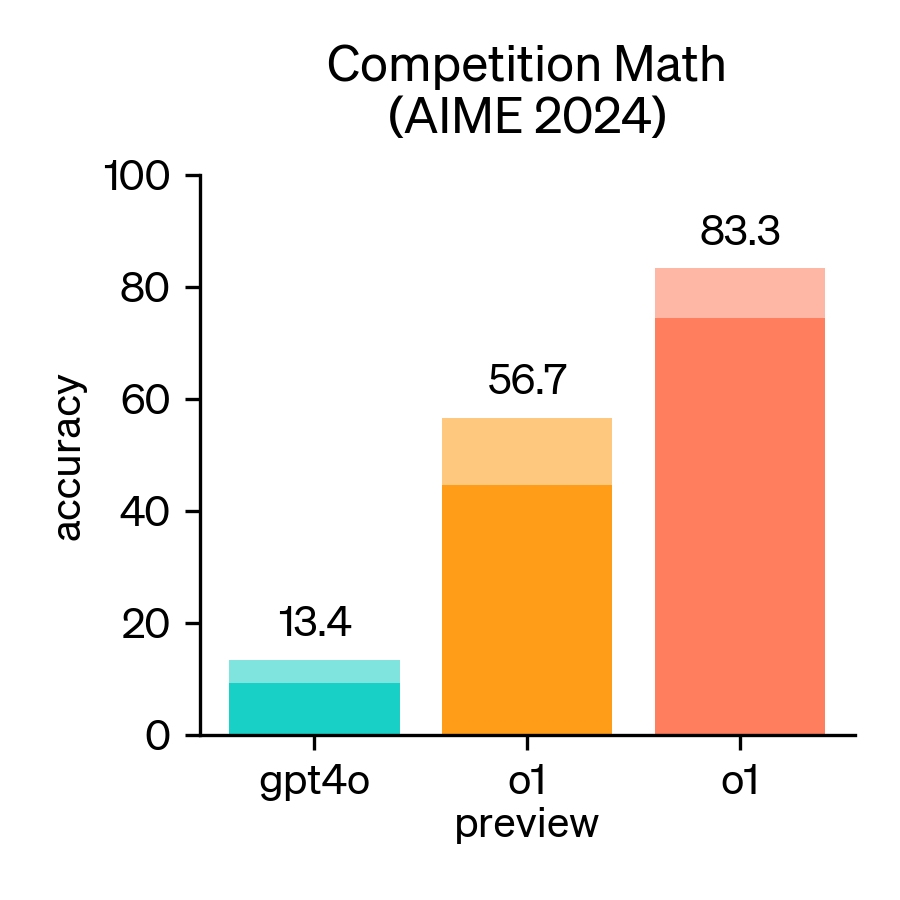
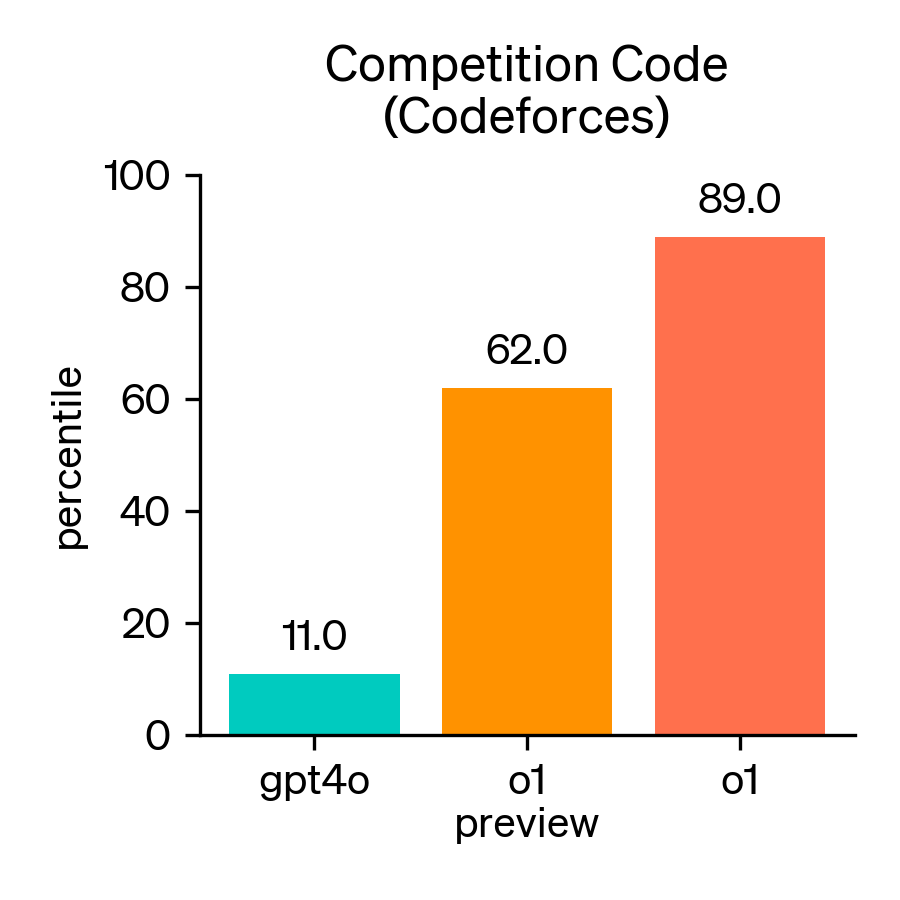
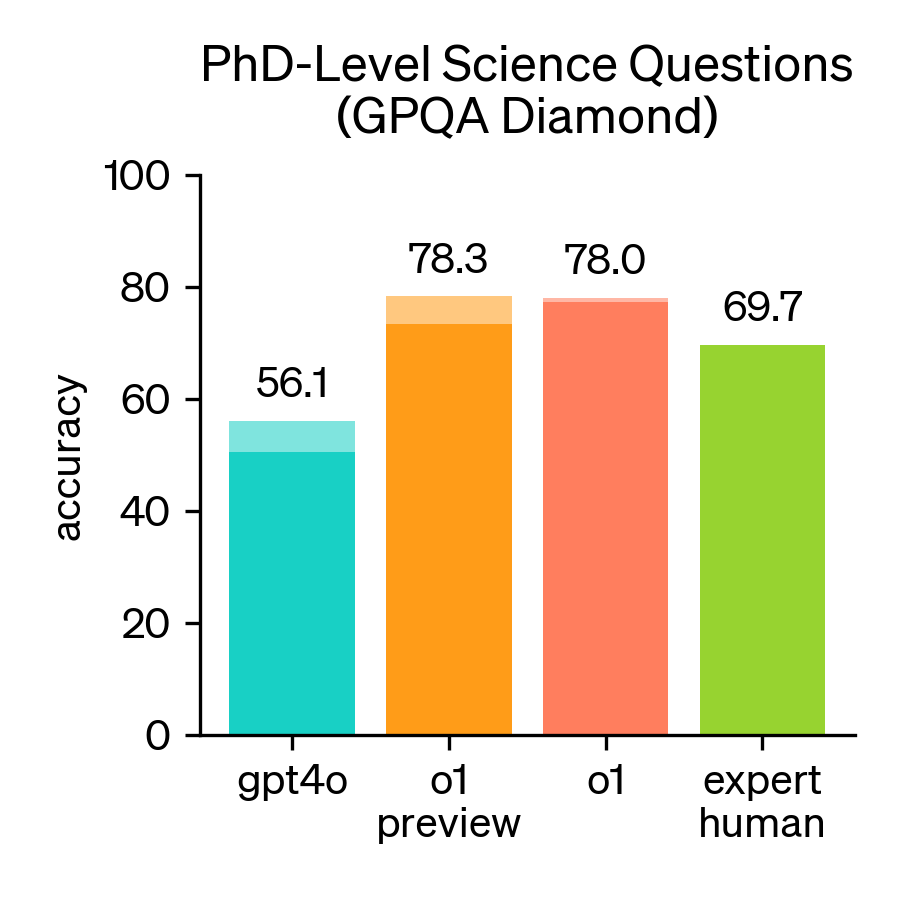
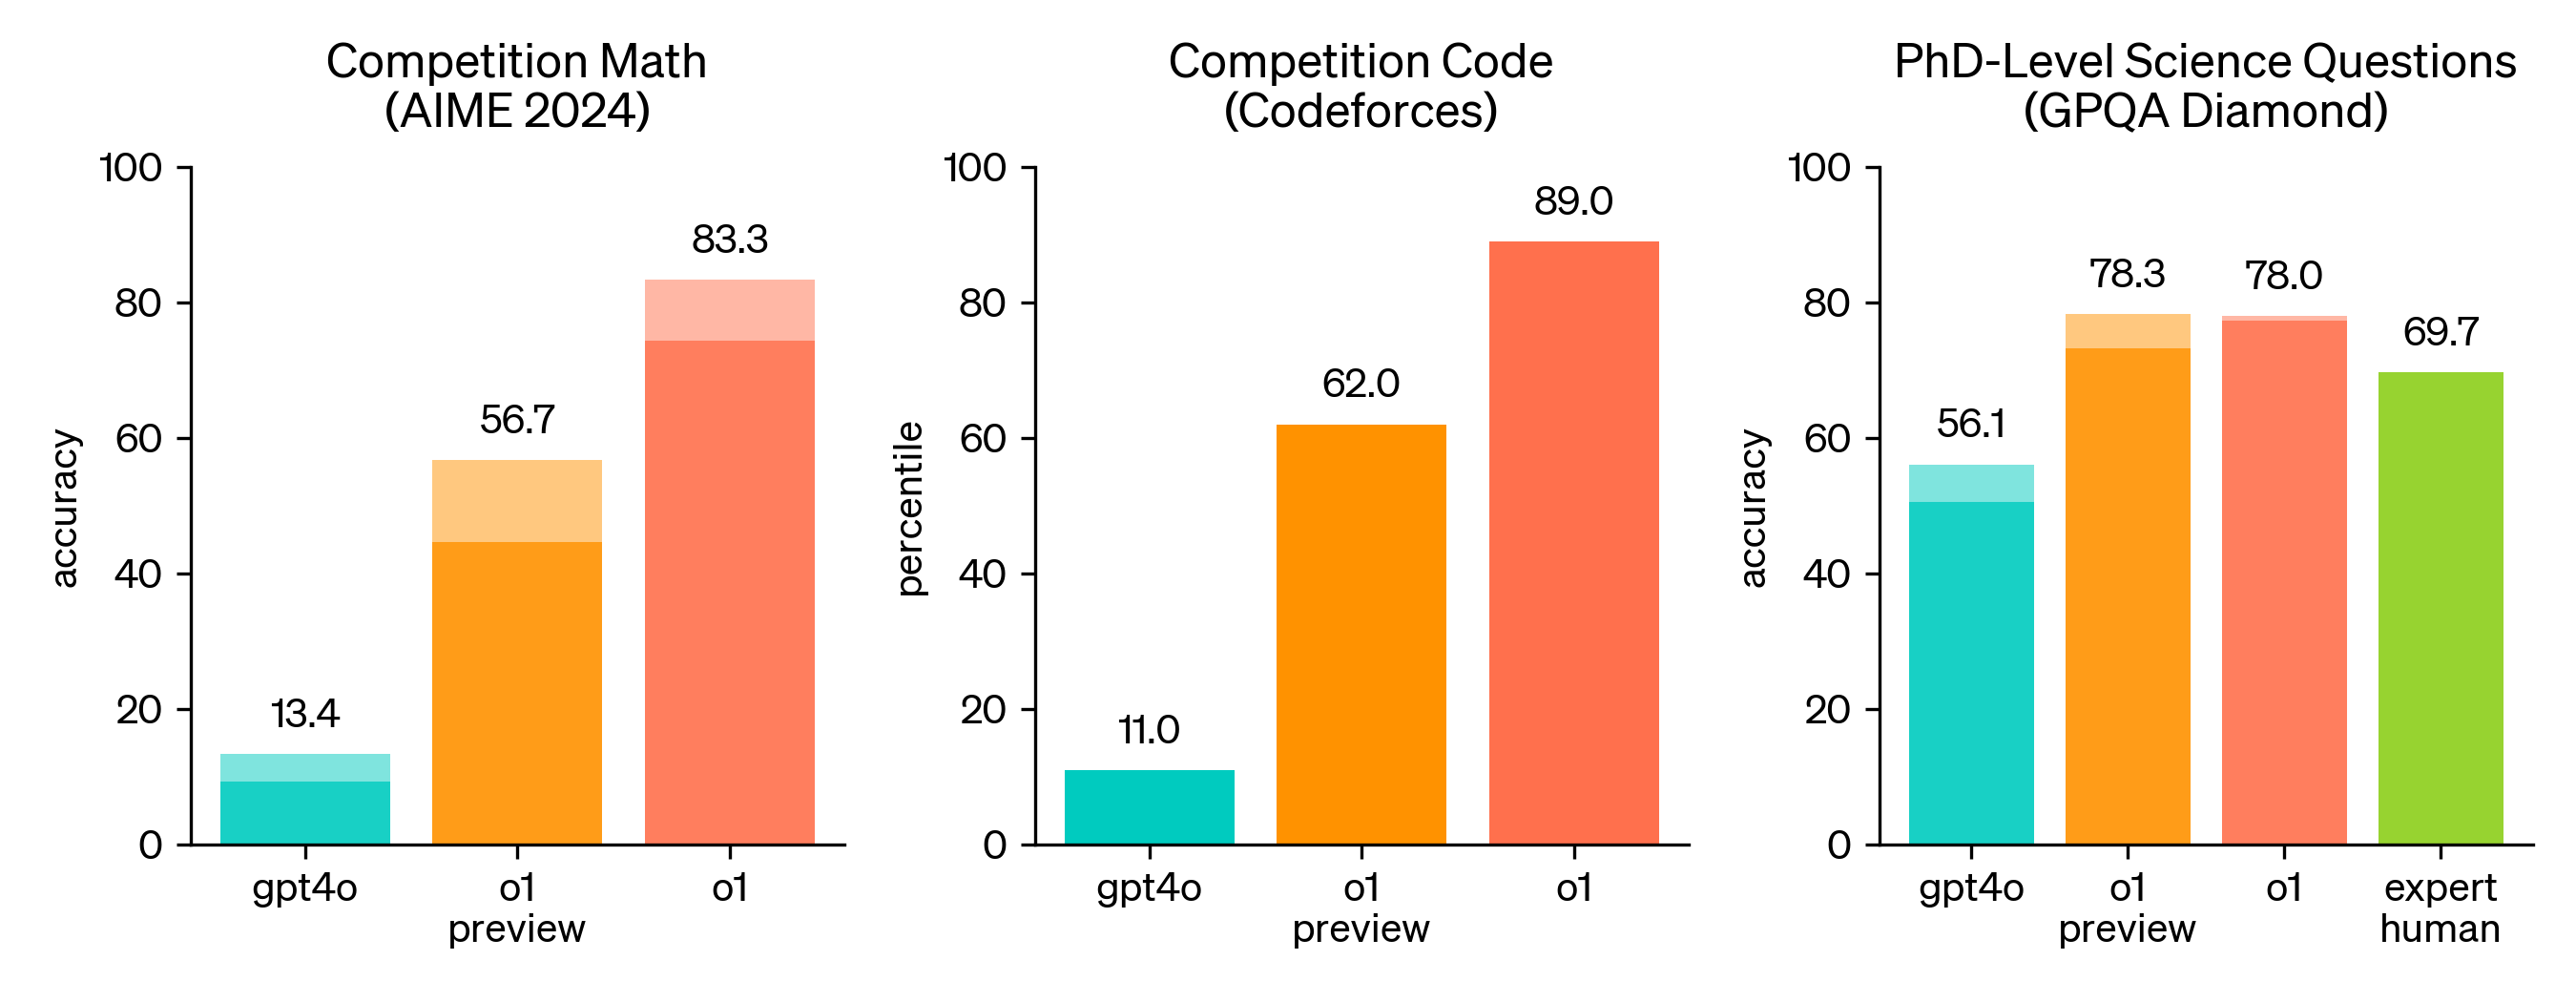
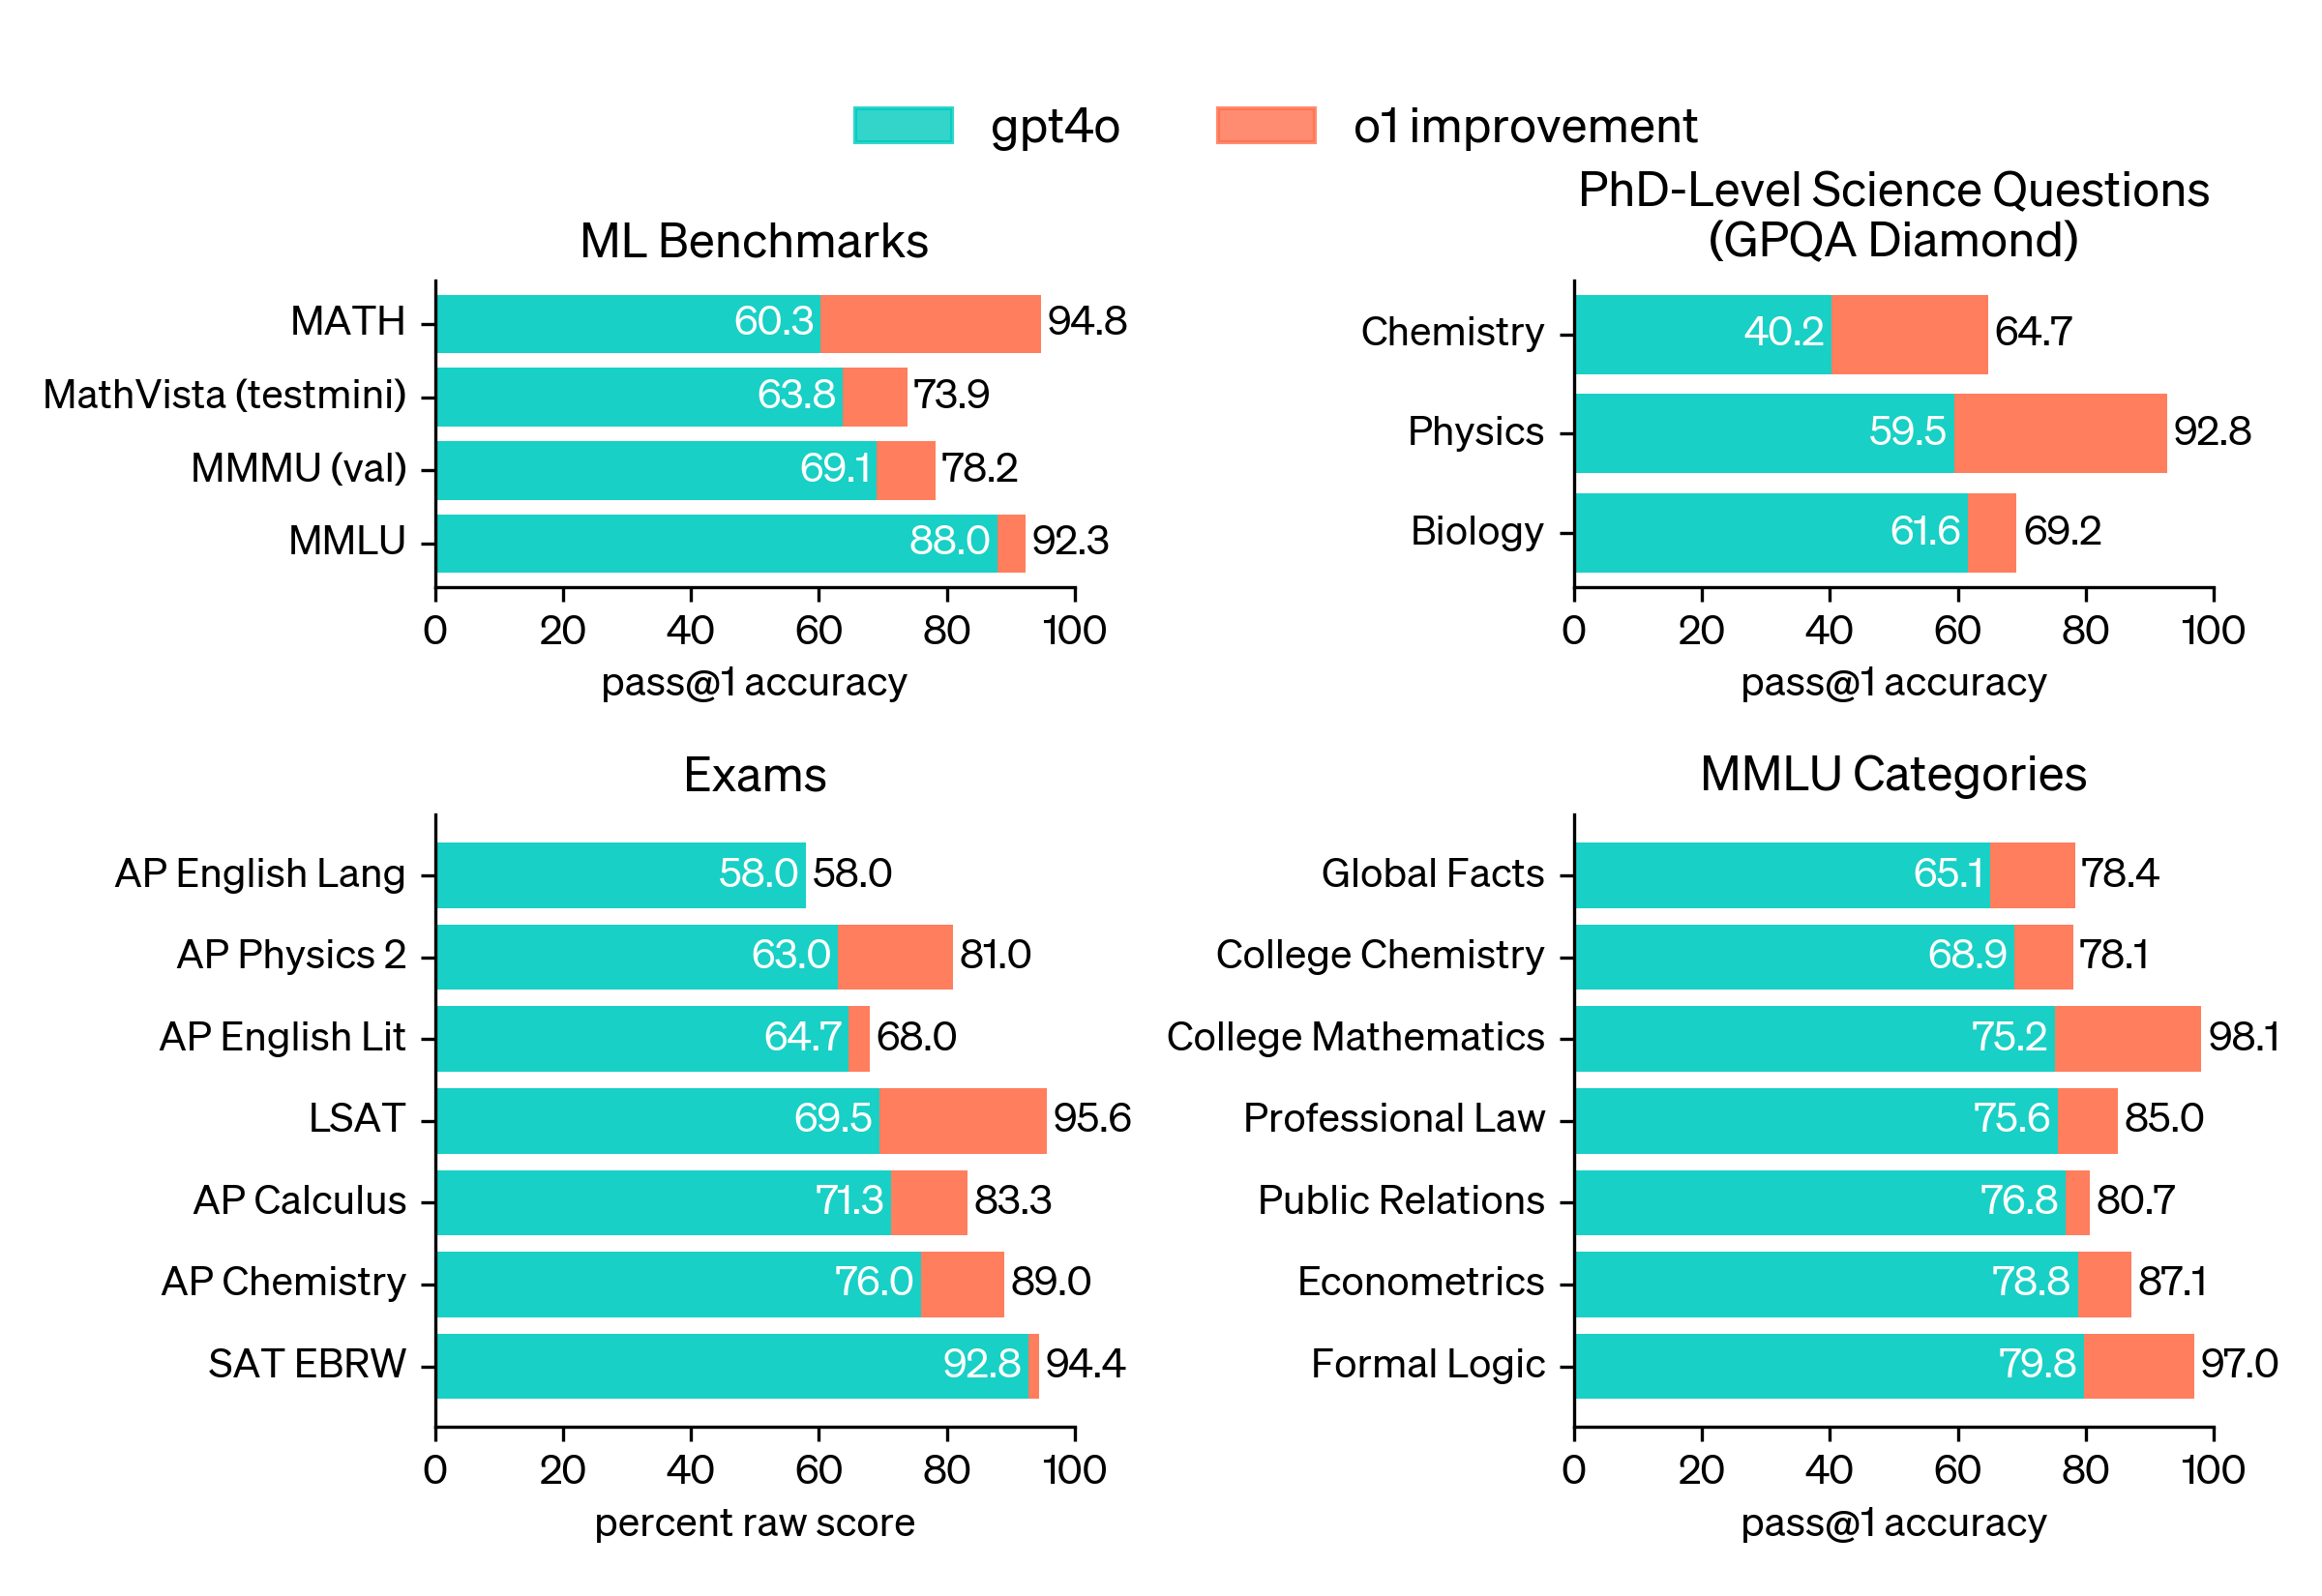
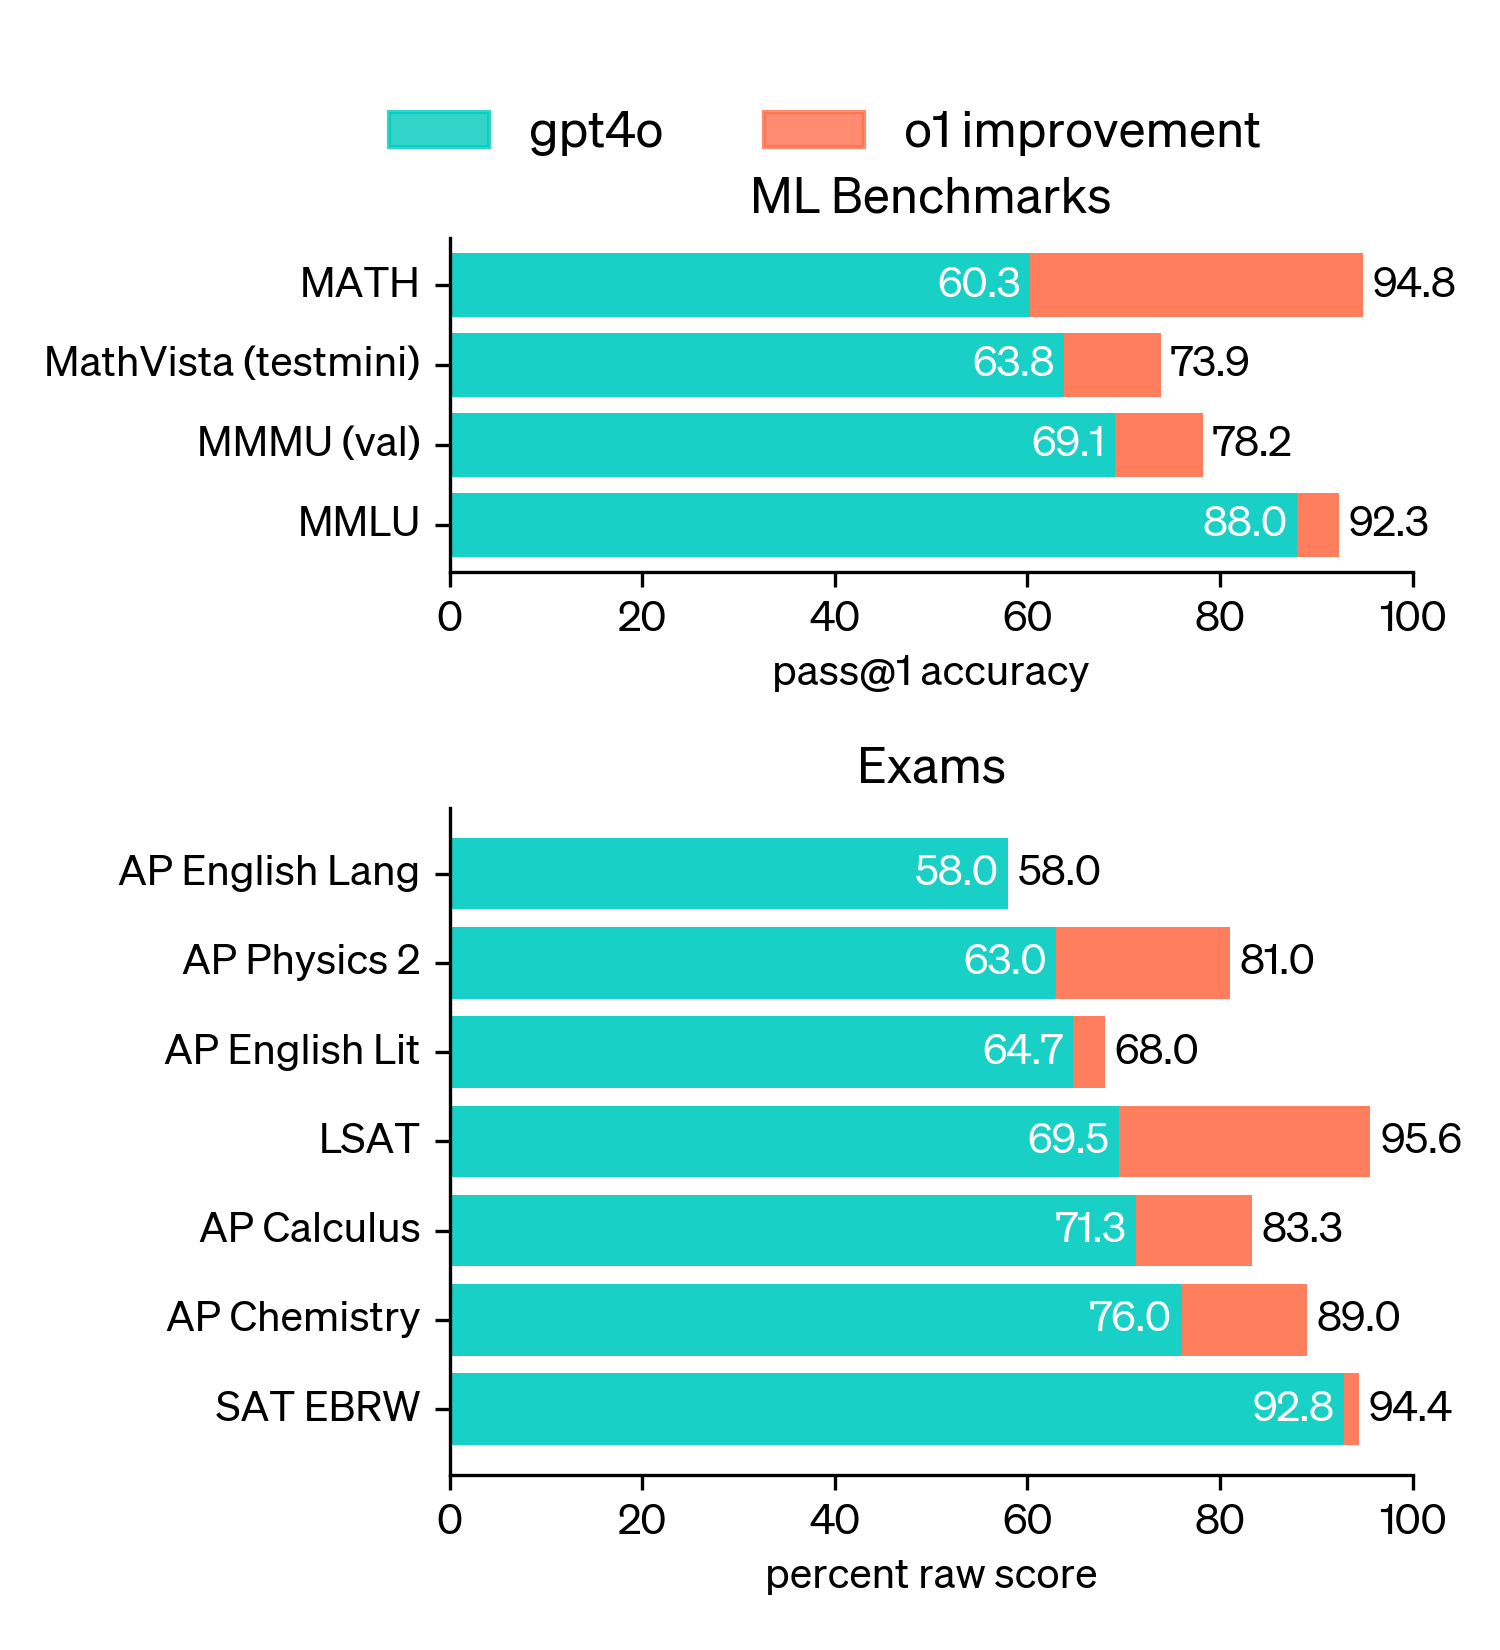
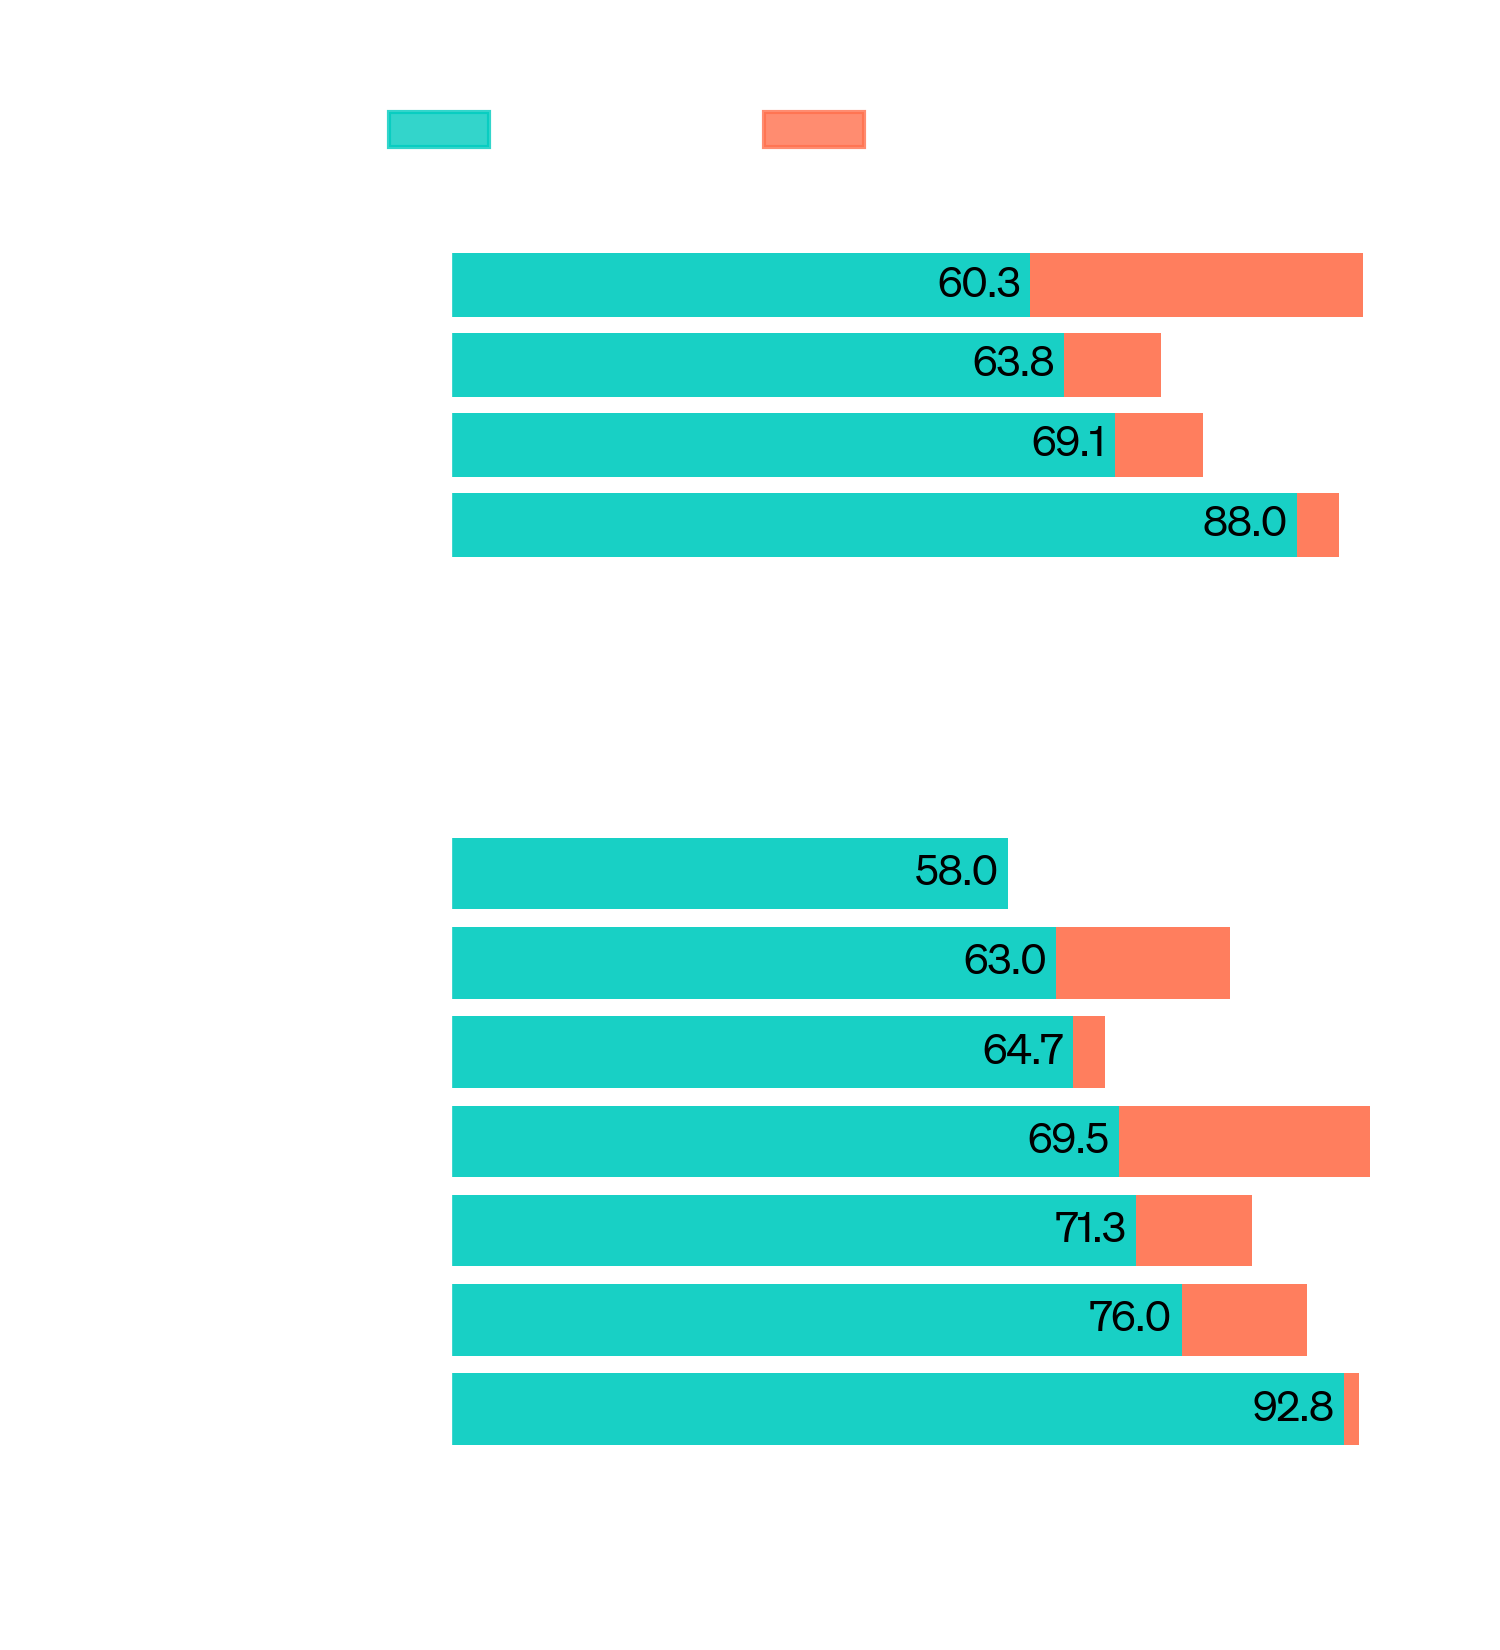
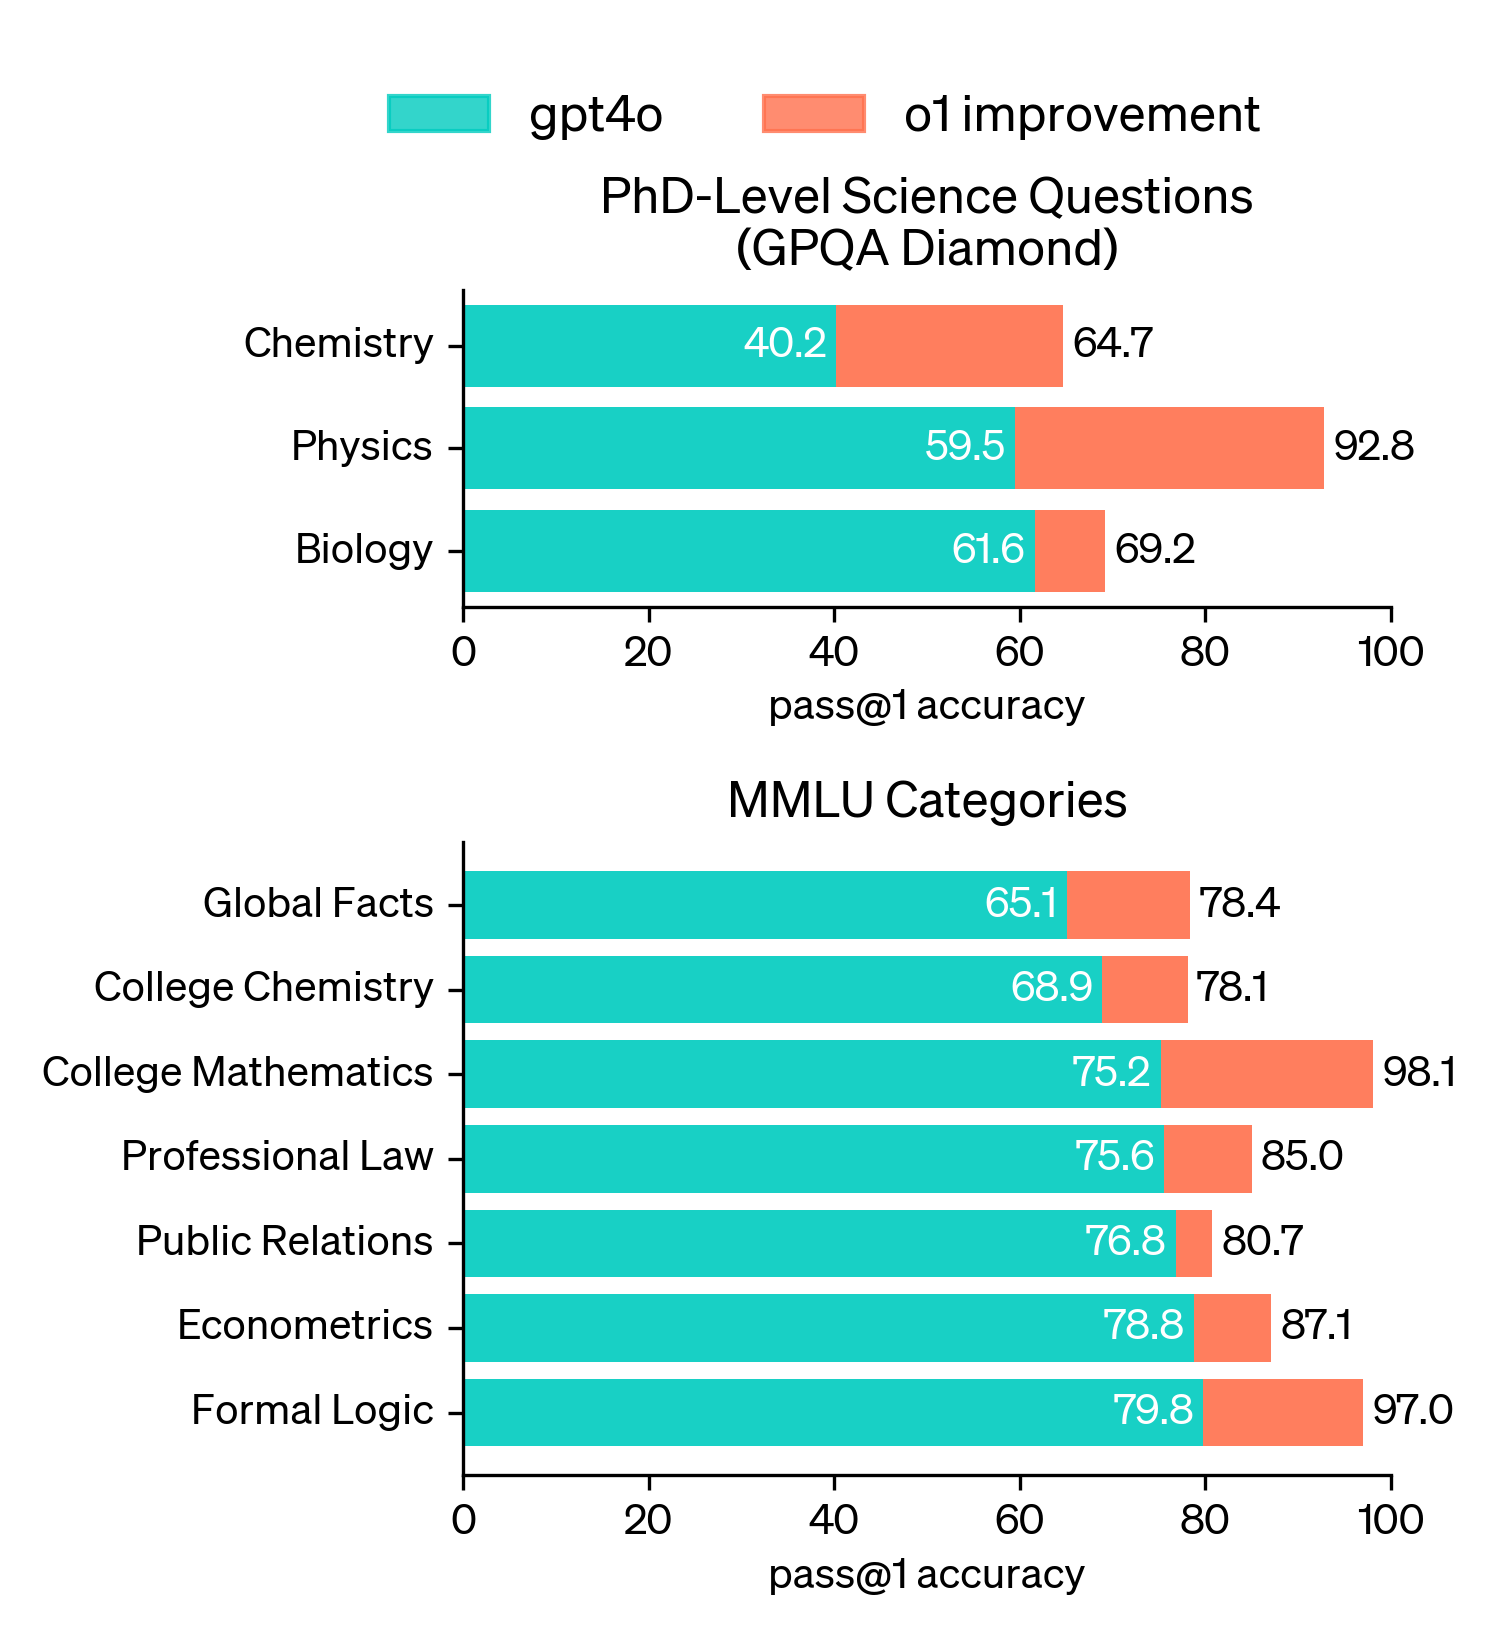
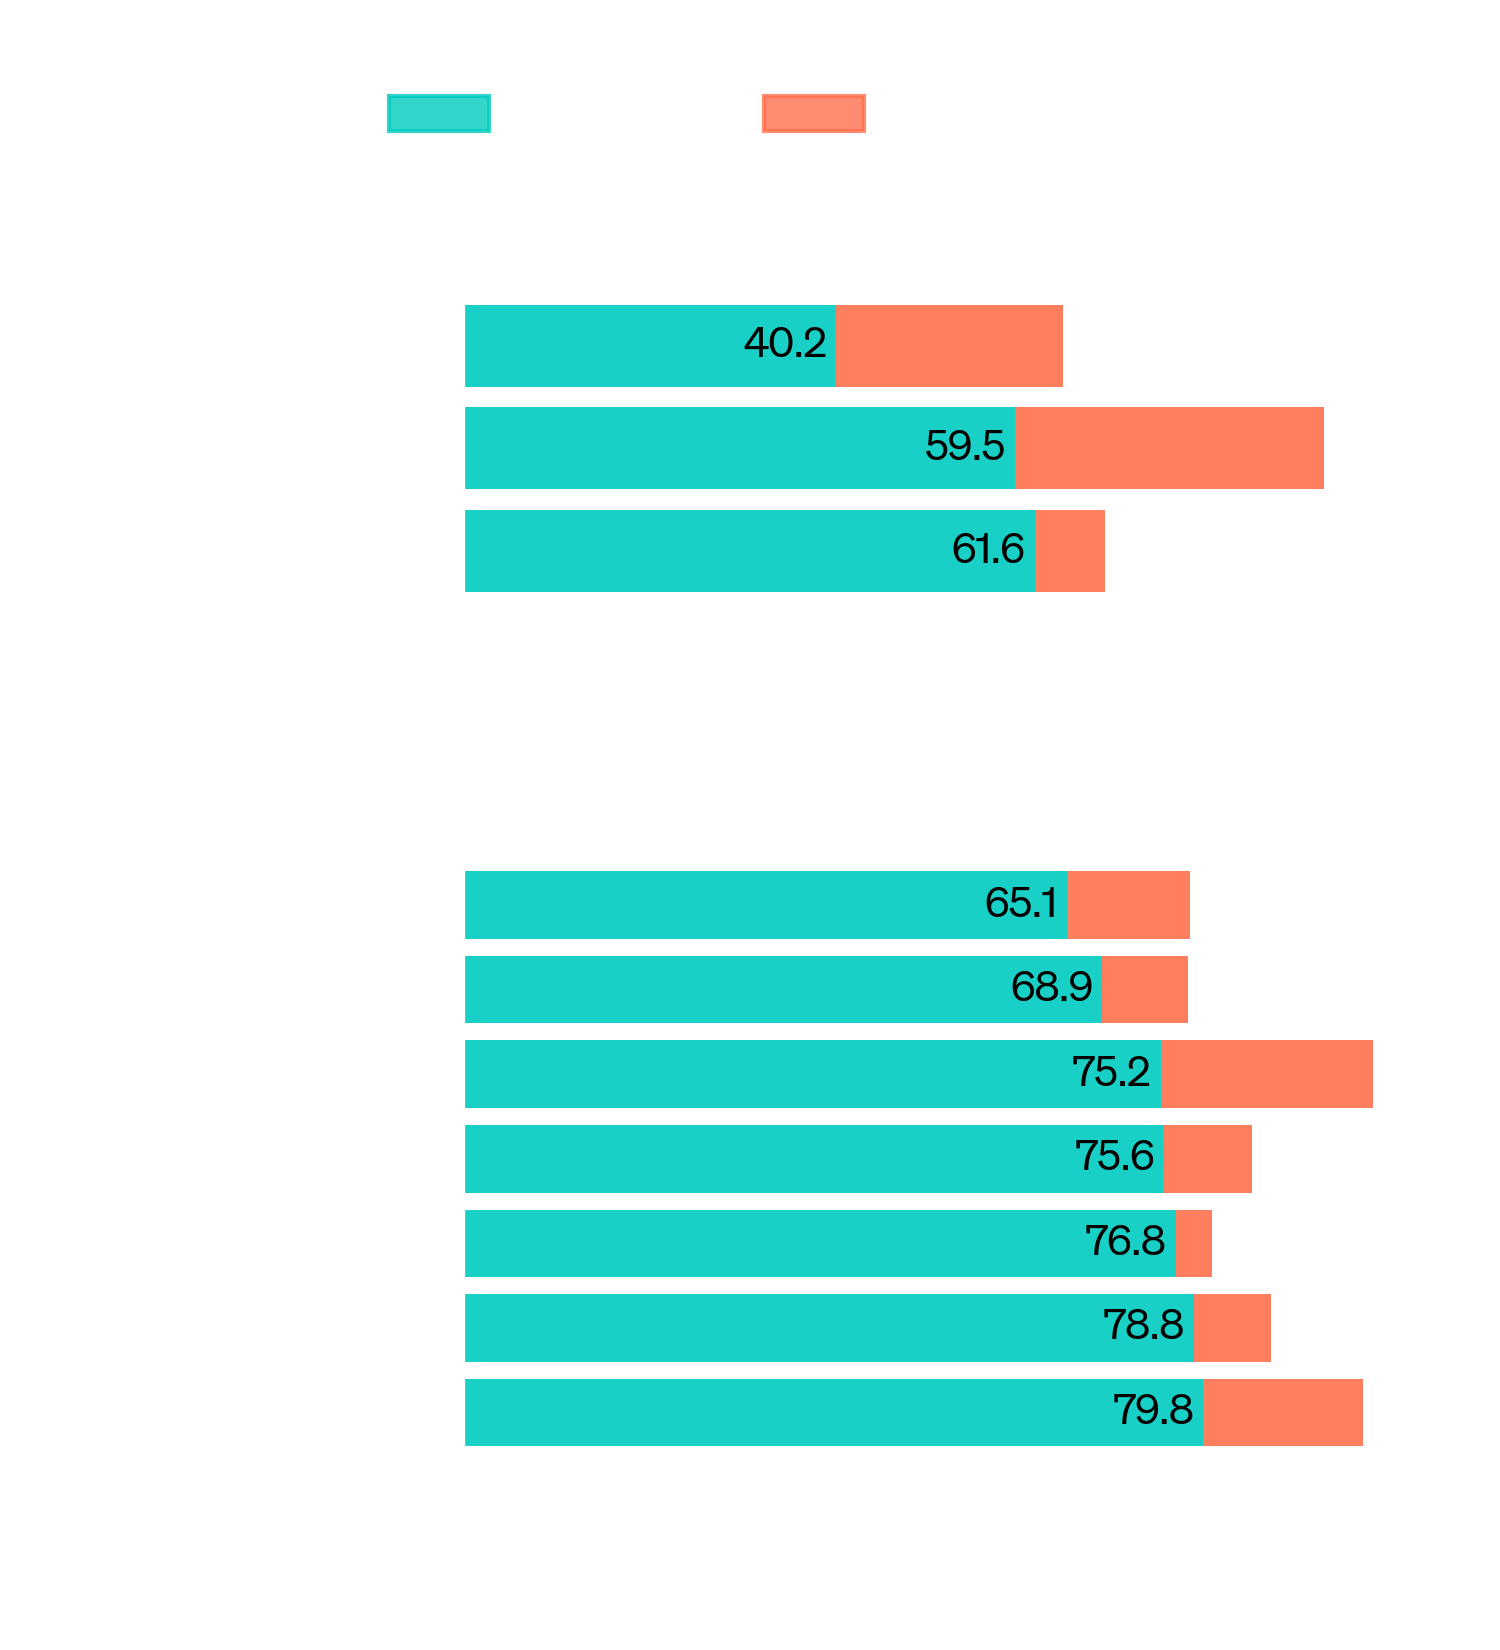
कई रीज़निंग-प्रधान बेंचमार्क में, o1 इंसानी एक्सपर्ट की परफ़ॉर्मेंस का मुक़ाबला करता है. हाल के फ़्रंटियर मॉडल1, MATH2 और GSM8K पर इतना अच्छा परफ़ॉर्म करते हैं कि ये बेंचमार्क अब इन मॉडल में फ़र्क़ करने में ज़्यादा असरदार नहीं हैं. हमने AIME पर मैथ की परफ़ॉर्मेंस का मूल्यांकन किया, यह ऐसा एग्ज़ाम है, जो अमेरिका के हाई स्कूल के सबसे तेज़ छात्रों को चुनौती देने के लिए तैयार किया गया. 2024 AIME एग्ज़ाम में, GPT‑4o ने औसतन सिर्फ़ 12% (1.8/15) प्रॉब्लम हल कीं। o1 ने हर प्रॉब्लम के एक ही सैंपल के साथ औसतन 74% (11.1/15), 64 सैंपल में आम सहमति से 83% (12.5/15) और सीखे गए स्कोरिंग फ़ंक्शन के साथ 1000 सैंपल को फिर से रैंक करने पर 93% (13.9/15) का स्कोर किया. 13.9 का स्कोर इसे नैशनल लेवल के टॉप के 500 छात्रों में जगह देता है और यूएसए मैथेमैटिकल ओलंपियाड के कटऑफ से भी ऊपर रखता है.
हमने o1 का मूल्यांकन GPQA डायमंड पर भी किया, जो कि एक ख़ासा मुश्किल इंटेलिजेंस बेंचमार्क है और जो केमिस्ट्री, फ़िज़िक्स और बायोलॉजी में दक्षता को टेस्ट करता है. मॉडल की इंसान से तुलना करने के लिए, हमने GPQA-डायमंड सवालों के जवाब देने के लिए पीएचडी वाले एक्सपर्ट की भर्ती की. हमने पाया कि o1 ने उन एक्सपर्ट लोगों के मुक़ाबले बेहतर परफ़ॉर्म किया, और इस बेंचमार्क पर ऐसा करने वाला यह पहला मॉडल बन गया. इन नतीजों से यह मतलब नहीं निकाला जाना चाहिए कि o1 सभी मामलों में PhD वालों के मुक़ाबले ज्यादा सक्षम है – इसका मतलब सिर्फ़ इतना ही है कि मॉडल कुछ प्रॉब्लम को हल करने में ज़्यादा माहिर है, जिन्हें PhD वाले हल कर पाते हैं. अनेकों अन्य ML बेंचमार्क पर, o1 ने स्टेट-ऑफ़-द-आर्ट यानी सबसे ज़्यादा आधुनिक परफ़ॉर्मेंस से बेहतर किया. अपनी इनेबल की गईं विज़न पर्सेप्शएन क्षमताओं के साथ, o1 ने MMMU पर 78.2% का स्कोर किया, जिससे यह एक्सपर्ट लोगों के साथ मुक़ाबला करने वाला पहला मॉडल बन गया. इसने MMLU की 57 सब-कैटेगरी में से 54 में GPT‑4o से बेहतर परफ़ॉर्म किया.
जैसे एक इंसान किसी मुश्किल सवाल का जवाब देने से पहले काफ़ी देर तक सोचता है, ठीक उसी तरह किसी प्रॉब्लाम को हल करने की कोशिश करते समय o1 विचारों की चेन का इस्ते माल करता है. रीइंफ़ोर्समेंट लर्निंग के ज़रिए, o1 अपनी विचारों की चेन को बेहतर बनाना और अपनी स्ट्रैटेजीज़ को रिफ़ाइन करना सीखता है. यह अपनी ग़लतियों को पहचानना और सही करना सीखता है. यह मुश्किल स्टेप्स को आसान स्टेप्स में तोड़ना सीखता है. अगर मौजूदा अप्रोच काम नहीं कर रही है, तो यह किसी और अप्रोच को आज़माना सीखता है. यह प्रोसेस मॉडल की रीज़न की क्षमता को असरदार तरीक़े से सुधार देती है. इस छलांग को दिखाने के लिए, हम कई मुश्किल प्रॉब्लम पर o1‑preview से विचारों की चेन को नीचे दिखा रहे हैं.
हमने मॉडल को ट्रेन किया और इसने 213 पॉइंट का स्कोर किया और 2024 इंटरनैशनल ओलंपियाड इन इंफ़ॉर्मेटिक्स (IOI) में 49वें पर्सेंटाइल में रैंक किया, इसे o1 से शुरू किया गया और प्रोग्रामिंग स्किल्स को और बेहतर बनाने के लिए ट्रेनिंग दी गई. इस मॉडल ने 2024 IOI में लोगों की तरह ही वैसे ही हालातों में मुक़ाबला किया. इसे छह चुनौतीपूर्ण एल्गोरिथम प्रॉब्लम को हल करने के लिए दस घंटे का समय दिया गया था और इसे हर प्रॉब्लम के लिए 50 सबमिशन करने थे.
हर प्रॉब्लम के लिए, हमारे सिस्टम ने कई कैंडिडेट के सबमिशन के सैंपल लिए और टेस्ट-टाइम सलेक्शन स्ट्रैटजी के आधार पर उनमें से 50 सबमिट किए. सबमिशन का सलेक्शन IOI पब्लिक टेस्ट केसेस, मॉडल-जनरेटेड टेस्ट केसेस और सीखे गए स्कोरिंग फ़ंक्शन पर परफ़ॉर्मेंस के आधार पर किया गया था. अगर इसके बजाय हमने बेतरतीब तरीक़े से सबमिट किया होता, तो हमने औसतन 156 पॉइंट का स्कोर किया होता, जिससे पता चलता है कि कंपिटिशन से जुड़ी रुकावटों में यह स्ट्रैटेजी लगभग 60 पॉइंट ला पाती.
हमने पाया कि सबमिशन से जुड़ी रुकावटों में ढील की वजह से मॉडल की परफ़ॉर्मेंस में काफ़ी सुधार हुआ. जब हर प्रॉब्लम पर 10,000 सबमिशन की अनुमति दी गई, तो मॉडल ने 362.14 का स्कोर किया – जो गोल्ड मेडल से भी ज़्यादा का था – वो भी बिना किसी टेस्ट-टाइम सिलेक्शन स्ट्रैटजी के.
आख़िर में, हमने इस मॉडल के कोडिंग स्किल को दिखाने के लिए Codeforces की कंपिटिटिव प्रोग्रामिंग कॉन्टेस्ट्स की नक़ल की. हमारा मूल्यांकन कंपिटिशन के नियमों से काफ़ी हद तक मैच करता था और 10 सबमिशन की अनुमति दी गई. GPT‑4o ने 808 की Elo रेटिंग3 हासिल की, जो लोगों के 11वें पर्सेंटाइल में है. यह मॉडल GPT‑4o और o1 दोनों से कहीं आगे निकल गया – इसने 1807 की Elo रेटिंग हासिल की, जो 93% कंपिटिटर के मुक़ाबले बेहतर परफ़ॉर्मेंस थी.

प्रोग्रामिंग कंपिटिशन पर और ज़्यादा फ़ाइन-ट्यूनिंग o1 में सुधार करती है. कंपिटिशन के नियमों के तहत ही इंप्रूव किए गए मॉडल ने 2024 इंटरनैशनल ओलंपियाड इन इंफ़ॉर्मेटिक्स (IOI) में 49वें पर्सेंटाइल में रैंक किया.
एग्ज़ाम और एकेडमिक बेंचमार्क के अलावा, हमने अलग-अलग डोमेन के बहुत बड़े स्पेक्ट्रम में चुनौतीपूर्ण, ओपन-एंडेड प्रॉम्प्ट पर o1‑preview बनाम GPT‑4o की ह्यूमन प्रेफ़रेंसेस का भी मूल्यांकन किया. इस मूल्यांकन में, इंसान ट्रेनर को o1‑preview और GPT‑4o से मिले प्रॉम्प्ट के बिना नाम वाले रिस्पांस दिखाए गए, और उन्हें अपने पसंद के रिस्पांस को चुनने के लिए कहा गया. डेटा एनालिसिस, कोडिंग और मैथ जैसी रीज़निंग-प्रधान केटेगरी में o1‑preview को gpt-4o के मुक़ाबले बड़े अंतर से प्रेफ़र किया गया. हालाँकि, कुछ स्वाभाविक भाषा से जुड़े टास्क में o1‑preview को प्रेफ़र नहीं किया गया, जो बताता है कि यह सभी यूज़ केस के लिए सही नहीं है.

विचारों की चेन की रीज़निंग अलाइनमेंट और सुरक्षा के लिए नए मौक़े देता है. हमने पाया कि मॉडल के बिहेवियर के लिए हमारी नीतियों को रीज़निंग मॉडल के विचार की चेन में इंटिग्रेट करना मानवीय मूल्यों और सिद्धांतों को मज़बूती से सिखाने का असरदार तरीक़ा है. मॉडल को हमारे सुरक्षा नियमों और कॉन्टेक्स्ट में उनके बारे में रीज़न करने के तरीक़े सिखाने पर, हमें रीज़निंग क्षमता के सबूत मिले, जो मॉडल की मज़बूती को सीधे फ़ायदा पहुंचाते हैं: o1‑preview ने मुख्य जेलब्रेक मूल्यांकनों और हमारे मॉडल की सुरक्षा रिफ़्यूज़ल सीमाओं के मूल्यांकन के लिए हमारे सबसे सख़्त इंटर्नल बेंचमार्क पर काफ़ी बेहतर परफ़ॉर्मेंस हासिल की. हमारा मानना है कि विचारों की चेन का इस्तेमाल सुरक्षा और अलाइनमेंट के लिए काफ़ी मददगार है, क्योंकि (1) यह हमें मॉडल के सोचने को लेजिबल तरीक़े से देख पाने में इनेबल बनाता है, और (2) सुरक्षा नियमों के बारे में मॉडल की रीज़निंग आउट-ऑफ़-डिस्ट्रिब्यूशन सिनारियो के लिए बहुत मज़बूत है.
अपने सुधारों की सख्त-टेस्टिंग करने के लिए, हमने अपनी तैयारी के फ़्रेमवर्क(एक नई विंडो में खुलेगा) के अनुसार, डिप्लॉय करने से पहले सुरक्षा टेस्ट और रेड-टीमिंग का एक सेट किया. हमने पाया कि विचारों की चेन की रीज़निंग से हमारे मूल्यांकनों में क्षमता सुधार में योगदान मिला. ख़ासकर ग़ौरतलब बात यह है कि हमने रिवॉर्ड हैकिंग के दिलचस्प उदाहरण(एक नई विंडो में खुलेगा) देखे. इन मूल्यांकनों के विस्तृत नतीजे, साथ वाले सिस्टम कार्ड में देखे जा सकते हैं.
| मेट्रिक | GPT-4o | o1-preview |
|---|---|---|
| नुक़सान पहुँचाने वाले प्रॉम्प्ट पर % कंप्लाएंसस्टैंडर्ड | 0.990 | 0.995 |
| नुक़सान पहुँचाने वाले प्रॉम्प्ट पर % कंप्लाएंसचुनौती वाले: जेलब्रेक्स और एज केस | 0.714 | 0.934 |
| ↳ हरासमेंट (बहुत ज़्यादा) | 0.845 | 0.900 |
| ↳ एक्सप्लॉयटेटिव सेक्सुअल कंटेंट | 0.483 | 0.949 |
| ↳ सेक्सुअल कंटेंट, जिसमें माइनर शामिल है | 0.707 | 0.931 |
| ↳ अहिंसक ग़लत चीज़ों के बारे में सलाह | 0.688 | 0.961 |
| ↳ हिंसक ग़लत चीज़ों के बारे में सलाह | 0.778 | 0.963 |
| WildChat Zhao, et al. में प्रति कैटेगरी सबसे ऊँचे मॉडरेशन API स्कोर के साथ टॉप 200 के लिए % सेफ़ कंप्लिशन. 2024(एक नई विंडो में खुलेगा) | 0.945 | 0.971 |
| गुडनेस@0.1 स्ट्रांगरिजेक्ट जेलब्रेक इवैल Souly et al. 2024(एक नई विंडो में खुलेगा) | 0.220 | 0.840 |
| ह्यूमन सोर्स्ड जेलब्रेक्स इवैल | 0.770 | 0.960 |
| बिनाइन एज केस पर % कंप्लाएंस“बहुत ज़्यादा रिफ़्यूज़ल नहीं” | 0.910 | 0.930 |
| XSTest में बिनाइन एज केस पर % कंप्लाएंस“बहुत ज़्यादा रिफ़्यूज़ल नहीं” Röttger, et al. 2023(एक नई विंडो में खुलेगा) | 0.924 | 0.976 |
हमारा मानना है कि विचारों की एक छिपी हुई चेन मॉनिटरिंग मॉडल के लिए अनोखा मौक़ा पेश करती है. यह मानते हुए कि यह भरोसेमंद और लेजिबल है, विचार की छिपी हुई चेन हमें मॉडल के "दिमाग़ को पढ़ने" और उसके विचार प्रोसेस को समझने देती है. उदाहरण के लिए, भविष्य में हम यूज़र के साथ छेड़छाड़ के इशारों के लिए विचारों की चेन को मॉनिटर करना चाहेंगे. हालांकि, इसके काम करने के लिए मॉडल को अपने विचारों को बिना बदले फ़ॉर्म में इज़हार करने की आज़ादी होनी चाहिए, इसलिए हम विचारों की चेन पर किसी भी नीति कंप्लायंस या यूज़र प्रेफ़रेंसेस को ट्रेन नहीं कर सकते. हम यह भी नहीं चाहते कि विचारों की अनअलाइंड चेन यूज़र को सीधे दिखे.
इसलिए, यूज़र के अनुभव, कंपिटिटिव फ़ायदे और विचारों की चेन की मॉनिटरिंग के विकल्प जैसे कई फ़ैक्टर पर सोच-विचार करने के बाद, हमने यूज़र को विचारों की चेन की बुनियादी चेन को न दिखाने का फ़ैसला लिया है. हम जानते हैं कि इस फ़ैसले के नुक़सान भी हैं. हम मॉडल को जवाब में विचारों की चेन से किसी भी यूज़फ़ुल आइडिया को फिर से पेश करना सिखाकर थोड़ी-बहुत इसकी भरपाई करने की कोशिश करते हैं. o1 मॉडल सीरीज़ के लिए हम विचारों की चेन का मॉडल-जनरेटिड सारांश दिखाते हैं.
o1 AI रीज़निंग में स्टेट-ऑफ़-द-आर्ट यानी सबसे ज़्यादा आधुनिक परफ़ॉर्मेंस को काफ़ी आगे ले जाता है. हम इस मॉडल का इंप्रूव्ड वर्ज़न पेश करने का प्लान बना रहे हैं, ताकि हम इसे दोहराते रहें. हमें उम्मीद है कि ये नई रीज़निंग क्षमताएं मॉडल को मानवीय मूल्यों और सिद्धांतों के साथ अलाइन करने की हमारी क्षमता को बेहतर बनाती जाएंगी. हमारा मानना है कि o1 – और इसके आगे के मॉडल – साइंस, कोडिंग, मैथ और संबंधित फ़ील्ड में AI के लिए कई नए यूज़ केस खोलेंगे. हम इसे जानने को लेकर बहुत रोमांचित हैं कि यह यूज़र और API डेवलपर के रोज़मर्रा के काम को कैसे बेहतर बना सकता है.
| डेटासेट | मेट्रिक | gpt-4o | o1-preview | o1 |
|---|---|---|---|---|
| कंपिटिशन मैथ AIME (2024) | cons@64 | 13.4 | 56.7 | 83.3 |
| पास@1 | 9.3 | 44.6 | 74.4 | |
| कंपिटिशन मैथ CodeForces | इलो | 808 | 1,258 | 1,673 |
| प्रसेंटाइल | 11.0 | 62.0 | 89.0 | |
| GPQA डायमंड | cons@64 | 56.1 | 78.3 | 78.0 |
| पास@1 | 50.6 | 73.3 | 77.3 | |
| बायोलॉजी | cons@64 | 63.2 | 73.7 | 68.4 |
| पास@1 | 61.6 | 65.9 | 69.2 | |
| केमिस्ट्री | cons@64 | 43.0 | 60.2 | 65.6 |
| पास@1 | 40.2 | 59.9 | 64.7 | |
| भौतिक विज्ञान | cons@64 | 68.6 | 89.5 | 94.2 |
| पास@1 | 59.5 | 89.4 | 92.8 | |
| गणित | पास@1 | 60.3 | 85.5 | 94.8 |
| MMLU | पास@1 | 88.0 | 92.3 | 90.8 |
| MMMU (वल) | पास@1 | 69.1 | n/a | 78.2 |
| MathVista (testmini) | पास@1 | 63.8 | n/a | 73.9 |
लेखक
साइटेशन्स
- 1
- 2
हमारे मूल्यांकन में https://arxiv.org/abs/2305.20050(एक नई विंडो में खुलेगा) में मिली ऐसी ही 500 प्रॉब्लम टेस्ट स्प्लिट का इस्तेमाल किया गया.
- 3