תכננו את משפחת המודלים GPT‑5.6 כך שתאזן בין יכולת לעלות בכל קשת המשימות שאנשים מבצעים באמצעות המודלים שלנו. מודל הדגל שלנו, GPT‑5.6 Sol, עם reasoning ברמה מקסימלית, משיג תוצאות טובות יותר מ-Claude Fable 5 במדד סוכני הקוד של Artificial Analysis, בפחות ממחצית העלות. Terra משתווה ל-GPT‑5.5 במבחני בינה במחצית המחיר, ו-Luna הוא המודל המהיר והמשתלם ביותר שלנו, במחיר נמוך ב-80% מזה של Sol. כדי להשיג את שיפורי היעילות האלה, צוותי המחקר והטכנולוגיה שלנו ביצעו אופטימיזציות משמעותיות בכל שכבה מרכזית של המערך הטכנולוגי שלנו. השיפורים האלה נוגעים למודלים שלנו, להסקה (האופן שבו אנחנו מריצים מודלים כדי ליצור פלט) ול-harness האג'נטי שלנו, שמשמש גם את Codex וגם את ChatGPT Work.
בארבע השנים האחרונות הרחבנו את השימוש במודלים שלנו למיליארד משתמשים פעילים וליותר משני מיליון עסקים. לאורך הדרך, היעילות הייתה גורם מרכזי בהנגשת יתרונות הבינה לכולם. המשימה שלנו היא להבטיח שבינה מלאכותית כללית תועיל לאנושות כולה. במהלך השנים האלה פעלנו בהתמדה למציאת דרכים נוספות לייעל את המערך הטכנולוגי שלנו, כדי להציע את המודלים בעלי הביצועים הטובים ביותר בכל נקודה בעקומת העלות–בינה. עם GPT‑5.6 השגנו את היעילות הגבוהה ביותר שלנו עד כה במונחי בינה לטוקן, בזכות אימון המודל לבצע יותר עבודה בכל טוקן. באימון אנחנו ממטבים הן את ההצלחה במשימה והן את היעילות, ומכוונים את המודל לפעול בדרך ישירה יותר להשלמת המשימה.
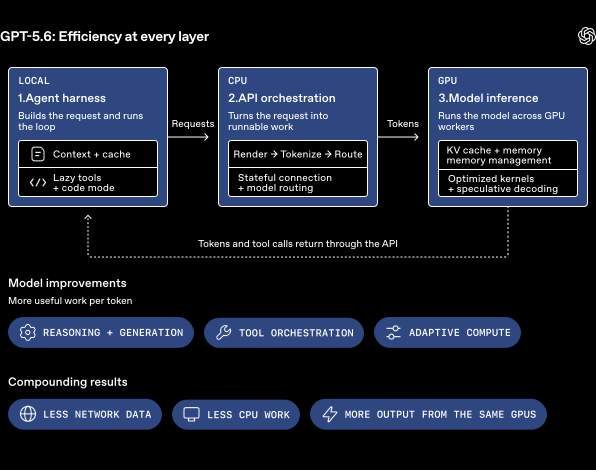
הפוסט הזה מתמקד במה שמעבר למודלים עצמם: כיצד תכננו ליעילות באמצעות שיפורים בשני חלקים מרכזיים נוספים במערך הטכנולוגי: 1) הסקה — אופטימיזציה של תהליכים כמו איזון עומסים, פענוח ספקולטיבי, שימוש במטמון ומיטוב קרנלים, כדי להפיק יותר פלט מאותה חומרה; ו-2) ה-harness האג'נטי שלנו — כולל ניהול טוב יותר של התנפחות ההקשר, השימוש בכלים ועבודה חוזרת. נספר גם על התפקיד של GPT‑5.6 Sol בהשגת כמה מהשיפורים האלה באופן עצמאי. אף שכל שיפור בפני עצמו עשוי להיראות מוגבל, יחד הם מצטברים ומאפשרים לנו לעמוד בחזית הן בבינה והן ביעילות.
בעולם שמשאבי החישוב בו מוגבלים והביקוש למודלים גדל מהר יותר מהקיבולת, היעילות עומדת בלב התכנון של כל מערכת. הדבר נכון במיוחד למערך ההסקה שלנו, שמריץ מודלים מאומנים כדי להפיק תשובות. המטרה המרכזית שלנו היא לספק יותר טוקנים באמצעות אותה חומרה, תוך שמירה על רמת הבינה, זמן התגובה, הזמינות והאמינות שהמשתמשים מצפים להם.
כדי להשיג זאת, נדרשת אופטימיזציה של המערכת כולה. מודל יכול להיות יעיל מאוד כשלעצמו, אך עדיין יקר להפעלה כשירות אם הבקשות מחולקות באופן לקוי, החומרה אינה מנוצלת או העברת הנתונים מאטה את החישוב. השיפורים בכל שכבה מצטברים ומחזקים זה את זה. הם נובעים מאופטימיזציה של ניתוב (לאן נשלחות בקשות), תזמון (מתי הן נשלחות), קרנלים (תוכנה שרצה על מעבדים גרפיים), מטמון (שמירת עבודה ושימוש חוזר בה) ומימוש המודל (סדר קוד ה-GPU). GPT‑5.6 Sol ב-Codex מילא תפקיד מרכזי בכל השיפורים האלה.
הדוגמה החשובה הראשונה היא איזון עומסים. ברמה הגלובלית, אנחנו מנתבים בקשות לפי גורמים כמו מיקום גאוגרפי, קיבולת זמינה וסוג המאיץ (סוג המעבד הגרפי או השבב הייעודי שעליו רץ המודל). בתוך אשכול, אנחנו מחלקים עבודה בין מופעי מודל לפי העומס, אורך ההקשר, זמינות המטמון ומאפיינים אחרים של הבקשות. בתוך כל מופע, יש לחלק את העבודה ביעילות בין המאיצים, תתי-הרשתות של המודל וליבות החישוב. GPT‑5.6 Sol ב-Codex עוזר לנו לנתח תעבורה בסביבת הייצור, לזהות מקורות לחוסר איזון שנעלמו מעינינו בעבר, לבדוק אסטרטגיות ניתוב חדשות ולכוונן בהתמדה את ההיוריסטיקות האלה. השיפורים האלה באיזון העומסים לבדם הפחיתו במידה ניכרת את עלות הפעלת המודלים שלנו כשירות.
השתמשנו ב-GPT‑5.6 Sol גם כדי למטב את המעבר קדימה של המודל: החישוב שממיר קלטים לתחזיות לגבי הטוקן הבא. גם כשכל פעולה בפני עצמה מהירה, העברת נתונים מופרזת בזיכרון, סנכרון ופריסות נתונים לא יעילות עלולים להשאיר את המעבדים הגרפיים ללא עבודה. כדי למנוע זאת, GPT‑5.6 Sol זיהה עבודה שאפשר לחשב מראש, לוותר עליה או לבצע במקביל. באמצעות Codex, GPT‑5.6 Sol שכתב ומיטב באופן עצמאי את הקרנלים שלנו בסביבת הייצור — קוד הליבה שמבצע את הפעולות המתמטיות המרכיבות את המודל. ההצלחה הזו התאפשרה בין היתר משום שאימנו את GPT‑5.6 לכתוב ולשפר ביעילות קרנלים ב-Triton(נפתח בחלון חדש) וב-Gluon(נפתח בחלון חדש), שתי שפות תכנות בקוד פתוח למעבדים גרפיים, ש-OpenAI מתחזקת. המאמצים האלה, לצד שיפורים רחבים יותר בקרנלים שהביא GPT‑5.6 Sol, הפחיתו ב-20% את העלות הכוללת של הפעלת המודלים כשירות. השקענו רבות גם בכלי אימות, כמו כלי הקוד הפתוח FpSan(נפתח בחלון חדש) (Floating-Point Sanitizer), כדי לסייע באימות נכונות הקרנלים שכתב GPT‑5.6 Sol.
פענוח ספקולטיבי הוא דרך נוספת לשפר מהירות ויעילות. השיטה כוללת הרצת מודל טיוטה קטן יותר (או ״מודל משער״) לצד המודל הראשי. מודל הטיוטה מציע כמה טוקנים, והמודל הראשי מאמת אותם במקביל. כשההצעות האלה מתקבלות, המערכת יכולה להפיק כמה טוקני פלט במעבר אחד של המודל הראשי, וכך לצמצם את כמות החישובים הרציפים היקרים. GPT‑5.6 Sol שיפר את מודל הטיוטה שלו באמצעות תכנון והרצה של מאות ניסויים בארכיטקטורה שלו, שבהם נבדקו שינויים בגודל, במבנה ובמאפיינים. בנוסף, GPT‑5.6 Sol הפעיל וניטר את תהליך האימון של המודל המשער, והתערב באופן עצמאי כשהתעוררו בעיות, ובהן תקלות חומרה וחוסר יציבות באימון. השיפורים שהושגו הגדילו את יעילות יצירת הטוקנים ביותר מ-15%.
בעת עיבוד טוקני קלט שאינם שמורים במטמון, המודל בונה את מטמון המפתח-ערך (KV) במעבר אחד עתיר חישוב; בעת יצירת פלט, הוא קורא מהמטמון ומרחיב אותו שוב ושוב. התצורה המיטבית להפעלת המודל כשירות — כגון קיבוץ לאצוות, חלוקה למקטעים וניהול KV — תלויה מאוד בעומס העבודה: אורך הפרומפט והפלט, גודל האצווה, שיעור הפגיעות במטמון, מאפייני השאילתות ועוד. אבל בעבר, מרחב התצורות היה גדול מכדי לכוונן אותו באופן שיטתי, ולכן המהנדסים נאלצו להסתמך על היוריסטיקות כלליות. בעזרת GPT‑5.6 Sol ב-Codex, הצלחנו לנתח עומסי עבודה בסביבת הייצור, לייצר ולהעריך תצורות מועמדות, ולמטב ברמת דיוק גבוהה את תצורת המנוע והמודל לכל תרחיש. כך אפשר ליישם אופטימיזציה מותאמת לעומס העבודה ברמה חדשה, ולהפיק יותר הסקה מועילה מאותה חומרה.
אופטימיזציה של הסקה היא לולאת משוב מתמשכת. אנחנו מודדים את התנהגות המערכת בסביבת הייצור, מזהים את הפערים הגדולים ביותר, מיישמים שינויים ומוודאים שהם משפרים את המערכת כולה, ולא רק תוצאה במבחן ביצועים מבודד. GPT‑5.6 Sol ו-Codex מאיצים כל חלק בלולאה הזו. כך הצוות שלנו יכול לבחון יותר רעיונות, להגיב מהר יותר לעומסי עבודה משתנים וליצור מערך הסקה שמציע למשתמשים זמן תגובה קצר יותר, קיבולת גדולה יותר ועלויות נמוכות יותר.
ChatGPT Work ו-Codex משלימים משימות מורכבות באמצעות סדרה של בקשות למודל וקריאות לכלים. בתור אחד — מבקשת המשתמש ועד לתשובה הסופית — Codex עשוי לבחון קוד מקור, לחפש בהיסטוריית פריסות, לקרוא דוחות תקריות, לערוך קובץ ולהריץ בדיקות. כל שלב עשוי לדרוש בקשה.
הכנת הקשר, העברת נתונים, הרצת הסקה, קריאה לכלים והפעלת תהליכים — כולן דורשות זמן ומשאבי חישוב. אם משימה דורשת 30 בקשות למודל, שנייה נוספת בכל בקשה מצטברת לזמן משמעותי. שיפור הביצועים הכוללים מחייב צמצום של עבודה חוזרת בכל המערכת, ולא רק האצה של המודל.

תור משתמש אחד עשוי לכלול סבבי פעולה רבים של המודל והכלים. כל עלות בחלק שחוזר על עצמו עשויה להצטבר שוב ושוב.
ההשפעות המצטברות האלה הנחו אותנו בתכנון ה-harness האג'נטי שלנו — שכבת תזמור ב-Rust שמחברת בין המודלים, הכלים וסביבת המשתמש. כעת נסביר כיצד מניעת התנפחות ההקשר, טעינת כלים ושימוש חוזר בעבודה שכבר נעשתה מייעלים כל בקשה.
ככל שסוכנים מקבלים גישה ליותר כלים, מיומנויות, תוספים והיסטוריית שיחה, חלונות ההקשר יכולים להתרחב בקלות. הדבר מגדיל עלויות, מסיח את דעת המודל ומוביל ל-reasoning מיותר. ה-harness יכול לצמצם את התקורה הזו באמצעות גילוי מושהה, כך שאינטגרציות, כלי MCP מותאמים אישית, מיומנויות ותוספים נחשפים רק כשיש בהם צורך. ה-harness גם מונע מכלים בודדים ומאינטגרציות MCP למלא במפתיע את חלון ההקשר. פלט של כלי מוגבל כברירת מחדל ל-10,000 טוקנים, אלא אם המודל מבקש מגבלה אחרת.
כפי שכבר ציינו, לולאת סוכן יכולה לשלוח למעבדים הגרפיים את אותן הוראות, היסטוריית שיחה, הגדרות כלים ותוצאות קודמות פעמים רבות בתור אחד. עיבוד הקלטים החוזרים האלה יקר, ולכן מטמון פרומפטים מאפשר שימוש חוזר בחישוב של תחילית פרומפט שכבר עובדה. כדי לשמר את התחילית הזו, ה-harness מאפשר רק להוסיף לסוף ההיסטוריה שהמודל רואה: הודעות חדשות, תוצאות כלים ועדכוני סביבה נוספים בסוף, במקום להשתלב בהקשר קודם. גם הכלים מוצגים בסדר דטרמיניסטי, ואילו הגדרות זמן ריצה, כגון מדיניות אישורים, מוחלות במהלך הביצוע במקום להיות מוטמעות בהגדרות הכלים. בחירת התכנון הזו תורמת לשיעורים הכוללים הגבוהים של פגיעות במטמון פרומפטים ב-Codex וב-ChatGPT Work.

העברה מצטברת משנה את מה שעובר ברשת; מטמון פרומפטים משנה את מה שהמודל עשוי להימנע מלחשב מחדש. הרוחבים נועדו להמחשה בלבד, ושכבת הדחיסה הנוספת אינה מוצגת.
שיפורי היעילות שהשגנו עם GPT‑5.6 הם תוצאה של שנים של שיפורים מצטברים בכל שכבות המערכת, במחקר, בהסקה וב-harness האג'נטי שלנו. התפקיד שמילא GPT‑5.6 בהשגת רבים מהשיפורים האלה נותן לנו סיבה לאופטימיות לגבי האצת קצב האופטימיזציה. נמשיך להעמיק את האופטימיזציה בתחומים כמו מיטוב קרנלים, לצד שיפורים יסודיים במערך הטכנולוגי שלנו. אנחנו מצפים להביא את השיפורים המתמשכים האלה, שנעשים מאחורי הקלעים, למשתמשים וללקוחות שלנו — בדמות בינה זמינה יותר ומשתלמת יותר.
תודה מיוחדת למתיו פרארי, פיליפ טייה, אחמד איברהים, ג'ו גרשנסון וסטיב קופי, חברי הצוות הטכני, על תרומתם לפוסט הזה.