אפידמיולוגיה של קובצי core: תיקון באג בן 18 שנה
ניתוח ברמת האוכלוסייה לאיתור גורמי קריסות מורכבות בתשתית הנתונים שלנו.
מאת נייתן ברונסון, חבר הצוות הטכני
המודלים והסוכנים של OpenAI מסתמכים יותר ויותר על תשתית נתונים שניתן להרחיב כדי לחפש נתונים רלוונטיים בזמן ההסקה — כשהמודלים חושבים על השאלה שלכם. חלק מהשירותים האלה כתובים ב-C++, שהשליטה שלה במערכת ברמה הנמוכה מאפשרת לנו למקסם ביצועים ולמזער את השימוש בזיכרון. יתרונות היעילות האלה חשובים ככל שאנחנו גדלים, אבל היעדר בטיחות הזיכרון ב-C++ פירושו שבאגים עלולים לגרום לקריסות עקב כתיבה לכתובות זיכרון שגויות או לא קיימות.
לפני כמה חודשים זיהינו קריסות בשירות Rockset, רכיב ייעודי בתשתית הנתונים של ChatGPT, החיוני לתוספי נתונים רבים ולחיפוש בשיחות. בכל אחת מהקריסות האלה נראה שפונקציית C++ רגילה הסתיימה ואז חזרה לכתובת לא תקינה. עקב כך עצרה הליבה את התוכנית, כי מצביע הפקודות כבר לא הצביע על קוד. לפעמים התא של כתובת החזרה במסגרת המחסנית הכיל NULL. לפעמים נראה שאוגר המעבד המשמש כמצביע המחסנית עצמו סטה ב-8 בתים, כאילו ערכו של %rsp הוקטן איכשהו באמצע ריצה רגילה. בשני המקרים הקריסה התרחשה בעת החזרה.
אלה אינם דפוסי כשל רגילים בקוד יישום. כתיבה תועה שפוגעת רק בכתובת חזרה שמורה היא אפשרית, אבל מאוד לא סבירה. באג שמסיט את %rsp ב-8 ללא שימוש באסמבלי משובץ, ב-setcontext או ב-longjmp (שאיננו משתמשים באף אחד מהם) מוזר עוד יותר, כי קוד שעבר הידור משנה את האוגר הזה ישירות רק בפתיח ובסיום של פונקציה. לכל השערה שאנחנו (או ChatGPT) העלינו היו ראיות נגד חזקות, כך שהבאג נראה בלתי אפשרי.
מה שחשבנו לבעיה אחת התברר לבסוף כשני באגים בלתי קשורים, שהתגלו במקרה באותו זמן. הראשון: שיבוש חומרה שקט בשרת מארח אחד של Azure, שבו המעבד פשוט לא ביצע חישובים נכון. השני: מצב מרוץ בן 18 שנה ב-GNU libunwind, באג שלא הבחינו בו בספריית קוד פתוח נפוצה.
הפוסט הזה מספר איך זיהינו ותיקנו קריסות שנראו בלתי מוסברות, באמצעות חשיבה כמו אפידמיולוג ובניית מערך נתונים איכותי על כלל אוכלוסיית הקריסות.
ראשית, נרחיב מעט על Rockset. זו מערכת נתונים שנבנתה לענן, לחיפוש ולניתוח בזמן אמת, המשמשת אותנו לצרכים פנימיים רבים ב-OpenAI, כגון מחברי סנכרון (Rockset נרכשה על ידי OpenAI ב-2024). עדכונים בהזרמה משמשים לשמירה על אינדקס עדכני של מאגר הידע ב-workspace, כדי ש-ChatGPT יוכל לחפש מידע רלוונטי כשהוא עונה על שאלות או מבצע פעולות.
שכבת הביצוע של Rockset כתובה ב-C++. שפת C++ מספקת גישה למעבד ברמה נמוכה, מה שמועיל לביצועים וליעילות, אך גם מאפשר לבאגים ביישום להוביל לגישות לא חוקיות לזיכרון ולשגיאות סגמנטציה. כדי לאתר אותן, אנחנו משתמשים במטפל באותות קטלניים של folly לרישום עקבות מחסנית בעת קריסה, ומעלים את קובצי ה-core המתאימים (תמונת מצב של התוכנית בעת הקריסה) לאחסון הבלובים של Azure לניתוח בהמשך. לכל רכיבי הקצה לעיבוד שאילתות ב-Rockset יש עותקים, מה שממזער את השפעת הקריסה על הלקוח. עם זאת, כל שגיאת סגמנטציה מצביעה על באג שצריך לתקן כדי לעמוד ביעדי האמינות והאיכות שלנו.
בתחילה התייחסנו לקבצים האלה כאל בעיית ניפוי באגים רגילה: לבדוק כמה קובצי core לעומק, להעלות השערות ולשלול אותן בזו אחר זו.
רוב הקריסות התרחשו במתודה בשם DocumentTree::updateDocument. בקריסות האלה נראה ש-updateDocument קראה לפונקציה לא ידועה X, שהמחסנית השתבשה בזמן ש-X הייתה פעילה, ואז X חזרה לכתובת שלא הכילה קוד בר-ביצוע. בחלק מהמקרים, המסגרת של X שזה עתה נשלפה נראתה תקינה, מלבד כתובת החזרה השמורה שלה שהייתה NULL. במקרים אחרים מצביע המחסנית עצמו נראה שגוי, אבל המסגרת התקינה הבאה עדיין נראתה שייכת ל-updateDocument.
לא ידענו מתי המחסנית משתבשת, ולכן מרחב החיפוש היה עצום. updateDocument היא מתודה גדולה שעוברת הרבה שיבוץ קוד בעת ההידור, ולכן מספר המועמדות לתפקיד X היה עצום.
האם זה באג בקוד ה-C++ שלנו? בעיה במהדר או בקישור? בעיה באחת מספריות זמן הריצה שלנו? באג בליבת Linux הקשור למסירת אותות או להחלפת הקשר? משהו נדיר עוד יותר? אם זו כתיבה תועה, למה היא לא נתפסה בסביבת קדם-הייצור שלנו עם ASAN?
ניסינו להשתמש ביומני היישום כדי לזהות את כל מופעי הבעיה, אבל קשה לסווג באגים של שיבוש מחסנית מיומנים בלבד, כי עקבות המחסנית המתועדים משובשים בעצמם או חסרים. לא הצלחנו לבנות שאילתת יומנים שלא החזירה גם זיהויים שגויים וגם החמצות. בדקנו ידנית עוד קובצי core ומצאנו דוגמאות נוספות, אבל התהליך דרש עבודה רבה מדי מכדי להפיק מערך נתונים מהימן.
בשלב הזה של החקירה שללנו (בטעות) באג בחומרה, כי ראינו קריסות בכמה אזורים ובכמה סוגי חומרה, ולכן המשכנו לחפש גורמים בתוכנה בלבד. במשך כמה ימים העמקנו מאוד בקריסה יחידה עם סטייה ב-%rsp, ושחזרנו את מה שקדם לה בעזרת תוכן המחסנית והאוגרים. כך מצאנו כמה רמזים אפשריים, אבל מאחר שלא ויתרנו על המסקנה הראשונית שלכל הבאגים יש אותו גורם, נשארנו תקועים.
לפני שנגיע לנקודת המפנה בחקירה, חשוב להסביר איזה מידע חילצנו מקובצי ה-core.
Rockset מהודרת עם -fno-omit-frame-pointer, כך שתמיד אפשר להגיע למסגרת המחסנית הפעילה דרך %rbp, והפונקציות הקוראות יוצרות רשימה מקושרת של מצביעי מסגרות.
ב-Linux על x86_64, ה-ABI של AMD64 System V שומר גם 128 בתים מתחת ל-%rsp בתור האזור האדום. האזור הזה זמין לקוד במרחב המשתמש, וחשוב מכך, כחלק מחוזה ה-ABI הליבה מבטיחה לא לדרוס אותו בעת מסירת אות.
האזור האדום היה מרכזי בחקירת קריסה לאחר חזרה מפונקציה, כי הוא משמר מידע מסוים מלפני החזרה. כשנוצר SIGSEGV, המטפל באותות קטלניים של folly רץ על המחסנית של התהליכון שקורס. מסגרות מחסנית שכבר אינן פעילות (כי הפונקציה שלהן חזרה) יידרסו על ידי המטפל באות, פרט ל-128 הבתים האחרונים. לכן אנחנו יכולים לומר דברים כמו ״מסגרת המחסנית של X שזה עתה נשלפה נראתה תקינה, מלבד כתובת חזרה של NULL״. האזור האדום משמר חלק מהמסגרות הלא פעילות, או לפעמים רק את הקצה של מסגרת לא פעילה אחת.
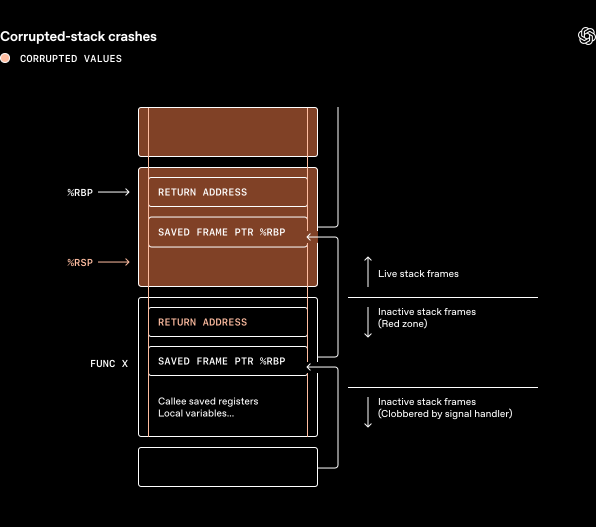
מצאנו קריסה אחת עם סטייה במחסנית שבה כל הפונקציות המעורבות היו קטנות מאוד. כך יכולנו לראות שהסטייה ב-%rsp נוצרה במהלך ביצוע פונקציה פשוטה יחסית, ושקריאות נוספות הצליחו אחריה. התוכנית קרסה רק כשהפונקציה הפעילה ניסתה לבסוף לחזור. אף אחד ממסלולי הקוד האלה לא השתמש בחריגות, באסמבלי משובץ, ב-setcontext או ב-longjmp. לכן, אם מצביע המחסנית אכן השתנה כפי שהשתמע מקובץ ה-core, שום באג סביר בקוד במרחב המשתמש לא הסביר זאת.
זה הפנה אותנו לליבה.
Rockset משתמשת באותות בתדירות גבוהה בהרבה מרוב התוכניות. ביצוע שאילתות מחולק למשימות קלות רבות שמחליפות ביניהן נתונים. זה חשוב לטיפול יעיל בעומסים של שאילתות רבות לשנייה, אך מקשה על חישוב צריכת המעבד לכל שאילתה, כי העבודה של שאילתות רבות משולבת באותו מאגר תהליכונים.
הפתרון שלנו הוא מנגנון שקראנו לו coarse_thread_cputime_clock. הוא מספק קירוב של clock_gettime(CLOCK_THREAD_CPUTIME_ID, ...) בעלות נמוכה מספיק לדגימה בכל מעבר בין משימות. אפשר להשתמש ב-API של timer_create כדי לתזמן מסירת אות מחזורית לפי כמה מדדים לחלוף הזמן, ובהם הצטברות זמן מעבד. אנחנו מתזמנים אות (SIGUSR2) למסירה מדי כמה אלפיות שנייה של זמן מעבד, ואז המטפל באות מעדכן ערך מקומי לתהליכון. אף שבמשימות רבות השעון הגס אינו מתקדם בזמן ביצוען, סכום כל ההפרשים נותן אומדן בלתי מוטה של זמן המעבד בפועל לשאילתה.
מכיוון שאנחנו מוסרים אותות לעיתים כה קרובות, באג נדיר בליבה הקשור להחלפת הקשר או למסירת אותות נראה סביר. הקדשנו זמן לקריאת דוחות באגים, קוד המקור של הליבה ותיקוני הליבה הייעודיים ל-Azure. ניסינו מבחני עומס. לא הצלחנו למצוא דבר שנראה קשור.
בשלב הזה החלטנו לקחת צעד אחורה ולנסות גישה אחרת.
יש שתי גישות עיקריות לניפוי בעיה כזאת.
האחת היא לפעול במעין תפקיד של רופא: להתמקד במטופל אחד, לבצע בדיקות רבות ולנסות לאבחן מקרה יחיד על סמך ראיות מפורטות.
השנייה היא לפעול יותר כמו אפידמיולוג: לבחון את כלל האוכלוסייה ולשאול אם יש דפוסים שמקרה יחיד לא יכול לחשוף. האם הבאג התחיל בגרסה מסוימת? האם יש מתאם בינו לבין מק״ט חומרה מסוים (דגם המעבד והשרת), אזור אחד או גרסת ליבה אחת? האם בתוך מה שנראה כתסמונת אחת מסתתרות כמה קבוצות נפרדות?
עד אז פעלנו בעיקר כרופאים. השינוי המרכזי היה ההחלטה שאנחנו צריכים לאסוף נתונים איכותיים על כלל האוכלוסייה.
הניסיונות הקודמים שלנו למצוא אוטומטית את כל מופעי הבעיה נכשלו כי ניסינו להשתמש בחיפושי טקסט ביומנים. קובצי ה-core עצמם מכילים הרבה יותר מידע, אבל בדיקה ידנית לא התאימה להיקף העבודה. החלטנו להשקיע בבניית תהליך שיוכל לנתח את קובצי ה-core באופן אוטומטי.
ביקשנו מ-ChatGPT לכתוב סקריפט שיוריד את החלק הראשון של כל קובץ core, יחלץ את האוגרים, יסנן זיהויים שגויים מוכרים בעזרת היומנים ויסווג את הקריסה אוטומטית כחזרה ל-null, סטייה במחסנית או אחר. אחר כך הרצנו את הסקריפט במקביל על כל קובצי ה-core של Rockset מסביבת הייצור בשנה הקודמת.
זו הייתה נקודת המפנה.
ברגע שהיה לנו מערך נתונים נקי, המתאמים התגלו מיד. מה שהתייחסנו אליו כבאג מוזר אחד היה למעשה שתי אוכלוסיות נפרדות של קריסות.
קובצי ה-core של החזרה ל-null התפזרו על פני אשכולות רבים ואזורים גאוגרפיים רבים. התדירות שלהם עלתה לאחרונה, אבל לא היה תאריך התחלה מובהק ולא גבול ברור בתשתית.
הקריסות עם הסטייה במחסנית נראו אחרת לגמרי. כולן הגיעו מאזור אחד, היה להן תאריך התחלה ברור, והן מעולם לא התרחשו בחוליות שפעלו זמן רב. אף שהן התרחשו בכמה מכונות וירטואליות של Azure (מכונות המתארחות בענן), הדפוס הצביע על מכונה פיזית אחת עם חומרה פגומה שגורמת לבעיות בכל מכונה וירטואלית שמוקצית אליה.

זה היה הרגע שבו הבנו שאיחדנו בראשנו שני באגים שונים. מכיוון שערבבנו דוגמאות נגדיות משני הבאגים, לא הצלחנו למצוא הסבר אחד עקבי.
בעזרת רשימה נקייה של חוליות Kubernetes וחותמות זמן, הצלחנו לייחס את הקריסות עם הסטייה במחסנית לשרת מארח פיזי יחיד, שאותו היה קל להוסיף לרשימת החסימה.
לא הצלחנו לשחזר את שיבוש האוגרים בשרת המארח הזה בסביבה מבוקרת, גם אחרי כמה שבועות של מבחני עומס. עם זאת, לאחר שהשרת המארח הבעייתי הוצא משירות, הקריסות עם הסטייה במחסנית נעלמו.
הסרת השרת המארח הפגום אינה פתרון קבוע, במובן זה שהיא לא מונעת מהבעיה להתרחש שוב. אבל אפשר לשנות את התוכנה כך שאם בעיה דומה תחזור, יהיה קל לזהות אותה ולטפל בה. שיפרנו את המטפל באותות קטלניים כך שיכלול את מצב האוגרים, כדי שנוכל לזהות הישנות של הבעיה מהיומנים בלבד (בלי צורך בקובץ core). שינינו את מישור הבקרה כך שבדרך כלל נעשה שימוש חוזר במכונות וירטואליות במקום להשמיד ולהקים אותן מחדש. כך קל הרבה יותר לזהות חוליות פגומות ברובד התשתית שלנו. עדכנו גם את נוהלי התפעול שלנו (ואת תפיסת הצוות) כדי להביא בחשבון את האפשרות הזו.
אחרי שהפרדנו את הקריסות מהשרת המארח הפגום, היה הרבה יותר קל להבין את קובצי ה-core שנותרו, של החזרה ל-null. קודם לכן שללנו פירוק מחסנית בעת חריגה, כי חשבנו שיש לנו דוגמאות נגדיות: קריסות במסלולי קוד שבהם בוודאות לא נעשה שימוש בחריגות. אבל כל הדוגמאות הנגדיות האלה השתייכו לקבוצת שיבושי החומרה.
כשבדקנו שוב את קובצי ה-core שנותרו לאור זאת, גילינו שהמסקנה הייתה הפוכה לגמרי: כל הקריסות התרחשו בזמן פירוק המחסנית בעת חריגה.
כש-C++ זורקת חריגה, מנגנון זמן הריצה צריך לגלות איזה בלוק catch אמור לקבל אותה ואילו פונקציות הריסה או מטפלי ניקוי יש להריץ בדרך. המהדר מפיק את המטא-נתונים האלה, אבל ההתאמה בפועל מתבצעת באופן דינמי בזמן הריצה.
פירוק המחסנית בעת חריגה אינו מבוצע בפועל על ידי הפונקציה שמפעילה throw, אלא על ידי פונקציות עזר שהקוד המהודר שנוצר קורא להן. שגרות זמן הריצה האלה בוחנות את המחסנית, שולפות מטא-נתונים על הפונקציות שנמצאות בה, מחפשות באופן דינמי מטפלי ניקוי ובלוקי catch, ואז מעבירות את הבקרה לאחד המקומות האלה. העברת הבקרה כוללת פירוק של כל מסגרות המחסנית שבדרך (כולל אלה של פונקציות העזר).
מבחינת אופן הפעולה, זה קרוב הרבה יותר ל-longjmp או למעבר בין סיבים מאשר לקריאה וחזרה רגילות. יש לשחזר את האוגרים שהפונקציה הנקראת אחראית לשמר, וכן את אוגרי מסגרת המחסנית %rbp ו-%rsp.
הקובץ הבינרי שלנו מקושר לשתי ספריות שמכילות מימושים של הפונקציות לפירוק המחסנית בעת חריגות ב-C++: libgcc ו-GNU libunwind. המקשר הדינמי בחר בהגדרות של GNU libunwind. זה הפתיע אותנו; ציפינו שהמימוש של libgcc ייבחר בגלל כללי גרסאות הסמלים, אבל בדיקת קבצים בינריים בזמן ריצה הראתה שלא כך היה.
בשלב הזה השערת העבודה שלנו השתנתה, כשוויתרנו על הנחה נוספת שהנחנו כשחשבנו שיש רק באג אחד.
אולי לא ראינו חזרה רגילה של פונקציה ל-NULL. אולי ראינו העברת בקרה במסגרת פירוק המחסנית — למעשה שחזור אוגרים בסגנון setcontext — שבה מצביע פקודת היעד הפך ל-NULL לפני העברת הבקרה. במילים אחרות, נתונים שגויים מספריית פירוק המחסנית, ולא תוכן שגוי בתא כתובת החזרה במחסנית.
זה צמצם מאוד את מרחב החיפוש. או ש-GNU libunwind חישבה מצב יעד שגוי, או שהיא חישבה מצב נכון ומשהו שיבש אותו לפני שהיה אפשר להחיל אותו.
קראנו את קוד המקור של GNU libunwind וגילינו שהיא יוצרת ucontext_t במחסנית, ממלאת בו את מצב האוגרים הרצוי למסגרת של מטפל הניקוי, ואז מעבירה מצביע למבנה הזה לשגרת אסמבלי פנימית: _Ux86_64_setcontext.
בשלב הזה כל החלקים היו בידינו.
מבנה ה-ucontext_t שנוצר נמצא באחת ממסגרות המחסנית ש-_Ux86_64_setcontext מפרקת במהלך הביצוע שלה. האם _Ux86_64_setcontext קראה מהמבנה אחרי ששינתה את %rsp, כשבשלב זה המבנה כבר לא היה חלק מהמחסנית הפעילה? אם כן, הוא היה חשוף לדריסה בעת מסירת אות, כמו SIGUSR2 התדיר שלנו.
התשובה הייתה כן.
אלה שש הפקודות האחרונות של _Ux86_64_setcontext בגרסת GNU libunwind שבה השתמשנו. רובן פקודות mov שטוענות מהזיכרון לאוגר יעד:
(%rdi מצביע על ucontext_t שהוקצה במחסנית, ופקודות המאקרו UC_MCONTEXT_* פשוט מתרחבות להיסט הקבוע שבו מאוחסן אוגר מסוים.)
הפקודה הראשונה פותחת את חלון המרוץ. היא מעדכנת את %rsp כך שיצביע לתחתית החדשה של המחסנית הפעילה. ברגע שזה קורה, המבנה שעליו מצביע %rdi כבר אינו חלק מהמחסנית הפעילה (או מהאזור האדום), וכבר אינו מחוץ לתחום עבור הליבה.
בדרך כלל זה לא גורם לבעיות, אבל אם אות מגיע בדיוק ברגע הנכון (הלא נכון?), הליבה תבנה את מסגרת האות ב-%rsp-128. זה עלול לדרוס את הזיכרון שעליו מצביע %rdi.
אם זה קורה לפני שהפקודה הבאה קוראת את UC_MCONTEXT_GREGS_RIP(%rdi), מצביע הפקודות המשוחזר עלול להשתבש. בקריסות שלנו, הוא הפך ל-NULL.
זה הבאג.
קוד האסמבלי הזה מסביר גם את אחד הממצאים שבלבלו אותנו: למה לפונקציה X היה NULL בתא כתובת החזרה של מסגרת המחסנית הקודמת.
setcontext נכתבה לשחזר את כל האוגרים, כולל %rdi, ולכן אינה יכולה להשתמש באוגר הזה כדי לקרוא את UC_MCONTEXT_GREGS_RIP(%rdi) ברגע האחרון של העברת הבקרה. במקום זאת, היא קוראת את הערך מוקדם יותר, שומרת אותו במחסנית, משחזרת עוד כמה אוגרים ואז משתמשת ב-retq כדי לקרוא את הערך השמור ולהעביר את הבקרה.
מה שנראה בקובצי ה-core כמו ״פונקציה חזרה ל-NULL״ היה למעשה ״מנגנון פירוק המחסנית יצר במחסנית כתובת חזרה, אבל כתובת היעד הזו השתבשה לפני שההעברה הושלמה״. הנחנו ששיבוש תא כתובת החזרה חייב להתרחש במקום, כי לא הכרנו מקומות שבהם נתונים (הניתנים לשיבוש) נכתבים לתא הזה בכוונה.
מה שגורם לבאג הזה להיראות מופרך הוא חלון המרוץ הצר כל כך. במצב מרוץ כזה, האירוע החיצוני (האות) צריך להתרחש בין שני צעדים שמבצע תהליכון אחר. ככל שהצעדים קרובים יותר זה לזה, הסיכוי שמצב המרוץ יתרחש קטן יותר.
במקרה הזה חלון הפגיעוּת הוא ממש באורך פקודה אחת! האות חייב להימסר אחרי ש-%rsp השתנה, אבל לפני שהפקודה הבאה טוענת את %rip. מעבד מודרני סופר-סקלרי עם ביצוע שלא לפי הסדר יכול להריץ כמה פקודות פשוטות כאלה במחזור שעון, כך שחלון המרוץ הוא כמאה פיקושניות.
כשמצאנו את המרוץ הזה, התגובה הראשונה שלנו הייתה שהוא ודאי נדיר מדי מכדי להסביר את שיעור הקריסות שראינו. ראינו יותר מתריסר קריסות של חזרה ל-null ביום בכלל מערך השרתים. האם מרוץ באורך פקודה אחת במהלך הניקוי בעת חריגה באמת יכול להסביר זאת?
פנינו לאומדן פרמי. אם חלון הפגיעוּת הוא בסדר גודל של שניות ו-SIGUSR2 מגיע מדי שניות של זמן מעבד, אז לכל מטפל ניקוי בעת חריגה או בלוק catch יש הסתברות של כ- להפסיד במרוץ.
Rockset משתמשת בחריגות כחלק ממנגנון הלחץ הנגדי הפנימי שלה לקליטת נתונים. שרת מארח יחיד בעומס יתר יכול לזרוק בסדר גודל של חריגות בשנייה. מכאן שהזמן הממוצע בין כשלים בשרת מארח שמשתמש בלחץ נגדי הוא שניות, כלומר קריסה אחת מדי כמה שעות. בקנה המידה של כלל מערך השרתים, זה די והותר כדי להסביר את תדירות הקריסות שנצפתה.
הבאג ב-GNU libunwind ישן — בן יותר מ-18 שנה. הוא קיים כבר בגרסת x86_64 הראשונה שתמכה בפירוק המחסנית בעת חריגות ב-C++.
אז למה הוא צץ דווקא עכשיו?
שיעור הקריסות יחסי בקירוב למספר החריגות שנזרקות ולמספר האותות שנמסרים. הוא תלוי גם בנפח המחסנית שהמטפל באות צורך.
Rockset חריגה בכל שלושת המדדים. אנחנו זורקים חריגות בקצב גבוה כחלק מבקרת עומס יתר שגרתית; מוסרים SIGUSR2 בתדירות חריגה בגלל coarse_thread_cputime_clock; ומוקדם יותר השנה הגדלנו את צריכת המחסנית של המטפל ב-SIGUSR2 באמצעות הוספת קריאה ל-timer_getoverrun, כדי להביא בחשבון אותות שמוזגו.
נראה שלשינוי האחרון הייתה חשיבות. אם המטפל צורך מעט מספיק מהמחסנית, ייתכן שלא יגיע לזיכרון הישן של ucontext_t ולא ידרוס אותו. לפני השינוי הזה איננו רואים קריסות כאלה כלל. לאחר השינוי השיעור נשאר נמוך, עד שהגדלנו את העומס בכמה שימושים שהעמיסו על מנגנון הלחץ הנגדי.
במילים אחרות, הבאג ב-libunwind תמיד היה שם, אבל המכפלה של קצב החריגות, קצב האותות וצריכת המחסנית של המטפל חצתה רק לאחרונה את הסף שבו השפעתו ניכרת בתפעול.
המנגנון הזה מסביר גם את צירוף המקרים שבו גם באג החומרה וגם הבאג ב-libunwind גרמו לקריסות בעיקר בתוך DocumentTree::updateDocument. הקריסות מ-libunwind נטו מאוד להתרחש במתודה הזו, כי היא תמיד פעילה בנקודה שבה אנחנו זורקים חריגה כדי להפעיל לחץ נגדי על קליטת הנתונים. גם קריסות עם סטייה ב-%rsp נטו מאוד להתרחש בה, כי החוליה עם החומרה הפגומה הייתה ממק״ט שמשמש אותנו לקליטת נתונים בהיקף גדול, פעולה שמקדישה את רוב זמן המעבד למתודה הזו.
צעד המנע המיידי שלנו היה לעבור מ-GNU libunwind למנגנון פירוק המחסנית של libgcc. המעבר היה כדאי גם בפני עצמו: במימוש של libgcc הושקעה עבודה רבה לצמצום התחרות על נעילות, דבר שחשוב כשעוברים למכונות וירטואליות גדולות.
תרמנו לפרויקט GNU libunwind גם קוד עצמאי לשחזור הבאג ותיקון(נפתח בחלון חדש), ווידאנו שבמנגנוני פירוק המחסנית האחרים אין בעיה דומה.
מסע ניפוי הבאגים הזה לימד אותנו הרבה על הפרטים של קישור דינמי, מטא-נתוני DWARF לפירוק המחסנית, מסירת אותות ב-Linux, ה-ABI של System V ומנגנון החריגות של C++. אבל הלקח המרכזי היה פשוט יותר מכל אלה.
הצעד החשוב ביותר לא היה הפענוח המתוחכם של האסמבלי או ההיכרות העמוקה עם הפרטים. הוא היה בניית מערך נתונים איכותי. בלי מערך הנתונים הזה, ערבבנו שתי תופעות נפרדות לסיפור אחד וניסינו לצאת מהבלבול בכוח ההיגיון. ברגע שהיו לנו נתונים מדויקים ומלאים על כלל האוכלוסייה, מבנה הבעיה התבהר: אוכלוסיית קריסות אחת נבעה משרת מארח פגום, והשנייה ממרוץ ב-libunwind. כשהנתונים השתפרו, ניפוי הבאגים נעשה קל יותר.
במערכות תשתית כמו Rockset, יש לכך חשיבות רבה. החקירה הזו חיזקה את המחויבות שלנו להטמעת מנגנוני מדידה וניטור מעמיקים, לחקירות אוטומטיות ולשיפור מתמיד בכלי התפעול שלנו. אמינות אינה רק תיקון באגים אחרי שהם מתרחשים — אלא גם בניית הנתונים, תהליכי העבודה והמיומנויות שהופכים בעיות בלתי אפשריות לכאלה שניתן לאבחן ולפתור.
מחברים
By Nathan Bronson ו-Member of Technical Staff


