Cómo Amplitude lanza mejoras en 1–2 días con OpenAI
Basado principalmente en modelos de OpenAI, Wave, el agente proactivo de producto de Amplitude, identifica qué desarrollar, ayuda a los equipos a lanzar cambios con agentes de programación y mide el impacto.
160 %
Aumento de la interacción con el agente frente al grupo de control tras un día
1–2 días
Tiempo estimado para lanzar una mejora del producto con Wave
51 %
Reducción del coste medio del modelo por tarea asignada con GPT‑6.1 Sol en la evaluación del agente de ciencia de datos de Amplitude.
1,34 $
Coste del modelo GPT‑6.1 Sol en la evaluación del investigador de oportunidades de Amplitude.
Amplitude siempre ha ayudado a los equipos a entender cómo se usan realmente sus productos. Su agente proactivo de producto, Wave, ayuda a los equipos a convertir esos hallazgos en mejoras que llegan a los usuarios. Según Amplitude, Wave funciona en torno a un 80 % con modelos de OpenAI, entre ellos GPT‑6.1 Sol, GPT‑6 Luna y GPT‑Image‑2.5 Flare. Wave convierte los hallazgos sobre el producto en planes de implementación que los equipos pueden enviar a agentes de programación, incluido Codex, y después mide el impacto.
Amplitude estima que Wave puede ayudar a los equipos a lanzar mejoras del producto en 1–2 días, frente al mes aproximadamente que tardaban antes. En la propia página de inicio de Amplitude, Wave ayudó a personalizar las tarjetas de sugerencias, lo que aumentó un 160 % los mensajes enviados a través de ellas.
«La IA ya puede encontrar tareas útiles que nunca se nos había ocurrido encargarle. Los modelos de OpenAI pueden investigar un problema, escribir y ejecutar código y usar los resultados para decidir qué probar a continuación».
Wave es el agente proactivo de producto de Amplitude. Los equipos le indican un área del producto, junto con los objetivos y las métricas que quieren mejorar. Wave combina datos de Amplitude, grabaciones de sesiones, comentarios de clientes y código para identificar y priorizar oportunidades, desarrollar soluciones y coordinar su implementación con personas y agentes de programación. Después, hace un seguimiento de los resultados y utiliza lo aprendido para orientar la siguiente ronda de mejoras.
Para este flujo de trabajo, Amplitude utiliza distintos modelos de OpenAI según la tarea. GPT‑6.1 Sol da soporte al gestor de oportunidades y a las investigaciones en profundidad del código y los datos. GPT‑6 Luna se encarga de tareas frecuentes de menor coste, como revisar código y realizar pequeñas comprobaciones de evaluación. GPT‑Image‑2.5 Flare genera maquetas del producto utilizando capturas de pantalla de las grabaciones de sesiones como referencias visuales.
Cuando una oportunidad está lista para desarrollarse, los equipos pueden enviarla directamente desde Wave a agentes de programación, incluido Codex, con un plan técnico y criterios de aceptación que guíen la implementación.
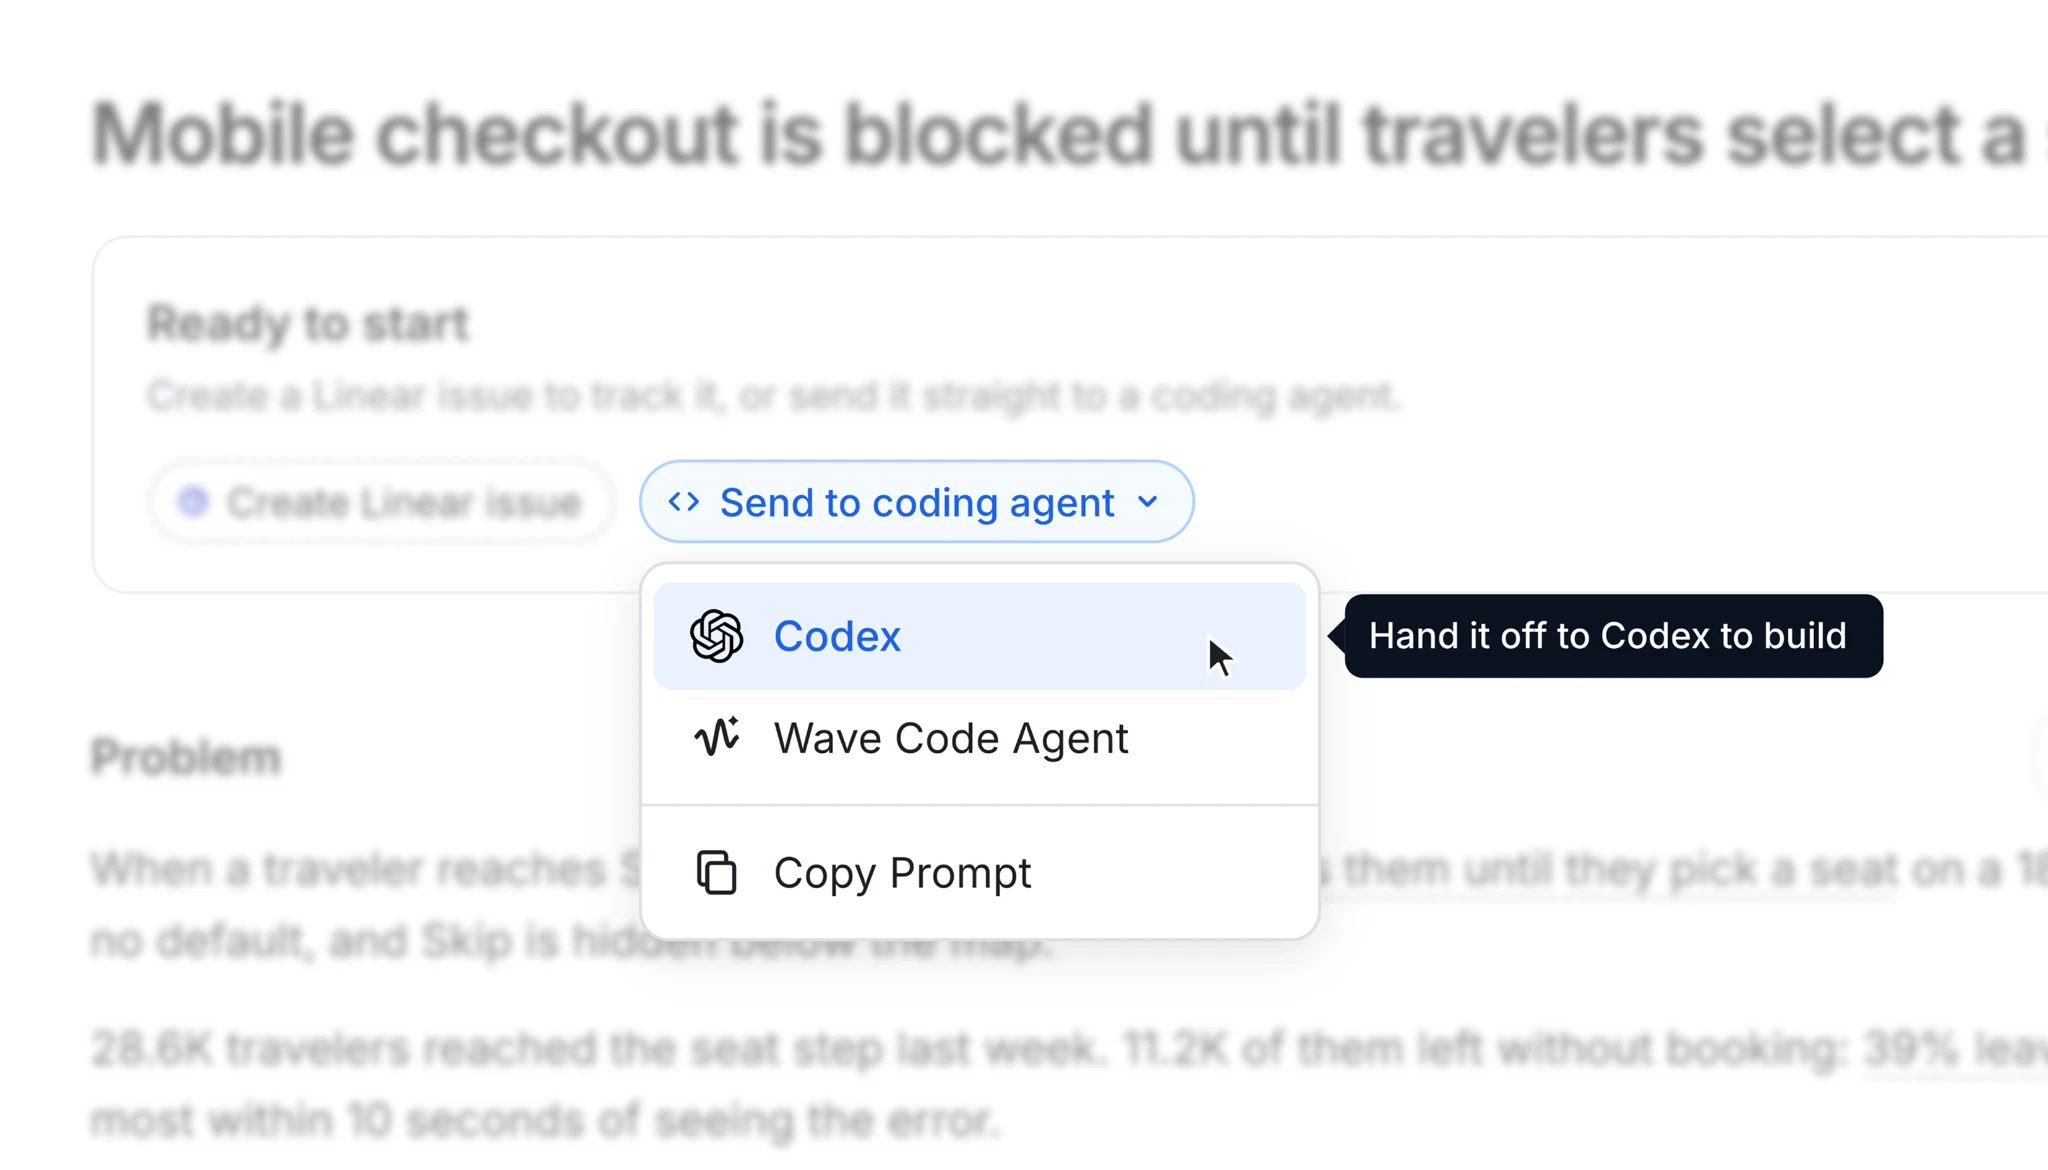
«La idea de Wave es que tengas una plataforma unificada con agentes que examinen enormes cantidades de grabaciones de sesiones, datos analíticos y código para encontrar oportunidades de mejorar los productos», explica Jacob Newman, responsable principal de producto de IA en Amplitude.
Amplitude probó Wave en su propia página de inicio, donde las tarjetas de sugerencias genéricas estaban pensadas para ayudar a los usuarios a iniciar una conversación con un agente de IA. Wave descubrió que los usuarios a menudo las pasaban por alto: en una muestra de 100 grabaciones de sesiones, 80 usuarios escribieron sus propias preguntas y solo 12 seleccionaron una sugerencia.
Wave propuso personalizar las tarjetas a partir de gráficos y paneles recientes, o de la página de la que procedía el usuario. Ilustró el cambio y elaboró un plan técnico que incluía mantener la escritura libre y mostrar sugerencias genéricas cuando no hubiera contexto disponible para personalizarlas. Tras una breve revisión, el equipo encargó el trabajo a un agente de programación y realizó una prueba A/B del cambio.
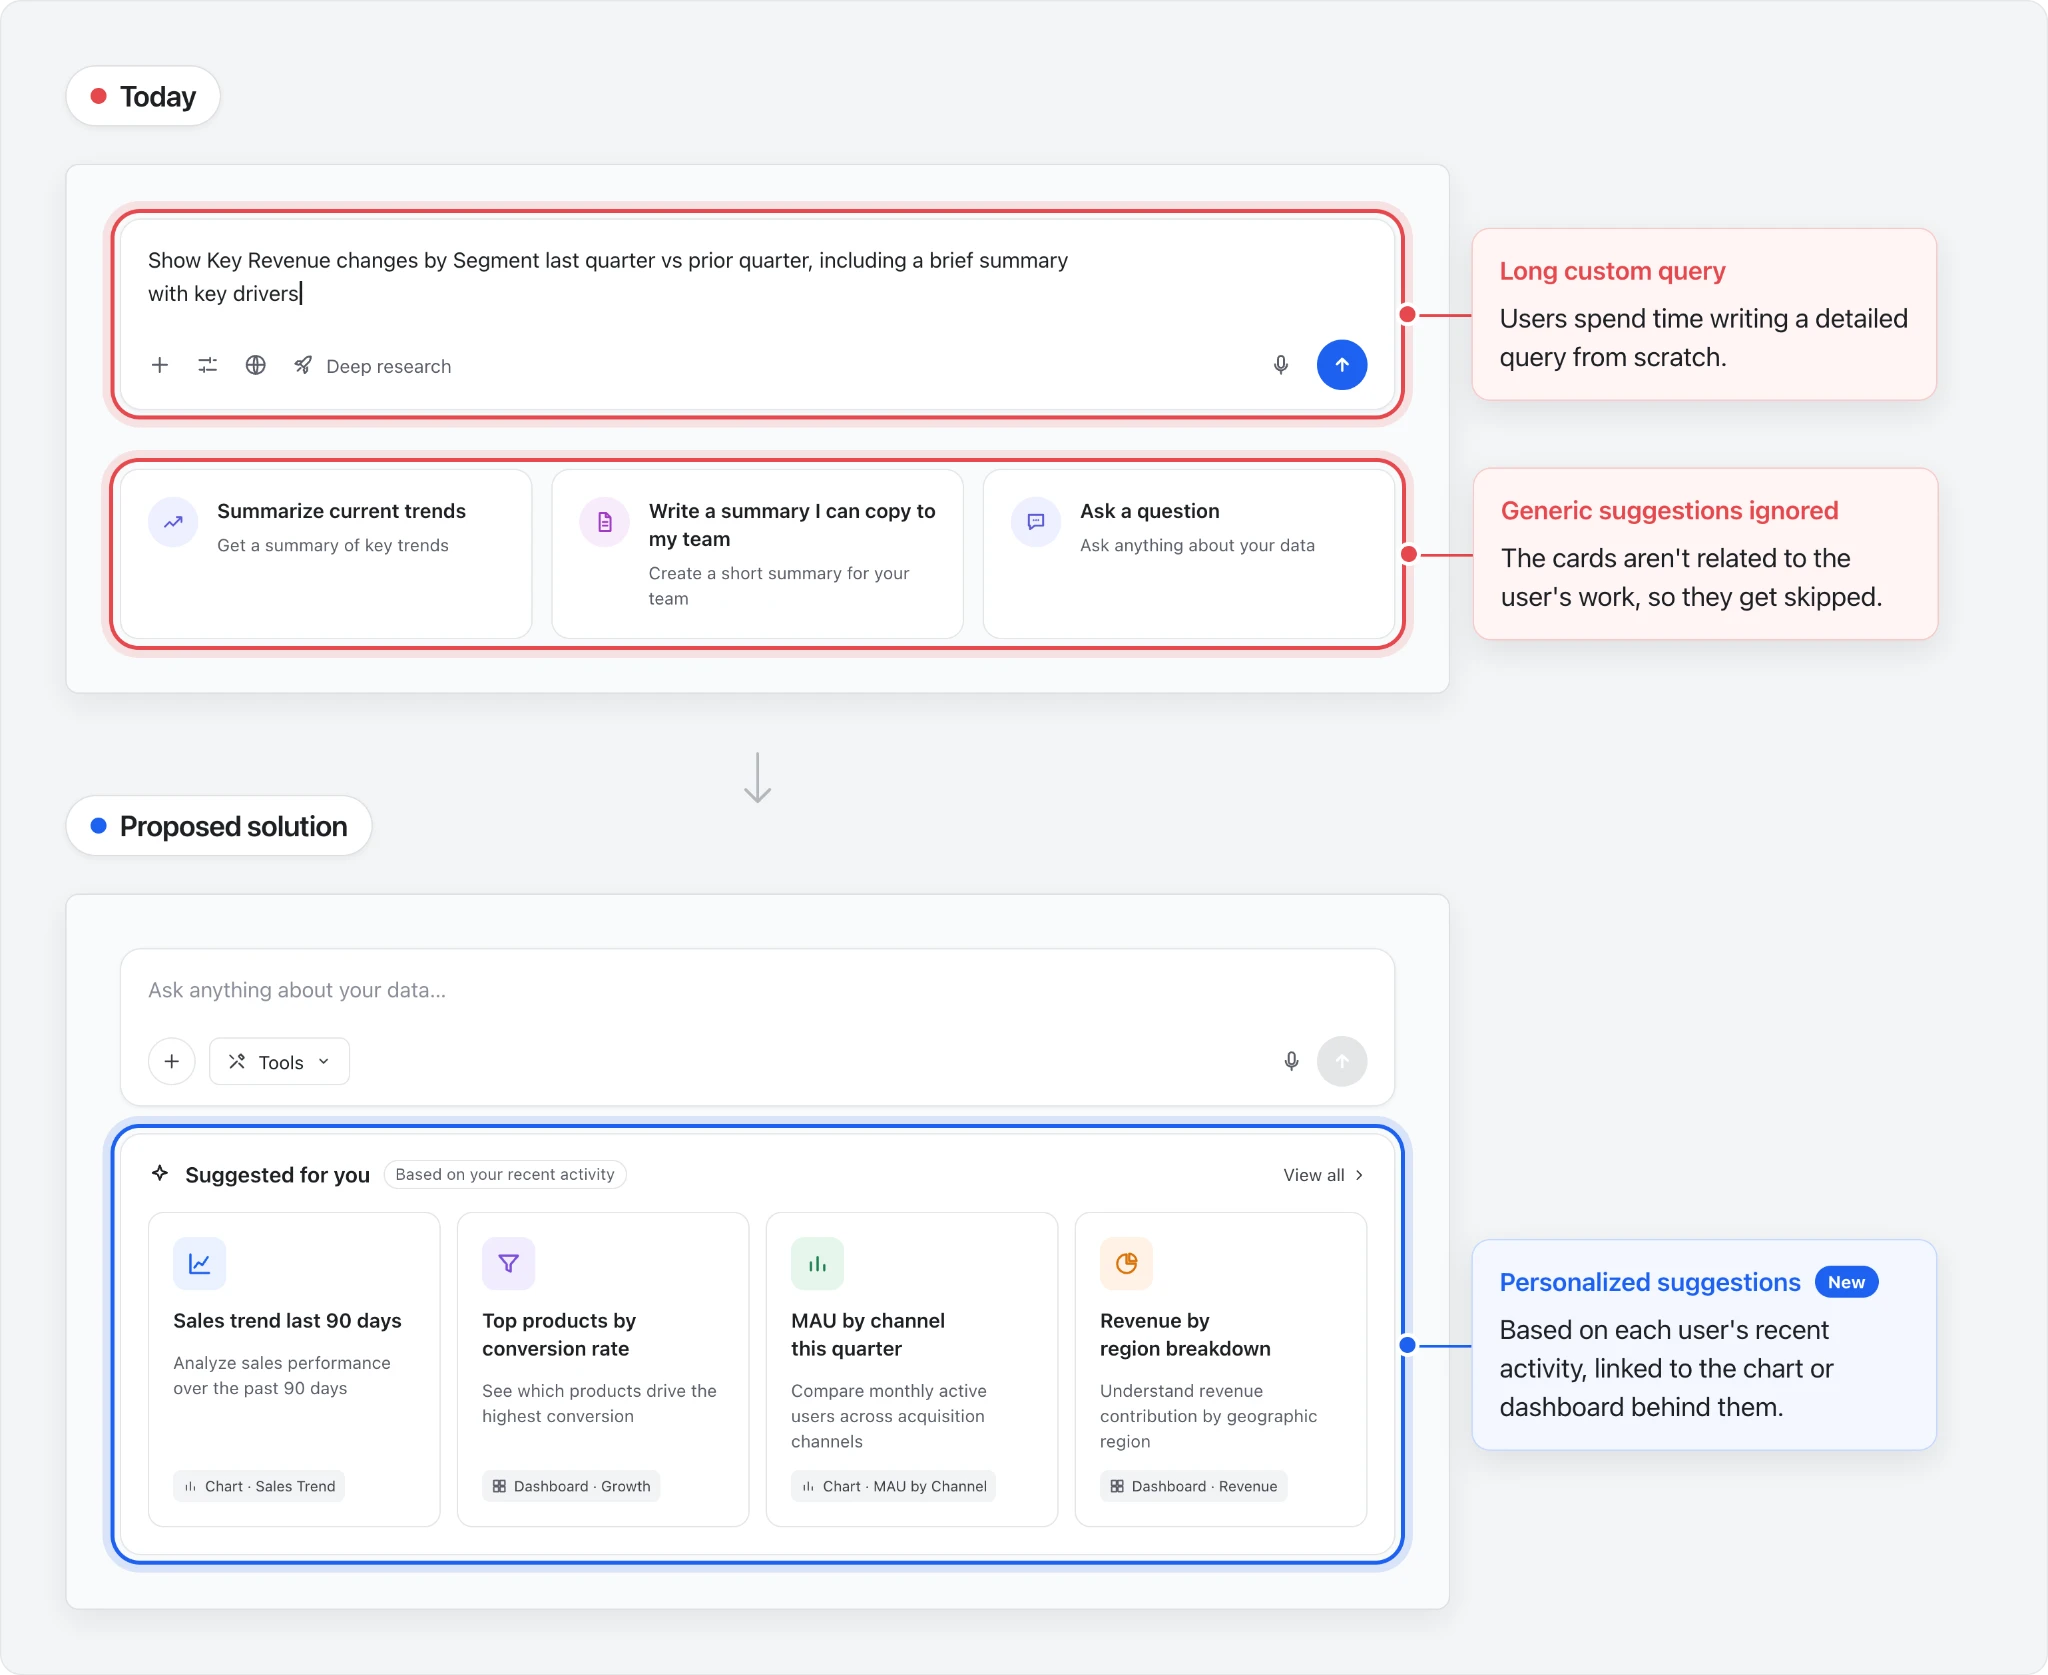
Según los resultados del experimento compartidos por Amplitude, los mensajes enviados a través de las tarjetas de sugerencias de la página de inicio aumentaron un 160 % frente al grupo de control tras un día. «Es un gran ejemplo de cómo algunos cambios que no son revolucionarios y que simplemente se pasan por alto pueden aumentar la adopción de funciones de formas inesperadas», explica Eric Carlson, ingeniero principal sénior de IA en Amplitude.
Cada tarea de Wave exige capacidades distintas a sus modelos. Una investigación en profundidad requiere una gran capacidad de razonamiento y conclusiones bien fundamentadas. Una pequeña comprobación que se repite cientos de veces debe ser rápida y económica. Amplitude evalúa la calidad, la latencia y el coste de cada tarea y asigna los modelos en función de esos criterios.
«OpenAI nos proporcionó tanto modelos con gran capacidad de razonamiento como modelos más pequeños y rápidos, lo que nos permitió equilibrar la calidad, la latencia y el coste de inferencia en todo el producto»
Para el investigador de oportunidades de Wave, Amplitude evaluó si los modelos corroboraban los hallazgos, evitaban falsos positivos, incorporaban los comentarios del evaluador, se recuperaban de fallos de las herramientas y ajustaban sus afirmaciones a las pruebas. GPT‑6.1 Sol obtuvo una puntuación global de 4,06 sobre 5, frente a 3,62, 3,52 y 2,94 de tres modelos alternativos. Lideró los cinco criterios de investigación y registró la mediana de tiempo de investigación más baja: 54 minutos.
En otra evaluación del agente de ciencia de datos de Wave, GPT‑6.1 Sol obtuvo 67,5 puntos sobre 100, frente a los 69,3 de otro modelo líder, con un coste medio del modelo de 1,28 $ por tarea asignada, frente a 2,63 $. GPT‑6.1 Sol también obtuvo mejores puntuaciones en el cumplimiento de los contratos de las herramientas, la estimación y la incertidumbre, y el anclaje en pruebas.
Para tareas de gran volumen, como revisar código y realizar pequeñas comprobaciones de evaluación, Amplitude utiliza GPT‑6 Luna para mantener bajos la latencia y el coste. Repartir el trabajo entre agentes especializados permite al equipo reservar el razonamiento más costoso para las tareas que más lo necesitan.
En la generación de esquemas de interfaz y maquetas, el modelo de generación de imágenes de OpenAI obtuvo 80,3 puntos sobre 100 para los esquemas de interfaz de soluciones, frente a los 63,9 de otro modelo de generación de imágenes. La evaluación de Amplitude abarcó la calidad de la comunicación, la fidelidad al producto, el seguimiento de instrucciones, la legibilidad del texto y la interfaz, y la coherencia visual en 15 oportunidades.
Clientes de distintos sectores ya utilizan Wave en versión beta para identificar y lanzar mejoras del producto. Wave analiza datos de sesiones y datos analíticos y, después, elabora recomendaciones con una solución propuesta, un plan técnico y criterios de aceptación.
A partir de ahí, los equipos pueden controlar el nivel de automatización. La mayoría de los equipos envía las correcciones de errores directamente a los agentes de programación, mientras que las nuevas funciones y las iniciativas de mayor envergadura pasan por una revisión humana.
En los cambios que llegan a lanzarse, el camino del descubrimiento a la ejecución puede ser corto: de los experimentos, indicadores de funciones y guías lanzados por clientes, uno de cada cuatro se puso en marcha el mismo día en que Wave detectó la oportunidad; la mitad, en menos de cuatro días; y dos de cada tres, en una semana.
Interpolación a partir de los hitos proporcionados; la curva es ilustrativa y no representa observaciones individuales.
«Nuestra ambición con OpenAI es que las empresas desarrollen software creando productos que mejoren por sí solos», afirma Skates. A medida que los modelos de OpenAI mejoren en razonamiento y programación, los equipos podrán delegar más trabajo de investigación e implementación en los agentes, lo que permitirá que mejores productos lleguen antes a los usuarios. Amplitude ya lo está viendo: los agentes identifican mejoras en su propio producto y ayudan a implementarlas mientras el equipo se ocupa de otras prioridades. «Creo que los equipos se sorprenderán de todo lo que pueden conseguir cuando su software trabaja a su lado para mejorar el producto».